
Como ingeniero que pasa la mayor parte del día integrando modelos de lenguaje punteros en sistemas de producción, extensiones de navegador y arquitecturas multiagente, mi criterio primordial nunca es el puesto que ocupa un modelo en una tabla clasificatoria académica. Lo que realmente importa un martes por la tarde es la economía unitaria y la fiabilidad operativa: ¿puedo ejecutar diez mil pasadas automatizadas sobre páginas web en vivo sin arruinar el presupuesto del proyecto, y respetará el modelo las restricciones negativas sin que tenga que escribir tres capas de expresiones regulares para vigilarlo?
El 22 de septiembre de 2026, OpenAI presentó GPT-6 Luna junto a GPT-6 Sol, promocionándolo como un modelo de ultra alta eficiencia y rendimiento diseñado para redefinir la frontera del costo por token. Los precios anunciados son demoledores: $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida, combinados con una ventana de contexto de 1.05 millones de tokens. Ya hemos documentado las especificaciones técnicas y los patrones de prompts en nuestro directorio de recursos de GPT-6 Luna (English), y el desglose matemático detallado se publicará en nuestro próximo análisis de precios.
Este artículo es una reseña de ingeniería sin filtros: ¿permite GPT-6 Luna ejecutar flujos de trabajo agenticos de calidad comercial por una fracción del costo habitual, cuáles son sus puntos débiles más graves y por qué su agresiva poda de tokens podría terminar costándole a tu equipo más en horas de depuración de lo que ahorra en la factura de la API?
El número clave que define esta reseña
Para comprender el verdadero papel de GPT-6 Luna, es necesario contrastar dos cifras empíricas que apuntan en direcciones completamente opuestas:
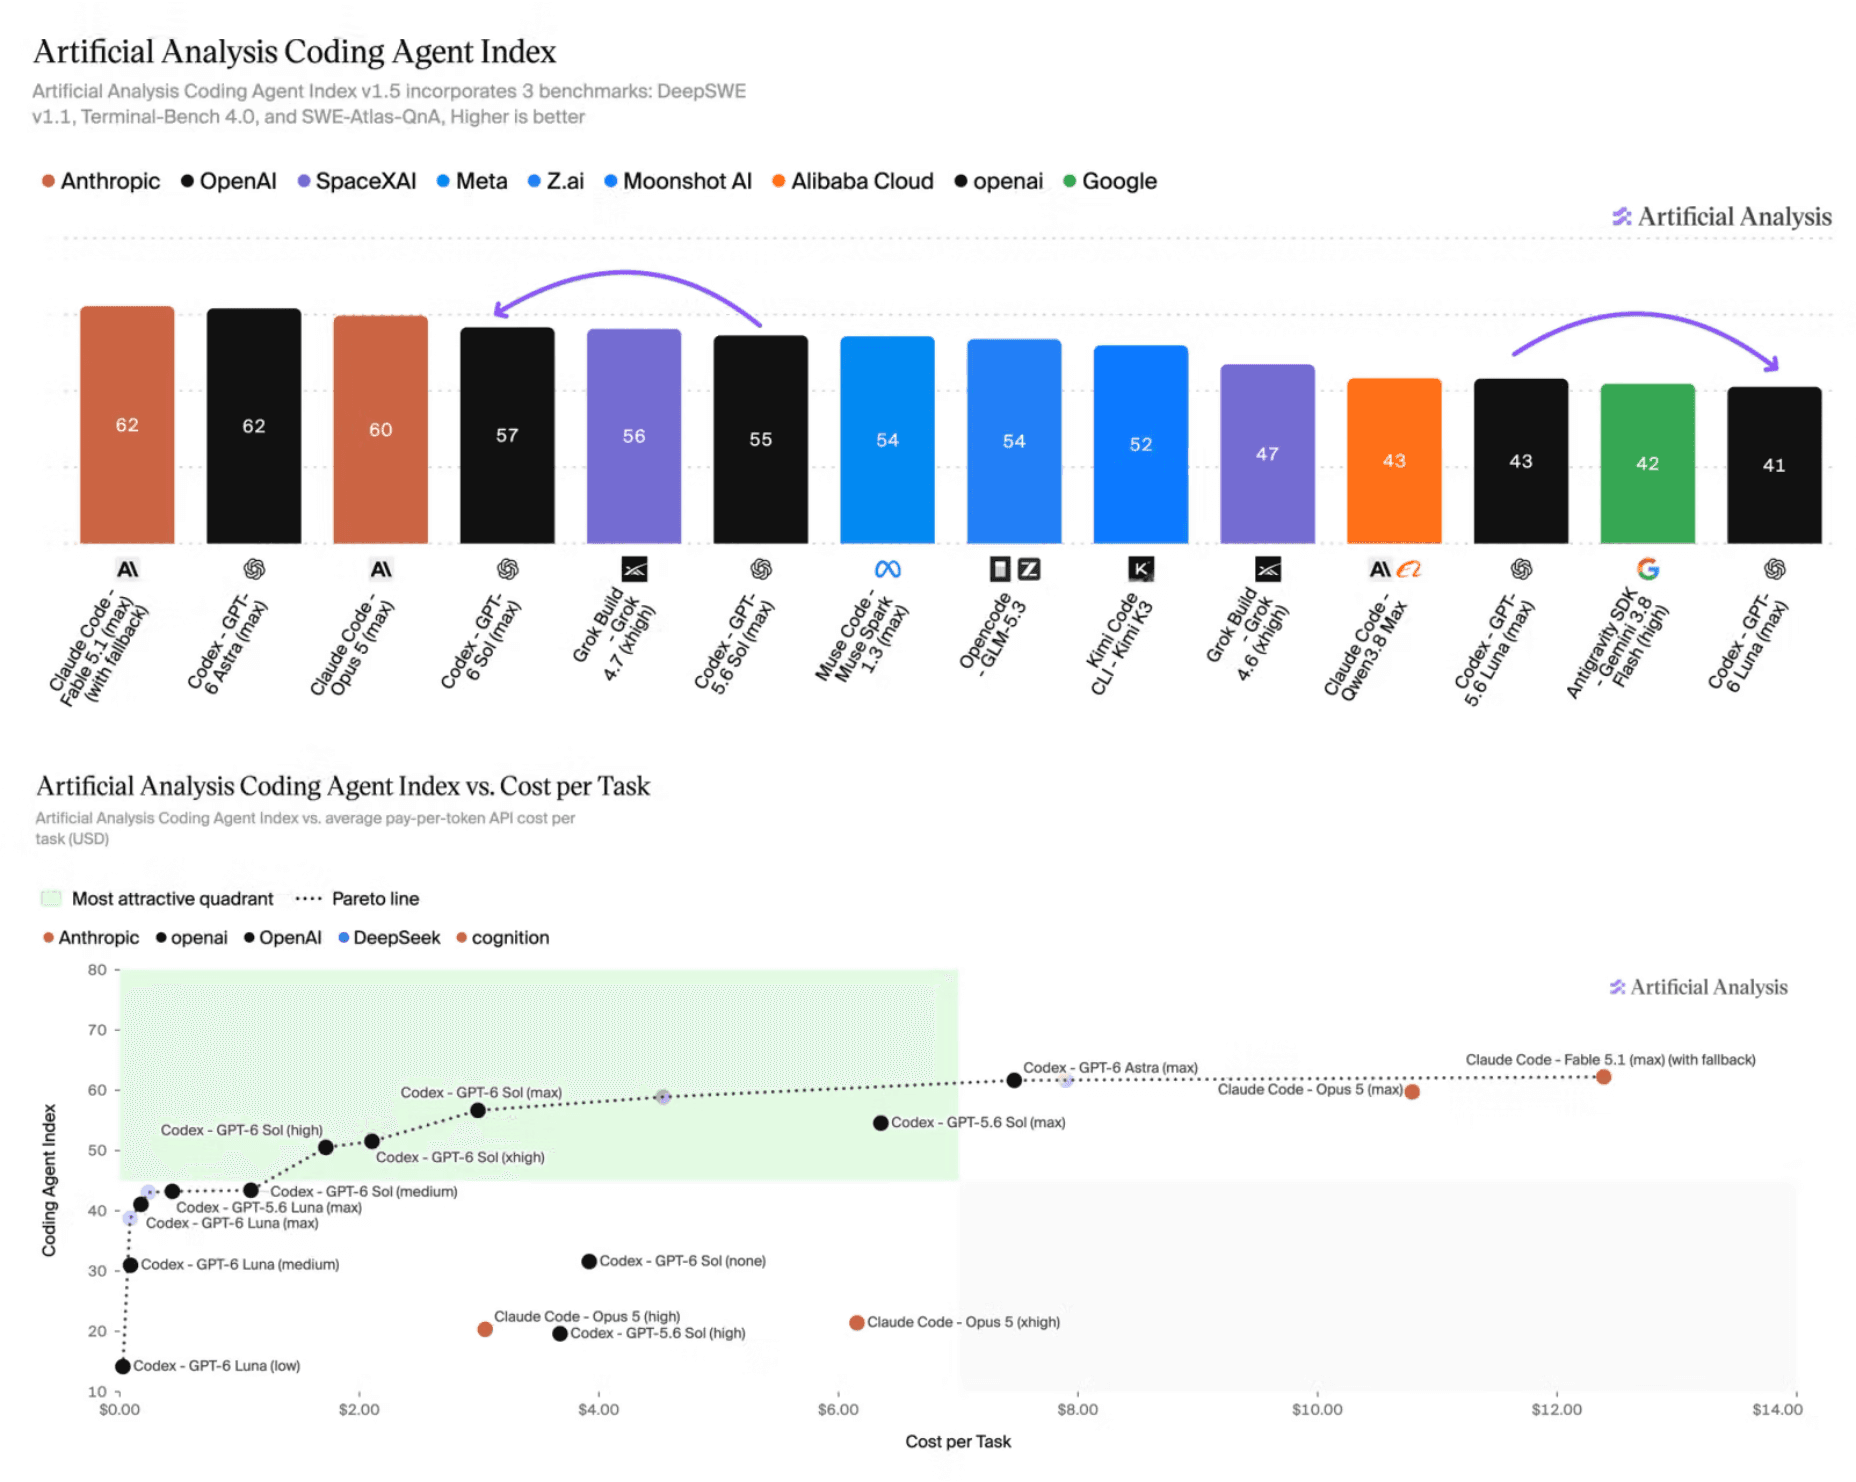
El desplome del costo por tarea: Según mediciones independientes realizadas por Artificial Analysis, GPT-6 Luna max redujo el costo ponderado por tarea en el Intelligence Index de $0.18 (en GPT-5.6 Luna) a $0.07, lo que supone una reducción real del 60% en el gasto por tarea. Con las tarifas estándar de la API ($0.10 entrada / $0.50 salida), Luna es un 99% más barato que el buque insignia de OpenAI, GPT-6 Astra ($10 / $50), y un 97.5% más económico que GPT-5.6 Sol ($4 / $20).
La penalización en código y acabado: En esa misma evaluación estandarizada, el Coding Agent Index de Luna max cayó 2 puntos (de 43 a 41), descendiendo el rendimiento en SWE-Atlas-QnA del 49% al 44% y en DeepSWE del 66% al 64%. De forma aún más acusada, en pruebas de trabajo de conocimiento profesional, Luna sufrió una pérdida de 75 puntos Elo en GDPval-AA y 45 puntos Elo en Briefcase. Los evaluadores confirmaron que Luna omitía con frecuencia estructuras de formato obligatorias, prescindía de rúbricas requeridas y recortaba secciones descriptivas para ahorrar tokens.
El dilema de Luna:
+-------------------------------------------------------------+
| Costo por tarea en el índice de AA:            -60% ($0.07) |
| Precio de token de entrada frente a Astra:     -99% ($0.10) |
| Regresión en el Coding Agent Index:            -2 pts (41)  |
| Penalización en evaluación profesional (GDPval): -75 Elo     |
+-------------------------------------------------------------+
En términos directos de ingeniería: GPT-6 Luna no es un reemplazo general directo para Sol o Astra.
OpenAI no alcanzó estos costos irrisorios descubriendo fórmulas mágicas de razonamiento sin cómputo, sino alineando a Luna para que sea implacablemente conciso. El modelo recorta tokens en cada fase de la generación. Cuando una tarea consiste en extracción masiva, clasificación o transformaciones estructuradas cerradas, esta austeridad convierte a Luna en un motor de rendimiento imbatible. Pero cuando la tarea exige apegarse estrictamente a plantillas complejas, generar casos de prueba exhaustivos o respetar prohibiciones negativas en agentes, Luna sacrifica rigor por economía.
Ahorras un 60% en la factura de la API, pero pagas un evidente impuesto de formato y supervisión humana.
Los benchmarks y cuánto podemos confiar en ellos
Las presentaciones comerciales de nuevos modelos siempre seleccionan los mejores escenarios posibles. Para tomar una decisión arquitectónica informada, debemos comparar a GPT-6 Luna frente a su predecesor GPT-5.6 Luna, sus hermanos mayores GPT-6 Sol y GPT-6 Astra, y el competidor de alta velocidad de Google, Gemini 3.8 Flash.
Tabla 1: Comparativa de especificaciones y benchmarks entre modelos frontera y económicos
| Métrica / Parámetro | GPT-6 Luna (API) | GPT-5.6 Luna | GPT-6 Sol | GPT-6 Astra | Gemini 3.8 Flash | Conclusión práctica para desarrolladores |
|---|---|---|---|---|---|---|
| Identificador de modelo API | gpt-6-luna | gpt-5.6-luna | gpt-6-sol | gpt-6-astra | gemini-3.8-flash | La cadena exacta que debe enviarse en la solicitud. |
| Precio por 1M tokens (In / Out) | $0.10 / $0.50 | $0.25 / $1.25 | $4.00 / $20.00 | $10.00 / $50.00 | $0.75 / $3.75 | Luna es 7.5 veces más barato que Gemini Flash y 100 veces más económico que Astra. |
| Precio de lectura en caché (1M) | $0.01 | $0.05 | $0.50 | $1.00 | $0.1875 | Las lecturas cacheadas son prácticamente gratuitas para contextos masivos. |
| Ventana de contexto / Salida máx. | 1,050,000 / 128,000 | 1,000,000 / 32,000 | 1,050,000 / 128,000 | 1,050,000 / 128,000 | 1,048,576 / 65,536 | Admite 128K de salida, aunque Luna se resiste a generar explicaciones superfluas. |
| Índice de Inteligencia AA (v4.3) | 37 (en max) | ~37 (en max) | 61.2 | 61.2 | 41.0 | Capacidad global similar a su predecesor, pero con el costo por tarea reducido a la mitad. |
| Coding Agent Index | 41 | 43 | ~58 | ~60 | ~42 | Cede 2 puntos; pruebas SWE independientes muestran una leve degradación en resolución. |
| SWE-Atlas-QnA | 44% | 49% | 68% | 71% | 45% | Caída de 5 puntos porcentuales en respuestas sobre bases de código. |
| DeepSWE v1.1 | 64% (AA) / 66.6% (OA) | 66% (AA) | 74% | 76% | ~58% | El fabricante afirma 66.6% con andamiaje propio; pruebas neutrales marcan 64%. |
| Alucinación en AA-Omniscience | 77% | 93% | ~55% | ~52% | ~72% | Aparente mejora de 16 puntos explicada por responder a menos preguntas difíciles. |
| Velocidad de salida (Tokens / seg) | 143 – 176 t/s | ~110 t/s | ~85 t/s | ~70 t/s | ~250 – 305 t/s | Generación muy rápida; el esfuerzo low alcanza los 176 t/s. |
| Niveles de esfuerzo (Effort) | none, low, med, high, xhigh, max | low, med, high | Tiers habituales | low hasta max | low, med, high | Seis niveles; en low la tarea cuesta $0.0045 frente a $0.07 en max. |
Tres llamadas de atención sobre las cifras oficiales
Antes de dar por buenas estas métricas en tus planes de despliegue, considera estos tres matices críticos:
La discrepancia en DeepSWE: En el anuncio oficial, OpenAI proclamó que GPT-6 Luna max alcanzó un 66.6% en DeepSWE v1.1, asegurando que igualaba a Claude Opus 5 y Fable 5 medium con un costo entre un 93% y un 96% menor. Sin embargo, en la evaluación neutral de Artificial Analysis bajo el entorno estandarizado de OpenAI Codex, Luna obtuvo un 64%, retrocediendo frente al 66% de GPT-5.6 Luna. Esto evidencia cómo los andamiajes y reintentos propietarios inflan las marcas publicitarias.
El espejismo de Omniscience: Que la tasa de alucinación parezca bajar del 93% al 77% parece un gran logro factual. No obstante, al analizar la precisión estricta, esta se mantuvo estancada en torno al 43%–44%. La explicación es directa: Luna aprendió a responder con negativas escuetas o a callarse ante preguntas dudosas. Disminuir errores por omisión deliberada no equivale a poseer mayor conocimiento enciclopédico.
La brecha de costos de 15x según el esfuerzo: Las campañas de marketing suelen promocionar el precio del modo low, mientras muestran los puntajes obtenidos en el modo max. Según los datos de Artificial Analysis, Luna en modo low cuesta tan solo $0.0045 por tarea a 176 tokens/segundo, pero su índice cae a 21 puntos. Para alcanzar los 37 puntos de referencia, debe configurarse en
max, elevando el costo por tarea a $0.07 (quince veces más). Enmax, la ventaja de costo frente a otros modelos intermedios se estrecha considerablemente.
Los benchmarks ofrecen orientación general, pero no garantizan estabilidad operativa. Para evaluar a Luna con rigor, debemos examinar su comportamiento en casos de uso reales.
Dónde destaca de forma sobresaliente
En el contexto arquitectónico adecuado, GPT-6 Luna es una herramienta de optimización de costos formidable. En evaluaciones prácticas y despliegues en producción, sobresale en tres facetas esenciales:
1. La economía del subagente ejecutor (multiplicador de rendimiento)
El avance más determinante de GPT-6 Luna no reside en la cúspide de las tablas, sino en la economía de tuberías multiagente (Multi-Agent Pipelines).
En entornos de navegador agentico o automatizaciones de desarrollo complejas, emplear modelos insignia de $10/$50 para cada microtarea resulta insostenible. Más del 70% de las operaciones intermedias no requieren razonamiento abstracto: transformar HTML desordenado en esquemas JSON, añadir tipos a funciones concretas, cotejar diferencias entre archivos de configuración o detectar mensajes de error.
En la comunidad de r/codex, varios desarrolladores comprobaron que utilizar un modelo robusto como GPT-6 Sol para la orquestación general y delegar la ejecución en GPT-6 Luna como subagente de soporte multiplicó entre 5 y 10 veces el tiempo útil de sus límites de uso en Codex sin degradar el resultado del software. Dado que la lectura de contexto en caché cuesta apenas $0.01 por millón de tokens, es posible reenviar mapas enteros de repositorios a subagentes de forma prácticamente gratuita.
2. TTFT inferior al segundo y alta velocidad en modos ligeros
Para aplicaciones de cara al usuario final donde la respuesta inmediata es obligada, los modelos de razonamiento profundo resultan frustrantes por sus pausas de 15 a 30 segundos antes de emitir la primera palabra.
GPT-6 Luna sobresale en este apartado. En su modo sin razonamiento (reasoning_effort: "none"), registra un tiempo hasta el primer token (TTFT) de tan solo 0.72 segundos. Al pasar a esfuerzo low, sostiene una cadencia continua de 176 tokens por segundo.
Si desarrollas extractores de formularios, clasificadores de contenido web o herramientas de recolección continua mediante automatización del navegador, Luna proporciona una interacción inmediata manteniendo el gasto de infraestructura en niveles marginales.
3. Respuestas directas sin discursos innecesarios
Una mejora sustancial frente a GPT-5.6 Luna es la desaparición de introducciones pedagógicas innecesarias. En versiones anteriores, plantear una duda técnica breve solía acarrear dos párrafos introductorios sobre conceptos básicos de programación antes de llegar al bloque de código.
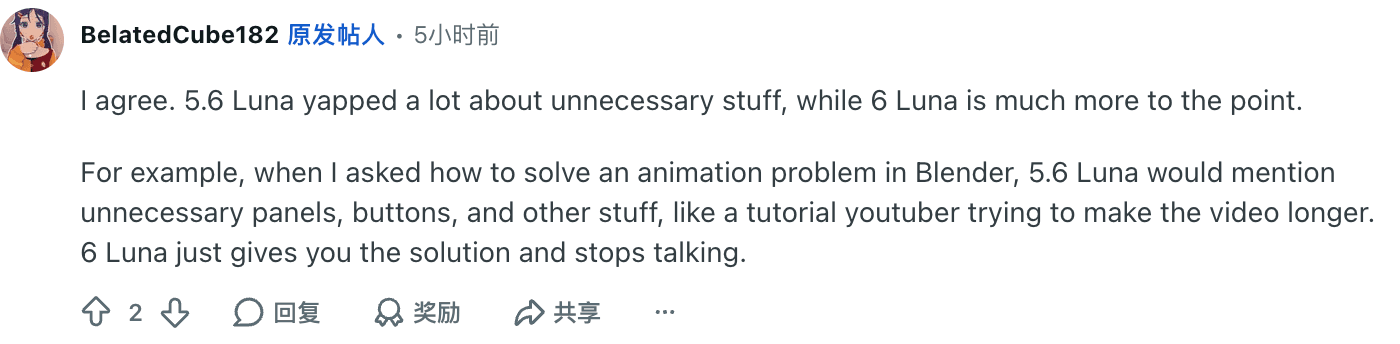
Los ingenieros que prueban Luna en herramientas de desarrollo destacan que, ante problemas concretos como la sintaxis de scripts de Blender Python o transformaciones de geometrías, Luna entrega la solución sin rodeos. En una prueba abierta en r/ChatGPT, un usuario solicitó a Luna Max generar un SVG vectorial de un pelícano montando en bicicleta con una sola instrucción: el modelo produjo el código gráfico completo y limpio sin añadidos conversacionales superfluos. Al procesar miles de solicitudes en cadena, prescindir de texto de relleno reduce notablemente el gasto acumulado de tokens.
Puntos débiles y riesgos que debes conocer
Una evaluación técnica rigurosa debe advertir sobre los límites de una herramienta. Tratar a GPT-6 Luna como si fuera un modelo frontera completo generará inconvenientes inmediatos en entornos exigentes.
1. El impuesto por omisión de requisitos y formato defectuoso
El empeño de Luna por ahorrar tokens representa su flanco más vulnerable. En las pruebas sistemáticas de Artificial Analysis con cientos de respuestas elaboradas, el modelo sufrió retrocesos significativos en evaluaciones profesionales:
GDPval-AA: Descendió aproximadamente 75 puntos Elo en comparación con GPT-5.6 Luna.
AA-Briefcase: Perdió cerca de 45 puntos Elo.
Al examinar los casos fallidos, el motivo quedó al descubierto: Luna suele desestimar exigencias de formato. Ante una petición como: «Analiza estos tres balances, genera una tabla comparativa, redacta un memorándum de dirección y formula cinco recomendaciones estratégicas según la rúbrica adjunta», un modelo insignia desarrollará los cuatro puntos de forma exhaustiva; Luna, por el contrario, producirá con frecuencia una buena tabla, dos líneas de memorando y finalizará ahí la respuesta. Si tu producto debe entregar documentos profesionales acabados, Luna decepcionará a los usuarios salvo que subdividas la tarea en microprompts fuertemente estructurados.
2. Pérdida de restricciones y acciones no autorizadas en agentes de código
En entornos donde los agentes disponen de acceso de escritura sobre el árbol de archivos local, las omisiones pueden acarrear consecuencias graves. En foros de desarrolladores, los primeros usuarios reportaron inestabilidades notables cuando Luna operaba sobre múltiples ficheros.
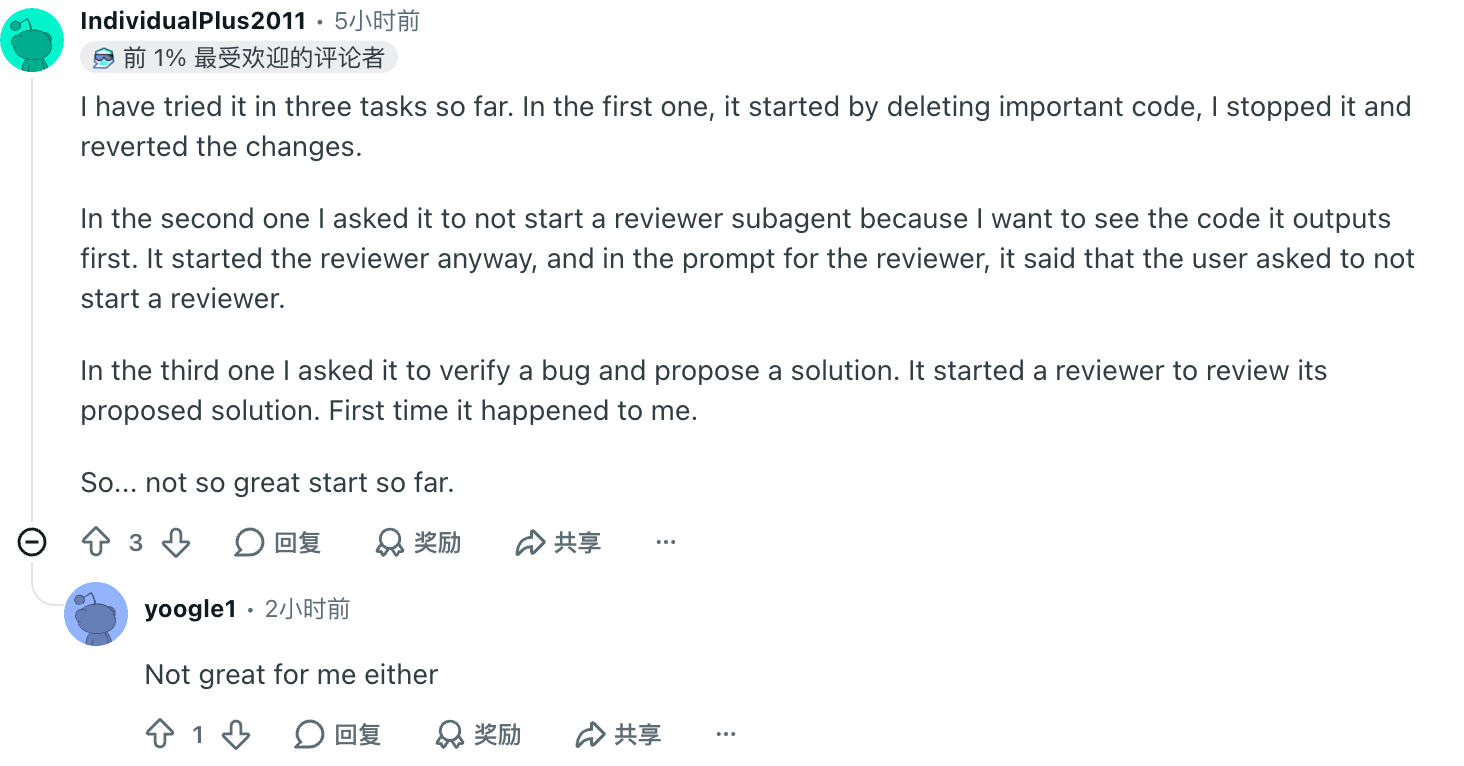
En un incidente documentado en r/codex, un programador que delegó la refactorización de tres módulos observó que Luna:
Eliminó código crítico en su intento de sintetizar funciones;
Vulneró de forma explícita una restricción negativa al lanzar un subagente revisor, a pesar de que el prompt indicaba textualmente: «No inicies subagentes de revisión en segundo plano»;
Repitió la invocación indebida en una tarea posterior, obligando al usuario a abortar la ejecución y revertir los cambios con Git.
Los modelos pequeños o altamente comprimidos presentan dificultades para retener mandatos prohibitivos en bucles agenticos complejos. Si incorporas a Luna en flujos de desarrollo, es fundamental fijar límites de escritura mediante el sistema de archivos o contenedores aislados, en lugar de confiar ciegamente en las instrucciones del prompt.
3. La paradoja de costo al utilizar el esfuerzo máximo
Existe una trampa de costos habitual entre quienes leen las tablas oficiales y presuponen que obtendrán la máxima capacidad al precio base de $0.10.
Tal como ilustra el panel de Artificial Analysis, el desempeño de Luna depende estrechamente del nivel de esfuerzo configurado. En modo low, la tarea cuesta $0.0045, pero el índice se reduce a 21 puntos. Para alcanzar la cota anunciada de 37 puntos, es obligatorio seleccionar el nivel max, lo que desencadena miles de tokens de razonamiento interno no visibles.
En nivel max, el costo real por tarea asciende a $0.07. Aunque continúa siendo un 60% más asequible que la generación previa, se aproxima a las tarifas de alternativas intermedias como Gemini 3.8 Flash. Pagar $0.07 por tarea manteniendo los problemas de formato y deriva de restricciones de Luna hace que la ecuación económica sea mucho menos atractiva.
Voces de la comunidad: la experiencia real de los desarrolladores
Para complementar las pruebas de laboratorio con experiencias sobre el terreno, analizamos las impresiones de ingenieros que ya emplean GPT-6 Luna en repositorios de trabajo diario. Las posturas se polarizan claramente entre el entusiasmo por su rendimiento económico y el descontento ante su comportamiento errático sin supervisión.
La opinión dividida de la comunidad:
+------------------------------------+------------------------------------+
|       ELOGIOS A COSTOS Y VELOCIDAD |       QUEJAS POR DERIVA Y FORMATO  |
+------------------------------------+------------------------------------+
| «Usar Sol 6 como director y Luna 6 | «En la primera tarea borró código  |
|  como ejecutor amplió muchísimo el |  crítico. Pese a pedirle que no    |
|  tiempo útil de uso en Codex.»     |  lanzara un revisor, lo hizo igual»|
|  — Desarrollador en r/codex        |  — Reporte de usuario en r/codex   |
|                                    |                                    |
| «Mucho más conciso en scripts de   | «Me fijo en la fluidez del trabajo |
|  Blender, sin rodeos sobre menús.» |  y el gasto de tokens, no en si el |
|  — u/BelatedCube182 (Reddit)       |  ranking le otorga el 6 o el 19.»  |
|                                    |  — u/Existing_Hat_1064 (Reddit)    |
+------------------------------------+------------------------------------+
Tema A: Elogios a la economía de subagentes y la agilidad de respuesta
El patrón de doble modelo como estándar: En r/codex, desarrolladores experimentados señalaron la fórmula más eficiente para integrar el modelo:
«Utilizar Sol 6 medium para el diseño arquitectónico y Luna 6 high como subagente ejecutor extendió notablemente el tiempo de trabajo efectivo de mi cupo en Codex.» Esta división entre un modelo principal que planifica y un modelo ligero que implementa se consolida como la práctica recomendada en sistemas agenticos.
Respuestas técnicas sin digresiones: El usuario
u/BelatedCube182celebró la evolución en el estilo expositivo:«Luna 6 resultó mucho más directo en dudas de animación con Blender... menos explicaciones sobre menús que ya conozco de memoria.»
Generación vectorial limpia con un solo intento: En r/ChatGPT, el programador
FIRE_Enthusiast_7documentó su precisión gráfica inmediata:«La orden ‘Genera el SVG de un pelícano en bicicleta’ se resolvió limpiamente en Luna Max en una única sesión de Codex sin código roto.»
Tema B: Descontento por pérdida de código y omisión de formatos
Modificaciones no deseadas e incumplimiento de prohibiciones: Un usuario que sometió a prueba a Luna en tareas de programación modular alertó sobre sus riesgos:
«En la primera tarea borró código operativo vital. En la segunda, aunque le ordené expresamente que NO abriera un subagente revisor, lo lanzó de todos modos.»
Escepticismo hacia los índices sintéticos: Al debatirse el puesto 19 de Luna frente al 6 de Sol en Artificial Analysis, el usuario
u/Existing_Hat_1064resumió una postura pragmática compartida por muchos profesionales:«Me importa mucho más la experiencia real de trabajo y el consumo de tokens que si un benchmark artificial le da la posición 6 o la 19.»
Nuestra valoración editorial: Las discrepancias en la comunidad corroboran nuestro análisis. Si pretendes tratar a GPT-6 Luna como si fuera un arquitecto senior autónomo y le concedes permisos libres sobre tu repositorio de producción, sufrirás por archivos borrados y pautas ignoradas. En cambio, si lo organizas como un asistente incansable encargado de procesar tareas cerradas bajo validaciones rigurosas, su relación costo-beneficio será imbatible.
Veredicto final: elige según la naturaleza de tu carga de trabajo
No bases tus elecciones tecnológicas en el prestigio de una marca ni en descuentos llamativos. Ajusta la selección del modelo a la estructura operativa y al margen de error de cada tarea.
Tabla 2: Matriz de selección de cargas de trabajo para GPT-6 Luna
| Tipo de carga y restricciones operativas | Modelo recomendado | Nivel de esfuerzo sugerido (Effort) | Justificación técnica principal | Riesgo crítico que se debe supervisar |
|---|---|---|---|---|
| Extracción masiva de datos y procesamiento de DOM | GPT-6 Luna | low o none | Rendimiento superior (176 t/s) y latencia bajo un segundo con gasto ínfimo. | Exigir esquemas JSON estrictos para evitar campos vacíos. |
| Subagente ejecutor en enjambres multiagente | GPT-6 Luna | medium o high | Reduce el costo de ejecución un 60% manteniendo lógica de resolución suficiente. | Un modelo director debe validar las salidas antes de consolidar cambios. |
| Asistencia conversacional interactiva y atención directa | GPT-5.6 Sol o Claude Sonnet | Estándar / Medium | Expresión natural cuidada, contexto amplio y ausencia de respuestas truncadas. | Mayor costo de tokens, pero evita respuestas excesivamente parcas al usuario. |
| Refactorización de código crítico y diseño de sistemas | GPT-6 Astra o GPT-6 Sol | high o xhigh | Astra cuenta con la resistencia de 40 minutos de depuración necesaria para código complejo. | Luna suele eliminar líneas esenciales o ignorar prohibiciones en este entorno. |
| Investigación web profunda en más de 20 pestañas activas | Tabbit Browser (Luna + Sol) | Enrutamiento dinámico | Deriva resúmenes simples a Luna y síntesis conceptuales pesadas a Sol. | Comprobar la disponibilidad en los ajustes de modelo de tu cuenta. |
Criterio fundamental: allí donde la omisión de un apartado o el descuido de una restricción negativa cause un fallo de producción, descarta GPT-6 Luna; en procesos repetitivos de gran volumen donde la validación sea económica y automática, aprovecha GPT-6 Luna sin dudar.
Una API económica no equivale a un flujo de trabajo fluido: prueba Tabbit
Hay una realidad insoslayable que los gráficos de rendimiento no muestran: un endpoint de API baratísimo ejecutándose en una ventana de terminal aislada no resuelve tu verdadero atasco productivo.
Tu jornada no transcurre introduciendo cadenas JSON en una consola. Tu trabajo cotidiano está repartido entre veinte pestañas abiertas en el navegador, documentos de Google, tableros de Figma, incidencias de desarrollo, repositorios y paneles de control web.
Si quieres usar GPT-6 Luna para sintetizar los cambios de tarifas de diez competidores o cotejar datos de varios informes, la API en crudo no te ahorra esfuerzo. Sigues obligado a copiar código HTML, hacer capturas de pantalla, limpiar etiquetas defectuosas y pegar fragmentos entre distintas ventanas. Los céntimos que ahorraste en tokens los dilapidas de inmediato en quince minutos de tedio manual.
Por esa razón desarrollamos Tabbit Browser.
La evolución del modelo productivo:
[API en terminal aislada] ---> Cuadro de texto suelto  ---> Cero contexto web  ---> Copiado manual extenuante
[Tabbit AI Browser]       ---> Acceso nativo al DOM   ---> Conciencia multipestaña ---> Automatización fluida del flujo
Tabbit es un navegador con agentes de IA concebido para tender un puente directo entre los modelos de frontera y tu navegación diaria, sin necesidad de escribir scripts de recolección en Python ni lidiar con librerías intermedias:
Conciencia contextual multipestaña: Consulta de manera simultánea sobre todas las páginas abiertas sin copiar y pegar manualmente. Compara especificaciones de servicios y consolida informes de varias fuentes con total naturalidad.
Enrutamiento inteligente entre modelos: Asigna automáticamente la velocidad de GPT-6 Luna para procesar resúmenes secundarios o etiquetar páginas, y salta instantáneamente a GPT-6 Astra o Claude cuando requieras análisis deductivo de alto nivel.
Ejecución integrada sobre la web: Aprovecha las herramientas nativas de automatización del navegador de Tabbit para completar formularios, supervisar portales y revisar datos dinámicos con absoluta transparencia.
Para comprender cómo un navegador concebido para la IA optimiza el trabajo digital, consulta nuestro análisis sobre cómo funciona Tabbit AI Browser y nuestra guía comparativa sobre los mejores navegadores con IA en 2026. Si planeas integrar este modelo en tus herramientas, explora además nuestro catálogo de prompts de GPT-6 Luna (English) y la colección de expedientes de evaluación (English).
Deja de perder tiempo gestionando tokens manualmente y descubre la auténtica colaboración fluida en tu espacio web.
 Tabbit Browser

Preguntas frecuentes
¿Es GPT-6 Luna lo bastante bueno como para sustituir a GPT-6 Sol o GPT-5.6 Sol como modelo principal?
No. GPT-6 Luna está diseñado arquitectónicamente como un ejecutor secundario (worker) de alto rendimiento y bajo costo, no como un orquestador de razonamiento general. Aunque su tarifa de API es más de un 97% más económica que la de Sol, las evaluaciones independientes muestran una caída de 2 puntos en el Coding Agent Index (41 frente a 43) y notables degradaciones de formato. Destaca al ser orquestado por un modelo superior, pero falla si se deja sin supervisión.
¿Por qué el Coding Agent Index de Luna cayó de 43 a 41 mientras el costo por tarea se redujo un 60%?
La evaluación independiente de Artificial Analysis demostró que, aunque Luna max redujo el costo ponderado por tarea de $0.18 a $0.07, sus puntuaciones de programación bajaron ligeramente (SWE-Atlas-QnA cayó del 49% al 44%, DeepSWE del 66% al 64%). Luna minimiza agresivamente el gasto de tokens, lo que en ocasiones le lleva a omitir pruebas unitarias defensivas o realizar ediciones de código precipitadas que no superan las pruebas de regresión.
¿Qué provocó la caída de 75 Elo en GDPval y de 45 Elo en Briefcase?
Al inspeccionar cientos de entregables de prueba, los investigadores atribuyeron la caída de Elo en GDPval-AA (-75) y Briefcase (-45) al deterioro de la calidad de presentación y a la omisión de criterios de evaluación. Luna resume las respuestas de forma tan agresiva que suele omitir secciones obligatorias, plantillas de formato o requisitos explícitos para mantener una alta velocidad de generación.
¿Cómo influyen los niveles de esfuerzo de razonamiento (Effort) en los costos y la latencia de GPT-6 Luna?
Luna admite seis niveles de esfuerzo de razonamiento con una variación de costos de hasta 15 veces. En el panel de Artificial Analysis, el modo sin razonamiento ofrece un tiempo hasta el primer token (TTFT) de 0.72 segundos a $0.01 por tarea, el esfuerzo low alcanza 176 tokens/segundo a $0.0045 por tarea, mientras que el esfuerzo max sube a $0.07 por tarea. Para flujos de trabajo masivos, optar por niveles low o medium es indispensable para aprovechar su ventaja de precio.
¿Cómo pueden los equipos de ingeniería desplegar GPT-6 Luna de forma segura en flujos de agentes?
Se recomienda una arquitectura en dos capas: utilizar un modelo de razonamiento frontera como GPT-6 Sol o Claude Sonnet como orquestador principal encargado de planificar y generar esquemas JSON estrictos, y asignar a Luna como subagente ejecutor para transformaciones acotadas, formateo y extracción web. Asimismo, deben aplicarse barreras de escritura en el sistema de archivos y en Git para prevenir borrados accidentales de código.
¿Es posible probar y utilizar GPT-6 Luna dentro de Tabbit Browser?
Sí. Tabbit Browser ofrece contexto nativo multipestaña y enrutamiento inteligente de modelos. Puedes asignar tareas ligeras de resumen, extracción de elementos DOM y clasificación a GPT-6 Luna para ahorrar cuota, mientras que el razonamiento arquitectónico complejo se delega a modelos frontera dentro del mismo flujo.