对话模式顺的时候
实测者描述回复更生动、对话更即兴,角色活在当下,而不是在叙述自己的选择。
DeepSeek V3.2 · 角色扮演实测指南
DeepSeek V3.2 已经成为许多 SillyTavern 用户的日常对话模型,但角色扮演的表现因模式而异。社区实测者反馈:对话(非思考)模式在角色中往往更自然、更有乐趣,而思考模式擅长规划,却可能显得过分刻意。在投入长聊之前,先跑一个短测试。
社区反馈是体验,不是跑分。本页不提供越狱或绕过安全控制的方法。
用户真实反馈
被引用最多的实测用五张角色卡、240 条消息对比了两种模式。帖子里呈现的规律是:自然感和乐趣通常是非思考模式胜出;思考模式则容易出现刻意感。
实测者描述回复更生动、对话更即兴,角色活在当下,而不是在叙述自己的选择。
面对密集的情节编排或长线规划,部分用户更偏爱思考模式。它能把后果梳理清楚,但有时会用分析盖过场景本身。
一条高赞评论把推理模型形容成"聪明但神经质的演员":恰好在对真实对话最需要即兴的地方过于刻意。
有用户觉得非思考的 DeepSeek 承载设定和 lore 更自然。他们自己强调这只是体感,需要再测,而不是测量结论。
15 分钟评测
照搬社区方法:同一张卡、同一段开场、只变一个变量。给回复为场景做了什么打分,而不是看某一段写得多漂亮。
写下五个事实:角色目标、语气、当前地点、刚发生的变化、一条禁止假设。要求输出 250 到 450 字,并推动一个改变场景的动作。
用完全相同的开场,先跑非思考模式,再开思考模式各试一次。在改动其他任何设置之前,每个分支先续聊两轮。
即兴感、情节推进、指令保持、重复控制各给 0、1 或 2 分。记录思考模式在哪加了规划、又抽走了存在感。
每次只改一条提示词规则或设置。如果四个分数没有变化,就回退它,而不是继续叠指令。
SillyTavern 路径
SillyTavern 提供角色卡、lorebook、预设和群聊。endpoint 和前端各自有各自的坑。
预设名字是社区约定。文件找作者要,并留意许可。预设不是万能解。
DeepSeek 会原地升级 API 模型名,请以官方 API 文档当前列出的对话模型标识为准,不要自行拼接版本字符串。
把角色事实和场景状态写进角色卡或系统提示。任何思考模式的指令,都要先和干净的对照分支对比再采信。
开一条思考关闭的分支和一条开启的分支。记录延迟、长度和场景推进。不要把隐藏推理当作质量保证。
加一条简短的输出规则,例如"用一个具体变化推进场景;不要重复最近两轮出现过的感官细节",然后验证模型是否遵守。
浏览器路径
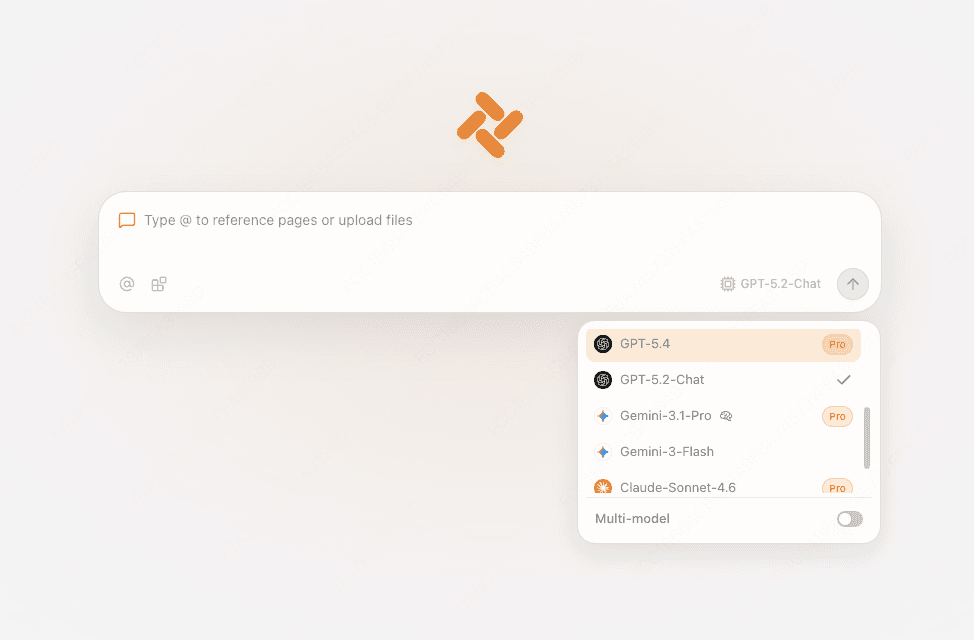
Tabbit 把浏览器和对话放在一起。在版本支持的条件下,在产品内的模型选择器里选 DeepSeek V3.2,再把角色 wiki、设定表或写作参考带进对话。
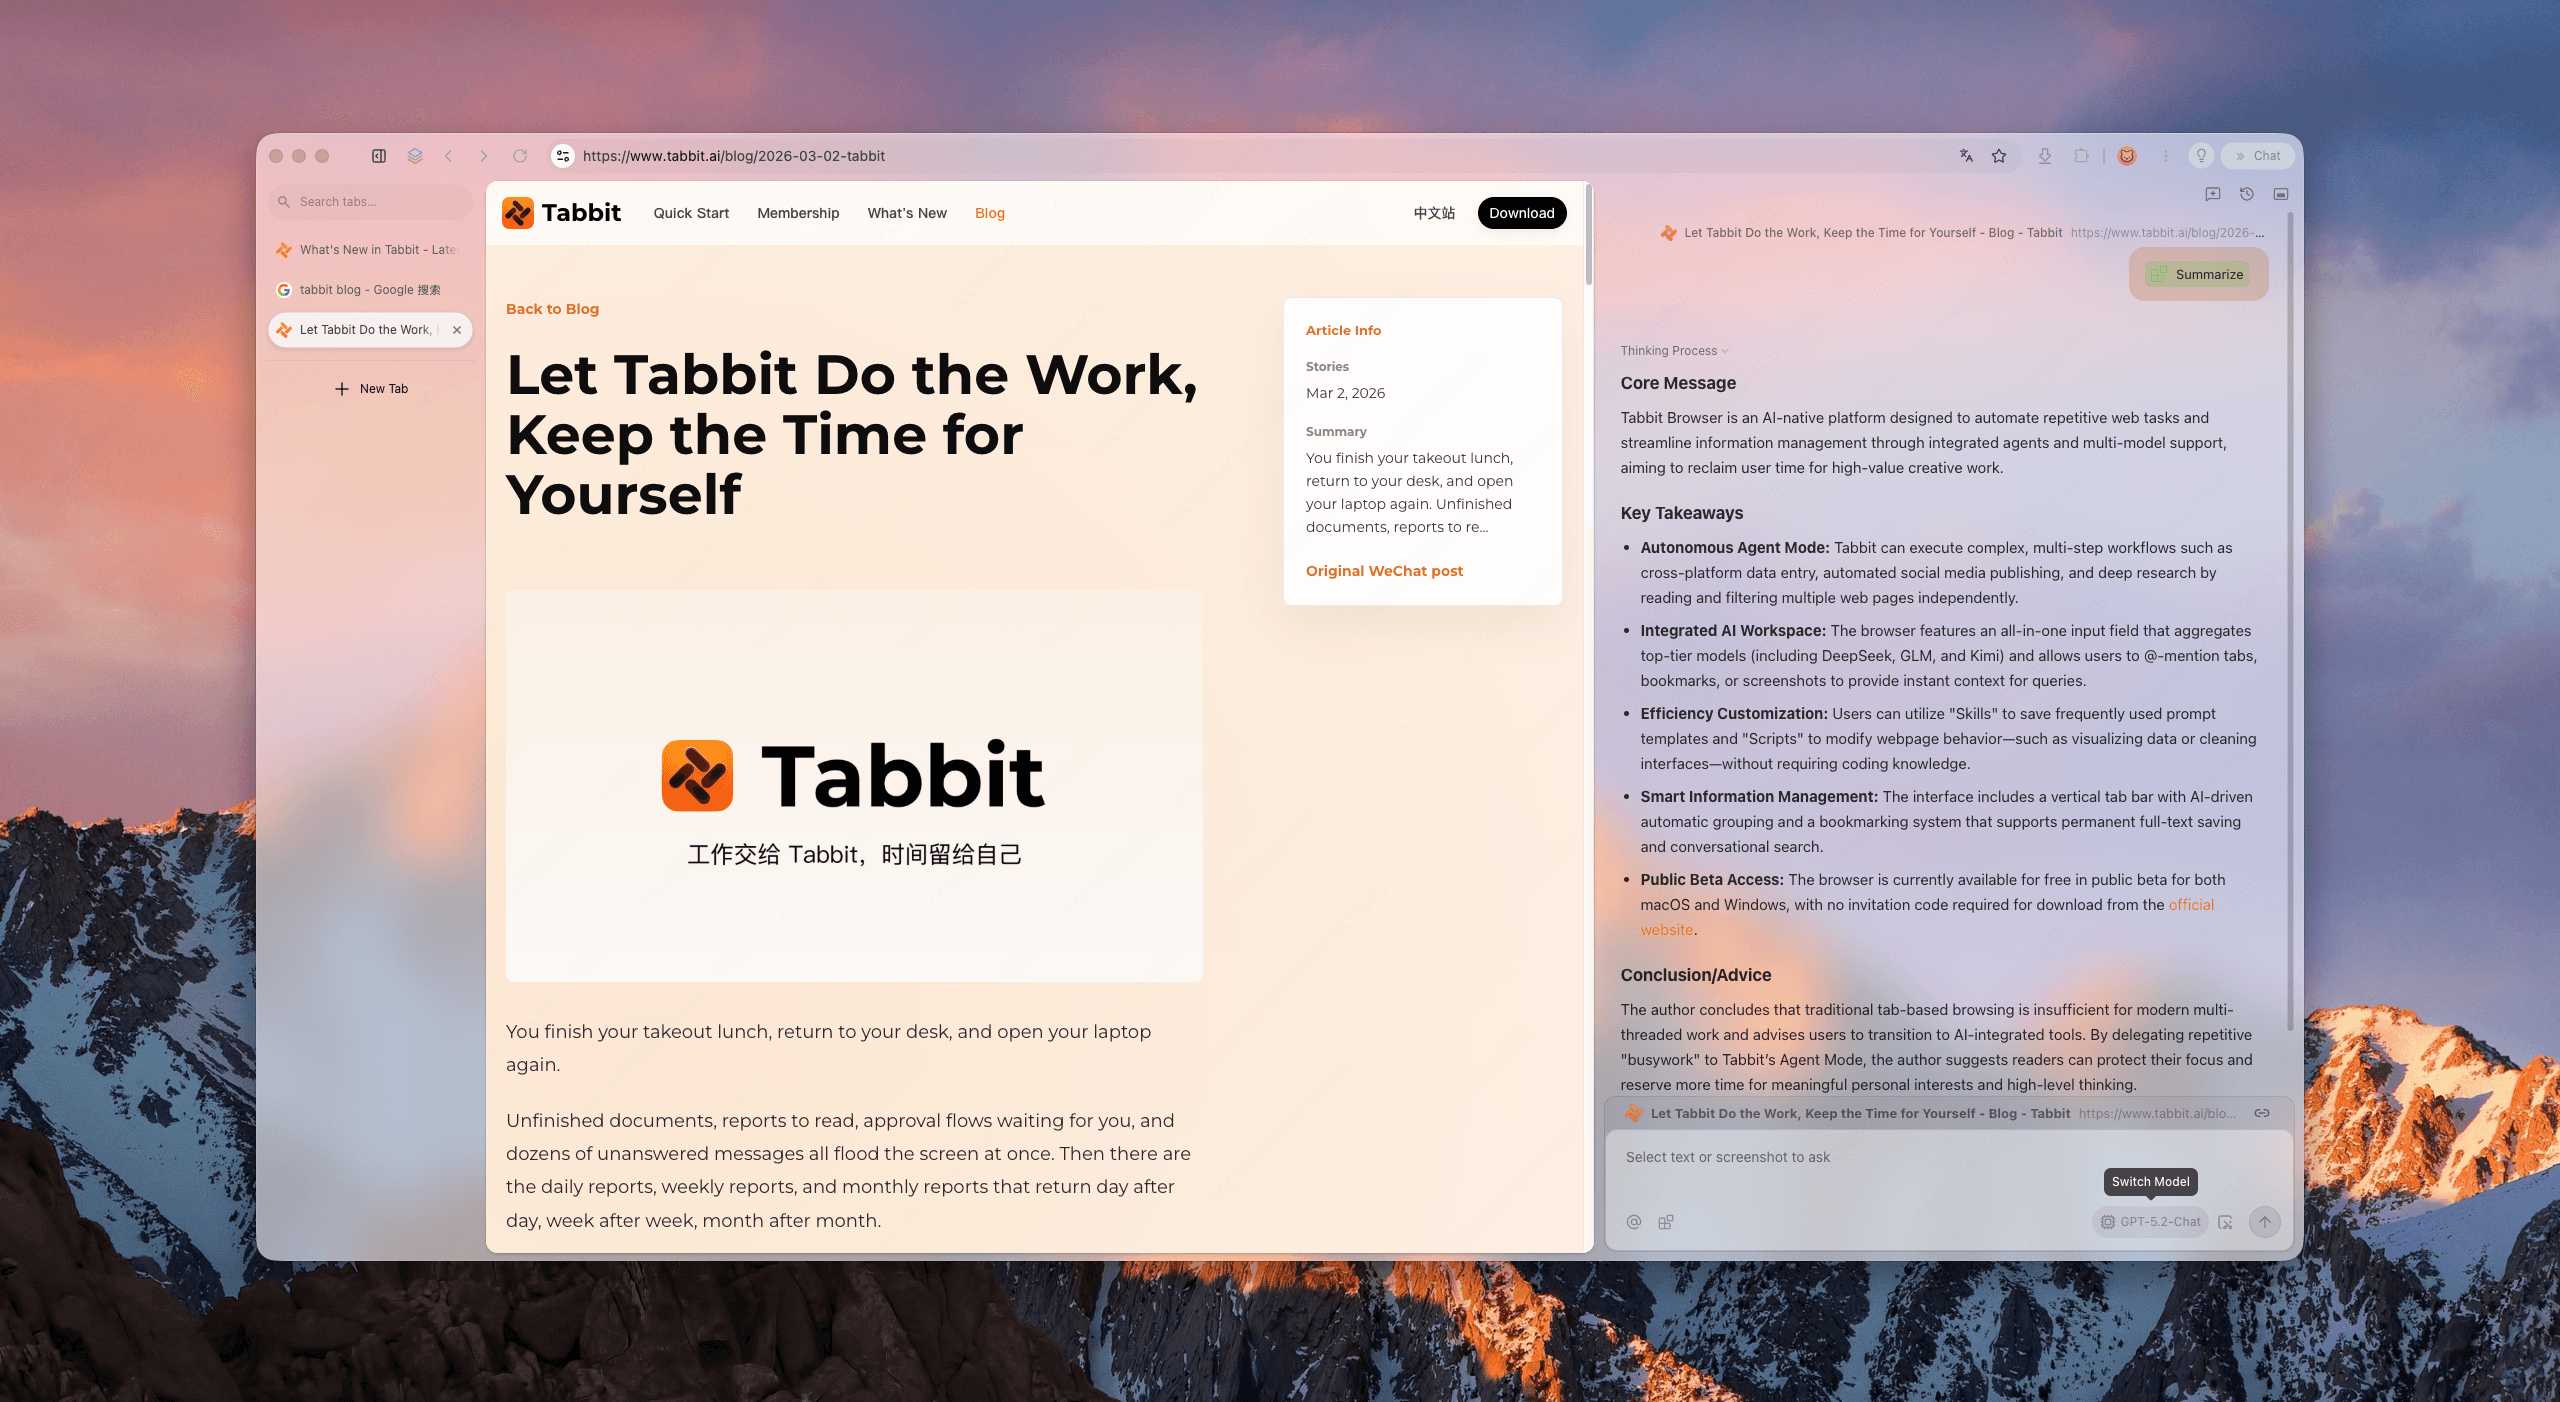
把角色卡、lore 页面或你自己的场景大纲留在标签页里。直接对着页面工作,不用把段落逐段复制进聊天框。
打开 Tabbit 的模型选择器,如果列表中有 DeepSeek V3.2 就选它。可用性随版本、地区、账号和灰度而变化。
输入 @ 引用打开的标签页、截图或文件。可以要求续写一段场景、做一次一致性检查,或在不违背页面事实的前提下改写。
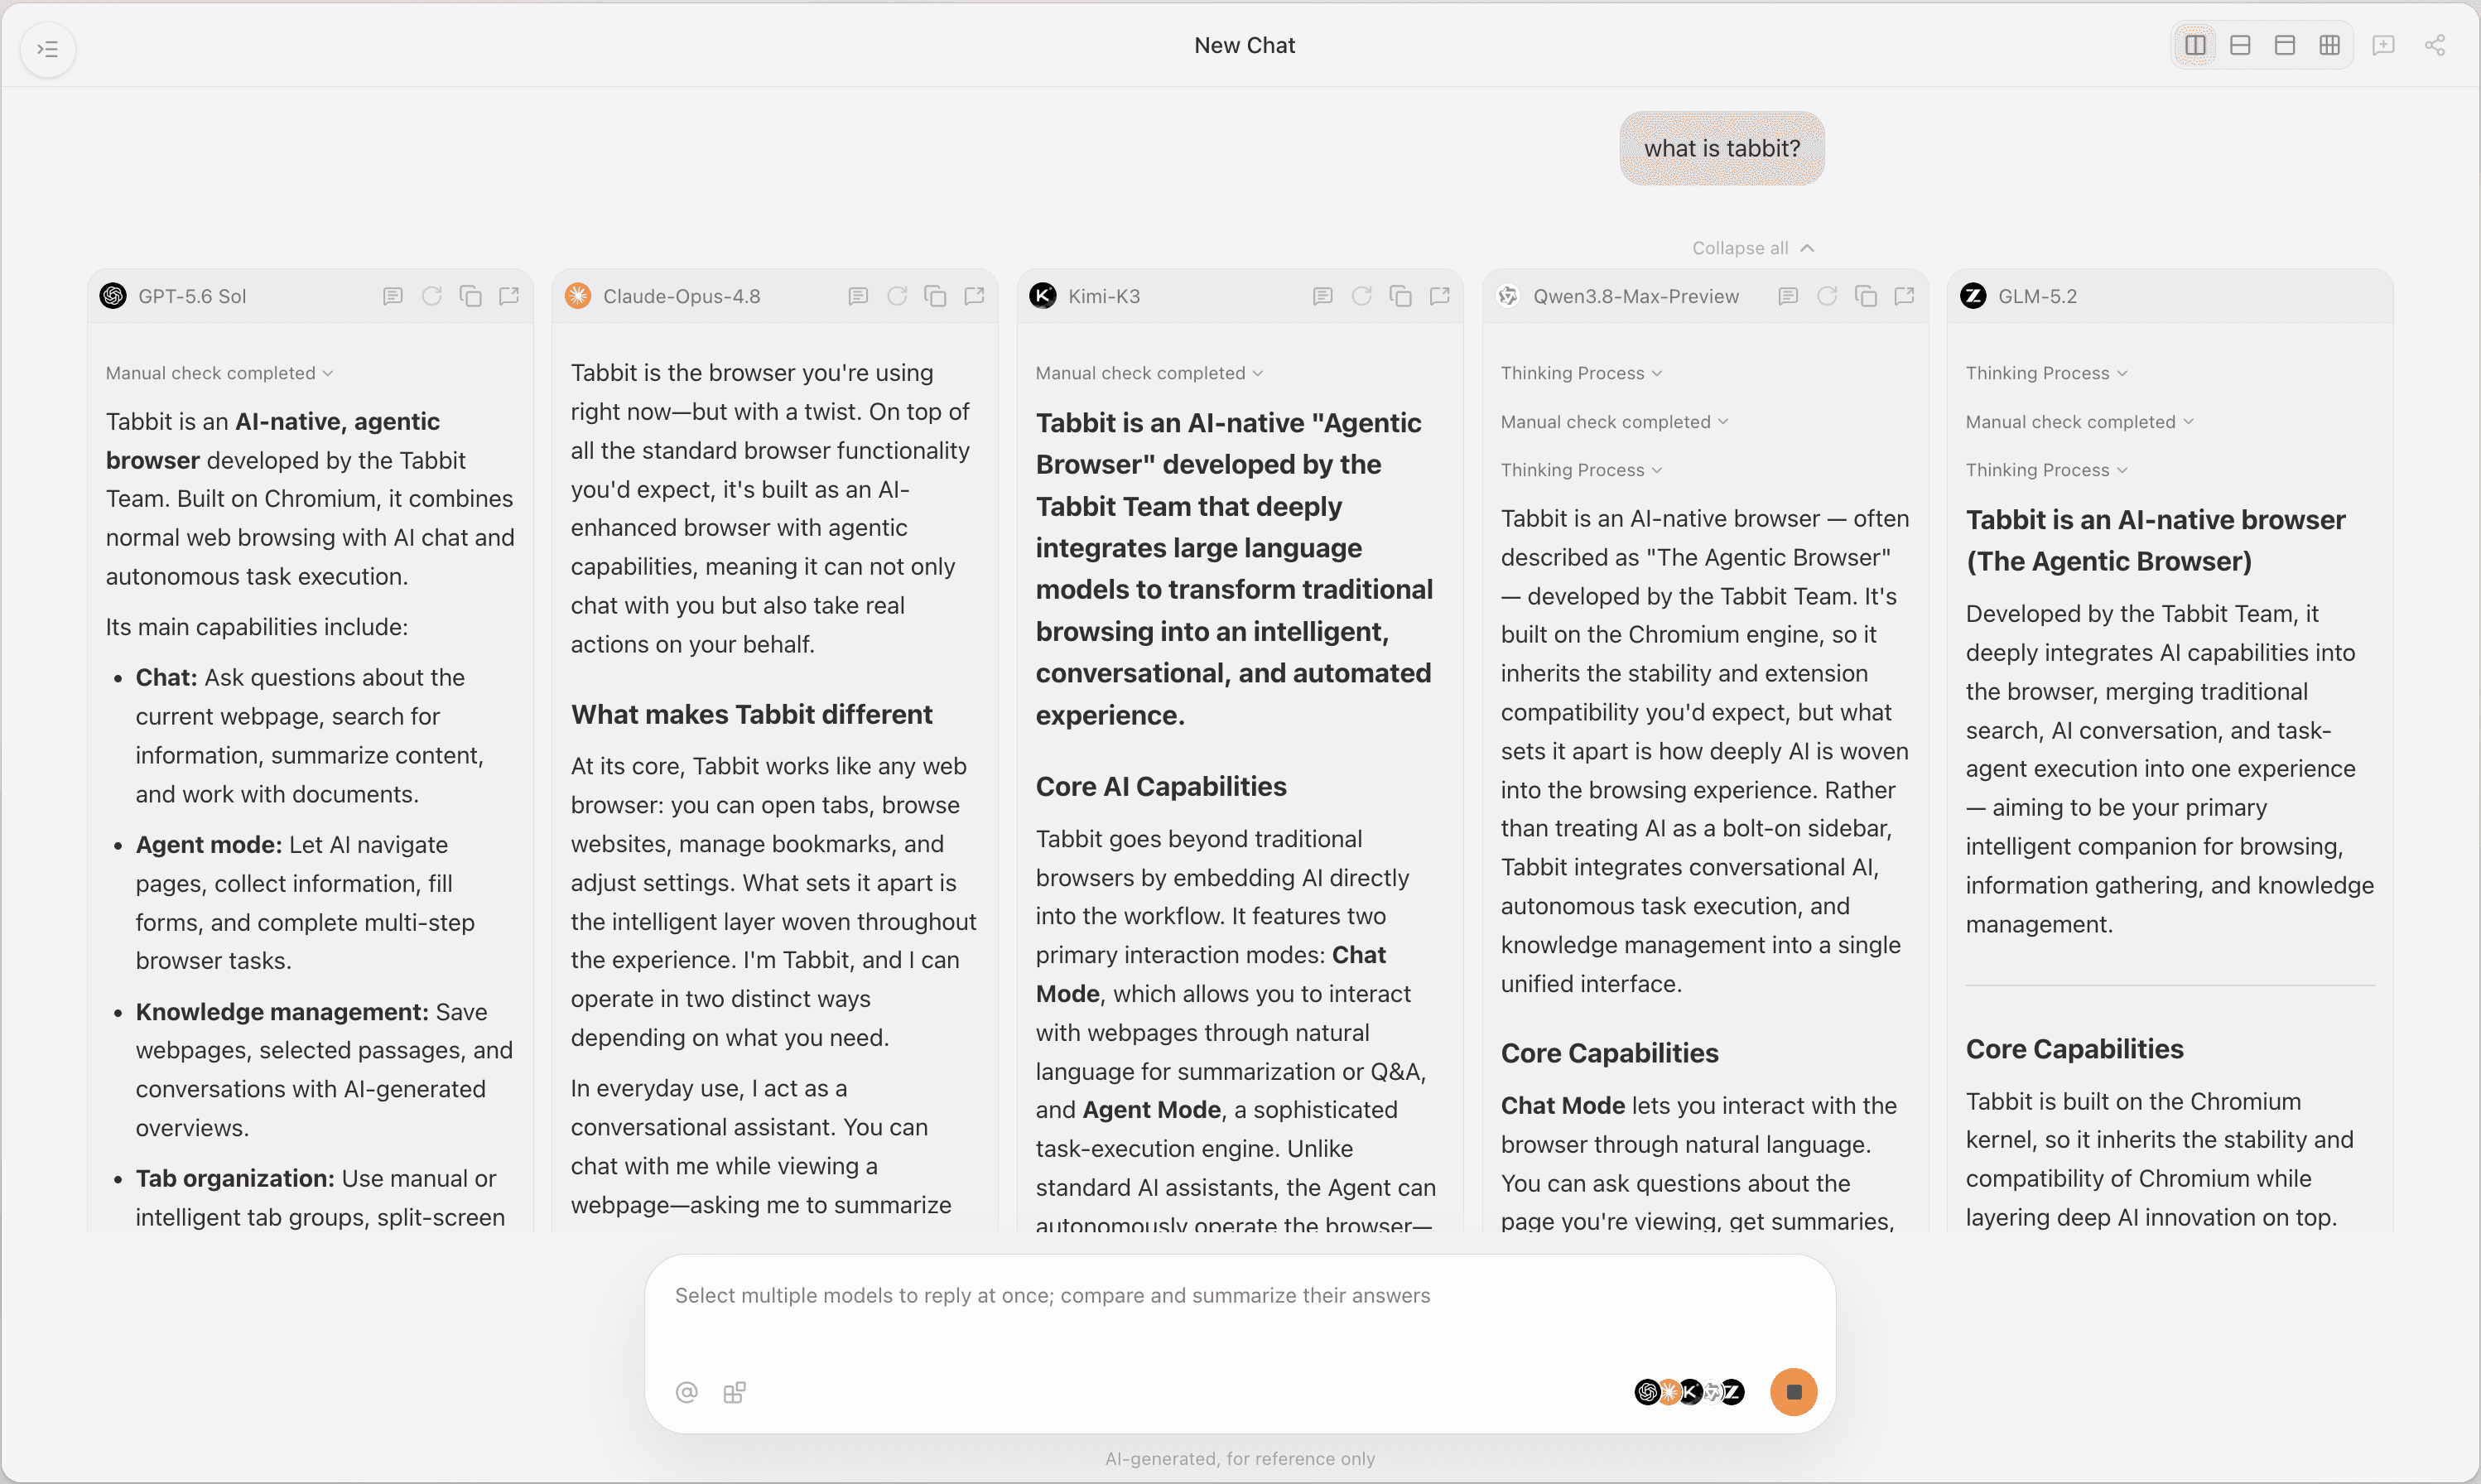
用多模型对话把同一段提示交给另一个模型,为语气或场景推进获取第二意见。
选对前端
两者解决的是工作流的不同部分。SillyTavern 是专门的 RP 驾驶舱;当角色素材本来就散落在网页和文件里时,Tabbit 更顺手。
| 需求 | SillyTavern | Tabbit |
|---|---|---|
| 角色卡和 lorebook | 原生支持 | 引用页面或文件 |
| 预设和提示词控制 | 深度控制 | 系统提示和 Skills |
| RP 旁边查网页 | 靠扩展或复制粘贴 | 打开的标签页用 @ 变成上下文 |
| 思考与对话分支对比 | 预设和 API 设置 | 浏览器内多模型对话 |
| 首次上手 | 前端、endpoint、key、预设 | 安装后看模型选择器 |
Tabbit
对比分支
01
把角色卡、lore 页面或你自己的场景大纲留在标签页里。直接对着页面工作,不用把段落逐段复制进聊天框。
02
浏览器内多模型对话
03
输入 @ 引用打开的标签页、截图或文件。可以要求续写一段场景、做一次一致性检查,或在不违背页面事实的前提下改写。
保持诚实
帖子混合了版本、预设、思考设置、角色卡和个人口味。把它们当作你自己受控测试的假设。
推理和 agent 分数衡量不了你的卡里的角色语气、节奏、幽默或一致性。跑分结论和 RP 体感要分开看。
角色扮演指南可以讨论边界和提示词行为,但不帮助规避安全系统。请写清楚、合法的场景边界。
Tabbit 的模型选择器是可用性的唯一事实来源。本页不承诺每个版本和账号都能看到 DeepSeek V3.2。
看原始证据
上面的观察来自公开的社区讨论和官方文档。打开来源可以看到完整语境。
常见问题
社区反馈混合但可用:对话(非思考)模式常被形容为在角色中更即兴、更有乐趣;思考模式规划更好但容易显得刻意。先在自家卡上跑三遍测试再下结论。
大多数日常和成熟主题的场次,实测者偏向非思考。长线剧情或复杂世界状态时,开思考模式,用同一段开场对比两个分支。
取决于角色卡、预设和模式。有用户觉得 V4 更快、更会推进场景,但 V3.2 在 RP 前端上依然流行。用同一场景亲测两个模型,比信任何单一排名可靠。
使用 OpenAI 兼容的 Chat Completions endpoint,在 DeepSeek API 文档确认当前模型名,角色事实写进角色卡或系统提示,并把思考模式开和关当作两个独立分支测试。
DeepSeek V3.2 已列入 Tabbit 支持的模型目录。打开产品内的模型选择器,确认你的版本和账号是否可用。
角色页面保持打开,选好模型,一口气跑完思考与非思考的分支对比。
macOS 和 Windows 免费下载。