
Claude Fable 5.1 coûte 10 dollars par million de tokens d'entrée et 50 dollars par million de tokens de sortie sur l'API Anthropic, avec des lectures de cache à 0,25 dollar par million — tous les tarifs vérifiés sur la documentation tarifaire d'Anthropic le 22 septembre 2026. Voilà la grille tarifaire, et elle est presque ennuyeuse : sur cinq lignes de tokens, quatre n'ont pas bougé depuis Fable 5. La facture est un autre objet. Sur la même grille, Artificial Analysis mesure une tâche de benchmark à 2,37 dollars en effort faible et 7,63 dollars au maximum — une amplitude de 3,2x sans toucher une seule ligne de prix — et une autre mesure indépendante place Fable 5.1 à 18 % plus cher par tâche que Fable 5, malgré la promesse de lancement « jusqu'à 45 % moins cher ».
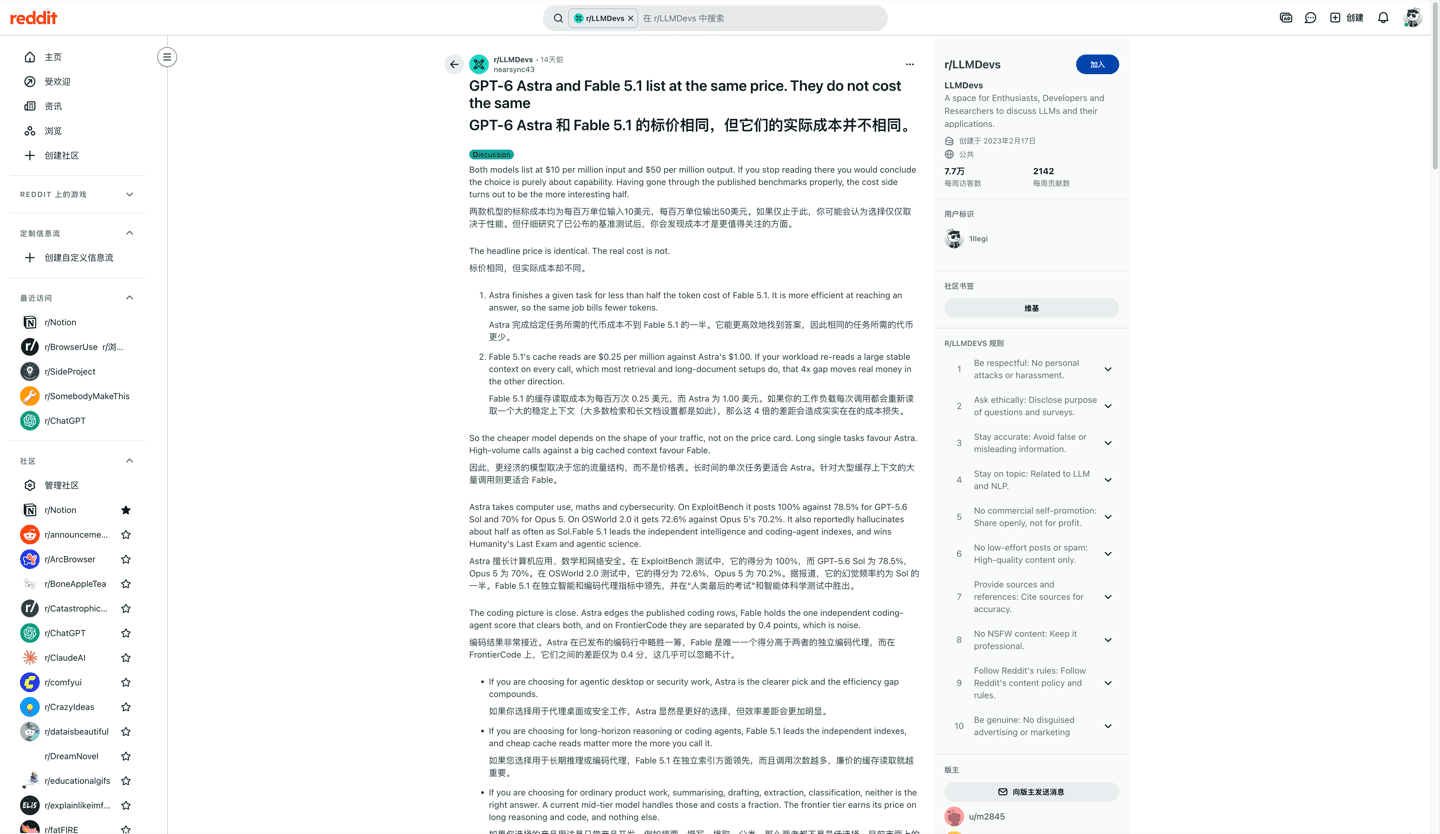
Ces deux phrases sont vraies, et l'écart entre elles est la raison d'être de cet article. Un post r/LLMDevs l'a formulé exactement : GPT-6 Astra et Fable 5.1 « sont affichés au même prix. Ils ne coûtent pas la même chose » — car la forme de votre trafic, pas l'étiquette, décide de la facture (r/LLMDevs). Cette page est le volet argent de notre panorama Claude Fable 5.1 et de sa review ; plus loin, Tabbit Browser apparaît comme un endroit pratique pour exécuter ces comparaisons une fois le budget posé. D'abord, les chiffres.
Points clés
La grille tarifaire : 10 dollars d'entrée, 0,25 de lecture de cache (0,025x — une exception pour toute la famille), 12,50/20 dollars d'écriture de cache (5 min/1 h), 50 de sortie par million de tokens. Batch divise tout par deux ; l'inférence US-only ajoute 1,1x à chaque ligne.
Une ligne a changé, tout le reste est la forme de la facture. Les lectures de cache ont chuté de 75 % par rapport au dollar de Fable 5. Anthropic estime des économies typiques d'environ 25 % et agentiques jusqu'à 45 % ; les mesures indépendantes ont réalisé 15–30 %, et une construction communautaire soigneusement documentée a coûté 2,4x plus cher que sur Fable 5.
L'effort est le plus grand levier contrôlable. L'échelle d'AA va de 2,37 à 7,63 dollars par tâche entre effort faible et maximal, pour 6 points d'intelligence. Fable est en High par défaut dans Claude Code et en Medium ailleurs — vérifiez ce que vous payez réellement.
Pas de falaise de contexte long. La fenêtre complète d'un million de tokens est facturée au tarif standard — à la différence de phares qui reTarifient les prompts longs — mais le nouveau tokenizer produit environ 30 % de tokens en plus à texte égal.
Les abonnements sont une autre économie. Fable n'est pas sur Free ; Pro/Max le mesurent en crédits d'usage à 50 % des limites hebdomadaires dans des fenêtres glissantes de 5 heures. Enterprise est à 20 dollars par siège plus l'usage aux tarifs API.
Les prix de Claude Fable 5.1 en un coup d'œil
La grille tarifaire standard complète, relevée sur la documentation tarifaire d'Anthropic le 22 septembre 2026. Mythos 5.1 — les mêmes poids derrière un programme d'accès restreint — est affiché à l'identique mais n'est pas achetable en général ; le panorama couvre cette lignée.
| Modèle | Entrée / 1M | Écriture 5m / 1M | Écriture 1h / 1M | Lecture cache / 1M | Sortie / 1M |
|---|---|---|---|---|---|
| Claude Fable 5.1 | $10,00 | $12,50 | $20,00 | $0,25 | $50,00 |
| Claude Fable 5 | $10,00 | $12,50 | $20,00 | $1,00 | $50,00 |
| Claude Opus 5 | $5,00 | $6,25 | $10,00 | $0,50 | $25,00 |
| Claude Sonnet 5 | $2,00 | $2,50 | $4,00 | $0,20 | $10,00 |
| Claude Haiku 4.5 | $1,00 | $1,25 | $2,00 | $0,10 | $5,00 |
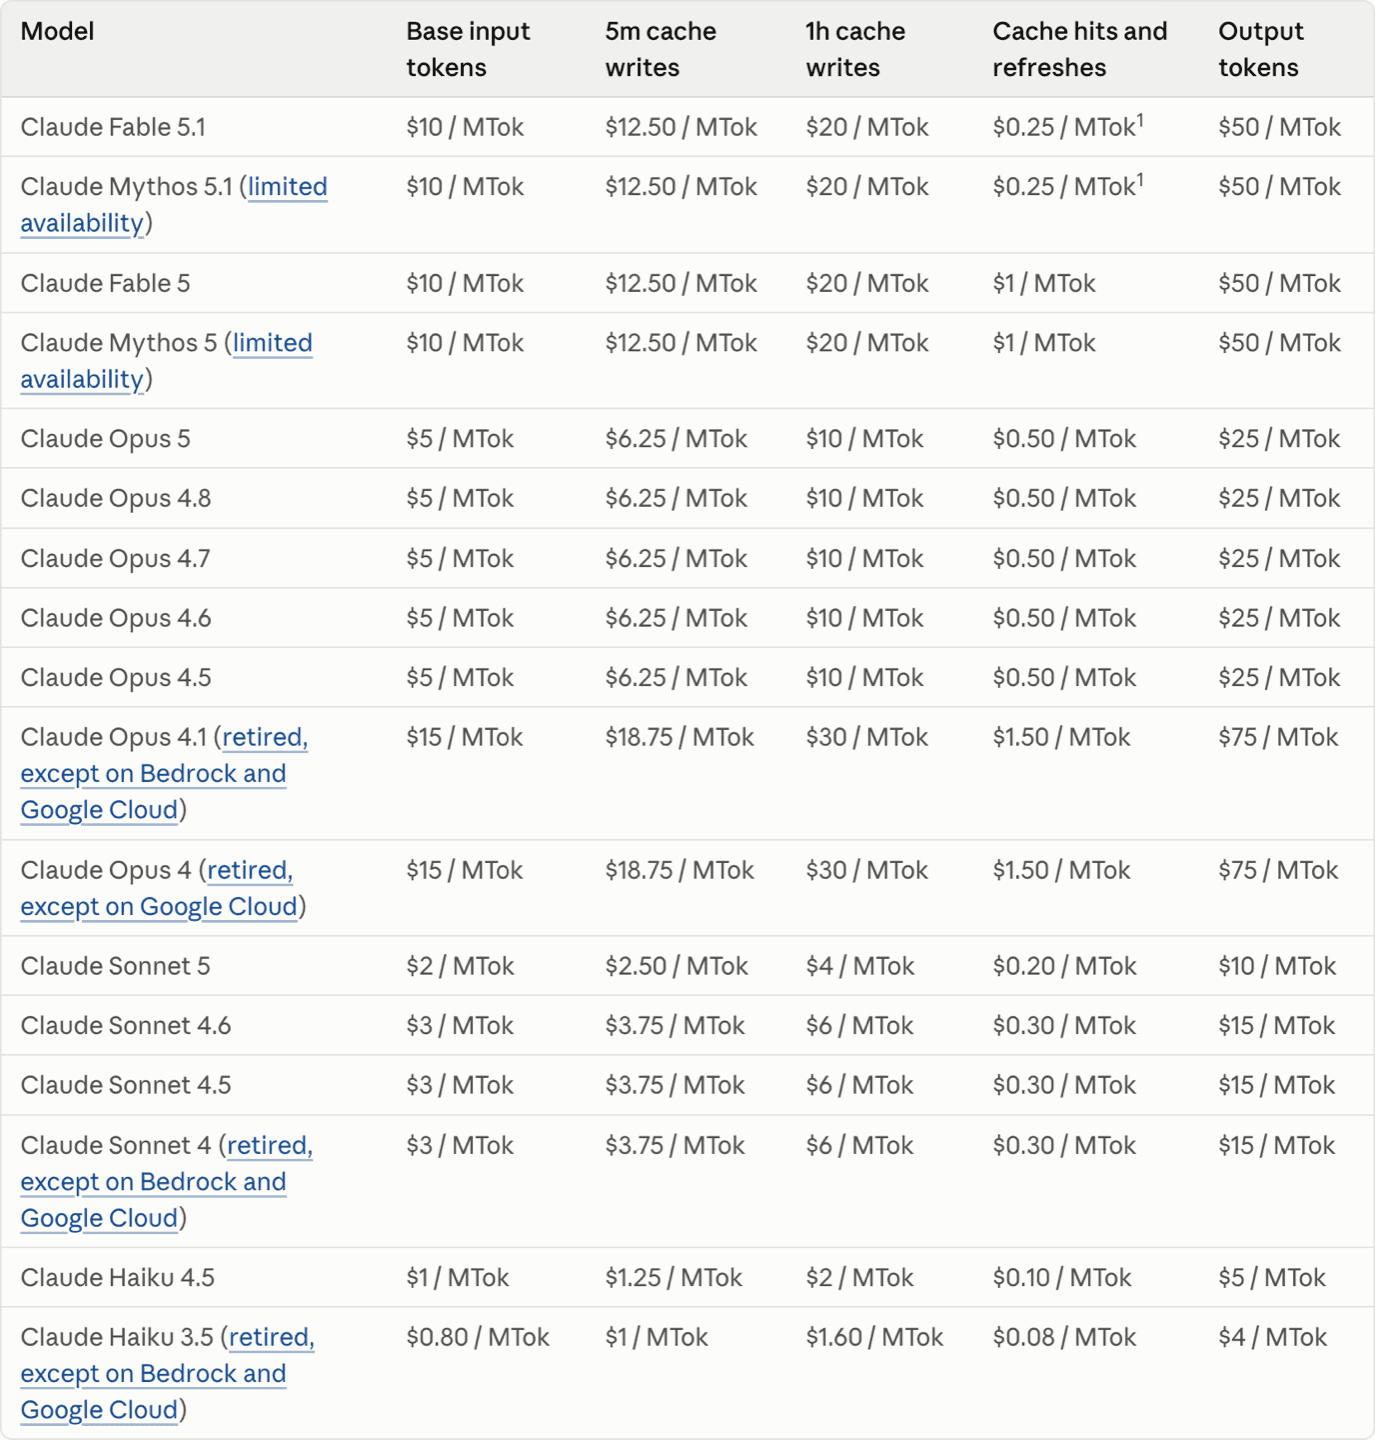
Trois choses dans ce tableau font les dégâts, et aucune n'est le 10 du titre :
La sortie coûte 5x l'entrée. Fable est un modèle de raisonnement adaptatif ; il pense en tokens de sortie facturables. Un prompt modeste avec une longue chaîne de raisonnement est une facture de sortie déguisée en entrée.
Écrire dans le cache coûte plus cher que l'entrée. 12,50 dollars, soit 1,25x le tarif de base pour une entrée de 5 minutes ; 20 (2x) pour une heure. Le cache s'amortit après une lecture de 5 minutes ou deux d'une heure — mais seulement si le préfixe est vraiment réutilisé.
Le tokenizer a changé sous vos pieds. Les modèles Claude 4.7 et suivants utilisent un tokenizer qui produit environ 30 % de tokens en plus pour le même texte, selon la propre note d'Anthropic. Comparer des prix par token aux modèles de l'ère Sonnet 4.6 sans cette correction surestime d'un tiers le coût de l'ancien modèle.
À épingler aussi : la fenêtre complète d'un million de tokens est facturée au tarif standard — « une requête de 900k tokens est facturée au même tarif par token qu'une requête de 9k », selon Anthropic. À la différence de la falaise 272K de GPT-6 Astra, où franchir un seuil re-tarife toute la requête, Fable n'a aucun palier de contexte long.
Le chiffre qui a changé : les lectures de cache ont chuté de 75 %
Le cache de prompts est la seule ligne qui a bougé entre Fable 5 et Fable 5.1, et elle mérite d'être comprise mécaniquement, car c'est la ligne sur laquelle vivent vos boucles d'agents.
Quand une requête répète un préfixe déjà traité — prompt système, contexte de dépôt, historique de conversation, définitions d'outils — l'API peut lire ce préfixe depuis le cache au lieu de le retraiter. Les écritures coûtent 1,25x l'entrée de base pour une entrée de 5 minutes, 2x pour une heure. Les lectures coûtent normalement 0,1x. Fable 5.1 (et Mythos 5.1) sont l'exception de toute la famille : les lectures coûtent 0,025x — 0,25 dollar par million — et la note d'Anthropic le marque explicitement. Ces multiplicateurs se cumulent avec la remise Batch et les prix de résidence des données.
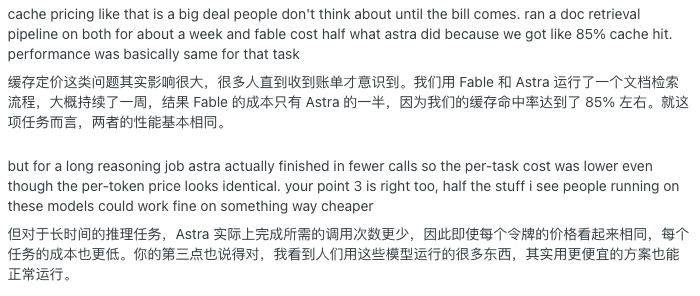
Pourquoi cela domine les factures d'agents : un agent qui fait 40 appels d'outils sur un contexte de 200 000 tokens relit ce préfixe 40 fois. Aux lectures à 1,00 dollar de Fable 5, ces relectures coûtent 8,00 dollars ; à 0,25 dollar sur Fable 5.1, elles coûtent 2,00 dollars — avant même de générer un seul token nouveau. Les chiffres de la communauté vont dans le même sens. Un développeur ayant fait tourner une semaine un pipeline de recherche documentaire à la fois sur Fable 5.1 et sur un concurrent à lectures de 1,00 dollar rapporte avoir payé environ moitié prix avec un taux de hits de cache de 85 % :
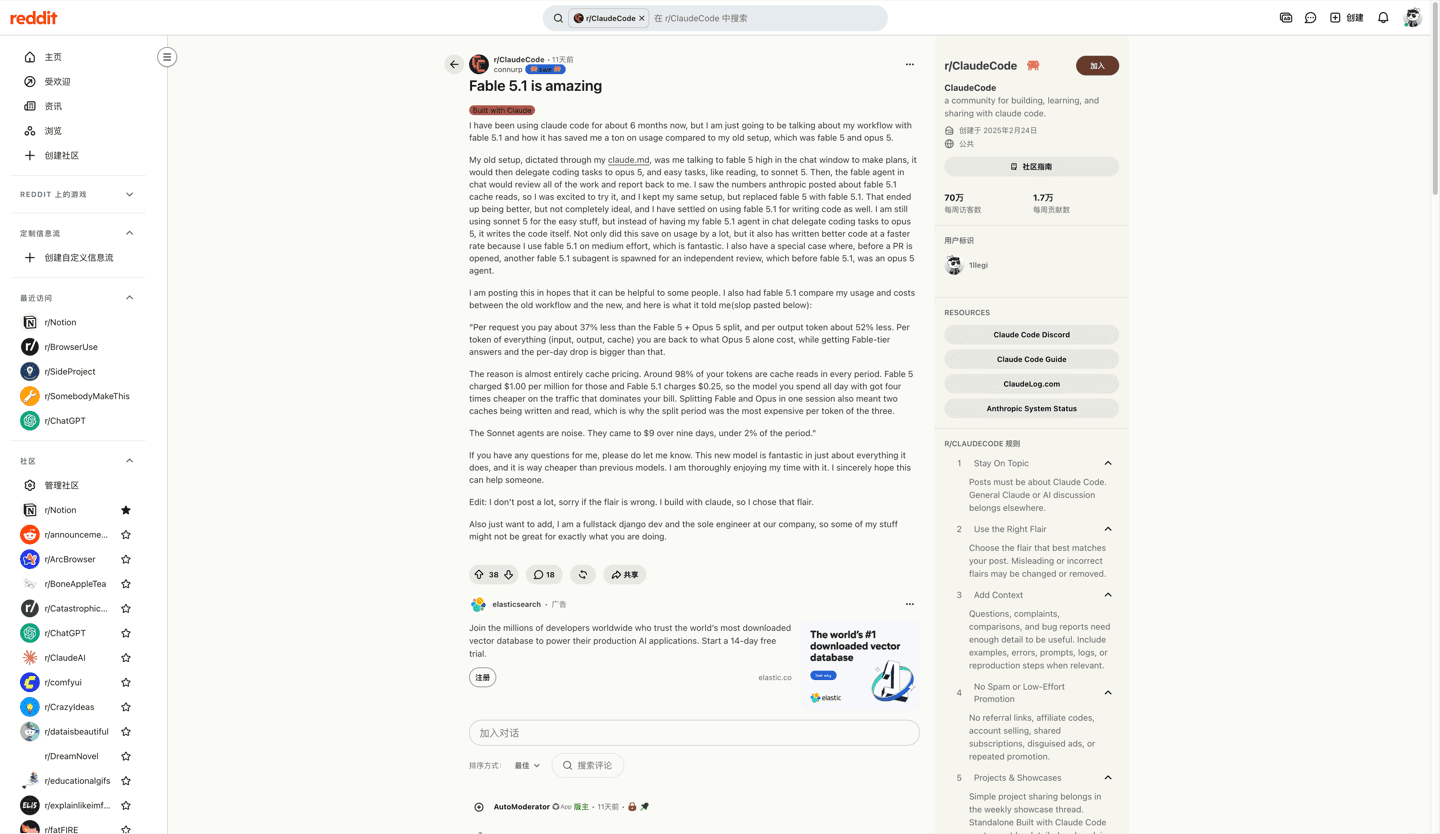
Et sur r/ClaudeCode, un développeur Django qui a remplacé un duo Fable 5 + Opus 5 par Fable 5.1 écrivant directement le code en effort Medium a calculé environ 37 % de moins par requête, et 52 % de moins par token de sortie — « la raison est presque entièrement le prix du cache », selon ses mots :
La condition dans les deux rapports : l'économie de cache exige un préfixe stable. Si votre contexte mute à chaque tour — sorties d'outils dynamiques, documents qui tournent — vous payez la pénalité d'écriture de 1,25x–2x à répétition au lieu de surfer sur les lectures à 0,025x. Ce mode d'échec est exactement ce que la section suivante mesure.
Ce que « jusqu'à 45 % moins cher » veut vraiment dire
La promesse de lancement d'Anthropic a des conditions précises, et les décortiquer fait la différence entre un budget et un vœu. Deux mises en garde avant de budgéter.
Mise en garde un : la base et les conditions. « Fable 5.1 coûtera environ 25 % de moins que Fable 5 pour les charges typiques, partout où l'usage est facturé au token… Pour le travail très agentique, l'économie sera souvent bien plus grande — jusqu'à environ 45 %. » La base est Fable 5, pas la concurrence. La promesse couvre l'usage facturé au token, et « très agentique » désigne les charges qui relisent de grands préfixes stables — la forme lecture-de-cache de la section précédente. Ce n'est pas un engagement sur votre facture par tâche accomplie.
Mise en garde deux : des mesures indépendantes ont trouvé la direction opposée. Artificial Analysis a mesuré Fable 5.1 consommant 140M de tokens de sortie sur son Intelligence Index contre 83M pour Fable 5, portant le coût par tâche en hausse de 18 % (3,14 → 3,69 dollars). La mesure sur 57 exécutions de Firecrawl (7 septembre 2026) a trouvé Fable 5.1 utilisant plus de tokens de sortie à tous les niveaux d'effort — 1,37x en faible, 1,12x en élevé, 1,30x au max — et des économies réalisées de 15–30 % de la facture, pas 25–45 %, « parce que les écritures de cache (d'une heure) coûtent 20 dollars par million et ne sont pas remisées ». Leur conclusion mérite citation : « Anthropic dit que Fable 5.1 est moins cher… Artificial Analysis a mesuré qu'il coûte 18 % de plus. Les deux ont bien mesuré. » Laquelle ressemble à votre facture dépend du token qui la domine.
La communauté a trouvé le mode d'échec en conditions réelles. Un développeur de r/ClaudeCode a passé le même prompt de construction aux deux modèles : Fable 5.1 a coûté 1 200 dollars là où Fable 5 en coûtait 500 — 2,4x — à tarifs affichés identiques :
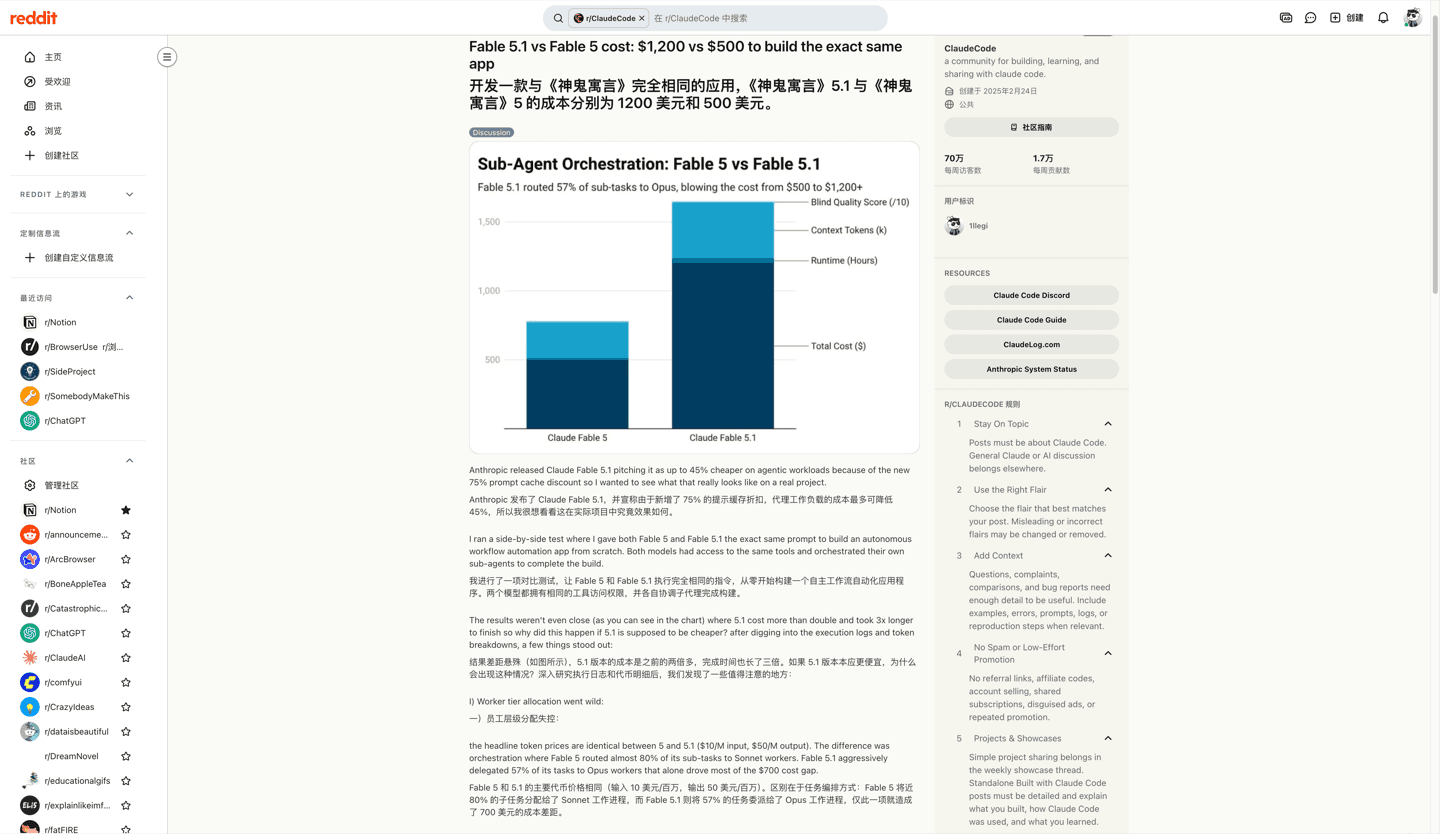
Son autopsie : Fable 5.1 a délégué 57 % des sous-tâches à des workers Opus (facturés aux tarifs Opus) là où Fable 5 routait 80 % vers Sonnet, et ses boucles de raisonnement ont gonflé le contexte actif au-delà de 404K tokens — « payer de lourdes pénalités d'écriture au lieu de profiter des lectures de cache bon marché ». La leçon n'est pas que Fable 5.1 est cher ; c'est que les paliers de délégation et le brassage de contexte sont des lignes de facturation qu'aucune grille tarifaire ne montre. Pour le volet capacités de ce compromis, voir la review et notre guide du raisonnement agentique.
Le levier d'effort : de 2,37 à 7,63 dollars par tâche
Fable 5.1 expose des niveaux d'effort de raisonnement adaptatif — et rien dans la grille tarifaire ne dit que ce curseur déplace le coût plus que n'importe quelle ligne de prix. Artificial Analysis le suit comme cinq entrées séparées ; instantané du 22 septembre 2026 :
| Effort | Intelligence Index | Coût par tâche II | Vitesse de sortie |
|---|---|---|---|
| low | 47 | $2,37 | 55 t/s |
| medium | 49 | $2,98 | 57 t/s |
| high | 51 | $3,91 | 56 t/s |
| xhigh | 53 | $5,98 | 63 t/s |
| max | 53 | $7,63 | 67 t/s |
Lisez ensemble les colonnes extrêmes : l'effort maximal coûte 3,2x l'effort faible par tâche, pour 6 points d'intelligence mesurée. Le faible affiche aussi la plus courte latence au premier token (8,47 s dans le même instantané). Le réglage cher n'est pas automatiquement le prudent ; c'est celui qui pense le plus longtemps en tokens de sortie facturables — les données de Firecrawl montrent que l'écart est presque entièrement du raisononnement caché (au max : tokens de raisonnement 4 205 → 6 725 tandis que le texte visible baissait de 6 %).
Les valeurs par défaut d'Anthropic en font une décision vivante : Fable 5.1 est en effort High par défaut dans Claude Code, et Medium dans Claude Cowork et sur Claude.ai. La même tâche sur deux surfaces se facture différemment dès le premier token. Les notes de lancement sont d'une franchise inhabituelle : Low ou Medium « obtiennent des résultats similaires ou meilleurs que ceux de Fable 5 à un coût bien moindre » — quand un éditeur vous dit que le réglage bon marché suffit souvent, c'est un cadeau ; acceptez-le.
Les lignes de facturation hors du titre
Quatre lignes décident de la plupart des factures réelles, et seule la première apparaît dans la couverture de lancement.
Batch : le levier des 50 %. Les requêtes Batch asynchrones sont facturées 5 dollars d'entrée / 25 de sortie sur Fable 5.1 — la plus grosse remise de la grille, cumulable avec le cache de prompts. Pour les évaluations, les refactors nocturnes et tout ce qui n'est pas face à un utilisateur, ce commutateur économise plus que n'importe quelle optimisation de prompt. Les sessions d'agents gérés n'y sont pas éligibles (avec état et interactives).
Inférence US-only : 1,1x sur tout. Régler inference_geo: "us" — ou le déploiement Azure US Data Zone équivalent — multiplie chaque catégorie par 1,1, lectures de cache incluses. Les régions contraintes par la conformité paient 10 % de plus discrètement sur chaque ligne ; le routage global est le défaut et le chemin bon marché.
Les surcoûts d'outils sont des factures de tokens. Déclarer le toolset browser-use ajoute environ 6 600 tokens d'entrée par requête ; computer-use environ 4 500 ; la définition de l'outil bash, 325. La recherche web côté serveur facture 10 dollars pour 1 000 recherches en plus des tokens. Un « agent » est une structure tarifaire, pas une conversation — les flux d'automatisation de navigateur devraient budgéter la ligne du toolset explicitement.
Ce que Batch et la résidence ne réparent pas : les retries, l'éventail de sous-agents (chaque sous-tâche routée vers Opus est facturée aux tarifs Opus), et l'inflation d'environ 30 % de tokens du tokenizer face aux modèles pré-4.7. Rien n'apparaît sur la grille ; tout apparaît sur la facture.
L'échelle familiale : Fable 5.1 vs Opus 5 vs Sonnet 5
| Ligne (par 1M tokens) | Fable 5.1 | Opus 5 | Sonnet 5 |
|---|---|---|---|
| Entrée | $10,00 | $5,00 | $2,00 |
| Lecture cache | $0,25 (0,025x) | $0,50 (0,1x) | $0,20 (0,1x) |
| Sortie | $50,00 | $25,00 | $10,00 |
| Batch entrée / sortie | $5,00 / $25,00 | $2,50 / $12,50 | $1,00 / $5,00 |
La ligne contre-intuitive est la lecture de cache : le modèle le plus cher de la famille a la lecture de cache la moins chère — 4x sous le multiplicateur standard de la famille. Anthropic a fixé au ratio le plus bas précisément la ligne que les boucles d'agents martèlent le plus. Si votre trafic relit de grands contextes stables, le prix d'entrée effectif de Fable s'effondre ; sinon, Opus 5 — moitié moins cher en affiché, double en ratio de lecture — peut gagner : Firecrawl a trouvé les tâches à spécification serrée moins chères sur Opus 5 « à chaque fois », tandis que les constructions ouvertes filaient en moyenne 11,83 dollars sur Opus contre 7,00 sur Fable 5.1.
Deux faits de plus sur l'échelle : les 2/10 dollars de Sonnet 5 étaient un prix d'introduction jusqu'au 31 août 2026 — Anthropic en a fait le prix standard, annulant la hausse prévue à 3/15 le 1er septembre. Et le piège du même prix affiché traverse les familles : Fable 5.1 et GPT-6 Astra affichent tous deux 10/50, et coûtent pourtant des montants opposés — Astra finit les longues tâches isolées avec moins de tokens, tandis que les lectures à 0,25 dollar de Fable gagnent toute charge à contexte caché fort volume. L'analyse r/LLMDevs qui l'a encadré :
Le positionnement d'Anthropic épouse l'échelle : Fable 5.1 pour « un travail ambitieux, de longue durée et asynchrone » — la review couvre quand ça tient — avec Opus et Sonnet pour le travail interactif quotidien.
Ce pour quoi vous ne payez pas
La documentation tarifaire et la page produit tracent des limites qui se lisent comme une politique de remboursement, et à l'échelle agentique elles comptent :
Les réacheminements de garde-fou ne se facturent pas aux prix Fable. Les requêtes signalées par les garde-fous cybersécurité ou biologie sont traitées par Opus 4.8 ou Opus 5 — « Vous ne serez pas facturé aux prix Fable pour les requêtes réacheminées », dit la page produit. Une réponse qui semble refusée sur un sujet de sécurité peut littéralement être une réponse Opus moins chère.
Les recherches web échouées ne sont pas facturées. Chaque recherche réussie coûte 10 dollars pour 1 000 ; celles qui échouent, rien. Le web fetch n'ajoute aucun frais au-delà des tokens devenus contexte.
L'exécution de code est gratuite avec recherche/fetch, et chaque organisation reçoit 1 550 heures de conteneur gratuites par mois avant le tarif de 0,05/heure.
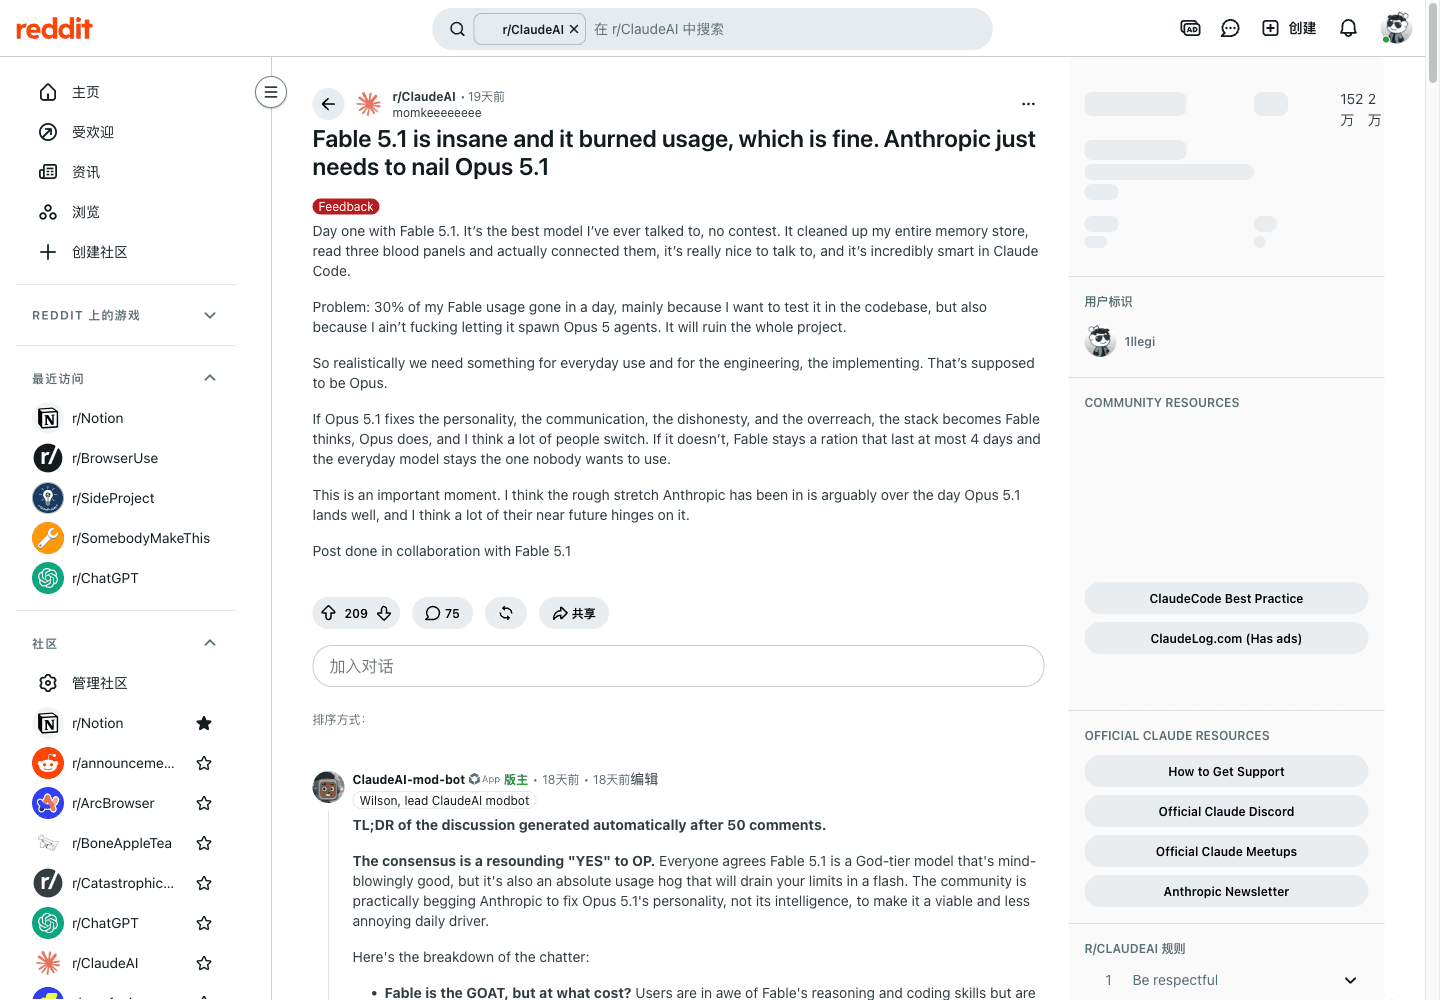
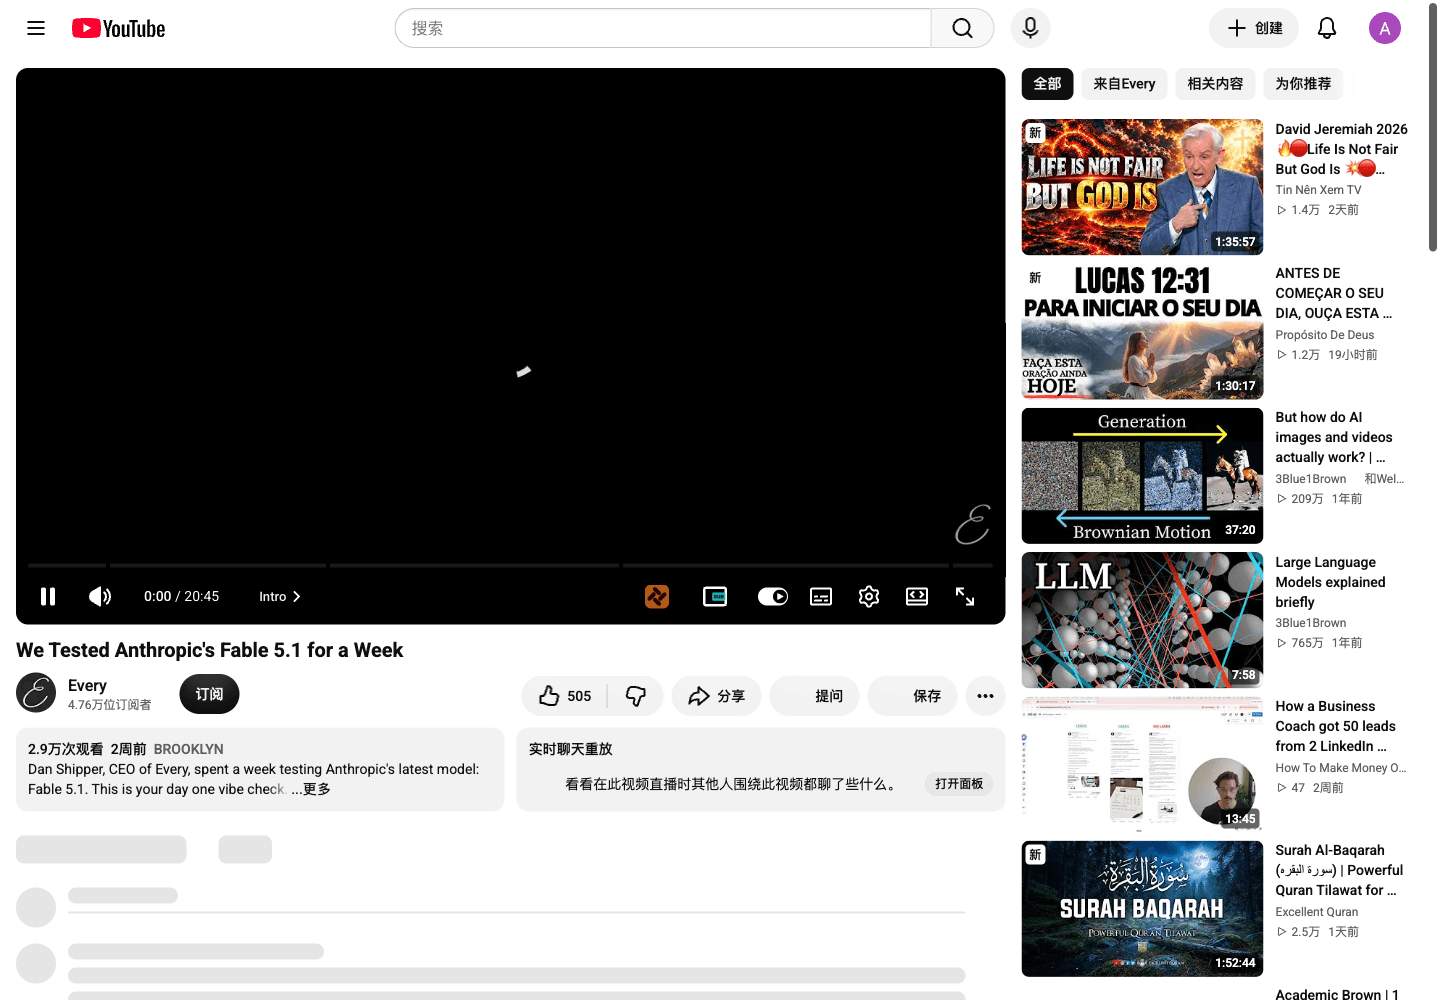
La contrepartie : le quota n'est pas de l'argent mais se comporte comme tel. Sur abonnement, Fable brûle vite les fenêtres de 5 heures — un utilisateur de r/ClaudeAI a rapporté 30 % de l'usage d'une journée envolés en une session de débogage (« je ne vais pas le laisser spawn des agents Opus 5 »), et des commentateurs de la vidéo d'Every ont rapporté épuiser une fenêtre de 5 heures en 10–20 minutes. Ce sont des expériences de forfait autodéclarées, pas des benchmarks, mais elles pointent dans le même sens que l'arithmétique API : la délégation et l'effort décident la vitesse de combustion. Les crédits d'usage des offres payantes permettent de continuer aux tarifs API standard au-delà des limites.
Disponibilité des offres : API, clouds et offres grand public
La grille API n'est qu'une économie sur trois. Vérifié sur claude.com/pricing et la documentation plateforme le 22 septembre 2026 :
| Surface | Prix (affichage vérifié) | Accès Fable 5.1 |
|---|---|---|
| API Anthropic | Tarifs token ci-dessus | Oui — claude-fable-5-1 |
| Offre Free | 0 $ | Non (Sonnet/Haiku seulement) |
| Pro | 17 $/mois annuel (200 $ d'avance) ou 20 $ mensuel | Oui — crédits d'usage, 50 % des limites hebdo |
| Max 5x / 20x | À partir de 100 $/mois | Oui — même règle de crédits, 5x/20x l'usage Pro |
| Team Standard / Premium | 20 $ / 100 $ par siège annuel (25 $/125 $ mensuel) | Oui — Premium = 5x Standard |
| Enterprise | 20 $/siège/mois annuel + usage aux tarifs API | Oui, avec contrôles de dépense |
| Clouds | AWS Bedrock, Google Cloud, Microsoft Foundry | Oui ; endpoints régionaux +10 %, Foundry facture en CCU |
La mécanique d'abonnement qui décide du coût réel : l'usage se réinitialise par fenêtres de session glissantes de 5 heures, avec des limites hebdomadaires en plus sur les offres payantes ; web, bureau, mobile et Claude Code puisent dans un même pool ; Pro vaut « au moins 5x » Free par fenêtre, Max 5x/20x Pro. Fable en particulier consomme des crédits d'usage fixés à 50 % des limites hebdomadaires sur Pro et Max — une heure de Fable coûte à votre allocation le double d'une heure de Sonnet, l'arithmétique derrière les rapports de « fenêtre brûlée » ci-dessus.
Les routes tierces ont leurs conditions : la page Fable d'OpenRouter précise que la rétention de données n'y est pas réductible, et son endpoint Bedrock est BYOK-only en pleine migration. Les défauts d'effort diffèrent aussi selon la surface — High dans Claude Code contre Medium sur le web — si bien qu'un même abonnement s'épuise à des vitesses différentes selon l'endroit où vous travaillez.
Deux budgets chiffrés, toutes les hypothèses visibles
Tarifs standard, sans retries, sans outils, hors taxes. De l'arithmétique posée, pas des prédictions.
Une question courte avec une longue réflexion. 10 000 tokens d'entrée, 2 000 de sortie :
(10 000 × $10 + 2 000 × $50) / 1 000 000 = $0,20Une boucle d'agent à froid sur un gros dépôt. 300 000 tokens d'entrée (toujours au tarif standard — pas de palier long), 8 000 de sortie :
(300 000 × $10 + 8 000 × $50) / 1 000 000 = $3,40La version à chaud de la même boucle. Même contexte de 300 000 tokens, 90 % caché, une écriture d'une heure par session, 8 000 de sortie :
(270 000 × $0,25 + 30 000 × $10 + 300 000 × $20 + 8 000 × $50) / 1 000 000 = $0,97 + écrituresCette troisième ligne est toute l'histoire de cette sortie en un calcul : le même travail passe de 3,40 dollars à moins d'un dollar quand le préfixe tient tranquille — et remonte dès que réapparaissent le brassage de contexte, les retries ou les sous-agents routés vers Opus. La ressource du modèle (English) et sa collection de prompts (English) référencent des tâches répétables pour mesurer votre propre taux de hits.
Calcul local
Estimez le coût en tokens de l’API Claude Fable 5.1
Utilise les tarifs officiels en USD vérifiés le 22-09-2026. Les valeurs restent dans ce navigateur.
Les lectures de cache sont facturées à 0,25 USD par million de tokens — l’exception 0,025x de Fable. L’estimation exclut les nouvelles tentatives, les surcoûts d’outils, les réacheminements de garde-fou et les marges des fournisseurs. Le multiplicateur États-Unis s’applique à chaque ligne. Vérifier les tarifs actuels
La calculatrice tourne entièrement dans cette page — rien n'est envoyé nulle part. Elle tarife les deux durées d'écriture de cache, les modes Batch et US-only, et valide les entrées localement. Ce qu'elle ne modélise volontairement pas : les retries, le routage de palier des sous-agents, les surcoûts d'outils et les réacheminements de garde-fou — cela relève de votre marge. Revérifiez la grille officielle avant d'engager un budget ; ce sont les chiffres du 22 septembre 2026.
Une option pratique : lancer la comparaison dans Tabbit
Après le budget vient la partie ennuyeuse : faire tourner du travail façon Fable exige un endroit où pages, fichiers et appels de modèles cohabitent, et où « essayer Fable en medium, retomber sur Sonnet » est une sélection et non un projet d'orchestration. C'est le vide que comble Tabbit Browser — un navigateur AI agentique dont le sélecteur de modèles, les onglets vivants et les fichiers locaux partagent une seule surface.
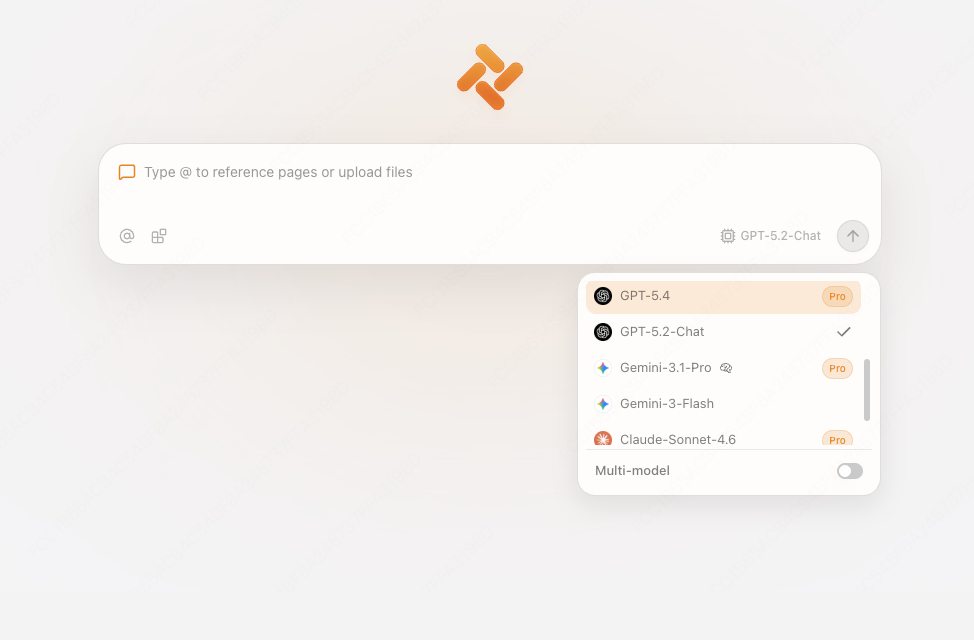
Les limites, dites sans détour : Tabbit est un client, pas une couche de facturation Anthropic. La disponibilité des modèles dépend de votre compte et de votre édition, et rien dans le navigateur ne change ce qu'Anthropic facture — la grille ci-dessus s'applique partout où Fable tourne. Cet article n'a pas exécuté de tâche Fable dans Tabbit, donc aucune affirmation de disponibilité ou de performance n'est faite ici. Ce que le navigateur change, c'est le coût de mise en route : mesurer votre propre taux de hits de cache et votre seuil d'effort sur du vrai travail — les deux chiffres que cette page entière dit décisifs pour votre facture — coûte le moins cher dans un atelier construit exactement pour ça. Le guide des habitudes Tabbit couvre la méthode ; la vue d'ensemble du navigateur AI est le point de départ général.
 Tabbit Browser
Table de décision tarifaire de Claude Fable 5.1
| Votre charge | Facteur de coût | Meilleure route de départ | À surveiller |
|---|---|---|---|
| Longues boucles d'agent, contexte dépôt/docs stable | Lectures de cache | Standard, préfixes stables, écritures 1 h | Le brassage de contexte reconvertit les lectures en écritures 1,25–2x |
| Chat court, éditions rapides | Tokens de sortie | Effort plus bas — ou Sonnet 5 | La sortie à 50 $/M domine ; Fable est un marteau pour une mouche |
| Évaluations nocturnes, refactors par lots | Volume | API Batch à -50 % | Les sessions interactives/agents gérés non éligibles |
| Constructions autonomes ouvertes | Délégation + sortie | Limiter les paliers de sous-agents ; laisser Fable écrire lui-même | Sous-agents routés vers Opus facturés aux tarifs Opus |
| Traitement US imposé par la conformité | Chaque ligne | US-only à 1,1x, Batch où permis | La prime s'applique aussi aux lectures de cache |
| Usage quotidien par abonnement | Fenêtres 5 h + crédits | Pro/Max avec crédits à 50 % des limites hebdo | Les défauts High brûlent les fenêtres en minutes |
Verdict final
Claude Fable 5.1 est tarifé comme un ingrédient pour le travail de longue haleine, et cette sortie a réellement déplacé un chiffre : les lectures de cache à 0,25 dollar par million rendent les boucles d'agents sur contexte caché radicalement moins chères que sur Fable 5 — les mesures indépendantes situent l'économie réalisée à 15–30 %, et votre kilométrage, c'est le taux de hits qui le décide, pas l'étiquette. Achetez-le exactement pour cette forme de travail, à l'effort le plus bas qui passe votre critère d'acceptation, avec des paliers de délégation plafonnés et Batch pour tout ce qui peut attendre. Pour les tâches interactives courtes, les budgets serrés ou les contextes qui brassen, l'échelle familiale existe précisément pour que le vaisseau amiral soit une décision de routage, pas un défaut — et sur abonnement, traitez la fenêtre de 5 heures comme la vraie facture.
Revérifiez la page officielle des prix chaque mois : la standardisation de Sonnet 5 montre que cette échelle bouge. Le panorama et la review portent l'histoire des capacités ; les enregistrements communautaires ci-dessus, la preuve par les charges ; et la comparaison tarifaire entre familles montre ce que le même prix affiché coûte ailleurs.
Sources
Documentation tarifaire Anthropic — grille, multiplicateurs de cache, Batch, résidence, tarification des outils ; vérifié le 22 septembre 2026
Page de lancement Anthropic et page produit Claude Fable — promesses d'économie, défauts, facturation des réacheminements, disponibilité ; vérifié le 22 septembre 2026
claude.com/pricing — offres Free/Pro/Max/Team/Enterprise et règles d'accès à Fable ; vérifié le 22 septembre 2026
Page de sortie Artificial Analysis — intelligence par effort, vitesse, instantané du coût par tâche ; vérifié le 22 septembre 2026
Firecrawl : mesure de coût sur 57 exécutions — ratios de tokens, économies réalisées, effets de la spécification ; 7 septembre 2026
OpenRouter Fable 5.1 — tarifs fournisseurs et conditions de route ; vérifié le 22 septembre 2026
Enregistrements communautaires avec captures et conditions en ligne : r/ClaudeCode 1 200 vs 500 $, r/ClaudeCode -37 %, analyse même prix r/LLMDevs, combustion de quota r/ClaudeAI, commentaires du test d'une semaine d'Every

Questions fréquentes
Combien coûte Claude Fable 5.1 ?
Sur l'API Anthropic, Claude Fable 5.1 est facturé 10 dollars par million de tokens d'entrée et 50 dollars par million de tokens de sortie, vérifié sur la documentation tarifaire d'Anthropic le 22 septembre 2026. Les écritures de cache coûtent 12,50 dollars par million (5 minutes) ou 20 dollars (1 heure), et les lectures de cache 0,25 dollar par million. L'API Batch divise tout par deux (5/25 dollars) et l'inférence US-only ajoute un multiplicateur de 1,1x sur chaque ligne.
Claude Fable 5.1 est-il moins cher que Fable 5 ?
Cela dépend du token qui domine votre facture. Anthropic estime que les charges typiques coûtent environ 25 % de moins et les charges très agentiques jusqu'à 45 % de moins, entièrement grâce à la baisse des lectures de cache à 0,25 dollar par million. Mais Artificial Analysis a mesuré un coût par tâche de benchmark en hausse de 18 %, car Fable 5.1 émet davantage de tokens de raisonnement. Les charges qui relisent un contexte stable en cache deviennent moins chères ; celles qui génèrent du neuf ou font tourner le contexte peuvent devenir plus chères.
Claude Fable 5.1 est-il disponible sur l'offre Free ?
Non. Le comparateur d'offres d'Anthropic indique Fable comme indisponible sur Free. Il est accessible aux utilisateurs Pro, Max, Team et Enterprise ; sur Pro et Max, l'usage de Fable puise dans des crédits d'usage fixés à 50 % des limites hebdomadaires. Les utilisateurs du plan Free n'ont accès qu'aux modèles Sonnet et Haiku.
Quelle est la manière la moins chère d'utiliser Claude Fable 5.1 ?
Empilez les leviers dans l'ordre : gardez des préfixes de prompt stables pour que les lectures soient facturées 0,25 au lieu de 10 dollars par million, utilisez le niveau d'effort le plus bas qui passe votre critère d'acceptation, passez par l'API Batch à -50 % ce qui peut attendre, et n'activez pas l'inférence US-only sans obligation de conformité. Limitez aussi la délégation : les sous-agents routés vers Opus 5 sont facturés aux tarifs Opus, une ligne de coût caché classique.
Claude Fable 5.1 facture-t-il un supplément pour les longs contextes ?
Non. Anthropic facture la fenêtre complète d'un million de tokens au tarif standard par token, sans palier de contexte long ni répricing par seuil ; le cache de prompts et les remises Batch s'appliquent sur toute la fenêtre. Cela diffère des modèles phares comme GPT-6 Astra, où les prompts de plus de 272K tokens d'entrée re-tarifient la requête entière à des tarifs de contexte long supérieurs.
Les réacheminements de garde-fou ou les appels d'outils échoués sont-ils facturés aux prix Fable ?
Non. Anthropic précise que les requêtes automatiquement réacheminées par les garde-fous de cybersécurité ou de biologie ne sont pas facturées aux prix Fable ; elles sont traitées par Opus 4.8 ou Opus 5. Les recherches web échouées ne sont pas facturées, le web fetch n'entraîne aucun frais supplémentaire et l'exécution de code est gratuite avec les outils de recherche ou de fetch.