
Claude Opus 5.5 es la decisión Opus más fácil en mucho tiempo: pasa a él tu trabajo Opus por defecto. Anthropic lo lanzó el 22 de septiembre de 2026 a 4 USD por millón de tokens de entrada y 20 de salida —un 20% menos que Opus 5— y lo presentó rindiendo "at the level of Claude Fable 5.1 on most work" con un coste de ejecución "40% less… than Opus 5". El registro independiente del día siguiente respalda en general esa presentación, con dos peros: al esfuerzo máximo el modelo habla lo bastante para comerse la rebaja, y vista de cerca, la mejora de capacidad sobre Fable 5.1 es incremental, no un nuevo techo.
Ese encuadre no es marketing en el vacío. Horas después del lanzamiento, el hilo más votado de r/ClaudeAI se titulaba "Opus 5.5 is 40% cheaper while being 30% faster than opus 5" — 775 upvotes de la comunidad repitiendo los números oficiales como argumento de compra. El comentario más votado del mismo hilo explica por qué la reacción es tan intensa: Opus 5 "couldn't even communicate properly", y la gente terminó "wasting even more time and tokens" peleándose con él (u/Front_Raspberry_6488, 226 upvotes). Esta reseña ordena cuáles de esos sentimientos aguantan la evidencia.
Todos los datos de abajo se abrieron y verificaron el 23 de septiembre de 2026, un día después del lanzamiento: la página de Anthropic, la página de Artificial Analysis y los hilos originales de Reddit. El recurso del modelo Claude Opus 5.5 (English) guarda la biblioteca de prompts y evidencia; sus fichas de reseña (English) son el registro a nivel fuente detrás de este artículo. Aún no existen páginas hermanas de precios ni alternativas de Opus 5.5, así que esta reseña no enlaza ninguna. Al final cubro qué significan los hallazgos para flujos de trabajo a nivel navegador, donde este tipo de modelos trabaja cada vez más.
Conclusiones clave
El número clave es 40%, y es una afirmación sobre cargas de trabajo, no una etiqueta de precio. Los precios bajaron 20% (4/20 USD) y las lecturas de caché cayeron 60% (a 0,20 USD/M). El "40% menos de coste" proviene de las pruebas de Anthropic con cargas típicas — SonarSource midió de forma independiente literalmente un 40% menos de tokens de salida en generación Java, mientras que Artificial Analysis midió 5,98 USD por tarea del índice al esfuerzo máximo.
Primero de un leaderboard independiente, a un coste. Artificial Analysis puntúa a Opus 5.5 (esfuerzo máximo) con 58, nº 1 de 212 modelos, y a la vez lo sitúa nº 95 de 212 en verbosidad: unos 119k tokens de salida por tarea del índice frente a unos 27k de GPT-6 Astra max.
El problema de comunicación que hundió a Opus 5 parece resuelto. La queja más fuerte contra Opus 5 era que el código salía bien pero la conversación no. Las voces del día uno describen 5.5 como rápido, natural y menos relleno, y SonarSource midió que la proporción de comentarios del Java generado cayó del 10,5% al 3,1%.
Menos código, errores más densos. En la prueba Java de SonarSource (build pre-lanzamiento) hubo un 27,5% menos de código y un 42% menos de incidencias con una tasa de aprobación plana, pero la densidad de errores por millón de líneas subió de 576 a 644, con errores de concurrencia al alza del 44%. La revisión de código sigue siendo obligatoria.
La lectura de METR: incremental, no un salto. La evaluación previa al despliegue halló mejoras incrementales sobre Fable 5.1 en cinco tareas de I+D de IA, con debilidades de juicio (anticipación, bucles de feedback, criterio de investigación) aún abiertas. Compra 5.5 por economía y pulido; escala a Fable cuando choques con su techo.
Qué es Claude Opus 5.5 en realidad
Claude Opus 5.5 es el primer modelo de la nueva familia Claude 5.5 de Anthropic, lanzado el 22 de septiembre de 2026. El ID del modelo es claude-opus-5-5; la página de lanzamiento lista disponibilidad en Anthropic Claude Platform, AWS, Google Cloud y Microsoft Azure. El sobre documentado: contexto de 1M de tokens, hasta 128K de salida, adaptive thinking y medium como esfuerzo por defecto — ese último detalle importa más que cualquier fila de benchmark de esta reseña.
| Pregunta | Instantánea publicada (verificada 2026-09-23) | Qué no demuestra |
|---|---|---|
| Lanzamiento e ID | 2026-09-22; claude-opus-5-5 | Que cada cliente exponga el mismo build y rango de esfuerzos |
| Precio entrada / salida | 4 / 20 USD por millón de tokens | Tu coste por tarea tras pensar y reintentar |
| Lectura / escritura de caché | 0,20 / 5 USD por millón (Opus 5: 0,50 / 6,25) | Un ahorro universal del 40% en toda carga |
| Contexto y salida | 1M de entrada, hasta 128K de salida | Que cada proveedor o plan exponga la ventana completa |
| Esfuerzo | adaptive thinking; medium por defecto | Que esfuerzos más bajos conserven las mismas puntuaciones (curva no publicada por tarea) |
| Disponibilidad | Anthropic, AWS, Google Cloud, Azure | Planes de consumo; no verificado aquí |
| Instantánea independiente | Artificial Analysis: 58, nº 1/212 (esfuerzo máximo) | Velocidad: AA marca latencia N/A para este modelo |
Anthropic también enmarca el lanzamiento de forma procedimental: es la primera entrega desde que la compañía "called for pacing the frontier", y fue probada antes del lanzamiento por evaluadores externos, incluidos Frontier Design y METR. En la auditoría conductual automatizada de Anthropic —cerca de 2.000 escenarios— Opus 5.5 es "the strongest-performing model we've tested to date", y una evaluación de límites de contención mostró aproximadamente un 85% menos de intentos de evasión que Opus 5 o Mythos 5.1. Son afirmaciones de seguridad que conviene registrar, y cortan en ambos sentidos: una sección posterior muestra cómo las intervenciones de salvaguardia también se convierten en ceros en benchmarks de capacidad.
La pregunta que responde esta reseña no es "es listo". Una tabla del fabricante y un nº 1 independiente ya dicen que sí. Es si un modelo con precio de caballo de batalla y presentación de buque insignia pertenece a tu flujo diario —frente a mantener las tarifas de Opus 5, pagar los precios de Fable 5.1, o mover el trabajo mecánico a modelos más baratos como GPT-5.6 Sol o MiMo-V2.6-Pro.
El número que decide esta reseña: 40%
La frase de presentación de Anthropic, verificada en la página, merece una lectura literal: Opus 5.5 "performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5". Dos afirmaciones en una línea —capacidad casi de buque insignia, economía de caballo de batalla— y ambas son verificables.
La parte del precio es pública y simple: la entrada cayó de 5 a 4 USD, la salida de 25 a 20, las lecturas de caché de 0,50 a 0,20 USD por millón. La caché es lo que más pesa en trabajo agéntico, porque una ejecución de 40 llamadas a herramientas relee su prefijo cacheado 40 veces; a 0,20 USD —el 5% del precio de entrada, el descuento de caché del 95% que lista Artificial Analysis— las sesiones largas se abaratan estructuralmente. Es la misma palanca que hizo de la rebaja de caché de Fable 5.1 la historia de su lanzamiento, ahora empujada más abajo.
La parte del 40% es donde vive la letra pequeña, y tres mediciones independientes la acotan:
Cobrado: la ejecución Java de SonarSource (build pre-lanzamiento, esfuerzo High) usó 12,96M de tokens de salida frente a 21,71M de Opus 5 — una reducción literal del 40% — con una tasa de aprobación a menos de un punto (87,68% vs 88,6%). Menos código, menos tokens, mismo resultado funcional. Así luce el descuento cuando funciona.
Gastado: Artificial Analysis ejecutó el Índice de Inteligencia a esfuerzo máximo y midió unos 119.000 tokens de salida por tarea — frente a unos 73k de Opus 5 max, unos 78k de Fable 5.1 max y unos 27k de GPT-6 Astra max — aterrizando en 5,98 USD por tarea ponderada y un puesto de verbosidad nº 95 de 212. Así luce el descuento cuando se deja al modelo pensar en voz alta a máximo volumen.
En medio: el análisis interno de M&A de Anthropic terminó en 63 minutos frente a 93 de Opus 5 con un "50% less to run" — probado por el fabricante, justo en la cifra prometida.
La reconciliación no es una contradicción; es el dial de esfuerzo. Medium es el valor por defecto por una razón: el descuento del 40% es real, y cobrarlo depende sobre todo del nivel de esfuerzo que tu flujo usa por reflejo. La lectura de METR apoya la misma conclusión desde el otro lado — el modelo es un paso incremental sobre Fable 5.1, así que la razón para cambiar es economía y pulido, no un techo nuevo. Si tu pipeline fija max porque "mejor modelo, mayor esfuerzo", ya te has vuelto a fijar precio de territorio insignia.
Qué pasó en trabajo real, antes del leaderboard
La evidencia más útil del día uno no es una fila de benchmark. Son tres historias de construcción con nombre, límites incluidos.
Una película de 45 minutos en una sola ejecución. u/mshort3 le dio a Claude Code una sola frase — "Lets make a ~70s riso film of your own choosing, free range" — dentro de un proyecto creativo existente, y reporta que Opus 5.5 produjo un viaje animado en tren de 78 segundos en una única ejecución de unos 45 minutos (r/ClaudeAI, 637 upvotes). El repositorio es público, y el autor atribuye el resultado a las skills y docs del propio proyecto, no solo al modelo. Una ejecución; sin registros de los estados intermedios.
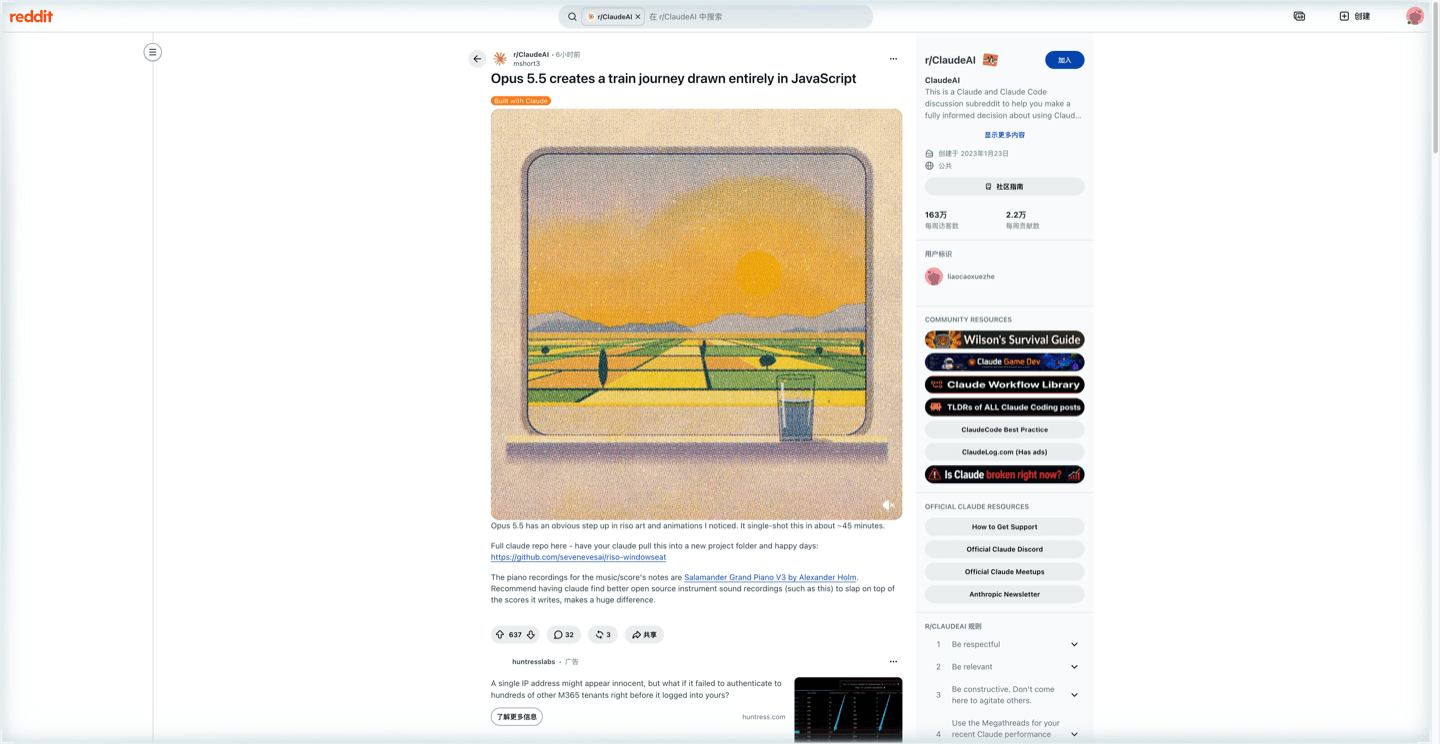
Hilo original: r/ClaudeAI 1wnkvys.
Un vídeo de un minuto con un solo prompt — con recibo de coste. u/AzorAhai1TK pidió "an average day at work… with a twist" renderizado como un vídeo inquietante de un minuto, y reporta que el modelo lo programó y renderizó de punta a punta a esfuerzo Extra-High en unos 45 minutos, usando cerca del 4% del cupo semanal de un plan de 20 USD/mes (r/ClaudeAI). Cifras autoinformadas, pero el dato de cupo es exactamente lo que un debate de precios necesita: las ejecuciones creativas a máximo esfuerzo no son gratis, ni catastróficas.
Velocidad "de noche a día" en Claude Code — con la advertencia puesta por su propio autor. u/Lazy_Assistance_1137 reporta que bugs de interfaz que "used to take a while to track down" se detectan "in no time", y llama al salto "night and day" — para advertir acto seguido: "this could just be the classic day-one honeymoon phase, and in two weeks we'll all be back to posting 'did they nerf it?' threads" (r/ClaudeAI, 273 upvotes). La respuesta más votada es de una sola palabra de profundidad: "It's crazy fast. I'm impressed." (u/capivara_de_pijama, 96 upvotes).
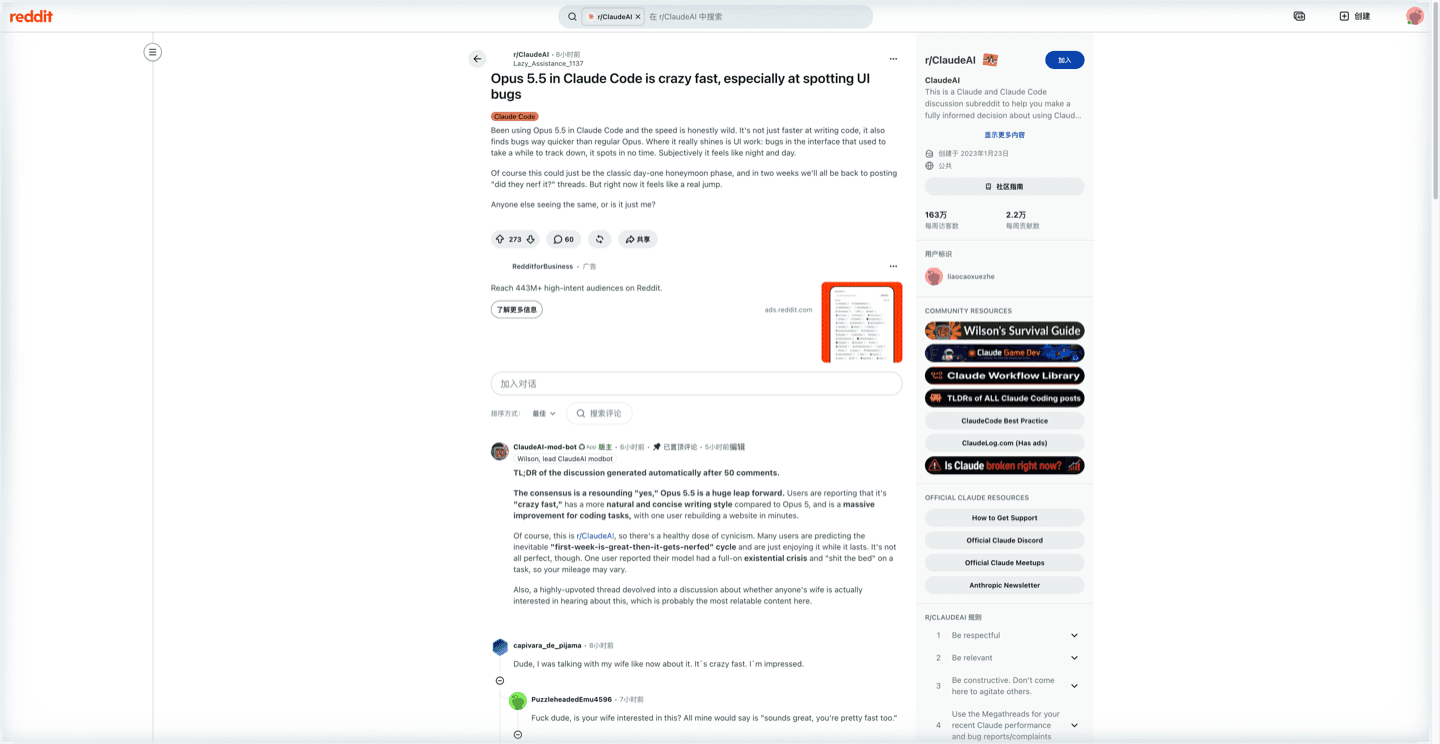
Hilo original: r/ClaudeAI 1wnil7n.
Tres historias, n=1 cada una, sin registros, sin conteos de tokens (salvo el 4% autoinformado). Lo que establecen: el modelo completa construcciones creativas largas, autodirigidas y multi-herramienta el primer día, repetidamente, en público, con artefactos que puedes abrir. Lo que no establecen: con qué frecuencia. Ese es el hueco que los benchmarks deberían rellenar — veamos cuánto rellenan de verdad.
Los benchmarks, y cuánto confiar en ellos
Tabla de lanzamiento de Anthropic, registrada tal como se publicó el 2026-09-22. Columnas distintas pueden venir de operadores y leaderboards distintos (las cifras de GPT-6 Astra y GPT-5.6 Sol están identificadas por Anthropic como provenientes de informes de OpenAI), así que lee filas, no aritmética entre columnas:
| Dominio / benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| Código agéntico: Terminal-Bench 4.0 | 66,4% | 55,8% | 52,3% | 57,9% | 37,3% |
| Código agéntico: FrontierCode v1.1 | 54,4% | 50,3% | 48,0% | 53,3% | 47,5% |
| Código agéntico: CursorBench 4.0 | 57,8% | 51,8% | 46,6% | — | 41,7% |
| Trabajo del conocimiento: GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| Flujos de negocio: AutomationBench | 40,0% | 31,4% | 26,9% | 41,4% | 28,8% |
| Razonamiento: Humanity's Last Exam (con herramientas) | 67,7% | 65,6% | 63,6% | 57,2% | — |
| Ciencia agéntica: Terminal-Bench-Science 0.1 | 58,7% | 52,6% | 29,0% | 64,6% | 22,4% |
| Uso de ordenador: OSWorld 2.0 (parcial) | 81,8% | 80,7% | 74,0% | — | — |
| Reconocimiento de gráficos: Chartography (con herramientas) | 89,0% | 88,4% | 83,4% | — | — |
Ahora el agua fría, en tres partes.
Los márgenes de error están publicados, y son anchos. Terminal-Bench 4.0 lleva un error estándar de ±2,6 puntos para Opus 5.5; Terminal-Bench-Science, de ±3,5–5 puntos por modelo. El salto Opus 5 → Opus 5.5 en TB-Science (29,0% → 58,7%) sobrevive a cualquier barra de error; la distancia con GPT-6 Astra (64,6%) en la misma fila también — a favor de Astra. La propia Anthropic advierte en la página que, a los niveles de capacidad actuales, las diferencias de puntuación pueden no representar de forma fiable las brechas del mundo real. Esa frase, dicha por el fabricante, es la línea más honesta de cualquier tabla de lanzamiento de esta temporada.
Las condiciones de comparación no son uniformes. Las filas de Terminal-Bench usan el arnés Claude Code; AutomationBench lo ejecutó y reportó Zapier, sin modelos de respaldo, de modo que las intervenciones de seguridad contaban como fallos; el proceso de puntuación independiente de GDPval-AA v2.1 no se detalla en la página. Una intervención de salvaguardia puede anular una tarea — un resultado de política registrado como fallo de capacidad. Nada de esto hace incorrecta la tabla; la convierte en un conjunto de instantáneas con condiciones distintas, no en una carrera controlada.
El registro independiente coincide en la forma, no en los márgenes. El índice propio de Artificial Analysis (v4.3.2, diez evaluaciones) da a Opus 5.5 max un 58, nº 1 de 212, liderando seis evaluaciones en solitario (Humanity's Last Exam 61,4%, SciCode 66,9%, GDPval-AA 1846, AA-Briefcase 1822 — 143 Elo por encima de Fable 5.1) y empatando con GPT-6 Astra xhigh en Terminal-Bench 4.0 con 59,6%. El test Java controlado de SonarSource es el dato más afilado: tasa de aprobación a un punto de Opus 5 generando un 27,5% menos de código — con densidad de errores por línea al alza, cubierta abajo. La evaluación previa al despliegue de METR, 10 días hábiles sobre cinco tareas de I+D de IA, concluye que la mejora sobre Fable 5.1 es "incremental… rather than a discontinuous leap", sin progreso mayor en anticipación, construcción de bucles de feedback o criterio de investigación.
Lo que sobrevive al chapuzón: el salto frente a Opus 5 es real y grande (TB-Science 29,0% → 58,7% no es un truco de redondeo); el nº 1 independiente tiene segunda fuente; la historia de costes tiene una réplica plenamente independiente (los conteos de tokens de SonarSource). Lo que no sobrevive: cualquier afirmación de que Opus 5.5 "gana limpiamente" a GPT-6 Astra — en la tabla de Anthropic, Opus 5.5 lidera Terminal-Bench 4.0 y Astra lidera Terminal-Bench-Science; en la ejecución TB-4.0 independiente de Artificial Analysis ambos empatan al 59,6%; nuestra reseña de GPT-6 Astra cubre sus propias contrapartidas.
Dónde brilla de verdad Opus 5.5
Por fin conversa como un compañero de trabajo
La fortaleza que ninguna fila captura: Opus 5 era un modelo de código fuerte al que la gente odiaba hablarle, y las voces del día uno dicen que 5.5 arregla la conversación en sí. Los comentarios top del hilo ancla son la autopsia de ese dolor — "Opus is fantastic, just until you have to talk to it" (u/Neon_Camouflage, 61 upvotes) — emparejados con alivio: "Heard Opus 5.5 is less verbose" (u/No-Temperature6597). El analizador de SonarSource pone número al cambio: la proporción de comentarios del Java generado cayó del 10,5% al 3,1% de las líneas, con la densidad de code smells un 21% abajo. Y la entrevista del filósofo formado (esfuerzo medium, incógnito) lo describe como "a model with polish and panache… It will happily cite back Theophrastus and Austin to you, but can't break the habit of wanting to get its hands dirty" (u/Wickywire). Si escribes o planificas para vivir — no solo compilas — esta es la mejora que importa más que cualquier nota de código.
Perseverancia agéntica, a precio Opus
Aquí está el centro de gravedad de la tabla oficial, y se sostiene: 66,4% en Terminal-Bench 4.0 y 58,7% en TB-Science (ambos dentro de sus bandas de error publicadas) con el arnés Claude Code; 57,8% en CursorBench 4.0; OSWorld 2.0 en 81,8% parcial para uso de ordenador. Los ejemplos internos son inusualmente concretos para evidencia de fabricante: en una tarea de resultados trimestrales, 16 de 18 informes pasaron un calificador que comprobaba cada cifra y cita y reprobó los intentos de Fable 5.1 y Opus 5; en un análisis de M&A ficticio, 63 minutos frente a 93 de Opus 5 a la mitad de coste. Autoinformado, pero con exactamente la forma de trabajo —largo, multi-archivo, con verificación— que miden las cifras de terminal. Para cargas de investigación agéntica y trabajo profundo, este perfil a 4/20 USD es el argumento más fuerte del lanzamiento.
La economía del esfuerzo medium es el titular silencioso
El medium por defecto más las lecturas de caché a 0,20 USD cambian la economía unitaria de las sesiones largas de un modo que los precios de cabecera no muestran. Artificial Analysis colocó cuatro de los cinco niveles de esfuerzo en la frontera de Pareto inteligencia-coste —la excepción es el nivel que nadie debería elegir por reflejo— y sus 5,98 USD por tarea pertenecen a max, no a medium. El test de pipeline de CodeRabbit halló que la configuración Standard (esfuerzo menor) batía a su propia configuración Max en el conjunto de 80 patrones con mejor precisión accionable y menos comentarios, mientras Max solo se adelantó en los 13 casos más duros de Signal. El patrón a través de las tres fuentes independientes es consistente: la función de valor de este modelo premia la selección deliberada de esfuerzo y castiga el reflejo. Para equipos pagando tarifas de Opus 5 —o de las Opus 4.8 legadas— el cambio es casi todo ventaja.
Dónde muerde
El esfuerzo máximo se come la rebaja
El mismo dial que abarata medium encarece max: unos 119k tokens de salida por tarea del índice de AA (4,4× GPT-6 Astra max, 1,6× Fable 5.1 max), 5,98 USD por tarea ponderada, verbosidad nº 95/212, 260M de tokens acumulados en toda la evaluación. CodeRabbit vio la misma forma en trabajo con perfil de producción: uso de tokens +49–60% frente a su línea base, con Max añadiendo un 57,6% (conjunto OSS) a un 60,1% (Signal) por precisión que a menudo no se necesitaba. Si tu arnés o tu hábito fija max, presupuesta dinero de buque insignia y mira también la reseña de Gemini 3.8 Flash para una alternativa deliberadamente frugal — y MiMo-V2.6-Pro para el coste medido por tarea más bajo de la cohorte reciente.
Menos código, errores más densos
Los números de SonarSource merecen su encuadre incómodo: el total de incidencias cayó un 42%, pero la densidad de errores por millón de líneas subió de 576 a 644, y los errores de concurrencia —la clase que aparece en producción, no en revisión— subieron un 44% hasta ser la categoría mayor (295/mLOC). Las tres densidades de severidad BLOCKER bajaron, lo cual tranquiliza de verdad, pero la forma es clara: 5.5 escribe código más compacto que no es uniformemente más seguro. Dos límites: la ejecución usó una build pre-lanzamiento (SonarSource repetirá con la disponibilidad general), y el hallazgo paralelo de CodeRabbit —11 patrones nuevos encontrados, 9 patrones de la línea base perdidos en el conjunto OSS— dice lo mismo desde el lado de la revisión. Mantén la revisión; muévela antes en el pipeline, no la borres.
Incremental sobre Fable, y lo desconocido que sigue desconocido
La evaluación de METR es la lectura independiente menos halagadora, y merece dos pasadas: mejoras sobre Fable 5.1 en las cinco tareas de I+D de IA, sin evidencia de automatización completa, y sin progreso mayor en las capacidades con forma de juicio — anticipación, predicción, construir bucles de feedback, criterio de investigación. Añade lo genuinamente desconocido: no existe latencia verificada (Artificial Analysis lista la velocidad como N/A para este modelo, así que esta reseña no cita ningún tiempo hasta el primer token), la disponibilidad en planes de consumo no está verificada, y las ejecuciones con salvaguardias pueden anular tareas, lo que significa que la configuración de seguridad de tu arnés es parte de tu capacidad medida. Un modelo con un día de vida llega con todo eso pegado. Nada descalifica; todo aboga por un piloto medido y no por un volteo de toda la flota.
Qué dijo la gente de verdad
La conversación del día uno se divide en dos ejes, no en uno.
Eje uno: por fin rápido — y por fin conversable. El hilo de velocidad y sus respuestas son deleite inequívoco; la entrevista filosófica es la versión cualitativa de lo mismo, describiendo pulido y ganas de mancharse las manos. Quien reconstruye flujos a su alrededor resume a la base: gente a la que gustaba el output de Opus 5 y odiaba la conversación.
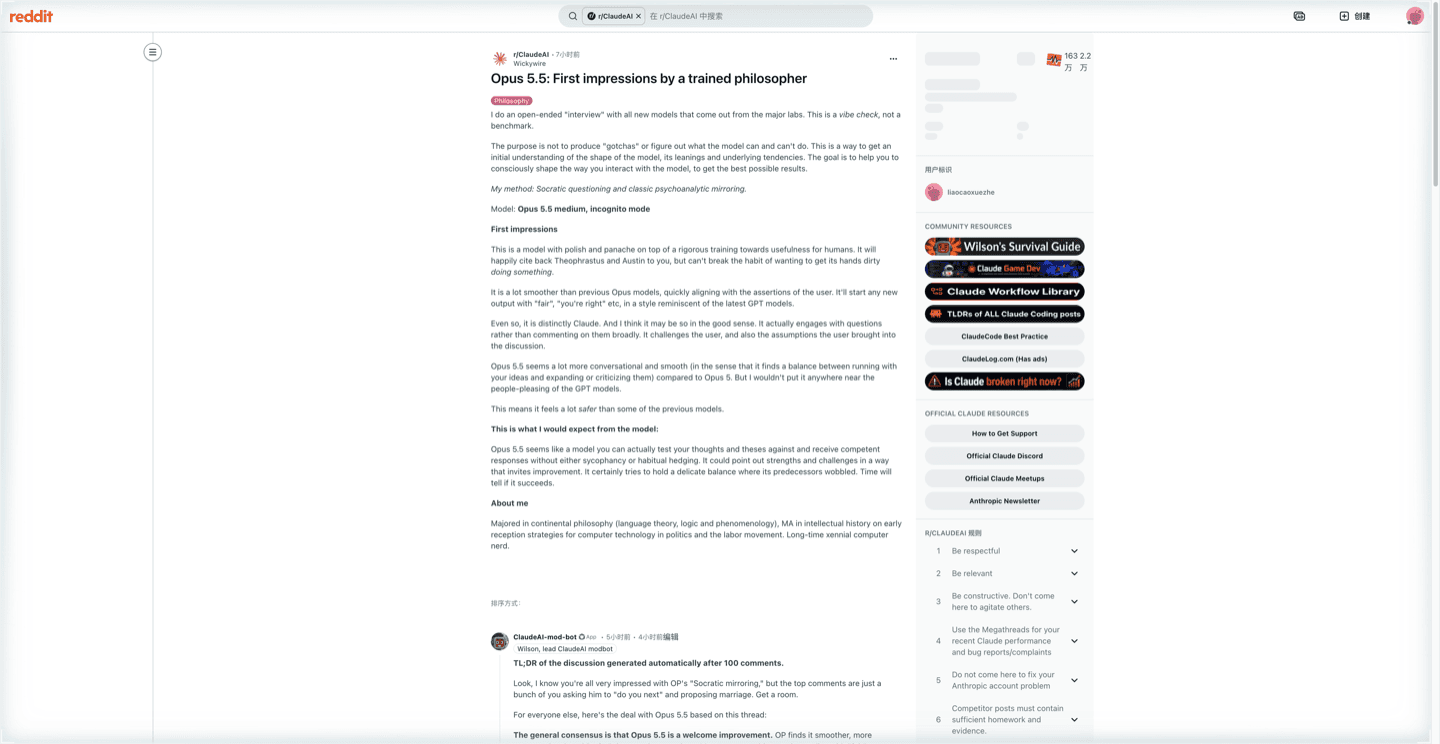
Hilo original: r/ClaudeAI 1wnkgie.
Eje dos: confía, pero verifica — el tejido cicatricial de Opus 5. El escepticismo del hilo ancla es específico: la gente fue quemada por un modelo que benchmarkaba bien y comunicaba mal, y no acepta números del día de lanzamiento como cierre. Un comentarista lee la intención de diseño con caridad — "Fable 5 & Opus 5 were designed & tested together with the intent being that you talk to Fable and it delegates execution to Opus agents" (u/canyonero7) — lo que plantea la pregunta real sobre 5.5: tiene precio de modelo de ejecución pero se vende como modelo de conversación, y ambos papeles en un solo modelo es justo lo que el hype del día uno no puede confirmar.
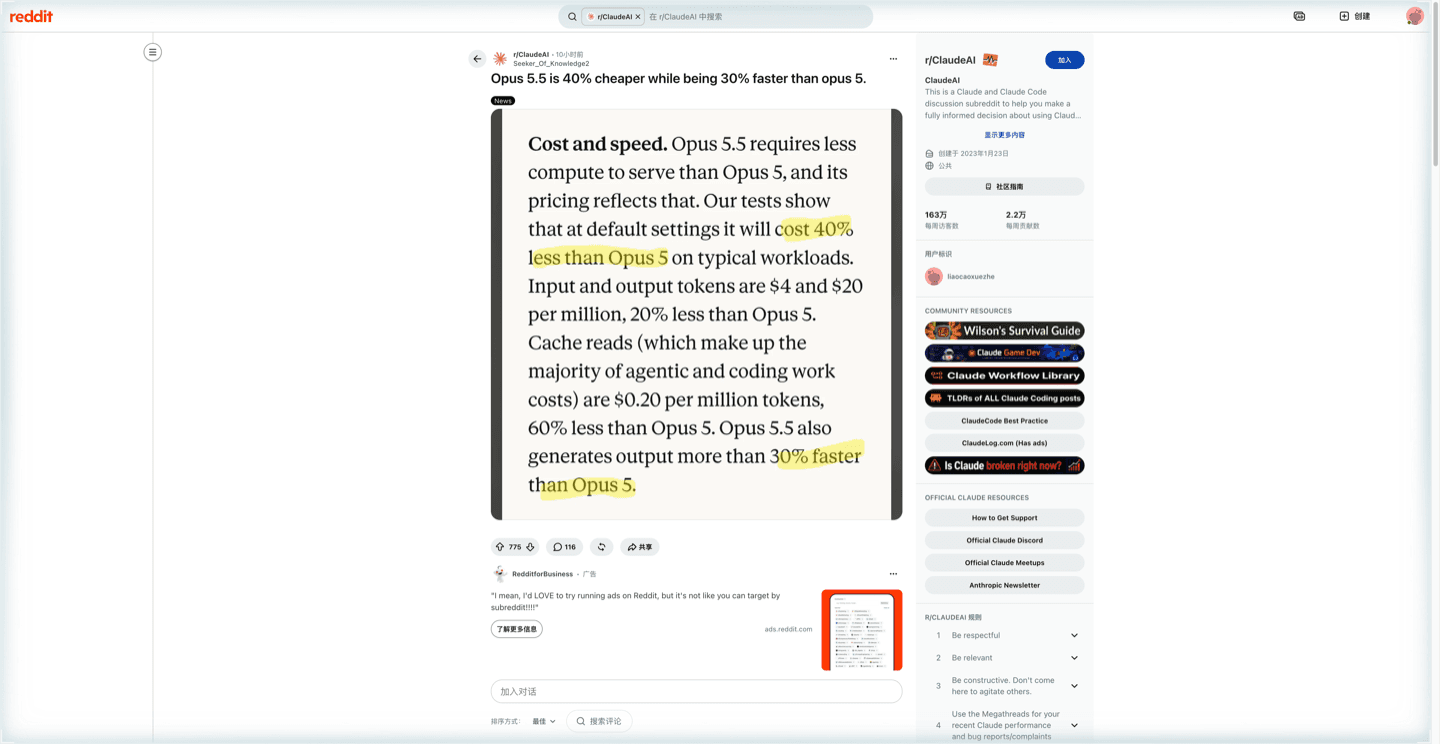
Hilo original: r/ClaudeAI 1wnf7sb.
Dónde aterriza esta reseña: con los entusiastas en la decisión de cambiar — la economía es demasiado unilateral para dejar trabajo nuevo en Opus 5 — y con los escépticos en el proceso. El autor de la fase de luna de miel tiene razón en que dos semanas de registros dirán más que cualquier tabla de arriba; también tiene razón en que ahora mismo, parece un salto real.
El veredicto: cambia tu trabajo Opus, conserva la disciplina
| Forma de la carga de trabajo | Veredicto | Por qué | Principal reserva |
|---|---|---|---|
| Trabajo agéntico de código por defecto hoy en Opus 5 o 4.8 | Cambia ya | Precios 20% menores, caché 60% más barata, conversación arreglada, TB-Science 29,0% → 58,7% | Fija el ID del modelo; remide cuando lleguen las re-ejecuciones GA |
| Frontera más dura e investigación de largo alcance | Escala a Fable 5.1 | METR: incremental sobre Fable; la propia presentación oficial es "nivel Fable en la mayoría del trabajo" | Los costes y rarezas de Fable son otra decisión |
| Ejecuciones largas sin supervisión, pipelines por lotes | Buena candidata en medium | Lecturas de caché a 0,20 USD + medium por defecto; frontera de Pareto de AA en 4 de 5 niveles | Sin latencia verificada — mide el primer token antes de apostar SLAs |
| Productos de chat interactivos | Mide primero | Latencia desconocida; la verbosidad a esfuerzo alto (nº 95/212) golpea directo a la experiencia y a la factura | AA marca velocidad N/A; aquí no se cita cifra alguna |
| Java o generación masiva de código sin revisión | Úsalo, con la revisión adelantada | Tasa plana, output más limpio, densidades BLOCKER a la baja | Densidad de errores 576 → 644/mLOC al alza; concurrencia +44% |
| Automatización con suelo de coste | Compara modelos más baratos | 4/20 USD es barato para la clase Opus, no en términos absolutos | MiMo a 0,13 USD/tarea o Gemini 3.8 Flash pueden encajar mejor en lo mecánico |
Dos notas sensibles al tiempo. Primera, todos los números independientes de este artículo son instantáneas del día uno: SonarSource probó una build pre-lanzamiento y repetirá en disponibilidad general; las clasificaciones de Artificial Analysis se mueven a diario. Segunda, la escalera familiar sigue llenándose — Sonnet 5 y Haiku 4.5 están por debajo de este lanzamiento, y la expresión "Claude 5.5 family" de Anthropic anuncia más miembros. Planifica el enrutado de modelos con un pin, no con un hábito.
Una ruta práctica: ejecútalo donde ocurre el trabajo
Todo lo anterior apunta a un patrón: la economía premia ejecuciones largas y multi-herramienta con esfuerzo deliberado, el modo de fallo es el volumen sin supervisión, y las preguntas abiertas —latencia, disponibilidad en el selector, estabilidad tras semanas— solo se responden ejecutando una tarea acotada, no leyendo una tabla más. Es un trabajo con forma de navegador: investigación multipágina, extracción y automatización donde un navegador agéntico sostiene las páginas y el contexto de la sesión mientras el modelo trabaja, con Tabbit Browser construido exactamente alrededor de ese bucle.
El límite honesto, igual que en nuestras otras reseñas de modelos: esta reseña no verificó si Opus 5.5 aparece en el selector de modelos de Tabbit Browser, y no se reclama ninguna ejecución práctica. Revisa el selector de tu cuenta, fija el ID del modelo, dale una tarea reversible — un cambio multi-archivo con un test existente, o un paquete de investigación con citas obligatorias — y registra el coste por resultado aceptado frente a Opus 5 antes de cambiar nada que te importe.
 Tabbit Browser
Fuentes
Anthropic: Introducing Claude Opus 5.5 — hechos de lanzamiento, precios, tabla de benchmarks, sección de seguridad (abierta el 2026-09-23)
Artificial Analysis: Claude Opus 5.5 y artículo de lanzamiento — índice 58 (nº 1/212), 5,98 USD/tarea, mediciones de verbosidad
METR: Predeployment evaluation of Claude Opus 5.5 — lectura de mejora incremental sobre Fable
SonarSource: Evaluating Claude Opus 5.5 on Java code generation — tasa de aprobación, tokens y densidad de errores (build pre-lanzamiento)
CodeRabbit: Opus 5.5 model review — contrapartidas de recall/precisión y uso de tokens
Hilos de Reddit: 1wnf7sb, 1wnil7n, 1wnkgie, 1wnkvys, 1wnh4fn

Preguntas frecuentes
¿Vale la pena Claude Opus 5.5?
Sí como tu modelo por defecto de la clase Opus. Apunta a un rendimiento de nivel Fable 5.1 en la mayoría del trabajo a 4 USD por millón de tokens de entrada y 20 de salida, un 20% menos que Opus 5, con lecturas de caché a 0,20 USD. Reserva Fable 5.1 para las tareas frontera más difíciles y evita activar el esfuerzo máximo por reflejo: la verbosidad medida ahí puede comerse el ahorro.
¿Es Claude Opus 5.5 más barato que Opus 5?
Los precios de lista bajan un 20% en entrada (4 USD frente a 5) y salida (20 frente a 25), y las lecturas de caché caen de 0,50 a 0,20 USD por millón de tokens. Anthropic afirma un coste total unos 40% menor en cargas típicas según sus propias pruebas. El ahorro real depende del nivel de esfuerzo y de la mezcla de tokens, así que mide una tarea representativa.
¿Es Opus 5.5 mejor que Fable 5.1?
Anthropic dice que Opus 5.5 rinde al nivel de Fable 5.1 en la mayoría del trabajo y cuesta menos de ejecutar. Las verificaciones independientes matizan: METR califica la mejora en I+D de IA como incremental sobre Fable 5.1, mientras que Artificial Analysis puntúa a Opus 5.5 con 58, el primero de su instantánea de 212 modelos. Léelo como casi paridad a menor coste, no como victoria clara.
¿Es bueno Claude Opus 5.5 para programar?
La tabla de lanzamiento reporta 66,4% en Terminal-Bench 4.0 con un error estándar de unos 2,6 puntos y 57,8% en CursorBench 4.0. El test de Java de SonarSource halló una tasa de aprobación parecida a la de Opus 5 (87,68% vs 88,6%) con menos código pero mayor densidad de errores, así que mantén la revisión de código en lugar de confiar a ciegas.
¿Por qué Claude Opus 5.5 consume tantos tokens?
Al esfuerzo máximo, Artificial Analysis midió unos 119.000 tokens de salida por tarea del Índice de Inteligencia, más de cuatro veces los ~27.000 de GPT-6 Astra, ubicando a Opus 5.5 en el puesto 95 de 212 en verbosidad. El esfuerzo por defecto es medium, y SonarSource midió un 40% menos de tokens de salida que Opus 5 en generación Java, así que el consumo depende del esfuerzo y de la carga.
¿Cuándo se lanzó Claude Opus 5.5 y dónde está disponible?
Anthropic lo lanzó el 22 de septiembre de 2026, con ID de modelo claude-opus-5-5, contexto de 1M de tokens y hasta 128K de salida. La página de lanzamiento lista Anthropic Claude Platform, AWS, Google Cloud y Microsoft Azure. La disponibilidad en planes de consumo no se verificó para esta reseña.
¿Puedo usar Claude Opus 5.5 en Tabbit Browser?
Esta reseña no verificó si Opus 5.5 aparece en el selector de modelos de Tabbit, así que no planifices en torno a ello. Revisa el selector de tu propia cuenta y ejecuta una tarea reversible antes de confiarle un flujo de trabajo.