
Claude Opus 5.5는 한동안 없었던 가장 쉬운 Opus 결정이다. 기본 Opus 작업을 옮겨라. Anthropic은 2026년 9월 22일 이를 출시하며 백만 토큰당 입력 4달러·출력 20달러 — Opus 5보다 20% 낮은 가격 — 을 매기고 "대부분의 작업에서 Claude Fable 5.1 수준"이며 "실행 비용은 Opus 5보다 40% 낮다"고 내세웠다. 출시 다음 날의 독립 기록은 이 문구를 대체로 뒷받침한다. 단 두 가지 단서가 있다. 최대 노력 수준에서는 말이 많아 할인을 먹어치울 만큼이고, 자세히 보면 Fable 5.1 대비 능력 향상은 점진적이지 새 천장이 아니라는 것.
이 구도는 허공에서 만든 마케팅이 아니다. 출시 몇 시간 만에 r/ClaudeAI 최다 추천 스레드의 제목은 "Opus 5.5 is 40% cheaper while being 30% faster than opus 5"였다 — 추천 775개. 커뮤니티가 공식 숫자를 구매 논거로 복창한 형국이다. 같은 스레드의 최상위 댓글이 반응이 이리 격렬한 이유를 설명한다. Opus 5는 "couldn't even communicate properly"였고 사람들은 "wasting even more time and tokens"하며 씨름했다(u/Front_Raspberry_6488, 추천 226). 이 리뷰는 그런 감정 중 무엇이 증거를 통과하는지 가려낸다.
아래 모든 사실은 2026년 9월 23일, 출시 다음 날 열어서 대조했다. Anthropic 출시 페이지, Artificial Analysis 모델 페이지, 그리고 각 Reddit 원문 스레드. Claude Opus 5.5 모델 리소스 (English)에 프롬프트와 증거 라이브러리가 있고, 리뷰 증거 카드 (English)가 이 글의 1차 기록이다. 아직 Opus 5.5의 가격 페이지나 대안 페이지는 없어서, 이 리뷰는 존재하지 않는 형제 페이지를 링크하지 않는다. 마지막에는 이 결과가 브라우저 수준 워크플로에서 무엇을 의미하는지 다룬다 — 이런 모델의 일터가 점점 그쪽으로 옮겨 가고 있다.
핵심 요약
핵심 숫자는 40%이고, 이는 가격표가 아니라 워크로드 주장이다. 가격은 20% 내렸고(4/20달러) 캐시 읽기는 60% 내렸다(0.20달러/M). "실행 비용 40% 절감"은 Anthropic 자체의 일반 워크로드 테스트에서 나온 것 — SonarSource는 Java 생성에서 문자 그대로 40% 적은 출력 토큰을 독립 측정했고, Artificial Analysis는 최대 노력 수준에서 과제당 5.98달러를 측정했다.
독립 리더보드 1위, 대가는 장황함. Artificial Analysis는 Opus 5.5(최대 노력)에 58점, 212개 모델 중 1위를 줬다. 동시에 장황함은 95위: 지수 과제당 약 11.9만 출력 토큰은 GPT-6 Astra 최대 수준의 약 2.7만 대비 4배 이상이다.
Opus 5를 침몰시킨 소통 문제는 해결된 것으로 보인다. Opus 5에 대한 가장 큰 불만은 일은 잘하는데 대화가 안 된다는 것이었다. 첫날 목소리는 5.5를 빠르고 자연스럽고 군더더기 없다고 묘사하고, SonarSource는 생성 Java의 주석 비율이 10.5%에서 3.1%로 떨어졌다고 측정했다.
코드는 적어지고 결함은 촘촘해진다. SonarSource의 출시 전 빌드 테스트에서 코드량 27.5% 감소, 문제 총수 42% 감소, 통과율은 동급. 그러나 백만 줄당 결함 밀도는 576에서 644로 올랐고 동시성 결함은 44% 증가. 리뷰는 여전히 필수다.
METR의 판정: 도약이 아니라 점진. 사전 배포 평가는 AI R&D 5개 과제에서 Fable 5.1 대비 소폭 향상을 확인했고, 판단형 역량(선견, 피드백 루프, 연구 안목)의 약점은 그대로다. 5.5는 경제성과 마감을 위해 사고, 한계에 부딪히면 Fable로 올려라.
Claude Opus 5.5는 실제로 무엇인가
Claude Opus 5.5는 Anthropic의 새 Claude 5.5 패밀리 첫 모델로 2026년 9월 22일 출시됐다. API 모델 ID는 claude-opus-5-5. 출시 페이지는 Anthropic Claude Platform, AWS, Google Cloud, Microsoft Azure를 제시한다. 문서상 규격은 컨텍스트 100만 토큰, 최대 12.8만 토큰 출력, adaptive thinking, 그리고 기본 노력 수준이 medium — 이 마지막 디테일이 이 리뷰의 어떤 벤치마크 행보다 중요하다.
| 항목 | 공개 스냅샷(2026-09-23 대조) | 증명하지 못하는 것 |
|---|---|---|
| 출시와 모델 ID | 2026-09-22; claude-opus-5-5 | 모든 클라이언트가 동일 빌드와 노력 범위를 노출 |
| 입력 / 출력 가격 | 백만 토큰당 4 / 20달러 | 사고와 재시도를 거친 과제당 완료 비용 |
| 캐시 읽기 / 쓰기 | 백만당 0.20 / 5달러(Opus 5: 0.50 / 6.25) | 모든 워크로드에서의 일률적 40% 절감 |
| 컨텍스트와 출력 | 입력 100만, 출력 최대 12.8만 | 모든 제공자·플랜이 전체 창을 제공 |
| 노력 수준 | adaptive thinking; 기본 medium | 낮은 노력에서 같은 점수 유지(과제별 곡선 미공개) |
| 가용성 | Anthropic, AWS, Google Cloud, Azure | 소비자 플랜. 여기서 미확인 |
| 독립 스냅샷 | Artificial Analysis: 58점, 212개 중 1위(최대) | 속도: AA가 이 모델의 지연을 N/A로 표기 |
Anthropic은 절차적 각주도 달았다. 회사가 "pacing the frontier"(프론티어 속도 조절)를 촉구한 이후 첫 출시라는 것, Frontier Design과 METR을 포함한 외부 평가자의 사전 테스트를 거쳤다는 것. Anthropic 자체 자동화 행동 감사(약 2,000 시나리오)에서 Opus 5.5는 "지금까지 테스트한 것 중 최고 성적"이고, 하나의 격리 경계 평가에서는 Opus 5나 Mythos 5.1보다 경계 우회 시도가 약 85% 적었다. 안전 측면 주장으로 기록할 가치가 있고, 양날이다. 뒤에서 보듯 세이프가드 개입은 능력 벤치마크에서 0점으로도 이어진다.
이 리뷰가 답하는 질문은 "똑똑한가"가 아니다. 제조사 표와 독립 1위가 이미 그렇다고 한다. 묻는 것은 실용마 가격에 플래그십급으로 선전되는 모델이 일상 워크플로에 자리 잡을 만한가다 — Opus 5 요금을 유지하는 것, Fable 5.1 가격을 지불하는 것, 기계적 작업을 GPT-5.6 Sol이나 MiMo-V2.6-Pro 같은 저렴한 모델로 넘기는 것과 비교해서.
이 리뷰를 결정하는 숫자: 40%
Anthropic의 기조 문장은 출시 페이지에서 원문 대조했다. Opus 5.5는 "performs at the level of Claude Fable 5.1 on most work and costs 40% less to run than Opus 5". 한 문장에 검증 가능한 주장이 둘 — 플래그십에 가까운 능력, 실용마의 경제성.
가격 부분은 공개되어 있고 단순하다. 입력은 5→4달러, 출력은 25→20달러, 캐시 읽기는 백만당 0.50→0.20달러. 캐시 읽기가 에이전트 작업에서 가장 큰 영향을 주는 이유는, 도구 호출 40번짜리 실행이 캐시된 접두사를 40번 다시 읽기 때문이다. 0.20달러 — 입력가의 5%, Artificial Analysis가 표기한 95% 캐시 할인 — 는 긴 세션을 구조적으로 싸게 만든다. Fable 5.1 출시를 장식했던 캐시 인하와 같은 레버를 더 밀어내린 것이다.
40% 부분에는 작은 글씨가 가득하고, 세 개의 독립 측정이 양쪽에서 조인다.
회수됨: SonarSource의 Java 생성(출시 전 빌드, High)은 출력 1,296만 토큰으로 Opus 5의 2,171만 대비 문자 그대로 40% 감소를 기록했다 — 통과율 차이는 1점 미만(87.68% 대 88.6%). 코드도 적고 토큰도 적고 기능 결과는 동일. 할인이 설계대로 작동한 모습이다.
소진됨: Artificial Analysis가 지능지수를 최대 노력으로 돌리자 과제당 약 119,000 출력 토큰이 나왔다 — Opus 5 최대 약 7.3만, Fable 5.1 최대 약 7.8만, GPT-6 Astra 최대 약 2.7만 대비 — 가중 과제당 비용 5.98달러, 장황함 212개 중 95위. 모델이 최대 음량으로 생각하도록 내버려뒀을 때 할인이 소진되는 모습이다.
중간: Anthropic 내부 M&A 분석 과제는 63분에 끝났고(Opus 5는 93분) "실행 비용 50% 감소" — 제조사 자체 테스트로, 주장값 그대로.
이 셋을 조율하는 건 모순이 아니라 노력 다이얼이다. 기본이 medium인 데는 이유가 있다. 40% 할인은 진짜고, 그걸 회수할지는 대부분 당신의 워크플로가 반사적으로 어느 수준을 쓰는지에 달렸다. METR의 능력 판정이 반대쪽에서 같은 결론을 뒷받침한다 — Fable 5.1 대비 점진적이므로 갈아타는 이유는 경제성과 마감이지 새 천장이 아니다. "최고 모델엔 최대 노력"이라는 이유로 max를 고정하는 파이프라인은 이미 스스로를 플래그십 영역으로 재가격한 것이다.
리더보드 이전, 실제 작업에서 일어난 일
첫날의 가장 유용한 증거는 벤치마크 행이 아니라, 이름과 한계가 명시된 세 개의 제작 스토리다.
45분 원테이크 영화. u/mshort3는 기존 창작 프로젝트 안에서 Claude Code에 한 문장 — "Lets make a ~70s riso film of your own choosing, free range" — 을 주었고, Opus 5.5가 약 45분의 단일 실행으로 78초짜리 애니메이션 기차 여행을 만들었다고 보고했다(r/ClaudeAI, 추천 637). 저장소는 공개되어 있고 저자는 공을 모델이 아니라 프로젝트 자체의 스킬과 문서에 돌린다. 실행 1회, 중간 상태 로그 없음.
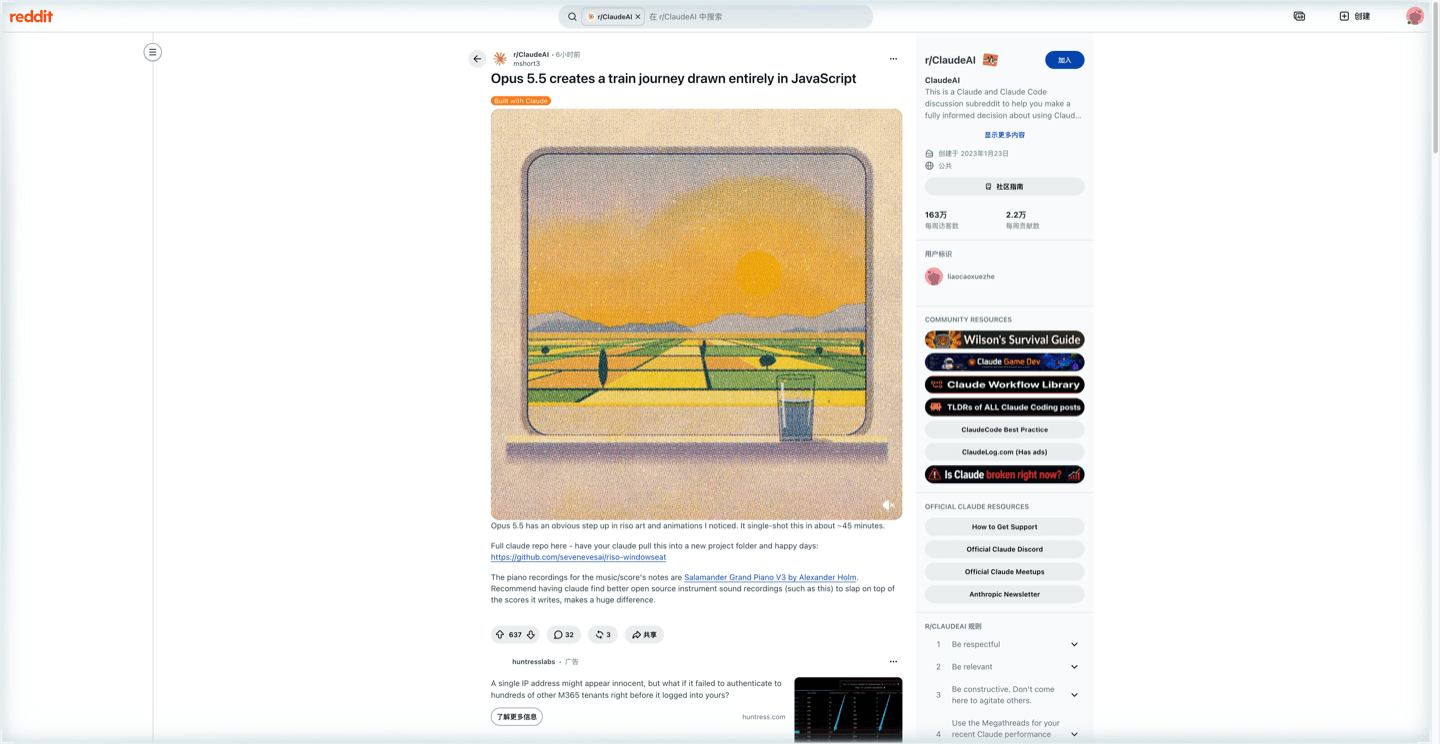
원문 스레드: r/ClaudeAI 1wnkvys.
프롬프트 하나로 1분 영상 — 비용 영수증 포함. u/AzorAhai1TK는 "an average day at work… with a twist"를 기묘한 1분 영상으로 렌더링해 달라고 했고, 모델이 Extra-High 수준에서 코딩부터 렌더링까지 약 45분, 월 20달러 플랜의 주간 한도 약 4%를 썼다고 보고했다(r/ClaudeAI). 자가 보고 숫자지만, 이 한도 데이터야말로 가격 논쟁에 필요한 것이다. 창작형 최대 노력 실행은 공짜도 재난도 아니다.
Claude Code에서의 "night and day" 속도 — 주의문은 저자가 직접 붙였다. u/Lazy_Assistance_1137는 한참 잡아야 했던 UI 버그가 "in no time"에 잡히고 향상이 "night and day"라 했다 — 곧바로 "this could just be the classic day-one honeymoon phase, and in two weeks we'll all be back to posting 'did they nerf it?' threads"라며 스스로 냉수를 끼얹었다(r/ClaudeAI, 추천 273). 최상위 답글은 한 단어 깊이다. "It's crazy fast. I'm impressed."(u/capivara_de_pijama, 추천 96).
원문 스레드: r/ClaudeAI 1wnil7n.
세 이야기, 각각 n=1, 로그 없음, 토큰 계수 없음(그 4% 제외). 증명되는 것: 출시 첫날 이 모델이 길고 자율적인 다중 도구 창작을, 반복적으로, 공개적으로, 열어볼 수 있는 결과물과 함께 완수했다는 것. 증명되지 않는 것: 그 빈도. 벤치마크가 채워야 할 빈자리가 바로 그것이다 — 실제로 얼마나 채우는지 보자.
벤치마크, 그리고 얼마나 믿을지
Anthropic 출시 표를 2026-09-22 공개 그대로 기록한다. 서로 다른 열은 서로 다른 운영자와 리더보드에서 왔을 수 있다(GPT-6 Astra와 GPT-5.6 Sol 수치는 Anthropic이 OpenAI 보고서 출처라고 명시). 열 간 산술이 아니라 행으로 읽어라:
| 영역 / 벤치마크 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|
| 에이전트 코딩: Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 37.3% |
| 에이전트 코딩: FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% | 47.5% |
| 에이전트 코딩: CursorBench 4.0 | 57.8% | 51.8% | 46.6% | — | 41.7% |
| 지식 노동: GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 1588 |
| 비즈니스 워크플로: AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 28.8% |
| 추론: Humanity's Last Exam(도구 포함) | 67.7% | 65.6% | 63.6% | 57.2% | — |
| 에이전트 과학: Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 22.4% |
| 컴퓨터 사용: OSWorld 2.0(부분) | 81.8% | 80.7% | 74.0% | — | — |
| 차트 인식: Chartography(도구 포함) | 89.0% | 88.4% | 83.4% | — | — |
이제 냉수 세 방.
오차 범위는 공개되어 있고 넓다. Terminal-Bench 4.0의 Opus 5.5 표준오차는 ±2.6포인트, Terminal-Bench-Science는 모델당 ±3.5–5포인트. TB-Science의 Opus 5 → Opus 5.5(29.0% → 58.7%) 도약은 어떤 오차대도 건드리지 못하고, 같은 행의 GPT-6 Astra(64.6%)와의 격차도 건드리지 못한다 — Astra 유리 방향으로. Anthropic 스스로 페이지에 "현재 능력 수준에서는 벤치마크 점수 차이가 실제 격차를 신뢰성 있게 대표하지 않을 수 있다"고 적었다. 제조사 입에서 나온 이 문장이 이번 시즌 그 어떤 출시 표보다 정직하다.
비교 조건은 균일하지 않다. Terminal-Bench 행은 Claude Code 하니스를 사용하고, AutomationBench는 Zapier가 폴백 모델 없이 실행·보고해 세이프가드 개입이 실패로 계수됐으며, GDPval-AA v2.1의 독립 채점 과정은 페이지에 상세가 없다. 가드가 개입한 과제는 0점이 될 수 있다 — 정책 결과가 능력 실패로 기록되는 것이다. 이것이 표를 틀리게 만들지는 않지만, 통제된 경주가 아니라 조건이 제각각인 스냅샷 묶음으로 만든다.
독립 기록은 모양은 동의하고 폭은 동의하지 않는다. Artificial Analysis 자체 지수(v4.3.2, 10개 평가)는 Opus 5.5 최대에 58점, 212개 중 1위. 6개 평가에서 단독 선두(Humanity's Last Exam 61.4%, SciCode 66.9%, GDPval-AA 1846, AA-Briefcase 1822 — Fable 5.1 대비 +143 Elo)이고 Terminal-Bench 4.0은 59.6%로 GPT-6 Astra xhigh와 동률. SonarSource의 통제 Java 테스트가 가장 날카로운 단일 데이터다. 통과율은 Opus 5와 1점 미만 차이, 코드는 27.5% 적게 — 그러나 줄당 결함 밀도는 상승, 뒤에서 다룬다. METR의 사전 배포 평가(영업일 10일, AI R&D 5개 과제)는 Fable 5.1 대비 향상이 "incremental… rather than a discontinuous leap"이며 선견·피드백 루프 구축·연구 판단에 큰 진전이 없다고 결론짓는다.
냉수를 맞고도 남는 것: Opus 5 대비 격차는 크고 진짜다(TB-Science 29.0% → 58.7%는 반올림 트릭이 아니다). 독립 1위에는 제2 출처가 있다. 비용 스토리에는 완전한 독립 재현이 하나 있다(SonarSource의 토큰 계수). 남지 않는 것: "Opus 5.5가 GPT-6 Astra를 완전히 이긴다"류의 주장. Anthropic 자체 표에서 Opus 5.5는 Terminal-Bench 4.0을 가져가고 Astra는 Terminal-Bench-Science를 가져간다. Artificial Analysis의 독립 TB-4.0에서 둘은 59.6% 동률. GPT-6 Astra 리뷰에서 그 모델의 트레이드오프를 따로 다룬다.
Opus 5.5가 진짜 좋은 곳
드디어 동료처럼 말한다
어떤 벤치마크 행도 담지 못하는 강점. Opus 5는 코드는 강한데 대화가 싫었던 모델이고, 첫날 목소리는 5.5가 대화 자체를 고쳤다고 한다. 앵커 스레드의 상위 댓글은 옛 상처의 부검 — "Opus is fantastic, just until you have to talk to it"(u/Neon_Camouflage, 추천 61) — 와 안도의 짝. "Heard Opus 5.5 is less verbose"(u/No-Temperature6597). SonarSource의 분석기는 이 행동 변화에 숫자를 붙였다. 생성 Java의 주석 비율이 줄의 10.5%에서 3.1%로, 코드스멜 밀도는 21% 감소. 훈련된 철학자의 분위기 점검(medium, 시크릿 모드)은 "a model with polish and panache… It will happily cite back Theophrastus and Austin to you, but can't break the habit of wanting to get its hands dirty"라고 묘사한다(u/Wickywire). 글쓰기와 기획으로 먹고사는 사람 — 컴파일만 하는 사람 말고 — 에게 이것은 어떤 코딩 점수보다 중요한 업그레이드다.
에이전트 완수력, Opus 가격에
공식 표의 무게중심이고, 버틴다. Terminal-Bench 4.0 66.4%, TB-Science 58.7%(둘 다 공개된 오차대 안), 하니스는 Claude Code. CursorBench 4.0 57.8%, OSWorld 2.0 부분 81.8%가 컴퓨터 사용을 덮는다. 내부 사례는 제조사 증거치고 이례적으로 구체적이다. 분기 실적 과제에서 18개 보고서 중 16개가 숫자와 인용을 하나하나 검증하는 채점기를 통과했고 Fable 5.1과 Opus 5의 시도는 둘 다 떨어졌다. 가상 M&A 분석은 63분(Opus 5는 93분), 비용 약 절반. 제조사 자체 테스트지만, 길고·다중 파일·검증이 많은 — 터미널 점수가 재는 바로 그 일의 형태다. 에이전트 연구와 깊은 작업에 4/20달러의 이 프로파일은 이번 출시에서 가장 단단한 논거다.
medium의 경제성은 조용한 헤드라인
기본 medium과 0.20달러 캐시 읽기는 긴 세션의 단위 경제를 바꾸는데, 표지 가격으로는 보이지 않는다. Artificial Analysis는 노력 수준 5개 중 4개를 지능-비용 파레토 프론티어에 올렸다 — 예외는 아무도 반사적으로 골라선 안 되는 수준 — 이고 5.98달러/과제는 max 것이지 medium 것이 아니다. CodeRabbit의 파이프라인 테스트에서 Standard 구성(낮은 노력)은 80패턴 집합에서 자사 Max 구성을 더 나은 실행 가능 정확도와 더 적은 댓글 수로 이겼고, Max가 앞선 것은 가장 어려운 Signal 13건뿐이었다. 세 독립 출처의 모양이 일치한다. 이 모델의 가치 함수는 의도적인 노력 선택에 보상하고 반사에 벌점을 준다. 아직 Opus 5나 구형 Opus 4.8 요금을 내는 팀에게 이 전환은 사실상 공짜 상승이다.
물기 시작하는 곳
max는 할인을 태운다
medium을 싸게 만드는 다이얼이 max를 비싸게 만든다. AA 지수 과제당 약 119k 출력 토큰(GPT-6 Astra max의 4.4배, Fable 5.1 max의 1.6배), 가중 과제당 5.98달러, 장황함 95/212위, 평가 전체 누적 2.6억 토큰. CodeRabbit은 실전 형태의 작업에서 같은 모양을 봤다. 토큰 사용량은 자사 기준 대비 +49–60%, Max는 OSS 집합 +57.6%, Signal 집합 +60.1%를, 흔히 필요 없는 정확도를 위해 더했다. 하니스나 습관이 max를 고정한다면 플래그십 예산을 잡고, 의도적으로 검소한 대안으로 Gemini 3.8 Flash 리뷰를, 최근 코호트에서 가장 싼 실측 과제당 비용으로 MiMo-V2.6-Pro를 함께 보라.
코드는 적고 결함은 더 촘촘하다
SonarSource의 숫자에는 불편한 액자가 필요하다. 문제 총수는 42% 줄었지만 백만 줄당 결함 밀도는 576 → 644로 올랐고, 동시성/스레드류 — 리뷰가 아니라 운영에서 드러나는 부류 — 는 44% 증가해 최대 카테고리가 됐다(295/mLOC). 최고 심각도 BLOCKER 밀도는 세 가지 모두 하락해 이건 진짜 안심 포인트지만, 모양은 분명하다. 5.5의 코드는 더 조밀하지만 균일하게 더 안전하지는 않다. 경계가 둘 있다. 이 테스트는 출시 전 빌드이고(SonarSource는 정식 제공 후 재실행 예정), CodeRabbit의 평행 발견 — OSS 집합에서 새 패턴 11개 발견, 기준선이 잡던 9개 놓침 — 이 리뷰 쪽에서 같은 말을 한다. 리뷰를 남기고 파이프라인 앞쪽으로 옮겨라. 지우지는 마라.
Fable 대비 점진, 그리고 모르는 것은 여전히 모른다
METR 평가는 가장 인색한 독립 판정이고 두 번 읽을 가치가 있다. AI R&D 5개 과제에서 Fable 5.1을 모두 소폭 앞서지만 완전 자동화의 증거는 없고, 판단형 능력 — 선견, 예측, 피드백 루프 구축, 연구 안목 — 에 큰 진전이 없다. 진짜로 모르는 것도 더하라. 검증된 지연 시간이 없다(Artificial Analysis가 이 모델 속도를 N/A로 표기하므로 이 리뷰는 첫 토큰 수치를 인용하지 않는다). 소비자 가용성은 미확인. 가드가 붙은 실행은 과제를 0점으로 만들 수 있어서, 당신 하니스의 안전 설정은 측정된 능력의 일부다. 하루 산 모델은 이 모든 것을 짊어지고 출하된다. 실격 사유는 하나도 없고, 전부 일괄 전환이 아니라 측정된 시험 도입을 가리킨다.
사람들은 실제로 뭐라고 했나
첫날 담론은 한 축이 아니라 두 축으로 갈라진다.
축 하나: 드디어 빠르다 — 그리고 드디어 대화가 된다. 속도 스레드와 그 답글은 명백한 환호고, 철학 인터뷰는 같은 것의 정성판이다. 마감과 손에 흙 묻히려는 성향을 묘사하고, 주변에서 워크플로를 재구축하는 사용자가 지지층을 요약한다. Opus 5의 산출물은 좋아했지만 대화는 혐오하던 사람들.
원문 스레드: r/ClaudeAI 1wnkgie.
축 둘: 신뢰하되 검증하라 — Opus 5의 반흔 조직. 앵커 스레드의 회의는 구체적이다. 사람들은 벤치마크는 좋고 소통은 나빴던 모델에 데였고, 출시일 숫자를 종결로 받아들이지 않는다. 한 댓글은 설계 의도를 선의로 읽는다 — "Fable 5 & Opus 5 were designed & tested together with the intent being that you talk to Fable and it delegates execution to Opus agents"(u/canyonero7) — 이것이 5.5를 둘러싼 진짜 질문을 세운다. 실행 모델 가격으로 책정되고 대화 모델로 선전한다. 하나의 모델이 두 역할을 다 하는 것은 바로 출시일 열광이 증명할 수 없는 부분이다.
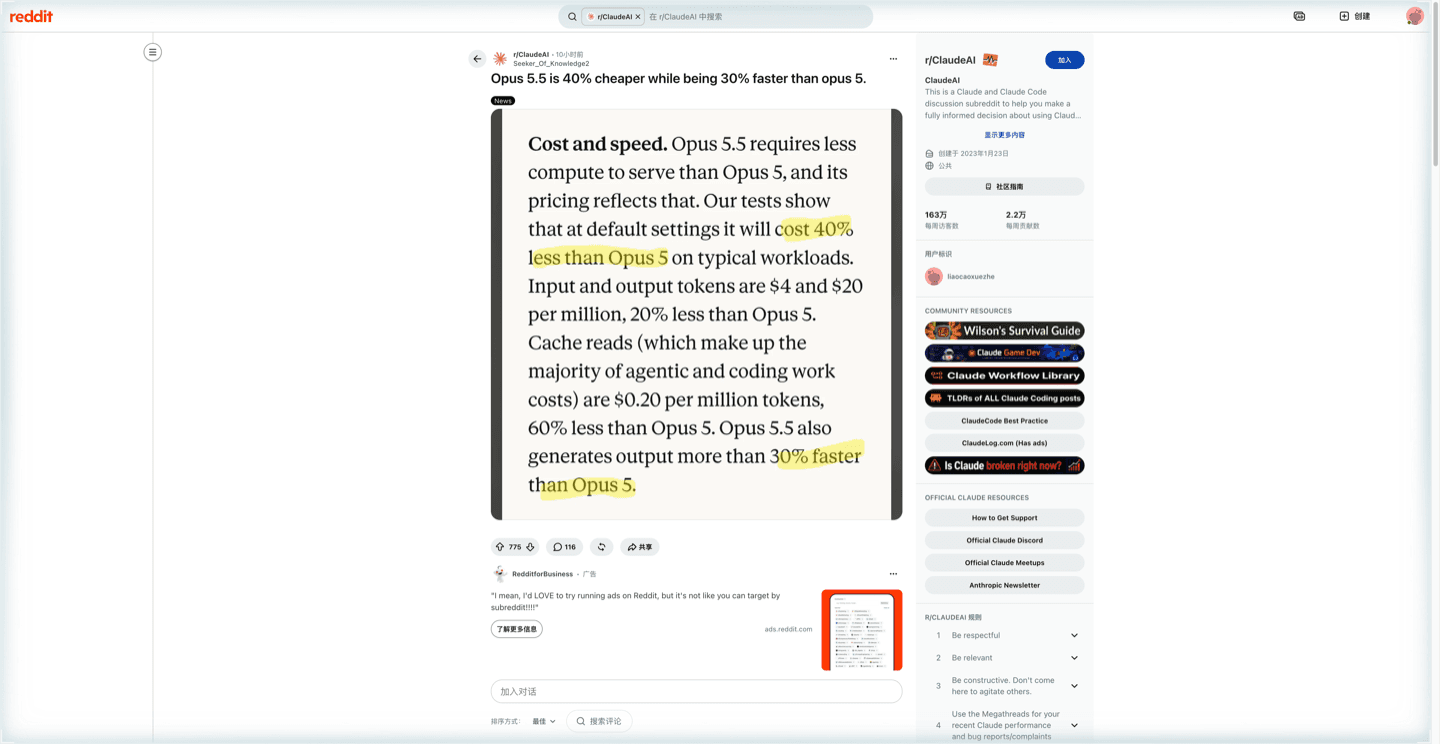
원문 스레드: r/ClaudeAI 1wnf7sb.
이 리뷰의 착지: 전환 결정은 환호 쪽과 함께 — 경제성이 한쪽으로 기울어 새 작업을 Opus 5에 둘 이유가 없다. 과정은 회의 쪽과 함께. 신혼기 저자가 옳다. 2주 치 로그가 위 어떤 표보다 말해줄 것이며, 지금 이 순간 실제 도약처럼 느껴진다는 점에서도 옳다.
결론: Opus 작업은 옮기고, 규율은 남겨라
| 워크로드 형태 | 결론 | 이유 | 주요 단서 |
|---|---|---|---|
| 현재 Opus 5 / 4.8에서 도는 기본 코딩 에이전트 작업 | 지금 전환 | 가격 20%↓, 캐시 60%↓, 소통 수선, TB-Science 29.0% → 58.7% | 모델 ID 고정. GA 재실행 후 재측정 |
| 가장 어려운 프론티어·장기 연구 | Fable 5.1로 승격 | METR: 점진적. 공식 문구 자체가 "대부분 Fable 수준" | Fable의 비용과 버릇은 별개 결정 |
| 무인 장기 실행, 배치 파이프라인 | medium의 좋은 후보 | 캐시 읽기 0.20달러 + 기본 medium. AA 파레토 5레벨 중 4 | 검증된 지연 없음 — SLA 걸기 전 첫 토큰 자체 측정 |
| 대화형 챗 제품 | 먼저 측정 | 지연 미지. 높은 노력의 장황함(95/212위)이 경험과 청구서를 직격 | AA 속도 N/A. 이 리뷰는 숫자를 인용하지 않는다 |
| 리뷰 없는 Java·대규모 코드 생성 | 쓰되 리뷰 전진 | 통과율 동급, 출력 간결, BLOCKER 밀도 하락 | 결함 밀도 576 → 644/mLOC 상승, 동시성 +44% |
| 비용 바닥 자동화 | 더 싼 모델과 비교 | 4/20달러는 Opus급으론 싸도 절대값은 안 싸다 | 기계 작업엔 MiMo 0.13달러/과제나 Gemini 3.8 Flash가 맞을 수 있다 |
시효성 노트 둘. 첫째, 이 글의 모든 독립 수치는 첫날 스냅샷이다. SonarSource는 출시 전 빌드를 테스트했고 정식 제공 후 재실행을 약속했으며, Artificial Analysis 순위는 매일 움직인다. 둘째, 패밀리 사다리는 아직 채워지는 중 — Sonnet 5와 Haiku 4.5는 이번 출시 아래에 있고, Anthropic의 "Claude 5.5 family"라는 표현은 추가 멤버를 시사한다. 모델 라우팅은 습관이 아니라 핀으로 계획하라.
실전 경로: 일이 일어나는 곳에서 돌려라
위의 모든 것이 하나의 모양을 가리킨다. 경제성은 길고·다중 도구·의도적 수준 선택의 실행에 보상하고, 실패 모드는 무감독 물량이며, 미해결 질문 — 지연, 선택기 가용성, 몇 주 뒤 안정성 — 은 표를 한 장 더 읽어서가 아니라 경계 있는 과제를 하나 돌려서만 답할 수 있다. 이건 브라우저 모양의 일이다. 다중 페이지 조사·추출·자동화를 에이전트 브라우저가 세션의 페이지와 맥락을 붙잡고 그 안에서 모델이 일한다. Tabbit Browser는 정확히 이 루프를 중심으로 만들어졌다.
다른 모델 리뷰와 같은 정직한 경계. 이 리뷰는 Opus 5.5가 Tabbit Browser의 실시간 모델 선택기에 나타나는지 확인하지 못했고 어떤 실사 실행도 주장하지 않는다. 자기 계정의 선택기를 확인하고, 모델 ID를 고정하고, 되돌릴 수 있는 작업 하나 — 기존 테스트 붙은 다중 파일 변경이나 인용 필수 조사 패키지 — 를 주고, '수용 가능한 결과당 비용'을 Opus 5와 비교한 뒤 아끼는 것을 옮겨라.
 Tabbit Browser
출처
Anthropic: Introducing Claude Opus 5.5 — 출시 사실, 가격, 벤치마크 표, 안전 섹션(2026-09-23 열람)
Artificial Analysis: Claude Opus 5.5 및 출시 글 — 지수 58(1/212위), 5.98달러/과제, 장황함 측정
METR: Predeployment evaluation of Claude Opus 5.5 — "Fable 대비 점진적" 판정
SonarSource: Evaluating Claude Opus 5.5 on Java code generation — 통과율, 토큰, 결함 밀도(출시 전 빌드)
CodeRabbit: Opus 5.5 model review — 재현율/정밀도와 토큰 트레이드오프

자주 묻는 질문
Claude Opus 5.5를 쓸 만한가?
기본 Opus급 모델로서는 그렇다. 백만 토큰당 입력 4달러, 출력 20달러에 대부분의 작업에서 Fable 5.1 수준을 겨냥하며 Opus 5보다 20% 저렴하고 캐시 읽기는 0.20달러까지 내려간다. 가장 어려운 프론티어 작업은 Fable 5.1에 남겨두고, 반사적으로 최대 노력 수준을 켜는 일도 피하라. 그 수준에서 측정된 장황함은 할인을 갉아먹는다.
Claude Opus 5.5가 Opus 5보다 싼가?
정가는 입력이 20% 낮아지고(4달러 대 5달러), 출력도 20달러 대 25달러이며, 캐시 읽기는 백만 토큰당 0.50달러에서 0.20달러로 내려간다. Anthropic은 자체 테스트를 근거로 일반적인 워크로드에서 총비용 약 40% 감소를 주장한다. 실제 절감액은 노력 수준과 토큰 구성에 달려 있으니 대표 작업으로 직접 측정하라.
Opus 5.5가 Fable 5.1보다 나은가?
Anthropic 스스로 Opus 5.5는 대부분의 작업에서 Fable 5.1 수준이면서 실행 비용은 더 낮다고 말한다. 독립 검증은 엇갈린다. METR은 AI R&D 작업에서의 향상을 Fable 5.1 대비 점진적이라 평가했고, Artificial Analysis는 58점으로 212개 모델 스냅샷 1위를 줬다. 더 낮은 가격의 사실상 대등한 수준으로 읽는 게 정확하다.
Claude Opus 5.5는 코딩에 좋은가?
출시 페이지는 Terminal-Bench 4.0에서 표준오차 약 ±2.6포인트를 붙여 66.4%, CursorBench 4.0에서 57.8%를 보고한다. SonarSource의 Java 통제 테스트에서는 통과율이 Opus 5와 비슷(87.68% 대 88.6%)했지만 코드는 적고 결함 밀도는 높았다. 맹신 대신 리뷰를 남겨라.
Claude Opus 5.5는 왜 토큰을 이렇게 많이 쓰나?
최대 노력 수준에서 Artificial Analysis는 지능지수 과제당 약 119,000개 출력 토큰을 측정했다. GPT-6 Astra 최대 수준(약 27,000개)의 4배 이상이며 장황함 순위는 212개 중 95위다. 기본 노력 수준은 medium이고 SonarSource는 Java 생성에서 Opus 5보다 40% 적은 출력 토큰을 측정했으니, 소모량은 노력 수준과 워크로드에 따라 달라진다.
Claude Opus 5.5는 언제 출시됐고 어디서 쓸 수 있나?
Anthropic은 2026년 9월 22일 출시했다. API 모델 ID는 claude-opus-5-5, 컨텍스트 100만 토큰, 최대 12.8만 토큰 출력이다. 출시 페이지는 Anthropic Claude Platform, AWS, Google Cloud, Microsoft Azure를 제시한다. 소비자 플랜에서의 제공 여부는 이번 리뷰에서 확인하지 못했다.
Tabbit Browser에서 Claude Opus 5.5를 쓸 수 있나?
이 리뷰는 Opus 5.5가 Tabbit의 실시간 모델 선택기에 나타나는지 확인하지 못했으므로 이를 전제로 계획하지 마라. 자신의 계정 모델 선택기를 확인하고 되돌릴 수 있는 작업 하나를 돌려본 뒤 워크로드를 맡겨라.