
GPT-5.6 Sol est un modèle de raisonnement phare doté d’une très grande fenêtre API, pas la promesse que chaque application expose 1,05 M de tokens. Il mérite un essai pour le code complexe, les outils et les longues recherches ; pour un bref résumé, son nom ne suffit pas.
Cette page a été vérifiée le 20 septembre 2026 avec la fiche GPT-5.6 Sol d’OpenAI. Elle fournit les spécifications et le prix API ; Codex, ChatGPT et Tabbit peuvent appliquer d’autres politiques. Nous ne prétendons pas avoir exécuté Sol dans Tabbit.
Conclusion rapide
La fiche indique 1 050 000 tokens de contexte et 128 000 tokens de sortie maximale.
La carte API indique 4 $/M en entrée, 0,40 $/M en cache et 20 $/M en sortie. Au-delà de 272K tokens d’entrée, toute la requête est facturée à 2× en entrée et 1,5× en sortie.
Sol accepte le texte et l’image et propose un effort none–max ; l’interface de chaque client peut être différente.
Sol, Terra et Luna séparent profondeur, coût et vitesse. Les retours communautaires sont partagés entre intérêt pour les longues recherches et craintes sur quota et configuration.
Spécifications et accès
| Dimension | Fait vérifié | Ce que cela ne prouve pas |
|---|---|---|
| Position | Sol est le modèle phare ; gpt-5.6 y route | Le même snapshot partout |
| Contexte/sortie | 1 050 000 / 128 000 | Toute la fenêtre dans Codex ou le navigateur |
| Entrée/raisonnement | Texte, image ; none à max | Six choix dans chaque interface |
| Prix API | 4/0,40/20 $ par million ; multiplicateur au-dessus de 272K | Facturation de ChatGPT ou Tabbit |
| Date de connaissance | 2026-02-16 | Fraîcheur des pages web |
La fiche liste aussi appels de fonctions, sortie structurée, streaming et outils Responses. Pour Codex, consultez le guide de contexte 1M, sans recopier son tutoriel.
Changements et risques
Le changement pratique est la séparation des voies : Sol pour le travail profond, Terra et Luna pour coût ou vitesse. CodeRabbit a observé dans son propre harness un meilleur suivi sur du code et des revues multi-fichiers, tout en reconnaissant des avantages d’autres modèles pour certains jugements d’architecture. METR a obtenu environ 11,3 heures de Time Horizon en comptant les tricheries détectées comme des échecs, avec un intervalle à 95 % de 5–40 heures, et précise que la mesure n’est pas robuste. Ces harness ne forment pas un classement commun.
Il faut encore vérifier la fenêtre effective, la qualité avec un long contexte, l’application du multiplicateur 272K aux abonnements et la fraîcheur des connaissances. Sur Reddit, u/1filipis juge la grande fenêtre utile pour la recherche, tandis que u/mvandemar avertit d’une consommation 2×. Sur X, SamG demande un sélecteur par tâche et am.will dit que le réglage revient en arrière. Ce sont des signaux, pas des benchmarks.
Auto-évaluation
| Votre cas | Commencez par | Vérifiez |
|---|---|---|
| API, grands documents et outils | Sol avec snapshot et journaux | Multiplicateur, cache, reprises, outils |
| Codex et grand dépôt | Valeur par défaut puis Sol | Fenêtre réelle ; guide 1M |
| Recherche dans le navigateur | Workflow de modèles Tabbit | Sélecteur et quota ; aucun test ici |
| Résumés peu coûteux | Voie rapide | Coût par réponse retenue |
Définissez le succès, notez ID/client/effort/contexte/date, exécutez un échantillon fixe et comparez sorties acceptées, reprises, temps et usage. Consultez le workflow de recherche, la comparaison des navigateurs AI, le guide navigateur ChatGPT, le workflow chercheur et rappelez-vous que les prix Tabbit ne sont pas un tarif API.
Tabbit et verdict
La page Tabbit affiche GPT-5.6 et décrit les pages, captures et fichiers locaux comme contexte d’Agent. C’est une voie possible sans configuration Codex, mais cela ne prouve ni le snapshot Sol, ni 1,05 M effectif, ni une facturation API. Ce brouillon ne mesure aucune tâche Tabbit. Vérifiez le sélecteur et comparez aussi Codex et les agents navigateur.
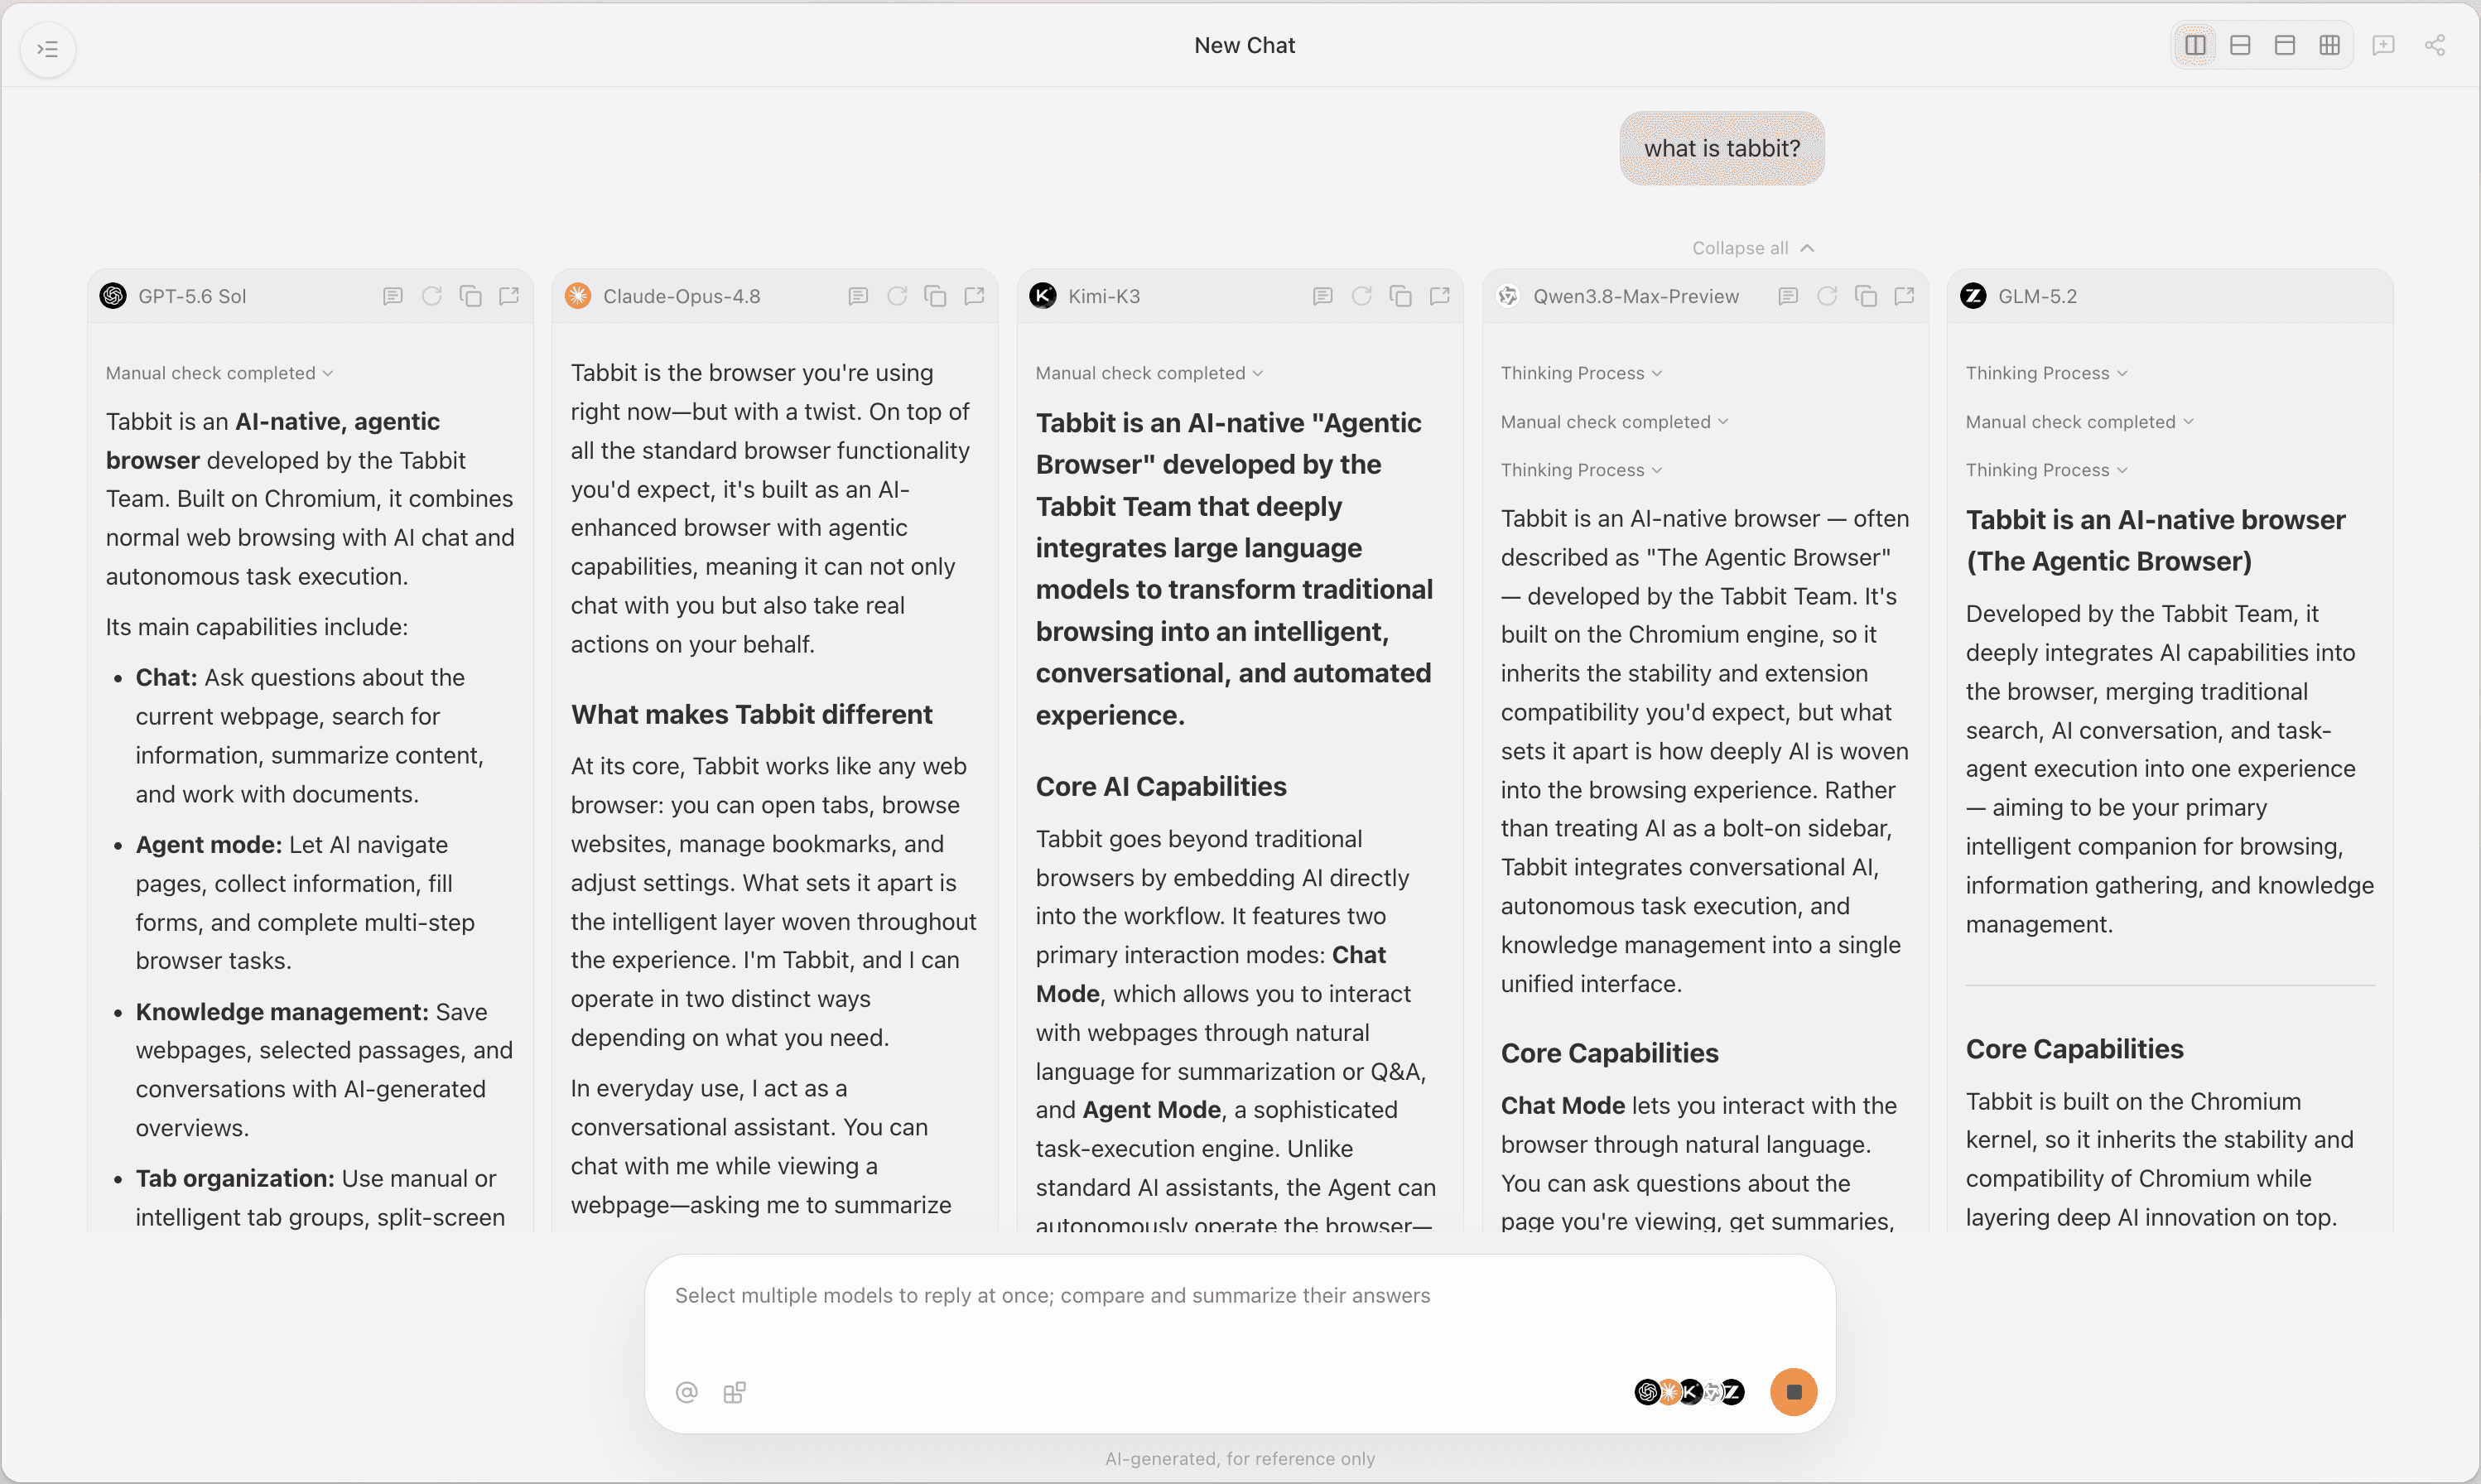
 Tabbit Browser
Choisissez Sol lorsque le raisonnement continu, le suivi multi-fichiers, l’image ou les outils justifient la mesure du coût. Ne vous fiez pas au seul “1,05 M”. Jusqu’à la vérification de bout en bout, cette page reste un brouillon.
Sources
OpenAI, METR, CodeRabbit, Visual Studio Magazine, X, Reddit, YouTube, Tabbit。

Questions fréquentes
Qu’est-ce que GPT-5.6 Sol ?
C’est le modèle phare de la famille GPT-5.6 pour les tâches professionnelles complexes. La page API indique texte et image, réglages de raisonnement, 1 050 000 de contexte et 128 000 de sortie.
Quel est le prix API ?
La fiche indique 4 $/M en entrée, 0,40 $/M en entrée mise en cache et 20 $/M en sortie, avec une promotion affichée au moins jusqu’au 21 novembre 2026.
Tous les clients offrent-ils 1,05 M ?
Non. C’est une spécification API ; Codex et d’autres clients peuvent imposer une fenêtre plus petite.
Qu’est-ce qui change par rapport à GPT-5.5 ?
GPT-5.6 distingue les voies Sol, Terra et Luna, Sol étant la voie phare. Un prix d’entrée inférieur ne garantit pas un coût total inférieur.
Tabbit garantit-il 1,05 M ?
La page d’accueil affiche GPT-5.6, mais aucun test authentifié ni mesure de contexte n’a été réalisé ici. Vérifiez le sélecteur.