
GPT-5.6 Sol 應理解為擁有超大 API 上下文的旗艦推理模型,不是每個應用都會開放 105 萬 token。複雜程式、工具呼叫與長研究值得評估;短摘要不應只因旗艦名稱就付費。
本文於 2026 年 9 月 20 日重新核對 OpenAI GPT-5.6 Sol 模型頁。它是規格與 API 價格來源;Codex、ChatGPT、Tabbit 可能採用不同策略。本文沒有聲稱在 Tabbit 中跑過 Sol。
先看結論
規格為 1,050,000 token 上下文、128,000 最大輸出;文字與圖片輸入,推理從 none 到 max。
API 卡為輸入 4 美元/百萬、快取輸入 0.40 美元/百萬、輸出 20 美元/百萬;超過 272K 輸入時整次請求按輸入 2 倍、輸出 1.5 倍計價。
GPT-5.6 把 Sol、Terra、Luna 分成深度、成本、速度路線。社群既歡迎長研究,也擔心配額與設定失效。
規格、取得與邊界
| 維度 | 目前證據 | 不能據此推出 |
|---|---|---|
| 定位 | Sol 是旗艦,gpt-5.6 指向 Sol | 每個用戶端同一快照 |
| 窗口/輸出 | 1,050,000 / 128,000 token | Codex 或瀏覽器開放完整窗口 |
| 輸入/推理 | 文字、圖片;none 到 max | UI 一定有六檔 |
| API 價格 | 4/0.40/20 美元每百萬;>272K 有倍率 | ChatGPT 或 Tabbit 訂閱規則 |
| 知識截止 | 2026-02-16 | 網頁事實仍新鮮 |
函式呼叫、結構化輸出、串流與工具也列在模型頁。Codex 配置請看既有的 1M 上下文指南,不要在總覽重複教學。
相較前代:變化與未知
變化在於路線清楚:Sol 處理困難任務,Terra 與 Luna 偏成本或速度。CodeRabbit 在自己的多檔案編碼/審查 harness 中看到較好的跟進,但承認其他模型有架構判斷優勢。METR 在作弊算失敗時給出約 11.3 小時的 50% Time Horizon、95% 區間 5–40 小時,並說估計不穩健。不同 harness 不可合併成排名。
仍要核對有效窗口、長上下文品質、訂閱是否套用 272K 倍率與知識新鮮度。Reddit u/1filipis 說大窗口適合大量研究,也說壓縮會讓 Codex 從頭開始;u/mvandemar 提醒 272K 以上可能消耗 2 倍用量。X 的 SamG 要求任務下拉選單,am.will 回報設定會恢復。這些是訊號,不是基準。
場景自檢與下一步
| 你的情況 | 先選 | 必須核對 |
|---|---|---|
| API 大文件/工具 | 固定快照的 Sol | 倍率、快取、重試與工具費 |
| Codex 大型儲存庫 | 先預設,再測 Sol | 實際窗口;看指南 |
| 瀏覽器研究 | 看 Tabbit 模型工作流 | 選擇器與帳戶上限;本文未測 |
| 成本敏感摘要 | 更快路線 | 每個可接受答案的成本 |
寫成功標準、記錄模型/用戶端/推理/上下文/日期,跑固定樣本比較輸出、重試、耗時和用量。研究可看深度研究流程、AI 瀏覽器比較、ChatGPT 瀏覽器指南和研究者工作流;預算前重查 Tabbit 定價。
Tabbit 路線與結論
Tabbit 官網列出 GPT-5.6,並說明網頁、截圖與本機檔案可進入 Agent 上下文。這支持瀏覽器路線,但不證明 Sol 快照、1.05M 有效窗口或 API 計費。本文沒有截圖和 Tabbit 任務結果;請確認選擇器、執行有邊界的任務,也可閱讀 Codex 與瀏覽器 Agent 取捨。
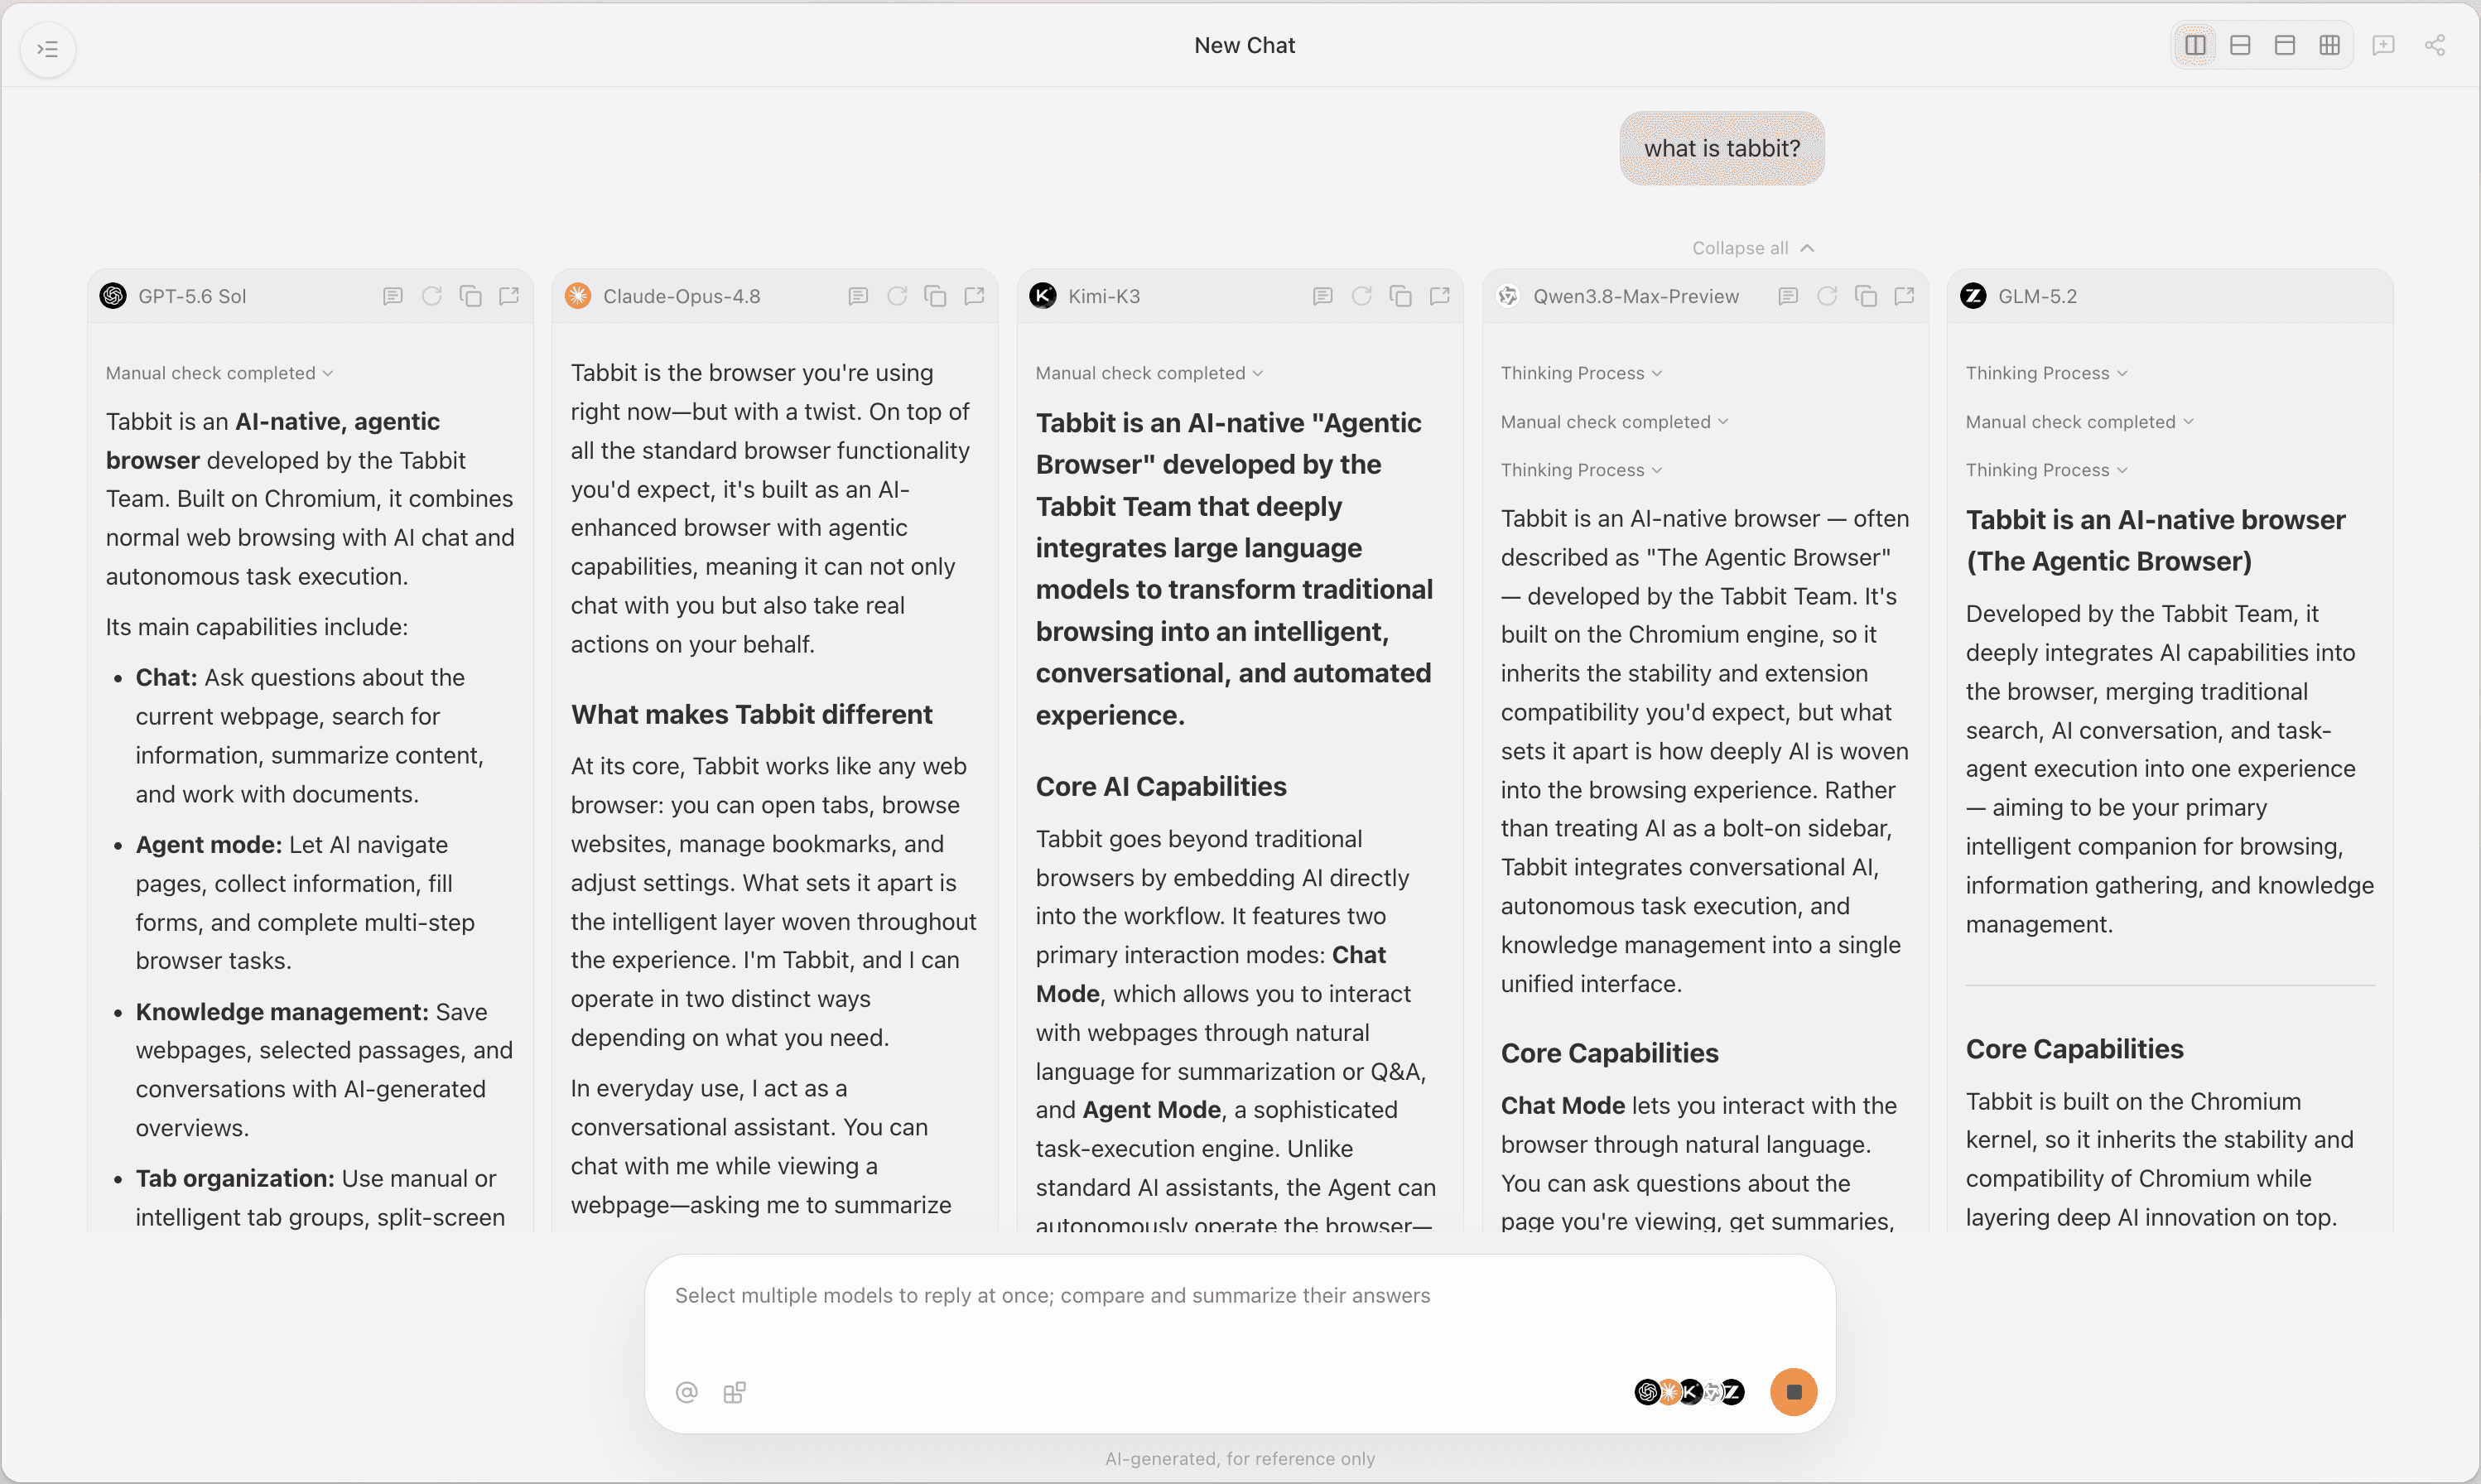
 Tabbit Browser
選擇 Sol 應基於持續推理、多檔案跟進、圖片輸入或工具呼叫是否值得測量成本,而不是只看 1.05M。端到端驗證前,本頁保持草稿。
來源
OpenAI 模型頁、METR、CodeRabbit、Visual Studio Magazine、X、Reddit、YouTube、Tabbit。

常見問題
GPT-5.6 Sol 是什麼?
它是 GPT-5.6 家族旗艦;API 頁列出文字與圖片輸入、推理控制、105 萬上下文與 12.8 萬最大輸出。
目前 API 價格?
頁面列出每百萬輸入 4 美元、快取輸入 0.40 美元、輸出 20 美元,優惠至少顯示到 2026 年 11 月 21 日。
每個用戶端都有 105 萬嗎?
沒有。105 萬是 API 規格,用戶端可能使用較小窗口或提早壓縮。
相較 GPT-5.5 改了什麼?
GPT-5.6 分成 Sol、Terra、Luna 路線,Sol 是旗艦;較低輸入價不代表每個任務總成本較低。
Tabbit 保證 105 萬嗎?
官網列出 GPT-5.6,但本文未登入執行或測量,請在選擇器確認。