
GPT-6.1 Terra 值得优先用于那些占满工作日的屏幕操作:读懂资料、找到对应记录、填写字段,再核对结果。它对 browser use 的吸引力很直接。OpenAI 把视觉推理与计算机操作作为重点,Token 价格也低于 Sol;实际操作仍需要连接浏览器或桌面工具。官方模型卡列出了这些能力与前提。
全文最重要的数字是超过 3 倍。OpenAI 报告,在 Agents' Last Exam 中,Terra 完成任务的速度超过 GPT-6.1 Sol 和 GPT-6 Astra 的 3 倍;标准 API 输入、输出 Token 单价则为 Sol 的一半。这是截至 2026 年 10 月 27 日核对的两种口径,足以支持尝试日常电脑任务,但不能相乘成六倍省钱,也不是所有任务的速度保证。官方发布说明。
首批用户也感受到了更短的等待。在 Codex 讨论中,u/ExplanationSenior104 表示工作约一分钟就完成了。这是个人体验,没有统一任务和推理档位。下文会区分证据、可复现测试方法和 Tabbit Browser 的适用位置。综合选型见 Terra 测评,完整计费见定价指南。
先看结论
Terra 能结合图像理解与工具,操作浏览器和桌面界面。
官方报告的速度优势针对完整评测任务,不只是输出文字更快。
标准短上下文 API 每百万 Token 的输入、缓存读取、输出分别为 1、0.05、5 美元,这不是订阅价格。
先试目标明确、结果可核对的工作,例如商品图匹配或表单准备。
本文没有人类速度对照;检查的 Tabbit 账号也没有 Terra,客户端任务实测仍待完成。
GPT-6.1 Terra 的 browser use 究竟是什么
Browser use 是在网站内读取字段、打开记录、切换标签,并根据页面内容执行操作。Computer use 还包括桌面图形应用。两者都不意味着模型自带浏览器,或无需连接环境就能进入已登录账号。
OpenAI 的计算机操作指南区分了两条路径:BrowserToolset 把选定的页面和标签操作暴露为函数工具;ComputerToolset 使用截图、鼠标和键盘。浏览器任务可以使用任一路径。了解这一区别,比只看产品是否叫“Agent”更有用。Agentic browser 解释介绍产品层,浏览器 Agent解释执行任务与回答问题的差别。
| 任务 | 合适的工具路径 | 核对什么 |
|---|---|---|
| 从商品页面提取四个字段 | 页面文字与控件 | 每个字段与原页一致 |
| 把供应商图片对应到目录记录 | 图像理解加浏览器控件 | 商品、规格、记录正确 |
| 操作缺少合适结构化集成的图形应用 | 截图和计算机操作 | 可见变化与保存产物 |
| 查找无需交互的公开事实 | 网页搜索 | 来源支持答案 |
这些是建议测试的任务,不是本文测得的结果。实现方式可参考 Agentic browsing 与浏览器自动化的区别。
为什么 Terra 的速度值得关注
一串小操作中,每一步的等待都可能影响体验。Agents' Last Exam 测试的是专业软件工作,包括根据图纸制作 3D 模型、为动画逐镜头整理带时间码的修复笔记。它比知识问答更接近完成工作,因此官方报告的速度优势值得关注。
但“更快”需要有比较对象。公开结论比较的是 Sol 和 Astra,没有证明 Terra 在你的供应商后台、表格或预约流程中都能胜过人类。熟悉流程的人可能在 Agent 加载工具前就完成一个小任务;重复批量工作则可能更适合自动化。两者都应该测量。
端到端耗时 = 准备 + 操作 + 等待 + 重试 + 审核修正
速度比 = 人工耗时 / Agent耗时,前提是得到相同且验收通过的结果
使用相同的开始、结束条件。保存错误记录应计为失败,而不是快速完成。记录人工和 Agent 是否预先打开了页面。如果耗时主要来自网站超时,更快的模型也未必明显缩短总时间。浏览器自动化指南提供了更多流程背景。
"Today I tested terra, and it is doing consistently the work done in 1m."
u/ExplanationSenior104,10 月 26 日 UTC,讨论的是 Codex 工作。可理解为“今天试用 Terra,工作一直能在一分钟内完成”。这是等待体验的反馈,不是受控浏览器基准。
计算机操作的证据支持什么
最直接的起点是输入可检查、输出可验收的工作。OpenAI 发布时举的例子是读取发票,再把信息录入会计软件;模型卡还提到将商品照片匹配到目录条目。这类任务把视觉理解与应用操作连起来,正是 Terra 与浏览器工作的关联。
先据此选测试,再看分数。提供一张样例发票和测试表单,核对供应商、发票号、币种、总额。再拿一张商品图对照小型目录,预先确定正确匹配。这里是建议的测试方法,本文没有声称已运行这些任务。
| 官方证据 | 报告中的 Terra 表现 | 帮助判断什么 |
|---|---|---|
| Agents' Last Exam,medium,对比 GPT-5.6 Terra | 高 15 个百分点,任务成本约为三分之一 | 是否重测前代工作流 |
| Agents' Last Exam,对比 Astra | 表现相当,Token 单价为十分之一 | 被评测任务是否需要旗舰模型 |
| Agents' Last Exam,完成时间 | 速度超过 Astra 和 GPT-6.1 Sol 的 3 倍 | 是否值得为减少等待而试用 |
| OSWorld 2.1,medium | 超过 GPT-5.6 Terra 的最佳成绩 | 哪些桌面任务值得评估 |
来源:OpenAI 10 月 26 日发布说明,10 月 27 日核对。这些是厂商报告,涉及不同对照对象与设置。表格不提供独立复现、纯浏览器成功率或人类基线,也不能把各行合成一个成本、质量比值。
看懂屏幕后继续操作
价值在于把图像理解与下一步动作连接起来。商品目录任务需要的不只是图片描述,还包括正确记录和规格。Terra 的图片输入和计算机工具让这类流程具备实现条件;面对近乎相同的商品是否可靠,仍应实际测试。
页面允许时,直接使用控件
结构化网页适合暴露文字与控件的驱动,操作过程也更容易核对。对于视觉布局或缺少合适控件的应用,截图操作仍有价值。官方工具指南说明了两条路径。Browser use 不必局限于不断根据截图猜鼠标坐标。
让重复任务的费用更低
按标准短上下文价格,假设单次请求含 20,000 个未缓存输入 Token 和 2,000 个输出 Token,模型 Token 费用是 0.03 美元;Sol 按 $2/$10 单价,相同 Token 数量为 0.06 美元。这是预算算术,不是实际会话账单。
Terra Token预算 = 20,000 / 1,000,000 × $1
+ 2,000 / 1,000,000 × $5 = $0.03模型卡列出了费率与调整条件。截图计入图像输入,输出应包括推理消耗,并按实际情况加上重试、工具、缓存写入和环境费用。输入超过 272K Token 后,整个请求适用的费率会变化。流程越少返工就能通过验收,低单价越有意义。
快和便宜之外,需要核对什么
视觉细节与长任务完成情况
u/Used_Growth_4068 的工程图重建反馈同时提到了速度与质量:
"it is noticeably worse then sol 6.1 , but 3 times faster"
对近似商品图和精细布局,这个取舍尤其值得测。要核对实际选中项和保存结果,速度本身无法说明细节是否保留。
在另一个 PDF 索引任务中,u/NewConfusion9480 报告多次中断,并表示换成 Sol 后完成了工作:
"Every time, 6.1 Terra would just stop without giving any reason."
两条反馈都不能推出普遍失败率,却指出了实用的验收项:是否完成、是否保留细节、保存产物是否符合要求。面对特别困难的工作,可参考 Astra 测评选择对照模型。
订阅额度与 API 单价分别判断
u/bulutarkan称,两次 xhigh 项目提示后,五小时额度下降了 10 个百分点:
"5 hours limit was 100% and dropped down to 90% in less than 2 minutes.."
正面反馈关注等待更短,顾虑则集中在细节、完成情况和额度。测试浏览器 Agent 时,应比较验收通过的工作与总监督量,不只挑最快的一次回答。这四个首日个案也不是代表性调查。
如何开始一个 Terra 浏览器任务
检查访问权限。在支持的 ChatGPT Work 或 Codex 中打开 Advanced,确认能选择 GPT-6.1 Terra。发布记录列出付费套餐与工作空间条件,普通 Chat 是另一种体验。
连接所需环境。网站任务可用内置浏览器;已有浏览器会话使用受支持的扩展;桌面应用则使用 Computer Use 插件。浏览器文档与桌面配置说明各自权限。获得浏览器访问不等于自动导入所有登录状态。
给一个任务与完成标准。从测试记录或只读提取开始,明确来源、字段、目标和验收条件。
查看实际结果。要求返回来源 URL 和缺失字段;准备表单时,提交前把可见值与原资料逐项比较。
第一个提示词可以很具体:
Open the product page I provide. Return a table with product name,
variant, displayed price, and source URL. Mark missing values as unknown.
If I provide a staging form, prepare those fields without submitting it.
Check each filled value against the source and report any mismatch.
这是建议输入,不是捕获的 Terra 输出。任务通过后再加入第二个页面或批量记录。开发者调用工具应使用 Responses API,模型名为 gpt-6.1-terra。应用负责提供浏览器驱动、操作上限、权限和结果验证,仅填写模型名并不等于搭好了自动化系统。
在 Tabbit Browser 中尝试这个工作流
Tabbit 的浏览器工作流能把页面、截图和文件上下文交给 Agent,官网说明了这些输入形式。因此,在需要的模型实际可用时,它适合评估从资料到网页操作的流程。
这里有一个明确限制:10 月 27 日检查的国际账号加载了 16 个模型选项,没有 GPT-6.1 Terra。本次没有发送 Terra 请求。Terra 资源页是参考资料,不代表账号已获访问。本文因此没有可报告的 Tabbit 端 Terra 完成时间、成功率或费用。
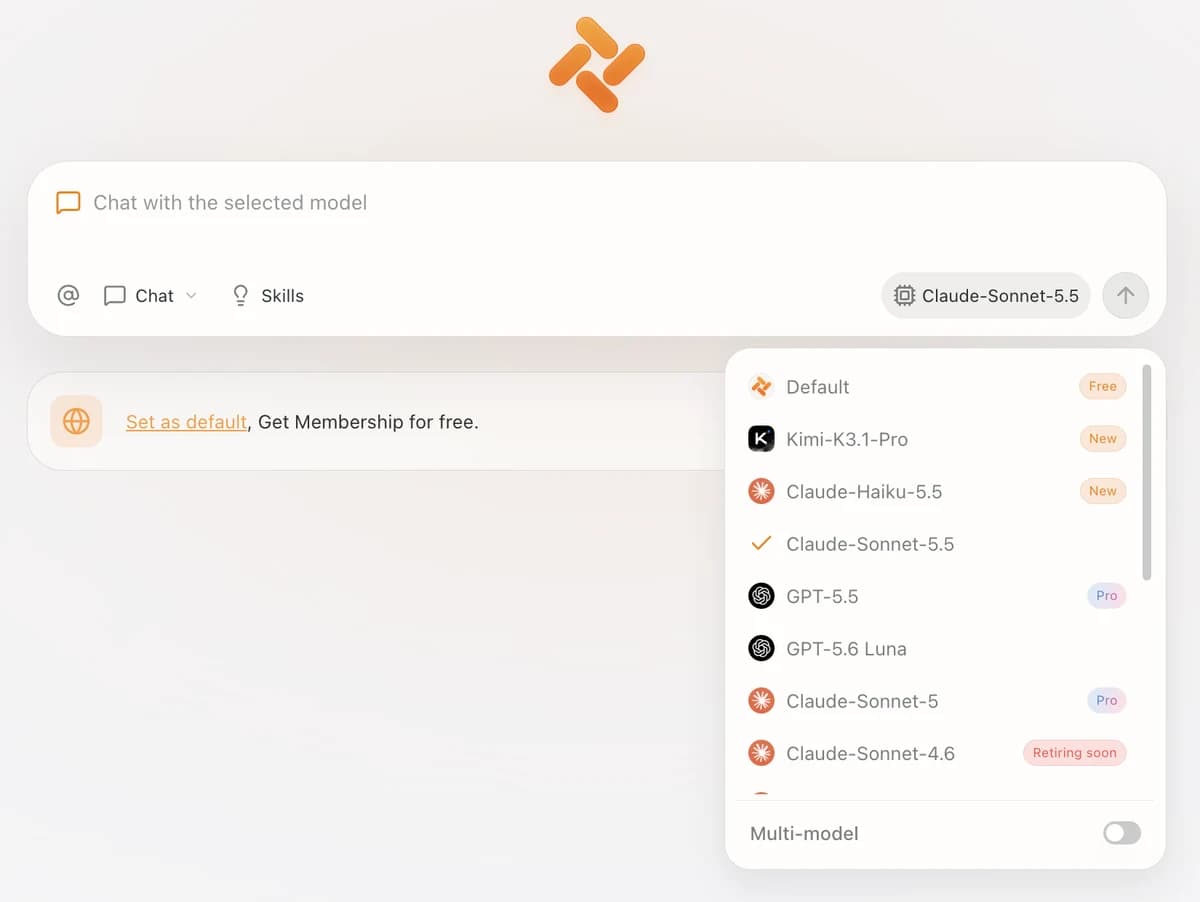
当选择器出现 Terra 后,先运行上面的四字段提取。记录模型显示名、可见的推理档位、工具活动、来源页面、输出和人工修正,并在开始前写下正确值。第二个测试比较两个商品页,第三个准备测试表单。资源页存在或其他模型完成任务,都不能算 Terra 实测。
需要的模型暂不可用时,选择实际提供该模型的环境。AI 浏览器比较可帮助判断外围工作流;每个产品的模型权限和费用仍须单独确认。
按工作负载选择
| 你的工作 | 建议下一步 | 决定因素 |
|---|---|---|
| 有明确来源的重复表单和商品记录 | 优先试 Terra | 字段正确、记录通过验收、总耗时 |
| 图像匹配或基于截图的应用操作 | 与更强模型对照 | 细节保留和实际保存结果 |
| 长时、模糊目标流程或复杂软件工程 | 切换前比较 Sol 或 Astra | 完成情况和监督量 |
| 已经熟悉的微小任务 | 同时测人工操作 | 准备时间可能比工作更长 |
| 在 Tabbit 中操作网页 | 先确认模型,再跑固定任务 | 真实可用性与可观察的操作 |
Terra 最有说服力的价值,是以较低价格完成实际电脑工作,并在 OpenAI 公布的评测里减少等待。这足以支持一次有目标的试用,还不足以宣布所有流程都比人快。先选一个结果可检查的任务,用总投入最少、能正确完成的方案。
 Tabbit Browser

常见问题
GPT-6.1 Terra 能操作浏览器吗?
可以,前提是在支持的环境中连接浏览器或计算机工具。模型卡列出了计算机操作、函数调用和图片输入能力。应用仍须提供会话、权限与工具,选择模型本身不会自动授权访问标签页。
Browser use 与 computer use 有什么区别?
Browser use 聚焦网站文字、控件与标签页。Computer use 可通过截图、鼠标和键盘操作图形界面,包括桌面应用。浏览器任务可以根据工具条件使用任一路径。
Terra 比 Sol 或人类更快吗?
OpenAI 报告 Terra 在 Agents’ Last Exam 中完成任务的速度超过 GPT-6.1 Sol 和 GPT-6 Astra 的 3 倍。这没有证明所有网站任务都更快,也没有建立人类对照。人工比较必须保持相同任务、验收产物与端到端计时。
Terra 浏览器自动化多少钱?
截至 2026 年 10 月 27 日,标准短上下文 API 每百万输入、缓存输入、输出 Token 分别为 1、0.05、5 美元。截图、推理、重试、缓存写入、工具和托管环境可能影响总费用。订阅额度与 API 账单分开计算。
从哪里开始使用 Terra?
OpenAI 在符合条件的付费 ChatGPT Work 和 Codex 中提供 Terra,受账号与工作空间权限影响。先在 Advanced 中检查模型,再配置浏览器或桌面工具。开发者调用工具须使用 Responses API,模型名为 gpt-6.1-terra。
Tabbit Browser 已经提供 GPT-6.1 Terra 吗?
本文在 2026 年 10 月 27 日检查的国际账号,其 16 个已加载模型选项中没有 Terra。可用性可能因账号不同或后续更新而变化。本文没有声称已在 Tabbit 中完成 Terra 任务实测。