
普段のコーディングや定型処理にはGPT-6.2 Solから。修正に時間がかかる難しい作業にはGPT-6.2 Astraも試します。 OpenAIは2026年11月17日(米国時間)に両モデルを公開しました。テストで明確に判定できる変更はSolを基準にできます。複数の要件が絡む作業では、Astraがレビューや修正をどれだけ減らせるかを測ります。OpenAIの発表。
短いコンテキストのStandard APIでは、同じトークン数ならAstraの料金はSolの4倍です。 一方、OpenAIによるFrontierCode 2.0のMax同士の比較では、Solのスコア差は0.5ポイント未満、費用はAstraの約5分の1でした。Tabbit Browserで両モデルに同じ仕様書を渡し、料金を読み取る例も紹介します。AstraのAPI仕様、SolのAPI仕様、OpenAIの評価結果。
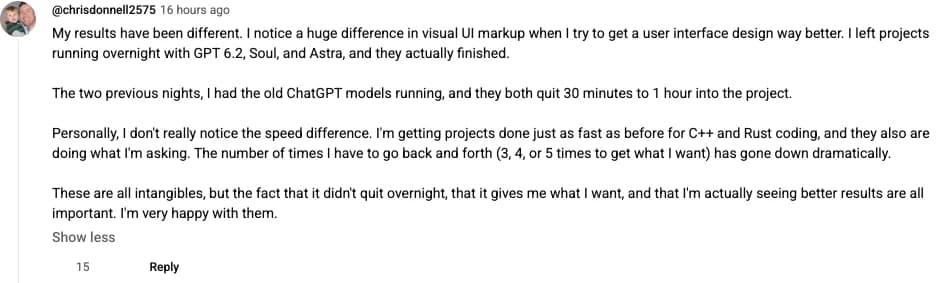
ある開発者は、両方の6.2モデルが夜間に任せたプロジェクトを完了し、C++やRustでのやりとりも減ったと報告しています。途中で人が介入した回数も記録すると、この違いを自分の作業で確かめられます。 元のコメント.
要点
同じAPI区分とトークン数なら、Solの料金は75%低くなります。
手戻りが多い作業では、Astraで要件の見落としが減るか確認します。
コンテキストウィンドウは共通です。入力が272Kを超えるとリクエスト全体の料金が上がります。
Codex、ChatGPT Work、APIでは利用条件と計測方法が異なります。
合格した成果物あたりの費用と時間には、失敗やレビューも含めます。
GPT-6.2 AstraとSolの仕様
| 比較項目 | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| APIモデルID | gpt-6.2-astra | gpt-6.2-sol |
| Standardの入力 / 出力、100万トークンあたり | 8ドル / 40ドル | 2ドル / 10ドル |
| キャッシュ読み取り / 30分の書き込み | 0.40ドル / 10ドル | 0.10ドル / 2.50ドル |
| APIウィンドウ / 最大入力 / 最大出力 | 1,050,000 / 922,000 / 128,000 | 1,050,000 / 922,000 / 128,000 |
| 入出力 | テキストと画像入力、テキスト出力 | テキストと画像入力、テキスト出力 |
| 推論強度 | Low、Medium、High、Xhigh、Max | Low、Medium、High、Xhigh、Max |
| 最初に試す用途 | 複雑な変更、失敗の影響が大きい作業 | 日常のコード変更、繰り返し処理 |
| 提供先 | API、対象アカウントのCodexとChatGPT Work | API、対象アカウントのCodexとChatGPT Work |
料金とAPI仕様は2026年11月19日に確認しました。アプリ内の上限は利用環境によって変わります。Astraの資料 (English)、Solの資料 (English)、前世代Astraの料金。
1件あたりのAPI料金を計算する
キャッシュなしの入力10万トークンと課金対象の出力2万なら、Astraは1.60ドル、Solは0.40ドルです。入力のうち8万を既存キャッシュから読む場合は0.992ドルと0.248ドルになります。推論トークンは出力料金に含まれます。キャッシュ書き込みやツールの費用は別に足してください。
入力が272Kを超えると、全体の入力とキャッシュの単価が2倍、出力が1.5倍になります。キャッシュなしで入力30万、出力2万のStandard料金は6.00ドルと1.50ドルです。同じコンテキスト長なら、BatchはStandardの半額、Fastは2倍です。Ultrafastは太平洋時間の2027年2月28日までは3倍、3月1日からは6倍です。OpenAI API料金表。
支払ったモデルとツールの費用を合計し、合格した件数で割ります。人が確認するなら、その作業時間も計上します。たとえば20件をSolで1回0.40ドルで実行し、16件が合格したとします。残り4件をAstraで1回1.60ドルずつ実行して全件合格すれば、総額は14.40ドル、1件0.72ドルです。初めから20件をAstraに渡すと、すべて1回で通っても32ドルです。この方法には失敗した4件を正しく検出できる仕組みが必要です。前世代Solの課金項目。
別の利用者は、失敗した処理を別のエージェントが修正する費用を指摘しています。その再作業も集計に入れます。 元のコメント.

コーディング、データ分析と速度
FrontierCode 2.0は、実在のリポジトリで変更がマージ基準を満たすかを評価します。OpenAIのMax同士の測定ではSolは0.5ポイント未満の差で、費用は約5分の1でした。Artificial Analysisは独自の実行環境を使っています。11月19日のIntelligence IndexではAstra Maxが62、Sol Maxが57です。コードの評価項目はFrontierCode-AA 2.0という別の名称です。自分のリポジトリでは、開始コミットとテストをそろえ、不要な変更もレビューします。OpenAIの評価、Artificial Analysis、前世代Astraのレビュー、前世代Solのレビュー。
Plotlyの分析試験ではAstraが41/43、Solが40/43でした。全問の費用は4.11ドルと1.22ドル、1問の中央値は12.4秒と10.5秒です。各1回の試験で、差は隠れたパターンを見つける1問でした。Ranthisの売上表に対するHighの試行では、Astraは3回とも10/10、Solは3回とも9/10でした。Solは毎回同じ例外行を落とし、定価換算の中央値はそれぞれ0.0337ドルと0.0085ドルでした。抽出を自動化するなら、集計件数と金額に加え、例外行もテストしましょう。Plotlyの分析試験、Ranthisの表計算テスト。
これらの試験ではSolが早く完了しました。実務では最初に読めるテキストが現れる時刻と、成果物が合格する時刻を分けて記録します。ツール待ち、再試行、修正は後者に影響します。同じ推論強度とツールで比較してから、導入予定の設定を試してください。推論強度別の測定。
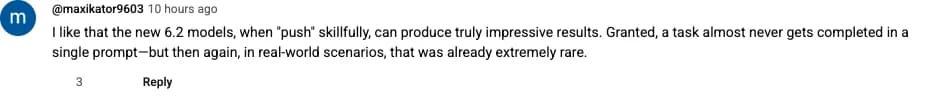
実作業ではたいてい追加の指示が必要だという利用者もいます。追加の往復と修正時間を試験に含めてください。 元のコメント.
Codex、ChatGPT Work、APIでの使い方
対象のCodexやChatGPT Workのワークスペースでモデル選択画面を開きます。APIを使う場合はモデルID、推論強度、処理区分を記録し、noneは指定しません。Responses APIのツールを使う場合は両モデルの条件をそろえます。移行前のバージョンで合格・不合格だった例も残しておきます。OpenAIの提供条件、Codexのブラウザツール設定、GPT-6.1 Solの作業例。
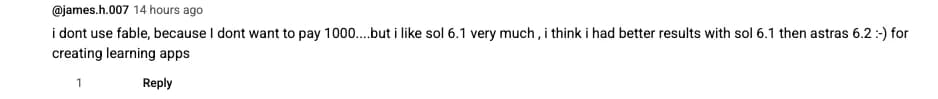
学習アプリを作る利用者はAstra 6.2より以前のSol 6.1の結果を好みました。切り替える前の成果物と設定を残しておきます。 元のコメント.
Tabbitで同じ資料を使って比べる
Tabbit BrowserのマルチモデルチャットでAstraとSolを選び、同じ2つの公式API仕様を添付します。モデルID、Standardの入力・キャッシュ読み取り・出力料金、長いコンテキストの境界、出典リンクを尋ねます。100万トークンあたり、Astraは8 / 0.40 / 40ドル、Solは2 / 0.10 / 10ドル。両方とも入力272K超でリクエスト全体の料金が上がります。マルチモデルでの調査方法、Webの出典を残す方法。
添付したOpenAIのモデル仕様2件だけを参照してください。1モデルにつき1行で、正確なAPIモデルIDとStandardの短いコンテキストでの未キャッシュ入力、キャッシュ読み取り、課金対象出力の料金を、100万トークンあたりの米ドルで示し、出典URLを添えてください。表の下に、長いコンテキスト料金が始まる入力数と、リクエスト全体に適用されるかを書いてください。出典にない値は不明と記してください。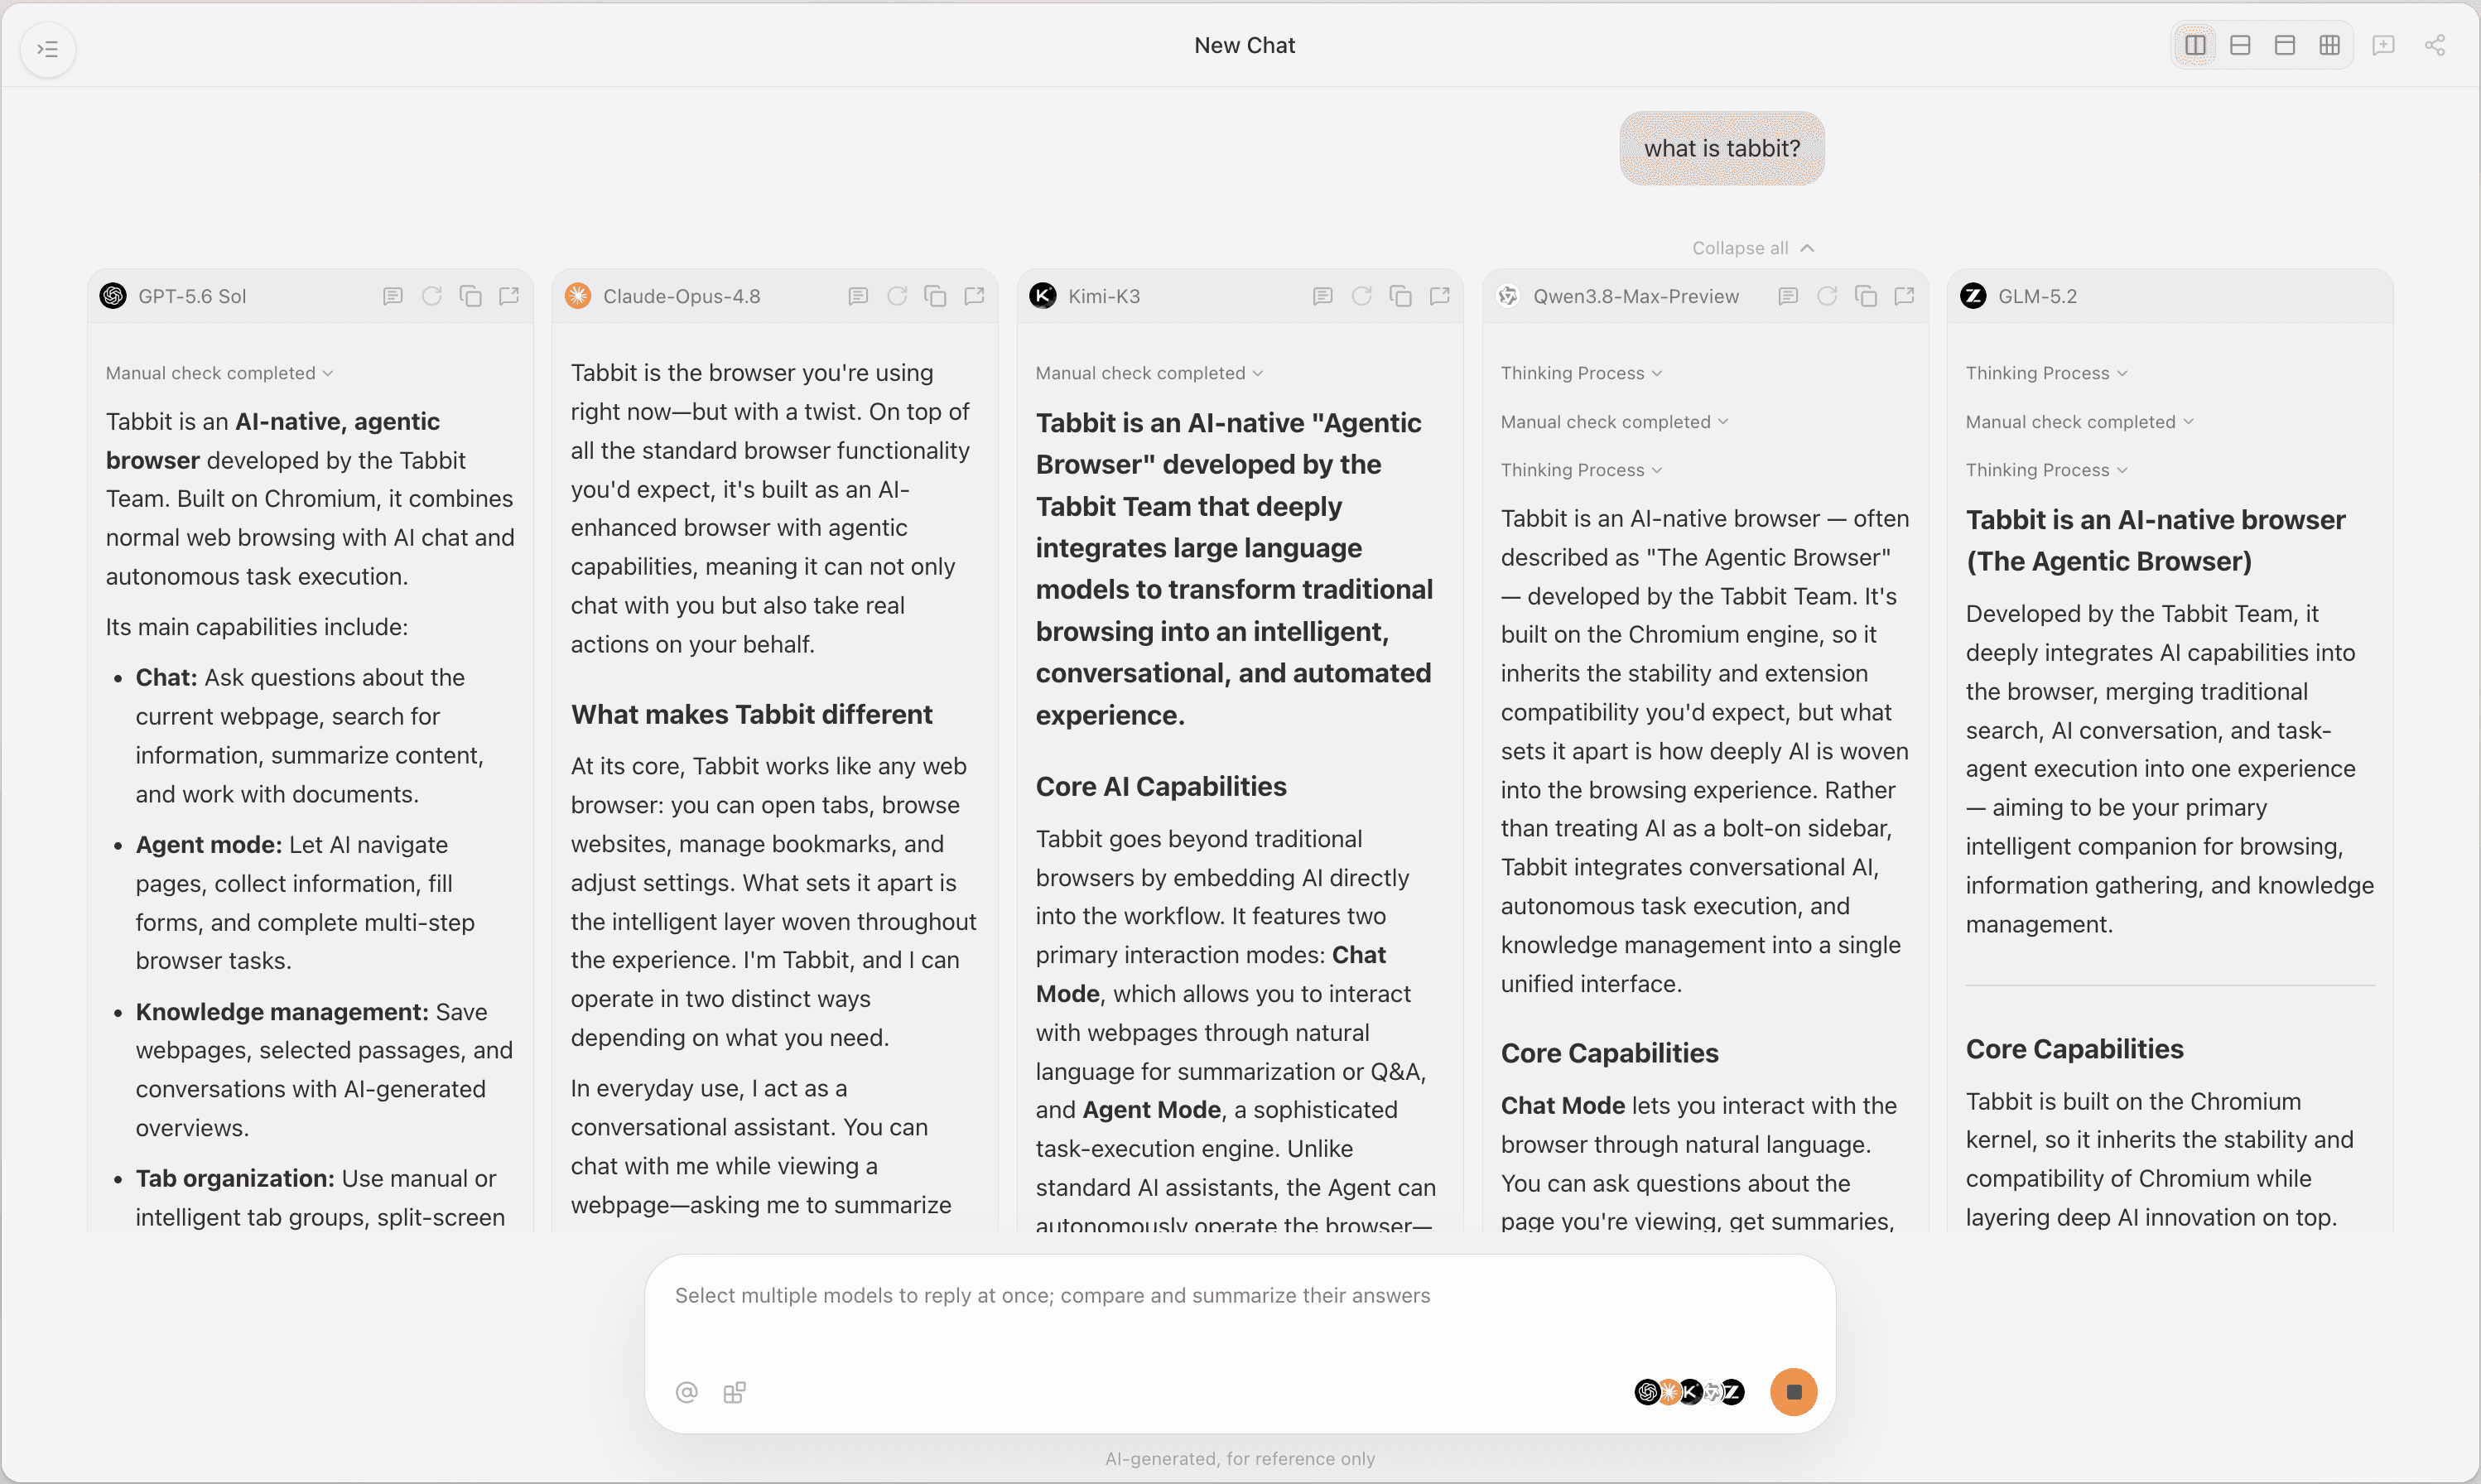
数字の順番、単位、リンク先を元の仕様書と照合します。実際の推論トークン数や再試行の費用を比較するときは、APIの利用記録を使います。
どんな仕事にどちらを選ぶか
| 作業 | 最初に試すモデル | 選び直す条件 |
|---|---|---|
| テストのある小さな修正 | Sol | Solが見落とす不具合をAstraが直せる |
| 複数モジュールの難しい変更 | 難例にAstra | Solの合格率とレビュー時間が同程度 |
| 一括分類やデータ抽出 | Sol | チェックで検出できない漏れが続く |
| 重要な文書や複数資料の調査 | Solで下案、Astraで例外を確認 | 網羅性、出典、修正時間を比較 |
| 大量のコンテキストを送るAPI処理 | Solと短い入力の試験 | Astraの合格率が追加料金に見合う |
| 既存のCodexやWorkの作業 | 合格するうち費用が低い方 | もう片方でレビュー時間が減る |
まずSolで代表的な作業を試し、失敗例と合格例を一部保存します。同じ例をAstraでも実行しましょう。Webの資料を使う場合は、出典とモデルID、結果をTabbitにまとめておくと、比較を再現できます。

よくある質問
GPT-6.2 AstraとSolはどちらを選ぶべきですか?
日常的なコード修正や検証しやすい定型処理にはSolから試します。要件の見落としが続く場合や手戻りが大きい作業では、同じ課題をAstraでも試してください。
SolはAstraよりどれくらい安いですか?
OpenAI APIで処理区分とトークン数が同じなら、Solのモデル料金は75%低くなります。合格した成果物あたりのコストには、推論、キャッシュ、ツール、再試行も影響します。
CodexやChatGPTで両方を使えますか?
OpenAIは対象アカウント向けにCodexとChatGPT Workで両モデルを公開し、APIでも提供しています。ワークスペースのモデル選択画面で確認してください。サブスクリプションの利用枠とAPI料金は別です。
コンテキストウィンドウは同じですか?
APIの仕様は両方とも105万トークンで、最大入力は92万2,000、最大出力は12万8,000です。入力が272Kトークンを超えると、リクエスト全体に長いコンテキストの料金が適用されます。
SolはいつもAstraより高速ですか?
PlotlyとRanthisのテストではSolが先に完了しました。実際の作業では、最初の文字が出るまでの時間と、検証済みの成果物を得るまでの時間を分けて測ってください。
どうすれば公平に比較できますか?
入力、ツール、合格条件をそろえます。まず同じ推論強度で試し、次に導入予定の設定で比べます。失敗や再試行も記録します。