
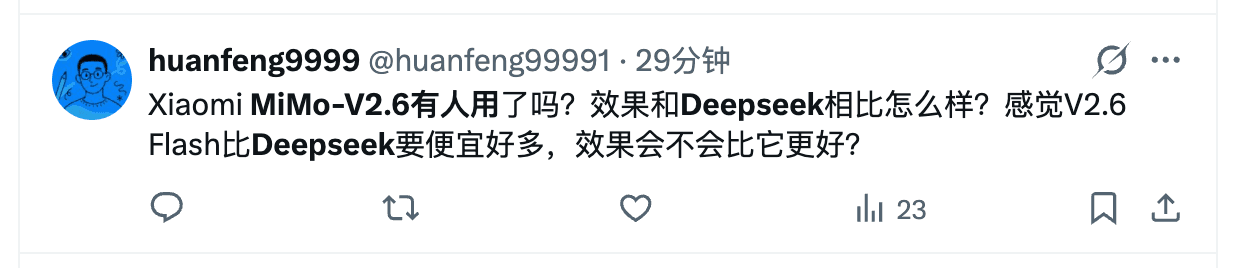
MiMo-V2.6-Pro はショートリストに残しておいて損のないモデルです。Xiaomi は2026年9月22日にこのフラッグシップを公開・オープンソース化し、Artificial Analysis Intelligence Index で 46 点を記録しました。これは当時のオープンウェイトモデルとしての最高スコアで、公式価格は100万トークンあたり入力 $0.435・出力 $0.87。前日に行われた Kingy AI の独立 OpenCode 実測では、隠されたコーディング検査 23 項中 23 項を約 $0.03 で合格し、Claude Opus 5 と同じ正答率を約35分の1のコストで達成しています。公開当日、X 上であるユーザーが比較の要点を一文で問いました。「Xiaomi MiMo-V2.6有人用了吗?效果和Deepseek相比怎么样?感觉V2.6 Flash比Deepseek要便宜好多,效果会不会比它更好?」(もう使った人は?DeepSeek と比べてどう?V2.6 Flash は DeepSeek よりずっと安いけど、効果はそれ以上?)
乗り換えを検討する理由は、Xiaomi 自身の言葉にあります。公式発表にはこうあります。「However, there is still a gap when compared with the strongest closed-source models Claude Fable 5.1 and GPT-6 Astra.」(最強のクローズドソースモデルである Claude Fable 5.1 や GPT-6 Astra と比較すれば、なお差がある。)ベンダーが自社の新フラッグシップがクローズドの最前線に届いていないと認めるのは珍しく、素直に受け取る価値があります。同じ指数で Fable 5.1 と GPT-6 Astra は 53 点。MiMo-V2.6-Pro の 46 から7ポイント上です。Claude Opus 5 は max effort で 51 点に達し、インデックスタスクあたり $5.86 かかるのに対し、MiMo は約 $0.13。約45倍の差です。
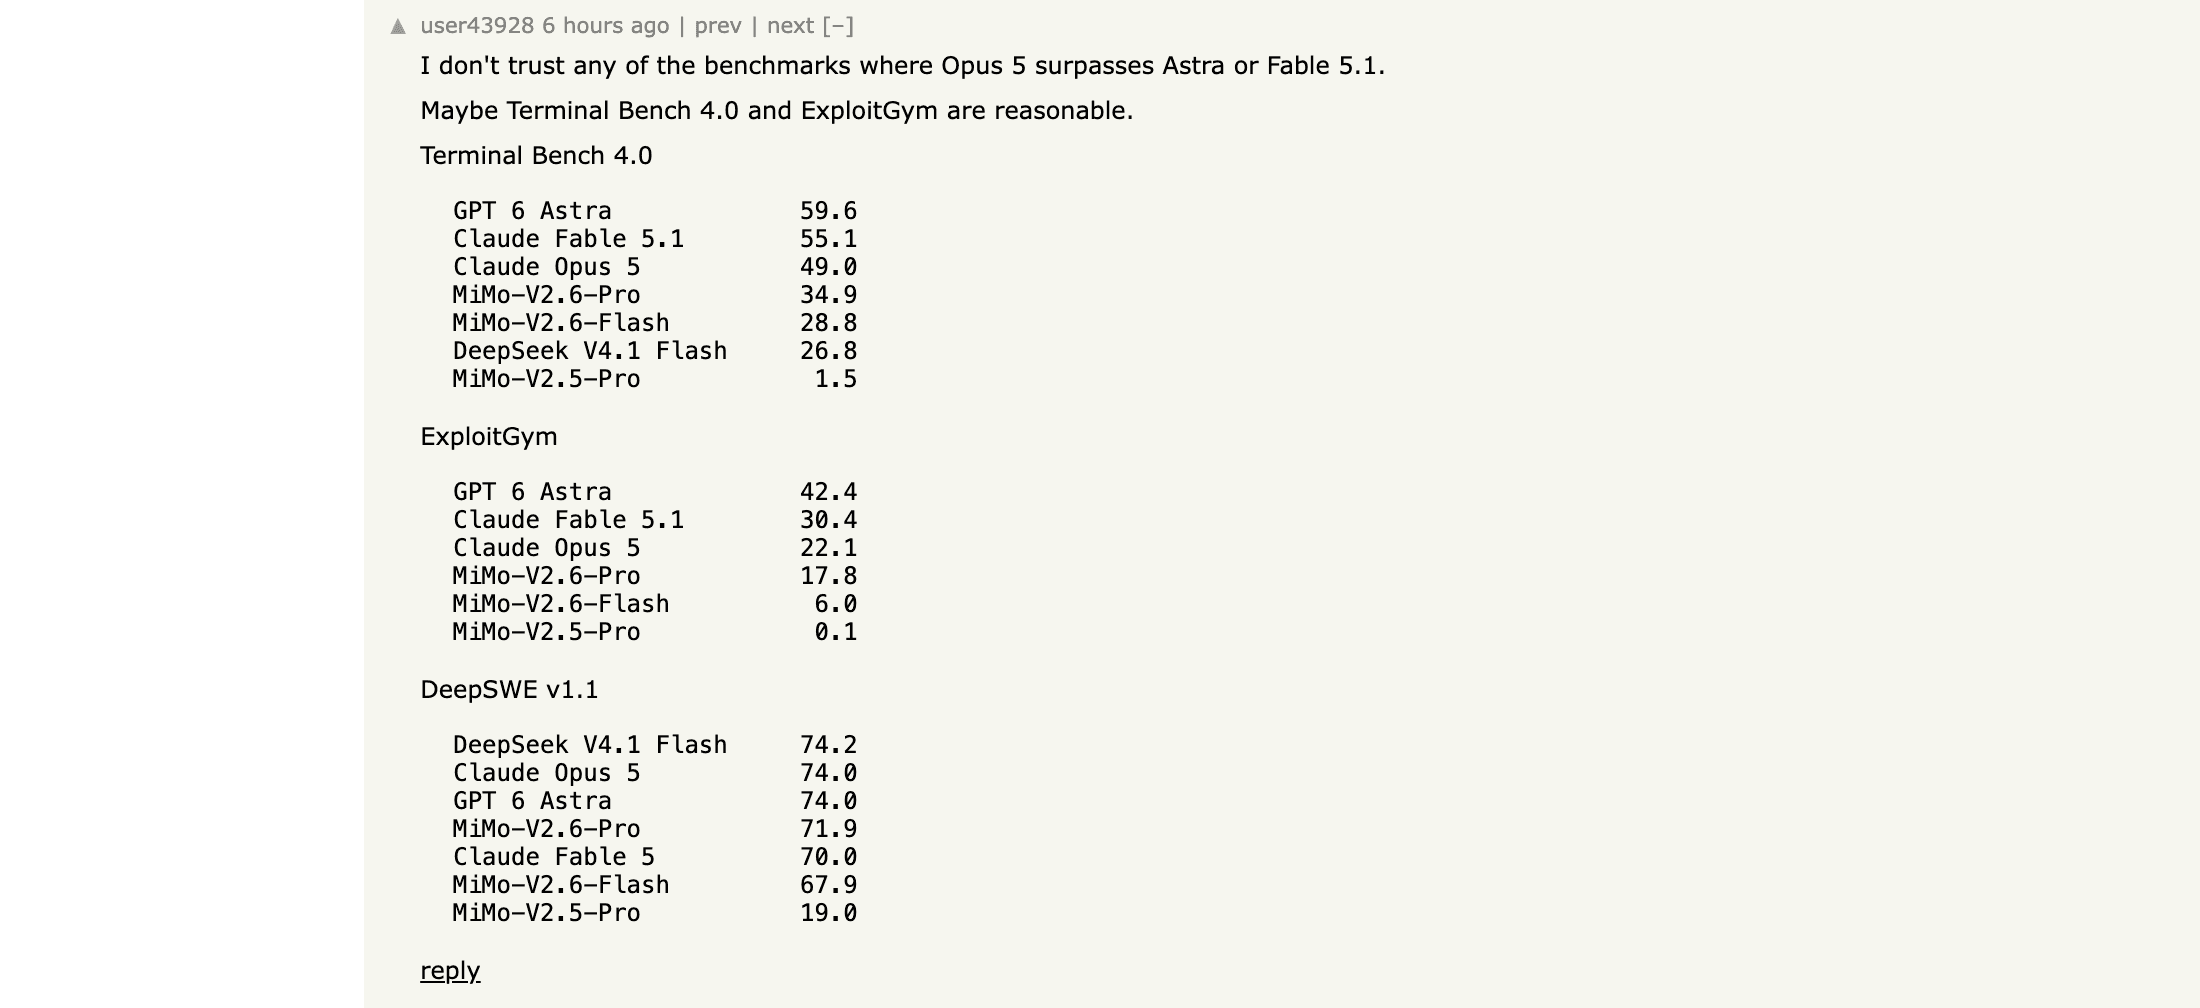
この7ポイントには、測定可能なコストが2つ隠れています。ターミナルを操作するエージェント系ベンチマーク Terminal Bench 4.0 では、Xiaomi 自身の表で MiMo-V2.6-Pro は 34.9。対する Claude Opus 5 は 49.0、GPT-6 Astra は 59.6 です。そしてスコアを支える推論は請求書に現れます。Hacker News のあるテスターは、最も低い推論レベルでしか実行できなかった理由をこう説明しました。「the other ones (medium/high) used way too many tokens and all requests timed out.」(medium/high のレベルはトークン消費が多すぎて、全部のリクエストがタイムアウトした。)これは MiMo-V2.6-Pro が弱いという主張ではありません。「最安のオープンウェイトフラッグシップ」というラベルが、エージェント能力の差と、思考が長くなるほど膨らむトークン請求という2つの隠れコストを覆い隠している、という指摘です。この2つには、それぞれ対応する代替先があります。
不満の原因がモデルではなく、API キーの管理・価格比較・5つのタブでの目視比較といった周辺作業にあるなら、最終セクションで第三の道を紹介します。Tabbit Browser 内で比較を実行する方法です。まずは候補から。
重要なポイント
最初に試すべきは MiMo-V2.6-Flash:1M コンテキスト、オムニモーダル入力、API 画面をそのままに、100万トークンあたり $0.14/$0.28。公式自ら「MiMo-V2.5-Pro を全面的に上回った」と述べています。
DeepSeek V4.1 Flash はスケジューリングの切り札:オフピークの入力 $0.15・出力 $0.60 は破格で、共有表の DeepSWE v1.1 では 74.2 で首位です。
Kimi K3 はプレミアムなオープンウェイトの対抗馬:2.8T パラメータの推論モデルで、評価タスクあたりのコストは約17倍。買えるのは異なるベンチマーク性格であって、明確な勝利ではありません。
Qwen3.8 Max(0902)は100万トークンあたり $2/$6 のクローズド Flagship。オープンウェイト運用なしで Alibaba の最上位を使いたいチーム向けです。
GLM-5.3 は「コード品質優先」の常時推論モデル:コミュニティは「きれいな解決策」を評価し、OpenRouter のプロモ価格は $0.78/$2.46 です。
本稿のベンチマークはすべてベンダー報告値か第三者インデックス値、コミュニティの発言はすべて個人の経験です。公開週のスコアは動きます。
この代替候補を選んだ基準
4つの基準を順に適用しました。
完タスクコストで測る。定価ではない。 半額でも思考が3倍のモデルは安くありません。各候補を公式または掲載ルートの100万トークン単価で評価し、キャッシュ・ピーク時間帯・Batch 割引を注記します。
実務でのエージェント信頼性。 Artificial Analysis のインデックスはオープンウェイト勢の序列には有効ですが、Terminal Bench 4.0、ExploitGym、DeepSWE v1.1 はインデックスが隠す差を見せます。候補は少なくとも1つの証拠を必要としました。
オープンウェイトとデプロイ適合性。 セルフホストはデータ保管地・コスト構造・ロックインを変えます。各候補にオープン/クローズドを明記。この1行が移行作業の半分を決めます。
実名のコミュニティエビデンス。 選好と失敗パターンは HN・Reddit・X の具体的で開ける投稿から得ており、プレスリリースからではありません。
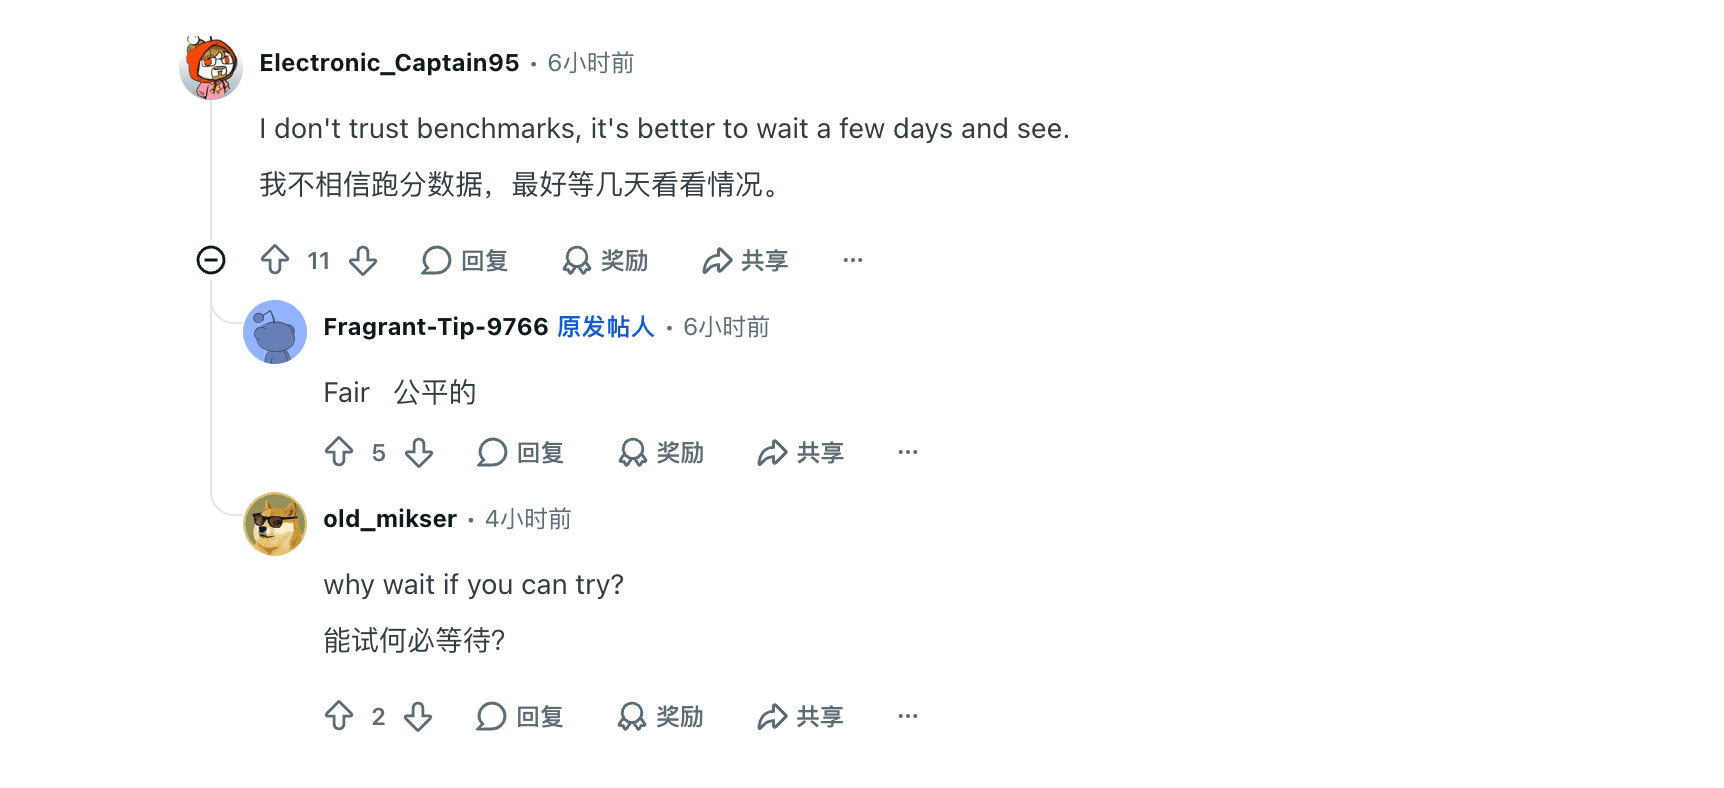
スクリーンショットはすべて2026年9月22日に実撮影した元投稿です。MiMo のコード利用を検討するスレッドで、ある Reddit ユーザーが姿勢を一言で示しました。「I don't trust benchmarks, it's better to wait a few days and see.」(ベンチマークは信じない。数日待って見るのがいい。)
候補5モデル一覧
| 候補 | 最適な用途 | 公表ルート | 100万トークンあたりの価格(2026-09-22 確認) | 最大の落とし穴 |
|---|---|---|---|---|
| MiMo-V2.6-Flash | 同ファミリーでコスト削減、移行最小 | mimo-v2.6-flash;1M コンテキスト/131K 出力;オープンウェイト | 入力 $0.14/キャッシュヒット $0.0028/出力 $0.28 | 難しいエージェントタスクでは Pro より推論の余裕が少ない |
| DeepSeek V4.1 Flash | オフピークのバッチとスケジュール型予算 | deepseek-flash;1M/384K;API のみ | オフピーク $0.15/$0.60;ピーク $0.30/$1.20;キャッシュヒット $0.003–$0.006 | ピーク時間帯(平日 UTC 01:00–04:00、06:00–10:00)は入出力とも倍額 |
| Kimi K3 | プレミアムなオープンウェイト推論と長尺エージェント | kimi-k3;1.0M コンテキスト;オープンウェイト | OpenRouter 掲載 $1.50/$7.50(50% オフ;定価 $3/$15) | 評価コストは MiMo の約17倍で、インデックスは逆に2ポイント低い |
| Qwen3.8 Max (0902) | マルチモーダル入力の Alibaba クローズド Flagship | qwen3.8-max-0902;1.0M コンテキスト | $2/$6 | クローズド——セルフホスト不可、ウェイト単位の代替なし |
| GLM-5.3 | 常時推論でコード品質優先 | glm-5.3;掲載 1.3M コンテキスト | OpenRouter 掲載 $0.78/$2.46(44% オフ) | 推論を無効化できない。ローカル運用は高コスト |
出典:Xiaomi MiMo 料金ページ(更新日 2026年9月21日)、DeepSeek 料金ページ、ならびに Kimi K3、GLM-5.3、Qwen3.8 Max の OpenRouter 掲載値。出力価格には推論トークンが含まれます。OpenRouter の価格には確認日時点のプロモバッジが付いています。Moonshot と Alibaba 自身の価格ページは本セッションでアクセスできなかったため、OpenRouter の掲載値を限界の注記付きで代用しています。
MiMo ファミリーの完全な料金計算——キャッシュ、UltraSpeed、Batch API——は MiMo-V2.6-Pro 料金ガイドに譲ります。本ページは「使い続けるか、乗り換えるか」の判断だけを扱います。
MiMo-V2.6-Flash
最適な用途: Xiaomi の API・コンテキスト長・入力タイプを変えずに、トークン請求を3分の2削ること。
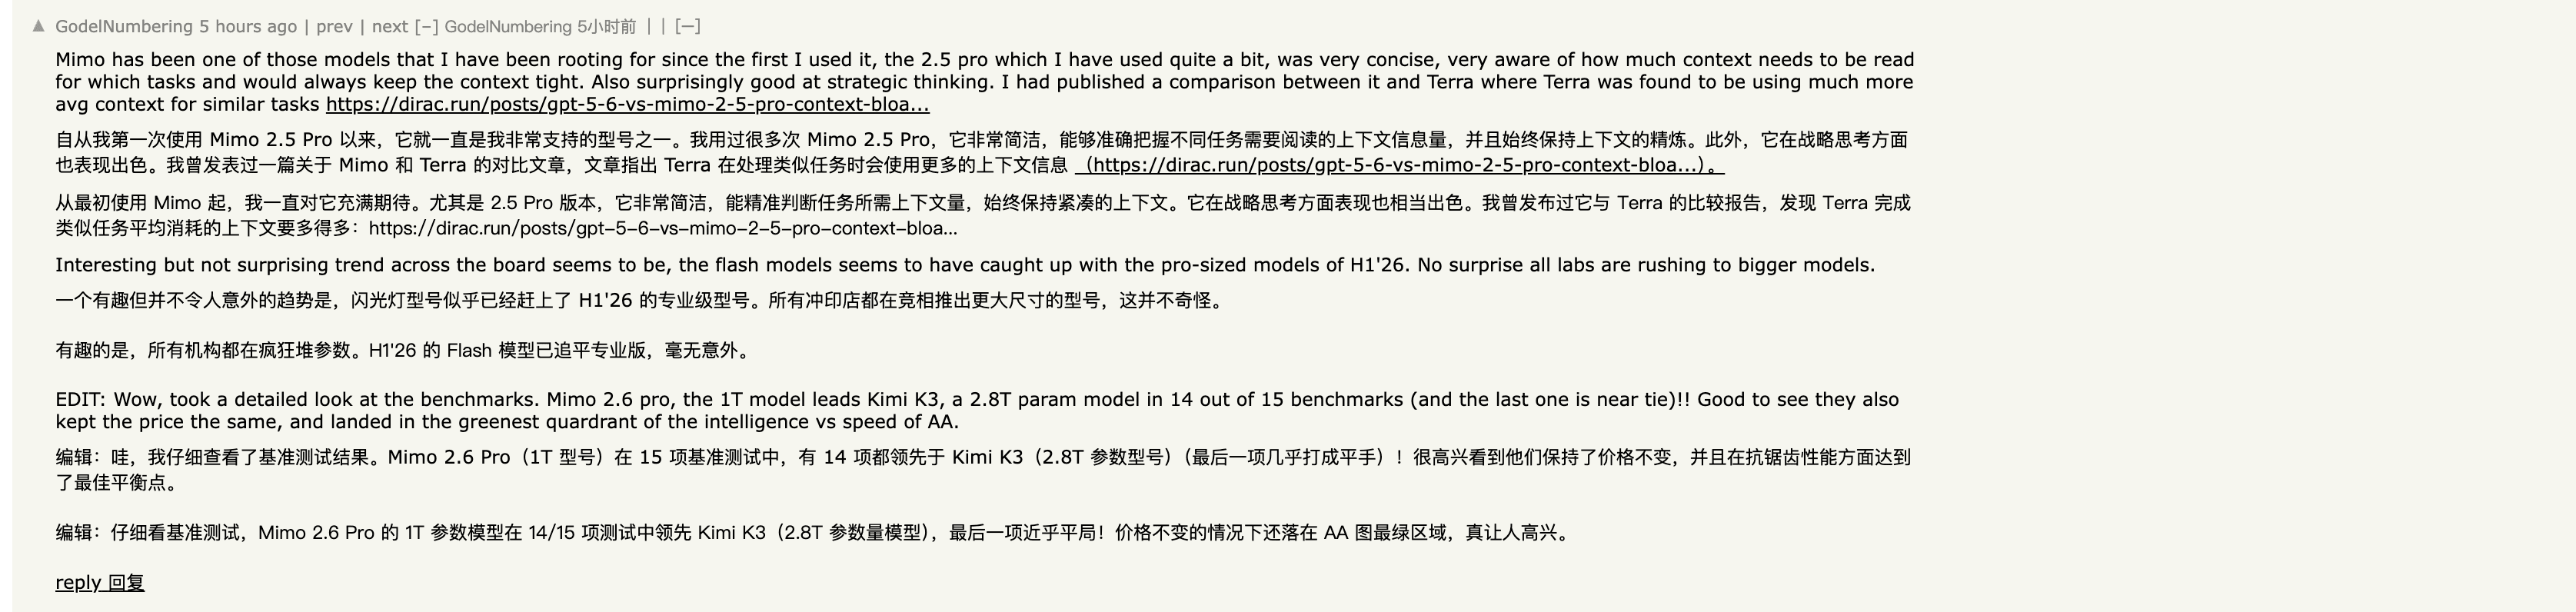
長所: Flash は Pro と同じ 1,048,576 トークンのコンテキスト、131,072 トークンの出力上限、ネイティブなマルチモーダル入力を共有し、価格は100万トークンあたり入力 $0.14・出力 $0.28。Batch API なら $0.07/$0.14 まで下がります。本リストで唯一、性能向上の裏付けがベンダー自身の発表文に書かれている候補です。「MiMo-V2.6-Flash has comprehensively outperformed MiMo-V2.5-Pro.」(MiMo-V2.5-Pro を全面的に上回った。)Xiaomi が公開した共有エージェント表では Terminal Bench 4.0 で 28.8 を記録し、DeepSeek V4.1 Flash の 26.8 を上回る。Kingy の独立 OpenCode 実測では無料ルートで 23 項中 21 項と、兄貴分に2項差まで迫りました。V2.5 から追い続けた HN のコメンターはこう要約しています。「the 2.5 pro… was very concise, very aware of how much context needs to be read for which tasks and would always keep the context tight」(2.5 Pro は非常に簡潔で、タスクごとに読むべきコンテキスト量をわきまえ、常にコンテキストを締めていた)。さらに編集でこう付け加えています。「Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!」(1T の MiMo 2.6 Pro は 15 項中 14 項で 2.8T パラメータの Kimi K3 をリードし、最後の1項もほぼ引き分け!!)
短所: 小さいモデルです。総パラメータ 309B/活性化 15B は Pro の 1.02T/42B に対し、深い多段推論の余裕は少なめ。同じ OpenCode 実測で2項差を付けられ、ExploitGym では Pro の 17.8 に対し 6.0 にとどまります。ワークロードが Pro の推論深度を必要とするなら、Flash は偽りの節約です。
料金: 100万トークンあたり入力 $0.14/キャッシュヒット $0.0028/出力 $0.28。Batch API でさらに半額。UltraSpeed の10倍乗数は Pro 専用です。計算例はファミリー料金表を参照。
結論: MiMo-V2.6-Pro への不満が請求額であって天井でないなら、まず Flash を試す——それこそ公式が出した安価な答えです。難しいエージェントタスクの品質への不満なら、Flash では解決しません。DeepSeek か Kimi K3 を見てください。
MiMo-V2.6-Flash モデルページ (English)に仕様と移行メモをまとめてあります。
DeepSeek V4.1 Flash
最適な用途: オフピークで実行できる高ボリューム処理と、1M コンテキスト・ビジョン対応・底値の API を求めるチーム。
長所: DeepSeek の現行料金ページに載っている deepseek-flash(DeepSeek-V4.1-Flash)は、非思考・思考両モード、1M コンテキスト、最大出力 384K、ビジョン、JSON 出力、ツール呼び出し、OpenAI 互換と Anthropic 互換の両エンドポイントに対応します。オフピークでは入力 $0.15、出力 $0.60(100万トークンあたり)。キャッシュが温まれば、繰り返しのプレフィックスは $0.003 で課金されます。Xiaomi が公開したエージェント系ベンチマークでは、DeepSWE v1.1 で 74.2 を記録。これは共有表の最高値で、74.0 の Claude Opus 5 と GPT-6 Astra、71.9 の MiMo-V2.6-Pro を上回ります。明示された同時実行上限は 2,500 で、ページ内で最上位です。
短所: 時間帯表です。ピーク時間帯——平日の UTC 01:00–04:00 と 06:00–10:00(中国の祝日を除く)——にはすべての料金が正確に2倍になり、ピークのキャッシュミスは100万トークンあたり $0.30 になります。実務コードの品質については評価が割れます。小さなオープンモデルを比較した LocalLLaMA のスレッドで、ベテランのコメンターはこう主張しました。「DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world - it is capable of getting to a solution but it's still hacky as heck」(技術的には GLM-5.3-Flash よりずっと有能だが、実務では劣る。解決には到達できるが、コードが雑すぎる)。DeepSeek は価格変更の権利を留保しているため、予算を組む際は本稿ではなく公式ページを引用してください。
料金: オフピークでキャッシュヒット $0.003/ミス $0.15/出力 $0.60。ピークは $0.006/$0.30/$1.20(100万トークンあたり)。オフピーク価格はピークのちょうど半分です。
結論: ワークロードがスケジューラブル——バッチ処理、夜間サマライズ、定時実行のエージェント——で、受け入れテストがその出力で通るなら DeepSeek を選んでください。ピーク時間帯の対話レイテンシを安定価格で保ちたい場合や、その深い推論が自社のタスクで実際に勝つ場合は、MiMo-V2.6-Pro を使い続けてください。
DeepSeek V4.1 Flash モデルページ (English)とDeepSeek V4 Flash 料金解説が時間帯表を詳しく扱っています。
Kimi K3
最適な用途: Moonshot のエコシステムに既に投資しており、Xiaomi 以外で最強のオープンウェイト選択肢を求め、その対価を払えるチーム。
長所: Kimi K3 は 2.8T パラメータのオープンウェイト・マルチモーダル推論モデルで、1.0M コンテキスト、KDA と Attention Residuals のアーキテクチャを備えます。OpenRouter の掲載価格は100万トークンあたり入力 $1.50/出力 $7.50(50% プロモ中;定価 $3/$15)。Artificial Analysis でも依然としてエリート級のオープンモデルです。max effort で Intelligence Index 43.6、Coding Index 76.2、Agentic Index 50.0——このエージェント数値は、複数の共有スイートで MiMo-V2.6-Pro の対応値を上回ります。リポジトリ規模の長尺作業には根強いファンがいます。
短所: 今月の価格×インデックスの計算は残酷です。OrcaRouter の分析は、同じ評価スイートの実行コストを Kimi K3 で $3,658.07、MiMo-V2.6-Pro で $206.66 と測定しました——17倍の差——スコアは 44 対 46。熱狂には批判もあります。「the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them. K3 is especially embarrassing…」(今、中国のラボが出している「最良」モデルの GLM 5.3 と Kimi K3 は、実務で使うと完全に崩壊する。特に K3 は embarrasing だ……)と、公開日に HN のコメンターが主張しました。公開されたテスト詳細のない強い意見であり、検証はできませんでしたが、K3 のプレミアムが買うのは別の性格であって保証された勝利ではない、という警告になります。

料金: 2026年9月22日時点の OpenRouter プロモ掲載で100万トークンあたり $1.50/$7.50。定価は $3/$15。本調査では Moonshot の価格ページにアクセスできなかったため、予算確定前に公式ページで確認してください。
結論: 既存の K 系パイプライン、特定のエージェント強み、マルチモーダルの性格がタスクスイートで勝ち、予算が承認済みなら Kimi K3 を選びます。同じインデックス性能がラベルより重く、コストが重いなら MiMo-V2.6-Pro を。17倍のコスト差が判断のすべてです。
Kimi K3 料金ガイドと Kimi K3 モデルページ (English)が料金構造と仕様を扱っています。
Qwen3.8 Max (0902)
最適な用途: Alibaba のクローズド Flagship——マルチモーダル入力、デフォルトで推論オン、1M コンテキスト——を、オープンウェイト運用なしの管理 API として使いたいチーム。
長所: Qwen3.8 Max の 0902 スナップショットは 2.4T パラメータの Mixture-of-Experts モデルで、テキスト・画像・動画入力を受け付け、1.0M コンテキスト、ツール呼び出し、構造化出力、設定可能な推論レベルに対応します。Artificial Analysis のインデックスでは 45 点——MiMo-V2.6-Pro の 46 と1ポイント差——で、Coding Index は 76 とフロンティア帯に並びます。100万トークンあたり $2/$6 は西側のどの Flagship より数分の一で、ウェイト運用の責任も負いません。Xiaomi 自身の発表文が、MiMo-V2.6-Pro が超えた相手として名前を挙げたのが Kimi K3 とこのモデルです。比較は公式が明示しています。
短所: クローズドであることが、セルフホストの議論を終わらせます。チェックポイントもライセンスファイルもなく、Alibaba がアクセス条件を変えればウェイト単位の退路もありません。Qwen のオープンウェイト・ファン自身が、小さいモデルを見るよう勧めています。「Thank you Xiaomi for making Qwen3.8-Next-Flash looks so awesome for half the size. Qwen is the king of open-weight models.」(半分のサイズの Qwen3.8-Next-Flash を際立たせてくれてありがとう、Xiaomi。オープンウェイトの王は Qwen だ。)MiMo 公開日に r/LocalLLaMA の常連が書いたこの「感謝」は、Qwen のオープンファミリーへの賛辞であると同時に、Max がこのファミリーのクローズド例外だと教えてくれます。
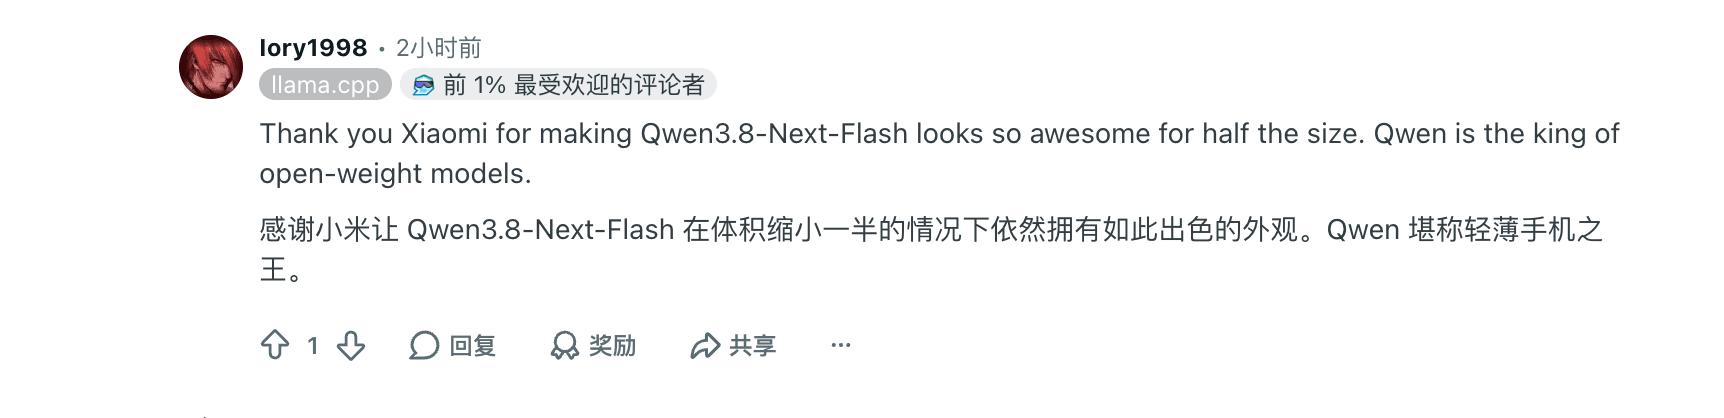
料金: 2026年9月22日時点で、OpenRouter の 0902 スナップショット掲載は100万トークンあたり入力 $2/出力 $6。本調査セッションでは Alibaba Cloud の価格ページが描画しなかったため、契約前に公式ページで確認してください。
結論: クローズドで管理されたマルチモーダル Flagship を使い、Alibaba のアカウント条件が地域とコンプライアンスに合うなら Qwen3.8 Max を選びます。オープンウェイト、MIT ライセンス、低い料金表に重みがあるなら MiMo-V2.6-Pro を。あるいは再テストが Xiaomi の表を再現し、より安いチェックポイントを支持するなら、その通りにしてください。
Qwen3.8 Max モデルページ (English)がスナップショットの仕様を追跡しています。
GLM-5.3
最適な用途: 速度や価格より解の品質が重要なコード生成。推論は常時オンです。
長所: GLM-5.3 は Z.ai の大規模推論モデルで、複雑なソフトウェア工学と長尺エージェントタスクのために構築されています。推論レベルは low/high/max(既定は max)で、OpenRouter の掲載では 1.3M コンテキスト。Artificial Analysis では Intelligence Index 44.8、さらに重要な Agentic Index は 53.1——エリート級のエージェント数値です。定性評価が面白いところです。DeepSeek の出力を「hacky(雑)」と呼んだ LocalLLaMA の同じコメンターは、同じ一文で GLM を称えています。「GLM-5.3 implements clean solutions (develops an architecture and uses design patterns).」(GLM-5.3 はきれいな解を書く。アーキテクチャを組み、デザインパターンを使う。)OpenRouter のプロモ掲載は100万トークンあたり $0.7826/$2.46——44% オフ——で、価格は MiMo-V2.6-Pro と Kimi K3 のちょうど中間に落ちます。
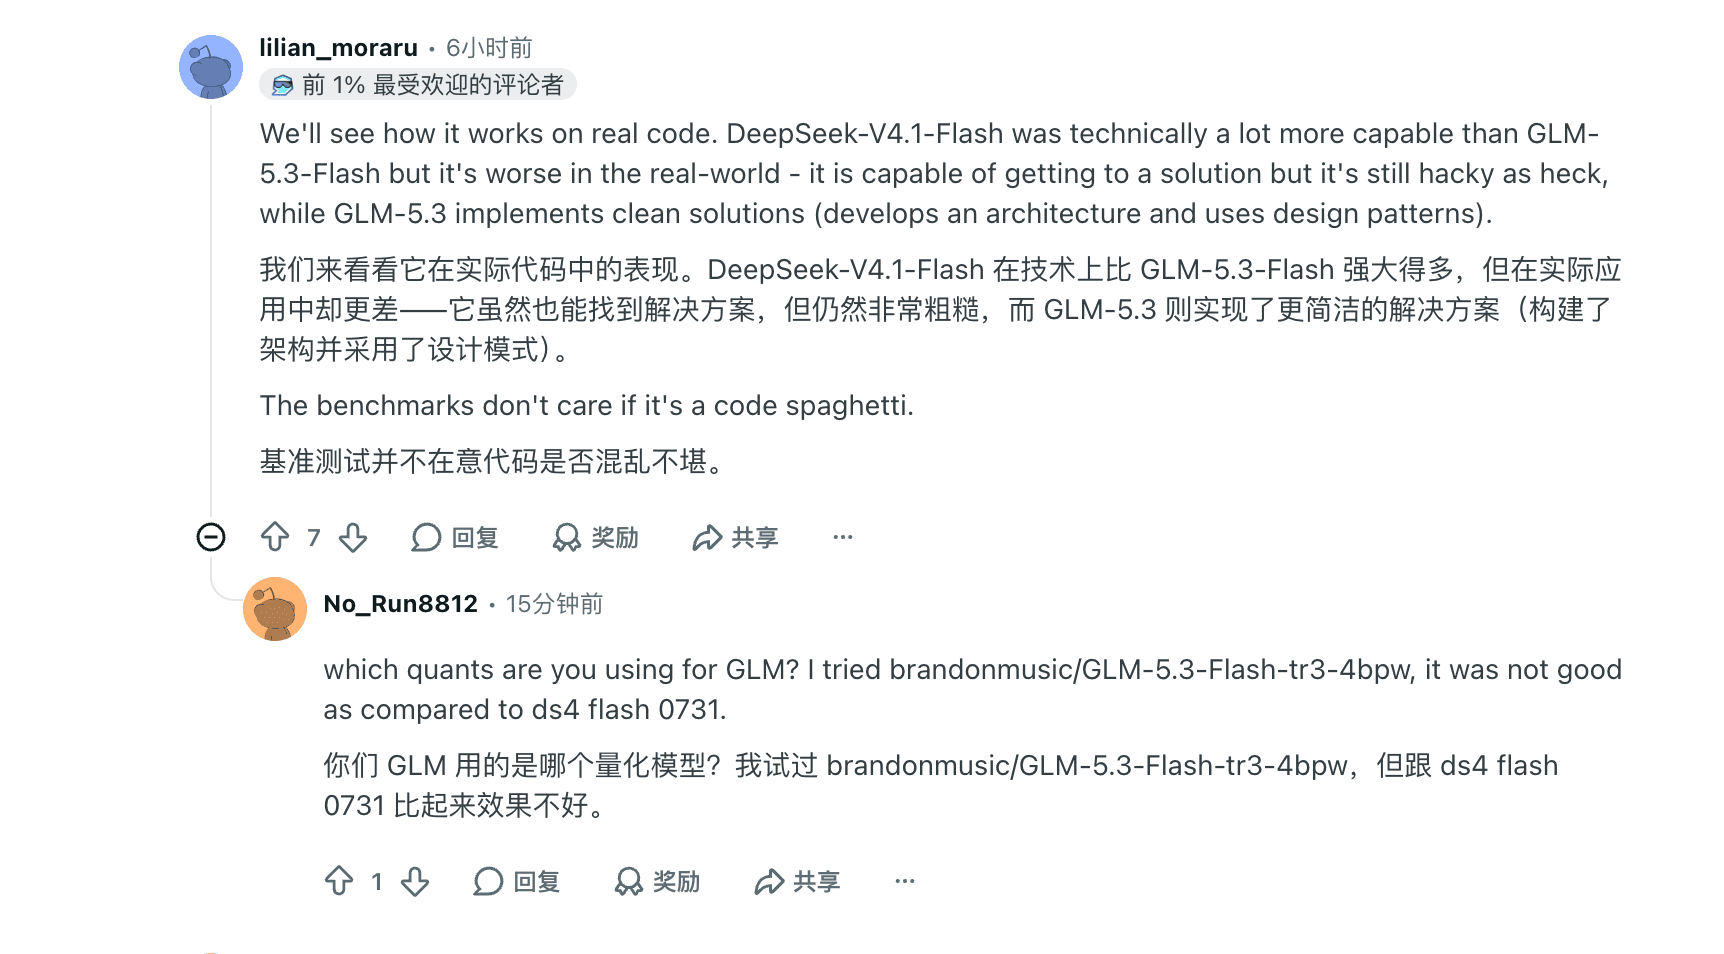
短所: 推論を無効化できないため、抽出や分類のような安い非思考モードが存在せず、すべての呼び出しが思考税を払います。ローカルサービングは別プロジェクトです。「GLM 5.3 flash should already not be on there. Extremely expensive to run local.」(GLM 5.3 flash はそもそもあのリストに入るべきではない。ローカルで動かすには高すぎる。)MiMo 比較スレッドのコメンターのこの言葉がそのまま当てはまります。さらに本調査セッションでは Z.ai のドキュメントサイトにアクセスできず、掲載価格には OpenRouter 単独の限界があります。
料金: 2026年9月22日時点で、OpenRouter の 44% オフ掲載は100万トークンあたり $0.7826/$2.46。定価は約 $1.40/$4.39。
結論: コードレビュー品質、アーキテクチャ感、エージェント指数がパイロットで勝ち、常時推論の予算を受け入れられるなら GLM-5.3 を選びます。切り替え可能でキャッシュフレンドリー、定価の半分以下の API が必要なら MiMo-V2.6-Pro を。請求額が支配的なら Flash を。
GLM-5.3 モデルページ (English)に仕様とルートの注記を保存してあります。
第三の道:Tabbit の中で比較を実行する
モデル乗り換えプロジェクトの多くは、モデルの品質ではなく物流でつまずきます。5社の API キー発行、出力の正規化、5つのタブでの目視比較。Tabbit Browser はこの層を攻めます。マルチモデル表示は1つのプロンプトを複数モデルへ同時送信し、回答をスプレッドシートのように読める横並びのカラムに配置します。オムニボックスのモデルセレクターは、再認証なしでチャットごとにアクティブなモデルを切り替えられます。
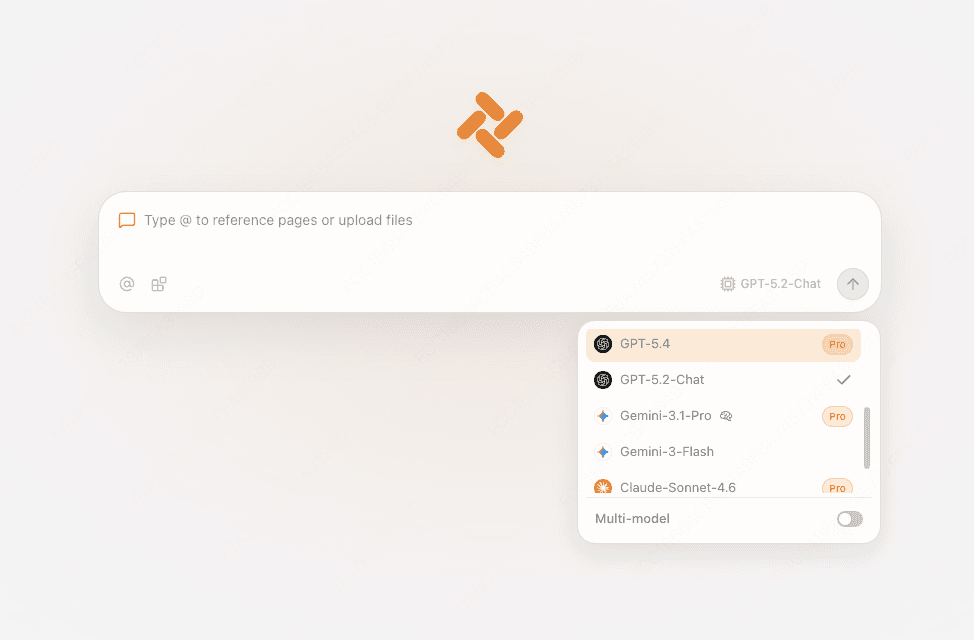
実践的なパイロットループはこうです。@ で対象のページやファイルを参照し、候補2〜3モデルを選んで一画面で回答を比較。それを実際に回している5つのタスクで繰り返します。請求書のスプレッドシートなしで、一午後で意思決定に耐えるサンプルが取れます。エージェント型ブラウジングがこの流れに何を加えるかは、agentic browser とは何かと2026年の AI ブラウザ比較を読んでください。
誠実さのための境界線が2つあります。第一に、Tabbit で実際に使えるモデルはアカウントのモデルセレクターとプラットフォーム規約に依存します。本記事は MiMo-V2.6-Pro を含む特定のモデルが全アカウントに内蔵されると主張せず、Tabbit は外部 API の課金関係を代替しません。第二に、ブラウザ内比較はパイロットであってベンチマークではありません。プロンプトとページは制御しますが、トークン計量と分散は制御しません。短リストの選定に使い、予算は料金ガイドで決めてください。
 Tabbit Browser
同一タスクのパイロットを実行する
ショートリストに残った候補がどれであれ、試し方は同じです。実際のタスクを2〜3個凍結し、入力・指示・ツール・出力契約・リトライ予算を固定します。トークン数、初トークン時間、完了時間、ツールの失敗、手動修正を記録し、出力として課金される推論トークンを含む完タスクコストを計算します。きれいな1回の実行は、料金も信頼性も証明しません。分散が驚きでなくなるまで繰り返してください。コンテキストやツールルートを変えることは、それはルートの差であって、あるモデルが普遍的に優秀な証拠ではありません。
結論:シナリオ別の「続ける/乗り換える」
このページに総合優勝はいません。公開日のリーダーボードも今月を生き残れません。判断は制約が決めます。
| 主要な制約 | 最初のパイロット | 合格基準 | 主な注意点 |
|---|---|---|---|
| 請求を削り、ワークフローは維持 | MiMo-V2.6-Flash | 同タスクが3分の2のトークン予算内で通る | 難しいエージェントタスクで推論の余裕が減る |
| 最安のスケジュール型バッチ | DeepSeek V4.1 Flash | オフピークの混合単価が $0.20/1M 未満で受け入れ通過 | ピークは倍額。スケジュールするか、払うか |
| 価格無制限のオープンウェイト対決 | Kimi K3 | タスクスイートの利益が17倍のコストを正当化する | プレミアムが買うのは性格であり、保証された勝利ではない |
| 管理されたクローズド Flagship・マルチモーダル | Qwen3.8 Max (0902) | コンプライアンスとアカウント条件が合い、タスクが通る | セルフホストの退路なし。スナップショットはローテートする |
| コード品質を速度より優先 | GLM-5.3 | 実リポジトリでのレビュースコアが対抗を上回る | 推論常時オン。安いモードはない |
| キャッシュフレンドリーな推論を $0.435/$0.87 で | MiMo-V2.6-Pro を継続 | 自分で回した完タスクコストが対抗を下回る | レベル管理を。トークン請求は思考とともに伸びる |
MiMo-V2.6-Pro を続けるなら、推論レベルを意識的に設定してください。medium と high にこそトークンの胃口があります。プロンプトのプレフィックスを安定させ、$0.0036 のキャッシュ層を機能させてください。

乗り換えるなら、リーダーボードではなく制約が行き先を選ばせてください。MiMo-V2.6-Pro 料金ガイドと Gemini 3.8 Flash の代替比較が、料金とファミリー横断の全体像を補う読み物です。
出典
本ガイドの事実・価格・引用はすべて2026年9月22日に確認しました。
OpenRouter 掲載:Kimi K3、GLM-5.3、Qwen3.8 Max (0902)
コミュニティ投稿は本文中のスクリーンショットとリンクのとおり:X(@huanfeng9999)、Reddit(r/DeepSeek、r/LocalLLaMA)、Hacker News(項目 49793293、49794307、49795049、49795769)

よくある質問
MiMo-V2.6-Pro に最も近い代替モデルは?
同ファミリーの MiMo-V2.6-Flash が最も近い代替です。1M コンテキスト、オムニモーダル入力、API 画面をそのままに、トークン単価は約3分の1。他社のオープンウェイト勢では Kimi K3 が最接近ですが、定価は数倍で、ベンチマークの性格も異なります。
API の表記価格が最も安い代替は?
DeepSeek V4.1 Flash のオフピーク料金が最安で、キャッシュヒット $0.003/ミス $0.15、出力 $0.60(100万トークンあたり)。MiMo-V2.6-Flash はキャッシュミス時の入力 $0.14 がさらに安く、両ファミリーとも Batch API やオフピーク実行でさらに圧縮できます。最安ルートはキャッシュ命中率と実行時間帯で決まります。
MiMo-V2.6-Pro を使い続けるのは理にかなっていますか?
多くの場合、理にかないます。Xiaomi の公式説明では Artificial Analysis Intelligence Index のオープンウェイト首位、価格は入力 $0.435/出力 $0.87(100万トークンあたり)、第三者による OpenCode 実測では 23 項中 23 項合格・1回約3セントという結果です。推論が重いタスクで、プロンプトがキャッシュフレンドリーで、エージェント系ベンチマークの上位数ポイントまで求めないなら、使い続けるのが合理的です。
これらの代替モデルはセルフホストできますか?
MiMo-V2.6-Pro、MiMo-V2.6-Flash、Kimi K3 はウェイトを公開しており、Z.ai の GLM シリーズにもオープンソースの伝統があるため、十分なハードウェアがあればローカル運用は可能です。Qwen3.8 Max はウェイト非公開の API モデル、DeepSeek V4.1 Flash は DeepSeek の API 経由で利用します。導入前にライセンスとチェックポイントの条件を必ず確認してください。
MiMo-V2.5-Pro から移行する必要はありますか?
はい。Xiaomi の公式ドキュメントは、mimo-v2.5-pro と mimo-v2.5 が北京時間2026年10月21日10:00 に正式廃止されると明記しています。V2.6 シリーズは V2.5 と同じ API 価格のため、移行の多くはモデル ID の変更とリグレッションテストで済み、予算は変わりません。
Tabbit Browser で MiMo-V2.6-Pro は使えますか?
Tabbit で実際に使えるモデルはアカウントのモデルセレクターとプラットフォーム規約に依存するため、本記事では内蔵を断定しません。Tabbit のマルチモデル表示では、アカウントで利用可能なモデルを並べて比較でき、実際のページで代替候補を試す現実的な方法になります。