
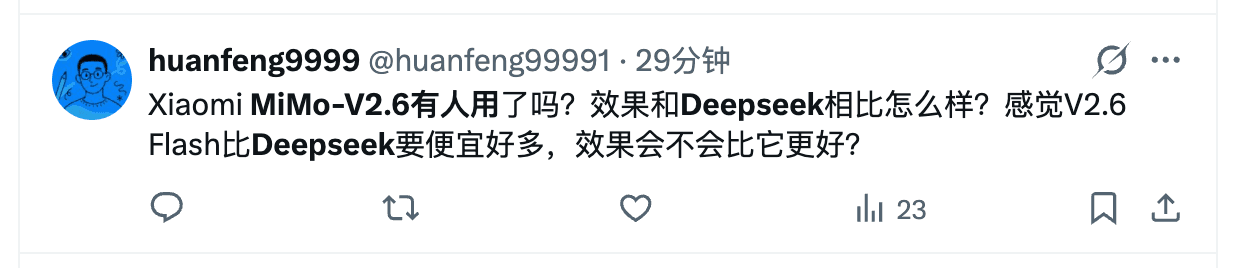
MiMo-V2.6-Pro 值得留在你的候選名單裡。小米在 2026 年 9 月 22 日發表並開源了這款旗艦,它在 Artificial Analysis 智能指數拿下 46 分——當時開源權重模型中的最高分——官方牌價是每百萬 token 輸入 $0.435、輸出 $0.87。發表前一天,Kingy AI 的獨立 OpenCode 實測給它 23 項隱藏編碼檢查全過、單次約 $0.03 的成績,準確率追平 Claude Opus 5,成本只有後者的約三十五分之一。發表當天,X 上有網友一句話問出了所有比較需求:「Xiaomi MiMo-V2.6有人用了吗?效果和Deepseek相比怎么样?感觉V2.6 Flash比Deepseek要便宜好多,效果会不会比它更好?」(有人用過了嗎?跟 DeepSeek 比效果如何?V2.6 Flash 好像便宜很多,會不會反而更好?)
要離開它的理由,恰恰來自小米自己。官方公告原文寫著:「However, there is still a gap when compared with the strongest closed-source models Claude Fable 5.1 and GPT-6 Astra.」(與最強閉源模型 Claude Fable 5.1 和 GPT-6 Astra 相比仍有差距。)廠商親口承認新旗艦還沒追上閉源前沿,這種話反而可信——同一指數上,Fable 5.1 和 GPT-6 Astra 坐在 53 分,比 MiMo-V2.6-Pro 高 7 分;Claude Opus 5 在 max effort 下拿 51 分,每個指數任務成本 $5.86,約是 MiMo($0.13)的 45 倍。
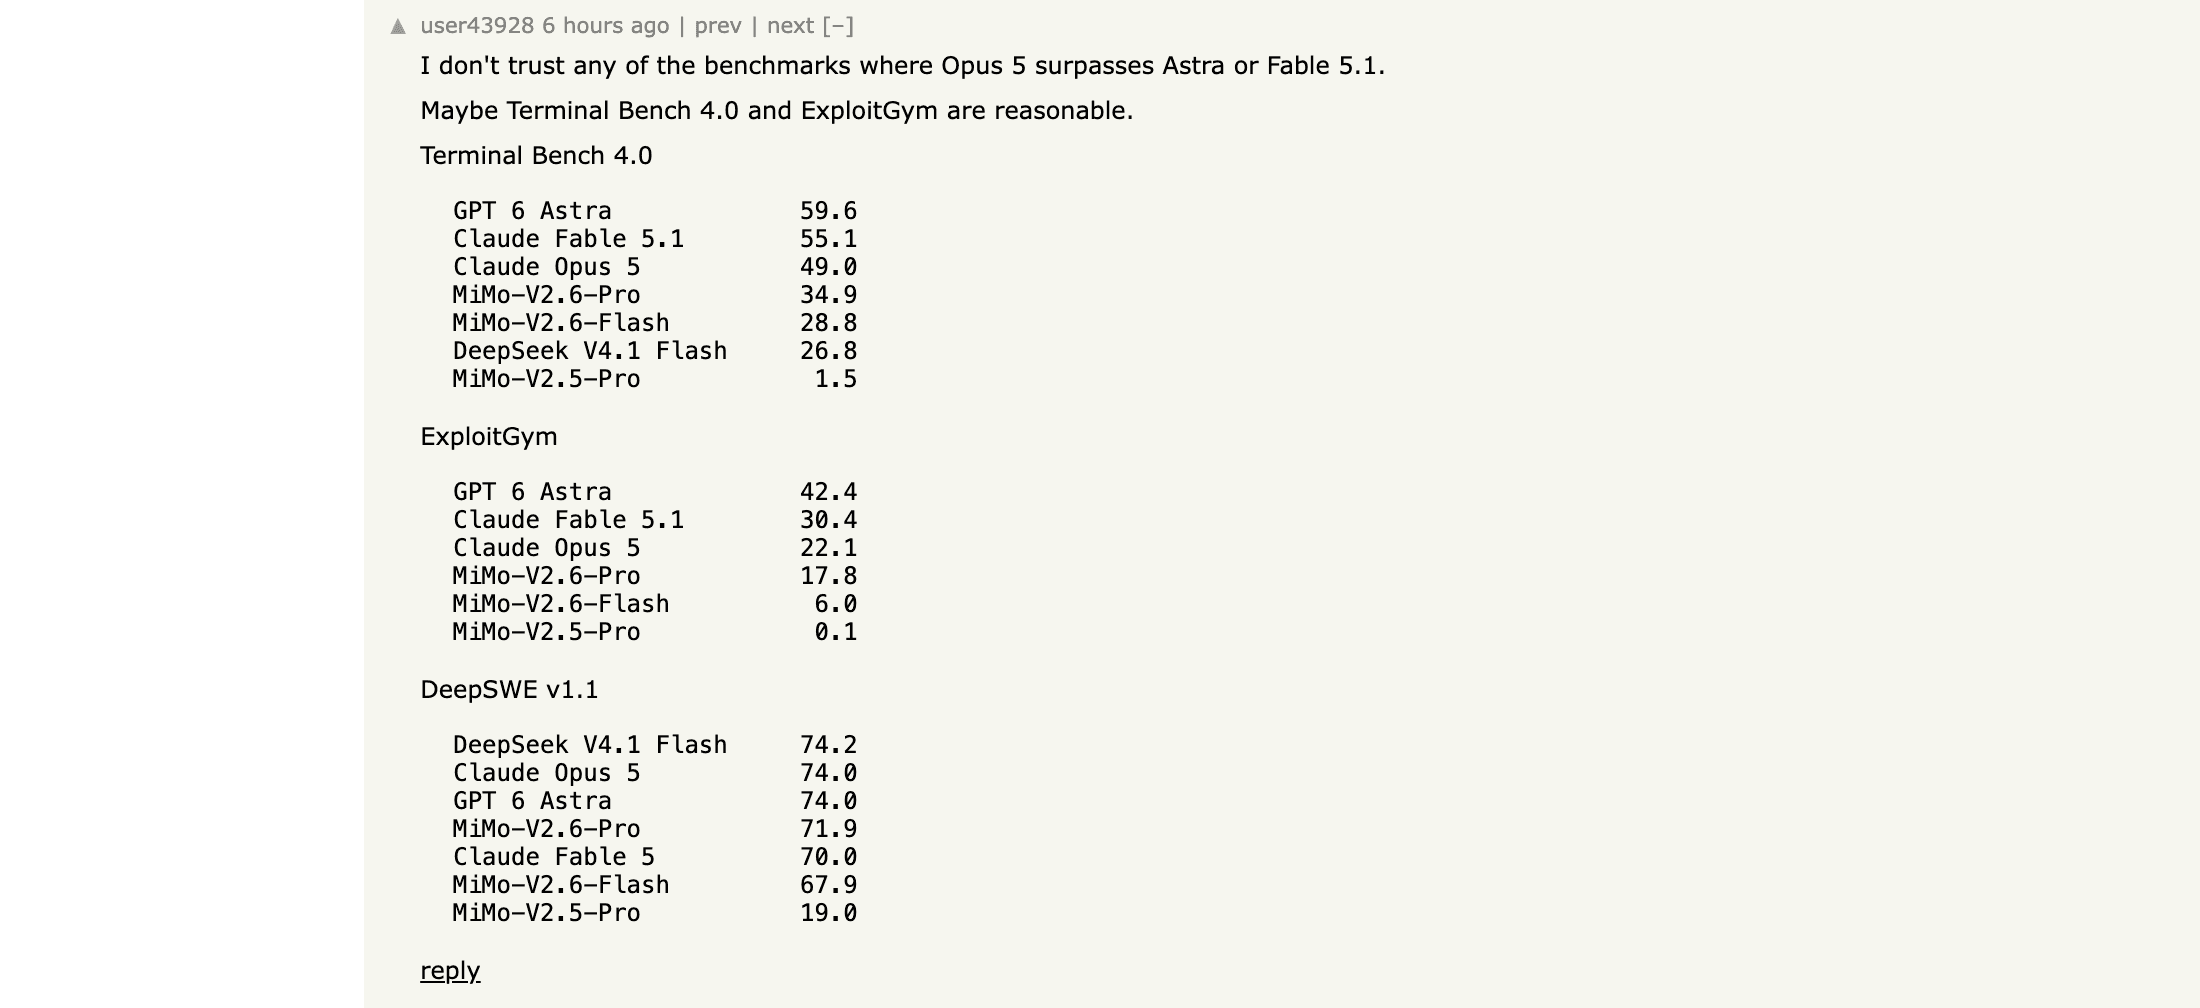
這 7 分差距背後藏著兩筆真實的帳。在 agent 類、要驅動終端機的 Terminal Bench 4.0 上,小米自己的表格給 MiMo-V2.6-Pro 打了 34.9 分,對面 Claude Opus 5 是 49.0、GPT-6 Astra 是 59.6。而支撐分數的推理過程會反映在帳單上:一位 Hacker News 測試者只能跑最低推理檔,因為「其他檔位(中/高)消耗的 token 太多,所有請求全部逾時」。這不是說 MiMo-V2.6-Pro 不行,而是說「最便宜的開源旗艦」這個標籤掩蓋了兩筆隱藏成本——agent 能力差距,以及隨思考變長的 token 帳單。這兩筆成本,都有對應的替代方案。
如果你不滿的其實不是模型,而是模型外圍的折騰——管理 API key、比價、開五個分頁人工比較——文末第 7 節給出第三條路:在 Tabbit 瀏覽器裡直接跑比較。先看候選。
核心結論
MiMo-V2.6-Flash 是第一個該測的替代方案:同樣的 1M 上下文、同樣的全模態輸入、同樣的 API 介面,價格 $0.14/$0.28(每百萬 token),小米官方還給了「全面超越 MiMo-V2.5-Pro」的背書。
DeepSeek V4.1 Flash 是排程型選手:離峰 $0.15 輸入 / $0.60 輸出幾乎沒有對手,而且在共享的 DeepSWE v1.1 表上以 74.2 分領跑。
Kimi K3 是高階開源權重對手:2.8T 參數推理模型,每個評測任務的成本約是 MiMo 的 17 倍,買到的是不同的基準樣貌,不是全面取勝。
Qwen3.8 Max(0902)是閉源同級旗艦,$2/$6 每百萬 token——適合想要阿里巴巴旗艦又不想碰開源維運的團隊。
GLM-5.3 是「程式碼品質優先」的常開推理模型:社群回饋肯定它「方案乾淨」,OpenRouter 促銷價 $0.78/$2.46。
本文所有基準都是廠商口徑或第三方指數口徑,所有社群留言都是個人經驗。發表週的數據會變。
我怎麼選出這些替代方案
四條標準,按順序套用:
完成任務的成本,不是牌價。 半價但思考三倍時間的模型並不便宜。每個候選都按自己的官方或掛牌路線計價,標註快取、尖峰與 Batch 折扣。
真實工作中的 agent 可靠度。 Artificial Analysis 指數把開源陣營排得很清楚,但 Terminal Bench 4.0、ExploitGym 和 DeepSWE v1.1 能看到指數掩蓋的差距。候選必須至少有其中一項的證據。
開源權重與部署條件。 自行部署改變資料落地、成本結構與綁定程度。每個候選都標明開源或閉源,這一行直接決定一半的遷移工作量。
具名的社群證據。 使用情境和失敗模式來自 HN、Reddit、X 上可點開的具體文章,不來自新聞稿。
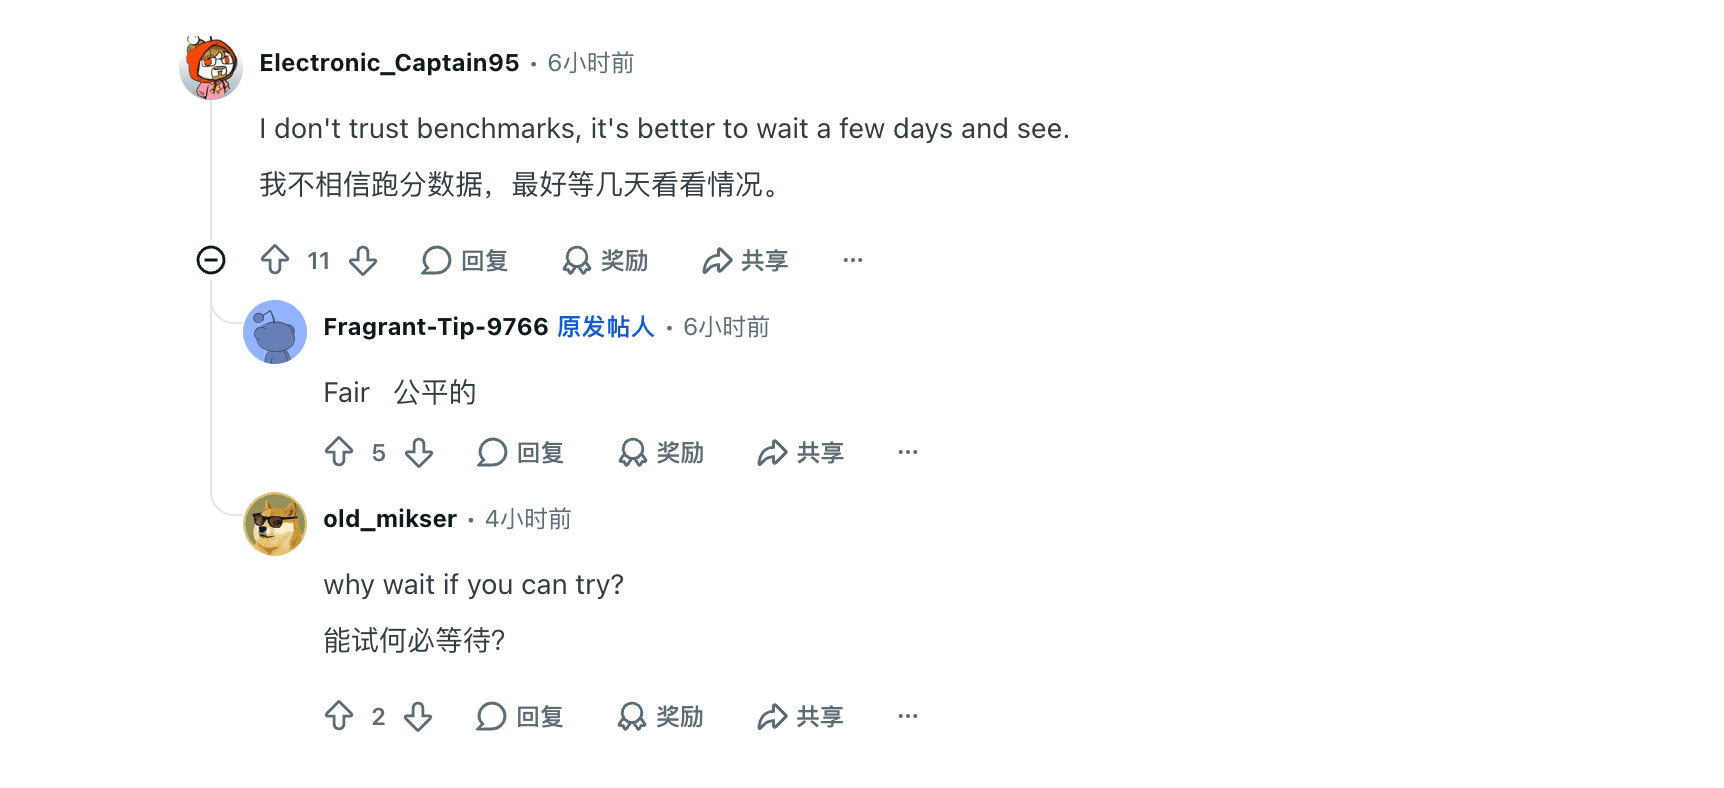
下面的截圖都是 2026 年 9 月 22 日實拍的原帖。在討論是否採用 MiMo 的討論串裡,一位 Reddit 網友把校準態度說得很直接:「I don't trust benchmarks, it's better to wait a few days and see.」(我不信跑分,最好等幾天再看看。)
五個候選一覽
| 候選 | 最適合 | 官方路線 | 每 1M token 價格(2026-09-22 核對) | 主要的坑 |
|---|---|---|---|---|
| MiMo-V2.6-Flash | 同門降價,遷移成本最小 | mimo-v2.6-flash;1M 上下文 / 131K 輸出;開源權重 | 輸入 $0.14 / 快取命中 $0.0028 / 輸出 $0.28 | 高難 agent 任務的推理餘裕不如 Pro |
| DeepSeek V4.1 Flash | 離峰批次與排程型預算 | deepseek-flash;1M / 384K;僅 API | 離峰 $0.15 / $0.60;尖峰 $0.30 / $1.20;快取命中 $0.003–$0.006 | 尖峰時段(工作日 UTC 01:00–04:00、06:00–10:00)輸入輸出全部加倍 |
| Kimi K3 | 高階開源推理與長程 agent | kimi-k3;1.0M 上下文;開源權重 | OpenRouter 掛牌 $1.50 / $7.50(5 折;目錄價 $3 / $15) | 評測任務成本約是 MiMo 的 17 倍,指數反而低 2 分 |
| Qwen3.8 Max (0902) | 阿里閉源旗艦,多模態輸入 | qwen3.8-max-0902;1.0M 上下文 | $2 / $6 | 閉源——不能自行部署,沒有權重級退路 |
| GLM-5.3 | 常開推理,程式碼品質優先 | glm-5.3;掛牌 1.3M 上下文 | OpenRouter 掛牌 $0.78 / $2.46(44% 折扣) | 推理無法關閉;本地部署成本高 |
來源:小米 MiMo 定價頁(更新時間 2026 年 9 月 21 日)、DeepSeek 定價頁,以及 Kimi K3、GLM-5.3、Qwen3.8 Max 的 OpenRouter 掛牌。輸出價包含推理 token。OpenRouter 價格帶有當日促銷徽章;Moonshot 與阿里巴巴自有的價格頁本次工作階段無法存取,因此以 OpenRouter 掛牌代替並註明此一邊界。
MiMo 家族的完整價目數學——快取桿桿、UltraSpeed、Batch API——見MiMo-V2.6-Pro 定價指南。本文只回答「留還是換」。
MiMo-V2.6-Flash
最適合: 不離開小米的 API、上下文視窗和輸入類型,把 token 帳單砍掉三分之二。
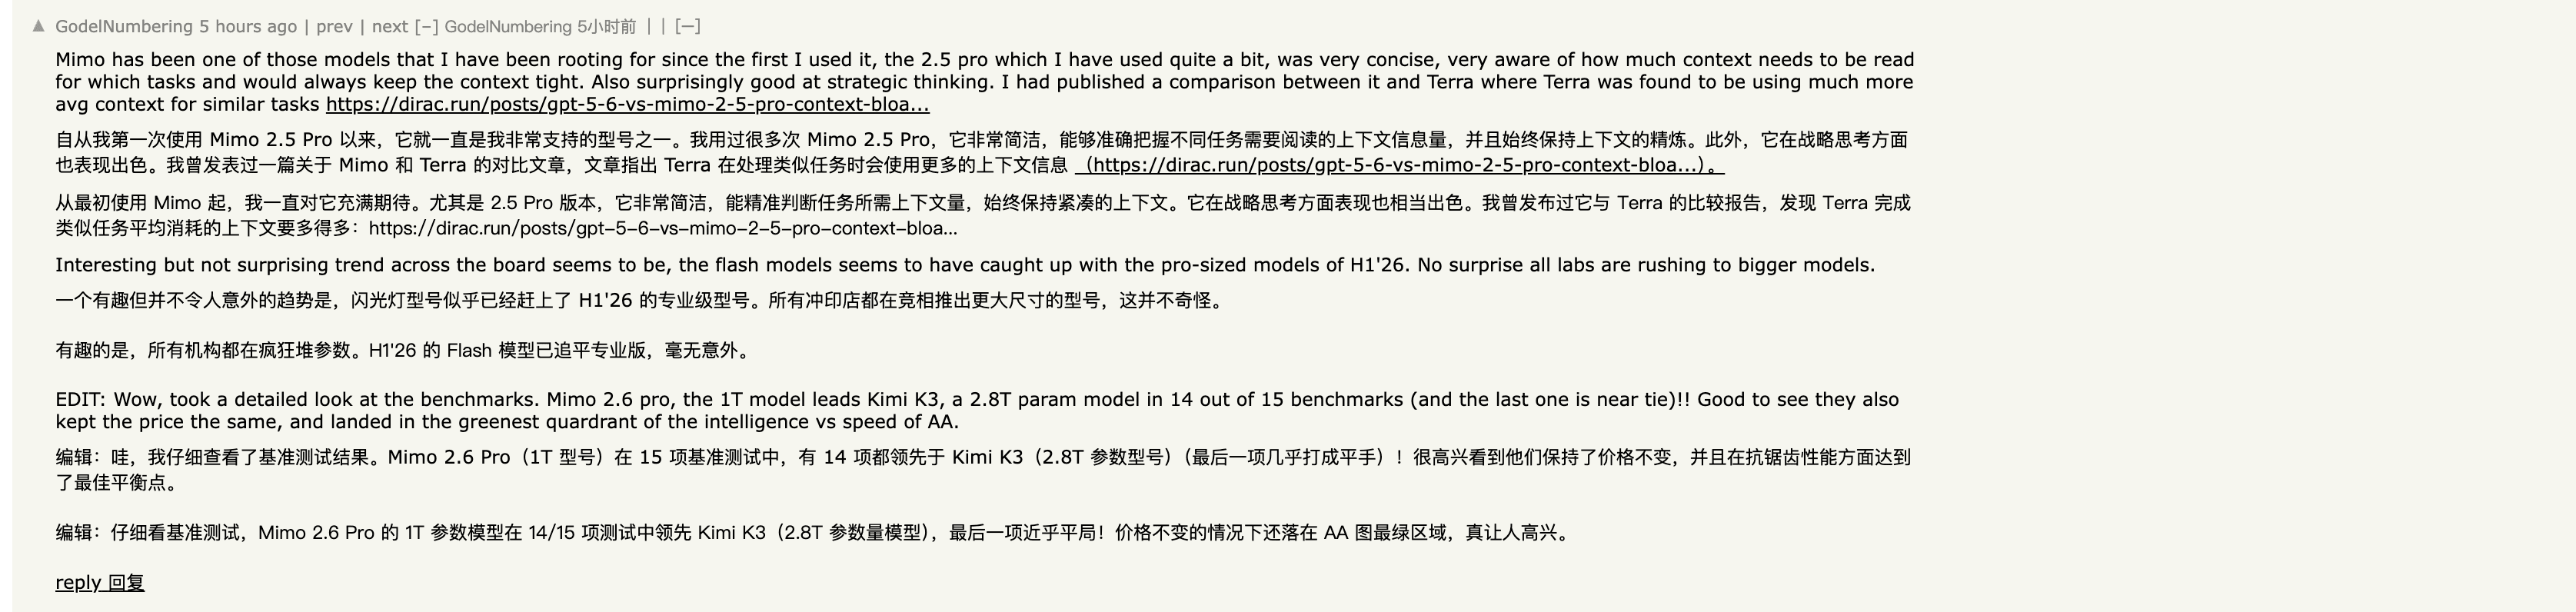
優點: Flash 與 Pro 共享 1,048,576 token 上下文、131,072 token 輸出上限和原生多模態輸入,價格為每百萬 token 輸入 $0.14、輸出 $0.28——走 Batch API 再降到 $0.07/$0.14。它是本清單裡唯一一個升級背書來自廠商發布稿本身的候選:「MiMo-V2.6-Flash has comprehensively outperformed MiMo-V2.5-Pro.」(全面超越 MiMo-V2.5-Pro。)在小米公布的共享 agent 表上,它 Terminal Bench 4.0 拿 28.8 分,高於 DeepSeek V4.1 Flash 的 26.8;Kingy 的獨立 OpenCode 實測在免費線路上拿下 23 項中的 21 項,只比大哥少兩項。一位從 V2.5 一路追過來的 HN 網友總結得很到位:「the 2.5 pro… was very concise, very aware of how much context needs to be read for which tasks and would always keep the context tight」(2.5 Pro 非常簡潔,清楚每個任務該讀多少上下文,始終保持上下文精煉),並在編輯中補充:「Mimo 2.6 pro, the 1T model leads Kimi K3, a 2.8T param model in 14 out of 15 benchmarks (and the last one is near tie)!!」(1T 的 MiMo 2.6 Pro 在 15 項基準裡的 14 項都領先 2.8T 參數的 Kimi K3,最後一項也接近打平!!)
缺點: 它是小模型。309B 總參數 / 15B 激活,對上 Pro 的 1.02T / 42B,深度多步推理的餘裕更小——同一場 OpenCode 實測裡它被扣掉兩個檢查項,ExploitGym 上 6.0 分對 Pro 的 17.8 分。如果你的工作負載吃的是 Pro 的推理深度,Flash 是假省錢。
定價: 每百萬 token 輸入 $0.14 / 快取命中 $0.0028 / 輸出 $0.28;Batch API 再打對折;UltraSpeed 的 10 倍加價只屬於 Pro。試算見家族價目。
結論: 如果你對 MiMo-V2.6-Pro 的不滿是帳單而不是上限,先測 Flash——這是官方自己給出的更便宜答案。如果你的不滿是高難 agent 任務的品質,Flash 解決不了,去看 DeepSeek 或 Kimi K3。
MiMo-V2.6-Flash 模型頁 (简体中文)把規格和遷移注意事項放在一起。
DeepSeek V4.1 Flash
最適合: 能跑離峰的大量任務,以及想要 1M 上下文、具視覺、地板價 API 的團隊。
優點: DeepSeek 目前定價頁列出的 deepseek-flash(DeepSeek-V4.1-Flash)同時支援非思考與思考模式,1M 上下文、384K 最大輸出,具視覺、JSON 輸出、工具呼叫,以及 OpenAI 和 Anthropic 兩種相容介面。離峰時段輸入 $0.15、輸出 $0.60 每百萬 token——快取變熱之後,重複字首只按 $0.003 計費。在小米公布的 agent 基準表上,DeepSeek V4.1 Flash 的 DeepSWE v1.1 拿到 74.2 分,是整張共享表的最高分,超過 74.0 的 Claude Opus 5 和 GPT-6 Astra,也超過 71.9 的 MiMo-V2.6-Pro。併發上限寫在頁面上的 2,500,是該頁最高檔。
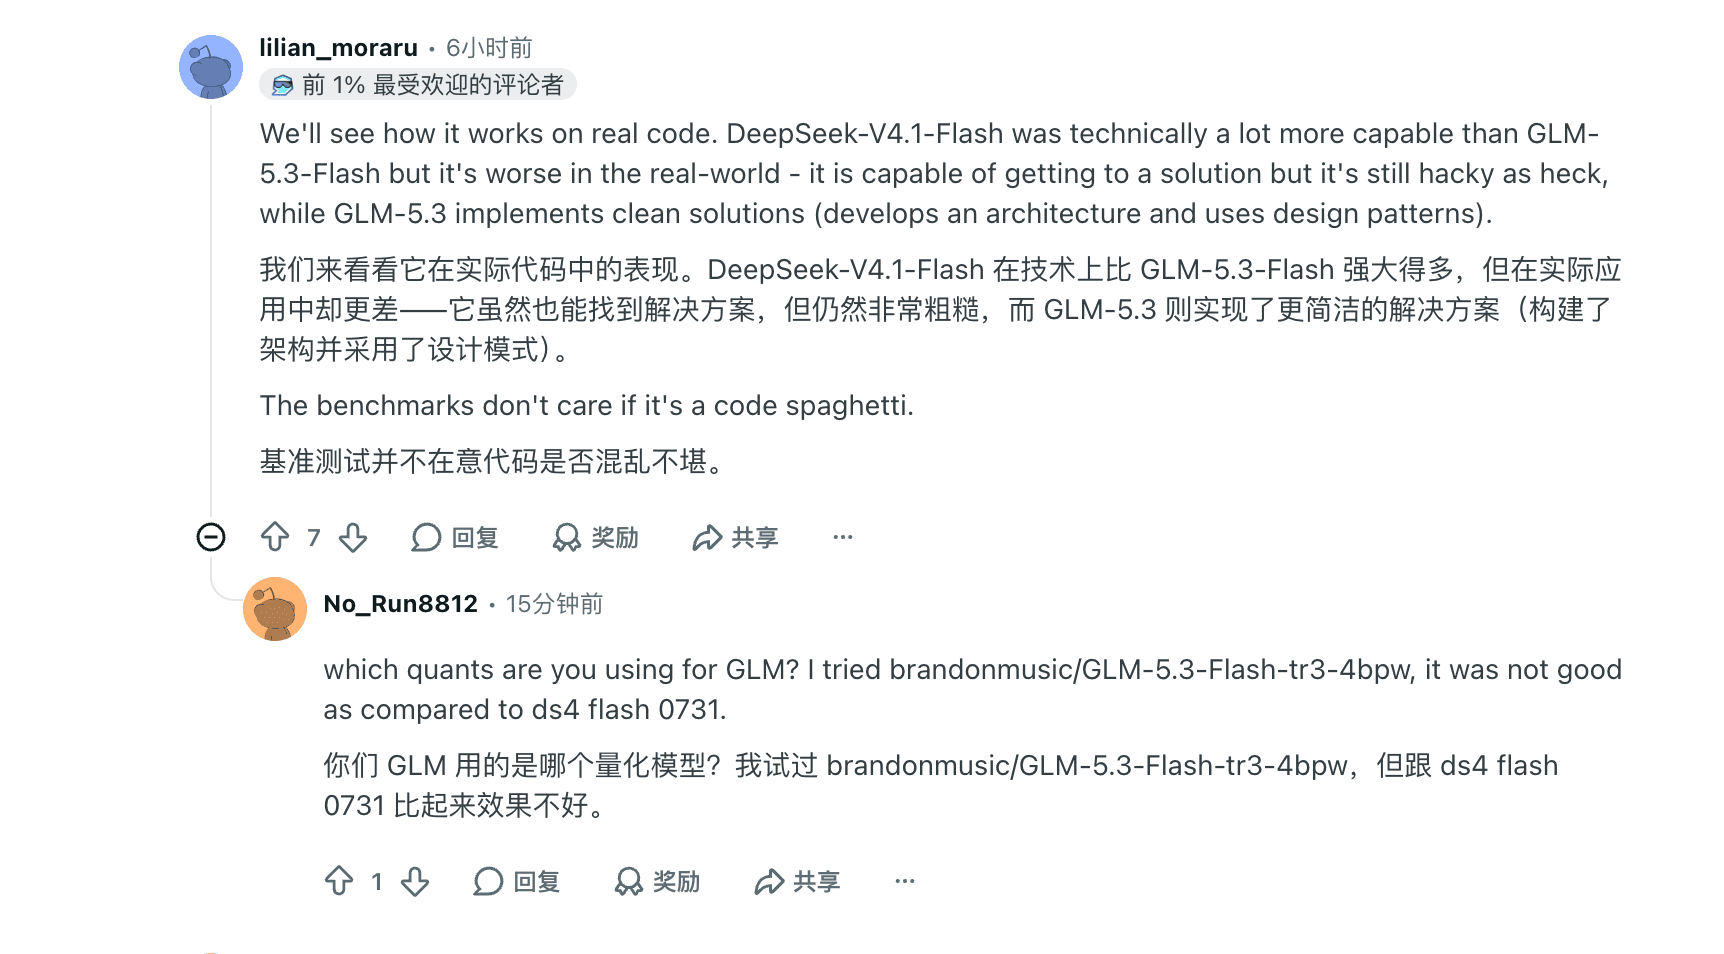
缺點: 時段表。尖峰時段——工作日 UTC 01:00–04:00 和 06:00–10:00,中國法定假日除外——所有費率精確加倍,尖峰快取未命中要 $0.30 每百萬。真實程式碼品質上社群意見分裂:在 LocalLLaMA 比較小型開源模型的討論串裡,一位資深留言者認為「DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world - it is capable of getting to a solution but it's still hacky as heck」(技術上比 GLM-5.3-Flash 強得多,但實際用起來更差——找得到方案,但很粗糙)。DeepSeek 也保留調價權利,做預算時引用它的頁面,別引用本文。
定價: 離峰 $0.003 快取命中 / $0.15 未命中 / $0.60 輸出;尖峰 $0.006 / $0.30 / $1.20 每百萬 token。離峰價就是尖峰的一半。
結論: 工作負載可排程——批次富集、夜間摘要、排程 agent——而且你的驗收測試在它的輸出上通過時,選 DeepSeek。需要尖峰時段互動延遲和可預測價格,或它的推理深度在你的任務集上確實贏時,留在 MiMo-V2.6-Pro。
DeepSeek V4.1 Flash 模型頁 (简体中文)和DeepSeek V4 Flash 定價拆解詳細覆蓋了時段表。
Kimi K3
最適合: 已經投入 Moonshot 生態、想要小米之外最強開源權重選項、並且付得起的團隊。
優點: Kimi K3 是 2.8T 參數的開源權重多模態推理模型,1.0M 上下文,採用 KDA 加注意力殘差架構,OpenRouter 掛牌 $1.50 輸入 / $7.50 輸出(5 折促銷;目錄價 $3 / $15)。在 Artificial Analysis 上它依然是精英級開源模型:max effort 下智能指數 43.6、編碼指數 76.2、agent 指數 50.0——這個 agent 分數在多個共享套件裡高於 MiMo-V2.6-Pro 的對應表現。做長程儲存庫級工作,它有真實的擁護者。
缺點: 這個月的價格-指數數學很殘酷。OrcaRouter 的分析測出同一套評測的成本:Kimi K3 $3,658.07,MiMo-V2.6-Pro $206.66——17 倍的差距——而分數是 44 對 46。熱度也有反對者:「the 'best' models available from chinese labs right now (GLM 5.3 and Kimi K3) fall apart completely when you try to do real work with them. K3 is especially embarrassing…」(現在中國實驗室最好的模型 GLM 5.3 和 Kimi K3,真拿去做實際工作就完全崩壞,K3 尤其尷尬……)這是發表日一位 HN 網友的激烈觀點,沒有公開測試細節、我們無法核實,但它提醒你:K3 的溢價買到的是另一種樣貌,不是穩贏。

定價: 2026 年 9 月 22 日 OpenRouter 促銷掛牌 $1.50 / $7.50 每百萬 token;目錄價 $3 / $15。本次調研中 Moonshot 官方價格頁無法存取,編列預算前請到官方頁面確認。
結論: 已有 K 系流水線、它的 agent 特長或多模態樣貌能贏得你的任務集、且預算已核准——選 Kimi K3。同樣在意指數表現、更在乎成本——選 MiMo-V2.6-Pro,17 倍的價差就是全部決策依據。
我們的Kimi K3 定價指南和 Kimi K3 模型頁 (简体中文)覆蓋了費率結構和規格。
Qwen3.8 Max (0902)
最適合: 想要阿里巴巴閉源旗艦——多模態輸入、預設開推理、1M 上下文——作為純託管 API、完全不碰開源維運的團隊。
優點: Qwen3.8 Max 的 0902 快照是 2.4T 參數的混合專家模型,接受文字、圖像、影片輸入,1.0M 上下文,支援工具呼叫、結構化輸出和可設定推理檔位。在 Artificial Analysis 指數上它拿 45 分,編碼指數 76,與前沿檔打平。$2 / $6 每百萬 token 的價格相對所有西方旗艦低了數倍,同時完全不必承擔權重託管責任。小米自己的發布稿點名 MiMo-V2.6-Pro 超越的就是它和 Kimi K3——這層比較是官方寫明的,不是我們推斷的。
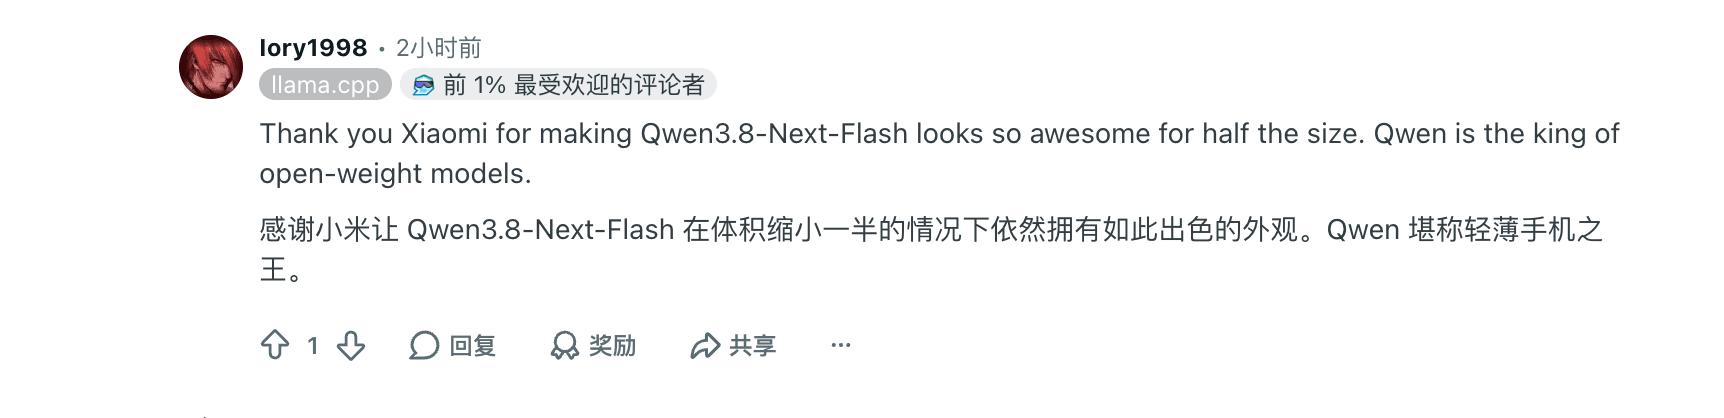
缺點: 閉源直接終結了自行部署的討論——沒有 checkpoint、沒有授權條款檔案,阿里巴巴調整存取條款時也沒有權重級退路。Qwen 自家的開源粉反而會勸你看小模型:「Thank you Xiaomi for making Qwen3.8-Next-Flash looks so awesome for half the size. Qwen is the king of open-weight models.」(感謝小米,讓體積減半的 Qwen3.8-Next-Flash 顯得更厲害了。Qwen 才是開源權重之王。)MiMo 發表當天一位 r/LocalLLaMA 老使用者的這句「感謝」,既是對 Qwen 開源家族的稱讚,也提醒你 Max 是這個家族的閉源例外。
定價: 2026 年 9 月 22 日核對,OpenRouter 上 0902 快照掛牌 $2 輸入 / $6 輸出每百萬 token。本次調研工作階段中阿里巴巴雲自有價格頁未能渲染,簽約前請到官方頁面確認。
結論: 想要閉源、託管、多模態的旗艦,且阿里巴巴的帳號條款符合你的地區與合規需求——選 Qwen3.8 Max。開源權重、MIT 授權或更低的價目表對你有分量——留在 MiMo-V2.6-Pro;或者當你的複測結果和小米的表格一致時,選那個更便宜的 checkpoint。
Qwen3.8 Max 模型頁 (简体中文)追蹤該快照的規格。
GLM-5.3
最適合: 方案品質比速度和價格更重要的程式碼生成——推理常開。
優點: GLM-5.3 是智譜 Z.ai 的大型推理模型,面向複雜軟體工程和長程 agent 任務,推理檔位分 low / high / max(預設 max),OpenRouter 掛牌 1.3M 上下文。在 Artificial Analysis 上,它智能指數 44.8,更有說服力的是 agent 指數 53.1——精英級。定性回饋更有意思:那位說 DeepSeek 輸出「粗糙」的 LocalLLaMA 留言者,同一句話裡誇了 GLM:「GLM-5.3 implements clean solutions (develops an architecture and uses design patterns).」(GLM-5.3 給出乾淨的方案——會先搭架構、用設計模式。)OpenRouter 促銷掛牌 $0.7826 / $2.46 每百萬 token——44% 折扣——價格正好落在 MiMo-V2.6-Pro 和 Kimi K3 之間。
缺點: 推理無法關閉,沒有廉價的非思考模式可以跑擷取或分類——每次呼叫都付思考稅。本地服務是另一個工程:「GLM 5.3 flash should already not be on there. Extremely expensive to run local.」(GLM 5.3 flash 根本不該出現在那個名單裡,本地跑太貴了。)MiMo 比較串裡這位網友的話可以直接引用。另外本次調研工作階段中 Z.ai 自家文件站無法存取,掛牌價只有 OpenRouter 一個來源邊界。
定價: 2026 年 9 月 22 日核對,OpenRouter 44% 折扣掛牌 $0.7826 / $2.46 每百萬 token;目錄價約 $1.40 / $4.39。
結論: 程式碼審查品質、架構感或 agent 指數能贏得你的試點,且常開推理的預算可以接受——選 GLM-5.3。需要可切換、快取友善的 API 且價格不到其目錄價一半——選 MiMo-V2.6-Pro;帳單主導——選 Flash。
GLM-5.3 模型頁 (简体中文)保存了它的規格與路線說明。
第三條路:在 Tabbit 裡直接跑比較
多數換模型的專案卡在後勤而不是模型品質:為五家供應商開 API key、統一輸出格式、開五個分頁人工比較。Tabbit 瀏覽器攻擊的就是這一層。它的多模型檢視把一條提示詞同時發給多個模型,答案並排成欄,讀起來像試算表;輸入框裡的模型選擇器可以在不同對話間切換目前模型,不需要反覆驗證。
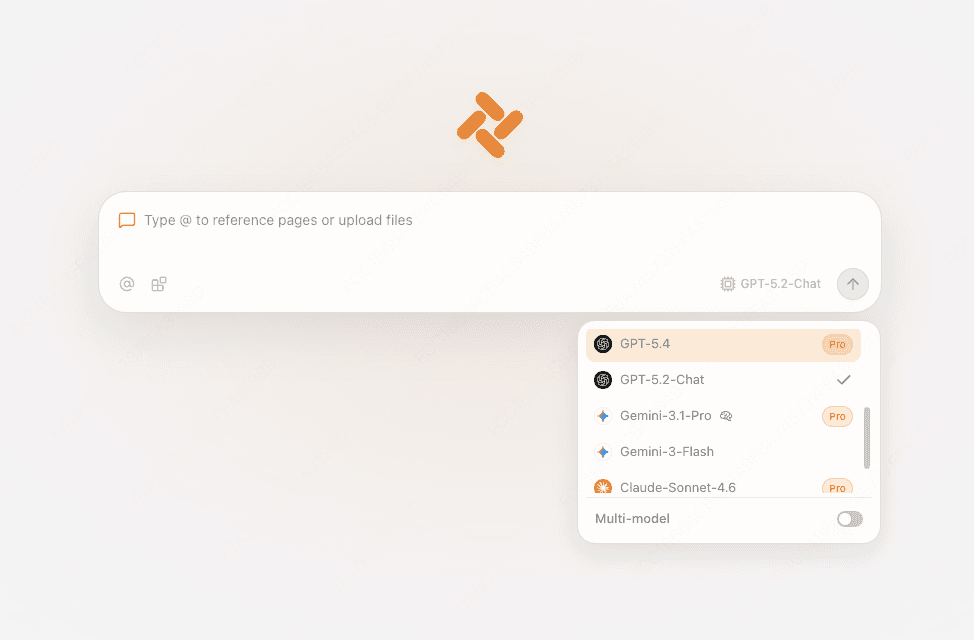
實用的試點迴圈是這樣的:用 @ 引用你在意的頁面或檔案,勾選兩三個候選模型,在一個檢視裡比較答案——然後在你實際執行的五個任務上重複。一個下午就能拿到決策等級樣本,還不用做對帳表格。想了解 agent 化瀏覽如何加強這套流程,見什麼是 agentic browser 和 2026 AI 瀏覽器比較。
兩條邊界保持誠實。第一,Tabbit 中的實際可用模型取決於帳號的模型選擇器與平台條款——本文不聲明包括 MiMo-V2.6-Pro 在內的任何具體型號內建於所有帳號,Tabbit 也不取代你的外部 API 計費關係。第二,瀏覽器側比較是試點不是基準:它控制了提示詞和頁面變數,不控制 token 計量和變異數。用它篩短名單,用定價指南定預算。
 Tabbit Browser
跑一次同任務試點
無論短名單裡剩下誰,測試方法都一樣:固定兩三個真實任務,連同輸入、指令、工具、輸出契約和重試預算一起凍結;記錄 token、首 token 時間、完成時間、工具失敗和人工修正——然後算完成任務的成本,包括按輸出計費的推理 token。一次乾淨的執行證明不了任何費率或可靠性;重複到變異數不再讓你驚訝為止。換了上下文或工具路線,是路線差異,不是某個模型全面更好的證據。
結論:按情境決定留還是換
本頁沒有總冠軍,發表日的排行榜也活不過這個月。決策跟著約束走:
| 主要約束 | 先試點 | 通過標準 | 主要提醒 |
|---|---|---|---|
| 砍帳單,留工作流 | MiMo-V2.6-Flash | 同樣任務在三分之二 token 預算內通過 | 高難 agent 任務推理餘裕變小 |
| 最便宜的離峰批次 | DeepSeek V4.1 Flash | 離峰混合單價低於 $0.20/1M 且驗收通過 | 尖峰加倍;要排程否則付錢 |
| 不限價的開源基準對標 | Kimi K3 | 任務集收益能撐住 17 倍評測成本 | 溢價買到的是樣貌,不是穩贏 |
| 託管閉源旗艦,多模態 | Qwen3.8 Max (0902) | 合規與帳號條款相符且任務通過 | 無自行部署退路;快照會輪替 |
| 程式碼品質優先 | GLM-5.3 | 真實儲存庫上的審查得分超過對手 | 推理常開;沒有省錢檔 |
| 快取友善的推理,$0.435/$0.87 | 留在 MiMo-V2.6-Pro | 自己跑的完成任務成本低於對手 | 盯緊檔位;token 帳單隨思考變長 |
如果你留在 MiMo-V2.6-Pro,認真設定推理檔位——中高兩檔就是它 token 胃口所在——並保持提示詞字首穩定,讓 $0.0036 的快取層發揮作用。

如果你決定換,讓約束選目的地,別讓排行榜選。MiMo-V2.6-Pro 定價指南和 Gemini 3.8 Flash 替代方案比較是更完整的價目與跨家族閱讀材料。
來源
本文所有事實、價格和引用核對於 2026 年 9 月 22 日:
OpenRouter 掛牌:Kimi K3、GLM-5.3、Qwen3.8 Max (0902)
社群文章以文中截圖和連結為準:X(@huanfeng9999)、Reddit(r/DeepSeek、r/LocalLLaMA)、Hacker News(條目 49793293、49794307、49795049、49795769)

常見問題
MiMo-V2.6-Pro 最接近的替代方案是什麼?
同門的 MiMo-V2.6-Flash 是最接近的替代方案:同樣 1M 上下文、同樣的全模態輸入與 API 介面,token 單價只有三分之一。另一陣營的開源權重對手是 Kimi K3,但目錄價貴上數倍,基準表現也不同。
哪個替代方案的官方標價最低?
DeepSeek V4.1 Flash 的離峰價最低:快取命中 $0.003、未命中 $0.15、輸出 $0.60(每百萬 token)。MiMo-V2.6-Flash 的未命中輸入價 $0.14 更低,兩家也都能透過 Batch API 或離峰時段再壓低。最便宜的路線取決於你的快取命中率與執行時段。
如果繼續用 MiMo-V2.6-Pro,它還合適嗎?
很多情況下依然合適。小米官方口徑是開源權重中 Artificial Analysis 智能指數第一名,價格 $0.435 輸入 / $0.87 輸出(每百萬 token),第三方 OpenCode 實測 23 項檢查全過、單次約 3 美分。只要你的任務偏重推理、提示詞對快取友善、也不追求 agent 基準的最後幾分,留在 MiMo 就是理性選擇。
這些替代方案都能自行部署嗎?
MiMo-V2.6-Pro、MiMo-V2.6-Flash 和 Kimi K3 都開放了權重,Z.ai 的 GLM 系列也有開源傳統,硬體充足時可以自行部署。Qwen3.8 Max 是閉源 API 模型,DeepSeek V4.1 Flash 則透過 DeepSeek API 使用。落地前請逐一確認授權條款與 checkpoint 條件。
MiMo-V2.5-Pro 一定要遷移嗎?
要。小米官方文件寫明 mimo-v2.5-pro 和 mimo-v2.5 將於北京時間 2026 年 10 月 21 日 10:00 正式停用。V2.6 系列沿用 V2.5 的 API 定價,多數遷移只是改模型 ID 加迴歸測試,不影響預算。
MiMo-V2.6-Pro 在 Tabbit 瀏覽器裡能用嗎?
Tabbit 中實際可用的模型取決於帳號的模型選擇器與平台條款,本文不做內建承諾。Tabbit 的多模型檢視可以把帳號內可用模型並排比較,是在真實頁面上試跑替代方案務實的辦法。