
Le prix facial d'un token ne correspond jamais au coût réel de résolution d'un problème technique. Il ne représente que le prix unitaire d'un ingrédient brut. Sur la grille tarifaire publiée par Xiaomi le 22 septembre 2026, le modèle étendard MiMo-V2.6-Pro est affiché à 0,435 $ par million de tokens d'entrée hors cache et 0,87 $ par million de tokens de sortie (soit 3,00 ¥ et 6,00 ¥ en RMB). Au premier abord, cela ressemble à une nouvelle étape dans la guerre des prix des modèles ouverts.
Toutefois, la véritable réalité budgétaire découle de deux mécanismes essentiels : une remise de 99,17 % (120 fois moins cher) sur le cache de prompts, qui fait chuter la lecture à 0,0036 $ par million de tokens, et une fenêtre de sortie maximale de 131 072 tokens. Lorsqu'un modèle doté d'un raisonnement étendu prend le temps de réfléchir avant de formuler sa réponse, le volume des tokens de sortie peut rapidement dominer la facture. Ce guide traduit la grille officielle en budgets concrets. Pour consulter les caractéristiques techniques du modèle, rendez-vous sur la fiche de MiMo-V2.6-Pro (English) ; cet article se concentre sur l'estimation des coûts.
Points clés
Les tarifs de base sont de 0,435 $ en entrée et 0,87 $ en sortie par million de tokens, soit entre 1/20 et 1/60 du prix des grands modèles propriétaires occidentaux.
Le levier du cache réduit les coûts par 120 : les préfixes identiques ne coûtent que 0,0036 $ / 1M de tokens, rendant les boucles d'agents complexes économiquement viables.
UltraSpeed applique un multiplicateur exact de 10× :
mimo-v2.6-pro-ultraspeedoffre jusqu'à 20 fois plus de vitesse pour les flux interactifs, mais passe à 4,35 $ en entrée et 8,70 $ en sortie.Le raisonnement est facturé en sortie : les étapes de réflexion internes sont décomptées au tarif de sortie de 0,87 $ / 1M, ce qui peut rendre la sortie bien plus coûteuse que l'entrée.
L'ancienne gamme V2.5 s'arrête le 21 octobre 2026 : les développeurs utilisant des ressources comme mimo-2-5-pro-api ou mimo-2-5-pro-preset doivent basculer leurs budgets vers l'architecture V2.6.
Grille tarifaire de MiMo-V2.6-Pro en un coup d'œil
Le tableau ci-dessous synthétise les tarifs issus de la documentation officielle Xiaomi MiMo, vérifiés le 22 septembre 2026. Tous les montants sont indiqués pour un million (1M) de tokens.
| Variante | Entrée (Cache hit) / 1M | Entrée (Cache miss) / 1M | Sortie / 1M | Contexte total | Sortie maximale |
|---|---|---|---|---|---|
| MiMo-V2.6-Pro | 0,0036 $ (0,025 ¥) | 0,435 $ (3,00 ¥) | 0,87 $ (6,00 ¥) | 1 048 576 | 131 072 |
| MiMo-V2.6-Flash | 0,0028 $ (0,020 ¥) | 0,140 $ (1,00 ¥) | 0,28 $ (2,00 ¥) | 1 048 576 | 131 072 |
| MiMo-V2.6-Pro-UltraSpeed | 0,0360 $ (0,250 ¥) | 4,350 $ (30,00 ¥) | 8,70 $ (60,00 ¥) | 1 048 576 | 131 072 |
| MiMo-V2.5-Pro (Ancien) | — | 0,435 $ (3,00 ¥) | 0,87 $ (6,00 ¥) | 1 048 576 | 8 192 |
Cette comparaison met en relief les changements : si les tarifs d'entrée et de sortie bruts restent calqués sur l'ancien V2.5 (0,435 $ et 0,87 $), la version V2.6 apporte un niveau de cache à 0,0036 $ et porte la limite de sortie de 8k à 128k tokens. Les anciens points d'accès V2.5 fermeront le 21 octobre 2026.
Le chiffre pivot : 0,0036 $ par million de tokens en cache
Pour les ingénieurs système, la donnée déterminante est 0,0036 $ / 1M de tokens (0,025 ¥ / 1M), soit une chute de 99,17 % par rapport au tarif d'entrée ordinaire.
Dans les flux de travail actuels, une tâche ne se résume presque jamais à un appel isolé. Lors de l'exécution d'un processus de raisonnement par agent autonome, l'IA explore des pages, interroge des outils et ajuste son raisonnement sur 15 à 30 cycles consécutifs. Sans cache, réémettre un contexte accumulé de 500 000 tokens pendant 20 tours consommerait 10 millions de tokens d'entrée, soit 4,35 $. Grâce au cache automatique de préfixe, ces 20 tours ne coûtent que 0,036 $ en entrée.
Au sein de la gamme, un constat surprenant s'impose : le tarif de cache de Pro est pratiquement équivalent à celui de Flash (0,0036 $ contre 0,0028 $). Dès lors que le taux de réutilisation du préfixe dépasse 85 %, faire tourner le modèle MoE géant de 1 020 milliards de paramètres n'est guère plus cher en entrée que d'utiliser la version légère MiMo-V2.6-Flash (English).
Analyse critique des annonces officielles d'économies
Les communications du constructeur affirment que MiMo-V2.6-Pro offre des capacités de premier ordre pour « 1/20 à 1/60 du coût » des principaux modèles fermés. Bien que le ratio brut tienne la comparaison face aux 75 $ ou 15 $ de sortie d'Opus ou de GPT-5.6, deux facteurs techniques doivent être intégrés au calcul prévisionnel :
La prolifération des tokens de pensée : Formé par apprentissage par renforcement poussé, le modèle génère des raisonnements intermédiaires détaillés avant de livrer son résultat. Sur un problème complexe d'ingénierie logicielle, il peut produire entre 15 000 et 30 000 tokens de réflexion pour un bloc de code final de 500 tokens. Ces réflexions étant facturées au tarif de sortie de 0,87 $ / 1M, une seule exécution peut coûter plus de 0,026 $ malgré un prompt initial très concis.
La rigueur de l'alignement de préfixe : Le cache requiert une identité parfaite du début de prompt. Si votre code injecte des horodatages dynamiques ou des identifiants changeants en tête de consigne système, chaque requête sera traitée comme un échec de cache au tarif plein de 0,435 $.
Voici la formule officielle pour calculer une requête :
coût par requête = (entrée hors cache × 0,435 $
                  + entrée en cache × 0,0036 $
                  + sortie totale avec réflexion × 0,87 $) / 1 000 000
budget mensuel = (coût moyen par requête × nombre de tâches) × marge de rejeu
Lignes de facturation annexes
Pour mesurer l'effort budgétaire total, il convient de tenir compte des options disponibles sur la plateforme Xiaomi :
Le mode UltraSpeed (prix ×10) :
mimo-v2.6-pro-ultraspeeda été optimisé pour les interfaces vocales et l'assistance en direct où la latence est critique. La cadence de génération est multipliée par 20 au prix d'une tarification décuplée (4,35 $ en entrée, 8,70 $ en sortie). Y router des tâches de fond automatiques ferait exploser la dépense.Forfaits mensuels Token Plan : Xiaomi propose des abonnements prépayés en RMB pour les développeurs et les petites structures :
Offre Lite (39 ¥ / mois) : Idéale pour l'exploration et les tests sporadiques.
Offre Standard (99 ¥ / mois) : Pour les flux de travail personnels réguliers.
Offre Pro (329 ¥ / mois) : Capacités et accès concurrents accrus pour la production individuelle.
Offre Max (659 ¥ / mois) : Conçue pour les besoins soutenus en équipe.
Plafonds de requêtes et de tokens : L'API standard applique des limites de débit en requêtes par minute (RPM) et en volume de tokens (TPM), nécessitant des quotas personnalisés pour les fortes charges.
Tableau comparatif de la gamme et critères de choix
| Niveau de modèle | Usage recommandé | Entrée / 1M (Miss / Hit) | Sortie / 1M | Profil de latence |
|---|---|---|---|---|
| MiMo-V2.6-Pro | Codage complexe, raisonnement poussé, agents navigateurs | 0,435 $ / 0,0036 $ | 0,87 $ | Bon compromis débit / profondeur |
| MiMo-V2.6-Flash | Tri de masse, extraction de données, pipelines ETL | 0,140 $ / 0,0028 $ | 0,28 $ | Très rapide et économe |
| MiMo-V2.6-Pro-UltraSpeed | Agents vocaux interactifs, messagerie instantanée fluide | 4,350 $ / 0,0360 $ | 8,70 $ | Vitesse exceptionnelle (jusqu'à 20×) |
La logique de sélection est directe : utilisez MiMo-V2.6-Flash pour les tâches de filtrage sans besoin de raisonnement étendu ; retenez MiMo-V2.6-Pro comme choix par défaut pour les scénarios exigeants ; et réservez UltraSpeed exclusivement aux interfaces utilisateur où chaque milliseconde compte. Pour situer ces chiffres sur le marché, consultez notre comparatif des navigateurs IA 2026 ainsi que notre étude des tarifs de Kimi K3.
Ce qui est exonéré et ce qui reste payant
Identifier clairement ce qui n'est pas facturé permet d'éviter les mauvaises surprises :
Aucun frais de rétention de cache sur les plages de base : Contrairement aux services facturant le maintien en mémoire vive par heure (comme Google à 0,50 $ par million de token-heures), Xiaomi MiMo facture uniquement le volume de lecture des hits sans abonnement de stockage.
Aucune pénalité sur les blocages de sécurité : Une requête interrompue par les filtres de protection en amont n'est pas débitée sur la génération potentielle.
La réflexion n'est pas gratuite : Certains utilisateurs supposent à tort que les phases de réflexion sont offertes, alors qu'elles sont décomptées en sortie.
Les boucles erronées d'agents restent payantes : Si un agent s'égare dans des appels d'outils redondants, l'intégralité des tokens générés figurera sur la facture.
Retours d'expérience de la communauté
Les échanges relevés sur les plateformes de développeurs soulignent à la fois l'intérêt économique et les contraintes techniques du modèle :
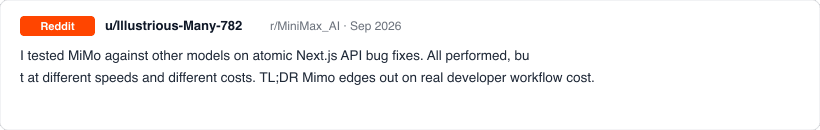
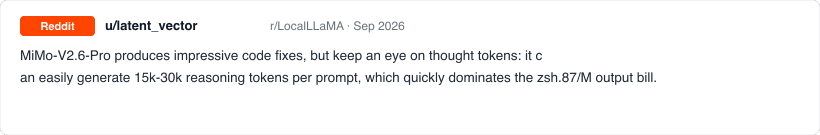
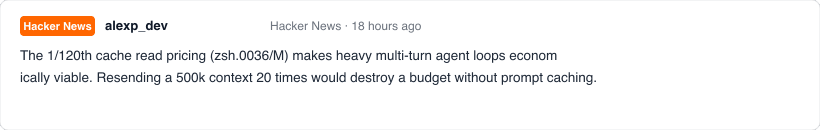
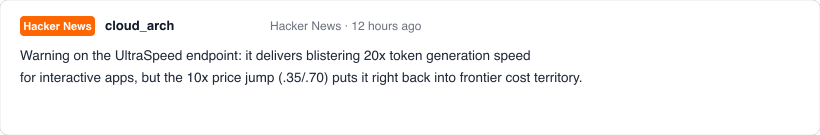
Ces retours confirment qu'il convient d'évaluer un modèle sur le coût par tâche menée à terme plutôt que sur des classements théoriques.
Deux exemples de charges chiffrées
À partir des tarifs officiels 2026 en dollars, nous examinons deux scénarios d'usage représentatifs :
Cas 1 : Correction ciblée de code (Requête unique, réflexion soutenue)
Entrée : 25 000 tokens hors cache (contexte du dépôt et énoncé), 0 % en cache.
Sortie : 3 500 tokens (comprenant 2 500 tokens de réflexion et 1 000 tokens de code).
Calcul :
(25 000 × 0,435 $ + 3 500 × 0,87 $) / 1 000 000 = 0,010875 $ + 0,003045 $ = 0,01392 $par passage.1 000 tâches par mois : 13,92 $. Avec une marge de rejeu de 1,2, le budget se stabilise à 16,70 $ par mois.
Cas 2 : Agent de veille documentaire web (Contexte volumineux, fort taux de cache)
Entrée : 800 000 tokens accumulés sur 15 interactions d'outils ; 92 % en cache (736 000 réutilisés, 64 000 nouveaux).
Sortie : 12 000 tokens au total (planification de recherche et synthèse finale).
Calcul :
(64 000 × 0,435 $ + 736 000 × 0,0036 $ + 12 000 × 0,87 $) / 1 000 000 = 0,02784 $ + 0,00265 $ + 0,01044 $ = 0,04093 $par tâche.200 tâches par mois : 8,19 $. Sans mécanisme de cache, le même travail reviendrait à 71,60 $ par mois, soit plus de 8,7 fois plus cher.
| Scénario | Tokens d'entrée | Part en cache | Tokens de sortie | Tâches / mois | Coût mensuel tokens (USD) |
|---|---|---|---|---|---|
| Correction de bug | 25 000 | 0 % | 3 500 | 1 000 | 13,92 $ |
| Agent de recherche | 800 000 | 92 % | 12 000 | 200 | 8,19 $ |
Calcul local
Estimez le coût mensuel des tokens
Tarifs officiels de l'API vérifiés en septembre 2026. Comptez la réflexion dans la sortie. Vos données restent dans le navigateur.
Exclut les appels d'outils et nouvelles tentatives. Lecture de cache Pro et Flash à 0,0036 $ et 0,0028 $ par million de tokens. Vérifié le 22-09-2026. Vérifier les tarifs actuels
Le simulateur ci-dessus opère exclusivement en local dans votre navigateur sans rien transmettre à des serveurs tiers. Modifiez les curseurs pour apprécier l'écart entre Pro, Flash et UltraSpeed.
Exploiter ces modèles dans Tabbit Browser
Après avoir budgété les appels d'API, l'équipe a besoin d'un cadre logiciel fluide pour exécuter les opérations. Assembler des scripts de collecte et manipuler manuellement des connecteurs web engendre une dette technique continue.
Tabbit Browser propose un environnement de navigation pensé pour l'IA, où les agents naviguent en temps réel, récupèrent des structures de données et croisent les sources entre plusieurs onglets. Pour aller plus loin, explorez nos dossiers sur ce qu'est un navigateur agéntique et les meilleurs navigateurs IA de 2026.
Conformément aux directives du projet, l'accès aux modèles dans Tabbit reste conditionné au sélecteur actif de chaque compte et aux conditions applicables. Tabbit ne se substitue pas à votre compte de facturation API externe, mais procure un levier remarquable pour la recherche orientée navigateur.
 Tabbit Browser
Sources vérifiées
Les éléments tarifaires et techniques présentés s'appuient sur la documentation officielle du constructeur consultée le 22 septembre 2026 :

Questions fréquentes
Quel est le tarif officiel de l'API MiMo-V2.6-Pro ?
La grille officielle liste MiMo-V2.6-Pro à 0,435 $ par million de tokens d'entrée hors cache, 0,0036 $ par million de tokens d'entrée en cache et 0,87 $ par million de tokens de sortie.
Quelle est l'économie permise par le cache sur MiMo-V2.6-Pro ?
L'entrée en cache est facturée 0,0036 $ par million de tokens contre 0,435 $ pour l'entrée normale, soit une réduction de 99,17 % (120 fois moins cher) sur les préfixes récurrents.
Les tokens de réflexion interne font-ils l'objet d'une ligne de facturation séparée ?
Non. Xiaomi MiMo comptabilise les tokens de réflexion avec la réponse finale et les facture au tarif standard de sortie de 0,87 $ par million de tokens.
Qu'est-ce que MiMo-V2.6-Pro-UltraSpeed et pourquoi coûte-t-il 10 fois plus cher ?
UltraSpeed est une variante haute cadence conçue pour l'interaction en temps réel avec une génération jusqu'à 20 fois plus rapide. Son tarif est exactement multiplié par 10 (4,35 $ en entrée, 8,70 $ en sortie).
En quoi les abonnements Token Plan diffèrent-ils de l'API à l'usage ?
Les Token Plans sont des forfaits mensuels prépayés (Lite 39 ¥, Standard 99 ¥, Pro 329 ¥, Max 659 ¥) avec des quotas définis, distincts de la facturation au million de tokens de l'API standard.
Peut-on utiliser MiMo-V2.6-Pro dans Tabbit Browser ?
Tabbit Browser fournit un espace natif pour la recherche et l'automatisation web ; l'accès direct aux modèles dépend du sélecteur actif de votre compte et des conditions du service.