
O Gemini 3.8 Flash merece um teste sério para tarefas longas, chamadas de ferramentas e análise multimodal. Ele não é um vencedor universal. O Google o posiciona como um modelo Flash de trabalho para engenharia de software, agentes autônomos e fluxos empresariais complexos. As evidências públicas sustentam um upgrade condicionado: o snapshot independente em high é forte, mas os dados de latência são incompletos.
O ponto contraintuitivo: medium custa 25% menos, com diferença de 1 ponto
A Artificial Analysis mostra US$ 1,24 por tarefa do Intelligence Index no high e US$ 0,93 no medium. Medium custa 25% menos, (1,24 - 0,93) / 1,24, enquanto o índice é 40 contra 41. É um snapshot datado: não prova equivalência estatística nem custo de produção; apenas justifica testar medium primeiro.
Escolha pelo gargalo do trabalho. Teste o modelo quando houver planejamento contínuo, entradas grandes ou várias chamadas de ferramentas. Mantenha outra opção quando o tempo até a primeira resposta, o orçamento fixo ou o suporte exato do cliente forem mais importantes. Esta análise combina fontes públicas com uma extração realizada em uma conta de teste do Tabbit. O Tabbit Browser aparece como uma camada de contexto, não como modelo alternativo.
Principais conclusões
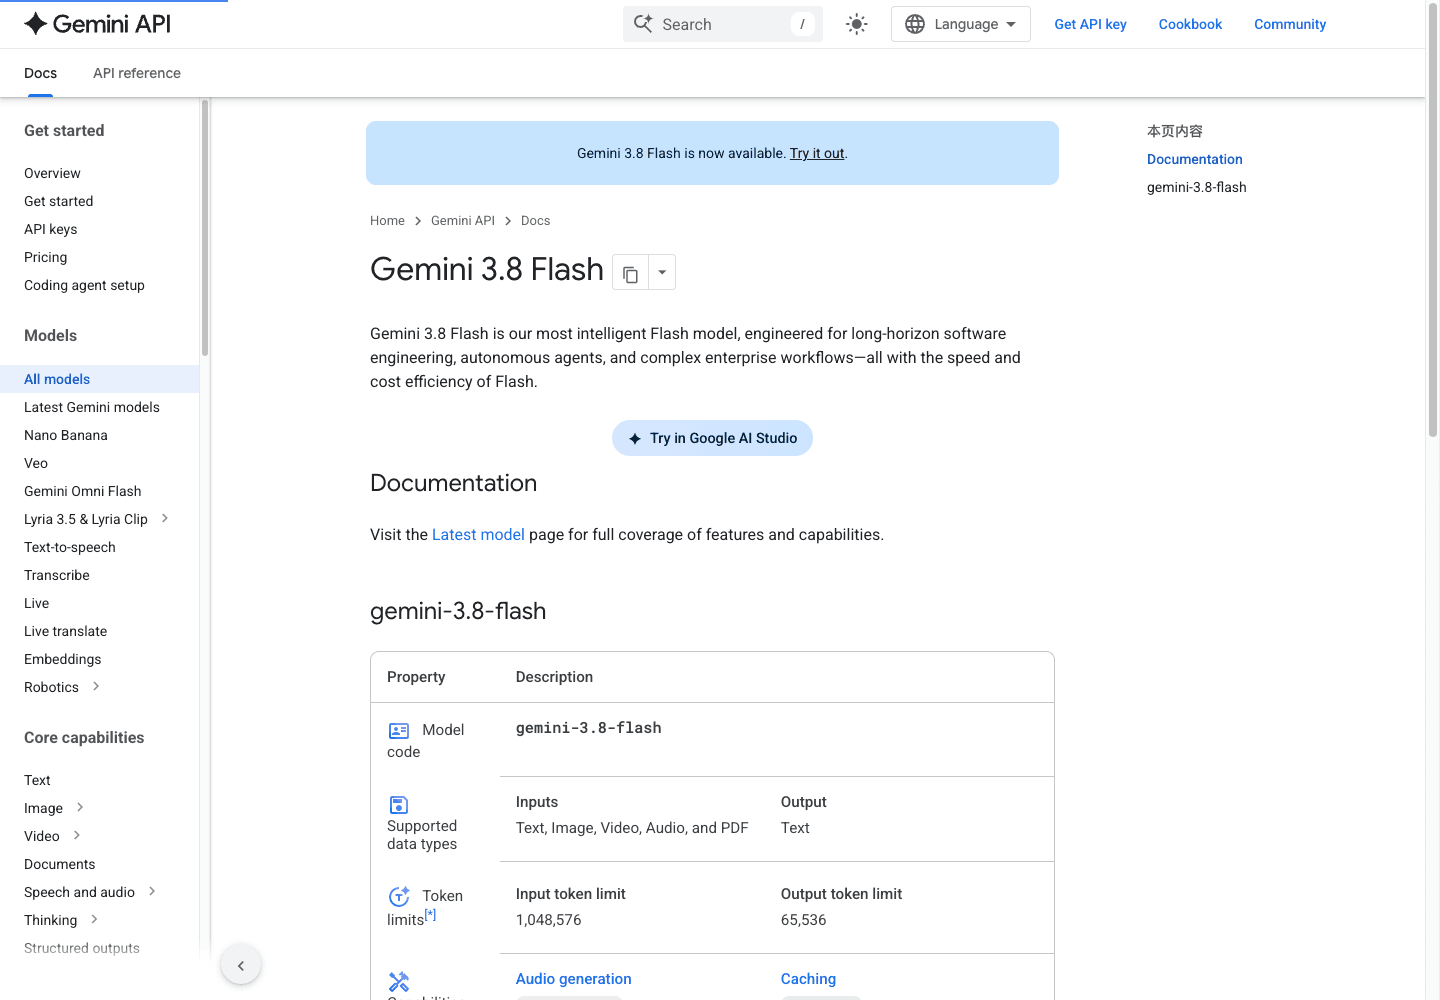
O raciocínio suporta low, medium e high; minimal não é suportado. Tokens de raciocínio entram no preço de saída.
No Artificial Analysis v4.3.2 verificado em 20-09-2026, high mostra índice 41, 305 tokens/s e US$ 1,24; medium 40 e US$ 0,93; low 33. Valores ausentes ficam desconhecidos.
Condições e método
Três pontos fortes e três limites
Fluxos com ferramentas
As ferramentas documentadas combinam com tarefas de ler, planejar, agir e verificar; o cliente pode expor menos.
Entradas grandes e multimodais
A API aceita texto, imagem, vídeo, áudio e PDF com entrada de 1M tokens. Limites do cliente e extração ainda precisam de testes.
Saída estruturada com amostra limitada
A amostra do Tabbit devolveu o JSON esperado e preservou o status desconhecido. O marcador Google Search e uma execução impedem generalizar.
Tokens de raciocínio aumentam o custo
O Google inclui esses tokens no preço de saída. Medium custa 25% menos por tarefa, mas o custo de produção não é garantido.
Nenhuma promessa de latência inicial
As páginas não oferecem medida utilizável do primeiro token. Os 305 tokens/s descrevem apenas geração.
Cliente e produção têm escopos diferentes
Uma opção visível no Tabbit e uma amostra de uma conta não provam suporte igual em todos os clientes, regiões ou caminhos.
Hacker News: quatro experiências individuais
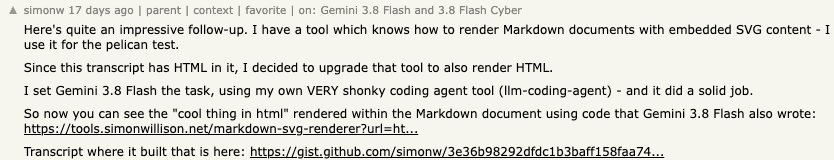
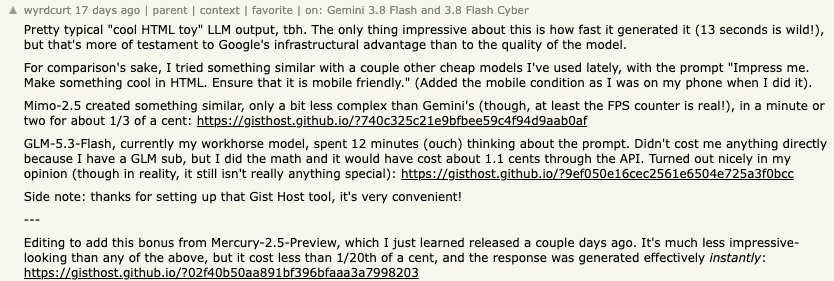
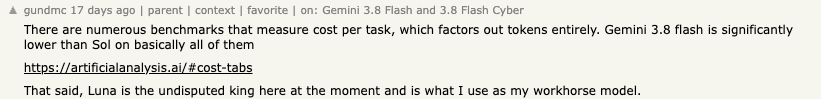
Os quatro comentários do Hacker News discutem código, utilidade de demonstrações, acesso a versões antigas e custo por tarefa. simonw aprova uma alteração no renderizador HTML com 3.8; wyrdcurt questiona a utilidade da demonstração; robertwt7 relata acesso a versões antigas na Austrália; gundmc prefere Luna e destaca custo por tarefa. São experiências individuais, não um benchmark comum.

Uma pequena amostra de extração no Tabbit antes do ranking
Em 20 de setembro de 2026, uma teste editorial executou uma tarefa sintética de extração no Tabbit Browser com o Gemini 3.8 Flash. O JSON retornado tinha os quatro campos esperados e não classificou como atrasado um registro sem status. Ver a captura
{"currency":"USD","paid_total":145,"overdue_ids":["B"],"unknown_status_ids":["D"]}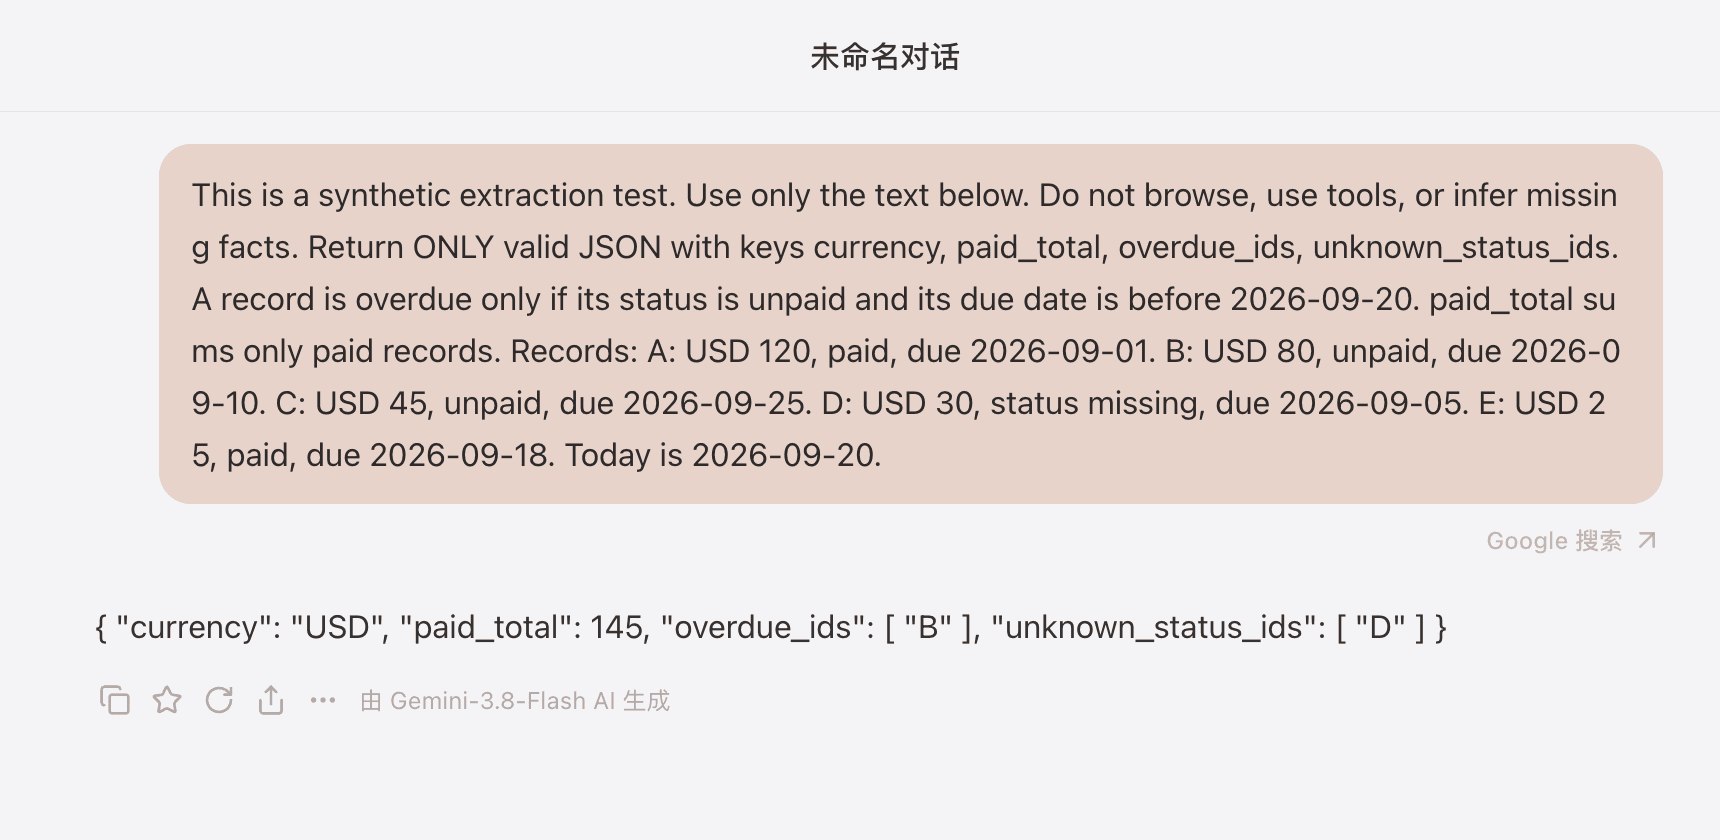
É uma amostra única de saída estruturada, não uma experiência pessoal do autor nem um benchmark. Nível de raciocínio, versão da API, tokens, custo, first-token latency e taxa de sucesso não foram medidos; a interface mostrava um marcador de busca do Google.
O snapshot público é útil, mas limitado
| Nível | Versão e data | Intelligence Index | Velocidade de saída | Custo por tarefa do índice | first-token latency | O que indica |
|---|---|---|---|---|---|---|
| High | v4.3.2, 20-09-2026 | 41 | 305 tokens/s | US$ 1,24 | Desconhecido | Snapshot forte com velocidade de geração visível. |
| Medium | v4.3.2, 20-09-2026 | 40 | Desconhecido | US$ 0,93 | Desconhecido | Índice próximo, com custo listado menor. |
| Low | v4.3.2, 20-09-2026 | 33 | Desconhecido | Desconhecido | Desconhecido | Índice menor; velocidade e custo não publicados. |
305 tokens/s mede geração, não o tempo até o primeiro token. O Google afirma no anúncio de lançamento melhorias frente ao 3.7, mas isso é uma afirmação do fornecedor. O contexto de lançamento está no resumo do Gemini 3.8 Flash.
O medium custa 25% menos por tarefa do Intelligence Index ((1,24 - 0,93) / 1,24) e marca 40 contra 41 do high. Esse snapshot não prova equivalência estatística nem custo de produção; apenas sugere testar medium primeiro.
Pontos fortes e limitações
A documentação lista function calling, code execution, file search, structured outputs, URL context e computer use preview. Isso combina com fluxos de ler, planejar, chamar uma ferramenta e verificar o resultado. O SDK ou cliente escolhido pode não expor todos os recursos. As entradas multimodais e a janela grande favorecem documentos; para classificação curta ou reescrita, esforço extra pode não compensar.
O alcance do teste no Tabbit Browser
A amostra registrada do Tabbit devolveu o JSON de quatro campos esperado e preservou corretamente o status desconhecido. A interface mostrou um marcador de busca do Google, então a execução sem ferramentas não foi provada. first-token latency, tokens, custo, nível de raciocínio e confiabilidade prolongada não foram medidos. É um exemplo reproduzível, não uma garantia de produção.
Escolha uma tarefa reproduzível nos guias de prompts (English) e confira as fontes da análise (English).
 Tabbit Browser
Escolha por carga de trabalho
| Carga ou restrição | Recomendação | Nível inicial | Atenção |
|---|---|---|---|
| Código em vários arquivos, ferramentas e depuração | Testar 3.8 Flash | medium, depois high | Medir testes, tentativas e tokens |
| Reescrita, classificação e alto volume | Comparar modelo leve | low | O esforço pode não acrescentar valor |
| Primeira resposta crítica | Não presumir vantagem | low ou alternativa | first-token latency desconhecido |
| Orçamento fixo | Fazer piloto com limites | low/medium | API, assinatura e Tabbit têm custos diferentes |
Antes de decidir, compare as alternativas, a análise de preços, a página do modelo (English) e a automação do navegador.
Veredito
Gemini 3.8 Flash é um candidato consistente para trabalho difícil, multimodal e com ferramentas. A evidência mais útil é a combinação de entradas, ferramentas e três níveis de raciocínio, junto ao índice high de 41. A principal limitação é a falta de velocidade, first-token latency e custo completos por nível, além do possível aumento de tokens.
Antes de mudar o modelo padrão, faça um piloto com duas tarefas reais. Defina sucesso antes, use o mesmo prompt e ferramentas, e compare tempo, correções, tokens e custo. Se a qualidade extra pagar o custo extra, mantenha 3.8 para essa categoria. Para comparar modelos, leia as alternativas, o recurso do modelo (English) e o guia de navegadores de IA.

Perguntas frequentes
Vale a pena usar o Gemini 3.8 Flash?
Vale testar em tarefas longas, multimodais e com ferramentas quando a qualidade da conclusão importa mais que uma latência totalmente previsível. As evidências públicas não provam que ele seja o melhor para tudo, e um raciocínio mais alto pode aumentar o consumo de tokens.
Como ler os benchmarks do Gemini 3.8 Flash?
Mantenha versão, nível de raciocínio, métrica e data juntos. No snapshot v4.3.2 da Artificial Analysis verificado em 20 de setembro de 2026, high mostra índice 41, 305 tokens de saída por segundo e US$ 1,24 por tarefa do índice; campos ausentes permanecem desconhecidos.
305 tokens por segundo significa primeira resposta rápida?
Não. É velocidade de geração, não first-token latency. A página consultada não mostrava um valor numérico de first-token latency.
O Gemini 3.8 Flash está disponível no Tabbit Browser?
Um único teste no Tabbit Browser devolveu o JSON de quatro campos esperado para uma extração sintética. A interface mostrou também um marcador de busca do Google; isso não prova execução sem ferramentas, disponibilidade em produção, latência, custo ou confiabilidade geral.
Quem deve evitá-lo?
Equipes que precisam de latência rígida, orçamento fixo ou uma ferramenta específica garantida devem comparar modelos mais leves e alternativas primeiro.