
Gemini 3.8 Flash 值得为长任务、工具调用和多模态工作认真试一次,但它不是对所有人都更好的模型。Google 将它定位为面向软件工程、自主 Agent 和复杂企业流程的高能力 Flash 模型。公开证据支持“条件性升级”:高推理档位的独立快照表现不错,但不同档位的延迟数据并不完整,不能把一个数字扩展成普遍结论。
反直觉锚点:medium 每项任务便宜 25%,指数只低 1 分
Artificial Analysis 显示 high 每项 Intelligence Index 任务为 1.24 美元,medium 为 0.93 美元。medium 便宜 25%,计算为 (1.24 - 0.93) / 1.24,但指数是 40 对 41。这是有日期的基准快照,不能解释为统计等价,也不能保证生产成本;它只说明值得先测 medium。
判断方法很直接:先找出任务瓶颈。需要持续规划、大输入或重复工具调用时,可以优先试 Gemini 3.8 Flash;如果首响时间、固定成本或客户端支持才是硬约束,就把更快或更便宜的模型放在对照组。本文基于公开资料,仅有一次 Tabbit 样例。后文会说明 Tabbit Browser 何时适合作为浏览器上下文工具,以及为什么当前不能把它的模型选择器当作生产可用性的证明。
核心结论
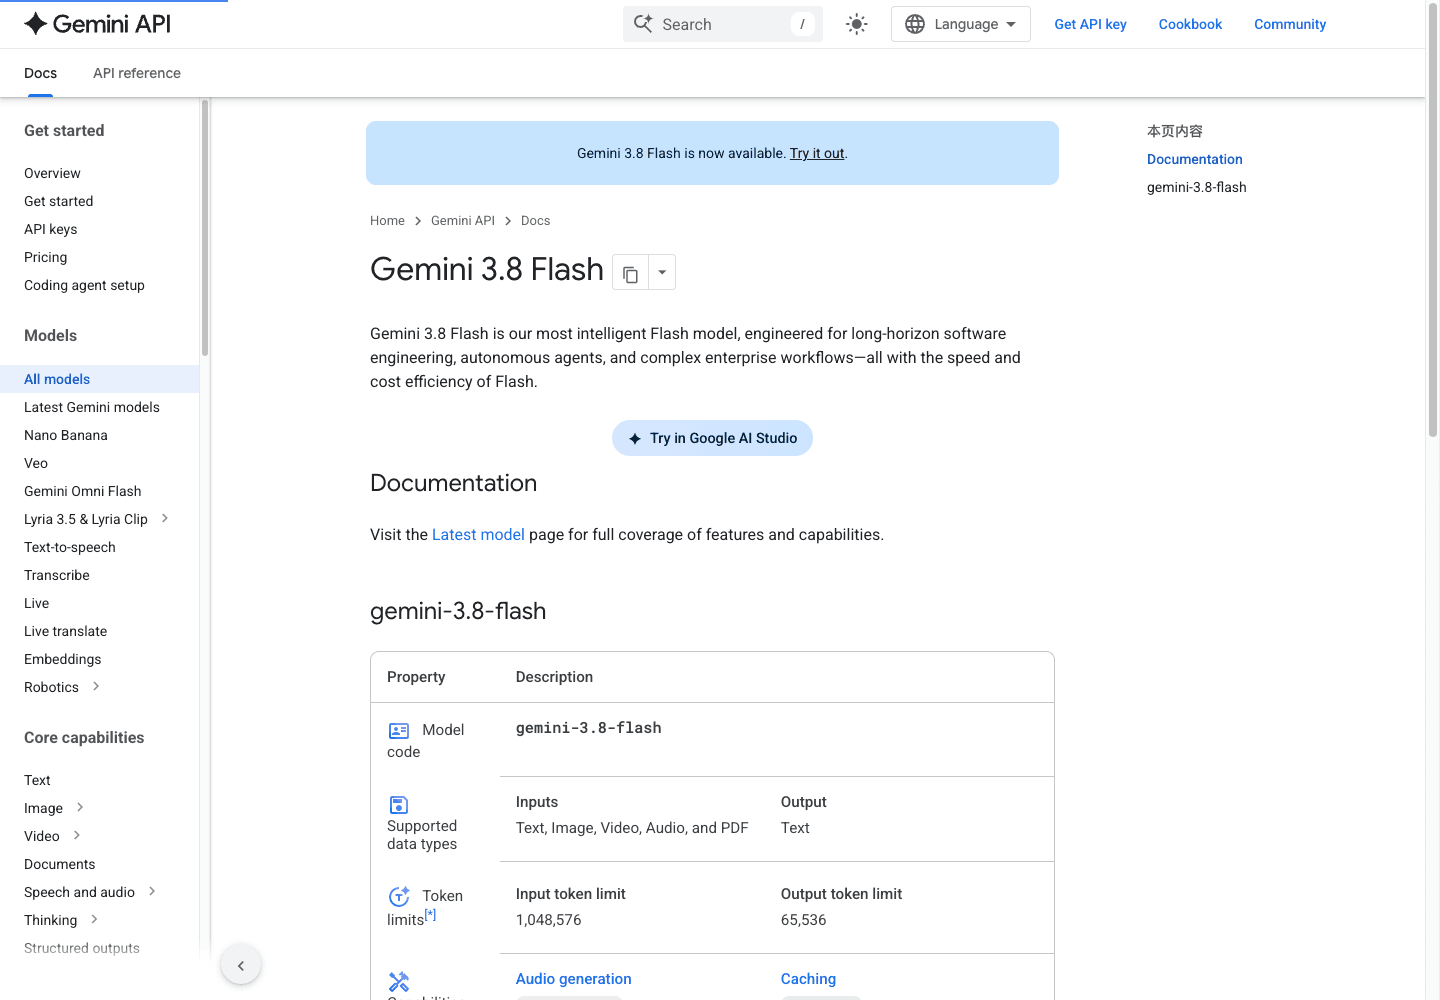
Gemini 3.8 Flash 是稳定 API 模型,支持文本、图片、视频、音频和 PDF 输入,文本输出;输入上限 1,048,576 token,输出上限 65,536 token。这些是 API 规格,不代表每个客户端都暴露相同窗口。Google 模型文档
推理支持 low、medium、high,不支持 minimal。Google 将思考 token 计入输出价格,因此更高推理可能带来更好的困难任务表现,也会带来更多用量和等待。
2026 年 9 月 20 日的 Artificial Analysis v4.3.2 快照中,high 的 Intelligence Index 为 41,输出速度为每秒 305 token,每项指数任务成本 1.24 美元;medium 为 40 和 0.93 美元;low 为 33。缺失字段保持未知。
适合把它作为困难多步骤任务的候选模型,而不是依据演示直接改掉全部默认配置。Tabbit 的生产可用性仍未核实。
条件与方法
这篇文章回答的是:购买者能从公开资料做出什么判断?关键是把模型版本、推理档位、指标和日期放在一起。脱离条件的基准数字不能公平比较。
三项优势与三项限制
工具调用工作流
官方工具适合“读取—规划—调用—检查”任务,但具体客户端未必开放全部工具。
大输入与混合媒体
API 支持文本、图片、视频、音频和 PDF,输入上限为 1M token;客户端限制和抽取质量仍需验证。
结构化输出:有条件的单次样例
Tabbit 样例返回预期四字段 JSON并保留未知状态。Google 搜索标记和单次样本都不支持更宽泛的结论。
Thinking token 会增加任务成本
Google 将思考 token 计入输出价格。medium 快照每项任务便宜 25%,但不等于生产成功任务也便宜 25%。
不用缺失延迟数据承诺首响
当前页面没有可用的首 token 延迟测量。305 output token/s 只描述生成速度,不能承诺首响。
客户端与生产范围需要分开判断
API 规格、Tabbit 选项和一次测试账户样例,不能证明所有客户端、地区或生产路径支持相同模型和工具。
Hacker News:四条个人使用反馈
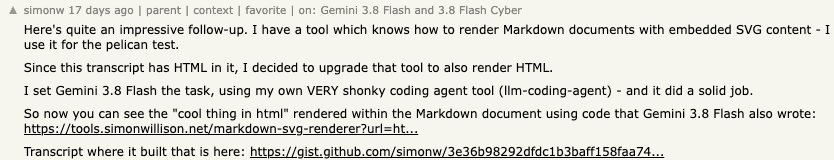
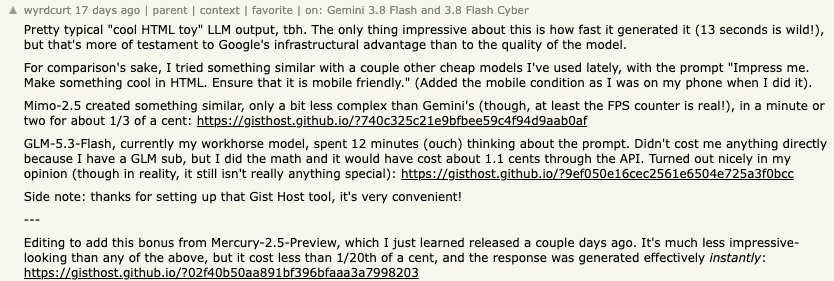
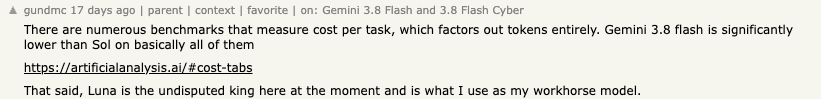
四条 Hacker News 评论分别涉及编码效果、演示价值、旧版访问和任务成本。simonw 对 3.8 的 HTML 渲染修改持肯定态度;wyrdcurt 质疑演示的实际价值;robertwt7 讨论澳大利亚旧版 Flash 的访问;gundmc 偏好 Luna,并关注任务成本。它们是个人反馈,不是共同基准。

一个 Tabbit 抽取样例:先看产品路径,再看排行榜
2026 年 9 月 20 日,编辑测试账户在 Tabbit Browser 中用 Gemini 3.8 Flash 执行了一次合成抽取任务。任务要求只返回包含 currency、paid_total、overdue_ids 和 unknown_status_ids 的 JSON,实际结果四个字段均符合预期,缺失状态的记录也没有被擅自算作逾期。查看样例截图
{"currency":"USD","paid_total":145,"overdue_ids":["B"],"unknown_status_ids":["D"]}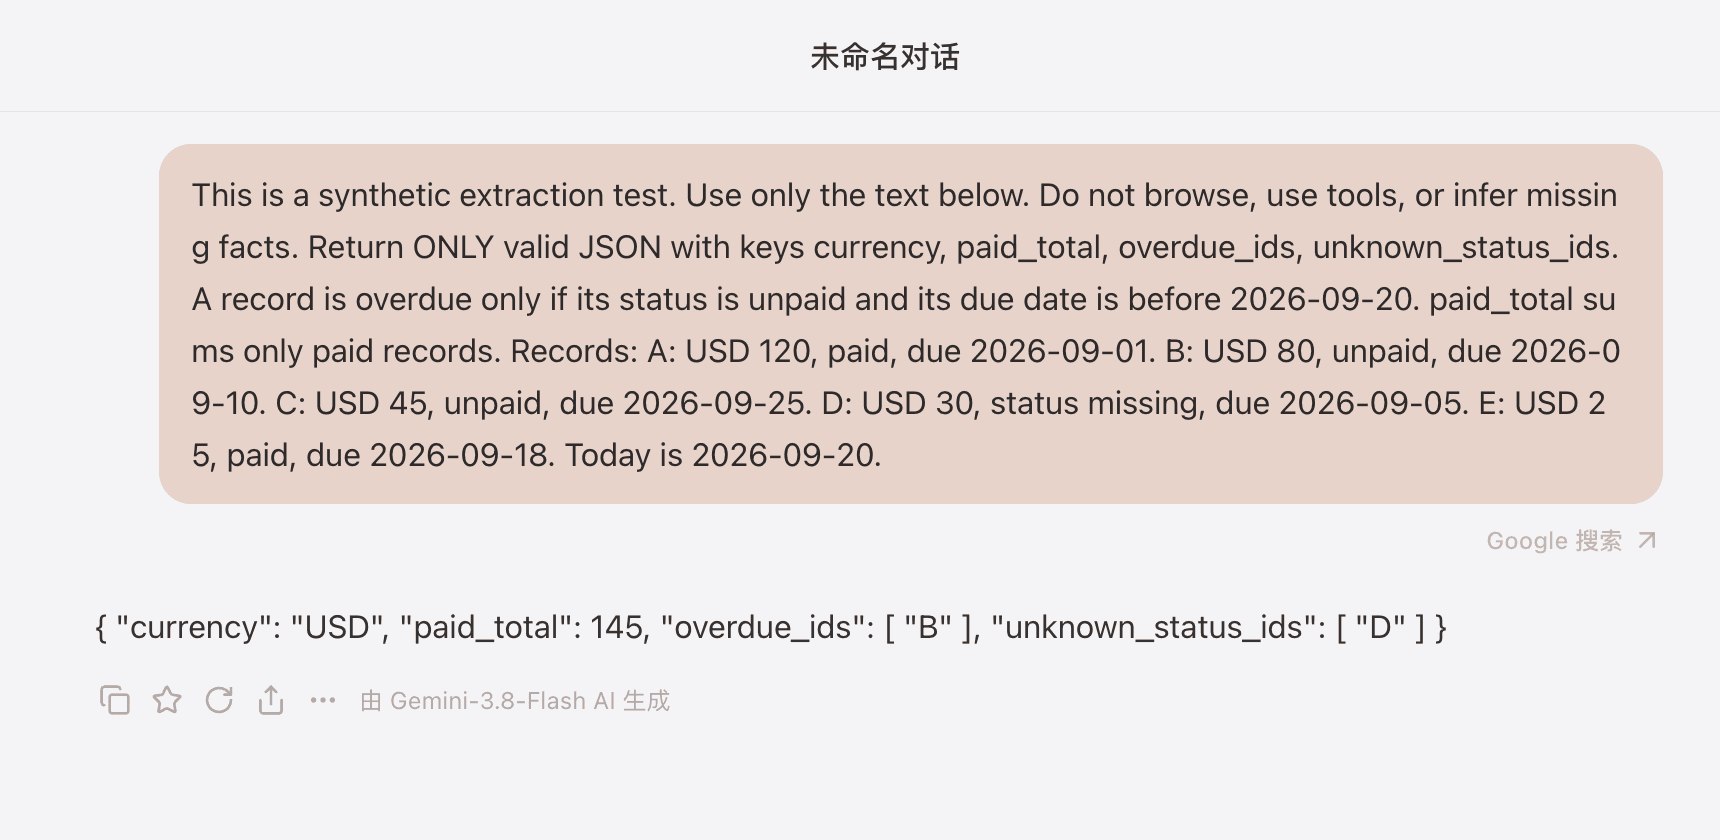
。
这只是一次结构化输出样例,不是作者亲测基准。没有测量推理档位、API 版本、token、成本、first-token latency 或成功率。界面同时显示“Google 搜索”标记,因此不能证明关闭了工具或没有发送搜索请求,也不能证明所有账户的生产可用性。
公开基准有用,但范围有限
Artificial Analysis 在同一 v4.3.2 快照下提供三个推理档位页面。这足以说明档位会改变结果,却不足以证明它在所有任务上排名第一,因为任务组成、提供商路径和指标未必等于你的生产工作。
| 推理档位 | Artificial Analysis 版本 | Intelligence Index | 输出速度 | 每项指数任务成本 | first-token latency | 这行数据能说明什么 |
|---|---|---|---|---|---|---|
| High | v4.3.2,2026-09-20 | 41 | 305 token/s | $1.24 | 未知 | 在高推理下的公开快照较强,页面显示了生成速度。 |
| Medium | v4.3.2,2026-09-20 | 40 | 未知 | $0.93 | 未知 | 该快照中指数接近 high,任务成本更低。 |
| Low | v4.3.2,2026-09-20 | 33 | 未知 | 未知 | 未知 | 该快照中指数更低;速度和成本未公开。 |
最重要的阅读规则是:未知不等于零。medium 的速度不是“慢”,low 的成本也不是“免费”,只是当前页面没有提供。每秒 305 token 是输出生成速度,不是首 token 延迟;页面没有显示 first-token latency,所以本文不作首响优势判断。
更有决策价值的反直觉比较是:medium 每项 Artificial Analysis Intelligence Index 任务成本比 high 低 25%,计算为 (1.24 - 0.93) / 1.24,但指数只低 1 分(40 对 41)。这是一个基准快照,不能解释为统计等价,也不能当作生产成本保证;它只说明值得先测 medium,而不是默认所有困难任务都用 high。
Google 的发布公告称 Gemini 3.8 Flash 相比 3.7 在软件工程、Agent 任务和多步骤推理上有明显提升。这属于厂商定位和自报结果。关于版本、规格和获取方式,请看 Gemini 3.8 Flash 总览;本篇只给出更窄的选型结论。
它可能擅长什么
官方模型页列出函数调用、代码执行、文件搜索、结构化输出、URL context 和 computer use preview。组合起来,它适合“读取资料—制定计划—调用工具—检查结果”的流程。但 SDK、订阅或浏览器客户端未必都开放这些工具。
如果小模型常在第一步就停止,更多持续推理可能有帮助;如果任务只是分类或短改写,额外推理未必抵得过 token 和等待成本。
API 支持文本、图片、视频、音频和 PDF,输入上限为 1,048,576 token,适合资料较多的分析。输出仍是文本,模型页没有列出图片或音频生成。客户端实际限制可能更小,需要按使用路径核对。
它可能让人失望的地方
Google 的定价页列出标准 API 价格:2026 年 12 月 31 日前为每百万输入 token 0.75 美元、每百万输出 token 3.75 美元,输出价格包含思考 token。Batch 和 Flex 是单独的计价行,不能自动叠加折扣。推理档位越高,输出用量可能越大,所以单价低不自动等于成功任务成本低。请看 定价分析 的公式和算例。
high 行有 305 token/s,medium 和 low 的速度是未知,三个页面都没有 first-token latency。模型可能先等待较久,再快速生成;因此不能用输出速度替代用户感受到的总等待时间。
社区分歧其实是在争论成功单位
生产决策应优先看成功任务成本。先写清成功标准,例如“从两份 PDF 提取 40 个字段且每个字段有引用”,或“修改三个文件并通过现有测试”。然后记录时间、重试、人工修改和 token。社区评测可以帮助你选择要试的提示词,但不能替你完成测量。
Tabbit Browser 的实测边界
一次记录的 Tabbit 样例在合成抽取任务中返回了预期的四字段 JSON,也正确保留了未知状态。界面显示 Google 搜索标记,因此不能证明无工具执行;同时没有测量 first-token latency、token、成本、推理档位或长期可靠性。它是一个可复现的样例,不是所有账户的生产保证。
 Tabbit Browser
按工作负载选择
| 工作负载或约束 | 建议 | 先试档位 | 原因 | 主要风险 |
|---|---|---|---|---|
| 多文件编码、工具调用、反复调试 | 值得试 Gemini 3.8 Flash | medium,需要时 high | 官方定位和演示都面向持续 Agent 工作 | 记录通过测试、重试和总 token |
| PDF、图片、视频或音频分析 | 使用路径支持时可以试 | medium | 输入类型广,API 窗口大 | 客户端限制和抽取质量仍需验证 |
| 短改写、分类、高频常规文本 | 先比较轻量模型 | low | 高推理可能增加成本却不改变答案 | low 的成本仍未知,需自行测量 |
| 首响是硬指标 | 不要假设 3.8 Flash 胜出 | low 或替代模型 | 当前快照没有 first-token latency | 输出速度不等于 first-token latency |
| 固定月度预算 | 设置 token 上限和重试预算后试点 | low/medium | 输出包含思考 token | API、订阅和 Tabbit 费用口径不同 |
| 多网页浏览研究 | 实时路径可用时考虑 Tabbit 做上下文层 | 取决于客户端 | 标签组织可减少上下文切换 | Tabbit 推理和生产可用性未核实 |
做决定前,可继续看 Gemini 3.8 Flash 替代品、定价分析、模型资源页 和 浏览器自动化。
结论:条件性升级,先做小型试点
Gemini 3.8 Flash 是困难、多模态和工具调用流程的可信候选。最强的公开论据不是“所有基准都赢”,而是它把广泛输入、工具和三个推理档位结合起来,且独立快照的 high 档位 Intelligence Index 为 41。最强的限制是不同档位的速度和成本数据不完整,更高推理还可能增加输出用量。
切换默认模型前,先做小试点:选两个真实任务,运行前定义成功标准,重复足够次数以暴露重试,记录完成时间、人工修正、输入输出 token 和总成本,再用同一提示词和工具配置对比当前模型。如果额外完成质量能覆盖额外 token 成本,就把 3.8 留给这类任务;否则把常规任务路由到其他模型。
想比较不同模型,继续阅读 Gemini 3.8 Flash 替代品指南;需要规格核对时打开 模型资源页;如果瓶颈是浏览器上下文,先看 AI 浏览器选择,并在实际产品中确认模型路径。

常见问题
Gemini 3.8 Flash 值得用吗?
如果任务需要持续规划、工具调用或多模态输入,而且完成质量比完全可预测的延迟更重要,它值得试用。公开证据不足以证明它适合所有任务;更高推理档位还可能增加 token 用量。
应该怎样看 Gemini 3.8 Flash 的基准数据?
必须同时记录评测版本、推理档位、指标和日期。2026 年 9 月 20 日查看的 Artificial Analysis v4.3.2 快照中,高档位指数为 41、输出速度为每秒 305 token、每项指数任务成本为 1.24 美元,其他缺失字段仍然未知。
Gemini 3.8 Flash 思考得更深会用更多 token 吗?
Google 将思考 token 计入输出价格。因此,更高档位可能提高困难任务的完成质量,也可能增加用量和成本。模型页列出 low、medium、high,不支持 minimal。
每秒 305 token 等于首字响应很快吗?
不等于。305 是生成速度,不是首 token 延迟。已查看的 Artificial Analysis 页面没有给出 first-token latency 数值,所以不能据此判断用户要等待多久。
Gemini 3.8 Flash 能在 Tabbit Browser 中使用吗?
一次 Tabbit Browser 测试在合成抽取任务中返回了预期的四字段 JSON。界面同时显示 Google 搜索标记,因此不能据此证明无工具执行、生产可用性、延迟、成本或普遍可靠性。
谁不适合使用 Gemini 3.8 Flash?
如果核心约束是严格首响、固定预算、特定客户端工具或可复现的部署保证,不要直接把它设为默认模型。应先比较轻量模型和替代方案。