
Gemini 3.8 Flash は、長い作業、ツール呼び出し、マルチモーダル分析を試す価値のあるモデルです。ただし、すべての用途で勝つモデルではありません。Google はソフトウェア開発、自律エージェント、複雑な企業ワークフロー向けの Flash モデルとして説明しています。公開証拠から言えるのは「条件付きのアップグレード」です。高い推論レベルの独立スナップショットは強い一方、遅延データは不完全です。
直感に反する軸:mediumは25%安く、指数差は1点
Artificial AnalysisではIntelligence Index 1タスクあたりhighは1.24ドル、mediumは0.93ドルです。mediumは(1.24 - 0.93) / 1.24で25%安い一方、指数は40対41です。日付付きのスナップショットであり、統計的同等性や本番費用を保証せず、mediumを先に試す根拠にとどまります。
ボトルネックで選んでください。大きな入力、継続的な計画、複数回のツール呼び出しが必要なら試します。初回応答時間、固定費用、クライアントのツール対応が重要なら、別のモデルを比較対象に残します。この記事は公開資料に基づく分析で、Tabbit のサンプルは1回に限られます。Tabbit Browser はモデルそのものではなく、ブラウザのコンテキストを整理する道具として扱います。
要点
推論は low、medium、high に対応し、minimal は非対応です。思考トークンは出力料金に含まれます。
2026年9月20日の Artificial Analysis v4.3.2 では high が指数41、305 output tokens/s、1.24ドル、medium が40と0.93ドル、low が33でした。未掲載値は未知です。
条件と方法
ランキングの前に見る Tabbit の小さな抽出例
2026年9月20日、編集テストアカウントでTabbit Browser上のGemini 3.8 Flashに合成抽出タスクを1回実行しました。返されたJSONは期待した4項目に一致し、状態が欠けた記録も期限超過にしませんでした。サンプル画像を見る。これは構造化出力の1回の例で、署名者の個人的な体験談やベンチマークではありません。推論レベル、APIバージョン、token、費用、first-token latency、成功率は測定しておらず、画面にはGoogle検索の表示もありました。
{"currency":"USD","paid_total":145,"overdue_ids":["B"],"unknown_status_ids":["D"]}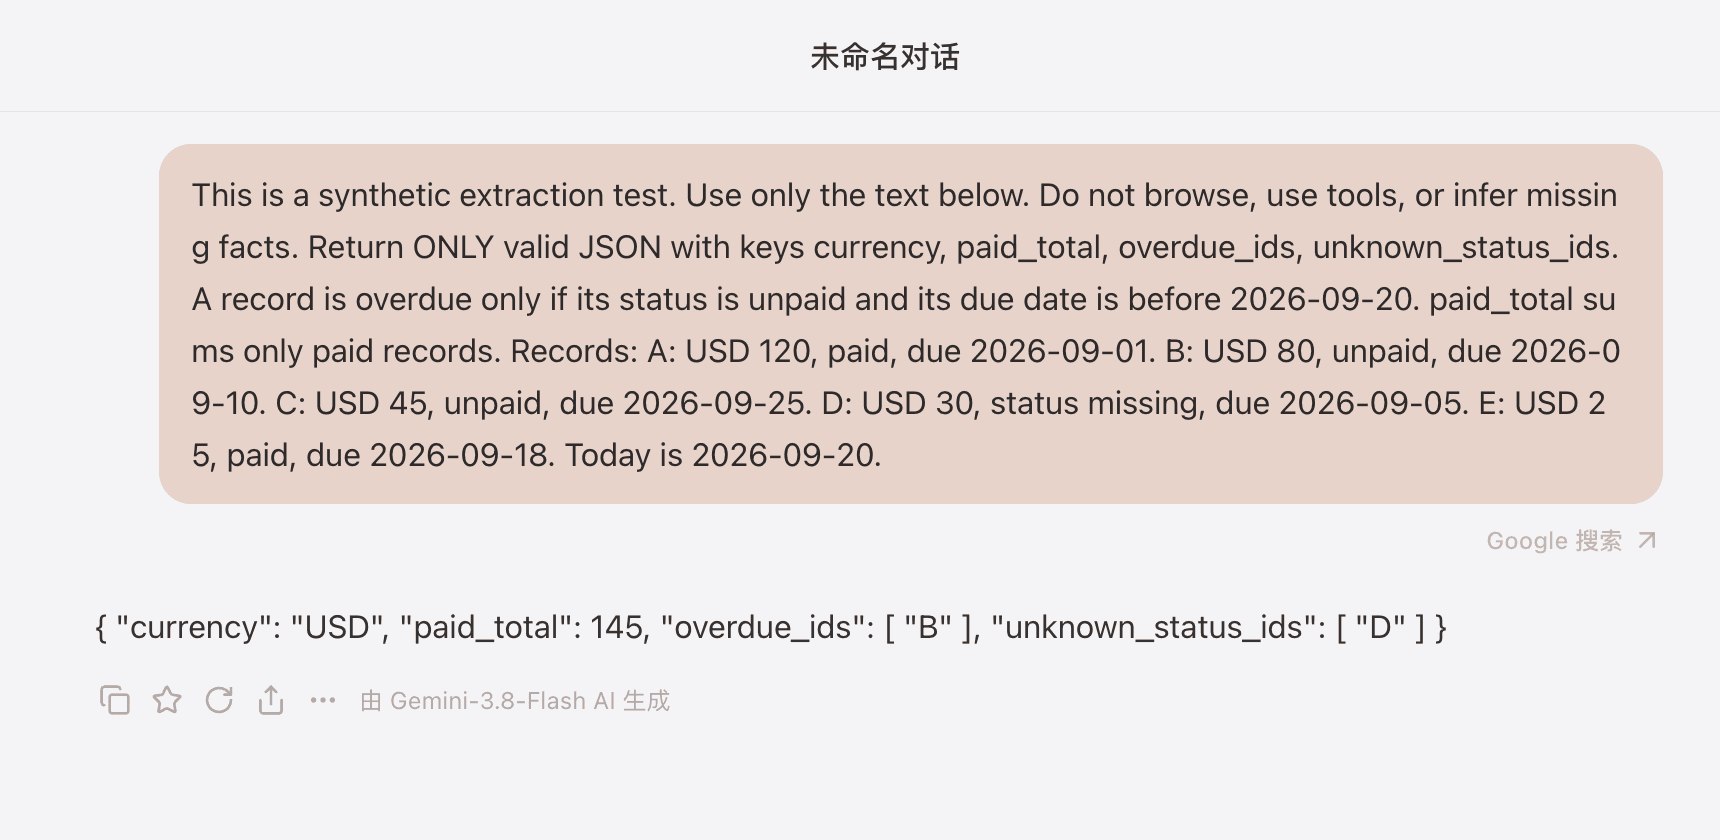
公開ベンチマークの読み方
| 推論 | 版・確認日 | Intelligence Index | 出力速度 | 指数タスク費用 | first-token latency | 読み取れること |
|---|---|---|---|---|---|---|
| High | v4.3.2、2026-09-20 | 41 | 305 token/s | $1.24 | 不明 | 高推論のスナップショットは強い。 |
| Medium | v4.3.2、2026-09-20 | 40 | 不明 | $0.93 | 不明 | 指数は近く、掲載費用は低い。 |
| Low | v4.3.2、2026-09-20 | 33 | 不明 | 不明 | 不明 | 指数は低いが速度と費用は不明。 |
305 token/s は生成速度であり first-token latency ではありません。Google は発表記事で3.7からの改善を主張していますが、これはベンダーの報告です。リリース条件は 概要記事 にまとめています。
mediumはhighより1タスクあたり25%安い((1.24 - 0.93) / 1.24)一方、指数は40対41で1点低いだけです。これは同等性や本番コストを保証するものではなく、mediumを先に試す根拠にとどまります。
3つの強みと3つの制限
ツール利用ワークフロー
公式ツールは読む・計画する・実行する・確認する作業に合いますが、クライアントごとに対応が異なります。
大きな入力とマルチモーダル
APIはテキスト、画像、動画、音声、PDFを受け付け、入力上限は1M tokenです。クライアント制限と抽出品質は要確認です。
条件付きの構造化出力例
Tabbitサンプルは4項目のJSONと未知状態を返しました。Google検索表示と1回の実行のため、一般化はできません。
推論tokenは費用を増やす
Googleは推論tokenを出力料金に含めます。mediumはタスク単価が25%低いものの、本番費用は保証されません。
初回遅延の約束はできない
確認ページには使える初回token遅延測定がありません。305 output token/sは生成速度だけを示します。
クライアントと本番範囲は別
Tabbitの表示や1アカウントの例から、全クライアント・地域・本番経路の対応は証明できません。
Hacker News 4件の原声が示すこと
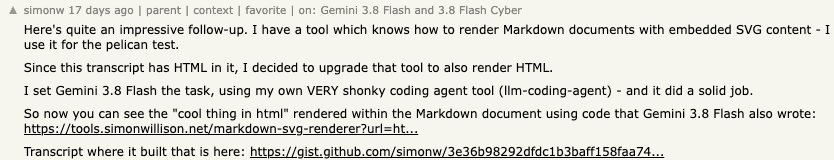
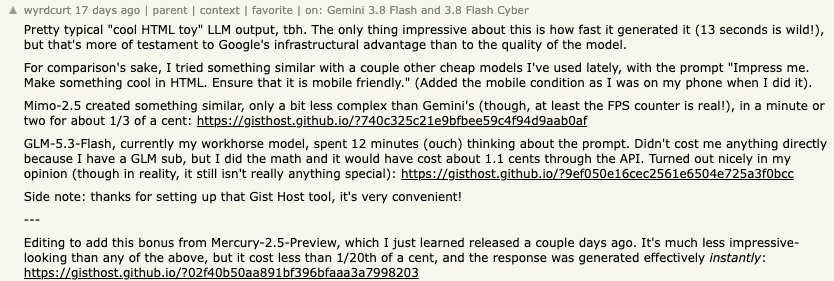

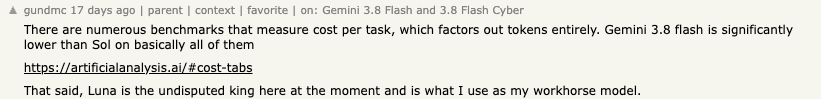
開いた原文は個別のワークフローと好みを示すだけで、普遍的な性能を証明しません。simonw は自作エージェントでHTML生成がうまくいったと報告し、wyrdcurt は結果を「cool HTML toy」と評し、古い議論の13秒生成に触れていますが現在のfirst-token latencyではありません。robertwt7 は非コーディング用途を評価しつつ豪州で旧版に留まる状況を述べ、gundmc はタスク単価を参照し別モデルを主力にしています。
Tabbit Browser の実測範囲
記録したTabbitのサンプルは合成抽出で期待した4項目のJSONを返し、未知の状態も正しく残しました。Google検索の表示があったためツールなしの実行は証明できず、first-token latency、token、費用、推論レベル、長期信頼性も測定していません。再現可能な一例であり、本番保証ではありません。
プロンプトと手順 (English)で再現できるタスクを選び、レビューの情報源 (English)で根拠を確認してください。
 Tabbit Browser
ワークロード別の判断
| 条件 | 判断 | まず試す推論 | 注意 |
|---|---|---|---|
| 複数ファイルのコード、ツール、反復修正 | 試す価値あり | medium、必要なら high | テスト成功、再試行、tokenを記録 |
| 短文、分類、大量処理 | 軽量モデルも比較 | low | 追加思考が価値を増やさない可能性 |
| 初回応答が最重要 | 優位を仮定しない | low または代替 | first-token latency不明、出力速度とは別 |
| 固定予算 | tokenと再試行上限を設定 | low/medium | API、購読、Tabbitの費用は別口径 |
判断前に、代替モデル、料金分析、モデルページ (English)、ブラウザ自動化も確認してください。
結論
Gemini 3.8 Flash は難しいマルチモーダル、ツール利用に適した候補です。すべてのベンチマークで勝つからではなく、入力、ツール、推論レベルの組み合わせが実務に合うからです。一方、速度、first-token latency、レベル別費用には未公開部分があります。
デフォルトを変更する前に、現実の2タスクで小さく試してください。成功条件を先に決め、同じプロンプトとツールで比較し、品質向上が追加費用を上回る場合だけ、そのタスク群に採用します。比較には 代替モデル、モデルリソース (English)、AIブラウザ選び を使えます。

よくある質問
Gemini 3.8 Flash は使う価値がありますか?
長い計画、ツール利用、マルチモーダル入力が必要で、完全に予測可能な遅延より完了品質を重視するなら試す価値があります。公開情報だけで全用途の最良モデルとは言えず、高い推論レベルはトークン消費を増やす可能性があります。
ベンチマークはどう読めばよいですか?
バージョン、推論レベル、指標、日付を必ずセットで見ます。2026年9月20日に確認した Artificial Analysis v4.3.2 では high が指数41、305 output tokens/s、指数タスク1件1.24ドルでした。非表示の値は不明のままです。
305 tokens/s は初回応答が速いという意味ですか?
いいえ。これは生成速度であり、first-token latencyではありません。確認したページには数値のfirst-token latencyがありませんでした。
Tabbit Browser で使えますか?
Tabbit Browser の1回のテストでは、合成抽出タスクから期待した4項目のJSONが返りました。画面にはGoogle検索の表示もあったため、ツールなしの実行、本番提供、遅延、費用、一般的な信頼性は証明できません。
誰に向きませんか?
厳密な初回遅延、固定予算、特定ツールの保証が必要なチームは、軽量モデルや代替モデルも先に比較すべきです。