
需要频繁修改代码、核对资料或产出分析报告时,可以先用 Gemini 4 Neon。Gemini 4 Carbon 适合拿来复核复杂工程、长程任务和遗漏代价高的判断。个人用户如果用 Gemini 应用,Google AI Pro 和 Ultra 都能选 Neon,Carbon 属于 Ultra。两款模型都可以通过付费 Gemini API 调用。Neon 发布公告 · Carbon 开放公告
2026 年 12 月 1 日是价格分界线。 Carbon 的每百万输出 token 价格在 11 月 30 日及以前为 10 美元,12 月 1 日起为 20 美元。Neon 为 15 美元。比较相同 token 用量时,只要换一个日期,价格排序就会变。实际预算还要计入思考 token、重试和可能发生的工具费用。Google Gemini API 价目表
如果比较时要打开好几个文档、费率页和评测来源,可以先在 Tabbit Browser 里把它们归到同一标签组,再到有权限的 Google 产品里运行同一任务。
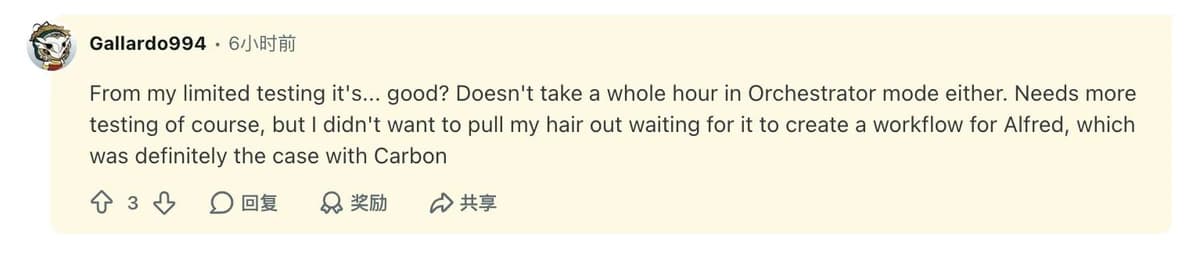
Neon 加入模型列表后,有 Antigravity 用户直接问有没有一张选型表。要回答这个问题,得先知道你用的是哪个产品,以及任务失败后是否值得重跑。
先看结论
按每百万输入和输出 token 计费,Carbon 促销期为 2 / 10 美元,12 月 1 日起为 4 / 20 美元。Neon 为 3 / 15 美元。
对 Gemini 应用里的 Google AI Pro 用户,这两款里可选的是 Neon。AI Ultra 还可选 Carbon。
Artificial Analysis 高档对比的综合指数是 Neon
xhigh61、Carbonhigh60。其测试任务平均耗时约 21 分钟和 36 分钟。两款模型都支持多模态输入和文本输出,API 上下文约 100 万 token。长资料能放进请求后,还要验证输出能否找回正确细节。
先让 Neon 跑日常复杂任务。遇到已经定位的漏项、失败测试或重要约束,再用 Carbon 复核。
Neon 和 Carbon 参数对比
| 选型维度 | Gemini 4 Neon | Gemini 4 Carbon |
|---|---|---|
| Google 定位 | 频繁执行的复杂推理、编码和知识工作 | 最难的长程推理和高级编码 |
| Gemini 应用个人订阅 | AI Pro、AI Ultra | AI Ultra |
| Gemini API 模型 ID | gemini-4-neon | gemini-4-carbon |
| 标准在线 API 输入 / 输出,每百万 token | 3 / 15 美元 | 截至 11 月 30 日 2 / 10 美元,12 月 1 日起 4 / 20 美元 |
| 缓存输入,每百万 token | 0.15 美元 | 截至 11 月 30 日 0.10 美元,12 月 1 日起 0.20 美元 |
| API 思考档位 | low、medium、high(默认)、xhigh | low、medium(默认)、high |
| 上下文与输出 | 约 100 万 token,多模态输入,文本输出 | 约 100 万 token,多模态输入,文本输出 |
应用里的订阅权限、Antigravity 的使用额度、API 项目的账单各按对应产品规则处理。可选模型见 Gemini 应用帮助, API 参数以 Neon 模型文档 和 Carbon 模型文档 为准。想了解 Carbon 此前的定位,可以看 Carbon 评测 和 Argon 与 Carbon 对比。
需要一次返回较长文本时,Google 文档写明同步非流式调用的单段输出上限为 Neon 65,536 token、Carbon 32,768 token。流式和长解码采用各自的限制。Gemini API 思考和上下文限制
查看 Neon 模型页 (English) · 查看 Carbon 模型页
基准里的速度和质量怎么读
Artificial Analysis 做了两种对比。两个模型都用 high 时,综合指数相同,按 Carbon 的非促销价估算,Neon 的单任务成本较低。各自开到最高档时,Neon xhigh 得 61 分,Carbon high 得 60 分,同组任务分别约用 21 和 36 分钟。报告还观察到约 110 和 57 token/s 的输出速率。Neon 生成的输出 token 约多 15%,因此更快的生成和更长的输出同时影响结算。Artificial Analysis 原始评测
阅读 PDF 时,档位也值得比较。GDP.pdf 这项测试中,Neon 的 high 为 33.4%,xhigh 为 28.0%,Carbon 的 high 为 28.4%。可以用一份熟悉的 PDF 作为样本,预先记下两个数字和一条脚注,要求模型标出页码,再核对它找得准不准、花了多久。
DeepMind 模型卡 说明 Neon 从 Carbon 改造而来。迁移时应显式设置思考档位。只换 ID,默认值就可能从 medium 变为 high。先做同档对比,再测最终准备部署的档位。若任务还需要登录后才能看的页面,可参考 Carbon 浏览器工作流,把网页权限和模型能力分别验收。
算一次交付需要多少钱
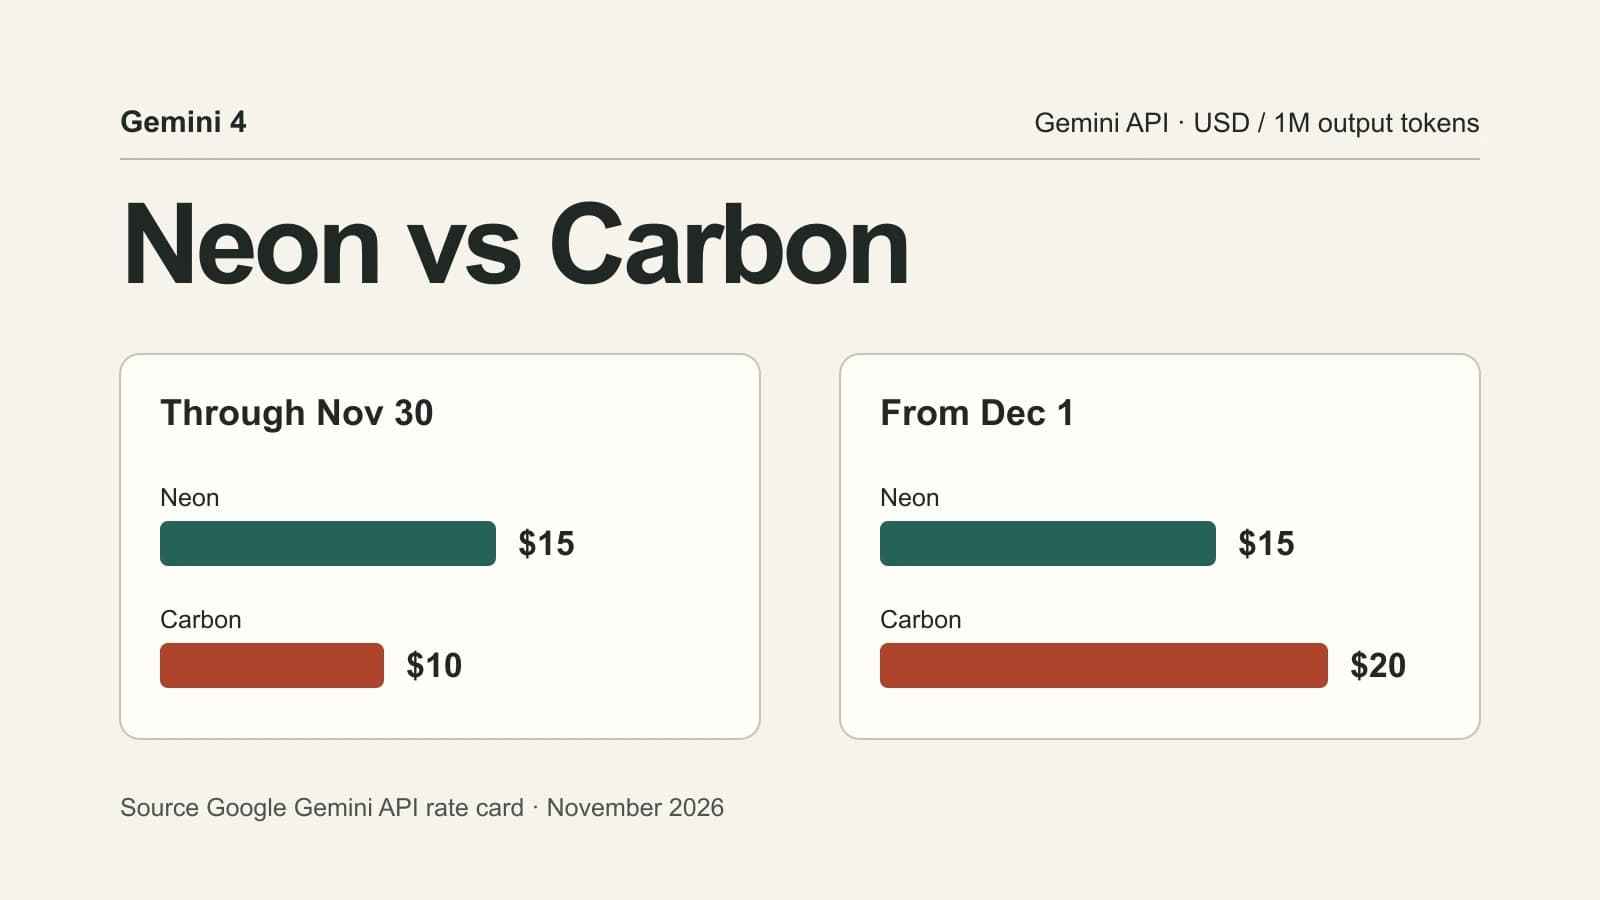
假设一次请求有 10 万未缓存输入 token、2 万计费输出 token,按标准在线接口估算。
Neon:100,000 × 3 ÷ 1,000,000 + 20,000 × 15 ÷ 1,000,000 = 0.60 美元。
Carbon:首发价下为 0.40 美元,12 月 1 日起为 0.80 美元。
谷歌把思考 token 计入输出费率。使用缓存时,只有实际命中的输入 token 按缓存价计费。重试、缓存存储和搜索工具等可能产生其他费用,做预算时另行核算。详情见 官方费率 和 Carbon 定价说明。
在相同 token 用量下,12 月一次 Carbon 调用花 0.80 美元,两次 Neon 调用花 1.20 美元。11 月促销期则是一次 Neon 花 0.60 美元、两次 Carbon 花 0.80 美元。上线后可以用「总支出 ÷ 通过验收的任务数」计算实际成本,同时记录人工返工时间。若要处理大量常规抽取,再把 Gemini 4 Hydrogen 加进基线,可参考 Carbon 与 Hydrogen 对比。
用同一道任务试两款模型
写代码时可以选一个有明确验收条件的需求,例如给解析器增加两种合法输入并保留旧行为。从同一代码状态复制两份,固定依赖版本、时间上限和测试。模型提交修改后检查原有测试是否通过、新增逻辑是否覆盖需求,以及有没有改动不相干的文件。耗时记到首次产出通过测试的补丁。
整理资料时,给两款模型相同的表格、PDF 和变更记录,要求指出哪一处数据对不上,重算总值并标明来源页或行。复杂迁移同样可以评分,例如检查方案是否兼容两种历史数据格式、有没有可执行的回退步骤。Carbon 的第二次运行值不值,取决于它能否补上已知漏项。
在 Tabbit 里准备对比所需的网页资料
把 Google 的模型文档、价目表和评测来源放进 Tabbit Browser 的同一个标签组,参照多模型研究整理指南 统一输入。如果需要核对一页的具体内容,可按 Tabbit 使用指南 使用 Chat with Page。准备好资料链接和评分条件后,把同一份输入分别带到有权限的 Gemini 会话。
可以先用本文的算例测试。请模型按 11 月 30 日和 12 月 1 日分别计算 10 万未缓存输入、2 万计费输出的费用,要求每个费率后附官方链接,再拿价目表核对。Google 账号或付费 API 项目决定能用哪个模型。不同入口的用法见 在浏览器里使用 Gemini。
你的场景适合哪款
| 任务 | 先选 | 什么时候换 |
|---|---|---|
| 用 AI Pro 订阅在 Gemini 应用里工作 | Neon | 如果某项任务明确需要 Carbon,再检查有权限的入口 |
| 改代码,每轮都运行测试 | Neon high | 同一问题反复过不了明确的测试时,试 Carbon |
| 从 PDF 或表格提取依据并写报告 | Neon high | 先核对难找的原文和计算,再定默认模型 |
| 长程迁移、架构评审或多步推理 | 用 Carbon 复核难点 | 可拆成独立验收步骤的部分可先交给 Neon |
| API 用量固定,按 token 预算 | 截至 11 月 30 日选 Carbon,之后选 Neon | 有数据后按每份合格结果的成本选择 |
复杂任务经常重复,默认用 Neon。已经知道某项验收过不去、某个细节容易漏,就让 Carbon 再跑一次,检查它是否解决了那一个问题。制定跨月预算前,把 11 月和 12 月的两组费率都代入。
 Tabbit Browser

常见问题
Gemini 4 Neon 和 Carbon 哪个更适合写代码?
开发中需要频繁修改并运行测试时,优先用 Neon。遇到重复出现的边界问题或影响较大的变更时,可以让 Carbon 用同一套验收条件复核。
Gemini API 里哪个模型更便宜?
按标准在线费率,Carbon 的首发价持续到 2026 年 11 月 30 日,这期间单价更低。12 月 1 日起,按谷歌公布的价格,Neon 的未缓存输入和输出单价比 Carbon 低 25%。
Google AI Pro 能在 Gemini 应用里用两个模型吗?
谷歌向 AI Pro 和 AI Ultra 提供 Neon。个人版 Gemini 应用的 Carbon 权限属于 AI Ultra,开发者还可通过付费 Gemini API 调用。
Gemini 4 Neon 比 Carbon 快多少?
Artificial Analysis 的这组测试中,Neon xhigh 平均约 21 分钟完成一项测试任务,Carbon high 约 36 分钟。你的任务受输入、思考档位和工具调用影响,需要实测完成时间。
Neon 和 Carbon 的上下文窗口一样吗?
谷歌为两款模型标注的 Gemini API 上下文上限均约为 100 万 token。具体客户端可能有自己的限制,使用长资料时还要检查模型能否找全关键细节。
从 Carbon 换成 Neon 时需要调整思考档位吗?
迁移时最好显式指定档位。Neon 默认 high,最高可选 xhigh,Carbon 默认 medium,最高可选 high。