
O que é o GPT-6.1 Terra e se vale a pena trocar
Vale a pena avaliar o GPT-6.1 Terra para tarefas visuais, escrita concisa com base em materiais fornecidos e automação computacional delimitada. É mais difícil recomendá-lo como substituto geral do GPT-6.1 Sol. As tarifas por token são menores, mas o nível de esforço e a quantidade de correções humanas determinam se uma tarefa concluída realmente custa menos.
Esta análise examina evidências públicas consultadas em 27 de outubro de 2026. Ela reúne a documentação da OpenAI, avaliações independentes e relatos de usuários no dia do lançamento. Não afirma ter feito um benchmark original do Terra nem uma execução verificada do Tabbit Browser com o Terra selecionado. No fim, há um fluxo de trabalho reproduzível, com essa limitação explicitada.
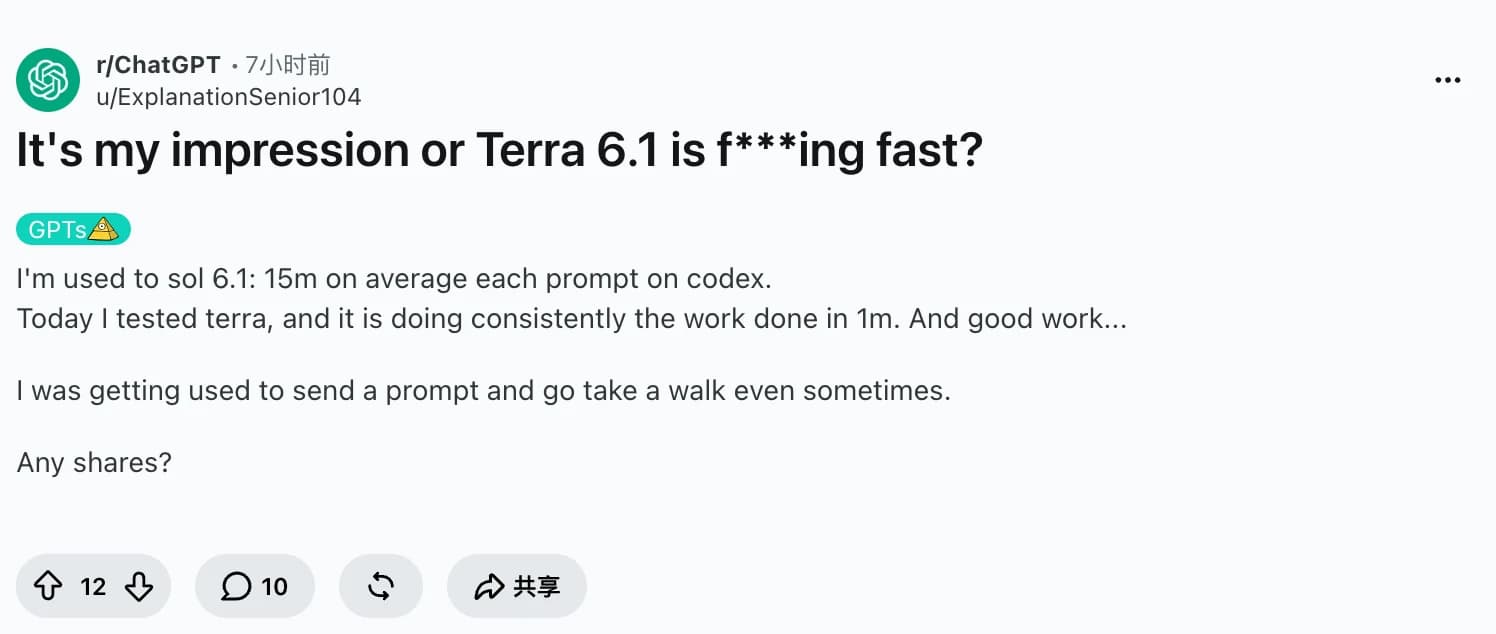
Um dos primeiros usuários do Codex, u/ExplanationSenior104, relatou uma conclusão muito mais rápida que com o Sol. Outros usuários descreveram tarefas com documentos interrompidas e consumo de cota inesperadamente rápido. Essa divergência é o motivo para avaliar o trabalho concluído em vez de comparar slogans de lançamento.
A OpenAI lançou o Terra em 26 de outubro, com foco em raciocínio visual, uso do computador e escrita natural. O ID da API é gpt-6.1-terra. Ele sucede o GPT-5.6 Terra; não o confunda com GPT-6 Sol, GPT-6.1 Sol ou o menor GPT-6 Luna.
Principais conclusões
As tarifas padrão da API para contexto curto são US$ 1 na entrada e US$ 5 na saída por milhão de tokens, metade das tarifas correspondentes do Sol. A entrada em cache custa US$ 0,05 por milhão de tokens.
A melhor pontuação do Terra no Intelligence Index, segundo a Artificial Analysis, é 48, contra 52 do GPT-6.1 Sol. Preço menor não significa capacidade geral equivalente.
O mesmo avaliador relata uma diferença de até 7,4 vezes no custo por tarefa entre configurações do Terra. Escolher o esforço faz parte da escolha do modelo.
Um teste de domínio e vários relatos de usuários levantam dúvidas sobre consistência e seguimento de instruções em tarefas longas. Isso justifica verificações, não uma afirmação de falha universal.
Faça um teste com um conjunto pequeno e fixo de tarefas antes de trocar um fluxo de trabalho. Mantenha separadas as franquias da assinatura, a cobrança da API e a associação ao Tabbit.
O número que importa: tokens pela metade do preço e uma variação de esforço de 7,4 vezes
A comparação interessante não é apenas Terra a US$ 1/US$ 5 contra Sol a US$ 2/US$ 10. A página atualizada de lançamento da Artificial Analysis relata uma diferença de 7,4 vezes entre as configurações do Terra com menor e maior custo médio por tarefa do Index. As duas observações podem ser verdadeiras. Um modelo mais barato pode gastar tokens adicionais suficientes, exigir tentativas extras ou precisar de tantas correções que a vantagem de preço desapareça.
Na avaliação de 26 de outubro, a Artificial Analysis coloca as configurações low e medium do Terra na fronteira de eficiência de custo do Intelligence Index. O Coding Agent Index mostra outro resultado: nele, low e xhigh estão nessa fronteira. Uma configuração atraente em um benchmark misto pode não ser a melhor para programação.
Nossa regra de seleção é simples:
Custo por tarefa aceita = custo total das execuções e tentativas / tarefas aprovadas nas verificações
Custo operacional = custo do modelo + custo de revisão e correção humana
Estas são fórmulas de avaliação, não resultados medidos do Terra. Se você não conseguir atribuir um preço à revisão humana, registre-a separadamente. Em uma reescrita baseada em fontes, mais raciocínio pode não acrescentar nada útil. Em um reparo difícil, pouco raciocínio pode transformar um trabalho em várias tentativas. Use a configuração mais baixa que passe nas verificações da tarefa e compare também com o Sol em uma configuração razoável.
Evidências práticas antes da tabela de benchmarks
A DualEntry testou o Terra em sua própria avaliação contábil de 101 tarefas, com três execuções. A empresa relata precisão de 78,2%, 16,1 segundos por tarefa e custo de US$ 0,042 por tarefa. Um dado é ainda mais revelador: somente 65,3% das tarefas passaram nas três execuções. O modelo pode ser rápido e barato e ainda gerar bastante trabalho de verificação.
Essa é uma avaliação de domínio feita por um fornecedor de software contábil, não uma classificação geral de modelos. O relatório divulgado não comprova uma comparação com esforço equivalente para todos os modelos. Não use os segundos ou dólares relatados para prever uma sessão no navegador. A contribuição útil é separar precisão média de repetibilidade.
As comparações mais amplas abaixo vêm de um único avaliador e identificam seu escopo.
| Avaliação ou medida de custo | GPT-6.1 Terra | GPT-6.1 Sol | GPT-6 Luna | O que responde |
|---|---|---|---|---|
| AA Intelligence Index v4.3.2, melhor configuração divulgada, arredondada | 48 | 52 | 38 | Capacidade geral nas dez avaliações do Index |
| AA Coding Agent Index v2.0, comparação divulgada | 48 | 54 | 31 | Capacidade para agentes de programação, um índice separado |
| Entrada / saída padrão da API por milhão de tokens, contexto curto | US$ 1 / US$ 5 | US$ 2 / US$ 10 | US$ 0,10 / US$ 0,50 | Preços unitários dos tokens, sem extras |
| Custo do Terra nas configurações de tarefas do Index | Variação de até 7,4× | Não é uma comparação entre modelos | Não é uma comparação entre modelos | Quanto a escolha do esforço do Terra afeta o gasto medido |
Fontes consultadas em 27 de outubro: página de lançamento da AA, avaliação de lançamento da AA e preços da OpenAI.
Os dois índices usam tarefas diferentes e não podem ser calculados em média juntos. As pontuações arredondadas do Intelligence são da melhor configuração divulgada de cada modelo, não medições com esforço igual. Preços por token não são preços por tarefa. As conclusões da AA são independentes dos gráficos de lançamento da OpenAI, mas ainda dependem das tarefas, ferramentas, pontuação e configuração da AA. Nenhuma mede sua própria taxa de conclusão.
A OpenAI também relata 50,3% no Terminal-Bench 4.0 com esforço máximo, contra o resultado divulgado de 21,5% do GPT-5.6 Terra. Essa comparação do fornecedor com o antecessor não prova que o Terra iguale o Sol em engenharia de software. A própria OpenAI recomenda Sol ou Astra para os trabalhos de programação mais complexos. Essa distinção também importa ao ler nossa análise anterior do GPT-6 Sol, que trata de outra versão.
Onde o Terra parece útil
Escrita clara quando o material de referência já está disponível
O melhor motivo para testar o Terra talvez seja algo simples: transformar anotações fornecidas em uma explicação legível. O guia de seleção de modelos da OpenAI recomenda especificamente avaliar escrita concisa baseada em fontes. Essa é uma afirmação mais restrita e útil do que chamá-lo de melhor modelo de escrita.
Forneça as fontes, o público, as seções necessárias e a instrução para não adicionar fatos sem respaldo. Avalie se ele preserva as ressalvas e inclui os detalhes necessários. Isso serve para documentação de produtos e resumos internos que um editor possa revisar. Não comprova confiabilidade em um livro longo ou relatório de pesquisa reunido com muitas ferramentas.
Trabalho visual com um resultado definido
A OpenAI posiciona o Terra para interpretar desenhos, combinar imagens de produtos e agir em telas de aplicativos. Nas avaliações de lançamento, o modelo supera o antecessor em raciocínio visual e tarefas de computador. Esses são bons motivos para testá-lo no preenchimento de formulários ou na interpretação de capturas de tela.
A condição prática é ter um resultado que possa ser inspecionado. Um campo preenchido deve corresponder ao valor da fonte; um item de catálogo selecionado deve corresponder à imagem. O problema de automação do navegador também envolve acesso às páginas, comportamento das ferramentas e validação. A pontuação do modelo cobre apenas parte desse fluxo de trabalho.
Melhor economia em tarefas delimitadas
O resultado de eficiência de custo da AA apoia testar configurações de baixo esforço em tarefas repetidas com critérios claros de aceitação. Alguns exemplos são extrair um conjunto fixo de campos ou reescrever um parágrafo sem introduzir fatos novos. O modelo fica entre o preço baixo do Luna e a capacidade geral mais ampla do Sol.
A melhora na factualidade também é animadora. A AA relata que o Terra chuta respostas em 38% das perguntas que não consegue responder no AA-Omniscience, abaixo dos 88% do GPT-5.6 Terra, enquanto a precisão sobe dois pontos. Essa taxa condicional de respostas chutadas não significa que 38% das respostas comuns sejam falsas, nem que todas as outras 62% estejam corretas. Ela justifica preservar explicitamente os valores desconhecidos em tarefas de extração.
Onde a economia pode desaparecer
Tarefas longas podem exigir mais supervisão do que o preço sugere
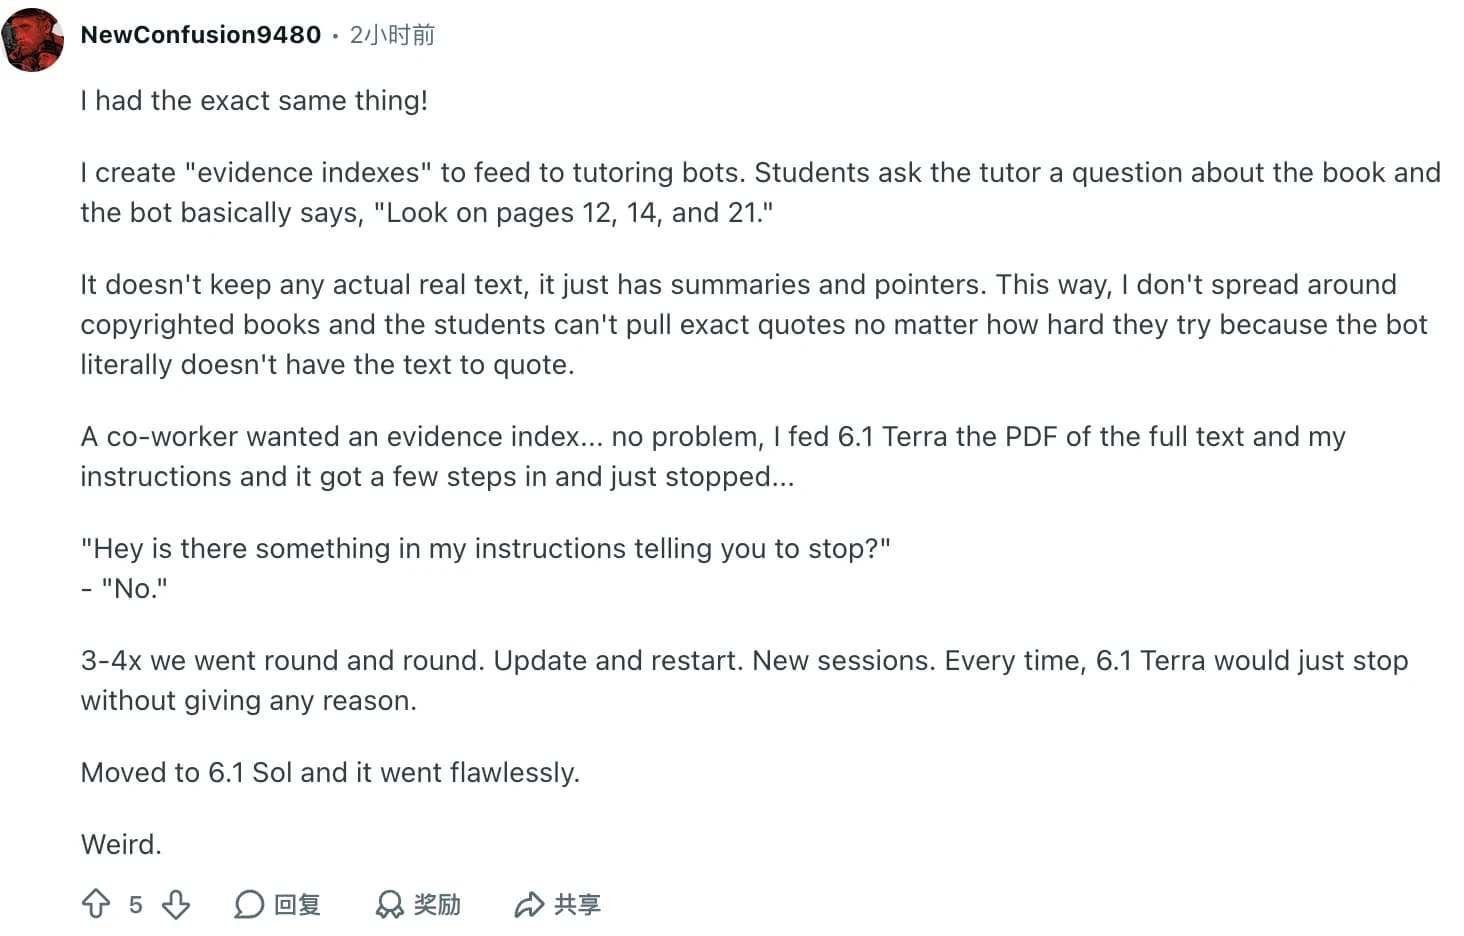
u/NewConfusion9480 descreveu uma tarefa concreta: criar um índice de evidências em PDF para aulas particulares. Segundo o relato, o Terra parava repetidamente, enquanto a troca para o Sol permitiu concluir o trabalho. A publicação original de u/Hefestion89 descreve falhas em instruções de procedimento durante uma análise literária capítulo a capítulo no ChatGPT Work.
São relatos do dia do lançamento, sem reprodução controlada. Eles não isolam o comportamento do modelo da orquestração ou do estado da sessão. Mas apontam para um critério útil de aceitação: o agente concluiu todas as seções necessárias sem precisar de instruções repetidas? Aumentar o esforço não substitui a verificação da conclusão.
A velocidade pode vir acompanhada de perda de qualidade
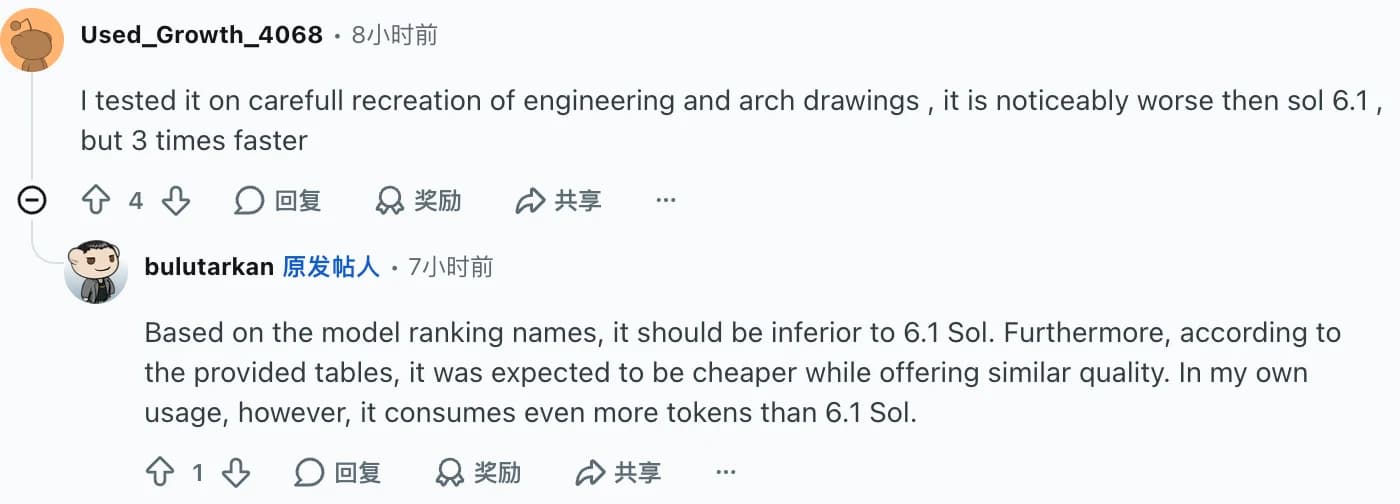
Um relato de u/Used_Growth_4068 sobre a recriação de um desenho descreve o Terra como mais rápido, mas visivelmente pior que o Sol. Não há entradas compartilhadas nem critérios de pontuação, então o multiplicador de velocidade citado é anedótico. Ainda assim, é um contraponto útil à suposição de que um trabalho visual mais rápido preserva cada detalhe.
O resultado de repetibilidade da DualEntry dá à mesma preocupação uma medida em um domínio. Se seu fluxo de trabalho exige a mesma resposta sempre, teste execuções repetidas em vez de escolher o exemplo mais favorável. Para trabalhos difíceis e ambíguos, compare com uma opção mais forte, como a que abordamos na nossa análise do GPT-6 Astra.
Descontos da API não preveem franquias de assinatura
A documentação do modelo da OpenAI lista seis configurações de esforço, com medium como padrão. Prompts acima de 272K tokens de entrada acionam tarifas mais altas para toda a solicitação. Gravações em cache e cobranças de ferramentas também podem pesar. Uma janela de contexto de 1.050.000 tokens descreve a capacidade, não uma promessa de que preenchê-la será barato.
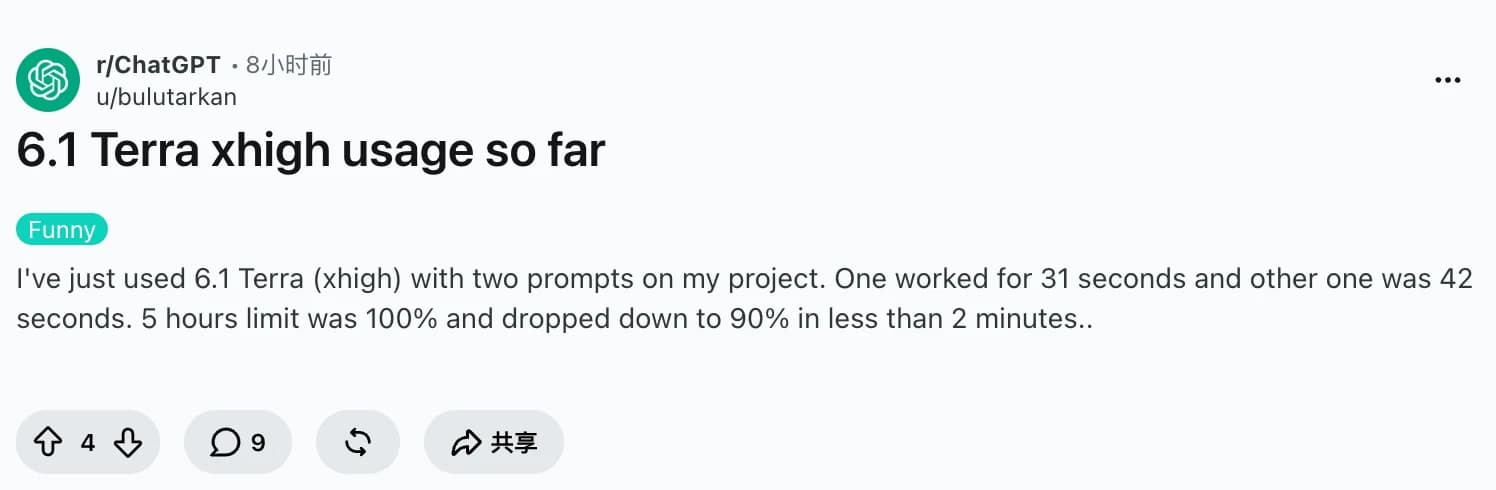
Enquanto isso, u/bulutarkan relatou uma queda de 10 pontos na franquia depois de dois prompts xhigh. Isso não é uma fatura da API nem uma comparação controlada de cotas. Conta, raciocínio, contexto e contabilização do produto podem variar. Considere o relato um motivo para conferir seu próprio uso, não uma fórmula de conversão entre tokens e porcentagens da assinatura.
O que os usuários disseram: velocidade versus conclusão
Os relatos positivos destacam esperas curtas. As preocupações se concentram na fidelidade das respostas, na conclusão do trabalho e nas franquias. Quatro exemplos coletados ilustram essas prioridades diferentes; não são uma pesquisa representativa. As citações entre aspas são traduções; as capturas preservam o texto original.
"Hoje testei o Terra, e ele está fazendo o trabalho consistentemente em 1 min. E um bom trabalho..."
u/ExplanationSenior104, trabalho no Codex, 26 de outubro UTC. O autor compara sessões pessoais, sem um conjunto equivalente de tarefas.
"é visivelmente pior que o sol 6.1, mas 3 vezes mais rápido"
u/Used_Growth_4068, recriação de desenhos de engenharia e arquitetura, 26 de outubro UTC. A captura preserva a redação original em inglês; as avaliações de velocidade e qualidade são observações do autor.
"Toda vez, o 6.1 Terra simplesmente parava sem dar motivo algum."
u/NewConfusion9480, indexação de evidências em PDF, 27 de outubro UTC. O relato diz que o Sol concluiu o fluxo de trabalho; a causa das interrupções do Terra não foi verificada.
"o limite de 5 horas estava em 100% e caiu para 90% em menos de 2 minutos..."
u/bulutarkan, dois prompts de projeto com xhigh, 26 de outubro UTC. É uma observação sobre assinatura, não uma medição do custo da API.
No Hacker News, wyre argumenta que o público do Terra são tarefas no computador, automação e escrita técnica. É uma opinião sobre o posicionamento, não outro teste. Ela combina com a distinção editorial útil aqui: avalie o Terra para o trabalho de que você precisa, em vez de esperar que um modelo mais barato substitua todos os modelos maiores.
O veredito por tipo de trabalho
Vale testar o Terra para fluxos de trabalho visuais e de escrita delimitados. Mantenha o Sol como referência para trabalhos longos e complicados. Pagar metade por token só compensa quando a saída aceita passa pela revisão.
| Seu tipo de trabalho | Opção inicial | O que verificar antes de trocar |
|---|---|---|
| Reescrever anotações fornecidas em uma explicação curta | Testar o Terra em none ou low | Fidelidade às fontes, seções necessárias e adequação ao público |
| Interpretar uma captura de tela ou preparar campos de formulário | Testar o Terra em low ou medium | Conferir cada valor com a fonte e inspecionar os resultados salvos |
| Corrigir um defeito pequeno e isolado no código | Comparar o Terra com o GPT-6.1 Sol | Verificações de regressão, total de tentativas e tempo de revisão |
| Alterações em um repositório grande ou tarefa documental autônoma e longa | Começar pelo Sol; considerar o Astra para tarefas mais difíceis | Conclusão de ponta a ponta e preservação de todas as restrições |
| Classificação de alto volume com um esquema simples | Comparar o Luna com o Terra | Custo por tarefa aceita e tratamento de erros nos seus próprios dados |
| Trabalho repetido em que resultados inconsistentes custam caro | Não escolher pelo preço do token | Repetibilidade e custo das correções |
As configurações da tabela são pontos de partida para testes, não opções ideais medidas. Nosso guia de navegadores com IA e a visão geral dos navegadores agênticos abordam a camada de produto em torno do modelo. Ela importa quando a tarefa envolve páginas, arquivos e resultados salvos.
Teste o fluxo de trabalho no Tabbit e confira o resultado
Um benchmark não dá ao modelo acesso às suas abas nem verifica um registro salvo. O Tabbit Browser fornece contexto do navegador e ferramentas para tarefas. O site oficial documenta como fazer referência a páginas, capturas de tela e arquivos locais. Esses recursos fazem dele um lugar prático para avaliar o tipo de trabalho ao qual o Terra se destina.
Primeiro, confira se o GPT-6.1 Terra realmente aparece no seletor de modelos da sua conta. A página de recursos do Terra (English) reúne configurações e evidências; sua existência não confirma a disponibilidade no cliente. Este artigo não concluiu um teste do Tabbit com o Terra selecionado e não pode informar taxa de sucesso, latência, cobrança de tokens ou vantagem em uma comparação nesse ambiente.
Para uma primeira verificação, abra a especificação pública de um produto e peça quatro campos: nome do produto, preço com moeda, limitação declarada e URL da fonte. Exija unknown quando a página não informar um valor. Repita em uma segunda página e compare os resultados com os originais visíveis. Uma segunda tarefa pode comparar as duas páginas sem importar afirmações de outros lugares. Para um documento longo, peça respostas por página e verifique cada citação.
Antes de executar, defina aprovação como a presença de todos os campos ou citações solicitados, nenhum acréscimo sem respaldo e um relatório verdadeiro de conclusão. Salve as entradas, o nome do modelo selecionado, as saídas, as capturas de tela e quaisquer correções. Repita as mesmas tarefas com o Sol, se estiver disponível. Mantenha as medições do cliente separadas dos benchmarks da API e não infira uma taxa geral de sucesso a partir de poucos exemplos.
Se essas verificações forem adequadas ao seu trabalho, baixe o Tabbit e compare um pequeno conjunto de tarefas. A disponibilidade do modelo e as regras de associação dependem do cliente e da região atuais; os preços da API nesta análise não são os preços do Tabbit.
 Tabbit Browser

Perguntas frequentes
Vale a pena usar o GPT-6.1 Terra em vez do GPT-6.1 Sol?
Vale a pena avaliar o Terra para fluxos de trabalho visuais, escrita baseada em fontes e automação computacional delimitada, quando velocidade e custo são importantes. O Sol continua sendo o ponto de partida mais forte para programação complexa e raciocínio prolongado. Compare tarefas concluídas e verificadas no nível de esforço que você realmente pretende usar.
Quanto custa o GPT-6.1 Terra pela API?
As tarifas padrão para contexto curto, consultadas em 27 de outubro de 2026, são US$ 1 por milhão de tokens de entrada, US$ 0,05 por milhão de tokens de entrada em cache e US$ 5 por milhão de tokens de saída. Gravações em cache, ferramentas, níveis de serviço e ajustes para contexto longo podem alterar a cobrança. As tarifas da API não especificam as franquias das assinaturas do ChatGPT, Codex ou Tabbit.
Devo sempre usar o esforço de raciocínio máximo com o Terra?
Não. A Artificial Analysis relata uma diferença de até 7,4 vezes no custo médio por tarefa entre configurações do Terra. Comece com uma configuração mais baixa em tarefas delimitadas e aumente o esforço somente quando seus próprios critérios de aceitação indicarem uma melhora útil.
A taxa menor de alucinação significa que as respostas são confiáveis?
É uma melhora em avaliações específicas, não uma garantia. A Artificial Analysis mede quando o modelo chuta respostas para perguntas que não consegue responder, enquanto a OpenAI relata erros factuais em outro conjunto interno de prompts. Nenhuma das porcentagens representa a taxa de erro dos seus documentos ou da sua aplicação.
O GPT-6.1 Terra pode chamar ferramentas pelo Chat Completions?
A OpenAI lista o Chat Completions como endpoint compatível, mas a chamada de ferramentas requer a API Responses. O modelo aceita texto e imagens e gera texto. Um produto desenvolvido com base no modelo pode adicionar ferramentas próprias ou recursos para lidar com arquivos.
Posso testar o GPT-6.1 Terra no Tabbit Browser?
Confira o seletor de modelos da sua conta antes de planejar um fluxo de trabalho com o Terra no Tabbit. Este artigo não verificou uma execução do Tabbit com o Terra selecionado, e a página de recursos do modelo não comprova a disponibilidade na sua conta. As regras de associação ao Tabbit são separadas dos preços da API da OpenAI.