
Ce qu’est GPT-6.1 Terra et s’il vaut la peine de changer
GPT-6.1 Terra mérite d’être évalué pour les tâches visuelles, la rédaction concise à partir de documents fournis et l’automatisation informatique bien délimitée. Il est plus difficile de le recommander comme remplaçant général de GPT-6.1 Sol. Ses tarifs par token sont plus bas, mais le niveau d’effort et le volume de corrections humaines déterminent si une tâche terminée coûte réellement moins cher.
Cet article évalue les informations publiques vérifiées le 27 octobre 2026. Il rassemble la documentation d’OpenAI, des évaluations indépendantes et des avis d’utilisateurs publiés le jour du lancement. Il ne prétend ni présenter un benchmark original de Terra ni avoir vérifié une exécution de Tabbit Browser avec Terra sélectionné. Vous trouverez à la fin un flux de travail reproductible, avec cette limite clairement indiquée.
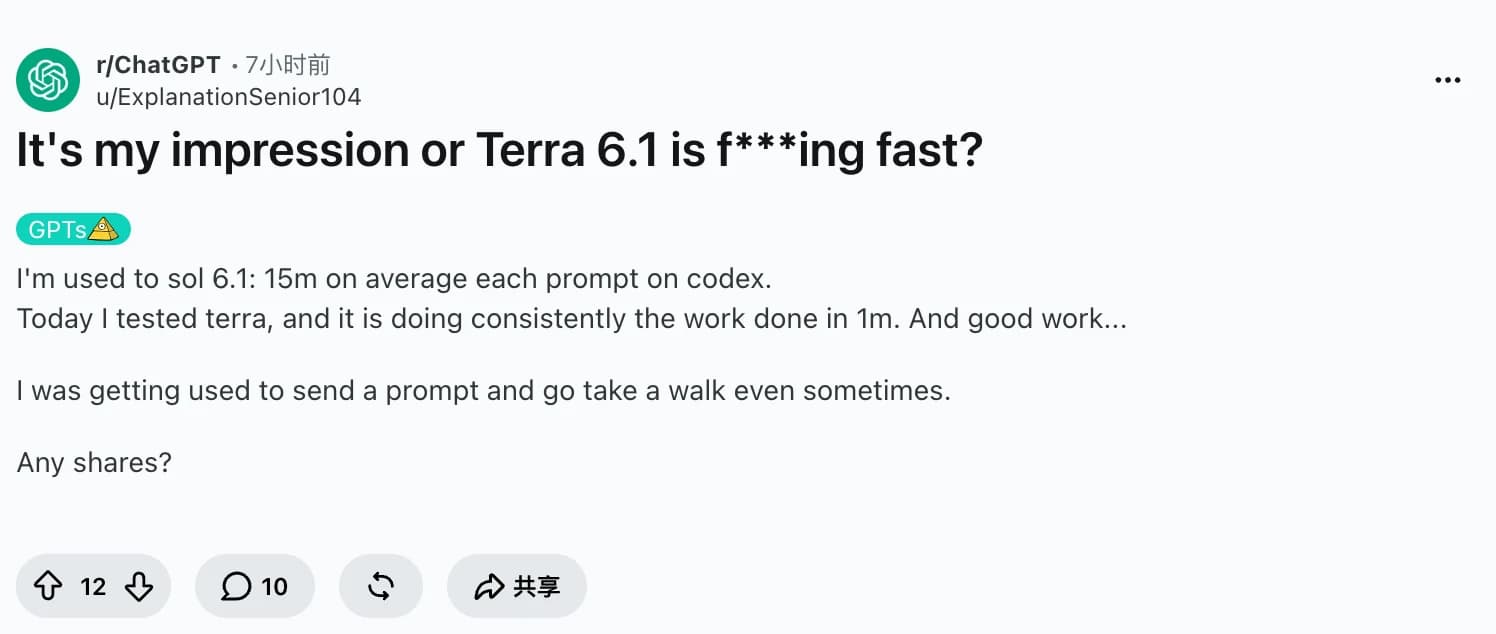
Un utilisateur précoce de Codex, u/ExplanationSenior104, a signalé une exécution bien plus rapide qu’avec Sol. D’autres utilisateurs ont décrit des tâches documentaires interrompues et une consommation de quota étonnamment rapide. Ces avis contradictoires sont une raison d’évaluer le travail terminé plutôt que de comparer les slogans de lancement.
OpenAI a lancé Terra le 26 octobre, en le destinant au raisonnement visuel, à l’utilisation de l’ordinateur et à la rédaction naturelle. Son identifiant API est gpt-6.1-terra. Il succède à GPT-5.6 Terra. Ne le confondez pas avec GPT-6 Sol, GPT-6.1 Sol ou le modèle plus petit GPT-6 Luna.
À retenir
Les tarifs standard de l’API pour un contexte court sont de 1 $ en entrée et 5 $ en sortie par million de tokens, soit la moitié des tarifs correspondants de Sol. L’entrée mise en cache coûte 0,05 $ par million de tokens.
Le meilleur score de Terra à l’Intelligence Index selon Artificial Analysis est de 48, contre 52 pour GPT-6.1 Sol. Un prix plus bas ne signifie pas une capacité générale équivalente.
Le même évaluateur signale un écart de coût par tâche pouvant atteindre 7,4 fois selon les réglages de Terra. Le choix du niveau d’effort fait partie du choix du modèle.
Un test sectoriel et plusieurs témoignages soulèvent des questions sur la régularité et le suivi d’instructions lors de tâches longues. Ils justifient des vérifications, pas une conclusion d’échec systématique.
Avant de changer un flux de travail, testez un petit ensemble fixe de tâches. Distinguez les quotas d’abonnement, la facturation de l’API et l’adhésion à Tabbit.
Le chiffre à retenir : des tokens deux fois moins chers et un écart d’effort de 7,4 fois
La comparaison intéressante ne se limite pas à Terra à 1 $/5 $ contre Sol à 2 $/10 $. La page de lancement mise à jour d’Artificial Analysis rapporte un écart de 7,4 fois entre les configurations Terra les moins et les plus coûteuses en moyenne par tâche de l’Index. Ces deux observations peuvent être vraies. Un modèle moins cher peut utiliser assez de tokens supplémentaires, nécessiter assez de nouvelles tentatives ou demander assez de corrections pour annuler son avantage tarifaire.
Dans son évaluation du 26 octobre, Artificial Analysis place les réglages low et medium de Terra sur la frontière d’efficacité des coûts de l’Intelligence Index. Le Coding Agent Index donne un autre résultat : les réglages low et xhigh sont sur cette frontière. Un réglage intéressant sur un benchmark mixte n’est pas forcément le bon pour le code.
Notre règle de sélection est donc simple :
Coût par tâche acceptée = coût total des exécutions et des nouvelles tentatives / tâches qui passent les vérifications
Coût opérationnel = coût du modèle + coût de la vérification et des corrections humaines
Ce sont des formules d’évaluation, pas des résultats mesurés pour Terra. Si vous ne pouvez pas chiffrer la vérification humaine, consignez-la séparément. Pour une réécriture à partir de sources, un raisonnement plus poussé peut n’apporter aucun bénéfice. Pour une réparation difficile, un effort insuffisant peut transformer une tâche en plusieurs tentatives. Utilisez le niveau le plus bas qui passe vos vérifications, puis comparez aussi avec Sol à un réglage raisonnable.
Éléments concrets avant le tableau des benchmarks
DualEntry a testé Terra sur sa propre évaluation comptable de 101 tâches, avec trois exécutions. L’entreprise rapporte une précision de 78,2 %, 16,1 secondes par tâche et un coût de 0,042 $ par tâche. Un résultat est plus révélateur : seulement 65,3 % des tâches ont réussi les trois exécutions. Le modèle peut être rapide et peu coûteux tout en générant un volume important de vérifications.
Il s’agit d’une évaluation sectorielle réalisée par un éditeur de logiciel comptable, pas d’un classement général de modèles. Le rapport publié ne prouve pas que chaque modèle a été comparé avec le même niveau d’effort. N’utilisez pas ses secondes ou ses dollars pour prévoir une session dans un navigateur. Son apport utile est de distinguer la précision moyenne de la répétabilité.
Les comparaisons plus larges ci-dessous viennent d’un seul évaluateur et précisent leur portée.
| Évaluation ou mesure de coût | GPT-6.1 Terra | GPT-6.1 Sol | GPT-6 Luna | Ce que cela mesure |
|---|---|---|---|---|
| AA Intelligence Index v4.3.2, meilleure configuration publiée, arrondie | 48 | 52 | 38 | Capacité générale sur les dix évaluations de l’Index |
| AA Coding Agent Index v2.0, comparaison publiée | 48 | 54 | 31 | Capacité des agents de code, sur un index distinct |
| API standard, entrée / sortie par million de tokens, contexte court | 1 $ / 5 $ | 2 $ / 10 $ | 0,10 $ / 0,50 $ | Prix unitaires des tokens, hors suppléments |
| Coût de Terra selon les configurations de tâches de l’Index | Variation jusqu’à 7,4× | Pas une comparaison entre modèles | Pas une comparaison entre modèles | Influence du niveau d’effort de Terra sur les dépenses mesurées |
Sources vérifiées le 27 octobre : page de lancement AA, évaluation de lancement AA et tarifs OpenAI.
Les deux indices utilisent des tâches différentes et ne peuvent pas être moyennés. Les scores Intelligence arrondis correspondent à la meilleure configuration publiée pour chaque modèle, pas à des mesures à effort égal. Les tarifs par token ne sont pas des tarifs par tâche. Les résultats d’AA sont indépendants des graphiques de lancement d’OpenAI, mais dépendent toujours des tâches, outils, méthodes de notation et configurations d’AA. Aucun ne mesure votre propre taux de réussite.
OpenAI rapporte séparément un score de 50,3 % à Terminal-Bench 4.0 avec un effort maximal, contre 21,5 % pour GPT-5.6 Terra dans les résultats publiés. C’est une comparaison du fournisseur avec son prédécesseur, pas la preuve que Terra égale Sol en ingénierie logicielle. OpenAI recommande elle-même Sol ou Astra pour les tâches de code les plus complexes. Cette distinction compte également à la lecture de notre précédent avis sur GPT-6 Sol, qui porte sur une version différente.
Les usages où Terra semble utile
Rédiger clairement quand les sources sont déjà disponibles
La meilleure raison d’essayer Terra est peut-être très simple : transformer des notes fournies en explication lisible. Le guide de sélection des modèles d’OpenAI recommande précisément d’évaluer la rédaction concise à partir de sources. C’est une affirmation plus limitée et plus utile que de le qualifier de meilleur modèle de rédaction.
Fournissez les sources, le public visé, les sections requises et l’interdiction d’ajouter des faits non étayés. Vérifiez qu’il conserve les nuances et fournit le niveau de détail nécessaire. Cet usage convient à la documentation produit et aux synthèses internes qu’un éditeur peut relire. Il ne prouve pas sa fiabilité sur un livre entier ou un rapport de recherche composé avec de nombreux outils.
Travail visuel avec un résultat défini
OpenAI destine Terra à l’interprétation de dessins, à la correspondance d’images de produits et aux actions dans les écrans d’applications. Dans ses évaluations de lancement, le modèle progresse par rapport à son prédécesseur en raisonnement visuel et sur les tâches de bureau. Ce sont de bonnes raisons de le tester pour remplir des formulaires ou interpréter des captures d’écran.
La condition pratique est de pouvoir inspecter le résultat. Un champ rempli doit correspondre à la valeur de la source ; un article de catalogue sélectionné doit correspondre à l’image. Le problème de l’automatisation du navigateur dépend aussi de l’accès aux pages, du comportement des outils et de la validation. Le score du modèle ne couvre qu’une partie du flux de travail.
Des économies possibles sur les tâches bien délimitées
Le résultat d’efficacité des coûts d’AA justifie de tester des niveaux d’effort faibles sur des tâches répétées assorties de critères d’acceptation clairs. Par exemple, extraire un ensemble fixe de champs ou réécrire un paragraphe sans introduire de faits nouveaux. Terra se situe entre le prix bas de Luna et la capacité générale plus large de Sol.
L’amélioration de la factualité est également encourageante. AA indique que Terra devine la réponse à 38 % des questions auxquelles il ne peut pas répondre dans AA-Omniscience, contre 88 % pour GPT-5.6 Terra, tandis que la précision augmente de deux points. Ce taux conditionnel de réponses devinées ne signifie pas que 38 % des réponses habituelles sont fausses, ni que les 62 % restants sont toutes correctes. Il justifie de conserver explicitement les valeurs inconnues dans les tâches d’extraction.
Quand les économies peuvent disparaître
Les tâches longues peuvent nécessiter plus de supervision que ne le laisse penser le prix
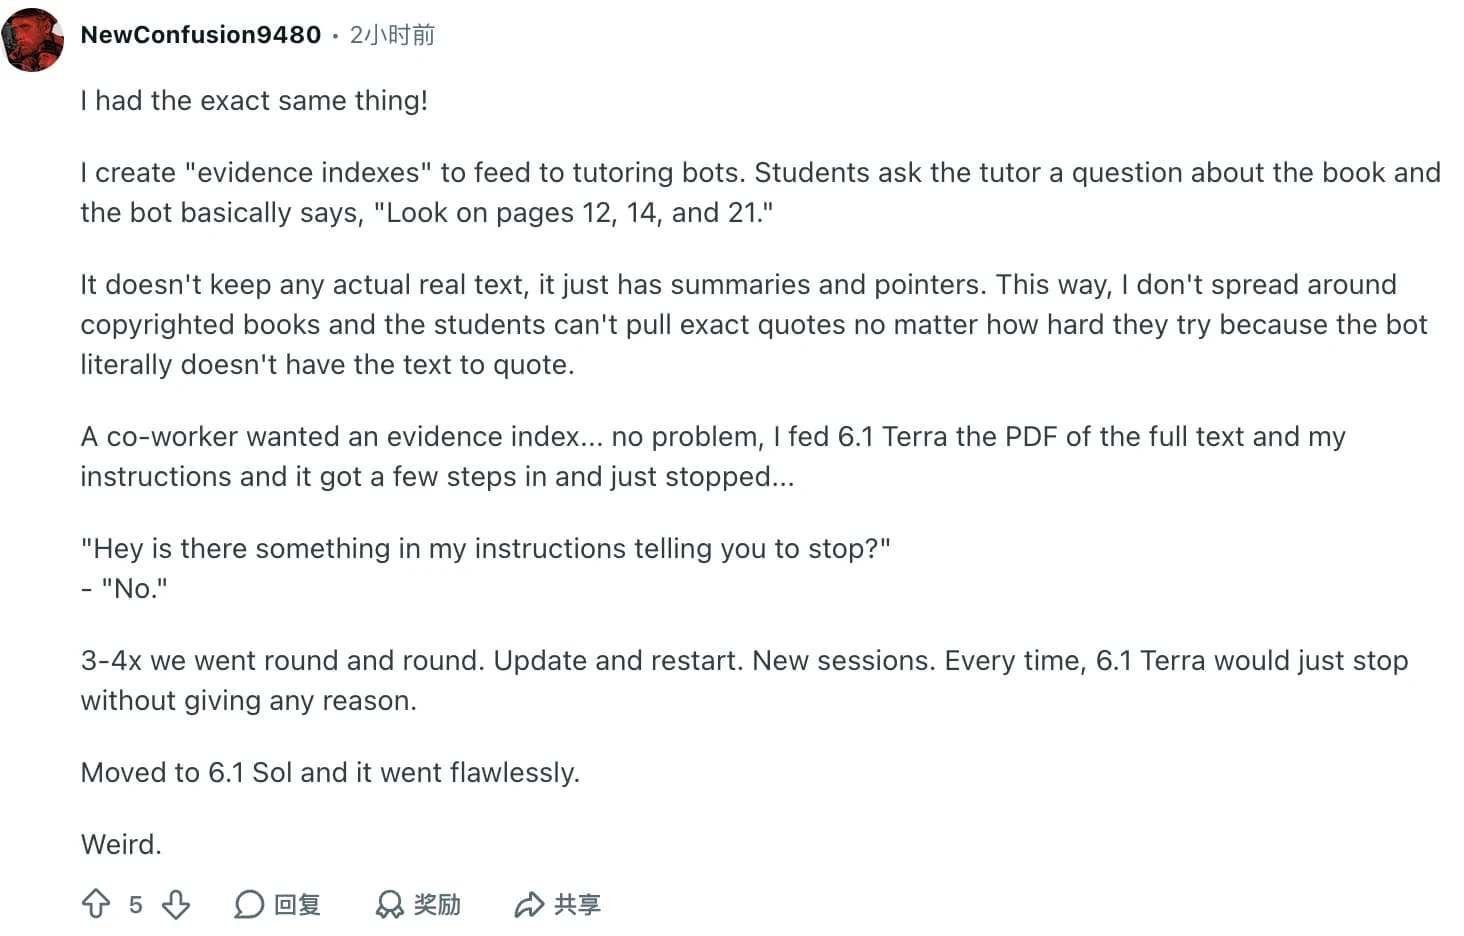
u/NewConfusion9480 a décrit une tâche précise : créer un index de preuves PDF pour du soutien scolaire. Selon son témoignage, Terra s’arrêtait à répétition, tandis que Sol a terminé le travail après le changement de modèle. La publication originale de u/Hefestion89 décrit des difficultés à suivre des consignes procédurales lors d’une analyse littéraire chapitre par chapitre dans ChatGPT Work.
Ces témoignages du jour du lancement n’ont pas été reproduits dans des conditions contrôlées. Ils ne permettent pas de distinguer le comportement du modèle de l’orchestration ou de l’état de la session. Ils suggèrent un critère d’acceptation utile : l’agent a-t-il terminé toutes les sections requises sans relances répétées ? Augmenter l’effort ne remplace pas la vérification du travail terminé.
La vitesse peut se payer par une baisse de qualité
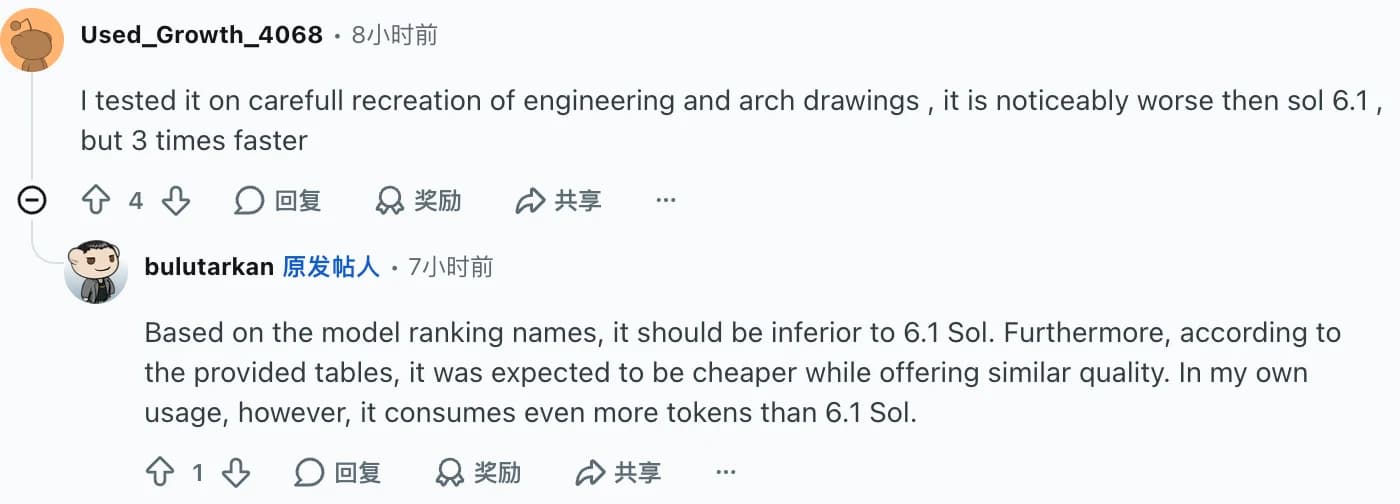
Un témoignage de u/Used_Growth_4068 sur la reproduction d’un dessin décrit Terra comme plus rapide, mais nettement moins bon que Sol. Les entrées et critères de notation ne sont pas partagés, donc le multiplicateur de vitesse avancé reste anecdotique. Le témoignage rappelle néanmoins qu’un travail visuel plus rapide ne conserve pas forcément chaque détail.
Le résultat de répétabilité de DualEntry donne à la même préoccupation une mesure dans un seul domaine. Si votre flux de travail exige la même réponse à chaque fois, testez plusieurs exécutions au lieu de choisir le meilleur exemple. Pour les tâches difficiles et ambiguës, comparez avec une option plus puissante comme celle présentée dans notre avis sur GPT-6 Astra.
Les réductions de l’API ne prédisent pas les quotas d’abonnement
La documentation du modèle d’OpenAI répertorie six niveaux d’effort, avec medium par défaut. Les prompts dépassant 272K tokens d’entrée entraînent des tarifs plus élevés pour l’ensemble de la requête. Les écritures en cache et les frais d’outils peuvent également compter. Une fenêtre de contexte de 1 050 000 tokens décrit une capacité, pas la promesse qu’il soit économique de la remplir.
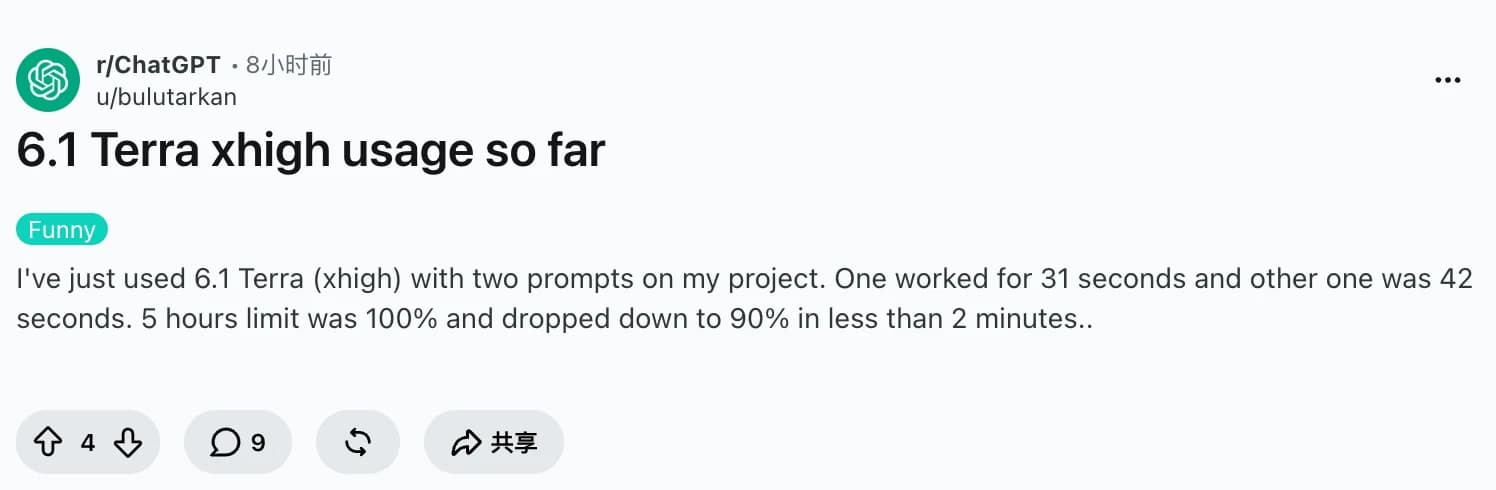
De son côté, u/bulutarkan a signalé une baisse de 10 points de son quota après deux prompts xhigh. Ce n’est ni une facture API ni une comparaison contrôlée de quotas. Le compte, le raisonnement, le contexte et la comptabilisation par le produit peuvent varier. Considérez ce témoignage comme une raison de vérifier votre propre consommation, pas comme une formule de conversion entre tokens et pourcentage d’abonnement.
Ce que disent les utilisateurs : vitesse ou tâche terminée
Les avis positifs portent sur les temps d’attente courts. Les critiques concernent la fidélité du résultat, l’achèvement du travail et les quotas. Quatre exemples recueillis illustrent ces priorités différentes ; ils ne constituent pas un sondage représentatif. Les citations entre guillemets sont des traductions ; les captures conservent le texte original.
« Aujourd’hui, j’ai testé Terra et il réalise régulièrement le travail en 1 min. Et il le fait bien… »
u/ExplanationSenior104, travail dans Codex, 26 octobre UTC. L’auteur compare ses propres sessions, sans ensemble de tâches équivalent.
« c’est nettement moins bon que sol 6.1, mais 3 fois plus rapide »
u/Used_Growth_4068, reproduction de dessins d’ingénierie et d’architecture, 26 octobre UTC. La capture conserve la formulation originale en anglais ; les appréciations de vitesse et de qualité sont celles de l’auteur.
« À chaque fois, 6.1 Terra s’arrêtait sans aucune raison. »
u/NewConfusion9480, indexation de preuves PDF, 27 octobre UTC. Le témoignage dit que Sol a terminé le flux de travail ; la cause des arrêts de Terra n’est pas vérifiée.
« la limite de 5 heures était à 100 % et elle est passée à 90 % en moins de 2 minutes… »
u/bulutarkan, deux prompts de projet avec xhigh, 26 octobre UTC. Il s’agit d’une observation sur un abonnement, pas d’une mesure du coût de l’API.
Sur Hacker News, wyre estime que Terra s’adresse aux tâches sur ordinateur, à l’automatisation et à la rédaction technique. C’est un avis sur son positionnement, pas un test supplémentaire. Il correspond à la distinction utile ici : évaluez Terra pour le travail dont vous avez besoin au lieu d’attendre d’un seul modèle moins cher qu’il remplace tous les modèles plus grands.
Verdict selon la tâche
Terra mérite un essai pour les flux de travail visuels et rédactionnels bien délimités. Gardez Sol comme point de comparaison pour les tâches longues et complexes. Payer moitié moins par token n’est intéressant que si le résultat accepté résiste à la vérification.
| Votre tâche | Modèle à essayer d’abord | Points à vérifier avant de changer |
|---|---|---|
| Transformer des notes fournies en une courte explication | Tester Terra avec none ou low | Fidélité aux sources, sections requises, adéquation au public |
| Interpréter une capture d’écran ou remplir des champs de formulaire | Tester Terra avec low ou medium | Comparer chaque valeur à sa source et inspecter les résultats enregistrés |
| Corriger un petit défaut de code isolé | Comparer Terra à GPT-6.1 Sol | Tests de régression, nombre total de nouvelles tentatives, temps de vérification |
| Modifier un grand dépôt ou accomplir une longue tâche documentaire autonome | Commencer par Sol ; envisager Astra pour les tâches plus difficiles | Achèvement de bout en bout et respect de toutes les contraintes |
| Classifier un grand volume de données selon un schéma simple | Comparer Luna et Terra | Coût par tâche acceptée et gestion des erreurs sur vos propres données |
| Répéter une tâche où des résultats incohérents coûtent cher | Ne pas choisir selon le prix des tokens | Répétabilité et coût des corrections |
Les niveaux indiqués dans ce tableau sont des points de départ pour les essais, pas des réglages optimaux mesurés. Notre guide des navigateurs IA et notre présentation des navigateurs agentiques traitent de la couche produit autour du modèle. Elle compte lorsqu’une tâche s’étend à plusieurs pages, fichiers et résultats enregistrés.
Essayez le flux de travail dans Tabbit, puis vérifiez le résultat
Un benchmark ne donne pas au modèle accès à vos onglets et ne vérifie pas un enregistrement sauvegardé. Tabbit Browser fournit le contexte du navigateur et des outils de tâche. Son site officiel explique comment référencer des pages, des captures d’écran et des fichiers locaux. Ces fonctions en font un outil pratique pour évaluer le type de travail visé par Terra.
Commencez par vérifier si GPT-6.1 Terra apparaît réellement dans le sélecteur de modèles de votre compte. La page de ressources Terra (English) rassemble les réglages et les éléments disponibles ; son existence ne prouve pas que le modèle soit accessible dans le client. Cet article n’a pas effectué de test Tabbit avec Terra sélectionné et ne peut donc fournir de taux de réussite, de latence, de facture de tokens ni de victoire comparative dans cet environnement.
Pour un premier contrôle, ouvrez une fiche produit publique et demandez quatre champs : nom du produit, prix avec devise, limite indiquée et URL de la source. Exigez la valeur unknown lorsque la page ne précise pas une information. Recommencez sur une deuxième page, puis comparez les résultats avec les originaux visibles. Une deuxième tâche peut comparer les deux pages sans importer d’affirmations externes. Pour un long document, demandez des réponses par page et vérifiez chaque citation.
Avant le test, définissez la réussite ainsi : tous les champs ou citations demandés sont présents, aucun ajout n’est sans fondement et le rapport d’achèvement est exact. Conservez les entrées, le nom du modèle sélectionné, les sorties, les captures d’écran et les corrections éventuelles. Répétez les mêmes tâches avec Sol si le modèle est disponible. Distinguez les mesures du client des benchmarks API et ne déduisez pas un taux général de réussite de quelques exemples.
Si ces vérifications correspondent à votre travail, téléchargez Tabbit et comparez un petit ensemble de tâches. La disponibilité des modèles et les règles d’adhésion dépendent du client et de la région ; les tarifs API de cet article ne sont pas les tarifs de Tabbit.
 Tabbit Browser

Questions fréquentes
GPT-6.1 Terra vaut-il la peine par rapport à GPT-6.1 Sol ?
Terra mérite d’être évalué pour les tâches visuelles, la rédaction à partir de sources fournies et l’automatisation informatique bien délimitée, lorsque la vitesse et le coût comptent. Sol reste le meilleur point de départ pour le code complexe et le raisonnement prolongé. Comparez les tâches terminées et vérifiées avec le niveau d’effort que vous utiliserez réellement.
Combien coûte GPT-6.1 Terra avec l’API ?
Les tarifs standard pour un contexte court, vérifiés le 27 octobre 2026, sont de 1 $ par million de tokens en entrée, 0,05 $ par million de tokens d’entrée mis en cache et 5 $ par million de tokens en sortie. Les écritures en cache, les outils, les niveaux de service et les ajustements pour contexte long peuvent modifier la facture. Les tarifs de l’API ne précisent pas les quotas d’abonnement à ChatGPT, Codex ou Tabbit.
Faut-il toujours utiliser l’effort de raisonnement maximal avec Terra ?
Non. Artificial Analysis signale un écart pouvant atteindre 7,4 fois le coût moyen par tâche selon les configurations de Terra. Commencez par un niveau faible pour les tâches délimitées et n’augmentez l’effort que si vos propres critères d’acceptation montrent un gain utile.
Un taux d’hallucination plus faible signifie-t-il que ses réponses sont fiables ?
C’est une amélioration sur des évaluations précises, pas une garantie. Artificial Analysis mesure les réponses devinées aux questions auxquelles le modèle ne peut pas répondre, tandis qu’OpenAI rapporte les erreurs factuelles sur un autre jeu de prompts interne. Aucun de ces pourcentages ne correspond au taux d’erreur de vos documents ou de votre application.
GPT-6.1 Terra peut-il appeler des outils avec Chat Completions ?
OpenAI indique que Chat Completions est un endpoint pris en charge, mais l’appel d’outils nécessite l’API Responses. Le modèle accepte du texte et des images et produit du texte. Un produit conçu autour du modèle peut ajouter ses propres outils ou la gestion de fichiers.
Puis-je essayer GPT-6.1 Terra dans Tabbit Browser ?
Vérifiez le sélecteur de modèles de votre compte avant de prévoir un flux de travail Terra dans Tabbit. Cet article n’a pas vérifié une exécution Tabbit avec Terra sélectionné, et la page de ressources du modèle ne prouve pas sa disponibilité pour votre compte. Les règles d’adhésion à Tabbit sont indépendantes des tarifs de l’API OpenAI.