
GPT-6.2 Astra coûte 8 USD par million de tokens d’entrée hors cache, 0,40 USD en lecture du cache et 40 USD en sortie avec le tarif Standard, jusqu’à 272 000 tokens d’entrée. L’écriture en cache coûte 10 USD par million pour 30 minutes ou 20 USD pour 12 heures. OpenAI a publié gpt-6.2-astra le 17 novembre 2026. Tarifs vérifiés le 19 novembre. Tarifs OpenAI · Annonce
Surveillez le seuil de 272 000 tokens d’entrée. Avec 3 000 tokens de sortie facturés et une entrée entièrement hors cache, passer de 272 000 à 273 000 tokens porte le coût de 2,296 à 4,548 USD. Le nouveau tarif s’applique à la requête entière. Fiche du modèle
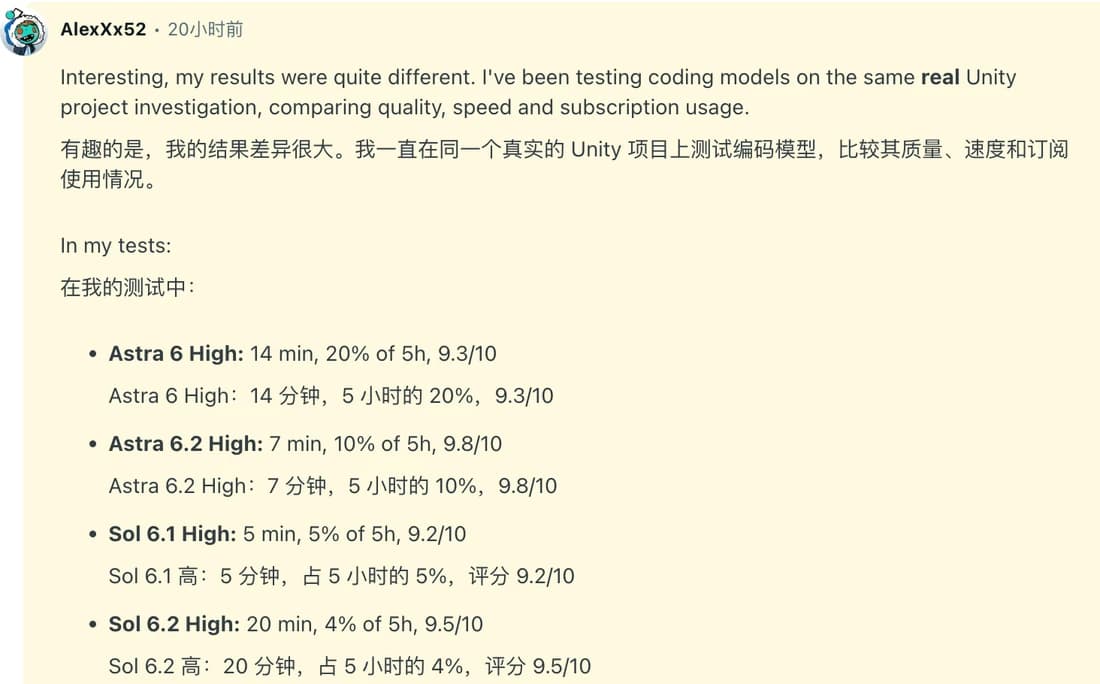
Un membre de r/codex a suivi son usage avec Pro 200 et s’interrogeait sur la façon dont Codex et ChatGPT consomment le même quota. Pour comparer les deux, relevez la consommation du forfait et le coût de l’API séparément. Discussion d’origine
À retenir
En Standard et en contexte court, l’entrée et la sortie coûtent 20 % de moins que sur GPT-6 Astra. La lecture en cache baisse de 60 %.
Au-delà du seuil, les prix d’entrée et de cache doublent et la sortie augmente de 50 %. Le modèle accepte jusqu’à 922 000 tokens d’entrée.
Batch divise le tarif Standard par deux. Fast le double. Ultrafast passe de 3× à 6× le 1er mars 2027, heure du Pacifique.
Sol coûte quatre fois moins par token en Standard sur un contexte court. Comparez le nombre de tentatives et le coût par résultat validé.
Grille des tarifs API
| API OpenAI, USD par million | Entrée hors cache | Lecture du cache | Écriture 30 min | Écriture 12 h | Sortie |
|---|---|---|---|---|---|
| Standard, jusqu’à 272 000 | $8 | $0.40 | $10 | $20 | $40 |
| Standard, au-delà de 272 000 | $16 | $0.80 | $20 | $40 | $60 |
| Batch, contexte court | $4 | $0.20 | $5 | $10 | $20 |
| Fast, contexte court | $16 | $0.80 | $20 | $40 | $80 |
| Ultrafast, contexte court jusqu’au 28 février 2027 | $24 | $1.20 | $30 | $60 | $120 |
| Ultrafast, contexte court dès le 1er mars 2027 | $48 | $2.40 | $60 | $120 | $240 |
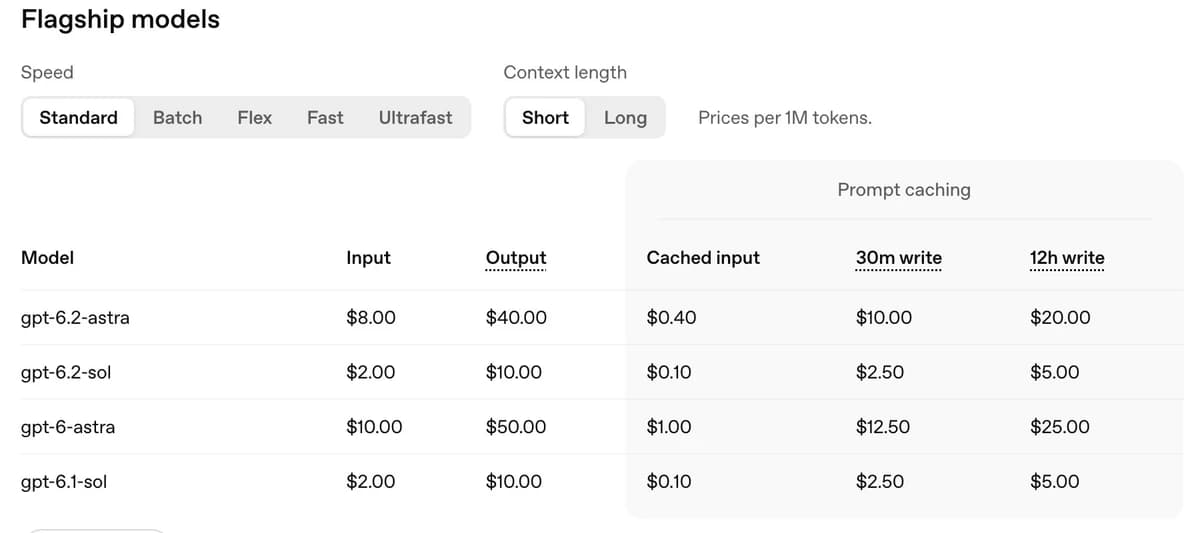
Dans la Responses API, les requêtes éligibles en arrière-plan coûtent 30 % de moins avec une fenêtre de deux heures et 40 % de moins avec celle de huit heures. Flex est affiché pour GPT-6 Astra. GPT-6.2 Astra est absent de cette liste. Les endpoints régionaux avec résidence des données et les endpoints FedRAMP affichent un supplément de 10 %. Tarifs OpenAI
Le seuil des 272 000 tokens
Additionnez l’entrée hors cache, les lectures et les deux types d’écriture. Une requête de 300 000 tokens franchit le seuil avec 250 000 tokens lus en cache. La fenêtre totale du modèle couvre 1 050 000 tokens, avec un maximum de 922 000 en entrée et de 128 000 en sortie. Guide GPT-6.2 Astra (English) · Spécifications officielles
Les anciens messages et les résultats d’outils s’accumulent dans les échanges. Mesurez une requête de fin de session. Si vous voulez découper les documents, vérifiez que les comparaisons entre passages restent correctes. Une deuxième passe consomme à nouveau des tokens. Réduire les tokens consommés par un agent de navigateur
Comparer Astra, Sol et la génération précédente
| API OpenAI, USD par million | Entrée hors cache | Lecture du cache | Écriture 30 min | Écriture 12 h | Sortie |
|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $10 | $20 | $40 |
| GPT-6.2 Sol (English) | $2 | $0.10 | $2.50 | $5 | $10 |
| GPT-6 Astra | $10 | $1 | $12.50 | $25 | $50 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $5 | $10 |
La grille concerne le tarif Standard jusqu’à 272 000 tokens d’entrée. Sur Agents’ Last Exam, OpenAI rapporte 5,2 points de plus que GPT-6 Astra pour moins d’un tiers du coût estimé. Pour votre propre travail, gardez des critères de validation identiques. Divisez la dépense de toutes les tentatives par le nombre de tâches validées. Évaluations d’Astra 6.2 (English) · Test de GPT-6 Astra · Évaluation OpenAI
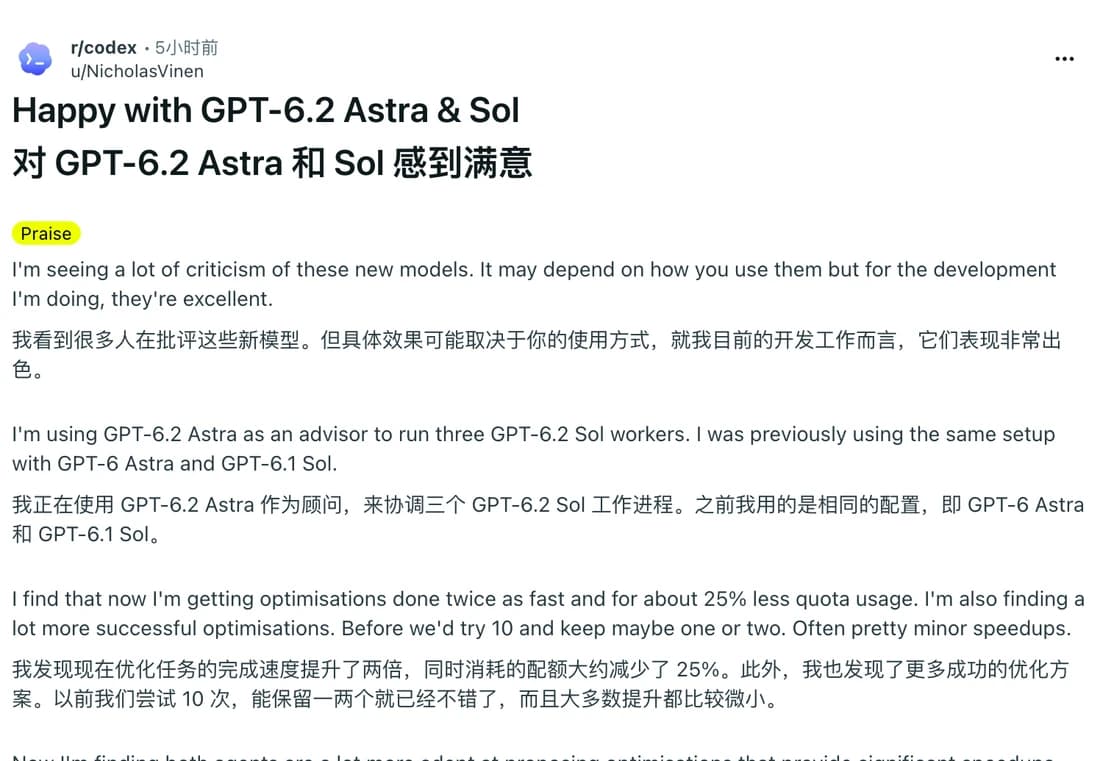
NicholasVinen a confié la supervision de trois agents Sol à Astra pour optimiser du code. Il dit avoir consommé moins de quota qu’avec les versions précédentes. Avec l’API, comptabilisez l’usage des quatre agents. Publication originale
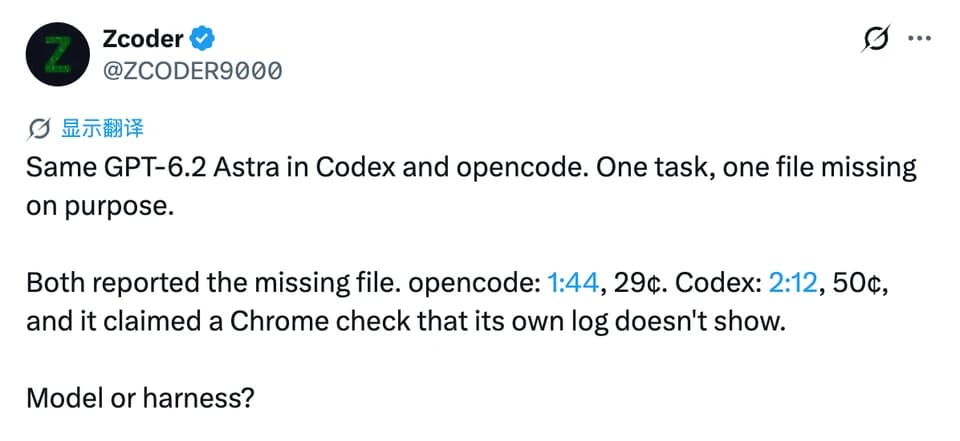
Zcoder a retiré volontairement un fichier et a soumis la même tâche à Astra via Codex et OpenCode. Les deux clients ont signalé le fichier manquant, avec des durées et des coûts différents selon l’auteur. Lors de votre comparaison, notez aussi le client et le déroulement du travail. Publication originale sur X
Deux estimations concrètes
Une relecture proche du seuil
Avec 272 000 tokens d’entrée hors cache et 3 000 en sortie, le calcul est (272 000 × 8 + 3 000 × 40) / 1 000 000, soit 2,296 USD. Avec 273 000 tokens d’entrée, les nouveaux tarifs donnent 4,548 USD. Pour 100 requêtes identiques, cela donne 229,60 ou 454,80 USD.
Une réponse de 1 000 tokens visibles et 2 000 de raisonnement représente 3 000 tokens de sortie. Astra rejette reasoning.effort: none. Commencez avec un niveau pris en charge qui satisfait vos critères. Un supplément de 1 000 tokens de sortie coûte 0,04 USD en contexte court et 0,06 USD en contexte long. Guide du raisonnement
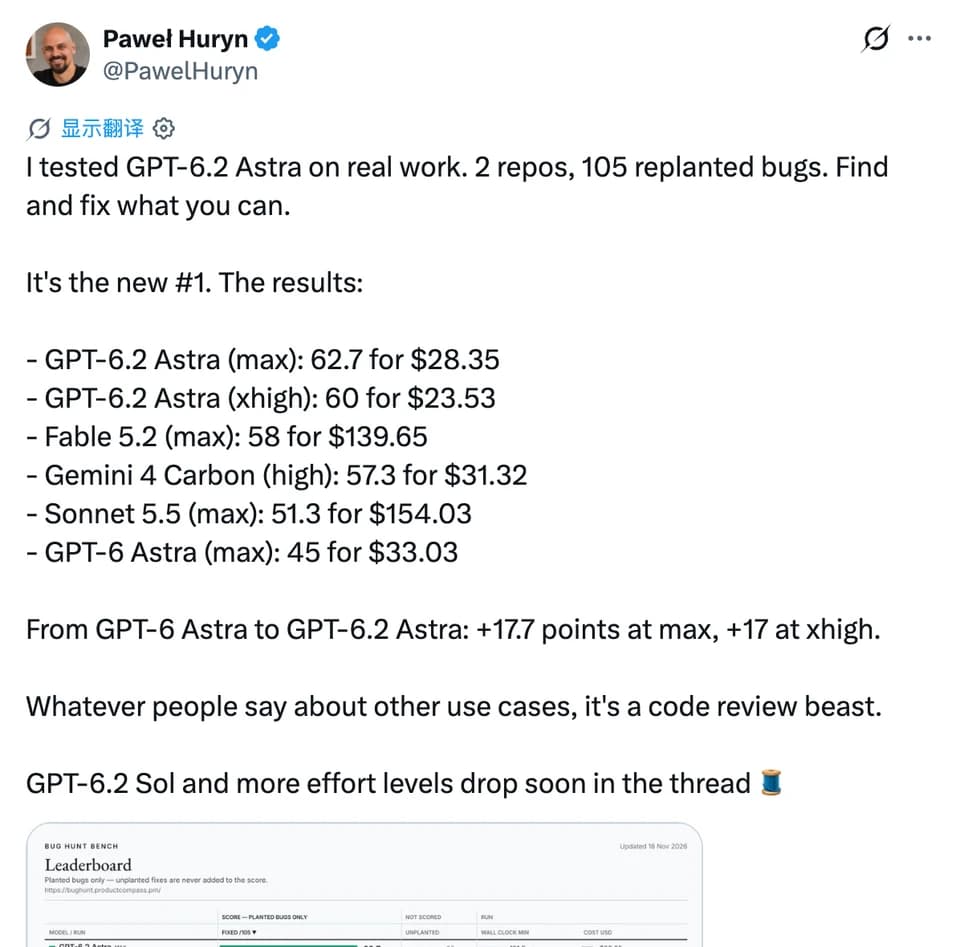
Paweł Huryn indique avoir dépensé 28,35 USD avec max et 23,53 USD avec xhigh sur deux dépôts. Max a obtenu un meilleur score dans son essai. Évaluez le surcoût avec les critères de votre propre travail. Publication originale sur X
Un document relu avec écriture en cache
Prenez 180 000 tokens d’entrée, dont 150 000 lus en cache, 10 000 écrits pour 30 minutes et 20 000 hors cache. Avec une sortie de 3 000 tokens, le coût est de 0,44 USD, soit 0,06 pour les lectures, 0,10 pour les écritures, 0,16 pour l’entrée ordinaire et 0,12 pour la sortie. Comptez 440 USD pour 1 000 requêtes. Avec une écriture de 12 heures, le coût unitaire serait de 0,54 USD.
Déduisez les lectures et les écritures du total d’entrée. Gardez le préfixe réutilisé à l’identique et placez les éléments variables à la fin. Échantillonnez aussi les premiers appels et ceux qui suivent une pause. Prompts et réglages d’Astra (English) · Guide du cache
Calculateur local
Estimer le coût de l’API GPT-6.2 Astra
Tarif Standard en dollars. Saisissez la consommation par requête. Le calcul se fait dans votre navigateur.
Incluez les tokens de raisonnement dans la sortie. Le calcul exclut les écritures en cache, les outils, les nouvelles tentatives, les taxes et les abonnements. Tarifs de l’API OpenAI
Le calculateur couvre l’entrée ordinaire, la lecture et la sortie facturée au tarif Standard. Ajoutez les écritures d’après le tableau. Pour estimer un mois d’usage, calculez un sous-total par groupe de requêtes de taille comparable.
Frais liés au cache, aux outils et aux forfaits
Une lecture n’entraîne pas un deuxième paiement au prix d’entrée ordinaire. Elle peut prolonger la couverture de 30 minutes sans nouvelle écriture. Le passage à 12 heures peut être facturé comme une écriture. Les outils hébergés peuvent avoir leur propre prix et produire de nouveaux tokens d’entrée. Ajoutez les tentatives supplémentaires, les taxes et les frais de prestataires si nécessaire. Guide du cache · Tarifs des outils
OpenAI a annoncé Astra dans ChatGPT Work et Codex pour Plus, Pro, Enterprise et Edu. Les deux produits partagent le quota applicable. Astra Ultrafast est annoncé pour Pro 500 et les espaces gérés éligibles. Pour Pro 200, le déploiement d’Ultrafast a commencé avec Sol. Vérifiez le quota et les crédits de votre compte. Aide Work et Codex · Annonce
Utiliser GPT-6.2 Astra dans Tabbit Browser
Ouvrez un document qui contient une réponse vérifiable et sélectionnez GPT-6.2 Astra. Avec Chat with Page, demandez une réponse accompagnée du passage qui la justifie. Vérifiez le passage avant de répéter l’exercice sur plusieurs onglets. Le guide de recherche multimodèle explique comment conserver les consignes et leurs sources. Pour chiffrer l’usage de l’API, utilisez les données de consommation OpenAI.
 Tabbit Browser
Le bon mode selon le travail
| Travail | Point de départ | Mesure utile |
|---|---|---|
| Transformations répétitives | GPT-6.2 Sol Standard | Résultats validés par dollar |
| Relectures et développement complexes | GPT-6.2 Astra Standard | Raisonnement, reprises et taille maximale |
| Travaux qui peuvent attendre | Batch ou traitement en arrière-plan éligible | Délai et disponibilité |
| Interaction sensible à la latence | Standard, puis Fast ou Ultrafast | Temps gagné et surcoût |
Réservez Astra aux tâches qui en bénéficient. Les tarifs GPT-6.1 Terra donnent un autre repère pour les tâches avec outils. Pour préparer le budget mensuel, rejouez un cas jusqu’à la fin et vérifiez si son entrée dépasse 272 000 tokens.

Questions fréquentes
Quel est le prix de GPT-6.2 Astra dans l’API OpenAI ?
Jusqu’à 272 000 tokens d’entrée, le tarif Standard est de 8 USD par million hors cache, 0,40 USD en lecture du cache et 40 USD en sortie. Les écritures coûtent 10 USD par million pour 30 minutes ou 20 USD pour 12 heures.
Que se passe-t-il au-delà de 272 000 tokens d’entrée ?
Le tarif de contexte long s’applique à toute la requête. En Standard, comptez 16 USD par million en entrée hors cache, 0,80 USD en lecture, 20 USD pour une écriture de 30 minutes, 40 USD pour 12 heures et 60 USD en sortie.
Les tokens de raisonnement de GPT-6.2 Astra sont-ils facturés ?
Oui. Comptez à la fois la sortie visible et les tokens de raisonnement. Si le total de sortie renvoyé par l’API inclut déjà ces deux valeurs, utilisez ce total.
ChatGPT Plus donne-t-il accès à GPT-6.2 Astra ?
OpenAI a annoncé l’accès Standard dans ChatGPT Work et Codex pour Plus, Pro, Enterprise et Edu. Dans les espaces gérés éligibles, l’administrateur peut devoir l’activer. Work et Codex partagent le quota du forfait et suivent ses conditions de crédit.
GPT-6.2 Astra est-il plus cher que GPT-6.2 Sol ?
En contexte court Standard et à consommation égale, chaque tarif d’Astra est quatre fois celui de Sol. Comparez le coût par tâche validée, en tenant compte des nouvelles tentatives.
Quel mode API coûte le moins cher ?
Batch affiche des tarifs divisés par deux. Les requêtes éligibles en arrière-plan dans la Responses API bénéficient d’une remise de 30 % pour une fenêtre de deux heures ou de 40 % pour huit heures. Vérifiez la disponibilité de ces modes et votre échéance.