
GPT-6.2 Astra 标准 API 每百万普通输入 token 8 美元,缓存读取 0.40 美元,输出 40 美元。 这组价格适用于输入不超过 27.2 万 token 的请求。缓存写入另按计费分类,保留 30 分钟每百万 token 10 美元,保留 12 小时每百万 20 美元。OpenAI 于 2026 年 11 月 17 日发布 gpt-6.2-astra,下文费率核对于 11 月 19 日。 OpenAI API 定价 · 发布公告
预算先看 27.2 万输入 token。 超过这个数以后,整次请求使用长上下文费率。假设输出固定为 3,000 token,输入全未缓存,输入从 27.2 万增至 27.3 万,单次费用就从 2.296 美元增至 4.548 美元。多轮任务应取几次后期请求的用量做预算。 OpenAI 模型文档
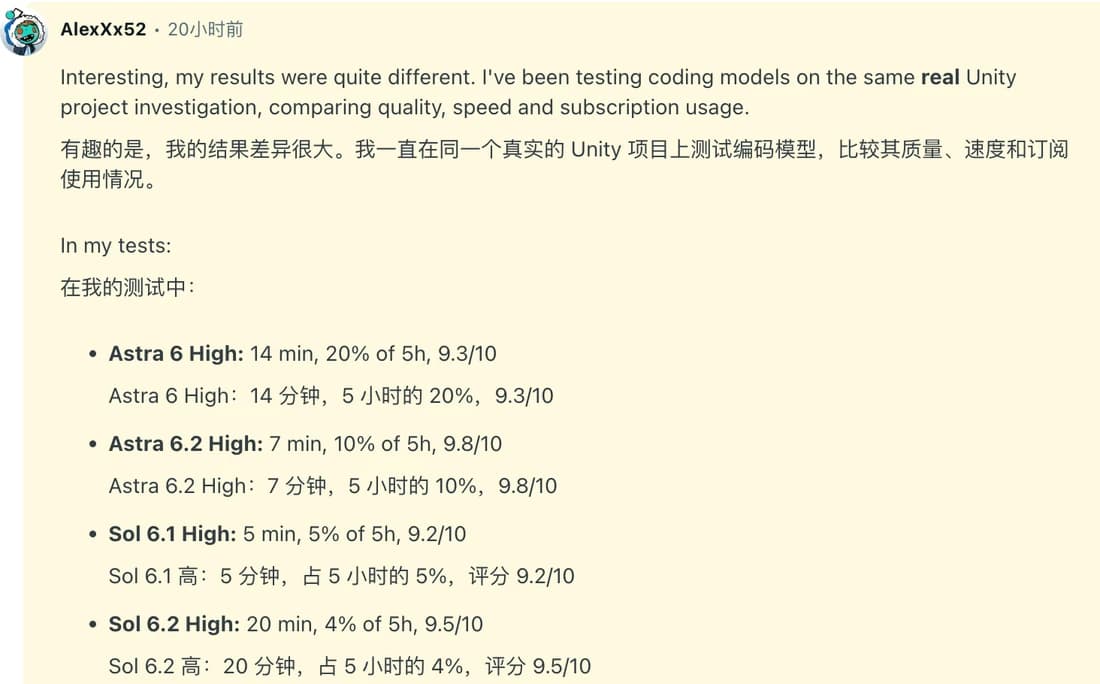
一位 r/codex 用户记录了 Pro 200 用量,但仍不确定 Codex 和 ChatGPT 如何共同消耗套餐额度。对比两种用法时,把套餐用量与 API 预算分开记。 原帖
关键结论
短上下文标准档的输入、输出比 GPT-6 Astra 便宜 20%,缓存读取便宜 60%。
长上下文的普通输入和缓存费率翻倍,输出费率提高 50%。模型允许最多 92.2 万输入 token。
Batch 是标准档的一半,Fast 是两倍。Ultrafast 于 2027 年 3 月 1 日(太平洋时间)由三倍涨至六倍。
短上下文标准档下,GPT-6.2 Sol 的每项 token 费率是 Astra 的四分之一。用同一套标准比较验收通过的任务,并计入重试。
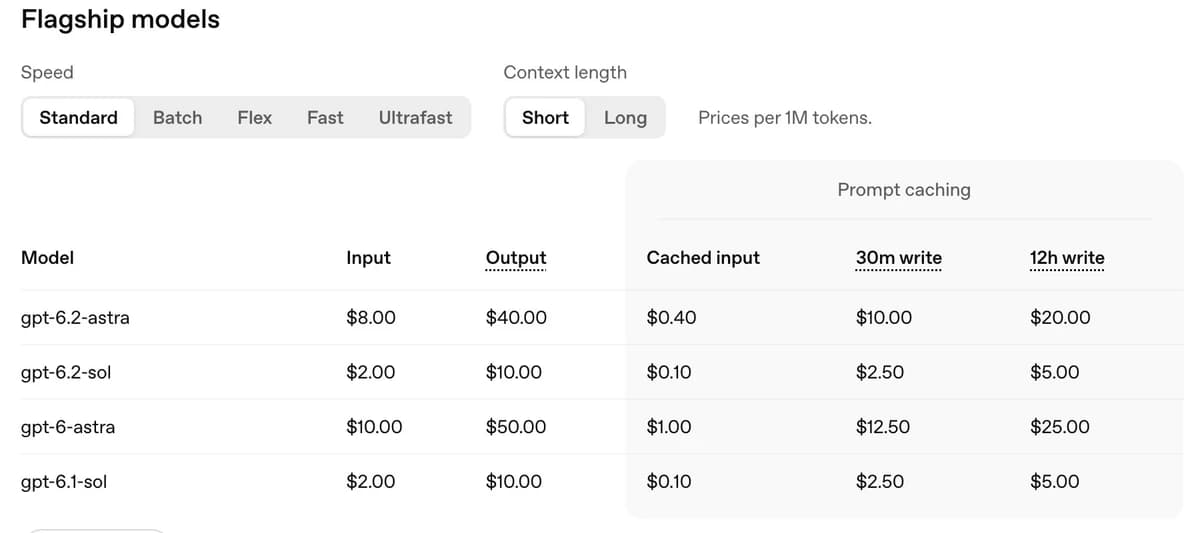
GPT-6.2 Astra API 费率表
| OpenAI API 每百万 token(美元) | 普通输入 | 缓存读取 | 写入 30 分钟 | 写入 12 小时 | 输出 |
|---|---|---|---|---|---|
| Standard,输入 ≤27.2 万 | $8 | $0.40 | $10 | $20 | $40 |
| Standard,输入 >27.2 万 | $16 | $0.80 | $20 | $40 | $60 |
| Batch,短上下文 | $4 | $0.20 | $5 | $10 | $20 |
| Fast,短上下文 | $16 | $0.80 | $20 | $40 | $80 |
| Ultrafast,短上下文(至 2027 年 2 月 28 日) | $24 | $1.20 | $30 | $60 | $120 |
| Ultrafast,短上下文(2027 年 3 月 1 日起) | $48 | $2.40 | $60 | $120 | $240 |
适用的 Responses API 后台任务可选两小时或八小时完成窗口,费率分别比标准档低 30% 和 40%。OpenAI 的 Flex 表列出 GPT-6 Astra,当前未列 GPT-6.2 Astra。数据驻留与 FedRAMP 端点适用 10% 加价,实际费率以所用端点为准。 OpenAI API 定价
输入超过 27.2 万 token 时会怎样
用普通输入、缓存读取和两类缓存写入的总数判断费率。输入 30 万、其中 25 万命中缓存,依然进入长上下文档。模型上下文窗口为 105 万 token,单次最多输入 92.2 万、输出 12.8 万。容量和计费门槛各有用途。 GPT-6.2 Astra 模型资料 · 官方规格
多轮对话的历史消息和工具返回内容会累积。先筛掉无关段落,再估算典型任务的后期输入量。如果任务需要跨文档对照证据,先小范围验证分段方案。多跑一遍来恢复上下文,也要计入成本。 减少浏览器 Agent 的 token 用量
对比 GPT-6.2 Sol 和上一代 Astra
| OpenAI API 每百万 token(美元) | 普通输入 | 缓存读取 | 写入 30 分钟 | 写入 12 小时 | 输出 |
|---|---|---|---|---|---|
| GPT-6.2 Astra | $8 | $0.40 | $10 | $20 | $40 |
| GPT-6.2 Sol | $2 | $0.10 | $2.50 | $5 | $10 |
| GPT-6 Astra | $10 | $1 | $12.50 | $25 | $50 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $5 | $10 |
在 OpenAI 公布的 Agents’ Last Exam 上,GPT-6.2 Astra 比 GPT-6 Astra 高 5.2 分,估算 API 成本不到三分之一。这个数来自发布评测。自己的工作流应统一任务和验收条件,记录服务档、token 数和尝试次数,用总费用除以验收通过数。 本代评测汇总 · 上一代 Astra 评测 · OpenAI 发布评测
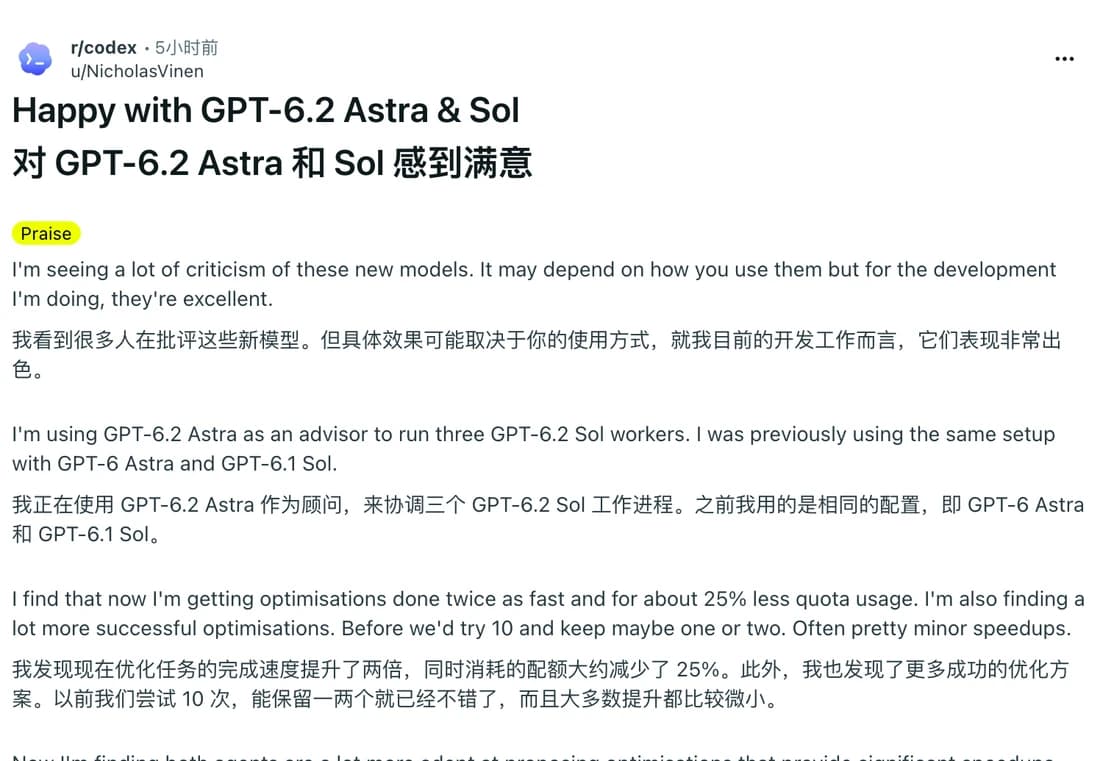
NicholasVinen 把 Astra 作为顾问,调度三个 Sol 执行代码性能优化,称新版组合比旧版更省订阅额度。部署到 API 时,顾问和三个执行者的用量都要记账。 原帖
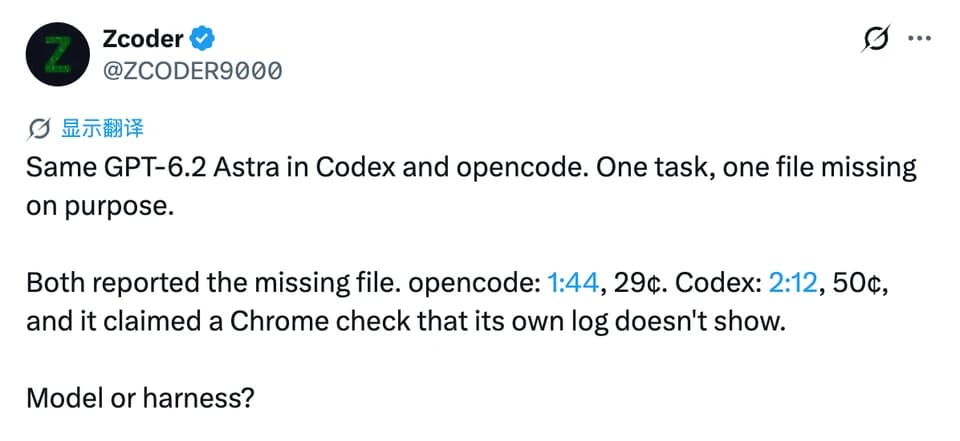
Zcoder 故意留空一个文件,让 Codex 和 OpenCode 用同一个 Astra 模型执行任务。两者都发现了缺失文件,耗时和费用却不同。估算时记录调用模型的客户端和整次流程。 查看 X 原帖
两个费用算例
输入量接近计费门槛
27.2 万普通输入加 3,000 输出,按标准档计算为 (272,000 × 8 + 3,000 × 40) / 1,000,000 = 2.296 美元。输入改为 27.3 万,输出量相同,费用为 (273,000 × 16 + 3,000 × 60) / 1,000,000 = 4.548 美元。100 次分别是 229.60 和 454.80 美元。
如果可见回答有 1,000 token,推理用了 2,000 个,计费输出就是 3,000 个。Astra 不接受 reasoning.effort: none。从能通过验收的推理档开始,每多 1,000 输出 token,短上下文多付 0.04 美元,长上下文多付 0.06 美元。 推理文档
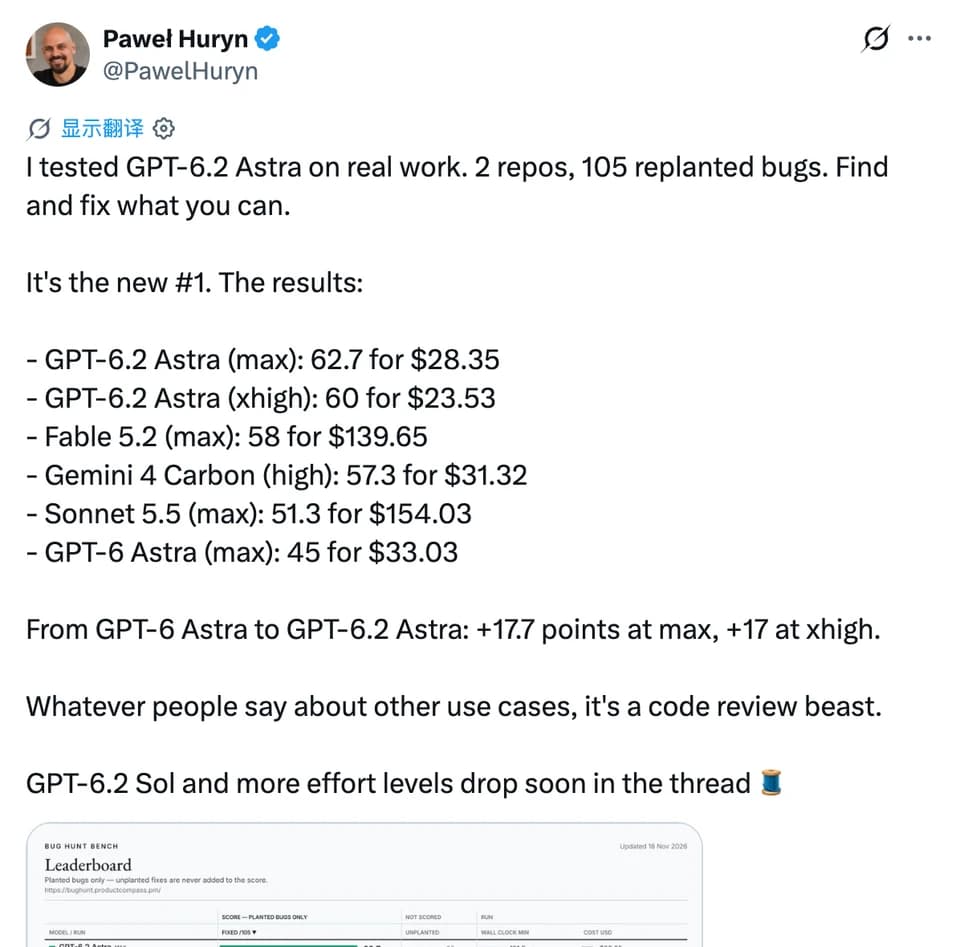
Paweł Huryn 在两个代码仓库做审阅测试,报告 max 档花费 28.35 美元,xhigh 档花费 23.53 美元,max 得分更高。这些是他的测试结果。用自己的验收条件判断高推理档是否值得。 查看 X 原帖
重复审阅文档并写入缓存
一次请求有 18 万输入,其中 15 万为缓存读取,1 万写入 30 分钟缓存,另有 2 万普通输入。再加 3,000 输出 token,共 0.44 美元,分别为读取 0.06、写入 0.10、普通输入 0.16、输出 0.12 美元。1,000 次为 440 美元。若同样的写入改用 12 小时保留,单次则为 0.54 美元。
从总输入中扣除缓存读取和两类写入,得到普通输入数。保持共享前缀一致,把每次变化的内容放在末尾。抽样时包含首次请求和长时间停顿后的请求,才能看到写入成本。 Astra 提示词与配置 · 缓存文档
本地计算器
估算 GPT-6.2 Astra API 费用
按标准档美元费率计算。填写单次用量,计算在浏览器内完成。
输出请计入推理 token。本估算不含缓存写入、工具、重试、税费和订阅。 OpenAI API 定价
计算器覆盖标准档普通输入、缓存读取和计费输出。写入费用可按表补算。月度请求有长有短时,按相近长度分组后计价,再加总。平均输入量可能掩盖跨档请求。
缓存、工具和订阅怎么记账
缓存读取按读取费率结算,同一 token 无须再付一次普通输入费。读取可刷新短期缓存的有效期,无须新写入。已有 30 分钟缓存需要升级为 12 小时缓存时,可能产生新的写入费。工具有独立费率,返回给模型的内容也可能产生输入 token。税费、第三方报价和实际重试次数需要单独核算。 缓存规则 · 工具定价
OpenAI 宣布向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise、Edu 用户开放 Astra。两款客户端共享套餐额度。Pro 500 和符合条件的托管工作区可用 Astra Ultrafast,Pro 200 的 Ultrafast 先从 Sol 开放。选购套餐时查看自己账号的用量和积分条款。 Work 和 Codex 说明 · 发布公告
在 Tabbit 中使用 GPT-6.2 Astra
选一份有可核对答案的文档,在 Tabbit Browser 中选择 GPT-6.2 Astra。用 Chat with Page 问一个具体问题,请模型附上支持答案的原文,核对后再加入其他标签页。用 多模型资料整理方法 保存提示词和出处。在浏览器里先验证任务结果,API token 用量则以 OpenAI 接口返回的计费数据为准。
 Tabbit Browser
不同任务怎么选
| 任务 | 起点 | 需要验证 |
|---|---|---|
| 重复转换和提取 | GPT-6.2 Sol Standard | Astra 是否提高了足够多的验收通过率 |
| 复杂审阅与开发 | GPT-6.2 Astra Standard | 推理输出、重试、最大输入量 |
| 可延后任务 | Batch 或符合条件的后台任务 | 时限、接口和实际费率 |
| 对时延敏感的交互 | 先 Standard,再实测 Fast 或 Ultrafast | 节省的时间是否值得付费 |
只有难度需要时才把任务发给 Astra。比较工具密集型任务时,也可以用 GPT-6.1 Terra 定价 做参考。确定月预算前,把一个典型任务跑到后半程,记录最大一笔输入有没有越过 27.2 万 token。

常见问题
GPT-6.2 Astra API 多少钱?
输入不超过 27.2 万 token 时,标准档每百万普通输入 8 美元、缓存读取 0.40 美元、输出 40 美元。30 分钟和 12 小时的缓存写入费率分别为 10 和 20 美元。
超过 27.2 万输入 token 后怎么收费?
整次请求改按长上下文费率计费。标准档每百万普通输入 16 美元、缓存读取 0.80 美元、30 分钟写入 20 美元、12 小时写入 40 美元、输出 60 美元。
推理 token 计入 GPT-6.2 Astra 的输出费吗?
计入。估算时同时考虑可见回答和推理 token。如果 API 返回的输出总数已包含推理 token,就直接使用该总数。
ChatGPT Plus 能用 GPT-6.2 Astra 吗?
OpenAI 宣布向 ChatGPT Work 和 Codex 的 Plus、Pro、Enterprise 和 Edu 用户提供标准档访问。符合条件的托管工作区可能需要管理员开启。Work 与 Codex 共享对应套餐用量,额外积分按套餐规则计费。
GPT-6.2 Astra 比 GPT-6.2 Sol 贵多少?
在短上下文、标准档和相同 token 构成下,Astra 的各项费率是 Sol 的四倍。任务的输出长度、通过率和重试次数可能不同,选型时应比较每个验收通过任务的成本。
哪个 API 服务档最便宜?
Batch 的公开 token 费率是 Standard 的一半。符合条件的 Responses API 后台任务选两小时窗口可省 30%,选八小时窗口可省 40%。根据任务的交付时限和接口支持情况选择。