
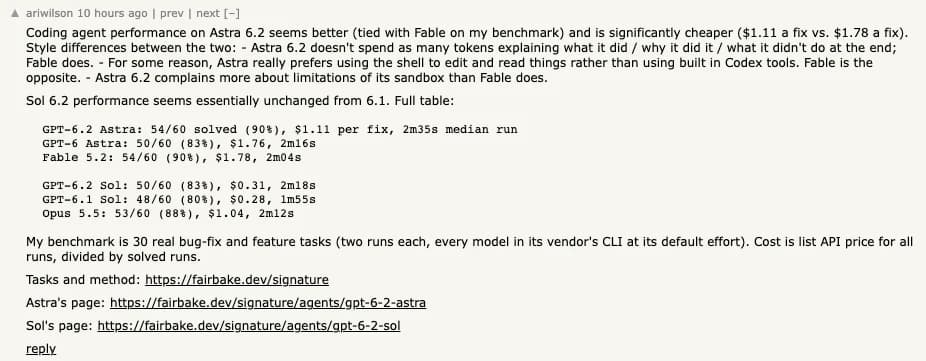
日常的なCodexの修正、資料がそろった文章作成、結果を検証できるAPI処理なら、まずGPT-6.2 Solを試す価値があります。未知のリポジトリやデータから手がかりを発見する仕事では、6.1 Solも比較に残してください。Hacker Newsのariwilsonは、30件の修正や機能追加で両方を比較しました。新版の成功は2回多く、所要時間の中央値は長くなりました。比較の原文
2026年11月17日、Plotlyの43問にかかった費用はGPT-6.2 Solが1.22ドル、GPT-6.1 Solが2.61ドルでした。新版は40問、旧版は43問すべてに正解しました。新版の誤答は、いずれも隠れたパターンを探す問題です。例外が結論を左右する仕事では、見落とした場合の確認時間も見積もります。Plotlyの報告
資料が複数のタブにある場合は、Tabbit BrowserでまとめてGPT-6.2 Solを使えます。以下の例では、比較するモデルに同じ資料を渡します。
要点
合格条件が決まっている仕事はMediumから試します。
Plotlyの1問当たりの中央値は17.6秒から10.5秒に短縮しました。隠れたパターンは旧版が5問、新版が2問に正解しました。
Standard APIの単価は6.1 Solと同じです。実際の費用には使用量、再試行、手直しが影響します。
Artificial AnalysisのCodex評価では、Maxのコーディングエージェント指数が3ポイント低下しました。主な差はリポジトリに関する質疑応答です。
再試行や人手での確認に時間がかかる場合は、同じ判定基準でAstraも試します。
GPT-6.2 Solを使える場所
APIのモデルIDは gpt-6.2-sol です。テキストと画像を受け取り、テキストを返します。コンテキストは1,050,000トークンで、入力上限が922,000、出力上限が128,000です。推論設定の none は受け付けません。Solのモデル資料 (English)と設定例 (English)も参照できます。API仕様
| 利用先 | 始め方 | 確認事項 |
|---|---|---|
| ChatGPT Work | 対象プランでWorkを開いてSolを選ぶ | EnterpriseとEduは管理者による有効化が必要 |
| Codex | モデル選択画面か /model を使う | Workと利用枠を共有。Ultrafastには別の利用条件がある |
| OpenAI API | gpt-6.2-sol を指定 | Standardは100万トークン当たり入力2ドル、キャッシュ済み入力0.10ドル、出力10ドル |
| Tabbit Browser | タブやファイルの資料を使う作業でGPT-6.2 Solを選ぶ | 回答と一緒に資料の抜粋とリンクを保存する |
推論設定とサービスの速度は別々に記録します。OpenAIはPlus、Pro、Business、Enterprise、EduでのWork提供を案内しており、管理対象のワークスペースには設定条件があります。WorkとCodexの案内
実際のタスクでわかったこと
Codexで同じ資料を使って3問を確認
編集チームはCodex CLIで gpt-6.2-sol をMediumにして1回試しました。API料金、Plotlyの結果、WorkとCodexの設定をまとめ、3問に出典付きで答えるよう指定しました。
入力40,000トークンのうち10,000はキャッシュ済みで、課金対象の出力は4,000。書き込みとツールを除くと0.060 + 0.001 + 0.040 = 0.101ドルです。Solは内訳と合計を正しく出し、旧版の発見が3件多いことと、p95レイテンシが未掲載であることを指摘しました。HighとUltrafastも区別し、3つの回答すべてに資料のラベルを付けました。数字は入力に含めています。資料を探す能力はSolの評価資料 (English)などを使い、別の条件で確かめます。
Plotlyではモデルが手がかりを探した
PlotlyはStudio Embeddedで各モデルを1回ずつ実行しました。新版は隠れたパターンを除く38問すべてに正解しました。ツール呼び出しは258回から158回、出力は約70,000から45,000トークンに減りました。パターンを見つける5問ではクエリが1問当たり約16回から約9回に減りました。Plotlyは他のモデルの再実行で最大3問の差を観測しています。今回どこで失敗したかを手がかりに、自分の仕事で同じ種類のケースを試してください。テスト方法と結果
ベンチマークをどう読むか
| 評価 | GPT-6.2 Sol | 比較 | 評価の範囲 |
|---|---|---|---|
| Plotlyの全問題 | 40/43、1.22ドル | 6.1 Solは43/43、2.61ドル | 各モデル1回 |
| Plotlyの隠れたパターン | 2/5 | 6.1 Solは5/5 | 同じ試験内の5問 |
| OpenAIが引用したFrontierCode 2.0 | Astraとの差は0.5ポイント以内 | Astraの約5分の1の費用 | 両方Max。リポジトリごとの基準で採点 |
| Artificial Analysisのコーディング指数 | 3ポイント低下 | GPT-6.1 SolのMax | 両方Codex。主にリポジトリの質疑応答で差 |
FrontierCodeでは必須条件を満たせなければ0点です。Artificial AnalysisではSWE-Atlas-QnA-AAが14ポイント下がり、重要な事実の抜けが報告されました。1ファイルの修正を通すテストと、呼び出し元をすべて調べる確認は別です。Cognitionの方法 · OpenAIの発表 · Artificial Analysisの結果
Solから試しやすい3つの仕事
テストで確認できる修正やレビュー
失敗を再現するテスト、または小さな差分を渡します。レビューではファイル、再現条件、利用者への影響を求めます。ブラウザーを使う場合、初期状態と確認手順をそろえます。Codexのブラウザーガイド
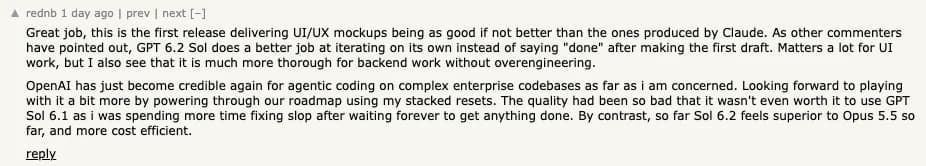
rednbは、SolがUIの初稿を出して終える前に、さらに修正を重ねたと報告しています。自分の画面で操作を検証するときの着眼点になります。元のコメント
入力が決まった定期分析
列と抽出期間、出力形式が安定した報告書は、効率差を調べやすい例です。行数、日付、単位、主要な数値の出典を確認してください。再試行と人手による修正も合格結果当たりの費用に含めます。
手元の資料を基にした文章
リリースノートや短い要約から始めます。名前、数値、リンクをそのまま使い、資料にない情報を明示するよう指定します。変わるページは、取得日と抜粋を検証可能な資料の収集手順に沿って残します。
追加の確認が必要なケース
例外を見つけることが目的のとき
途中で単位が変わる値や、2か所で別々に設定された項目をテストに入れます。例外と根拠の両方を確認し、6.1 Solが安定していれば比較に残します。GPT-6 Solレビューが扱うのは以前の版です。
呼び出し元が1つ抜けると結論が変わるとき
共有関数を使う箇所と、引数の既定値を変える箇所を挙げさせ、実際のコードと照合します。推論設定を上げて再現する漏れが減るかを確かめます。複数サービスの調査ではAstraも試します。
見た目が整った試作でも動作を確認するとき
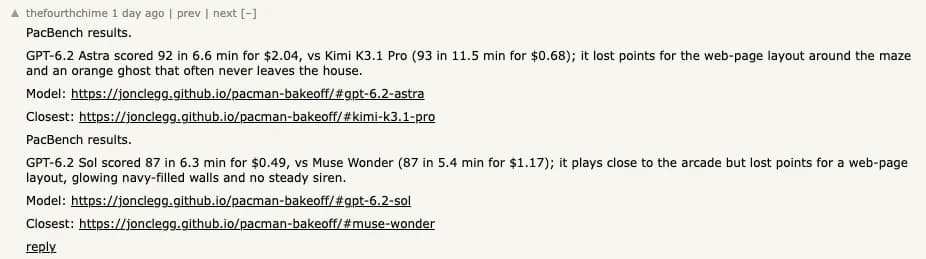
対象サイズで開き、各操作とアニメーション、音を確認します。thefourthchimeは生成した試作でレイアウトと音の問題を報告しました。元のコメント
別の描画テストでprmoustacheは、Highでも自転車の同じ側に両脚が描かれたと報告しています。元のコメント

Tabbitで比較資料をそろえる
編集チームはTabbit Browserで公開ページを読み、APIの3つの料金、Plotlyの正答数と費用、10.5秒の中央値、Ultrafastの利用条件を照合しました。API料金 · Plotlyの報告 · Workの案内

Tabbitのエージェント連携でページを集め、複数モデルでの調査手順に沿って数値とURLを保存します。比較する各モデルに同じ資料を渡し、検索力は同じ出発ページと権限で別に評価します。今回、資料の確認はTabbitDance、試行はCodexで行いました。同じ資料をTabbit内のGPT-6.2 Solに渡して実行することもできます。
仕事ごとに選ぶ
| 仕事 | 最初に試す設定 | 切り替える条件 |
|---|---|---|
| 小さな修正、PR、定型の報告 | GPT-6.2 SolのMedium | 漏れや修正が増えたら現在の設定と比較 |
| 手がかり、呼び出し元、例外の発見 | 6.1 Solと6.2 Solを同じ問題で比較 | 重要な例外の発見数と確認時間で判断 |
| 複数サービスの調査 | AstraとSolを比較 | 難しい案件がより多く合格するかを確認 |
| 大量のAPI処理 | 代表的な依頼で6.2 Solを試す | 総時間、課金額、再試行、合格結果当たりの費用で判断 |
日常の1件、既知の例外を含む1件、難しい1件で試します。同じ水準で合格し、費用か確認時間が減った仕事から移行してください。以前の上位モデルはGPT-6 Astraレビューで確認できます。資料が複数のタブにあるなら、Tabbitで入力をそろえて比較します。
 Tabbit Browser

よくある質問
GPT-6.2 SolはGPT-6.1 Solより優れていますか?
結果を確認しやすい日常業務では、まず6.2 Solを試してください。Plotlyの試験では費用が半分以下でしたが、隠れたパターンを見つけたのは5問中2問で、6.1 Solは5問とも正解でした。移行前に難しい案件でも両方を比べてください。
GPT-6.2 SolはCodexでのコーディングに向いていますか?
範囲が狭い修正やPRレビュー、信頼できるテストがある変更で試しやすいモデルです。複数ファイルの動作を追う質問では現在のモデルと比較してください。Artificial Analysisは両モデルをCodexのMaxで評価し、6.2 Solのリポジトリに関する質疑応答で低下を確認しました。
GPT-6.2 Solの料金はいくらですか?
Standard APIは100万トークンにつき入力2ドル、キャッシュ済み入力0.10ドル、出力10ドルです。キャッシュへの書き込みや一部のツールには別料金がかかります。WorkとCodexは契約の利用枠を共有します。
通常のChatGPTのチャットでGPT-6.2 Solは使えますか?
OpenAIは2026年11月17日にChatGPT Work、Codex、APIで提供を開始しました。ChatGPTではWorkを開きます。EnterpriseとEduでは管理者による有効化が必要です。
GPT-6.2 SolとGPT-6.2 Astraはどう選びますか?
確認が容易な仕事はSolから始めます。複数のサービスをまたぐ調査や、手戻りの大きな仕事ではAstraを試してください。同じ判定基準で合格件数と総費用を比べます。
GPT-6.2 Solの推論設定は何にすべきですか?
範囲が明確ならMediumから始め、再現する失敗をHighで試します。Maxは重要なケースに測定できる改善がある場合に使います。Ultrafastは速度の設定で、利用条件が別にあります。