
O GPT-6 Astra é inegavelmente uma conquista técnica de peso. Nas avaliações de referência divulgadas pela OpenAI em 3 de setembro de 2026, ele reduziu o tempo de execução no benchmark de tarefas de desktop OSWorld 2.0 de 75 para 40 minutos — uma aceleração de 47% — elevando a taxa de sucesso para 72,6%. Em testes conduzidos por desenvolvedores independentes, ele provou ter uma resiliência exemplar ao concluir a implementação de um cliente de API em Python no Codex em 33 minutos superando 13 ciclos consecutivos de autocorreção sem falhas, ao mesmo tempo em que encontrou de 3 a 5 vezes mais fontes web em pesquisas exploratórias aprofundadas. Se o seu maior gargalo for o tempo gasto por humanos monitorando fluxos longos de agentes autônomos, o Astra entrega capacidade autêntica.
Contudo, os motivos para avaliar alternativas decorrem de contas simples de engenharia. A OpenAI estabeleceu as tarifas padrão de API do Astra em US$ 10,00 por milhão de tokens de entrada e US$ 50,00 por milhão de tokens de saída: exatamente 2,5 vezes o custo do GPT-5.6 Sol (US$ 4,00 / US$ 20,00). Para piorar, se uma única requisição ultrapassar 272.000 tokens de entrada, uma sobretaxa expressiva é aplicada a toda a chamada. Paralelamente, dados independentes da Artificial Analysis mostram que o índice geral de inteligência do Astra avançou apenas 0,3 ponto em relação ao Sol (61,2 contra 60,9), e sua marca alardeada de 99,9% no ARC-AGI-3 dependia de adaptadores proprietários que despencaram para 62,7% sob ambientes de teste públicos comuns.
Esse contraste define a decisão de migração: pagar um sobrepreço de 150% na fatura de API para obter um ganho de 0,5% no raciocínio geral é financeiramente irracional se o seu fluxo de trabalho não exigir 40 minutos de teimosia autônoma. Para pipelines de alto volume, codificação interativa ágil, análise multimodal massiva e tarefas cotidianas com supervisão humana, há modelos que entregam resultados equivalentes ou superiores por uma fração do preço. O artigo de visão geral do GPT-6 Astra cobre as especificações técnicas e nossa avaliação detalhada do GPT-6 Astra disseca os limites dos benchmarks sintéticos; este guia oferece o roteiro prático para escolher a sua alternativa ideal.
Principais conclusões
O GPT-5.6 Sol é a alternativa de transição mais natural: Mantém 99,5% do raciocínio geral do Astra (60,9 contra 61,2) com um desconto de 60% (US$ 4/US$ 20 contra US$ 10/US$ 50 por milhão de tokens) e latência inicial muito mais baixa.
Claude Fable 5.1 e Sonnet 5 lideram na arquitetura de código: O cache de prompts da Anthropic corta os custos de entradas repetidas em 75%, oferecendo um senso estético superior na refatoração de código sem os avisos burocráticos constantes do Astra.
O Gemini 3.8 Flash é o campeão de eficiência em multimídia massiva: Custando US$ 0,75 na entrada e US$ 3,75 na saída, ele processa grandes volumes de áudio, vídeo e arquivos PDF com mais de 85% de economia em relação ao Astra.
O DeepSeek V4.1 Flash viabiliza lotes com orçamento mínimo fora do pico: As leituras de cache caem para US$ 0,003 por milhão de tokens em horários de menor demanda, tornando-se imbatível para rotinas de fundo programadas.
O Tabbit Browser Agent elimina a complexidade da camada de execução: Se a sua maior dor for orquestrar navegadores headless, mapear árvores DOM e gerenciar chaves de API, executar modelos diretamente no Tabbit Browser dispensa qualquer código intermediário.
Quatro critérios para avaliar alternativas
Custo real por tarefa concluída, e não tabelas de preços nominais: Um modelo com tarifas baixas que gera 4.000 tokens de prolixidade ou exige três tentativas manuais custa mais caro do que um modelo enxuto. O custo real inclui tokens de raciocínio, eficiência de cache, penalidades acima de 272K e horas de intervenção humana.
Latência tolerável na interação com humanos no circuito: Quando um desenvolvedor espera por uma resposta interativa, o tempo até o primeiro token (TTFT) e a estabilidade da geração são mais importantes que o rendimento máximo em segundo plano.
Compatibilidade com contexto longo, ferramentas e multimodalidade: A troca de modelo não pode custar a perda de chamadas de função nativas, inspeção de documentos ou de uma janela de contexto de 1 milhão de tokens.
Evidência empírica coletada em produção real: Damos prioridade a registros reais de incidentes, limites de concorrência e relatos de engenheiros no Hacker News e Reddit em vez de anúncios institucionais.
Cinco alternativas em resumo
| Modelo candidato | Ideal para | Rota oficial | Preço checado (22-09-2026) | Contexto / Saída máx. | Principal contrapartida (The main catch) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | Substituto direto e econômico no mesmo ecossistema | gpt-5.6-sol | US$ 4,00 entrada / US$ 20,00 saída (por 1M) | 1.050.000 / 128.000 | Menos persistente em loops autônomos de desktop com mais de 10 passos |
| Claude Fable 5.1 / Sonnet 5 | Arquitetura de software e refatoração precisa de código | claude-fable-5-1 / claude-sonnet-5 | US$ 2,00–US$ 3,00 entrada / US$ 10,00–US$ 15,00 saída | 1.000.000 / 128.000 | Limites rigorosos de concorrência e alto custo no modo de raciocínio profundo |
| Gemini 3.8 Flash | Extração massiva de dados multimodais e alto rendimento | gemini-3-8-flash | US$ 0,75 entrada / US$ 3,75 saída (por 1M) | 1.048.576 / 65.536 | Maior tempo até o primeiro token em níveis altos de pensamento |
| DeepSeek V4.1 Flash | Processamento em lote econômico fora do horário de pico | deepseek-flash | Fora de pico: US$ 0,15 entrada / US$ 0,60 saída | 1.000.000 / 384.000 | Tarifa majorada em horários de pico e ausência de agente visual de desktop |
| Tabbit Browser Agent | Execução de tarefas na web sem código de integração | Ambiente integrado de desktop | Seletor multimodelo integrado | DOM das abas ativas + Arquivos locais | Focado em produtividade no desktop, não como endpoint de servidor |
Observações de preços: Valores padrão de API verificados em 22 de setembro de 2026. Tokens de raciocínio são cobrados como saída. O cache de prompts reduz a tarifa de entrada em 75% a 90%.
GPT-5.6 Sol
Ideal para: Equipes que desejam migrar do Astra sem alterar o código existente, mantendo o SDK da OpenAI e reduzindo os gastos de API em 60%.
Pontos fortes: O GPT-5.6 Sol tem a mesma janela de 1.050.000 tokens, esquemas idênticos de chamada de ferramentas e suporte a JSON estruturado. No índice da Artificial Analysis, o Sol registrou 60,9 pontos contra 61,2 do Astra, preservando 99,5% do raciocínio geral. Na prática diária, ele inicia a resposta muito mais rápido, sem as pausas prolongadas do Astra em modos avançados de reflexão. Como destacou o desenvolvedor handzhiev no Hacker News, o Sol se comporta como um "cavalo de batalha confiável" que se mostra "mais do que suficiente para a imensa maioria dos trabalhos" sem cobrar taxas exorbitantes.
Pontos fracos: O Sol precisou de cerca de 75 minutos na simulação do OSWorld 2.0, contra 40 minutos do Astra. Em tarefas de agentes que demandam mais de dez ciclos contínuos de correção automática, ele apresenta maior tendência a desvios. Para um exame detalhado sobre sua capacidade de memória, veja nossa análise sobre o contexto de 1M no GPT-5.6 Sol.
Preço de referência: US$ 4,00 por milhão de tokens de entrada, US$ 0,50 para acertos de cache e US$ 20,00 por milhão de tokens de saída, sem acréscimos na faixa de 272K.
Veredito: Adote o GPT-5.6 Sol se suas tarefas no Astra não exigirem navegação complexa em interfaces gráficas de computador ou dezenas de etapas de depuração automatizada. É a opção padrão mais inteligente para 80% das aplicações de produção.
Claude Fable 5.1 e Sonnet 5
Ideal para: Desenvolvedores full-stack, arquitetos de sistemas e equipes que exigem código de fácil manutenção, elegância de design e conformidade precisa com instruções.
Pontos fortes: Os modelos da Anthropic se destacam pelo rigor estilístico e pela clareza modular. Enquanto o Astra pode se tornar desnecessariamente longo, o Claude realiza intervenções pontuais sem comprometer a estrutura ao redor. O engenheiro Skiffssh observou no Hacker News que, apesar dos avanços do Astra em modelagem 3D, ele "continuará utilizando o Claude por um bom tempo" em função da sua solidez técnica. Além disso, o cache de prompts concede 75% de abatimento em entradas repetidas, barateando muito sessões longas de desenvolvimento.
Pontos fracos: A Anthropic estabelece limites organizacionais de concorrência apertados, o que pode restringir processos paralelos de larga escala. O raciocínio adaptativo pode elevar substancialmente os tokens de saída faturáveis e os filtros de segurança rejeitam categoricamente tarefas associadas a engenharia reversa.
Preço de referência: Entre US$ 2,00–US$ 3,00 na entrada e US$ 10,00–US$ 15,00 na saída por milhão de tokens, com leituras de cache a US$ 0,20–US$ 0,30.
Veredito: Escolha o Claude Fable 5.1 ou Sonnet 5 se o seu motivo para deixar o Astra for qualidade de código, precisão arquitetônica ou redução de custos com cache em contextos longos.
Gemini 3.8 Flash
Ideal para: Extração em massa de dados, análise de grandes acervos documentais e ingestão de horas de áudio, vídeo e relatórios extensos em PDF.
Pontos fortes: O Gemini 3.8 Flash alia uma janela de 1.048.576 tokens a um suporte nativo e eficiente para texto, imagem, áudio e vídeo. Sua tarifa de US$ 0,75 de entrada e US$ 3,75 de saída é mais de 85% menor que a do Astra, gerando tokens com velocidade impressionante. Como mostram nossa análise de preços do Gemini 3.8 Flash e a revisão detalhada do Gemini 3.8 Flash, ele oferece uma vantagem econômica indiscutível no tratamento de dados não estruturados.
Pontos fracos: Quando configurado em modo de pensamento elevado, a latência para o primeiro token aumenta de forma sensível. Em tarefas lógicas muito complexas, o texto pode divagar se não houver um esquema de resposta rigoroso.
Preço de referência: US$ 0,75 por milhão de tokens de entrada e US$ 3,75 por milhão de saída para chamadas de até 128K (US$ 1,50 / US$ 7,50 para janelas maiores).
Veredito: Migre imediatamente para o Gemini 3.8 Flash se os custos do Astra estiverem inviabilizando seus processos de leitura de arquivos e multimídia, mantendo o Astra apenas para tarefas que requeiram execução interativa no terminal.
DeepSeek V4.1 Flash
Ideal para: Processamento em lote de baixo orçamento, limpeza de dados e rotinas que possam ser transferidas para horários de menor demanda.
Pontos fortes: O DeepSeek V4.1 Flash impõe um padrão agressivo de custo: fora do pico, o cache sai por US$ 0,003 por milhão de tokens, com entrada a US$ 0,15 e saída a US$ 0,60. Ele oferece 1M de contexto e teto de saída de 384K tokens, permitindo operar em modo direto ou com raciocínio ativado.
Pontos fracos: Os preços dobram nos horários de pico em dias úteis (01:00–04:00 e 06:00–10:00 UTC) para US$ 0,30 de entrada e US$ 1,20 de saída. Ele também não conta com agentes visuais de desktop para automação de janelas no formato do OSWorld.
Preço de referência: Fora do pico: US$ 0,15 entrada / US$ 0,60 saída; no pico: US$ 0,30 entrada / US$ 1,20 saída por milhão de tokens.
Veredito: Adote o DeepSeek V4.1 Flash quando o custo unitário por token for a principal métrica e você puder programar as tarefas fora dos horários de pico. Ele não substitui o Astra na automação de interfaces de desktop.
Tabbit Browser Agent
Ideal para: Analistas, profissionais e desenvolvedores que precisam delegar tarefas a agentes em aplicações web e múltiplas abas sem programar conectores e scrapers.
Pontos fortes: Com frequência, a insatisfação com o GPT-6 Astra não tem relação com os pesos do modelo, mas com o desgaste de manter a infraestrutura de automação: configurar Playwright, ler o DOM e gerenciar falhas de rede exige dias de trabalho. O navegador Tabbit traz agentes multimodelo diretamente para o espaço de navegação. É possível realizar pesquisas complexas e cruzar dados entre abas por meio de um seletor que encaminha a tarefa ao motor mais apropriado.
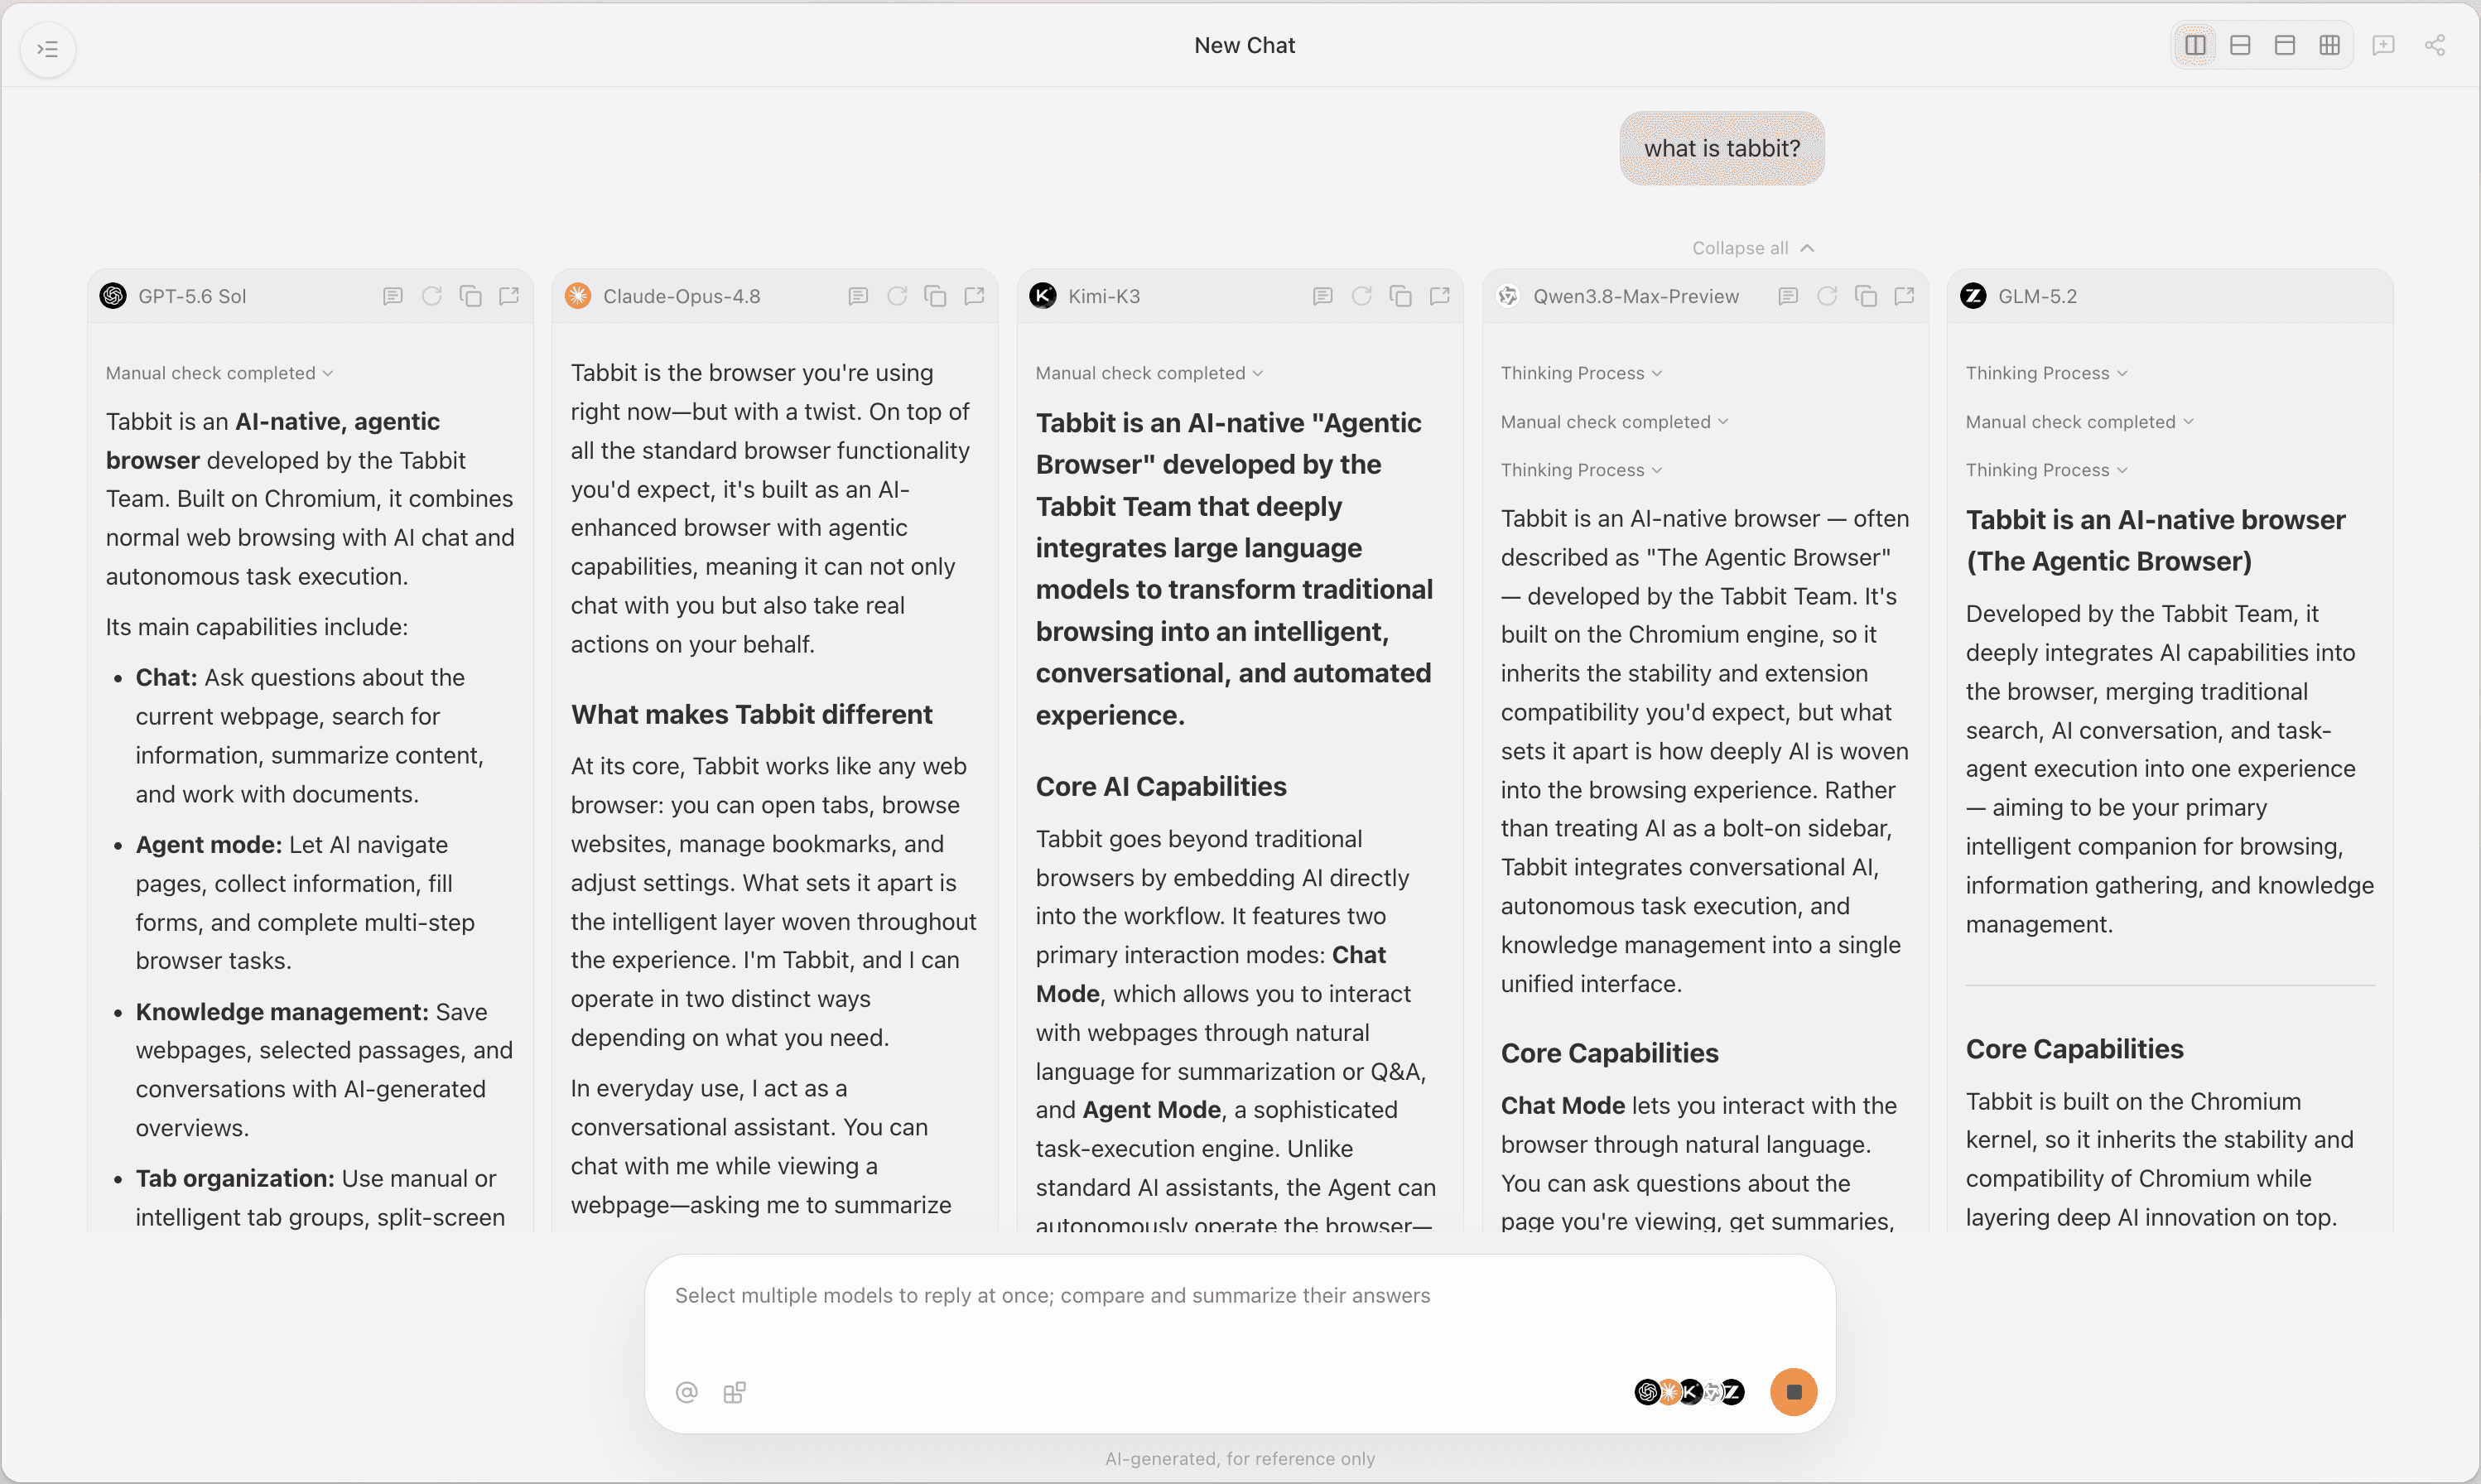
Pontos fracos: O Tabbit foi desenvolvido para a produtividade interativa no computador de trabalho e não como um servidor de API para responder a milhões de requisições de fundo.
Preço de referência: Gratuito para download e avaliação no macOS e Windows, com ampla flexibilidade para utilização de modelos integrados.
Veredito: Utilize o navegador Tabbit se você consome a cara API do Astra somente para ler páginas web, resumir documentos ou operar fluxos no navegador. Compreender o que é um navegador com agentes e analisar o mercado de navegadores com IA baseados em agentes demonstra que uma boa camada de execução supera com frequência a troca de modelo. Saiba mais no nosso guia do navegador Tabbit AI e na seção sobre automação de navegadores.
 Tabbit Browser
Como escolher de acordo com a sua principal limitação técnica
Em vez de procurar um suposto modelo perfeito em tudo, diagnostique o principal ponto de atrito na sua rotina e escolha a alternativa indicada:
| Restrição principal | Modelo recomendado para teste | Critério de validação | Principal contrapartida |
|---|---|---|---|
| Orçamento de API e compatibilidade de SDK | GPT-5.6 Sol | Pipeline funciona com 60% de economia sem alterações de código | Taxa de conclusão ligeiramente menor em loops com mais de 10 passos |
| Qualidade do código e refatoração | Claude Fable 5.1 / Sonnet 5 | Menor necessidade de correções manuais e custos controlados com cache | Exige atenção aos limites de concorrência por organização |
| Volume de documentos e multimídia | Gemini 3.8 Flash | Economia superior a 85% no processamento de PDFs longos e vídeos | Espera inicial de resposta perceptível em modos de raciocínio alto |
| Processamento em lote super econômico | DeepSeek V4.1 Flash | Pipelines noturnos concluídos dentro das tarifas reduzidas fora do pico | Tarifas mais altas nos horários de pico e sem agentes de desktop |
| Cansaço de programar scripts e scrapers | Tabbit Browser Agent | Tarefas resolvidas diretamente nas abas ativas sem código intermediário | Destinado ao uso pessoal no desktop, não para APIs de servidores |
Roteiro para um teste comparativo prático
Antes de fazer uma migração estrutural completa, realize um teste prático e estruturado:
Defina duas tarefas representativas: Um problema de raciocínio de código delimitado (como refatorar um módulo complexo de API) e um trabalho de extração de dados (analisar um PDF financeiro de 50 páginas com tabelas).
Padronize o ambiente: Mantenha rigorosamente as mesmas instruções, definições de ferramentas, esquemas de saída e regras de nova tentativa em cada modelo.
Calcule o custo total real: Some o consumo de tokens de entrada, saída, raciocínio e o tempo de revisão despendido por desenvolvedores.
Meça o comportamento da latência: Execute cada tarefa pelo menos cinco vezes por modelo para registrar a variação da resposta inicial e o tempo total de conclusão.
Avalie o índice de autonomia: Verifique se o resultado foi aprovado de primeira sem interferência humana ou se exigiu correções manuais.
Conclusão
O GPT-6 Astra é uma ferramenta de engenharia projetada para cenários de alta complexidade. Se o seu projeto precisa que um agente opere um computador durante 40 minutos em um ambiente sem instrumentos ou escreva cálculos espaciais em 3D passando por diversas etapas de autocorreção, o preço de US$ 10 / US$ 50 faz sentido.
Entretanto, para a grande maioria das tarefas de desenvolvimento e rotinas empresariais, o Astra impõe uma sobretaxa de 2,5x desnecessária. O GPT-5.6 Sol entrega capacidade comparável por 40% do valor; o Claude se sobressai na clareza estrutural do código; o Gemini 3.8 Flash domina na eficiência multimodal; e o DeepSeek assegura o custo mais baixo para processos em lote. E se o seu objetivo central for realizar tarefas na web sem a dor de cabeça de manter scripts instáveis, trabalhar com agentes dentro do navegador Tabbit é a rota mais direta para alcançar alta produtividade.

Perguntas frequentes
Qual é a alternativa mais próxima dentro da mesma família ao GPT-6 Astra?
O GPT-5.6 Sol é a alternativa direta mais óbvia. Ele compartilha a mesma janela de contexto de 1.050.000 tokens e o protocolo de chamadas de ferramentas. No índice de inteligência independente da Artificial Analysis, alcançou 60,9 pontos (apenas 0,3 ponto abaixo do Astra), mas reduz os custos em 60% (US$ 4/US$ 20 contra US$ 10/US$ 50 por milhão de tokens) com uma resposta inicial bem mais ágil.
Por que buscar alternativas ao GPT-6 Astra se ele alcançou o recorde de 40 minutos no OSWorld?
A redução de 75 para 40 minutos no OSWorld 2.0 (um ganho de 47%) reflete resistência autônoma em loops de depuração prolongados, e não menor latência no uso cotidiano. Para perguntas e respostas, suporte a código ou bate-papos interativos, o Astra impõe esperas no primeiro token, inflação de tokens e uma sobretaxa de 2,5x sem benefícios perceptíveis para tarefas normais.
Qual modelo alternativo tem a tarifa oficial de API mais baixa?
O DeepSeek V4.1 Flash apresenta os preços mais baixos do mercado, com leituras de cache fora do horário de pico a partir de US$ 0,003 e tarifas base de entrada de US$ 0,15 e saída de US$ 0,60 por milhão de tokens. Entre os grandes provedores ocidentais, o Gemini 3.8 Flash lidera em economia a US$ 0,75/US$ 3,75. No entanto, o custo final real depende da verbosidade e dos tokens de raciocínio gerados.
Como o limite de 272K tokens de entrada afeta os custos reais?
Nas tarifas oficiais da OpenAI para o Astra, se uma chamada ultrapassar 272.000 tokens de entrada, a requisição inteira é faturada no patamar mais elevado, e não apenas o excedente. Isso gera um degrau de custo expressivo: uma requisição de 280K custa consideravelmente mais do que duas chamadas de 140K. Modelos como Sol, Gemini e Claude mantêm estruturas de preços mais lineares.
Os preços de token de API podem ser comparados diretamente com assinaturas mensais como ChatGPT ou Claude Pro?
Não. A API opera sob cobrança estrita por consumo com garantias de concorrência, enquanto as assinaturas individuais cobram taxa fixa mensal (US$ 20 a US$ 200) sujeita a limites dinâmicos de mensagens e filas de espera. Automações de produção e integrações sistêmicas devem ser calculadas com base na economia da API.
Como posso testar e comparar esses modelos alternativos dentro do navegador Tabbit?
O navegador Tabbit possui um seletor multimodelo integrado que permite alternar entre GPT-6 Astra, GPT-5.6 Sol, Claude, Gemini e DeepSeek em uma única interface de trabalho. Sem precisar escrever scripts de extração ou código de integração com MCP, você pode executar consultas paralelas aproveitando suas abas ativas e documentos locais para validar o desempenho prático.