
GPT-6 Astra 確實是一項令人印象深刻的工程成果。在 OpenAI 於 2026 年 9 月 3 日發布的官方測評中,它在桌面端模擬測試集 OSWorld 2.0 上的執行時間由 GPT-5.6 Sol 的 75 分鐘大幅縮短至 40 分鐘,速度提升約 47%,並將任務完成率推進至 72.6%。在獨立開發者的實測中,它成功跑通了歷時 33 分鐘、經歷 13 輪自動報錯與排錯重試的 Codex Python 客戶端構建,且在長程網路深度調研中發現了 3 至 5 倍的多源資訊。如果你的業務瓶頸在於需要人類長時間盯盤監護複雜的長程 Agent 循環,Astra 展現出了無可替代的自愈執行力。
然而,決定尋找替代方案的理由同樣來自嚴肅的工程帳本。OpenAI 將 Astra 的標準 API 費率定為每百萬輸入 Token $10.00、輸出 $50.00,整整是 GPT-5.6 Sol($4.00/$20.00)的 2.5 倍。更為苛刻的是,一旦單次請求輸入超過 272,000 Token,整筆調用將立即觸發高階溢價。與此同時,來自 Artificial Analysis 的中立品質評估顯示,Astra 的智力綜合指數僅從 Sol 的 60.9 微升至 61.2(增幅僅 0.3 分),而其 ARC-AGI-3 宣稱的 99.9% 驚人成績完全由專用 Adapter 驅動,在標準公開測試框架下驟降至 62.7%。
這就是核心選型權衡所在:如果你從事的工作不需要模型進行長達 40 分鐘的連續自主試錯,那麼為僅 0.5% 的通用智商增量多支付 150% 的帳單,本質上是在為「過剩的頑固性」繳納昂貴的稅費。對於大吞吐批次處理、敏捷互動式編碼、海量多模態文件解析以及日常辦公輔助,完全有更經濟、響應更迅速的替代路徑。讀者可在 GPT-6 Astra 總覽 中查驗規格參數,在 GPT-6 Astra 深度測評 中審視基準水分,而本文將提供清晰的替代選型路線圖。
核心結論
GPT-5.6 Sol 是最穩妥的同門降級選項: 保留了 Astra 99.5% 的通用推理水平(60.9 vs 61.2),成本立省 60%($4/$20 對比 $10/$50),且首 Token 響應明顯更敏捷。
Claude Fable 5.1 與 Sonnet 5 執掌複雜程式碼架構: 依靠最高 75% 的 Prompt 快取折扣,在長程式碼重構與邏輯嚴密性上維持出色的品味,且沒有 Astra 頻繁彈出的合規說教。
Gemini 3.8 Flash 是高吞吐多模態效率冠軍: 輸入僅 $0.75 / 輸出 $3.75,吞吐單價較 Astra 降低 85% 以上,原生支援長影片、音訊和超大 PDF 批次處理。
DeepSeek V4.1 Flash 釋放極致離峰批次處理算力: 離峰快取命中低至 $0.003 / 基礎輸入 $0.15,是構建定時後台任務、成本高度敏感型工作流程的首選。
Tabbit 瀏覽器 Agent 徹底解構執行時門檻: 若痛點在於編寫爬蟲、解析 DOM 樹以及配置複雜的無頭工具鏈,直接在 Tabbit 瀏覽器中調用多模型能省去所有工程膠水程式碼。
篩選替代模型的四大標準
已完成任務的真實花費,而非單純的標稱價目表: 標價便宜但頻繁輸出數千字廢話、或需要三次人工重試的模型並不划算。綜合成本必須計算思考 Token 膨脹係數、上下文快取利用率、272K 溢價斷崖以及工程師介入校正的時間成本。
人在迴路互動的可忍受延遲: 當工程師在終端或對話框前等待時,首 Token 生成時間(TTFT)與串流輸出的穩定性遠比後台峰值吞吐重要。後台非同步 Agent 可以容忍 40 分鐘,但互動結對編程不行。
上下文、多模態與工具鏈生態匹配度: 替換模型絕不能以丟失原生工具調用(Tool Calls)、結構化提取或百萬 Token 上下文解析為代價。
經真實開發者核驗的一手實踐證據: 摒棄合成基準天梯榜,優先採信 Hacker News 與 Reddit 工程師在生產踩坑中沉澱的報錯、速率限制與可用性實測。
五款替代方案速覽
| 候選模型 | 最佳適用場景 | 官方調用路線 | 核驗費率(2026-09-22) | 上下文 / 最大輸出 | 主要權衡與短板(The main catch) |
|---|---|---|---|---|---|
| GPT-5.6 Sol | 最直接的同門低成本工作馬 | gpt-5.6-sol | 輸入 $4.00 / 輸出 $20.00(每 1M) | 1,050,000 / 128,000 | 在超過 10 步的複雜桌面自動化閉環中頑固度略遜 |
| Claude Fable 5.1 / Sonnet 5 | 複雜系統架構與精細程式碼重構 | claude-fable-5-1 / claude-sonnet-5 | 輸入 $2.00–$3.00 / 輸出 $10.00–$15.00 | 1,000,000 / 128,000 | 組織並發速率限制嚴格,高思考模式單價高昂 |
| Gemini 3.8 Flash | 海量多模態數據抽取與極速吞吐 | gemini-3-8-flash | 輸入 $0.75 / 輸出 $3.75(每 1M) | 1,048,576 / 65,536 | 最大思考 Effort 下首 Token 延遲存在明顯等待 |
| DeepSeek V4.1 Flash | 定時離峰批量推理與極低預算批次處理 | deepseek-flash | 離峰輸入 $0.15 / 輸出 $0.60(每 1M) | 1,000,000 / 384,000 | 工作日高峰期存在階梯加價,無原生桌面視覺 Agent |
| Tabbit 瀏覽器 Agent | 無需膠水程式碼的桌面與網頁工作流程 | 桌面內建執行環境 | 動態整合多模型選擇器 | 活動標籤 DOM + 本機文件 | 專注桌面互動與工作流程,非無頭高並發後台介面 |
計價說明:費率基於 2026 年 9 月 22 日官方標準 API。思考 Token 按輸出計費。Prompt Caching 命中可使輸入單價降低 75% 至 90%。
GPT-5.6 Sol
最佳適用: 希望以零程式碼重構成本從 Astra 遷移、繼續沿用現有 OpenAI SDK 生態並將帳單直降 60% 的工程團隊。
核心優勢: GPT-5.6 Sol 與 Astra 擁有完全一致的 1,050,000 Token 上下文視窗、相同的 JSON 結構化約束以及一致的函數調用介面。在 Artificial Analysis 品質指數中,Sol 測得 60.9 分,與 Astra 的 61.2 分相比幾乎沒有通用能力斷層。在日常調用中,Sol 的首 Token 響應顯著優於 Astra,避免了高思考檔位帶來的長時間卡頓。Hacker News 工程師 handzhiev 在評估中指出,Sol 是名副其實的「可靠工作馬」,「足以應付絕大多數生產任務」,無需為前沿概念支付溢價。
主要短板: Sol 在 OSWorld 2.0 桌面長程任務中的表現為 75 分鐘,且在超過 10 輪的連續自愈報錯測試中,比 Astra 更容易出現邏輯退化或提前退出。關於其上下文視窗的詳細表現,可參考我們針對 GPT-5.6 Sol 100 萬 Token 視窗能力 的深度解讀。
參考計費: 輸入每百萬 Token $4.00,快取命中 $0.50,輸出 $20.00。不存在 272K 門檻懲罰性加價。
明確裁決: 如果你的調用場景不涉及長達半小時的複雜桌面 GUI 試錯或十餘步深度排錯,GPT-5.6 Sol 是替代 Astra 最理性的預設選項。
Claude Fable 5.1 與 Sonnet 5
最佳適用: 全端架構師、系統工程師以及對程式碼可維護性、重構邏輯及指令精細遵循有極高要求的研發團隊。
核心優勢: Anthropic 家族在複雜工程編碼中展現出更高的邏輯嚴密性與克制力。與 Astra 偶現的過度冗長不同,Claude 在進行倉庫級重構時能準確把握抽象邊界。工程師 Skiffssh 在 Hacker News 上分享道,儘管 Astra 在 3D 幾何生成上有所突破,但他「依然會在常規程式碼架構中堅守 Claude」。此外,Anthropic 的 Prompt Caching 可為重複前綴輸入提供 75% 的可觀減免,大幅削減多輪除錯的實際支出。
主要短板: Anthropic 的組織並發速率限制相對苛刻,容易在突發高並發請求時觸發限流重試;自適應思考開啟後輸出 Token 增長迅速,且安全防護策略雖然不像 Astra 那樣充滿官僚口吻,但在逆向工程等邊緣場景下仍會直接拒絕。
參考計費: 標準費率約為輸入 $2.00–$3.00、輸出 $10.00–$15.00 每百萬 Token,快取命中輸入低至 $0.20–$0.30。
明確裁決: 若促使你離開 Astra 的是程式碼生成的工程品味、邏輯嚴謹度或長上下文快取效益,切換至 Claude 是最佳技術決策。
Gemini 3.8 Flash
最佳適用: 海量文件抽取、長音視頻理解、大批次爬蟲資訊結構化等對吞吐速度和單位成本高度敏感的業務。
核心优势: Gemini 3.8 Flash 提供了原生跨模態理解能力與超高並發生成速率,能夠直接處理超長影片、錄音與圖文混排 PDF。其官方輸入單價 $0.75 / 輸出 $3.75 比 Astra 低出 85% 以上,且長文字生成吞吐遠超 OpenAI 旗艦型號。正如我們在 Gemini 3.8 Flash 費率解析 與 Gemini 3.8 Flash 全面評測 中所測算的,它在批量數據流水線中具備壓倒性的單位產出效益。
主要短板: 在啟用 High 思考模式時,其首 Token 延遲增加;若提示詞缺乏極其嚴格的結構約束,在處理超長複雜推理時論述容易發散。
參考計費: 128K 以內輸入 $0.75 / 輸出 $3.75(超長視窗輸入 $1.50 / 輸出 $7.50)。
明確裁決: 如果 Astra 的昂貴帳單是由海量文件解析、多模態清洗或日常批量抽取引起的,果斷遷移至 Gemini 3.8 Flash。
DeepSeek V4.1 Flash
最佳適用: 成本紅線極其嚴苛的後端批次處理、海量數據清洗與能夠進行夜間錯峰調度的背景任務。
核心優勢: DeepSeek V4.1 Flash 確立了極具衝擊力的離峰價格標竿:非高峰期快取命中僅 $0.003,基礎輸入 $0.15,輸出 $0.60。它具備 1M 上下文與 384K 的超大輸出上限,兼具思考與非思考模式。在開發者社群中,其透明的計費與性價比備受好評。
主要短板: 工作日高峰時段(UTC 01:00–04:00 及 06:00–10:00)費率翻倍至輸入 $0.30 / 輸出 $1.20;公網服務在亞太業務高峰偶有排隊波動;且不具備像 Astra 那樣經過專門針對桌面作業系統優化的原生視覺執行代理。
參考計費: 離峰輸入 $0.15 / 輸出 $0.60,高峰輸入 $0.30 / 輸出 $1.20 每百萬 Token。
明確裁決: 當任務預算受限且系統具備離峰緩衝能力時,DeepSeek V4.1 Flash 極具性價比;但切勿嘗試將其作為桌面級 GUI 自動化的直接替代品。
Tabbit 瀏覽器 Agent
最佳適用: 需要直接面向網頁 SaaS、線上看板、數據多標籤頁開展調研與協作,卻不願編寫任何無頭瀏覽器和 API 膠水程式碼的使用者。
核心優勢: 很多時候,使用者對 GPT-6 Astra 的抱怨並不源於模型本身,而是源於維護自動化環境的巨大疲勞。配置 Playwright、處理驗證碼、擷取 DOM 樹與除錯網路超時會消耗大量開發時間。Tabbit 瀏覽器 將多模型調度與工作流程直接整合在日常瀏覽器環境中,使用者可在閱讀頁面時直接呼出側邊欄,按需分派任務給最適合的底層模型。
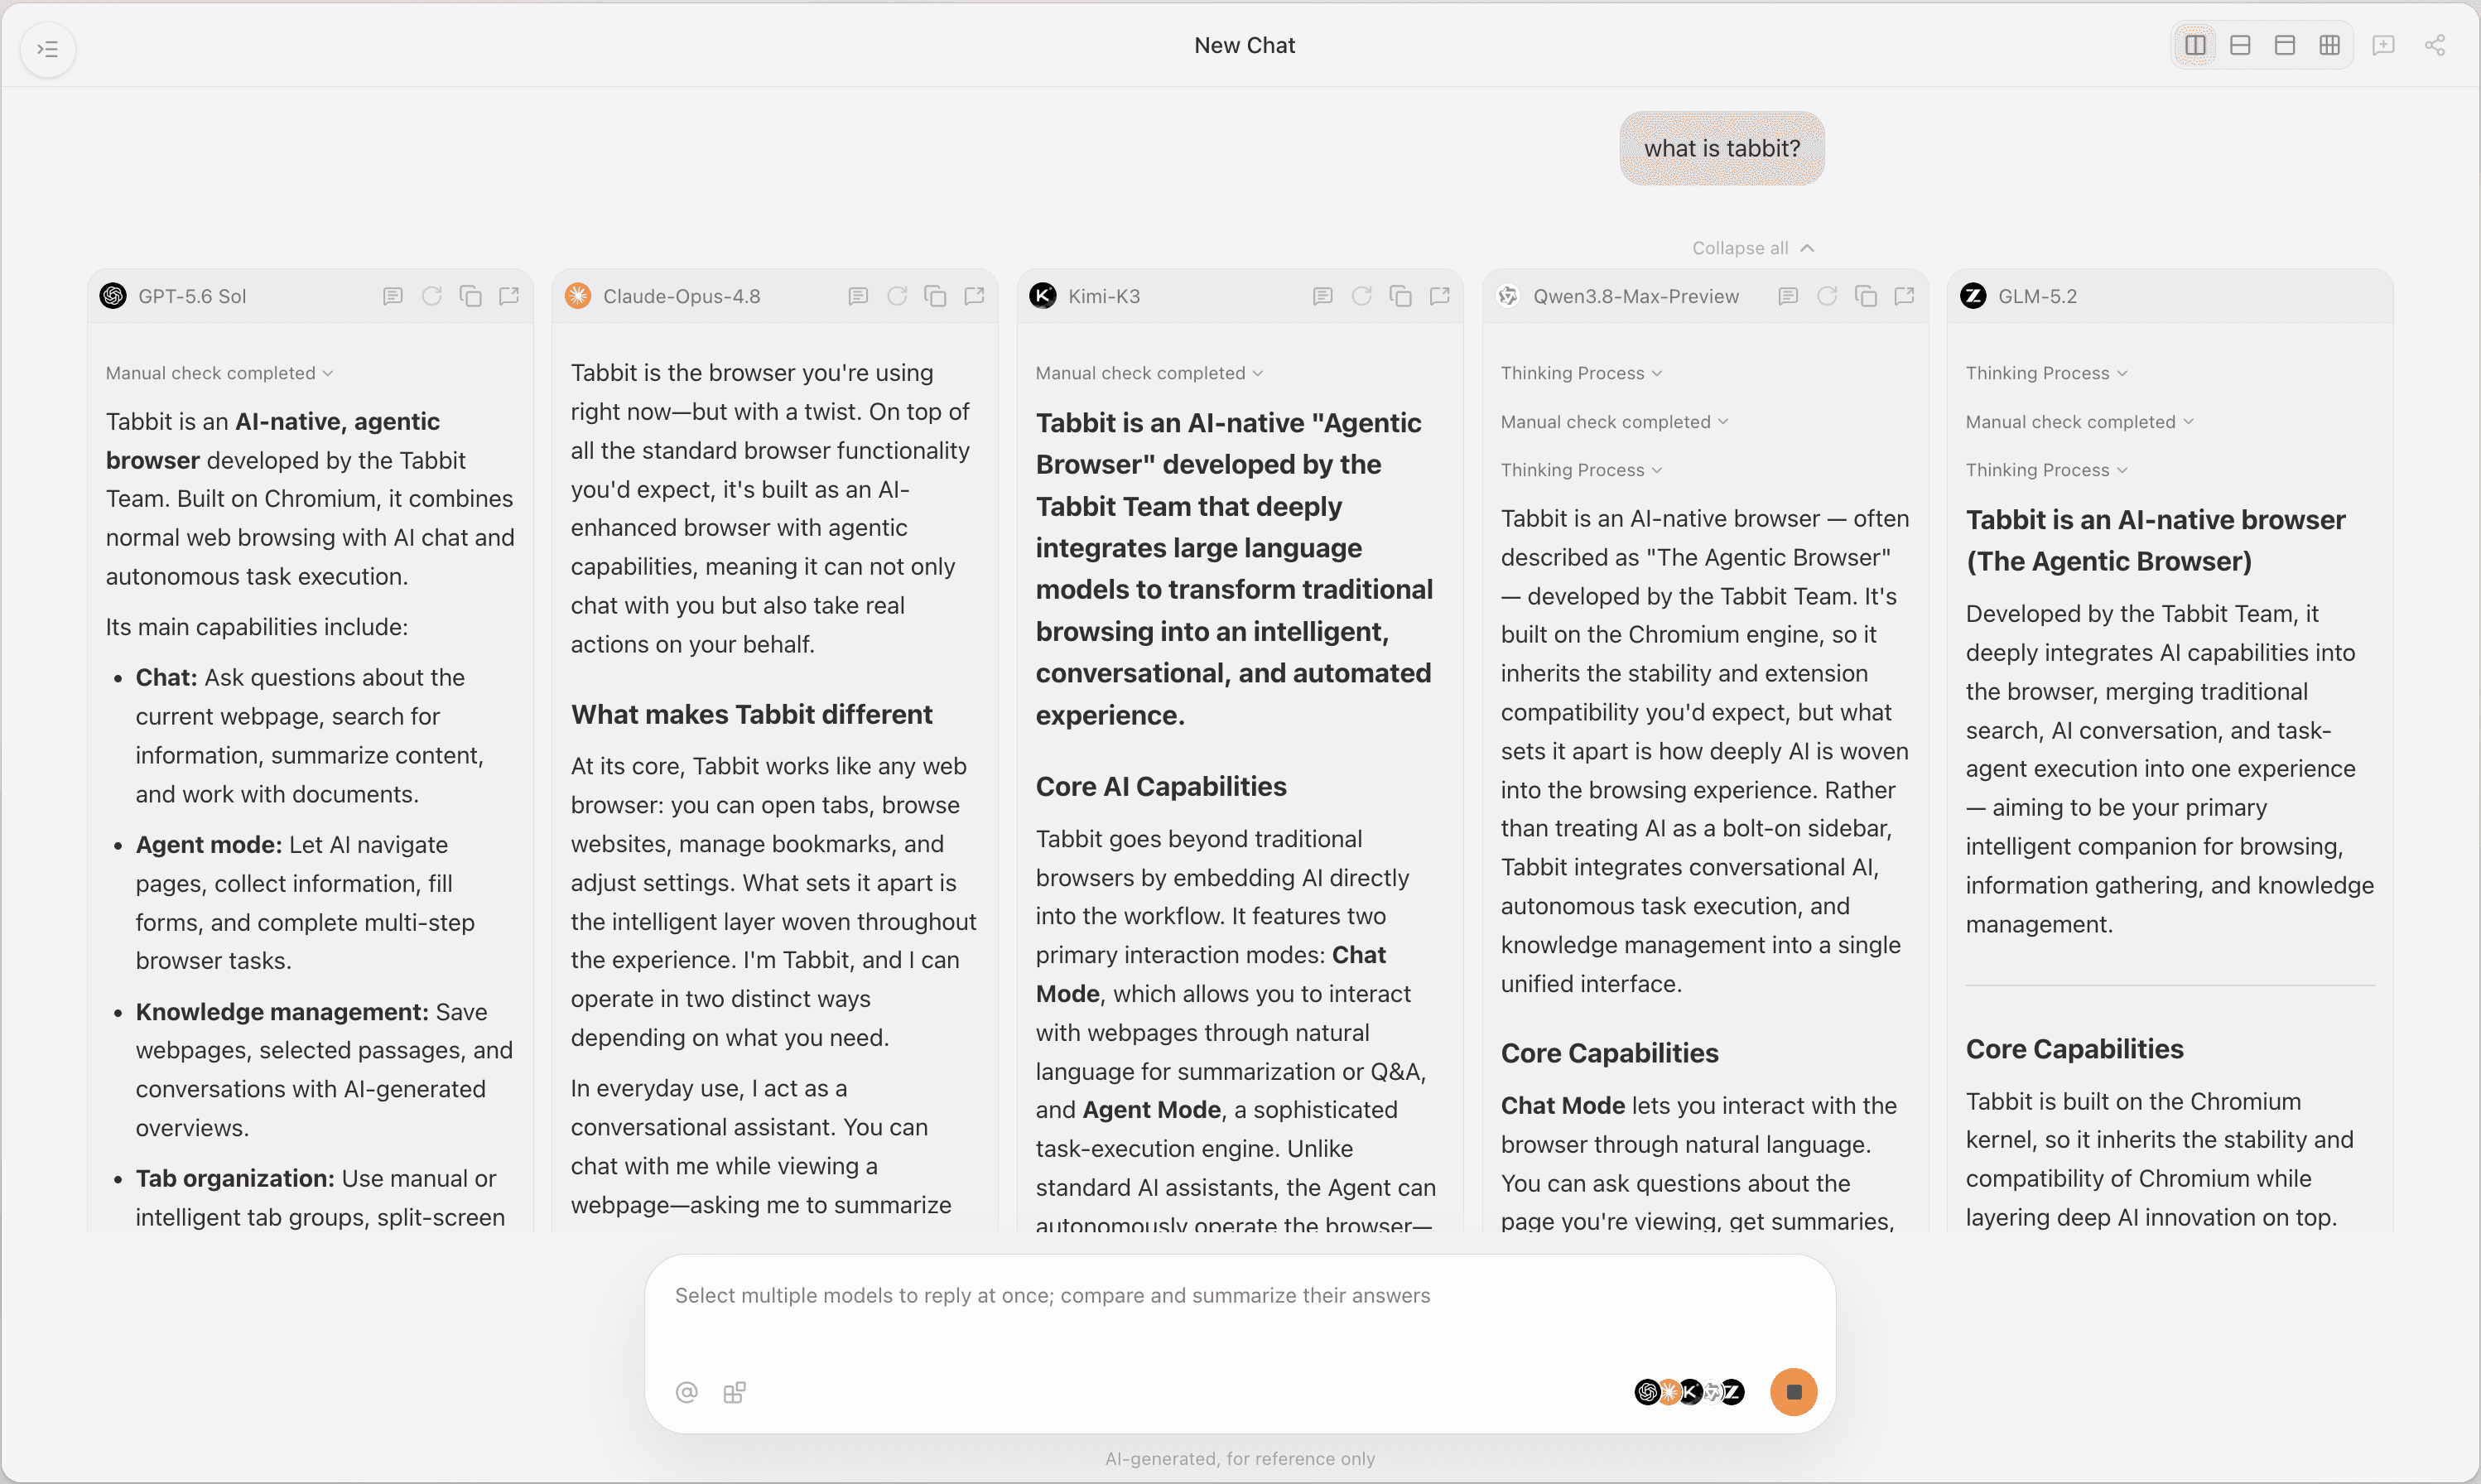
主要短板: Tabbit 專為桌面端沉浸式辦公與互動自動化設計,而非用於每秒處理數千次非同步 API 請求的後台無頭伺服器。
參考計費: 提供 macOS 與 Windows 客戶端免費下載試用,支援根據工作流程靈活選用內建模型。
明確裁決: 如果你調用 Astra 的主要目的是分析網頁資訊、處理本機文件或完成瀏覽器內操作,問題不在於模型,而在此執行層。了解 什麼是 Agentic 瀏覽器 並深入探索 Agentic AI 瀏覽器家族,能為你開闢全然不同的生產力路徑。更多內容請參考我們的 Tabbit 瀏覽器深度指南 與 瀏覽器自動化技術專欄。
 Tabbit Browser
按任務的核心約束做選型決策
放棄盲目尋找「全能第一」的思維,先明確當前最主要的痛點,再選定最匹配的替代路徑:
| 核心約束 | 首選試點模型 | 驗證成功的標準 | 核心權衡代價 |
|---|---|---|---|
| API 預算吃緊且沿用 SDK | GPT-5.6 Sol | 任務順利跑通,Token 花費立省 60%,無需修改介面架構 | 在 10 步以上的長程桌面複雜糾錯中完成率略有下降 |
| 程式碼優雅度與倉庫級重構 | Claude Fable 5.1 / Sonnet 5 | 減少人工返工修改,多輪快取讀取使總體支出明顯可控 | 需應對更為嚴格的團隊並發速率限制 |
| 多模態解析與超大吞吐量 | Gemini 3.8 Flash | 複雜 PDF/音訊影片任務完成度一致,單任務成本降低 85%+ | 高思考模式下首 Token 等待時間較為明顯 |
| 極低成本錯峰批次處理 | DeepSeek V4.1 Flash | 離峰定時流水線穩定落地,單任務花費達到最低下限 | 需規避高峰期計費溢價,無原生桌面自動化視控能力 |
| 厭煩編寫爬蟲與膠水程式碼 | Tabbit 瀏覽器 Agent | 直接在打開的網頁多標籤中跑通複雜提取,免去鷹架搭建 | 適用於桌面互動環境,無法作為純無頭後台介面 |
執行同任務對照試點
在正式大面積遷移前,建議執行小規模嚴謹對照:
固定兩個代表性任務: 選取一個邊界明確的程式碼重構任務(如優化一個複雜模組),以及一個多頁長文件結構化解析任務。
統一測試測試約束: 保持提示詞意圖、外部工具定義、結構化輸出規範與重試策略絕對一致。
核算全流程實際成本: 統計輸入、輸出、思考 Token 消耗與人工糾錯時間,避免僅看標價。
記錄延遲波動分布: 連續運行至少 5 次,記錄首 Token 響應耗時與總執行時長。
計算免監護完成率: 評估任務是否無需人工接管直接達成驗收。
結語
GPT-6 Astra 是一款定位極度明確的專用工具。如果你的系統必須依靠它在不受控的作業系統環境中連續探索 40 分鐘,或者在三維空間程式碼裡經歷十幾次自愈試錯,那麼其 $10/$50 的價格是成立的。
但在絕大多數通用軟體開發與企業業務中,Astra 強加了並不必要的 2.5 倍溢價。GPT-5.6 Sol 以 40% 的成本提供了幾乎一致的推理基準;Claude 在程式碼工程美學上更勝一籌;Gemini 3.8 Flash 是多模態吞吐的性價比標竿;DeepSeek 則牢牢鎖定了離峰批次處理的成本底線。而若你的真正目標是高效率駕馭網路資訊,在 Tabbit 瀏覽器中直接調度多模型,才是擺脫低效鷹架的最快路徑。

常見問題
最接近 GPT-6 Astra 的同門替代模型是哪款?
GPT-5.6 Sol 是最直接的同門降級選項。它共享相同的 1,050,000 Token 上下文視窗與工具調用協定,在 Artificial Analysis 獨立智力指數中取得 60.9 分(僅比 Astra 低 0.3 分),但單價直降 60%(輸入/輸出 $4/$20 vs $10/$50),首 Token 響應也更為敏捷。
既然 GPT-6 Astra 創下了 40 分鐘 OSWorld 記錄,為何還要考慮替代方案?
Astra 在 OSWorld 2.0 任務時間上從 75 分鐘降至 40 分鐘(縮減 47%),體現的是其在長程自愈循環中的頑固耐力,而非日常互動的低延遲。對於日常問答、程式碼輔助與即時分析,Astra 存在顯著的首 Token 等待、高 Effort 模式下的 Token 暴漲以及 2.5 倍的價格溢價,在多數通用場景下屬於性能過剩與成本浪費。
哪款替代模型的標稱 API 成本最低?
DeepSeek V4.1 Flash 擁有極具競爭力的公網費率,其離峰快取命中單價低至每百萬 Token $0.003,基礎輸入與輸出分別為 $0.15 和 $0.60。在歐美前沿模型陣營中,Gemini 3.8 Flash 以輸入 $0.75 / 輸出 $3.75 位居低費率前列。不過,實際任務花費還取決於生成冗長度、思考 Token 消耗和重試頻率。
272K 輸入 Token 階梯門檻如何影響實際調用成本?
在 OpenAI 公布的 Astra 費率中,一旦單次請求輸入超過 272K Token,整筆請求將統一按更高的階梯費率計費,而非僅對超出部分溢價。這造成了陡峭的成本斷崖,單次 280K 的調用花費顯著高於兩次 140K 調用。而 Sol、Gemini 與 Claude 等替代模型維持著更為線性的定價或更平緩的快取計費結構。
API Token 計費能與 ChatGPT 或 Claude Pro 訂閱會員直接換算嗎?
不能。API 是按使用量精確結算的開發者介面,具備確定性的並發與調用保障;而個人或團隊訂閱採用固定月費制(20 至 200 美元),但受制於動態訊息頻次限制、排隊配額和路由降級。需要程式化自動化、批量任務或生產系統整合的業務必須依據 API 經濟模型做預算評估。
如何在 Tabbit 瀏覽器中同時測試和對比這些替代模型?
Tabbit 瀏覽器內建了多模型切換選擇器,使用者可以在同一個日常工作空間內,按需調用 GPT-6 Astra、GPT-5.6 Sol、Claude、Gemini 或 DeepSeek。無需自行編寫爬蟲腳本或拼接 MCP 膠水程式碼,即可讓不同模型直接讀取活動標籤頁、解析本機文件並協同完成複雜的跨頁面調研。