
O valor nominal por token nunca reflete o custo total de solução de um problema de engenharia. Trata-se apenas do preço de uma matéria-prima. Na tabela oficial publicada pela Xiaomi em 22 de setembro de 2026, o modelo focado em eficiência MiMo-V2.6-Flash está cotado a US$ 0,140 por milhão de tokens de entrada sem cache e US$ 0,280 por milhão de tokens de saída (ou ¥ 1,00 e ¥ 2,00 em RMB). Custando mais de 3 vezes menos que a versão topo de linha Pro, o Flash posiciona-se como uma das opções omnimodais leves mais agressivas do mercado.
No entanto, o impacto estrutural nos custos baseia-se em dois mecanismos: um desconto de 98,0% (50 vezes mais barato) no cache de prompts, que reduz a entrada em cache para US$ 0,0028 por milhão de tokens, e uma arquitetura MoE (Mixture-of-Experts) dispersa que ativa apenas 15B de parâmetros de um total de 309B, mantendo uma velocidade superior a 140 tokens por segundo. Para extração em lote na web ou agentes de navegação com alta frequência de chamadas, essas condições redefinem a economia de escala. Este guia traduz os valores oficiais em estimativas reais para o seu orçamento. Para consultar as especificações técnicas, veja a página do modelo MiMo-V2.6-Flash (English); para a versão 1,02T, confira nossa análise de preços do MiMo-V2.6-Pro.
Principais conclusões
Tarifas base de US$ 0,14 de entrada e US$ 0,28 de saída por milhão de tokens, tornando o Flash mais de 3 vezes mais acessível em ambos os eixos do que o modelo principal MiMo-V2.6-Pro (English) (US$ 0,435 / US$ 0,87).
O cache de prompts reduz custos de entrada em 98,0%: prefixos idênticos custam apenas US$ 0,0028 / 1M de tokens (¥ 0,02 / 1M), permitindo consultar longos contextos e documentações por frações de centavo.
UltraSpeed é exclusivo do Pro: o Flash não possui nem necessita de um plano UltraSpeed com taxa 10x, pois seus 15B parâmetros ativados já entregam nativamente baixa latência e alta velocidade de streaming.
Tokens de raciocínio são cobrados como saída: nas versões RL com raciocínio, o fluxo interno de reflexão é tarifado como saída a US$ 0,28 / 1M.
Convergência de custos em alta taxa de cache: em loops de agentes com mais de 85% de acertos de cache, a diferença de leitura entre Pro (US$ 0,0036) e Flash (US$ 0,0028) é de apenas US$ 0,0008, fazendo do volume de saída o verdadeiro critério de escolha econômica entre os modelos.
Tabela de preços do MiMo-V2.6-Flash
A tabela a seguir reflete as tarifas oficiais conferidas em 22 de setembro de 2026 na documentação oficial da Xiaomi MiMo. Todos os valores são calculados por milhão de tokens (1M).
| Variante do modelo | Entrada (Cache hit) / 1M | Entrada (Cache miss) / 1M | Saída / 1M | Janela de contexto | Saída máxima |
|---|---|---|---|---|---|
| MiMo-V2.6-Flash | US$ 0,0028 (¥ 0,02) | US$ 0,140 (¥ 1,00) | US$ 0,280 (¥ 2,00) | 1.048.576 | 131.072 |
| MiMo-V2.6-Pro | US$ 0,0036 (¥ 0,025) | US$ 0,435 (¥ 3,00) | US$ 0,870 (¥ 6,00) | 1.048.576 | 131.072 |
| DeepSeek V4.1 Flash | US$ 0,0030 (¥ 0,021) | US$ 0,150 (¥ 1,05) | US$ 0,300 (¥ 2,10) | 1.048.576 | 8.192 |
| Gemini 3.8 Flash | US$ 0,0375 | US$ 0,150 | US$ 0,600 | 1.048.576 | 8.192 |
Essa estrutura comercial posiciona o MiMo-V2.6-Flash de forma muito nítida: ele compete diretamente com alternativas como DeepSeek V4.1 Flash e Gemini 3.8 Flash, oferecendo suporte para até 131.072 tokens de saída em uma janela integral de 1 milhão de tokens.
O número determinante: US$ 0,0028 por milhão de tokens em cache
Para quem dimensiona infraestrutura de TI, a métrica central é US$ 0,0028 / 1M tokens (¥ 0,02 / 1M). Isso representa uma redução de exatos 98,0% (50 vezes menos) sobre o valor sem cache de US$ 0,140.
Em fluxos automatizados, como em um fluxo de raciocínio de agentes, o agente analisa páginas DOM, extrai registros tabulares e preenche formulários repetidas vezes. Reenviar 100.000 tokens de contexto web ao longo de 20 rodadas sem cache consumiria 2 milhões de tokens de entrada (US$ 0,28). Com o cache automático de prefixo, essas mesmas 20 rodadas custam menos de US$ 0,006 na entrada.
Além disso, a arquitetura MoE dispersa do Flash ativa apenas 15B de seus 309B parâmetros, assegurando tempo de resposta inicial (TTFT) muito baixo e geração contínua acima de 140 tokens por segundo.
Analisando as declarações oficiais de eficiência
A Xiaomi promove o MiMo-V2.6-Flash como a solução ideal para fluxos de processamento em massa que exigem baixo custo unitário sem perder a qualidade de raciocínio. Embora o custo por token seja excelente, dois limites práticos devem ser considerados:
Cobrança de tokens de raciocínio no modo RL: O modelo
MiMo-V2.6-Flash-RLinclui etapas de avaliação interna por aprendizado por reforço. Apesar de o preço de saída ser atrativo (US$ 0,28 / 1M), tarefas complexas podem emitir entre 3.000 e 6.000 tokens de pensamento antes de devolver uma resposta JSON de 200 tokens. Como o raciocínio é faturado como saída, o custo final da chamada depende da profundidade reflexiva.Estabilidade do prefixo de cache: O benefício de US$ 0,0028 requer prefixos consistentes entre as chamadas. Inserir variáveis voláteis, como timestamps ou IDs aleatórios no início do prompt, anulará o cache e ativará a cobrança integral de US$ 0,140 / 1M.
Fórmula validada para cálculo de custos:
custo por requisição = (entrada sem cache × 0,140
                      + entrada em cache × 0,0028
                      + saída total com raciocínio × 0,280) / 1.000.000
orçamento mensal = (custo médio por requisição × chamadas faturáveis) + margem de repetição
Regras de faturamento fora da tabela principal
Calcular o custo total de posse (TCO) exige considerar aspectos operacionais da API Xiaomi MiMo:
UltraSpeed indisponível no Flash: Diferente do Pro, que oferece a opção
mimo-v2.6-pro-ultraspeedcom multiplicador de 10x (US$ 4,35 entrada, US$ 8,70 saída), o Flash não disponibiliza nem requer esse modo. Sua arquitetura com 15B ativos já assegura respostas muito ágeis.Assinaturas Token Plan: Para pequenas equipes com preferência por planos mensais fixos em RMB:
Plano Lite (¥ 39 / mês): Para prototipagem e automações leves.
Plano Standard (¥ 99 / mês): Para desenvolvedores com demandas regulares de extração.
Plano Pro (¥ 329 / mês): Concorrência ampliada para esteiras de produção.
Plano Max (¥ 659 / mês): Capacidade garantida para ingestão corporativa em larga escala.
Limites de concorrência (RPM/TPM): As chaves de API pós-pagas têm limites de chamadas por minuto. Esteiras paralelas com muitos crawlers devem solicitar aumento de cota com antecedência.
Descontinuação da linha V2.5: A geração anterior MiMo-V2.5 será encerrada em 21 de outubro de 2026. Recomendamos a migração imediata para os endpoints V2.6.
Comparativo de níveis da família MiMo
| Nível do modelo | Recomendado para | Entrada / 1M (Miss / Hit) | Saída / 1M | Perfil de vazão e latência |
|---|---|---|---|---|
| MiMo-V2.6-Flash | Extração web em massa, triagem de dados, resumos | US$ 0,140 / US$ 0,0028 | US$ 0,280 | Vazão ultra-alta (140+ tok/s), 15B ativos MoE |
| MiMo-V2.6-Pro | Programação pesada, matemática avançada, raciocínio lógico | US$ 0,435 / US$ 0,0036 | US$ 0,870 | Raciocínio profundo, 42B ativos / 1,02T totais MoE |
| MiMo-V2.6-Pro-UltraSpeed | Agentes de voz interativos, atendimento ao cliente em tempo real | US$ 4,350 / US$ 0,0360 | US$ 8,700 | Geração ultrarrápida (até 20x mais rápido, custo 10x) |
O ponto contraintuitivo deste comparativo envolve a dinâmica de cache: em tarefas isoladas sem cache, o Flash é 3,1 vezes mais barato que o Pro. Por outro lado, em um loop de agente com 90% de acerto de cache, a diferença na taxa de entrada entre Flash (US$ 0,0028) e Pro (US$ 0,0036) é de apenas US$ 0,0008 por milhão de tokens. Nesses casos, a escolha reside quase unicamente no custo de saída (US$ 0,28 vs US$ 0,87) e na necessidade de profundidade de raciocínio. Avalie outras opções no nosso guia comparativo de navegadores de IA de 2026.
Itens isentos de cobrança e custos indiretos
Definir claramente os limites de cobrança evita surpresas na fatura:
Sem taxa horária de armazenamento em janelas base: Diferente de plataformas que cobram pela manutenção horária do contexto em disco, a Xiaomi MiMo cobra apenas pelas leituras efetivas com acerto de cache.
Sem custo em bloqueios de segurança: Requisições interrompidas por filtros de segurança não pagam pelos tokens de conclusão não gerados.
Tokens de reflexão são pagos: No modo RL, os passos internos de raciocínio são cobrados normalmente na linha de saída a US$ 0,28 / 1M.
Falhas de execução consomem créditos: Caso seu robô enfrente loops de CAPTCHA ou erros de parsing que exijam repetições, todos os tokens emitidos serão faturados.
Relatos da comunidade técnica
Registros coletados em fóruns de desenvolvimento demonstram o comportamento do MiMo-V2.6-Flash em esteiras reais:
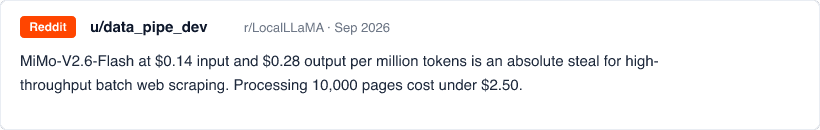
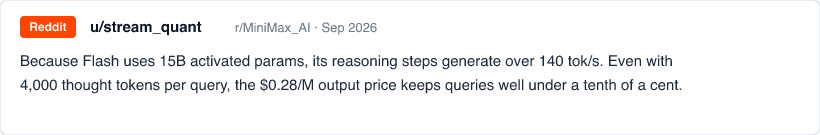
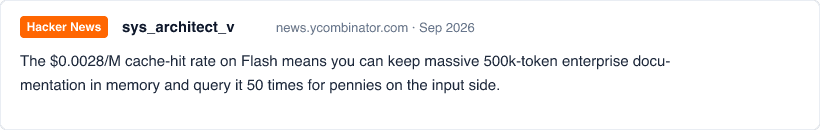
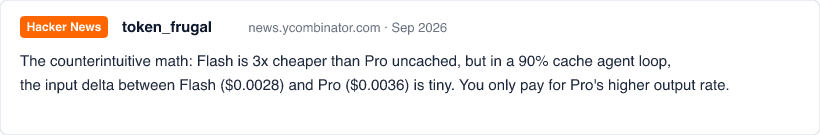
Esses relatos convergem para a mesma orientação prática: utilize o Flash para lidar com altos volumes de dados e acione o Pro somente quando as exigências lógicas justificarem o custo adicional.
Dois exemplos de tarefas reproduzíveis
Para consolidar esses números na prática, detalhamos duas estimativas sob as tarifas oficiais de 2026 em dólares:
Exemplo 1: Extração estruturada de páginas web em lote (Alto volume, cache moderado)
Entrada: 15.000 tokens por página (HTML e regras de formatação); 25% de cache (3.750 tokens em cache, 11.250 sem cache).
Saída: 800 tokens (registro limpo em formato JSON).
Cálculo:
(11.250 × US$ 0,140 + 3.750 × US$ 0,0028 + 800 × US$ 0,280) / 1.000.000 = US$ 0,001575 + US$ 0,0000105 + US$ 0,000224 = US$ 0,00181por página.10.000 páginas / mês: US$ 18,10 / mês. (O mesmo volume no MiMo-V2.6-Pro custaria US$ 55,97 / mês, gerando 68% de economia com o Flash).
Exemplo 2: Agente de pesquisa documental multietapas (Alto índice de cache)
Entrada: 300.000 tokens acumulados em 10 rodadas de ferramentas; 85% de cache (255.000 tokens em cache, 45.000 tokens novos).
Saída: 5.000 tokens no total (triagem, síntese e relatório).
Cálculo:
(45.000 × US$ 0,140 + 255.000 × US$ 0,0028 + 5.000 × US$ 0,280) / 1.000.000 = US$ 0,00630 + US$ 0,000714 + US$ 0,00140 = US$ 0,00841por tarefa.500 tarefas / mês: US$ 4,21 / mês. Sem o cache de prompts, a entrada custaria US$ 0,042 por execução, elevando o custo mensal para US$ 21,70 / mês (mais de 5 vezes mais caro).
| Carga de trabalho | Tokens de entrada | Proporção em cache | Tokens de saída | Tarefas por mês | Custo mensal estimado |
|---|---|---|---|---|---|
| Extração web em lote | 15.000 | 25% | 800 | 10.000 | US$ 18,10 |
| Agente de pesquisa documental | 300.000 | 85% | 5.000 | 500 | US$ 4,21 |
Cálculo local
Estime o custo mensal de tokens
Tarifas oficiais da API verificadas em setembro de 2026. Inclui o raciocínio na saída. Os valores permanecem no navegador.
Exclui chamadas de ferramentas e novas tentativas. Leitura em cache Pro e Flash a $0,0036 e $0,0028 por 1M tokens. Verificado em 22-09-2026. Ver tarifas atuais
A calculadora acima funciona totalmente no seu navegador, sem enviar dados para servidores externos. Você pode ajustar as variáveis para comparar os custos entre Flash, Pro e UltraSpeed.
Orquestração de fluxos no Tabbit Browser
Orçar tokens é apenas parte do trabalho de engenharia. É imprescindível dispor de um ambiente de execução que atue com estabilidade na web real. Criar scripts com navegadores headless e gerenciar autenticações consome muito tempo de suporte.
O Tabbit Browser oferece um ambiente nativo de IA onde agentes inteligentes navegam em aplicações dinâmicas, extraem dados estruturados e cruzam informações entre abas. Para entender melhor essa tecnologia, veja nossos artigos sobre o que é um navegador de agentes e os melhores navegadores de IA em 2026.
Conforme documentado oficialmente no projeto, a disponibilidade dos modelos no Tabbit varia de acordo com o seletor ativo da sua conta e os termos do serviço. O Tabbit não substitui sua assinatura de API, mas oferece um ambiente de alto rendimento para suas tarefas web.
 Tabbit Browser
Fontes oficiais
As tarifas e especificações técnicas foram validadas em 22 de setembro de 2026 com base em dados oficiais:
Cartão do modelo no Hugging Face: XiaomiMiMo/MiMo-V2.6-Flash-RL
Cartão do modelo no Hugging Face: XiaomiMiMo/MiMo-V2.6-Pro-RL

Perguntas frequentes
Quanto custa o MiMo-V2.6-Flash pela API oficial?
A tabela oficial lista o MiMo-V2.6-Flash a US$ 0,140 por milhão de tokens de entrada sem cache, US$ 0,0028 por milhão de tokens de entrada em cache (acerto de cache) e US$ 0,280 por milhão de tokens de saída em dólares (¥ 1,00, ¥ 0,02 e ¥ 2,00 em RMB).
Qual é a economia gerada pelo cache de prompts no MiMo-V2.6-Flash?
A entrada em cache custa US$ 0,0028 por milhão de tokens, contra US$ 0,140 na entrada sem cache. Isso representa uma redução de 98,0% (50 vezes mais barato) nos prefixos recorrentes.
Como os preços do MiMo-V2.6-Flash se comparam aos do MiMo-V2.6-Pro?
O Flash é mais de 3 vezes mais barato em entrada sem cache (US$ 0,14 vs US$ 0,435) e em saída (US$ 0,28 vs US$ 0,87). Na entrada em cache, o Flash custa US$ 0,0028/M contra US$ 0,0036/M do Pro.
Os tokens de raciocínio interno são cobrados à parte no Flash RL?
Não. A Xiaomi MiMo fatura os tokens de raciocínio com o texto final como saída padrão a US$ 0,28 por milhão de tokens. Não há cobrança separada para as etapas de pensamento.
O MiMo-V2.6-Flash possui um modo UltraSpeed?
Não. O UltraSpeed é um nível exclusivo com custo 10x reservado ao MiMo-V2.6-Pro. O Flash já opera nativamente a mais de 140 tok/s devido à sua arquitetura MoE com 15B parâmetros ativados.
Posso utilizar o MiMo-V2.6-Flash no Tabbit Browser?
O Tabbit Browser oferece um ambiente nativo de IA para pesquisa web e automação. A disponibilidade real depende do seletor de modelos da sua conta e dos termos da plataforma.