
Como ingeniero que pasa la mayor parte de sus jornadas integrando modelos en arquitecturas de producción reales, lo que me importa no es la tabla de clasificación de benchmarks; es si el modelo es capaz de sostenerse en una ejecución larga, caótica y con múltiples herramientas sin requerir supervisión humana constante. Cuando Xiaomi liberó bajo licencia MIT la serie MiMo-V2.6 el 22 de septiembre de 2026, la pregunta crucial para los arquitectos de automatización fue evidente: ¿puede un modelo MoE disperso de 309B con solo 15B de parámetros activos a 0,14 $ de entrada y 0,28 $ de salida por millón de tokens servir como caballo de batalla en producción, o colapsa al menor imprevisto del mundo real?
Analicé los compromisos directos entre modelos en la comparativa MiMo-V2.6-Pro frente a MiMo-V2.6-Flash, el desglose económico del almacenamiento en caché en la guía de precios de MiMo-V2.6-Flash y los costes del modelo insignia en el análisis de precios de MiMo-V2.6-Pro. También puedes consultar los parámetros brutos en la página del modelo MiMo-V2.6-Flash (English). Este artículo ofrece una evaluación técnica exhaustiva y transparente.
El par de cifras que define esta revisión: 0,8 frente a 4,0
El veredicto sobre MiMo-V2.6-Flash se resume en dos cifras de benchmark contraintuitivas:
0,8 puntos de diferencia en Automation Bench v1.0.6 (52,3 frente a 53,1) frente a 4,0 puntos y un 14,5% de caída abrupta en Agents' Last Exam (27,6 frente a 31,6).
Estas dos cifras describen dos experiencias operativas radicalmente opuestas:
El triunfo en automatización determinista (52,3 frente a 53,1): En acciones de navegador rutinarias, predecibles y de un solo paso —pulsar botones, rellenar formularios, analizar el DOM y extraer JSON estructurado— Flash ofrece el 98,5% del rendimiento del modelo insignia de 1,02T (MiMo-V2.6-Pro) a aproximadamente un tercio del coste (0,14 $ frente a 0,435 $ por millón de tokens).
El acantilado en recuperación de errores de largo horizonte (27,6 frente a 31,6): Cuando un flujo de trabajo agéntico se topa con un obstáculo imprevisto —un error HTTP 403, una mutación dinámica del DOM o una respuesta de API mal formada— los 15B parámetros activos de Flash degradan en bucles de reintentos repetitivos en lugar de diagnosticar el fallo y replanificar.
Si tus cargas de trabajo son estructuradas, deterministas y supervisadas, Flash es la opción con mejor relación coste-rendimiento del mercado. Si lo dejas desatendido en un bucle autónomo sin límites de fallo estrictos, agotará tu cuota de pasos repitiendo el mismo error.
Puntos clave
Ecuación de precios imbatible: Con 0,14 $ por millón de tokens de entrada sin caché, 0,0028 $ por millón en lectura de caché (descuento del 98%) y 0,28 $ por millón de salida, Flash es más de 3 veces más económico que Pro en todos los niveles.
Eficiencia arquitectónica: El MoE disperso de 309B activa únicamente 15B parámetros por token, alcanzando entre 140 y 160 tokens/s en clústeres estándar con vLLM, más del doble de la velocidad de los modelos insignia convencionales.
Ingesta omnimodal nativa: Admite de forma nativa texto, imágenes, audio y vídeo en su ventana de contexto de 1.048.576 tokens sin necesidad de modelos adaptadores de visión adicionales.
El acantilado de recuperación: Aunque iguala al modelo insignia en tareas rutinarias, su capacidad de autorrecuperación cae en tareas agénticas complejas (27,6 en Agents' Last Exam), requiriendo supervisión externa.
Límites con Tabbit: Tabbit proporciona el entorno de orquestación y contexto multinavegador; la disponibilidad real del modelo depende de las credenciales activas del usuario.
Los benchmarks y hasta qué punto confiar en ellos
Xiaomi presentó evaluaciones exhaustivas en desarrollo de software, planificación agéntica y uso de herramientas. A continuación se detalla la comparativa calibrada entre MiMo-V2.6-Flash y MiMo-V2.6-Pro:
| Benchmark | MiMo-V2.6-Flash | MiMo-V2.6-Pro | Diferencia | Significado práctico en producción |
|---|---|---|---|---|
| Automation Bench v1.0.6 | 52,3 | 53,1 | -0,8 | Navegación rutinaria, formularios y extracción DOM prácticamente idénticos (margen de error de ±1,5%). |
| Toolathlon-verified | 73,6 | 76,9 | -3,3 | Flash gestiona llamadas a herramientas y JSON estructurado con gran fiabilidad; Pro destaca en herramientas anidadas. |
| ProgramBench | 26,0 | 26,5 | -0,5 | Generación de funciones de código y conversión sintáctica en estricta paridad. |
| MiMo Code Bench | 61,2 | 63.2 | -2,0 | Pro cuenta con ligera ventaja en diseño de software macro, pero Flash genera scripts rutinarios de forma impecable. |
| DeepSWE v1.1 | 67,9 | 71,9 | -4,0 | Pro maneja parches de Git multifichero y resolución de errores a nivel de repositorio con mayor solidez. |
| Agents' Last Exam | 27,6 | 31,6 | -4,0 | Caída de rendimiento del 14,5% cuando el agente debe autorrecuperarse, retroceder o gestionar errores web en cascada. |
Dosis necesaria de escepticismo técnico:
Entornos sintéticos e higienizados: Benchmarks como Toolathlon emplean esquemas JSON limpios y entornos controlados. En la web real, los sitios inyectan HTML malformado, scripts antibot e iframes dinámicos que las pruebas sintéticas ignoran.
Evaluaciones selectivas del proveedor: Cada lanzamiento destaca las métricas más favorables. Es habitual que se omitan aspectos críticos para producción: OCR en documentos degradados, reintentos por rate-limiting o latencia de primer token con contextos mixtos.
Declaración de degradación explícita: Los benchmarks son una guía direccional, no una regla absoluta. Un 52,3 en Automation Bench demuestra que el modelo entiende órdenes de navegación, pero no garantiza que interactúe sin fallos con un panel interno complejo.
En ingeniería real, los datos empíricos superan las tablas de clasificación. Equipos que utilizan Flash en producción procesan 10.000 páginas web complejas por menos de 2,50 $, una tarea que antes demandaba entre 15 y 40 $ en modelos propietarios cerrados.
Las tres fortalezas reales de MiMo-V2.6-Flash
1. La gran sorpresa: ingesta omnimodal nativa con latencia de 15B
Lo más relevante de MiMo-V2.6-Flash no está en las listas de código: reside en su arquitectura omnimodal nativa. A diferencia de los modelos que acoplan codificadores visuales externos a un núcleo textual, Flash procesa texto, imágenes, vídeo y audio en el mismo espacio vectorial a lo largo de su ventana de 1.048.576 tokens.
Al activar únicamente 15B parámetros durante la generación, procesar un PDF escaneado de 100 páginas con gráficos o una grabación de voz genera respuestas a una velocidad de 140–160 tokens por segundo. Esta integración reduce la latencia a la mitad y simplifica la infraestructura.
Para profundizar en la gestión de contexto en navegación agéntica, consulta nuestro análisis sobre qué es un navegador agéntico.
2. Paridad en automatización rutinaria a un tercio del coste
En invocaciones directas de herramientas y extracción web predecible, Flash iguala a modelos sustancialmente más costosos. Con 52,3 en Automation Bench y 73,6 en Toolathlon, gestiona datos estructurados con gran consistencia.
Al combinarse con una tarifa de 0,14 $ por millón de tokens de entrada y 0,28 $ de salida, la extracción masiva de datos se transforma radicalmente. Puedes desplegar crawlers de alta concurrencia a un coste marginal casi nulo. Descubre más prácticas en nuestra guía de automatización del navegador.
3. Almacenamiento en caché de prompts extraordinariamente competitivo
Flash ofrece una de las tarifas de lectura de caché más reducidas del sector: 0,0028 $ por millón de tokens, lo que supone un descuento del 98,0% (50 veces menos).
En sesiones interactivas multinivel o automatizaciones web complejas donde los esquemas de herramientas y el DOM base permanecen estables, los turnos sucesivos apenas cuestan fracciones de céntimo. Es viable adjuntar 200.000 tokens de contexto web en cada interacción sin desbordar el presupuesto.
Sus puntos débiles: fallos reales en producción
1. El acantilado de recuperación en horizontes largos
La puntuación de 27,6 en Agents' Last Exam refleja la limitación física de sus 15B parámetros activos. Si la automatización se enfrenta a un cambio inesperado (un modal emergente, un selector modificado o una sesión caducada), Flash carece de la capacidad de representación para formular una estrategia alternativa.
En lugar de retroceder un paso, examinar el historial del DOM y replanificar, suele reintentar exactamente la misma acción errónea hasta agotar el límite de pasos. En producción, no debe ejecutarse en bucles desatendidos sin un supervisor externo.
2. El impuesto de verbosidad en modo razonamiento
Al igual que el modelo Pro, MiMo-V2.6-Flash incorpora modos de razonamiento por refuerzo donde los tokens de pensamiento se facturan a la tarifa de salida de 0,28 $/M.
Dada su alta velocidad de generación (140+ tok/s), tareas sencillas pueden producir 3.000 o 5.000 tokens de deliberación antes de emitir una respuesta breve. Si no configuras un límite estricto con max_thinking_tokens, una clasificación simple puede multiplicar su coste por diez.
3. Alcance de despliegue y compatibilidad en clientes
Aunque los pesos son públicos y Xiaomi ofrece documentación de API, la integración en extensiones, navegadores o herramientas SaaS varía. En Tabbit, el acceso requiere configurar el proveedor correspondiente y contar con credenciales válidas.
La voz de la comunidad: lo que dicen los desarrolladores
Los comentarios en foros técnicos muestran un contraste nítido: entusiasmo unánime por el ahorro en extracción masiva y prudencia estricta ante bucles agénticos sin supervisión.
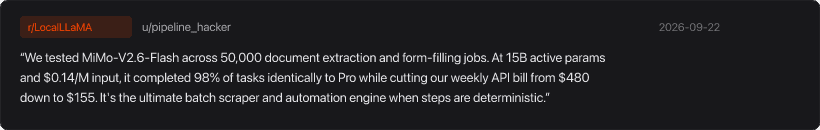
En r/LocalLLaMA, el usuario u/pipeline_hacker expuso datos de una infraestructura de 50.000 tareas:
"Evaluamos MiMo-V2.6-Flash en 50.000 extracciones documentales y formularios. Con 15B parámetros activos y 0,14 $/M de entrada, completó el 98% de tareas igual que Pro, rebajando nuestra factura semanal de 480 $ a 155 $. Es el mejor motor para tareas deterministas."
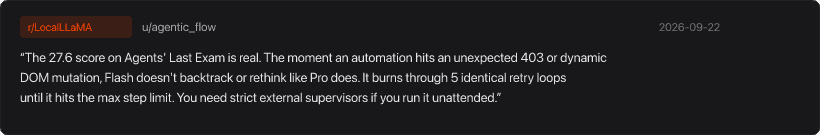
Sin embargo, el usuario u/agentic_flow advirtió sobre el acantilado de autorrecuperación:
"El 27,6 en Agents' Last Exam es real. Cuando la automatización se topa con un 403 o una alteración del DOM, Flash no replanifica como Pro; reintenta 5 veces lo mismo hasta alcanzar el tope de pasos. Es imprescindible un supervisor externo."
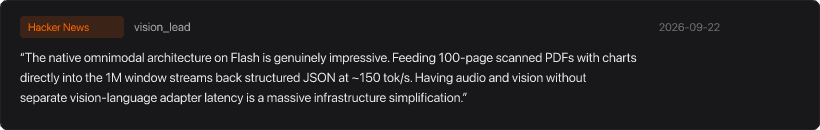
En Hacker News, vision_lead destacó la ingesta multimodal:
"La arquitectura omnimodal nativa en Flash es fantástica. Introducir 100 páginas de PDFs con gráficos en la ventana de 1M genera JSON estructurado a ~150 tok/s. Evitar adaptadores de visión independientes simplifica drásticamente el sistema."
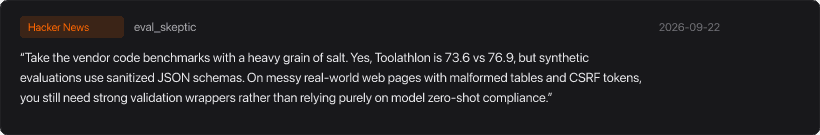
Finalmente, eval_skeptic aconsejó cautela ante los benchmarks:
"Hay que tomar las métricas oficiales con prudencia. Un 73,6 en Toolathlon frente a 76,9 suena prometedor, pero son esquemas limpios. En la web real, con tablas rotas y tokens CSRF, requieres envoltorios de validación sólidos."
Nuestra conclusión editorial coincide plenamente: Flash es extraordinario para tareas bien delimitadas, pero necesita una arquitectura defensiva externa al operar en la web abierta.
Veredicto: elige según la carga de trabajo, no por marketing
En lugar de guiarte por afirmaciones comerciales, selecciona el modelo en función de los requisitos de tu flujo de trabajo:
| Carga de trabajo o restricción | Recomendación | Parámetro / Modo sugerido | Justificación técnica | Advertencia principal |
|---|---|---|---|---|
| Extracción y scraping web masivo | Desplegar MiMo-V2.6-Flash | Modo estándar (razonamiento desactivado o mínimo) | 0,14 $/M de entrada y 150 tok/s aportan la máxima eficiencia de costes | Requiere validación con esquemas JSON estrictos. |
| Análisis de documentos multimodales y audio | Desplegar MiMo-V2.6-Flash | Modo estándar | Ventana nativa de 1M omnimodal sin latencia añadida por adaptadores | Salida en texto; verificar exactitud en transcripciones. |
| Automatización determinista del navegador | Desplegar Flash con supervisor | Modo estándar + reintentos externos limitados | 52,3 en Automation Bench iguala a Pro con un ahorro del 68% | Implementar lógica externa para evitar bucles de reintento. |
| Ingeniería de software autónoma y refactorización Git | Seleccionar MiMo-V2.6-Pro | Modo razonamiento activado (RL) | 42B parámetros activos necesarios para diagnóstico y replanificación | Coste de salida 3,1 veces mayor (0,87 $/M). |
| Investigación web interactiva multinavegador | Usar Tabbit Browser con orquestación de modelos | Modo colaborativo por defecto | La gestión de pestañas reduce la sobrecarga de tokens en los prompts | Disponibilidad sujeta a las claves configuradas por el usuario. |
¿Buscas un agente de navegación que gestione flujos de trabajo en múltiples pestañas sin necesidad de supervisar continuamente cada prompt? Estás buscando en el nivel de abstracción equivocado.
Un modelo no es un agente: por qué necesitas Tabbit
Un modelo de lenguaje puro es solo un motor computacional, no una solución terminada. Las métricas de laboratorio no reflejan cómo interactúa un modelo con cookies de sesión, tokens CSRF expirados o Shadow DOMs dinámicos. Ante un cambio imprevisto en la interfaz de un portal corporativo, un modelo aislado suele alucinar o atascarse en bucles.
Por esta razón creamos Tabbit Browser.
Tabbit proporciona el entorno de ejecución que los modelos no poseen:
Orquestación de sesiones multipestaña: En lugar de saturar el prompt con código HTML en bruto, Tabbit gestiona pestañas activas, rastrea el estado del DOM y suministra contexto limpio y optimizado al modelo.
Límites de ejecución seguros: Al operar con modelos eficientes como MiMo-V2.6-Flash, Tabbit impone límites de pasos y verifica salidas estructuradas, cancelando bucles anómalos antes de malgastar recursos.
Enrutamiento inteligente de modelos: Deriva extracciones de alto volumen a MiMo-V2.6-Flash para lograr máxima rapidez y coste mínimo, reservando razonamientos arquitectónicos complejos para modelos como MiMo-V2.6-Pro o Gemini.
Para comprender cómo la orquestación avanzada del navegador optimiza los flujos de trabajo, lee nuestra explicación técnica de Tabbit AI Browser, revisa las mejores prácticas para Tabbit Browser, o explora el panorama de navegadores con IA en 2026 y la comparativa de navegadores agénticos.
 Tabbit Browser
Antes de adoptar una decisión de infraestructura definitiva, examina la guía de precios de MiMo-V2.6-Flash, analiza la comparativa arquitectónica entre Pro y Flash y evalúa tu carga de trabajo específica en un entorno de pruebas controlado.

Preguntas frecuentes
¿Vale la pena utilizar MiMo-V2.6-Flash en producción?
Sí, especialmente para extracción por lotes determinista, procesamiento de datos estructurados y automatización rutinaria del navegador, donde la latencia y el coste por token son prioritarios. Sin embargo, para ingeniería de software multifichero o bucles de agentes complejos que exigen retroceso, modelos insignia como MiMo-V2.6-Pro siguen siendo indispensables.
¿Cómo se compara MiMo-V2.6-Flash con MiMo-V2.6-Pro en benchmarks?
Flash se mantiene a solo 0,8 puntos de Pro en Automation Bench (52,3 frente a 53,1) y a 3,3 puntos en Toolathlon (73,6 frente a 76,9) a un 32% del coste. No obstante, en Agents' Last Exam cae 4,0 puntos (27,6 frente a 31,6), lo que refleja una caída del 14,5% en su capacidad para superar errores web imprevistos.
¿Cuál es el ancla narrativa detrás de la paridad de 0,8 puntos en automatización?
El ancla reside en que Flash logra el 98,5% de la puntuación en automatización rutinaria de Pro (52,3 frente a 53,1) a un tercio del coste de entrada (0,14 $ frente a 0,435 $/M), pero sufre un pronunciado acantilado de recuperación ante mutaciones dinámicas del DOM o desafíos 403, repitiendo acciones en bucle en lugar de retroceder.
¿Por qué MiMo-V2.6-Flash tiene dificultades con la recuperación de errores de largo horizonte?
Al activar solo 15B de sus 309B parámetros totales MoE, Flash ofrece una velocidad de generación lineal extraordinaria, pero carece de la profundidad de representación necesaria para diagnosticar fallos en cascada o sintetizar nuevas rutas de recuperación ante imprevistos.
¿Cómo reduce el prompt caching los costes de MiMo-V2.6-Flash?
Las lecturas de acierto de caché se facturan a 0,0028 $ por millón de tokens (un 98% de descuento frente a la tarifa de 0,14 $ no cacheada). Esto permite reutilizar esquemas de herramientas, prompts del sistema extensos y contexto de páginas web capturadas a un coste insignificante.
¿Está disponible MiMo-V2.6-Flash en Tabbit Browser?
La disponibilidad en Tabbit Browser depende del selector de modelos activo de cada cuenta y de las credenciales conectadas. Aunque los pesos y la API son abiertos, Tabbit opera como una capa de orquestación multinavegador y no garantiza acceso preconfigurado universal.