
Como engenheiro que passa grande parte dos seus dias integrando modelos a produtos em produção, o que me importa não é a tabela de classificação de benchmarks; é saber se o modelo consegue sustentar uma execução longa, ruidosa e repleta de chamadas de ferramentas sem exigir babá humana contínua. Quando a Xiaomi disponibilizou sob licença MIT a família MiMo-V2.6 em 22 de setembro de 2026, a indagação dos arquitetos de automação foi direta: será que um modelo MoE esparso de 309B com somente 15B parâmetros ativos a US$ 0,14 de entrada e US$ 0,28 de saída por milhão de tokens pode atuar como cavalo de batalha na produção, ou desmorona diante de atritos comuns da web real?
Detalhei os trade-offs diretos no guia comparativo MiMo-V2.6-Pro vs MiMo-V2.6-Flash, as dinâmicas de cache no artigo de preços do MiMo-V2.6-Flash e os custos do modelo emblemático na análise de preços do MiMo-V2.6-Pro. Os parâmetros brutos podem ser conferidos na página do modelo MiMo-V2.6-Flash (English). Este artigo apresenta uma avaliação técnica transparente e sem concessões.
A dupla de números que define esta análise: 0,8 vs 4,0
O veredito sobre o MiMo-V2.6-Flash é selado por duas métricas de benchmark contraintuitivas:
0,8 ponto de diferença no Automation Bench v1.0.6 (52,3 contra 53,1) versus 4,0 pontos e uma queda de 14,5% no Agents' Last Exam (27,6 contra 31,6).
Esses dois números retratam duas experiências operacionais radicalmente distintas:
O triunfo na automação determinística (52,3 contra 53,1): Em tarefas rotineiras, estruturadas e previsíveis de navegação — cliques em seletores claros, preenchimento de campos, inspeção de DOM e extração de JSON limpo —, o Flash entrega 98,5% do desempenho do modelo topo de linha de 1,02T (MiMo-V2.6-Pro) custando cerca de um terço (US$ 0,14 contra US$ 0,435 por milhão de tokens).
O abismo de recuperação em horizontes longos (27,6 contra 31,6): Quando um fluxo agêntico se depara com imprevistos — como um erro HTTP 403, uma mutação do DOM via hidratação dinâmica ou uma resposta malformada de API —, os 15B parâmetros ativos do Flash degradam em repetições mecânicas sem conseguir diagnosticar o erro e replanejar a rota.
Se o seu fluxo de trabalho for bem delimitado, determinístico e supervisionado, o Flash oferece a melhor relação custo-benefício do mercado. Porém, se você o abandonar sem rédeas em um laço autônomo sem limites rígidos de falha, ele esgotará sua cota de passos repetindo a mesma ação infrutífera.
Destaques fundamentais
Política de preços agressiva: US$ 0,14 por milhão de tokens de entrada sem cache, US$ 0,0028 em leitura de cache (desconto de 98%) e US$ 0,28 de saída, resultando em economia superior a 3 vezes em relação ao Pro.
Eficiência arquitetural MoE: O modelo esparso de 309B mobiliza apenas 15B parâmetros por token gerado, atingindo vazão de 140 a 160 tokens/s em servidores comuns com vLLM, mais que o dobro da velocidade de modelos de ponta tradicionais.
Entrada omnimodal nativa: Processa nativamente texto, imagem, áudio e vídeo em sua janela de 1.048.576 tokens sem depender de adaptadores visuais separados.
Ruptura na recuperação autônoma: Ao marcar 27,6 no Agents' Last Exam, sua capacidade de resolver falhas complexas se mostra limitada, exigindo supervisores externos.
Fronteiras de uso no Tabbit: O Tabbit provê o ecossistema de sessões multiabas e ferramentas do navegador; o acesso ao modelo reflete a configuração de provedores da conta.
Os benchmarks e o quanto confiar neles
A Xiaomi divulgou medições extensas sobre programação, planejamento agêntico e uso de ferramentas. A seguir, veja o comparativo calibrado entre o MiMo-V2.6-Flash e o topo de linha MiMo-V2.6-Pro:
| Benchmark | MiMo-V2.6-Flash | MiMo-V2.6-Pro | Diferença | Significado real em produção |
|---|---|---|---|---|
| Automation Bench v1.0.6 | 52,3 | 53,1 | -0,8 | Navegação de rotina, formulários e extração de DOM praticamente idênticos (margem de erro de ±1,5%). |
| Toolathlon-verified | 73,6 | 76,9 | -3,3 | Execução de ferramentas e esquemas JSON regulares muito estável; Pro sobressai em árvores de ferramentas aninhadas. |
| ProgramBench | 26,0 | 26,5 | -0,5 | Geração de funções isoladas e conversão sintática em perfeita equivalência. |
| MiMo Code Bench | 61,2 | 63,2 | -2,0 | Pro leva vantagem em arquitetura de software abrangente, mas o Flash entrega scripts rotineiros sem falhas. |
| DeepSWE v1.1 | 67,9 | 71,9 | -4,0 | Pro soluciona patches Git multifunção e depuração de repositórios com maior robustez. |
| Agents' Last Exam | 27,6 | 31,6 | -4,0 | Queda de 14,5% na eficiência quando o agente precisa retroceder ou contornar incidentes web em cadeia. |
Dose necessária de prudência analítica:
Ambientes sintéticos assépticos: Testes como o Toolathlon usam esquemas JSON higienizados e fluxos lineares. Na web viva, portais inserem HTML malformado, mecanismos antibot e iframes dinâmicos que testes estáticos simplesmente não capturam.
Seleção favorável de métricas: Lançamentos comerciais sempre destacam os índices mais vistosos. Aspectos cruciais para a operação diária costumam ser omitidos: OCR sob degradação severa, concorrência sob limites de taxa e latência de primeiro token com contextos volumosos.
Declaração de escopo: Benchmarks indicam direções, não garantias contratuais. Obter 52,3 no Automation Bench confirma o domínio dos comandos do navegador, mas não assegura sucesso absoluto em um painel interno corporativo altamente customizado.
Na engenharia de produção, registros práticos superam rankings estáticos. Equipes que operam o Flash relatam extrações de 10.000 páginas web complexas por menos de US$ 2,50 — operação que demandava de US$ 15 a US$ 40 em modelos proprietários fechados.
Três diferenciais legítimos do MiMo-V2.6-Flash
1. A surpresa positiva: ingestão omnimodal nativa na latência de 15B
O aspecto mais empolgante do MiMo-V2.6-Flash não consta nas pontuações de código: é a sua arquitetura omnimodal nativa. Em vez de acoplar modelos de visão separados a uma base textual, o Flash acomoda texto, imagem, vídeo e áudio no mesmo espaço vetorial ao longo de 1.048.576 tokens.
Por manter apenas 15B parâmetros engajados na inferência, processar um PDF digitalizado de 100 páginas com ilustrações ou um arquivo de áudio gera respostas JSON estruturadas a cerca de 140–160 tokens por segundo. Essa abordagem unificada reduz a latência pela metade e simplifica sua arquitetura.
Para aprofundar na gestão de contexto em navegação avançada, consulte nossa explicação sobre o que é um navegador agêntico.
2. Paridade na automação rotineira com um terço do custo
Em chamadas diretas de funções e raspagem de dados previsível, o Flash não fica a dever para modelos substancialmente mais caros. Com 52,3 no Automation Bench e 73,6 no Toolathlon, ele executa tarefas estruturadas com notável consistência.
Com a tarifa de US$ 0,14 na entrada e US$ 0,28 na saída por milhão de tokens, a economia da extração em escala muda de patamar. É possível operar crawlers contínuos a custo marginal ínfimo. Conheça outros casos práticos em nosso guia de automação de navegador.
3. Economia expressiva com prompt caching
O Flash oferece uma das taxas de leitura em cache mais atrativas do ecossistema: US$ 0,0028 por milhão de tokens, o que representa 98,0% de abatimento (50 vezes mais barato).
Em sessões prolongadas ou processos de extração nos quais as instruções do sistema e o DOM de referência permanecem idênticos, as etapas seguintes custam frações irrisórias de centavo. Você pode reenviar 200.000 tokens de contexto de página a cada interação sem comprometer o orçamento.
Limitações práticas e cenários de falha
1. O abismo de recuperação em fluxos longos
A nota 27,6 no Agents' Last Exam escancara a barreira dos 15B parâmetros ativos. Se o script esbarra em uma anomalia (um modal inesperado, um seletor alterado ou expiração de autenticação), o Flash não tem repertório representacional suficiente para deduzir uma rota de escape.
Em vez de retroceder um passo, analisar o histórico e replanejar a estratégia, ele tende a insistir no mesmo clique ou comando incorreto até esgotar o limite de tentativas. Em produção, ele jamais deve rodar de modo desatendido sem supervisores externos.
2. O custo indireto dos tokens de raciocínio
Assim como o modelo Pro, o MiMo-V2.6-Flash conta com modo de pensamento baseado em aprendizado por reforço, cobrando tokens de raciocínio na taxa normal de saída de US$ 0,28/M.
Sua geração é extremamente rápida (140+ tok/s), o que significa que, sem um teto estabelecido, consultas simples podem gerar de 3.000 a 5.000 tokens de deliberação antes de uma resposta curta. Se você não delimitar o processo com max_thinking_tokens, o custo de tarefas triviais pode aumentar dez vezes.
3. Integração e suporte em clientes
Embora os pesos sejam públicos e a API esteja documentada, o suporte em extensões e plataformas varia. No Tabbit, o acesso depende dos provedores e chaves configurados na sua conta.
A voz dos desenvolvedores na comunidade
As opiniões nos fóruns de engenharia se dividem claramente: entusiasmo geral com a eficiência em processamento massivo e cautela redobrada contra laços de agentes autônomos sem rédeas.
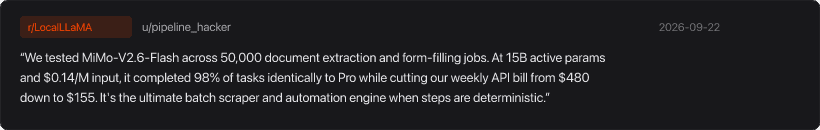
No r/LocalLLaMA, o usuário u/pipeline_hacker compartilhou métricas de uma infraestrutura com 50.000 requisições:
"Testamos o MiMo-V2.6-Flash em 50.000 extrações documentais e envios de formulários. Com 15B parâmetros ativos e US$ 0,14/M de entrada, ele concluiu 98% das tarefas de modo idêntico ao Pro, enquanto reduziu nossa fatura semanal de US$ 480 para US$ 155. É o motor definitivo para automação determinística."
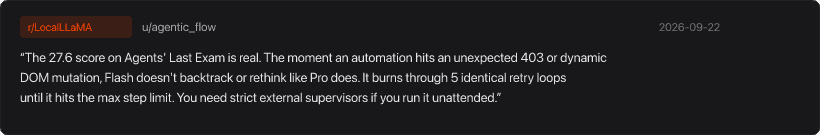
Por outro lado, u/agentic_flow destacou o ponto cego da autorrecuperação:
"A pontuação 27,6 no Agents' Last Exam condiz com a prática. Se o processo encontra um 403 ou alteração no DOM, o Flash não reformula como o Pro; ele repete 5 vezes a mesma tentativa até estourar o limite de passos. Para execuções desatendidas, um supervisor externo é obrigatório."
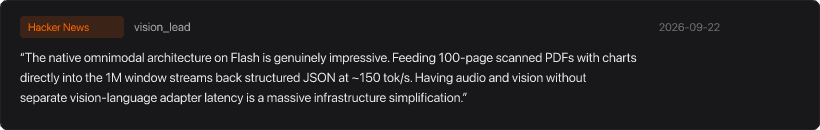
No Hacker News, vision_lead ressaltou a versatilidade multimodal:
"A arquitetura omnimodal nativa do Flash é impressionante. Submeter um PDF digitalizado de 100 páginas com gráficos para a janela de 1M gera JSON estruturado a ~150 tok/s. Eliminar adaptadores visuais dedicados traz um alívio enorme para a infraestrutura."
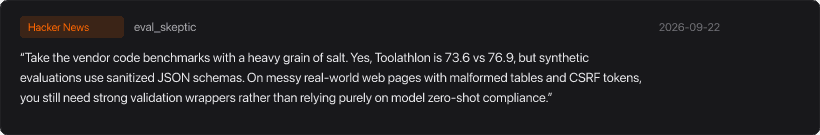
Por fim, eval_skeptic aconselhou comedimento:
"Benchmarks oficiais exigem cautela. Um 73,6 contra 76,9 no Toolathlon soa ótimo, mas lida com dados higienizados. Na internet real, com tabelas desconfiguradas e tokens CSRF, camadas de validação defensiva continuam indispensáveis."
Nosso julgamento editorial coincide integralmente: o Flash é espetacular para fluxos bem delimitados, mas requer arquitetura defensiva externa ao lidar com a web imprevisível.
Matriz de decisão por carga de trabalho: escolha pelo perfil da tarefa
Em vez de se guiar por apelos de marketing, fundamente sua decisão nas características reais do seu fluxo:
| Carga de trabalho ou restrição | Recomendação | Parâmetro / Modo sugerido | Justificativa técnica | Ponto de atenção |
|---|---|---|---|---|
| Raspagem e extração web em alta escala | Adotar o MiMo-V2.6-Flash | Modo padrão (pensamento desativado ou mínimo) | US$ 0,14/M na entrada e 150 tok/s asseguram rentabilidade ideal | Validação estrita de esquema com JSON Schema obrigatória. |
| Análise de documentos multimodais e áudios | Adotar o MiMo-V2.6-Flash | Modo padrão | Contexto omnimodal nativo de 1M sem latência de adaptadores | Saída estritamente textual; auditar acurácia de transcrição. |
| Automação determinística de navegador | Flash com supervisor externo | Modo padrão + retestes limitados | 52,3 no Automation Bench empata com o Pro por um terço do custo | Criar mecanismos externos para interromper laços infinitos. |
| Refatoração complexa de código e tarefas Git | Optar pelo MiMo-V2.6-Pro | Modo de raciocínio ativado (RL) | 42B parâmetros ativos essenciais para diagnóstico e reversão | Custo de saída 3,1 vezes maior (US$ 0,87/M). |
| Pesquisa web interativa em múltiplas abas | Tabbit Browser orquestrando modelos | Modo colaborativo padrão | Gestão de abas diminui o consumo excessivo de tokens em prompts | Disponibilidade online conforme chaves cadastradas na conta. |
Se o seu objetivo é contar com um agente de navegação capaz de interagir em múltiplas abas sem intervenção humana contínua em cada prompt, sua busca está focada na camada errada. Veja a próxima seção.
Um modelo não é um agente: por que o Tabbit é fundamental
Modelos de linguagem puros são unidades de processamento, não aplicações acabadas. Pontuações de laboratório não dizem como o modelo reage a cookies de sessão expirados, falhas de CSRF Token, alternância de abas ou Shadow DOMs dinâmicos. Quando o layout de um sistema corporativo muda sutilmente, um modelo isolado costuma alucinar ou travar.
É por esse motivo que desenvolvemos o Tabbit Browser.
O Tabbit fornece o ecossistema de execução que os modelos isolados não possuem:
Orquestração de sessões multiabas: Em vez de despejar código HTML bruto e desordenado no prompt, o Tabbit monitora abas ativas, acompanha o estado do DOM e alimenta o modelo apenas com o contexto enxuto e necessário.
Gatilhos de segurança determinísticos: Ao acionar modelos ágeis como o MiMo-V2.6-Flash, o Tabbit estipula limites de passos e audita o formato estruturado das saídas, desarmando laços antes do desperdício de créditos.
Roteamento inteligente de modelos: Encaminhe tarefas pesadas de coleta para o MiMo-V2.6-Flash com máxima velocidade e baixo custo, direcionando raciocínios arquiteturais densos para o MiMo-V2.6-Pro ou Gemini.
Para compreender como a orquestração avançada eleva sua produtividade diária, conheça nossa explicação sobre a arquitetura do Tabbit AI Browser, examine as melhores práticas para o Tabbit Browser, ou confira o panorama de navegadores com IA em 2026 e a comparativa de navegadores agênticos.
 Tabbit Browser
Antes de definir sua arquitetura final, examine o guia de preços do MiMo-V2.6-Flash, avalie o comparativo arquitetural Pro vs Flash e valide seu fluxo de trabalho em um ambiente de testes devidamente controlado.

Perguntas frequentes
Vale a pena usar o MiMo-V2.6-Flash em produção?
Sim, especialmente para extração determinística em lote, pipelines de dados estruturados e automação rotineira de navegador em que a latência e o custo por token são decisivos. Contudo, para engenharia de software multifunção ou laços de agentes autônomos que demandam retrocesso constante, modelos de topo como o MiMo-V2.6-Pro continuam indispensáveis.
Como o MiMo-V2.6-Flash se compara ao MiMo-V2.6-Pro nos benchmarks?
O Flash fica a apenas 0,8 ponto do Pro no Automation Bench (52,3 contra 53,1) e a 3,3 pontos no Toolathlon (73,6 contra 76,9), consumindo cerca de 32% do custo. No entanto, no Agents' Last Exam, o Flash fica 4,0 pontos atrás (27,6 contra 31,6), evidenciando uma queda de 14,5% na capacidade de contornar erros dinâmicos na web.
Qual é a âncora narrativa por trás da paridade de 0,8 ponto em automação?
A âncora reside no fato de o Flash atingir 98,5% da pontuação do Pro em automação rotineira (52,3 contra 53,1) com um terço do custo de entrada (US$ 0,14 contra US$ 0,435/M), mas sofrer um declínio acentuado diante de mutações do DOM ou bloqueios 403, repetindo ações em laço em vez de replanejar.
Por que o MiMo-V2.6-Flash tem dificuldades na recuperação de erros de longo horizonte?
Ao ativar apenas 15B dos seus 309B parâmetros MoE totais, o Flash oferece altíssima velocidade de geração, mas carece da capacidade de representação paramétrica necessária para diagnosticar falhas em cascata e sintetizar novas alternativas de solução.
Como o prompt caching barateia os custos do MiMo-V2.6-Flash?
A leitura de cache é cobrada a US$ 0,0028 por milhão de tokens (desconto de 98% em relação à taxa sem cache de US$ 0,14). Isso possibilita reaproveitar esquemas de ferramentas extensos e contexto de páginas web rastreadas com impacto financeiro mínimo.
O MiMo-V2.6-Flash está disponível no Tabbit Browser?
A disponibilidade no Tabbit Browser depende do seletor de modelos da sua conta e das credenciais vinculadas. Embora os pesos e a API sejam públicos, o Tabbit atua como ambiente de orquestração multinavegador e não garante acesso pré-configurado irrestrito a todos.