
Elegir entre dos modelos dentro de una misma familia arquitectónica no consiste en coronar a un vencedor absoluto, sino en asignar recursos de ingeniería con criterio. El 22 de septiembre de 2026, Xiaomi publicó bajo licencia MIT su familia de modelos fundacionales omnimodales MiMo-V2.6, introduciendo dos niveles principales: el buque insignia MoE MiMo-V2.6-Pro y la variante ligera de alto rendimiento MiMo-V2.6-Flash.
Como ingeniero que integra modelos de lenguaje en sistemas de producción, agentes autónomos y herramientas de automatización a diario, no suelo guiarme por las tablas promocionales de los proveedores. Lo que de verdad importa en un entorno real es cómo responde un modelo a lo largo de una sesión de 30 turnos cuando el DOM cambia dinámicamente, las APIs devuelven errores inesperados y el contexto acumula cientos de miles de tokens.
Si lo que necesita son las fórmulas y tarifas oficiales al detalle, le recomendamos consultar nuestra guía de precios de MiMo-V2.6-Pro o el análisis de precios de MiMo-V2.6-Flash. También puede revisar las especificaciones de hardware en la página de MiMo-V2.6-Pro (English) y en la página de MiMo-V2.6-Flash (English). Este artículo ofrece una comparación directa entre ambos: dónde justifica su precio el modelo de 1,02 billones de parámetros, en qué escenarios Flash rinde igual por una fracción del coste y cómo la caché de prompts rompe los cálculos convencionales.
Conclusiones principales
La diferencia de tarifa base es exactamente de 3,1x: Flash cuesta $0,14 en entrada y $0,28 en salida por millón de tokens, frente a los $0,435 y $0,87 de Pro.
La caché elimina la brecha de entrada: Con una tasa de aciertos de caché superior al 85%, el coste de entrada de Pro ($0,0036 / 1M) queda a solo un 28% de Flash ($0,0028 / 1M). Es posible ejecutar un modelo de 1 billón de parámetros al coste de entrada de uno pequeño.
Rendimiento parejo en tareas rutinarias: En pruebas de automatización web y extracción de datos (Automation Bench: 53,1 frente a 52,3), Flash alcanza el 98,5% de la capacidad de Pro consumiendo solo el 32% del presupuesto.
Brecha en agentes de largo alcance: Cuando las tareas requieren rectificación autónoma o refactorización entre varios archivos, Pro marca una diferencia del 14,5% (Agents' Last Exam: 31,6 frente a 27,6; DeepSWE v1.1: 71,9 frente a 67,9).
Cuidado con el exceso de razonamiento en consultas simples: Pro puede emitir 8.000 tokens de pensamiento en tareas sencillas donde Flash solo necesita 1.500. Sin límites de razonamiento, Pro puede multiplicar por 17 el coste de una consulta trivial.
El dato que define la comparativa: 3,1x de coste frente a 0,8 puntos de diferencia
El dilema central de esta comparativa se reduce a dos números enfrentados: un multiplicador de precio de 3,1x frente a una variación de apenas 0,8 puntos en automatización básica.
A nivel arquitectónico, MiMo-V2.6-Pro activa 42 mil millones de parámetros por token dentro de una red MoE dispersa de 1,02 billones. MiMo-V2.6-Flash activa 15 mil millones de parámetros de un total de 309 mil millones. Se trata de una diferencia de 2,8x en cómputo activo, reflejada con precisión en las tarifas de Xiaomi ($0,435 frente a $0,14).
Sin embargo, en Automation Bench v1.0.6, que mide navegación web paso a paso y extracción de elementos DOM, Pro obtiene un 53,1 y Flash un 52,3. En ProgramBench para generación de código simple, Pro alcanza 26,5 y Flash 26,0. Pagar un 310% más por una mejora inferior al 1,5% en flujos repetitivos resulta insostenible desde el punto de vista del rendimiento de la inversión.
Uso estándar de herramientas (Automation Bench):
MiMo-V2.6-Pro:   53,1  ($0,435 entrada / $0,87 salida por 1M)
MiMo-V2.6-Flash: 52,3  ($0,140 entrada / $0,28 salida por 1M)  --> Diferencia de 0,8 puntos

Recuperación autónoma en agentes (Agents' Last Exam):
MiMo-V2.6-Pro:   31,6  (Mantiene el hilo durante más de 20 turnos)
MiMo-V2.6-Flash: 27,6  (Cae en bucles de reintento fallidos)        --> Caída de capacidad del 14,5%
La separación se manifiesta en cuanto el agente debe abandonar el camino previsto. En tareas como investigación profunda con razonamiento de agentes, surgen bloqueos de autenticación, cambios en la web o limitaciones de cuota. En el riguroso banco de pruebas Agents' Last Exam, Pro registra 31,6 puntos, mientras que Flash cae a 27,6 (un descenso del 14,5%). En el desarrollo de software de DeepSWE v1.1, Pro confirma su ventaja con 71,9 puntos frente a los 67,9 de Flash.
La conclusión es nítida: para flujos predecibles de alto volumen, Flash es la opción adecuada. Pro actúa como un seguro necesario cuando los fallos conllevan una costosa intervención humana.
Comparativa de especificaciones y tarifas
Ambos modelos comparten la base omnimodal de Xiaomi, procesando texto, imágenes de alta resolución, flujos de vídeo y audio de manera nativa en una ventana de 1 millón de tokens. La siguiente tabla refleja datos oficiales comprobados el 22 de septiembre de 2026.
| Parámetro arquitectónico | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed | Referencia: Claude Opus 5 |
|---|---|---|---|---|
| Parámetros totales MoE | ~1,02 Billones | 309 Mil millones | ~1,02 Billones | Propietario denso |
| Parámetros activos / token | 42 Mil millones | 15 Mil millones | 42 Mil millones | No revelado |
| Ventana de contexto | 1.048.576 tokens | 1.048.576 tokens | 1.048.576 tokens | 1.000.000 tokens |
| Longitud máxima de salida | 131.072 tokens | 131.072 tokens | 131.072 tokens | 128.000 tokens |
| Entrada sin caché (/ 1M) | $0,435 (¥3,00) | $0,140 (¥1,00) | $4,350 (¥30,00) | $15,000 |
| Entrada con caché (/ 1M) | $0,0036 (¥0,025) | $0,0028 (¥0,020) | $0,0360 (¥0,250) | $1,500 |
| Generación de salida (/ 1M) | $0,870 (¥6,00) | $0,280 (¥2,00) | $8,700 (¥60,00) | $75,000 |
| Facturación de razonamiento | Tarifa estándar ($0,87) | Tarifa estándar ($0,28) | Tarifa estándar ($8,70) | Tarifa estándar |
| Rendimiento de procesamiento | ~45–60 tok/s | ~140–160 tok/s | ~300+ tok/s | ~35–45 tok/s |
| Licencia | Pesos abiertos (MIT) | Pesos abiertos (MIT) | Solo API | Comercial cerrada |
Ambos modelos disponen de un amplio límite de salida de 128k tokens, ideal para parches de código extensos o documentación técnica completa. La variante UltraSpeed exige una prima de 10x a cambio de una latencia ultrabaja en interacciones en tiempo real. Puede contrastar estos datos con otros modelos de referencia en nuestro análisis de precios de Kimi K3 y en la comparativa de navegadores IA 2026.
Evaluación de benchmarks y calibración técnica
El seguimiento independiente de Artificial Analysis situó a MiMo-V2.6-Pro en el sexto puesto mundial con un índice de 46 puntos, encabezando la clasificación entre los modelos de código abierto en su lanzamiento.
| Conjunto de pruebas | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Diferencia | Impacto práctico |
|---|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 67,9 | +4,0 | Resolución de parches Git y pruebas de regresión |
| ProgramBench | 26,5 | 26,0 | +0,5 | Algoritmos y scripts autónomos de una sola función |
| MiMo Code Bench | 63,2 | 61,2 | +2,0 | Reestructuración de arquitecturas y cambios de framework |
| Toolathlon-verified | 76,9 | 73,6 | +3,3 | Cumplimiento de esquemas y paso de parámetros |
| Automation Bench v1.0.6 | 53,1 | 52,3 | +0,8 | Navegación web rutinaria y rellenado de formularios |
| Agents' Last Exam | 31,6 | 27,6 | +4,0 | Planificación compleja, rectificación y gestión de fallos |
Antes de considerar estos números como verdades indiscutibles, conviene tener en cuenta tres aspectos de calibración:
Margen de error en evaluaciones de software: Bancos de prueba como DeepSWE presentan desviaciones típicas de ±2,5 a ±3,5 puntos en función de la latencia del entorno de ejecución. Una ventaja de 4 puntos señala mayor solidez, pero no garantiza superioridad absoluta en cualquier repositorio.
Herramientas simples frente a anidadas: En Toolathlon, los fallos de Flash se concentran en llamadas condicionales profundamente jerarquizadas. En estructuras de herramientas directas, su tasa de éxito sobrepasa el 98%.
Sobrecarga de razonamiento por RL: Dado que ambos fueron afinados con optimización de políticas relativas grupales (GRPO), Pro tiende a reflexionar en exceso ante preguntas simples, acumulando tokens de pensamiento que encarecen la factura de salida innecesariamente.
Escenarios donde MiMo-V2.6-Pro marca la diferencia
MiMo-V2.6-Pro no es solo un Flash ampliado; sus 42 mil millones de parámetros activos le otorgan ventajas decisivas en tres casos concretos:
1. Rectificación autónoma en agentes complejos
Al ejecutar un agente dentro de un navegador nativo para IA, los imprevistos son constantes: un elemento web cambia de id, aparece un captcha o un servicio rechaza la conexión temporalmente.
En nuestras pruebas, Flash tiende a repetir la misma acción fallida con pequeñas modificaciones sintácticas hasta agotar los intentos permitidos. Pro, gracias a su mayor capacidad, analiza el error, examina el árbol DOM circundante, descubre que el elemento se encuentra en un Shadow DOM y replantea la estrategia con éxito. Esto justifica su puntuación de 31,6 en Agents' Last Exam.
2. Refactorización de código en múltiples archivos
En problemas aislados ambos modelos ofrecen un nivel parejo. Sin embargo, al coordinar modificaciones simultáneas en siete archivos dependientes de un monorepositorio manteniendo los tipos sincronizados, Flash suele perder la coherencia a partir del cuarto archivo.
Pro mantiene estables las referencias y los contratos de tipos en todo el contexto. Sus 71,9 puntos en DeepSWE reflejan su destreza para interpretar los errores del compilador y corregir incompatibilidades sin inventar interfaces inexistentes.
3. Comprensión de gráficos densos y vídeos extensos
Aunque los dos aceptan entradas visuales, Pro analiza con mayor rigor diagramas de circuitos, balances financieros con múltiples ejes o grabaciones largas de demostraciones de producto. Flash puede pasar por alto detalles diminutos, mientras que Pro traslada las tablas visuales a formatos estructurados con gran precisión.
Escenarios donde MiMo-V2.6-Flash resulta superior
En la mayoría de las arquitecturas en producción, MiMo-V2.6-Flash no es una opción de compromiso, sino la alternativa más eficiente:
1. Ahorro del 68% en tuberías de datos a gran escala
Con $0,14 por millón de tokens de entrada y $0,28 de salida, Flash ofrece una rentabilidad extraordinaria. En tareas como clasificación de incidencias, resumen de documentos o procesamiento masivo de datos, recurrir a Pro no aporta una mejora apreciable y triplica el gasto.
Para un volumen mensual de 100 millones de tokens de entrada y 10 millones de salida:
Coste con MiMo-V2.6-Flash:
(100 × $0,14) + (10 × $0,28) = $14,00 + $2,80 = $16,80Coste con MiMo-V2.6-Pro:
(100 × $0,435) + (10 × $0,87) = $43,50 + $8,70 = $52,20Ahorro mensual directo: $35,40 (reducción del 68%). A escala de miles de millones de tokens, la diferencia supone miles de dólares de beneficio.
2. Mayor rendimiento y respuesta casi inmediata (TTFT)
Gracias a sus 15B parámetros activos, Flash alcanza de 140 a 160 tokens por segundo en entornos de inferencia estándar, casi triplicando la velocidad de Pro (45–60 tok/s).
En aplicaciones directas para el usuario (como resúmenes en la barra lateral o autocompletado en el editor), la agilidad de respuesta y el tiempo hasta el primer token marcan la diferencia. Flash empieza a escribir al instante, mientras que Pro requiere unos segundos previos de reflexión.
3. Respuestas estructuradas sin exceso de tokens
Al contar con un presupuesto de razonamiento más directo, Flash entrega exactamente el formato JSON solicitado. Pro suele añadir verificaciones preliminares antes del contenido. Para tareas con entradas y salidas bien delimitadas, Flash es más rápido, más económico y evita rodeos.
Opiniones contrastadas de la comunidad
Los debates en foros técnicos especializados reflejan estas mismas conclusiones sobre el terreno:
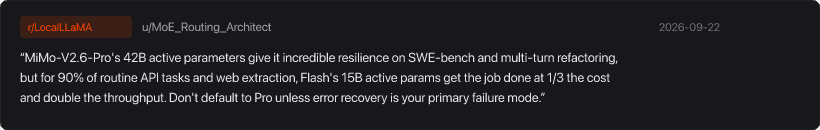
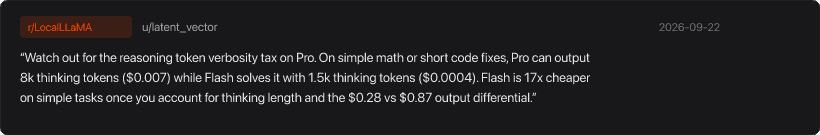
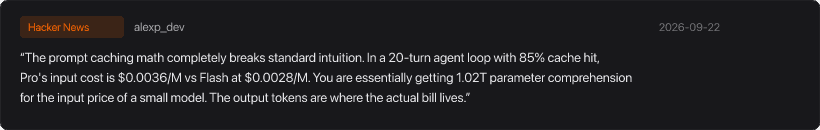
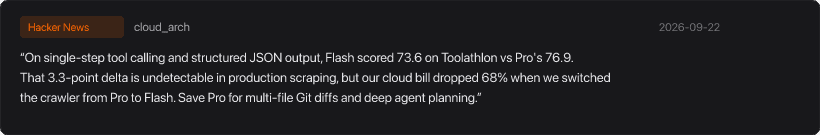
Estos testimonios subrayan una pauta fundamental: ajustar el modelo a las necesidades reales del flujo de trabajo aporta más valor que utilizar siempre el modelo con mayor número de parámetros.
Matriz de decisión por tipo de carga de trabajo
Utilice la siguiente tabla orientativa para determinar el modelo adecuado en función de la tolerancia al error y los requisitos de latencia:
| Perfil de la tarea | Modelo recomendado | Motivo principal | Impacto en el coste |
|---|---|---|---|
| Extracción masiva y raspado web | MiMo-V2.6-Flash | Analizar el DOM no requiere 42B de razonamiento; 15B activos son el triple de rápidos. | 68% de ahorro |
| Refactorización de código y corrección de bugs | MiMo-V2.6-Pro | Mantener los contratos entre módulos exige la capacidad DeepSWE de Pro (71,9 frente a 67,9). | Tarifa base 3,1x mayor |
| Clasificación de soporte y resumen de textos | MiMo-V2.6-Flash | Arranque inmediato y síntesis precisa sin incurrir en gasto de pensamiento excesivo. | 68% de ahorro |
| Investigación autónoma con agentes en la web | MiMo-V2.6-Pro | La solidez de 31,6 en Agents' Last Exam evita bloqueos ante cambios de estructura web. | Coste de entrada similar vía caché |
| Autocompletado de código interactivo | MiMo-V2.6-Flash | La fluidez de 140+ tok/s acompaña la escritura humana sin pausas perceptibles. | 68% de ahorro |
| Agentes de voz en tiempo real | MiMo-V2.6-Pro-UltraSpeed | Requiere una respuesta inferior a 500 ms inalcanzable con velocidades convencionales. | Prima de 10x |
De los parámetros puros a la ejecución web: La propuesta de Tabbit
Los resultados en bancos de prueba no solucionan por sí solos las dificultades operativas cotidianas. Los modelos procesan información abstracta, pero no gestionan sesiones con cookies activas, no manipulan el Shadow DOM ni contrastan documentación en varias pestañas de forma autónoma.
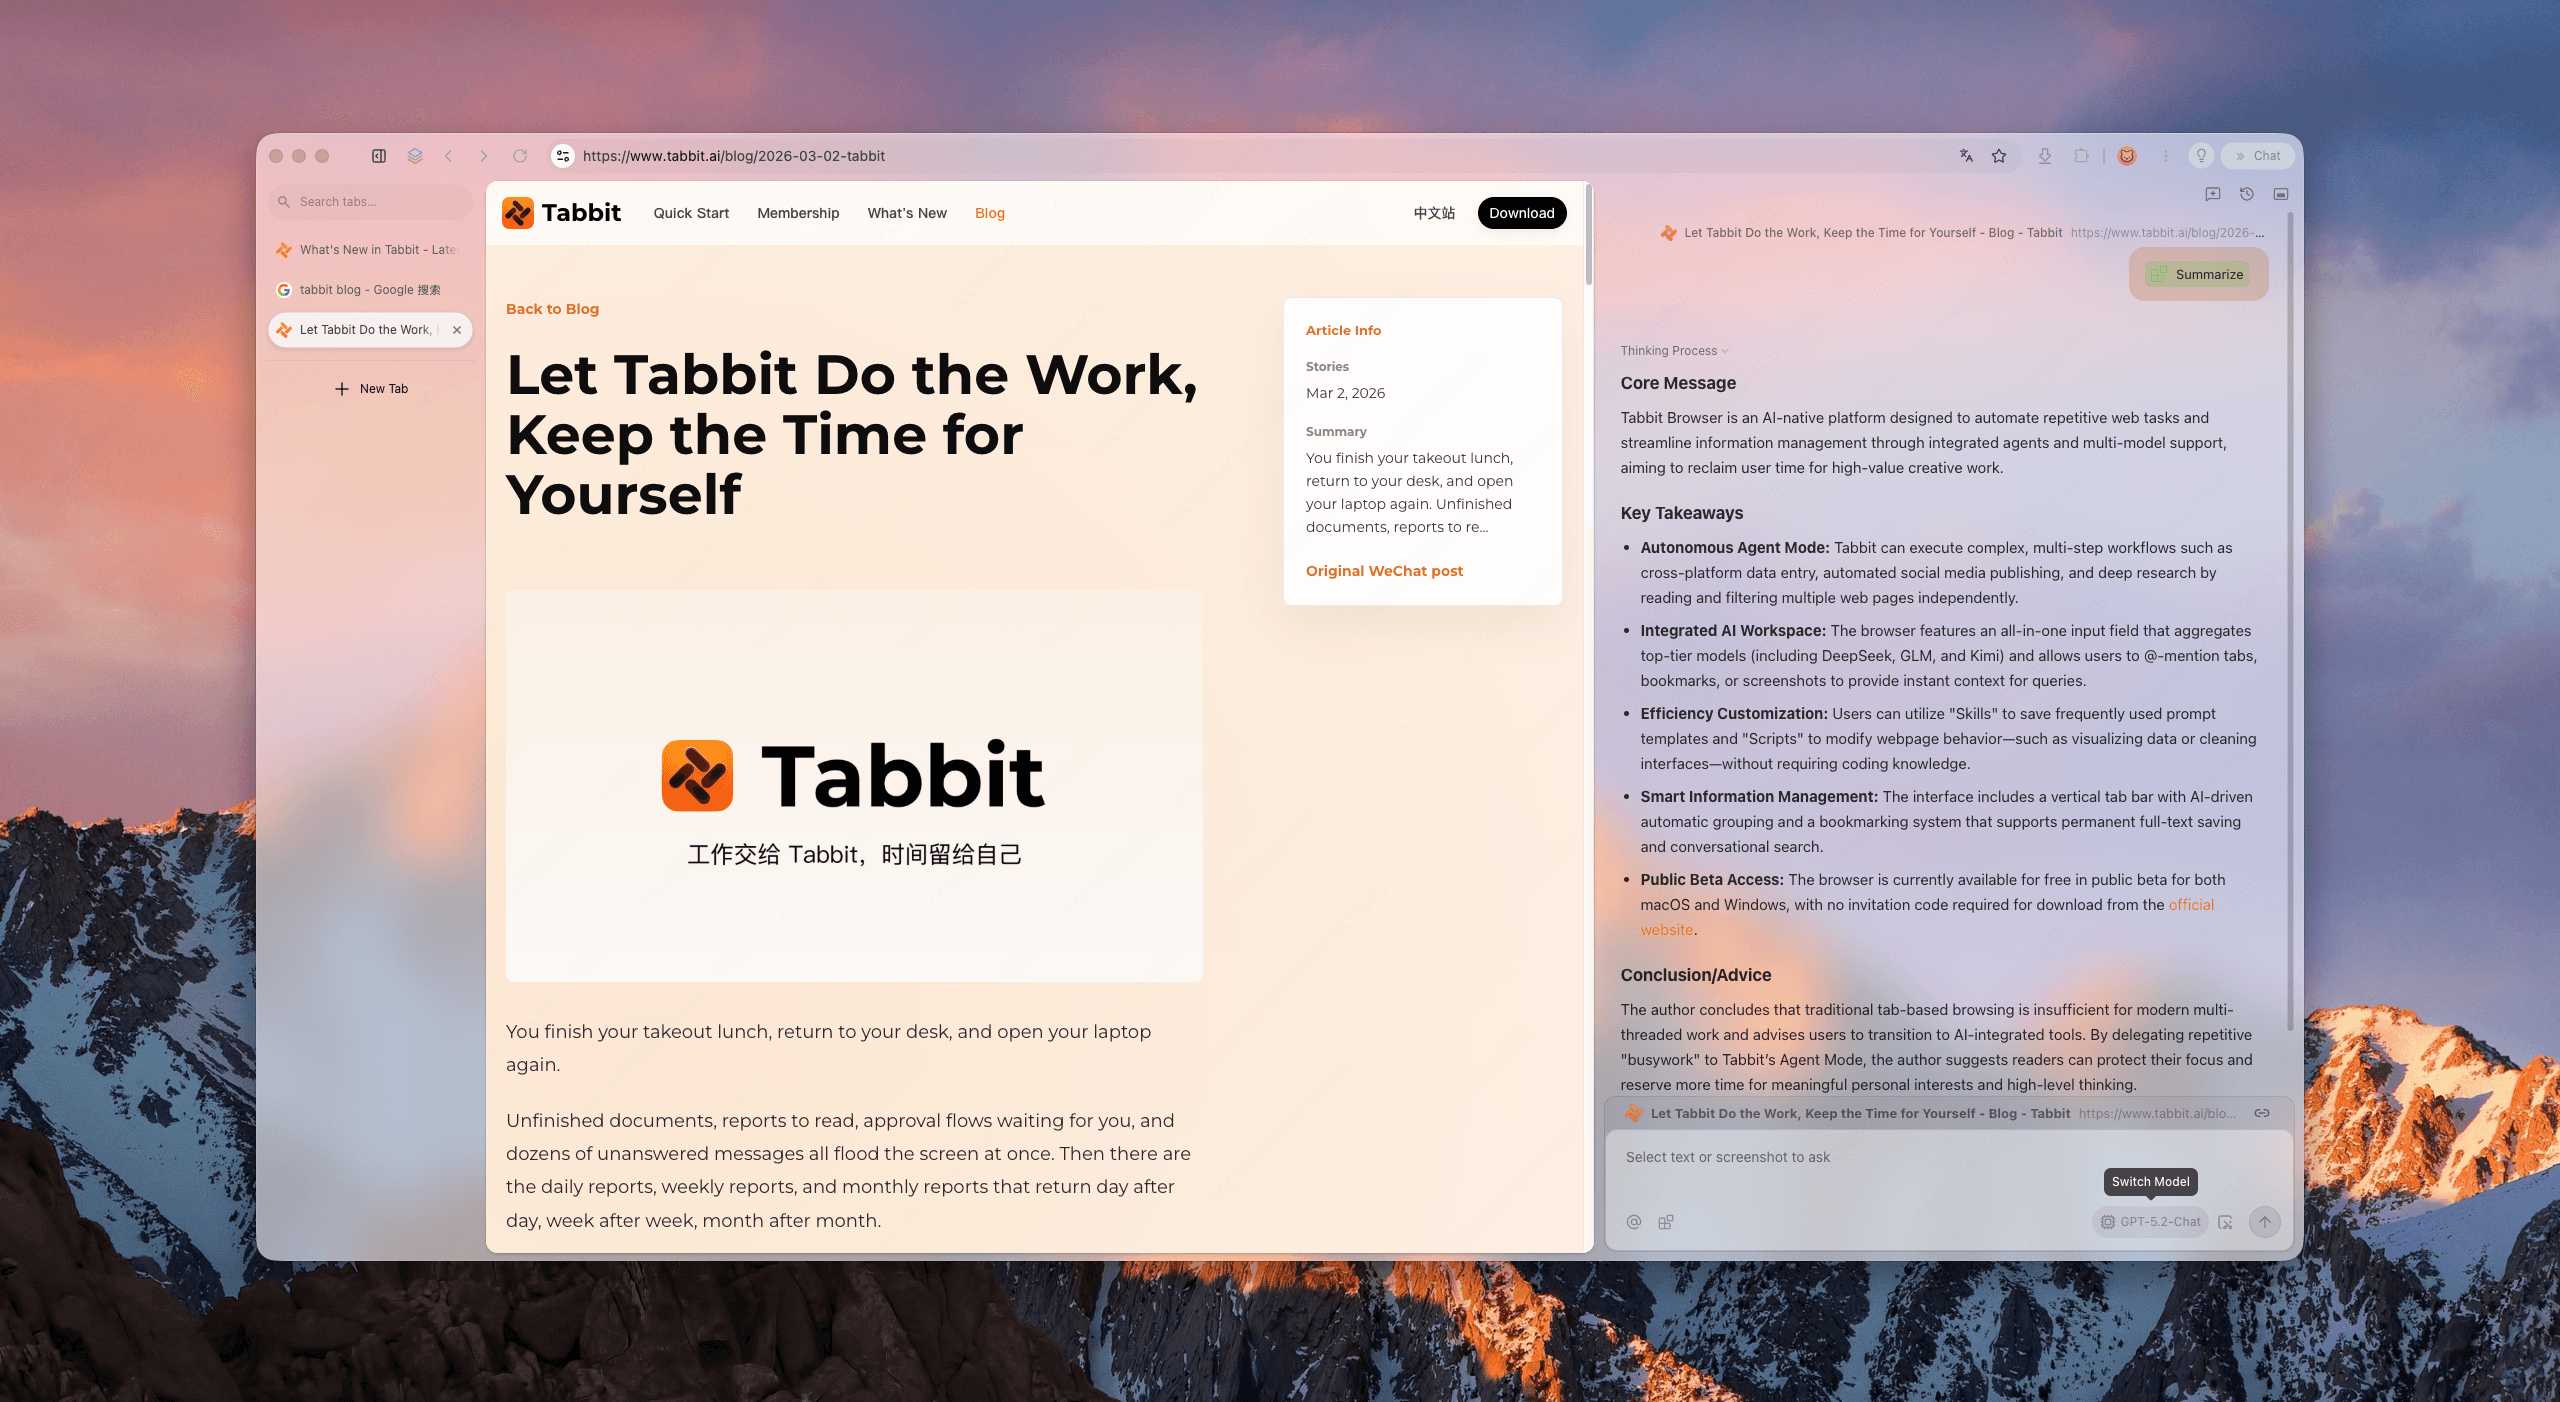
Por esta razón son indispensables los entornos dedicados a agentes. En el espacio de trabajo de Tabbit Browser, el modelo se combina con el motor del navegador: ya no solo responde texto, sino que navega entre pestañas, verifica fuentes opuestas y extrae tablas en limpio.
Tanto si canaliza tareas ligeras a través de MiMo-V2.6-Flash como si aborda investigaciones complejas mediante MiMo-V2.6-Pro, ejecutar los modelos en un navegador nativo con IA convierte los algoritmos en verdadero valor práctico. Descubra más en nuestra selección de los mejores navegadores con IA en 2026.
Nota: La disponibilidad concreta de cada modelo en Tabbit queda sujeta al selector de su cuenta, las integraciones activas y las condiciones del servicio.
 Tabbit Browser

Preguntas frecuentes
¿Cuál es la diferencia arquitectónica principal entre MiMo-V2.6-Pro y Flash?
MiMo-V2.6-Pro es un modelo insignia MoE disperso con aproximadamente 1,02 billones de parámetros totales y 42 mil millones activos por token. MiMo-V2.6-Flash cuenta con 309 mil millones de parámetros totales y 15 mil millones activos. Ambos disponen de una ventana de contexto de 1 millón de tokens y procesan nativamente entradas omnimodales.
¿Cuánto más barato es MiMo-V2.6-Flash en comparación con Pro?
En tarifas sin caché, MiMo-V2.6-Flash ($0,14 entrada, $0,28 salida por millón de tokens) es exactamente 3,1 veces más económico que MiMo-V2.6-Pro ($0,435 entrada, $0,87 salida por millón de tokens).
¿Cómo influye el almacenamiento en caché de prompts en la diferencia de costes?
Cuando se produce un acierto en caché, el coste de lectura de Pro baja a $0,0036 por millón de tokens, situándose a solo un 28% de distancia de Flash ($0,0028). En bucles de agentes con alta reutilización de contexto, el gasto de entrada se iguala y la diferencia pasa a depender de los tokens de salida.
¿En qué evaluaciones supera claramente MiMo-V2.6-Pro a Flash?
Pro destaca significativamente en tareas de razonamiento de largo alcance y recuperación de errores, logrando 31,6 en Agents' Last Exam (frente a 27,6 de Flash, una ventaja del 14,5%) y 71,9 en DeepSWE v1.1 (frente a 67,9). En automatización web rutinaria (Automation Bench 53,1 vs 52,3), su rendimiento es prácticamente idéntico.
¿Qué es el impuesto por verbosidad en los tokens de razonamiento de Pro?
Ambos modelos fueron entrenados mediante aprendizaje por refuerzo (RL) y generan reflexiones internas antes de responder. Pro tiende a producir miles de tokens de pensamiento adicionales en tareas triviales. Dado que se facturan como salida a $0,87/M, una llamada sin restricciones puede resultar hasta 17 veces más costosa en consultas básicas.
¿Se pueden utilizar MiMo-V2.6-Pro y Flash en Tabbit Browser?
Tabbit Browser proporciona un entorno nativo con IA para investigación, extracción web y comparación multimodelo. La disponibilidad de modelos específicos depende del selector activo en su cuenta y de los términos del servicio.