
在同一個模型家族內進行選型,從來不是非黑即白的簡單裁判,而是一場工程資源與任務複雜度的精細配置。2026 年 9 月 22 日,小米在 MIT 協議下正式開源了全模態大模型家族 MiMo-V2.6,並同步推出了兩個主力層級:旗艦混合專家模型 MiMo-V2.6-Pro 與輕量高吞吐模型 MiMo-V2.6-Flash。
作為一名每天將大模型接入真實軟體系統、自動化採集流程與 Agent 工作流程的工程師,我向來不依賴廠商發布時的行銷排行榜。在實際生產場景裡,真正決定成敗的是:當一個網頁 DOM 動態變更、API 返回偶發錯誤、上下文累積到幾十萬 token 時,模型能不能穩定完成長達 30 步的複雜鏈條而不崩潰。
如果你主要關心費率核算細節,可以先閱讀我們的 MiMo-V2.6-Pro 定價指南 或 MiMo-V2.6-Flash 定價實測;也可以在 MiMo-V2.6-Pro 模型專頁 (简体中文) 與 MiMo-V2.6-Flash 模型專頁 (简体中文) 查看參數定義。本文是一份硬核的工程對照指南:到底在什麼場景下 1.02 兆參數的旗艦能夠證明溢價,在什麼工作負載下 Flash 能以不到三分之一的成本交付完全一致的結果,以及為什麼前綴快取機制會顛覆我們對兩者的成本直覺。
核心結論
未快取費率相差 3.1 倍:Flash 的輸入每百萬 token 1.00 元($0.14)、輸出 2.00 元($0.28);Pro 輸入 3.00 元($0.435)、輸出 6.00 元($0.87)。
快取命中抹平輸入差異:在 85% 以上前綴快取命中率的場景中,Pro 快取讀取費僅 0.025 元/百萬 token($0.0036),與 Flash 的 0.020 元($0.0028)幾乎無差,相當於用小型模型的輸入成本運行萬億級旗艦。
常規自動化旗鼓相當:在標準網頁導航、表單提取與 API 格式化評測中(Automation Bench: 53.1 對 52.3),Flash 達到了 Pro 98.5% 的表現,但花費只有後者的 32%。
長程 Agent 的斷崖落差:一旦任務進入跨多檔案的複雜容錯、程式碼架構重構與未知異常回溯,Pro 建立了 14.5% 的明顯壁壘(Agents' Last Exam: 31.6 對 27.6;DeepSWE v1.1: 71.9 對 67.9)。
簡單查詢謹防思考膨脹:Pro 在簡單任務中可能生成 8,000 個思考 token,而 Flash 僅需 1,500 個。在不限制思考預算時,Pro 在小任務上的成本可能飆升到 Flash 的 17 倍。
決定戰局的關鍵數字:3.1 倍價格差 vs 0.8 分的自動化差距
這場對比最反直覺的核心數字是一對矛盾指標:3.1 倍的價格乘數,對比 0.8 分的基礎自動化分差。
在硬體架構層面,MiMo-V2.6-Pro 從 1.02 兆總參數的 MoE 網路中啟動 420 億活躍參數;MiMo-V2.6-Flash 則從 3090 億總參數中啟動 150 億活躍參數。兩者有 2.8 倍的啟動算力差距,小米在 API 報價上也給出了 3 元 vs 1 元($0.435 對 $0.14)的倍數。
然而在 Automation Bench v1.0.6(衡量多步驟網頁點擊、數據提取與 DOM 交互)的測試中,Pro 得分為 53.1,Flash 得分為 52.3。在 ProgramBench 單一函式程式碼生成中,Pro 得分為 26.5,Flash 得分為 26.0。如果你的業務主要是確定性的數據提取或日常輕量程式碼編寫,為不到 1.5% 的邊際提升支付 310% 的溢價顯然不符合成本效益。
常規工具調用(Automation Bench):
MiMo-V2.6-Pro:   53.1  (輸入 3.00 元 / 輸出 6.00 元 每百萬 token)
MiMo-V2.6-Flash: 52.3  (輸入 1.00 元 / 輸出 2.00 元 每百萬 token)  --> 差距僅 0.8 分

長程 Agent 容錯與自癒(Agents' Last Exam):
MiMo-V2.6-Pro:   31.6  (在 20 輪交互後維持全局狀態)
MiMo-V2.6-Flash: 27.6  (容易陷入死循環重試)                  --> 能力驟降 14.5%
分水嶺出現在任務脫離確定性路徑的時刻。在諸如 深度推理與 Agent 調研 這類場景中,爬蟲會遭遇反爬阻攔、表單變更或動態驗證碼。在嚴苛的 Agents' Last Exam 基準上,Pro 取得 31.6 分,而 Flash 跌落至 27.6 分(降幅達 14.5%)。在工程實測 DeepSWE v1.1 中,Pro 的 71.9 分 同樣顯著壓制 Flash 的 67.9 分。
結論非常清晰:確定性、高吞吐的流水線選 Flash;一旦任務需要自主回溯或失敗成本極高,Pro 是必不可少的保險繩。
規格、架構與定價一覽
兩款模型均繼承了小米的原生全模態底座,在一個長達 100 萬 token 的超大上下文窗口中同時支援文字、高解析度圖像、視訊流與音訊輸入。下方規格於 2026 年 9 月 22 日核對自官方技術文檔。
| 架構維度 | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed | 參考:Claude Opus 5 |
|---|---|---|---|---|
| MoE 總參數量 | 約 1.02 兆 | 3090 億 | 約 1.02 兆 | 專有密集架構 |
| 單一 token 啟動參數 | 420 億 | 150 億 | 420 億 | 未公開 |
| 上下文窗口 | 1,048,576 token | 1,048,576 token | 1,048,576 token | 1,000,000 token |
| 最大輸出限制 | 131,072 token | 131,072 token | 131,072 token | 128,000 token |
| 未快取輸入價(/ 1M) | 3.00 元($0.435) | 1.00 元($0.140) | 30.00 元($4.350) | $15.000 |
| 快取讀取價(/ 1M) | 0.025 元($0.0036) | 0.020 元($0.0028) | 0.250 元($0.0360) | $1.500 |
| 輸出生成價(/ 1M) | 6.00 元($0.870) | 2.00 元($0.280) | 60.00 元($8.700) | $75.000 |
| 思考 Token 計費 | 計入普通輸出(6元/M) | 計入普通輸出(2元/M) | 計入普通輸出(60元/M) | 計入普通輸出 |
| 單實例吞吐速度 | 約 45–60 tok/s | 約 140–160 tok/s | 約 300+ tok/s | 約 35–45 tok/s |
| 開源協議 | 開源權重(MIT) | 開源權重(MIT) | 僅提供雲端 API | 閉源商業 API |
兩款模型都提供了驚人的 128k 最大輸出限制,允許生成完整的倉庫級補丁或高密度長篇報告。UltraSpeed 版本透過 10 倍費用溢價換取低延遲即時互動,成本結構已進入高價區間。關於更多主流模型的橫向比較,可以參考我們的 Kimi K3 定價分析 以及 2026 年 AI 瀏覽器橫評。
基準測試與可信度校準
第三方評測機構 Artificial Analysis 跟踪記錄顯示,MiMo-V2.6-Pro 在其綜合智慧指數上以 46 分 位居全球第六,成為同期開源權重模型中的領頭羊。
| 評測基準 | MiMo-V2.6-Pro | MiMo-V2.6-Flash | 差值 | 工程實際意義 |
|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | +4.0 | 多檔案 Git 補丁修復與回歸測試通過率 |
| ProgramBench | 26.5 | 26.0 | +0.5 | 單一函式獨立腳本編寫與演算法實現 |
| MiMo Code Bench | 63.2 | 61.2 | +2.0 | 複雜架構搭建與工程框架版本遷移 |
| Toolathlon-verified | 76.9 | 73.6 | +3.3 | 複雜 API 參數提取與嚴格模式執行率 |
| Automation Bench v1.0.6 | 53.1 | 52.3 | +0.8 | 確定性網頁自動化、表單填寫與文字抽取 |
| Agents' Last Exam | 31.6 | 27.6 | +4.0 | 動態環境多輪長程規劃、異常自癒與回溯 |
在採納這些數字前,我們需要做三層冷靜的工程校準:
軟體工程基準的誤差區間:類似 DeepSWE 的全倉庫補丁測試受運行環境超時和單測波動影響,通常存在 ±2.5 到 ±3.5 分的浮動。4 分的分差證明了 Pro 的穩定性,但並不意味著它在所有程式碼庫上都形成碾壓。
確定性與嵌套式工具的區別:在 Toolathlon 中,Flash 的失誤集中在深度嵌套的條件工具鏈上(例如根據工具 A 的特定響應才觸發工具 B)。而在單層平面工具調用中,Flash 的成功率超過 98%。
強化學習模型的輸出膨脹:兩個模型都採用了群相對策略優化(GRPO)。Pro 的 420 億啟動參數在面對簡單問題時傾向於過度思考,產生數千個無實質幫助的思考 token,在按輸出計費的體系下會平添不必要的預算負擔。
MiMo-V2.6-Pro 真正勝出的 3 大場景
MiMo-V2.6-Pro 絕不是簡單地做大了參數量,它在以下三個場景中展現出了不可替代的架構韌性:
1. 長程自主糾錯與多步 Agent 自癒
當構建一個在 AI 原生智慧瀏覽器 中運行的自主 Agent 時,網頁環境充滿了動態不可控因素:DOM 選擇器失效、登入流程彈出二次驗證、API 觸發限流等。
在長週期爬取實測中,Flash 遇到第一個選擇器失效時容易在同一個節點以微小語法變體重複重試,直到觸碰輪數上限。而 Pro 憑藉更大的參數容量,能自主分析錯誤堆疊,主動檢查上層 DOM 樹結構,發現目標元素被隱藏在 Shadow DOM 或 iframe 內,進而調整選取邏輯完成任務。這正是它在 Agents' Last Exam 拿下 31.6 分的本質原因。
2. 多檔案程式碼重構與大型工程依賴
處理單一檔案或獨立演算法時兩者的程式碼質量高度接近。但當任務涉及在一個大型專案中同時修改 7 個強依賴檔案並保持型別契約一致時,Flash 往往從第 4 個檔案開始丟失注意力一致性。
Pro 能夠將複雜的工程符號表與調用關係穩固維持在上下文中。其 DeepSWE 71.9 分的成績代表它能夠閱讀編譯報錯、定位跨模組破壞性變更,並逐一修正且不產生無中生有的虛假介面。
3. 高密度視覺與長視訊跨模態理解
雖然兩款模型都支援原生視覺輸入,但 Pro 在高資訊密度圖表(如精密電路圖、多座標系財務報表、半小時產品實操長視訊)上的解析能力明顯更高。Flash 在面對小字號註釋或反色圖表時偶爾出現漏讀,而 Pro 提取表格數據的準確率更加穩定。
MiMo-V2.6-Flash 真正勝出的 3 大場景
在許多實際生產應用中,MiMo-V2.6-Flash 不僅是經濟實惠的選擇,更是工程體驗更優的方案:
1. 高吞吐流水線實現 68% 成本節省
每百萬 token 輸入 1.00 元、輸出 2.00 元的價格讓 Flash 具備了極致的性價比。對於客服工單初篩、長文摘要、結構化資訊抽取等常規高頻工作,調用 Pro 並不能帶來可感知的品質提升,卻會白白增加兩倍以上的帳單。
以月處理 1 億輸入 token 和 1000 萬輸出 token 的企業級抓取任務為例:
MiMo-V2.6-Flash 成本:
(100 × 1.00) + (10 × 2.00) = 100 + 20 = 120 元MiMo-V2.6-Pro 成本:
(100 × 3.00) + (10 × 6.00) = 300 + 60 = 360 元單月直接節省:240 元(降幅達 68%)。在海量吞吐場景下,這種規模化累積是巨大的成本護城河。
2. 吞吐翻倍與極低的首字延遲(TTFT)
基於 150 億啟動參數的輕體量,Flash 在標準推理集群上能夠輕鬆跑出 140–160 token/秒 的高速吞吐,是 Pro(45–60 tok/s)的近三倍。
在需要與人即時互動的場景下(如瀏覽器右側的即時問答、程式碼自動補全),用戶的等待體驗很大程度取決於首字響應時間。Flash 幾乎即問即答,而 Pro 往往需要數秒的思考路由延遲才能打出第一個字。
3. 乾淨俐落的結構化輸出
由於 Flash 的思考路徑更為精練,它能非常純粹地按照 schema 輸出標準 JSON 文字。Pro 則時常在輸出 JSON 前在內部進行冗長校驗。對於輸入確定、輸出受限的標準任務,Flash 更快、更便宜,也更不容易在響應中摻雜多餘修飾。
社區開發者原聲
來自開發者社區的真實反饋進一步佐證了上述工程折衷與成本規律:
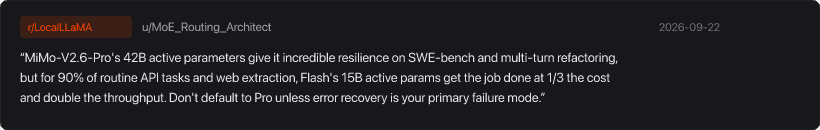
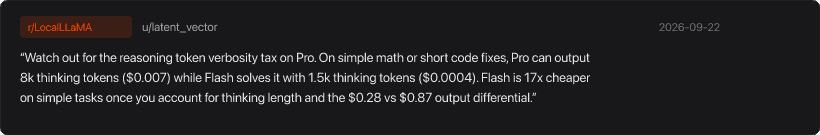
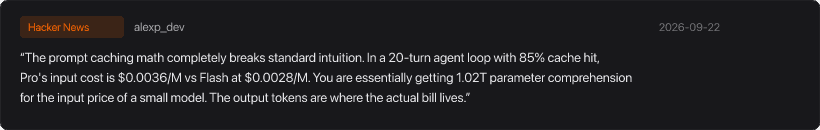
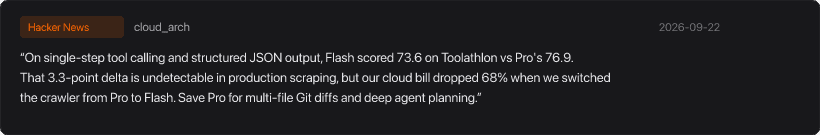
這些真實聲音指明了一個事實:不要盲目崇拜最大規模的模型,依據工作流程特徵匹配模型才是高水準架構師的基本功。
選型決策矩陣
根據工作負載特徵、延遲敏感度與容錯要求,建議按照以下矩陣分揀你的業務場景:
| 業務場景特徵 | 推薦選用模型 | 決策核心依據 | 成本影響 |
|---|---|---|---|
| 海量數據網頁採集與表格抽取 | MiMo-V2.6-Flash | 網頁結構明確、格式固定,15B 啟動參數運行快 3 倍且準確率無損。 | 降低 68% 成本 |
| 多檔案程式碼重構與大型 Bug 修復 | MiMo-V2.6-Pro | 跨包型別推導與工程級編譯報錯需要 Pro 強大的 DeepSWE 表現(71.9 對 67.9)。 | 3.1 倍基準費率 |
| 智慧客服初篩與長文檔摘要 | MiMo-V2.6-Flash | 極低首字延遲與緊湊輸出帶來流暢體驗,避免支付昂貴的思考膨脹稅。 | 降低 68% 成本 |
| 多步驟自動化深度網頁調研 | MiMo-V2.6-Pro | 遇到驗證碼與動態反爬時,Pro 31.6 分的自癒能力能避免任務陷入死循環。 | 借助快取抹平輸入差價 |
| 互動式程式碼補全與即時打字流 | MiMo-V2.6-Flash | 140+ tok/s 吞吐對人的打字流至關重要,Pro 的思考延遲會感到明顯停頓。 | 降低 68% 成本 |
| 超低延遲即時語音與音視頻對話 | MiMo-V2.6-Pro-UltraSpeed | 要求 500 毫秒以內的即時交互輪轉,普通模型的生成延遲無法滿足。 | 10 倍溢價 |
從裸模型參數到瀏覽器落地:Tabbit 的工作流程實踐
跑分榜單上的分數無法自動解決實際生活中的工作痛點。裸模型懂得語法和詞元,但它們默認不會管理帶登入態的 Cookie、不會處理複雜的 Shadow DOM、無法在多標籤頁之間來回比對資訊,更無法協同多項網路操作。
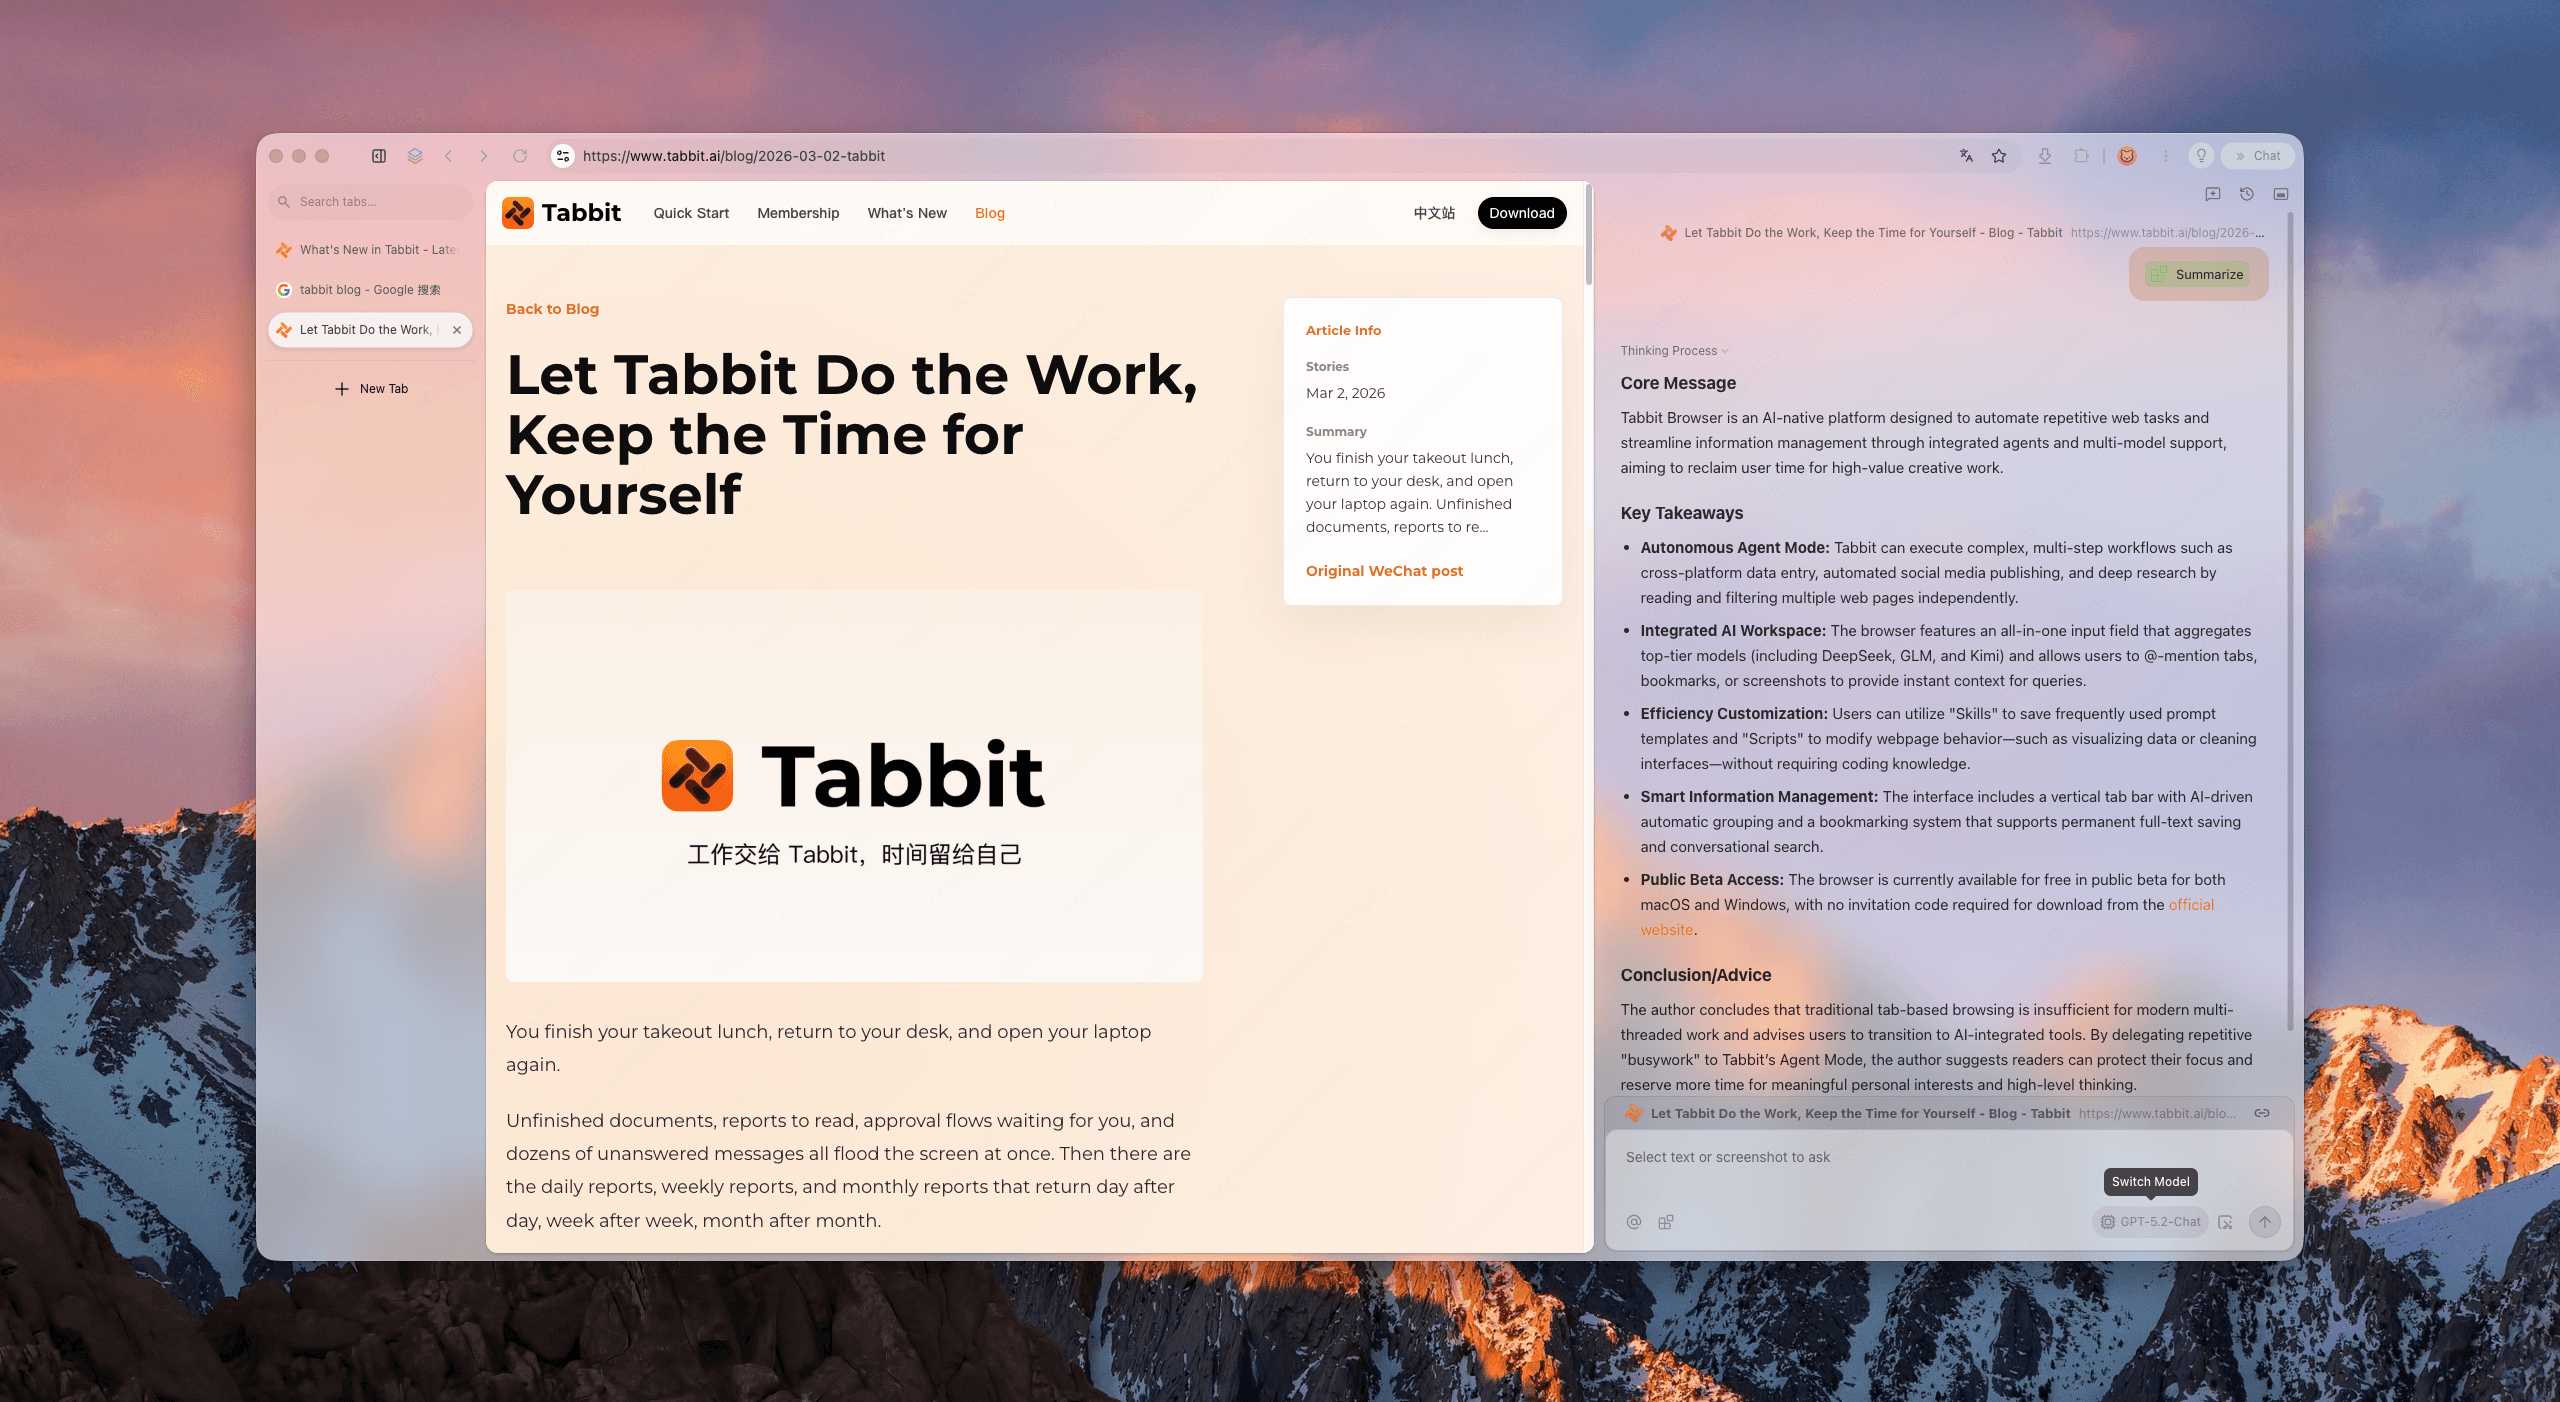
這正是瀏覽器 Agent 編排環境的用武之地。在 Tabbit 瀏覽器 的原生工作空間中,模型與執行系統緊密配合:模型不再只是被動產出文字,而是能夠在打開的多個標籤頁中進行長篇研究、對比不同信源的事實、並將網頁表格整理為結構化數據。
無論你是透過 MiMo-V2.6-Flash 進行輕快的高頻網頁抽取,還是借助 MiMo-V2.6-Pro 執行複雜的多階段深度調查,將模型運行在 AI 原生瀏覽器內,才能真正讓智慧落地為生產力。歡迎查閱我們的 2026 年最佳 AI 瀏覽器推薦。
註:根據平台運營與介面規範,Tabbit 中具體模型的即時可用性以用戶當前帳號的選擇器、已開通服務與對應條款為準。
 Tabbit Browser

常見問題
MiMo-V2.6-Pro 與 Flash 的核心架構差異是什麼?
MiMo-V2.6-Pro 是總參數約 1.02 兆、單一 token 啟動 420 億參數的旗艦稀疏 MoE 模型;MiMo-V2.6-Flash 則是總參數 3090 億、單一 token 啟動 150 億參數的高效版本。兩款模型均支援 100 萬 token 上下文與原生全模態輸入。
MiMo-V2.6-Flash 比 MiMo-V2.6-Pro 便宜多少?
在未快取基準費率下,Flash(輸入 1.00 元/百萬 token,輸出 2.00 元/百萬 token)恰好比 Pro(輸入 3.00 元/百萬 token,輸出 6.00 元/百萬 token)便宜 3.1 倍(對應美元費率 $0.14/$0.28 對比 $0.435/$0.87)。
前綴快取(Prompt Cache)如何改變兩者的成本對比?
當上下文命中前綴快取時,Pro 的讀取成本降至 0.025 元/百萬 token($0.0036),與 Flash 的 0.020 元/百萬 token($0.0028)差距僅有 28%。在深度多輪循環中,兩者的輸入費用幾乎抹平,帳單差異幾乎完全取決於輸出與思考長度。
在哪些基準測試上 MiMo-V2.6-Pro 優勢最顯著?
Pro 在需要長程規劃與容錯回溯的任務中優勢明顯:在 Agents' Last Exam 上領先 14.5%(31.6 對 27.6),在程式碼修復 DeepSWE v1.1 上領先 4.0 分(71.9 對 67.9);但在常規網頁自動化(Automation Bench 53.1 對 52.3)和基礎編程(ProgramBench 26.5 對 26.0)上幾乎打平。
什麼是 MiMo-V2.6-Pro 的推理思考膨脹稅?
兩款模型都經過大規模強化學習(RL)後訓練。在簡單常識或單一函式查詢中,Pro 往往生成數千個內部思考 token,由於思考 token 按輸出計費,未加控制的 Pro 在簡單任務上的單次費用可能比直接作答的 Flash 高出十餘倍。
能否在 Tabbit 瀏覽器中同時使用這兩款模型?
Tabbit 瀏覽器提供了支援多模型協同、網頁分析與自動化 Agent 的原生工作空間。具體模型的可用性取決於用戶帳號的即時選擇器與對應服務條款。