
Escolher entre dois modelos de uma mesma família arquitetural não se resume a apontar um vencedor definitivo, mas a calibrar recursos de engenharia com precisão. Em 22 de setembro de 2026, a Xiaomi disponibilizou sob licença MIT sua família de modelos fundacionais omnimodais MiMo-V2.6, introduzindo dois níveis principais: o modelo MoE de grande porte MiMo-V2.6-Pro e a opção compacta de alto rendimento MiMo-V2.6-Flash.
Como engenheiro que integra modelos em sistemas em produção, agentes autônomos e pipelines de extração todos os dias, não costumo me pautar por tabelas promocionais de lançamento. O que realmente importa em um cenário real é saber se o modelo consegue sustentar uma sessão de 30 etapas sem intervenção quando o DOM sofre alterações dinâmicas, APIs retornam falhas intermitentes e o contexto ultrapassa centenas de milhares de tokens.
Caso precise das fórmulas e valores oficiais detalhados, consulte nosso guia de preços do MiMo-V2.6-Pro ou a análise de custos do MiMo-V2.6-Flash. As especificações completas de hardware estão disponíveis na página do MiMo-V2.6-Pro (English) e na página do MiMo-V2.6-Flash (English). Este artigo traz o confronto direto de engenharia: onde o gigante de 1,02 trilhão de parâmetros comprova seu valor, onde o Flash entrega o mesmo resultado por um terço do preço e por que o cache de prompts transforma os cálculos tradicionais.
Principais conclusões
Diferença de tarifa base de exatamente 3,1x: O Flash cobra $0,14 na entrada e $0,28 na saída por milhão de tokens, contra $0,435 e $0,87 do Pro.
O cache de prompts iguala os custos de entrada: Com taxa de acerto de cache acima de 85%, o custo de leitura do Pro ($0,0036 / 1M) fica a apenas 28% do Flash ($0,0028 / 1M). Você executa 1 trilhão de parâmetros quase pelo preço de entrada de um modelo leve.
Equivalência em tarefas comuns: Em avaliações de navegação e preenchimento de formulários (Automation Bench: 53,1 contra 52,3), o Flash alcança 98,5% do desempenho do Pro consumindo somente 32% dos recursos financeiros.
Queda de desempenho em agentes complexos: Quando a tarefa exige correção autônoma ou refatoração em vários arquivos de código, o Pro estabelece uma vantagem de 14,5% (Agents' Last Exam: 31,6 contra 27,6; DeepSWE v1.1: 71,9 contra 67,9).
Atenção ao excesso de reflexão em tarefas simples: O Pro pode gerar 8.000 tokens de pensamento em casos triviais onde o Flash resolve com 1.500. Sem limites de raciocínio, o Pro pode custar até 17 vezes mais em consultas básicas.
O número determinante: 3,1x de custo contra 0,8 ponto de diferença
O cerne desta comparação repousa em dois números contrastantes: um multiplicador de preço de 3,1x frente a uma variação de apenas 0,8 ponto em automação rotineira.
Em termos de arquitetura, o MiMo-V2.6-Pro aciona 42 bilhões de parâmetros ativos por token em uma malha MoE esparsa de 1,02 trilhão. O MiMo-V2.6-Flash aciona 15 bilhões de parâmetros de um total de 309 bilhões. É uma proporção de 2,8x em computação ativa, que a Xiaomi reflete fielmente em sua tabela de preços ($0,435 vs $0,14).
No entanto, no benchmark Automation Bench v1.0.6, que avalia extração de DOM e cliques sequenciais na web, o Pro pontua 53,1 e o Flash 52,3. No ProgramBench para geração de código simples, o Pro atinge 26,5 e o Flash 26,0. Pagar 310% a mais por uma melhoria inferior a 1,5% em rotinas bem delineadas é uma decisão desfavorável do ponto de vista de custos.
Chamada rotineira de ferramentas (Automation Bench):
MiMo-V2.6-Pro:   53,1  ($0,435 entrada / $0,87 saída por 1M)
MiMo-V2.6-Flash: 52,3  ($0,140 entrada / $0,28 saída por 1M)  --> Diferença de apenas 0,8 ponto

Recuperação de falhas em agentes (Agents' Last Exam):
MiMo-V2.6-Pro:   31,6  (Mantém o estado por mais de 20 turnos)
MiMo-V2.6-Flash: 27,6  (Entra em loops de repetição de erros)    --> Queda de 14,5% na capacidade
O distanciamento ocorre no momento em que o agente precisa sair do roteiro previsto. Em processos como pesquisa aprofundada com raciocínio de agentes, barreiras inesperadas surgem com frequência: seletores quebrados, captchas ou bloqueios de tráfego. No teste rigoroso Agents' Last Exam, o Pro sustenta 31,6 pontos, ao passo que o Flash regride para 27,6 (queda de 14,5%). No teste de engenharia DeepSWE v1.1, o Pro confirma a superioridade com 71,9 pontos contra 67,9 do Flash.
A recomendação é direta: para operações previsíveis e com alto fluxo de dados, adote o Flash. O Pro é a garantia indispensável para tarefas cujo fracasso exige reparação humana manual.
Especificações, arquitetura e tabela de preços
Ambos os modelos se apoiam no motor omnimodal nativo da Xiaomi, processando texto, imagens de alta resolução, arquivos de vídeo e áudio em uma única janela de 1 milhão de tokens. A tabela abaixo consolida dados verificados em 22 de setembro de 2026.
| Aspecto arquitetural | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.6-Pro-UltraSpeed | Referência: Claude Opus 5 |
|---|---|---|---|---|
| Parâmetros totais MoE | ~1,02 Trilhão | 309 Bilhões | ~1,02 Trilhão | Proprietário denso |
| Parâmetros ativos / token | 42 Bilhões | 15 Bilhões | 42 Bilhões | Não revelado |
| Janela de contexto | 1.048.576 tokens | 1.048.576 tokens | 1.048.576 tokens | 1.000.000 tokens |
| Comprimento máx. de saída | 131.072 tokens | 131.072 tokens | 131.072 tokens | 128.000 tokens |
| Entrada sem cache (/ 1M) | $0,435 (¥3,00) | $0,140 (¥1,00) | $4,350 (¥30,00) | $15,000 |
| Entrada com cache (/ 1M) | $0,0036 (¥0,025) | $0,0028 (¥0,020) | $0,0360 (¥0,250) | $1,500 |
| Geração de saída (/ 1M) | $0,870 (¥6,00) | $0,280 (¥2,00) | $8,700 (¥60,00) | $75,000 |
| Cobrança de raciocínio | Tarifa de saída ($0,87) | Tarifa de saída ($0,28) | Tarifa de saída ($8,70) | Tarifa de saída |
| Velocidade de geração | ~45–60 tok/s | ~140–160 tok/s | ~300+ tok/s | ~35–45 tok/s |
| Licenciamento | Pesos abertos (MIT) | Pesos abertos (MIT) | Exclusivo via API | Comercial fechada |
Ambos disponibilizam um limite de saída de 128k tokens, ideal para gerar alterações de código inteiras ou relatórios densos sem interrupções artificiais. A opção UltraSpeed adiciona uma taxa de 10x voltada a interações instantâneas em tempo real. Veja também nossa avaliação de preços do Kimi K3 e o comparativo de navegadores de IA 2026.
Verificação de benchmarks e ressalvas práticas
Em avaliações independentes publicadas pelo Artificial Analysis, o MiMo-V2.6-Pro atingiu o sexto lugar global com índice de 46 pontos, posicionando-se no topo dos modelos com pesos abertos em seu lançamento.
| Suite de avaliação | MiMo-V2.6-Pro | MiMo-V2.6-Flash | Diferencial | Relevância técnica |
|---|---|---|---|---|
| DeepSWE v1.1 | 71,9 | 67,9 | +4,0 | Aplicação de patches Git e testes de regressão |
| ProgramBench | 26,5 | 26,0 | +0,5 | Implementação de algoritmos e funções isoladas |
| MiMo Code Bench | 63,2 | 61,2 | +2,0 | Migração de frameworks e estruturação de projetos |
| Toolathlon-verified | 76,9 | 73,6 | +3,3 | Extração de parâmetros e conformidade com esquemas |
| Automation Bench v1.0.6 | 53,1 | 52,3 | +0,8 | Automação básica de formulários e leitura web |
| Agents' Last Exam | 31,6 | 27,6 | +4,0 | Planejamento autônomo e recuperação diante de falhas |
Para interpretar essas métricas com rigor, vale observar três fatores essenciais:
Margem de variação em testes de código: Conjuntos de dados complexos como o DeepSWE registram oscilações normais de ±2,5 a ±3,5 pontos de acordo com a carga do ambiente de execução. A diferença de 4 pontos confirma maior consistência, mas não significa domínio absoluto em qualquer contexto.
Chamadas diretas vs dependências aninhadas: No Toolathlon, os tropeços do Flash decorrem quase sempre de condições encadeadas. Em estruturas de ferramentas diretas, seu índice de sucesso ultrapassa 98%.
Custo do raciocínio prolongado: Treinados com GRPO, os 42 bilhões de parâmetros ativos do Pro tendem a elaborar reflexões extensas mesmo para respostas óbvias. Com a tarifação atrelada aos tokens de saída, isso pode onerar a fatura sem gerar valor adicional.
Cenários em que o MiMo-V2.6-Pro realmente compensa
O MiMo-V2.6-Pro não é apenas uma versão expandida do Flash; seus 42 bilhões de parâmetros ativados conferem vantagens claras em três situações:
1. Autocorreção e resiliência em agentes autônomos
Ao operar um agente dentro de um navegador com suporte nativo a IA, as variações na web são inevitáveis: seletores renomeados, telas de autenticação ou limites de requisições.
Em testes práticos, o Flash costuma insistir na mesma instrução com pequenas variações textuais até esgotar suas tentativas. O Pro, por sua vez, avalia o relatório de erro, examina o DOM ao redor, detecta que o botão está dentro de um Shadow DOM e reformula sua abordagem com êxito. Essa adaptabilidade sustenta sua nota de 31,6 no Agents' Last Exam.
2. Refatoração em múltiplos arquivos e dependências
Em códigos pontuais, ambos entregam qualidade equivalente. No entanto, quando a tarefa exige alterar sete arquivos conectados em um monorepositório mantendo os contratos de tipos intactos, o Flash começa a perder o contexto a partir do quarto arquivo.
O Pro preserva com segurança o mapa de dependências e as tipagens em toda a extensão do prompt. Seus 71,9 pontos no DeepSWE decorrem da capacidade de depurar logs do compilador e aplicar correções estruturais sem inventar funções inexistentes.
3. Interpretação de imagens ricas e vídeos longos
Ainda que os dois modelos aceitem mídia nativamente, o Pro examina plantas arquitetônicas, balanços com múltiplos eixos ou gravações de demonstração com mais profundidade. O Flash pode omitir detalhes secundários, enquanto o Pro extrai tabelas e números com consistência superior.
Cenários em que o MiMo-V2.6-Flash é a melhor opção
Na maior parte das aplicações corporativas cotidianas, o MiMo-V2.6-Flash não representa uma concessão, mas sim a escolha mais inteligente:
1. Redução de 68% em rotinas massivas de dados
A $0,14 por milhão de tokens de entrada e $0,28 de saída, o Flash oferece uma economia imbatível. Em triagens de suporte, resumos de relatórios ou estruturação de dados, o uso do Pro não traz ganhos perceptíveis e triplica a fatura mensal.
Considere uma operação mensal de 100 milhões de tokens de entrada e 10 milhões de saída:
Custo com MiMo-V2.6-Flash:
(100 × $0,14) + (10 × $0,28) = $14,00 + $2,80 = $16,80Custo com MiMo-V2.6-Pro:
(100 × $0,435) + (10 × $0,87) = $43,50 + $8,70 = $52,20Economia direta mensal: $35,40 (queda de 68%). Projetada em escala de bilhões de tokens, essa diferença representa uma margem substancial.
2. Rendimento em dobro e início imediato de resposta (TTFT)
Graças ao perfil ágil de 15B parâmetros ativos, o Flash sustenta 140 a 160 tokens por segundo em servidores de inferência habituais, quase o triplo da velocidade do Pro (45–60 tok/s).
Em aplicações voltadas ao usuário final (como sumários na barra lateral ou autocompletar de código), o tempo até a exibição do primeiro caractere (TTFT) define a sensação de velocidade. O Flash começa a escrever sem hesitação, enquanto o Pro despende alguns segundos ponderando antes de iniciar.
3. Estruturação direta sem enrolação
Com um orçamento de pensamento mais compacto, o Flash gera o esquema JSON exato sem rodeios. O Pro costuma realizar verificações prévias antes de formatar a saída. Para instruções objetivas, o Flash é mais rápido, mais barato e sem excesso de palavras.
O que a comunidade de desenvolvedores relata
As discussões técnicas em fóruns especializados confirmam essas constatações práticas:
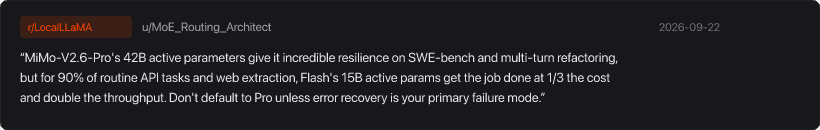
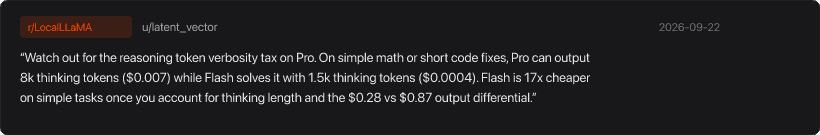
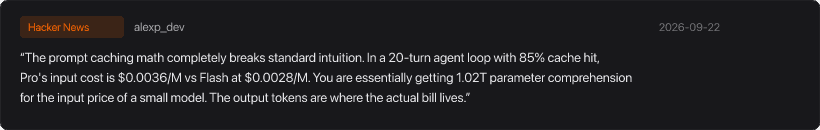
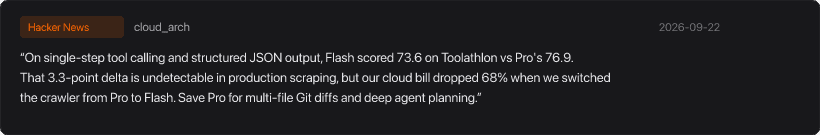
Esses relatos convergem em uma premissa clara: priorize o alinhamento entre modelo e tipo de atividade em vez de recorrer sistematicamente ao modelo com a maior contagem de parâmetros.
Matriz de escolha por tipo de demanda
Utilize o quadro a seguir para embasar sua decisão com base na tolerância a falhas e na rapidez exigida:
| Perfil de trabalho | Modelo sugerido | Justificativa técnica | Impacto orçamentário |
|---|---|---|---|
| Extração contínua e raspagem de dados web | MiMo-V2.6-Flash | Analisar HTML não exige 42B de raciocínio; 15B ativos são 3x mais velozes. | Economia de 68% |
| Refatoração estrutural e reparo de código | MiMo-V2.6-Pro | Manter a integridade de módulos requer a força do Pro no DeepSWE (71,9 contra 67,9). | Tarifa base 3,1x maior |
| Triagem de suporte e resumos executivos | MiMo-V2.6-Flash | Resposta instantânea e objetiva, evitando o consumo supérfluo de tokens de reflexão. | Economia de 68% |
| Pesquisa web investigativa em múltiplos passos | MiMo-V2.6-Pro | Diante de mudanças no site, o índice de 31,6 no Agents' Last Exam impede travamentos. | Custo de entrada similar com cache |
| Preenchimento de código interativo | MiMo-V2.6-Flash | A cadência de 140+ tok/s acompanha o fluxo do desenvolvedor sem interrupções. | Economia de 68% |
| Agentes de voz com baixa latência | MiMo-V2.6-Pro-UltraSpeed | Demanda tempo de resposta abaixo de 500 ms inatingível em ritmos padrão. | Custo 10x superior |
Dos modelos teóricos à prática no navegador: A integração Tabbit
Pontuações em tabelas técnicas não bastam para resolver os entraves do trabalho real. Os modelos processam termos e sintaxes, mas não lidam sozinhos com cookies de sessão, não decifram elementos no Shadow DOM nem coordenam consultas cruzadas entre múltiplas abas.
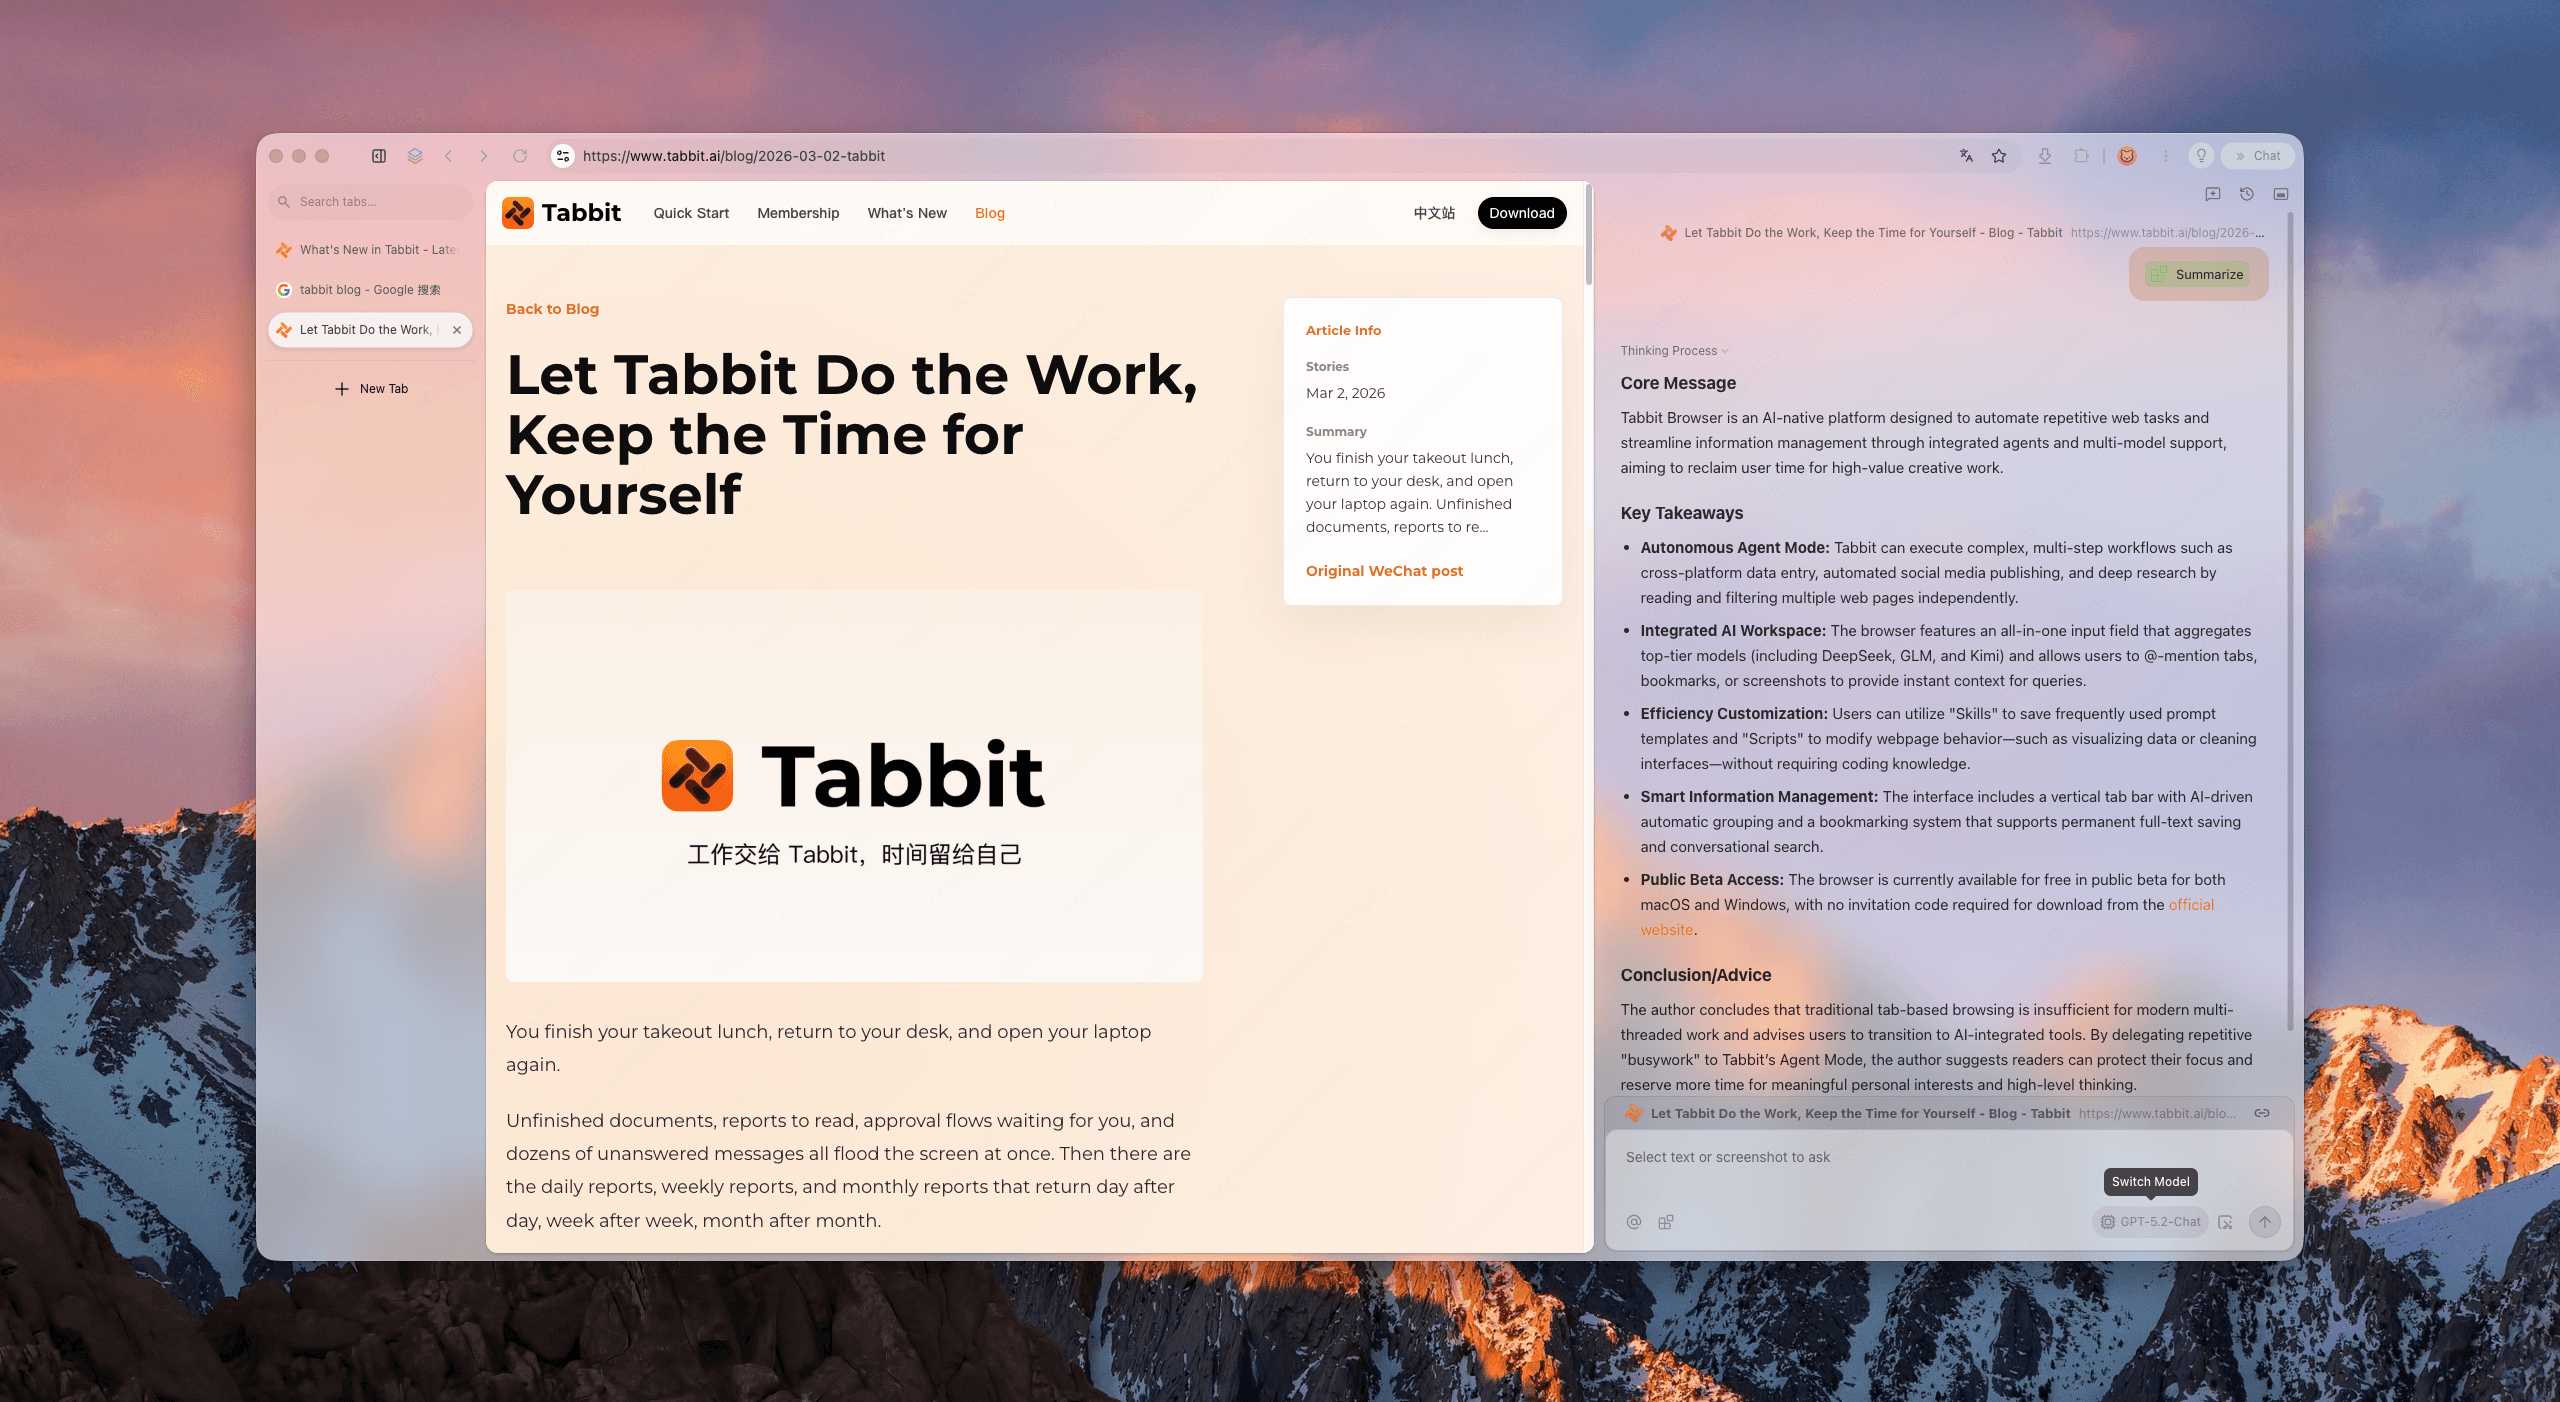
Por essa razão os ambientes de orquestração se tornaram imprescindíveis. No Tabbit Browser, o modelo atua integrado ao navegador: ele deixa de ser apenas um gerador de texto e passa a comparar fontes distintas em abas ativas e consolidar dados de páginas web.
Seja executando pipelines econômicos com o MiMo-V2.6-Flash ou investigações detalhadas com o MiMo-V2.6-Pro, conectar a inteligência a um navegador nativo de IA é o que transforma o potencial em produtividade. Saiba mais em nosso guia sobre os melhores navegadores com IA em 2026.
Nota: A disponibilidade prática dos modelos no Tabbit varia segundo o seletor ativo da conta, as integrações autorizadas e as condições contratuais.
 Tabbit Browser

Perguntas frequentes
Qual é a principal diferença arquitetural entre MiMo-V2.6-Pro e Flash?
O MiMo-V2.6-Pro é um modelo MoE esparso de topo com cerca de 1,02 trilhão de parâmetros totais e 42 bilhões ativos por token. O MiMo-V2.6-Flash possui 309 bilhões de parâmetros totais e 15 bilhões ativos por token. Ambos contam com uma janela de contexto de 1 milhão de tokens e suporte nativo a entradas omnimodais.
O quanto o MiMo-V2.6-Flash é mais econômico que o Pro?
Nas tarifas padrão sem cache, o MiMo-V2.6-Flash ($0,14 entrada, $0,28 saída por milhão de tokens) é exatamente 3,1 vezes mais barato que o MiMo-V2.6-Pro ($0,435 entrada, $0,87 saída por milhão de tokens).
Como o cache de prompts afeta a diferença de custo entre os modelos?
Quando há acerto no cache de prefixo, o custo de leitura do Pro cai para $0,0036 por milhão de tokens, ficando a apenas 28% de distância do Flash ($0,0028). Em fluxos de agentes com alta repetição de contexto, o custo de entrada se equipara e a despesa passa a ser ditada pelos tokens de saída.
Em quais benchmarks o MiMo-V2.6-Pro supera claramente o Flash?
O Pro se destaca com folga em tarefas de raciocínio prolongado e recuperação de falhas, marcando 31,6 no Agents' Last Exam (contra 27,6 do Flash, vantagem de 14,5%) e 71,9 no DeepSWE v1.1 (contra 67,9). Em automação web rotineira (Automation Bench 53,1 vs 52,3), o desempenho é praticamente equivalente.
O que é a taxa de prolixidade nos tokens de raciocínio do Pro?
Ambos foram treinados via aprendizado por reforço (RL) e geram reflexões internas antes da resposta final. O Pro tende a gerar milhares de tokens de pensamento mesmo em tarefas elementares. Como são faturados à tarifa de saída ($0,87/M), uma chamada sem restrições pode ficar até 17 vezes mais cara em consultas simples.
É possível utilizar o MiMo-V2.6-Pro e o Flash no Tabbit Browser?
O Tabbit Browser oferece um ambiente nativo com IA para pesquisa, extração web e comparação de múltiplos modelos. A disponibilidade de modelos específicos depende do seletor ativo na sua conta e dos termos de serviço vigentes.