
O GPT-6.1 Terra custa US$ 1 por milhão de tokens de entrada, US$ 0,05 por milhão de tokens de entrada em cache e US$ 5 por milhão de tokens de saída na tabela de tarifas da API Standard da OpenAI para contexto curto, verificada em 27 de outubro de 2026. Gravações no cache são categorias de cobrança separadas: US$ 1,25 por 30 minutos ou US$ 2,50 por 12 horas. Esses valores são preços de API, não de uma assinatura do ChatGPT ou do Tabbit. (Preços da OpenAI)
O número a observar é 95%: uma leitura do cache custa 95% menos que uma entrada comum. Isso pode importar mais que o preço de entrada em destaque quando um agente relê as mesmas instruções e documentos. Ainda assim, não garante que uma tarefa concluída custe menos. Em um relato no Reddit publicado no dia do lançamento, ayudha90 contou que consumiu mais da franquia da assinatura e gostou menos do resultado depois de aumentar o nível de esforço do Terra. É a experiência de uma pessoa, não uma fatura de API nem uma comparação controlada.
A seguir estão a tabela de tarifas atual, as condições por trás dos descontos, dois orçamentos reproduzíveis e uma calculadora local. A seção do Tabbit Browser confere o seletor de modelos antes de sugerir um fluxo de trabalho com um cliente.
Preços da API do GPT-6.1 Terra em resumo
Preços em USD por milhão de tokens, verificados em 27 de outubro de 2026. As duas colunas usam processamento Standard sem adicional regional. A coluna do modelo anterior vem do cartão atual do GPT-5.6 Terra e da tabela de preços, não de um valor histórico presumido.
| Categoria de cobrança, contexto curto | GPT-5.6 Terra | GPT-6.1 Terra | Variação |
|---|---|---|---|
| Entrada sem cache | $2.00 | $1.00 | −50% |
| Leitura de entrada em cache | $0.20 | $0.05 | −75% |
| Gravação no cache, 30 minutos | $2.50 | $1.25 | −50% |
| Gravação no cache, 12 horas | $5.00 | $2.50 | −50% |
| Saída, incluindo raciocínio | $12.00 | $5.00 | cerca de −58.3% |
Este é o GPT-6.1 Terra, ID de API gpt-6.1-terra, um modelo que recebe texto e imagens e gera texto. A OpenAI o posiciona para raciocínio visual, uso do computador e escrita. Sua janela de contexto de 1.050.000 tokens é uma especificação de capacidade; a faixa de preço mais baixa termina bem antes. O resumo anterior do Terra contextualiza o antecessor, enquanto o cartão atual do modelo define as especificações vigentes.
Principais conclusões
A leitura de entrada em cache custa US$ 0,05 por milhão de tokens, 5% da tarifa comum de entrada de US$ 1 do Terra. Gravações no cache custam mais e precisam entrar separadamente no orçamento.
Entrada, leituras do cache e gravações no cache são categorias de tokens mutuamente exclusivas. Somar uma tarifa de gravação à entrada comum dos mesmos tokens superestima a conta.
Acima de 272K tokens de entrada, a solicitação inteira usa tarifas mais altas. Caber mais contexto na memória não mantém o preço de contexto curto.
Batch e Flex reduzem pela metade as respectivas tarifas Standard; Fast as dobra. Cada modo tem suas próprias condições, então escolha o processamento antes de estimar o custo.
Compare o custo por resultado aceito com um nível de esforço adequado. Gastos da API em dólares, franquia da assinatura e acesso pelo cliente respondem a perguntas diferentes.
O desconto de 95% só se aplica a leituras do cache
A US$ 0,05, a tarifa de leitura em cache do Terra equivale a um vigésimo da tarifa de entrada sem cache. Em relação à tarifa de US$ 0,20 por leitura em cache do GPT-5.6 Terra, ela é 75% menor. Os percentuais têm denominadores diferentes. Nenhum deles significa que a conta inteira caia 95% ou 75%.
Um prefixo repetido pode incluir instruções, ferramentas e contexto de documentos estáveis. A reutilização do cache exige que os prefixos correspondam e tenham pelo menos 1.024 tokens nesses modelos. Se o prefixo mudar ou o período de retenção não for atendido, um acerto esperado pode virar uma gravação ou uma entrada comum. Meça o uso retornado pela API em vez de presumir que toda solicitação repetida acerta o cache. O guia de prompt caching explica as regras de correspondência e retenção.
Para os tokens de entrada que não estão sendo gravados no cache, uma taxa de acerto h resulta neste custo de entrada por milhão de tokens de entrada total em contexto curto:
custo de entrada = (1 − h) × $1 + h × $0.05
h = 80% → custo de entrada = $0.24
Esses US$ 0,24 não incluem a saída nem as gravações no cache. A primeira solicitação que cria um prefixo é diferente de uma solicitação posterior que o lê. Isso importa nos ciclos de pesquisa de agentes, em que o contexto repetido pode dominar o volume de entrada.
Transforme a economia anunciada em orçamento por tarefa
A comparação de tarifas é favorável: a entrada cai pela metade, a saída fica cerca de 58,3% mais barata e as leituras caem 75% em relação ao antecessor atualmente listado. As tabelas oficiais estabelecem essas diferenças. Elas não mostram quantos tokens sua tarefa precisa, com que frequência é bem-sucedida nem se outro modelo a resolve com menos tentativas.
No mesmo relato no Reddit, ayudha90 comparou entre modelos e níveis de esforço um aplicativo de gestão de projetos em pixel art. A pessoa relatou consumir 39% de uma franquia de cinco horas em cerca de 20 minutos usando Terra em nível alto e máximo. Diferenças de esforço, preferências subjetivas pelo resultado e a medição de uma assinatura impedem uma conclusão clara sobre o custo da API. O alerta prático continua útil: confira o resultado que você aceita, não apenas a menor tarifa de token exibida.
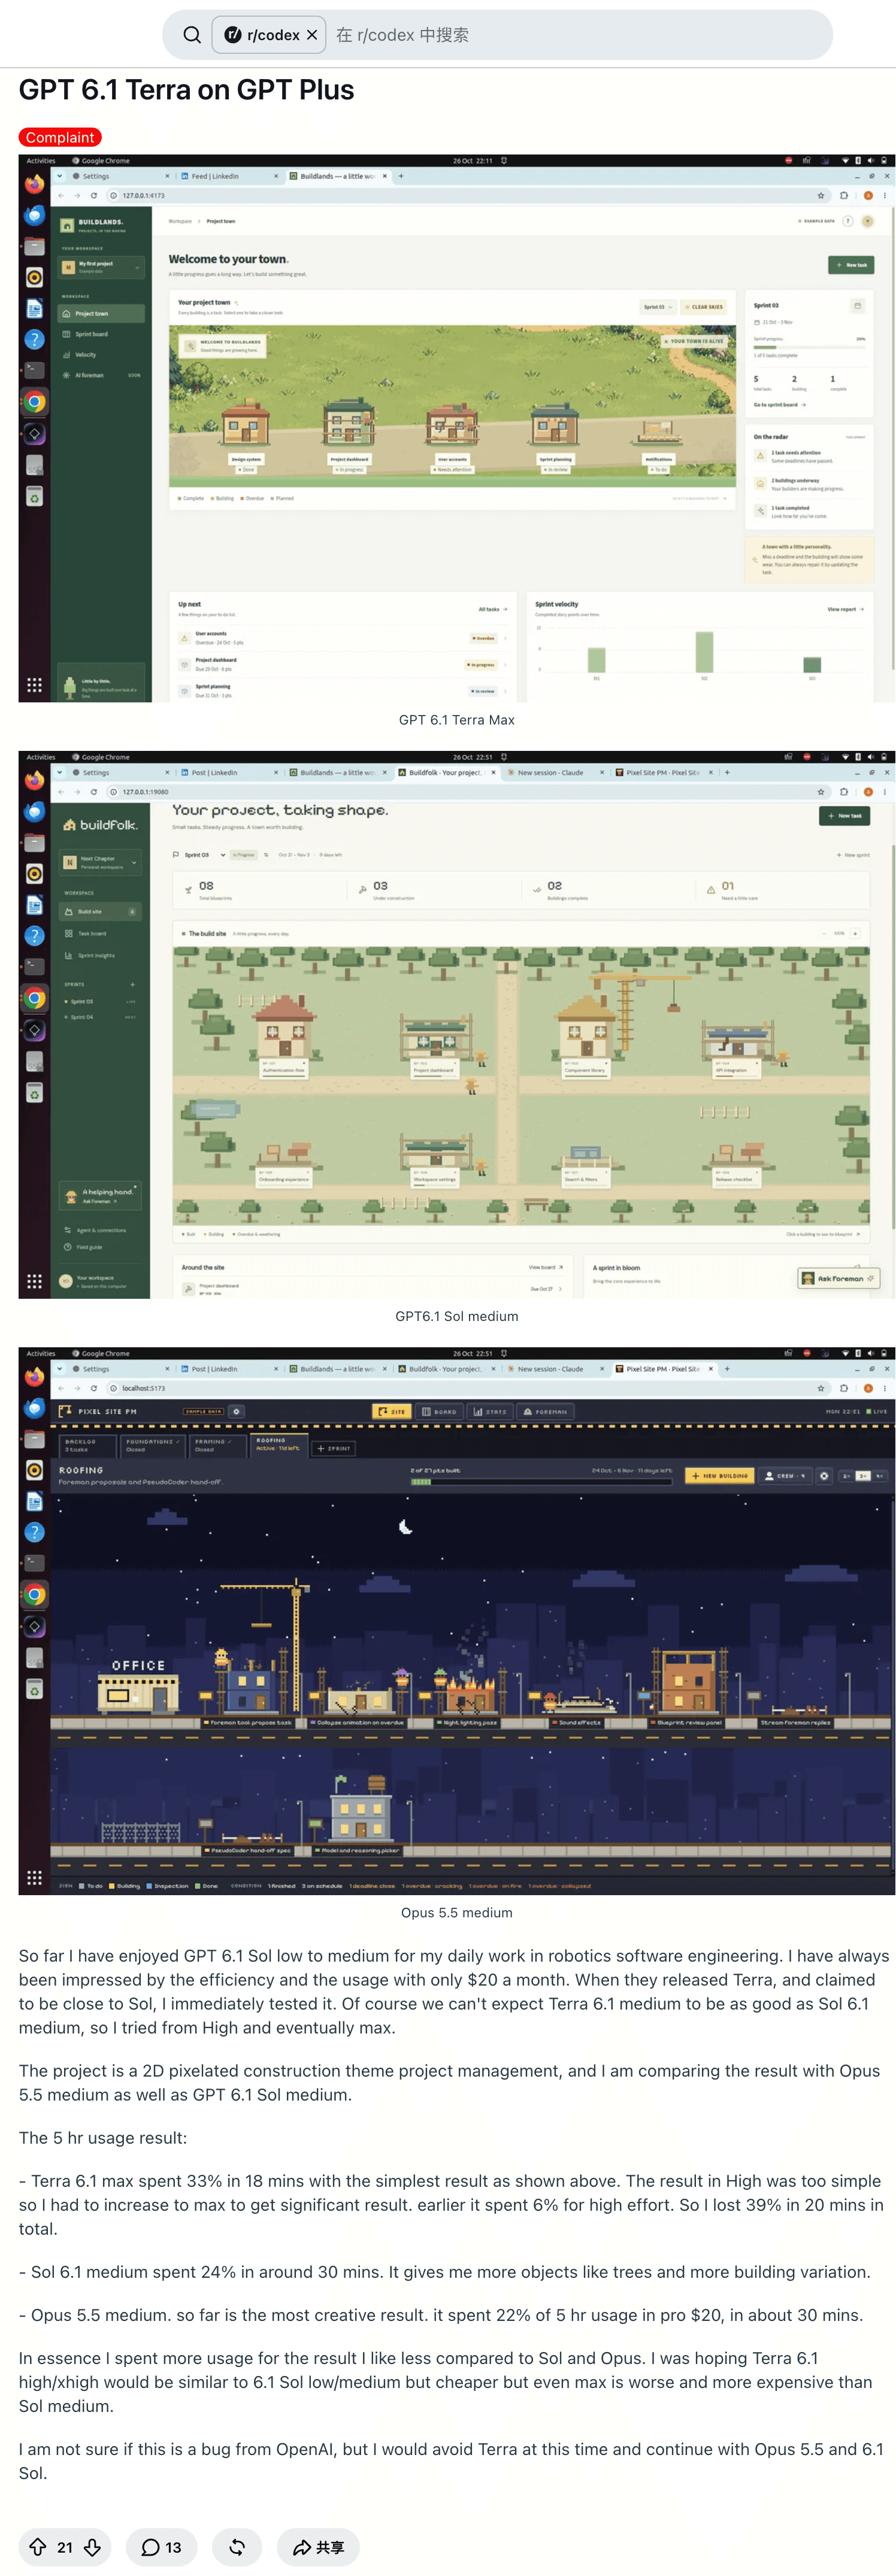
Uma métrica útil para decidir é:
custo por resultado aceito = gasto total em tentativas / resultados aceitosUse as mesmas entradas representativas, defina os critérios de aceitação antes de testar e registre também o uso das tentativas malsucedidas. O guia de casos de uso de pesquisa com IA ajuda a separar uma tarefa de extração delimitada de um projeto longo de pesquisa; cada uma precisa de um orçamento diferente.
Outros itens de cobrança e o limite de 272K
O cartão do modelo Terra estabelece que solicitações com mais de 272.000 tokens de entrada custam 2× as tarifas de entrada e cache e 1,5× a tarifa de saída. Isso vale para a solicitação toda, incluindo os primeiros 272K tokens.
| Modo de processamento do Terra | Contexto de entrada | Entrada | Leitura em cache | Gravação 30m | Gravação 12h | Saída |
|---|---|---|---|---|---|---|
| Standard | ≤272K | $1 | $0.05 | $1.25 | $2.50 | $5 |
| Standard | >272K | $2 | $0.10 | $2.50 | $5 | $7.50 |
| Batch / Flex | ≤272K | $0.50 | $0.025 | $0.625 | $1.25 | $2.50 |
| Batch / Flex | >272K | $1 | $0.05 | $1.25 | $2.50 | $3.75 |
| Fast | ≤272K | $2 | $0.10 | $2.50 | $5 | $10 |
| Fast | >272K | $4 | $0.20 | $5 | $10 | $15 |
Com exatamente 272K, use a linha de contexto curto. Em 272.001, a linha longa vale para tudo. Por exemplo, 300K de entrada comum e 10K de saída custam $0.6 + $0.075 = $0.675 em Standard, antes de outras cobranças. Seria incorreto cobrar a tarifa maior apenas pelos 28K que ultrapassam o limite.
Batch é assíncrono, e Flex tem disponibilidade de processamento e semântica de latência diferentes. Confirme se Batch ou Flex atende ao aplicativo antes de contar com o desconto. A tabela de API atual não lista Terra em Ultrafast; a opção para Sol ou Astra não é uma tarifa do Terra.
O processamento regional acrescenta 10% quando disponível. Ferramentas hospedadas podem ter suas próprias cobranças. Por exemplo, Web search custa US$ 10 por 1.000 chamadas, mais os tokens de conteúdo da pesquisa nas tarifas do modelo. Contêineres e armazenamento do File search também têm itens separados. A tabela citada não especifica vencimento de promoção para Terra; a nota promocional até 21 de novembro é de outro modelo, o GPT-5.6 Sol.
Qual nível da família combina com o trabalho?
Estas são as tarifas Standard atuais para contexto curto na mesma tabela oficial, não uma classificação de qualidade.
| Modelo | Entrada | Leitura em cache | Gravação 30m | Gravação 12h | Saída | Ponto de partida |
|---|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.25 | $0.50 | Tarefas focadas e repetíveis, após verificar a qualidade |
| GPT-6.1 Terra | $1 | $0.05 | $1.25 | $2.50 | $5 | Fluxos de trabalho visuais, com documentos e uso do computador |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $5 | $10 | Programação mais exigente e raciocínio prolongado |
| GPT-6 Astra | $10 | $1 | $12.50 | $25 | $50 | Trabalho difícil em que a capacidade extra justifica o custo |
Entrada e saída do Terra custam dez vezes as do Luna, mas as leituras em cache custam apenas cinco vezes mais. Por isso, a composição do cache importa antes mesmo de avaliar a qualidade. Os guias de preços do Luna, custos do Sol e preços do Astra cobrem opções próximas; os artigos anteriores mantêm suas próprias datas de verificação, então use a tabela oficial de hoje para as tarifas atuais.
O Terra aceita os níveis de esforço none, low, medium, high, xhigh e max; medium é o padrão. Comece por ele em uma tarefa representativa, reduza o esforço se o resultado continuar aceitável e aumente-o apenas quando o trabalho extra ajudar. Tokens de raciocínio são cobrados como saída. Uma tarifa de entrada menor não compensa indefinidamente um raciocínio mais longo ou novas tentativas. (Guia de raciocínio)
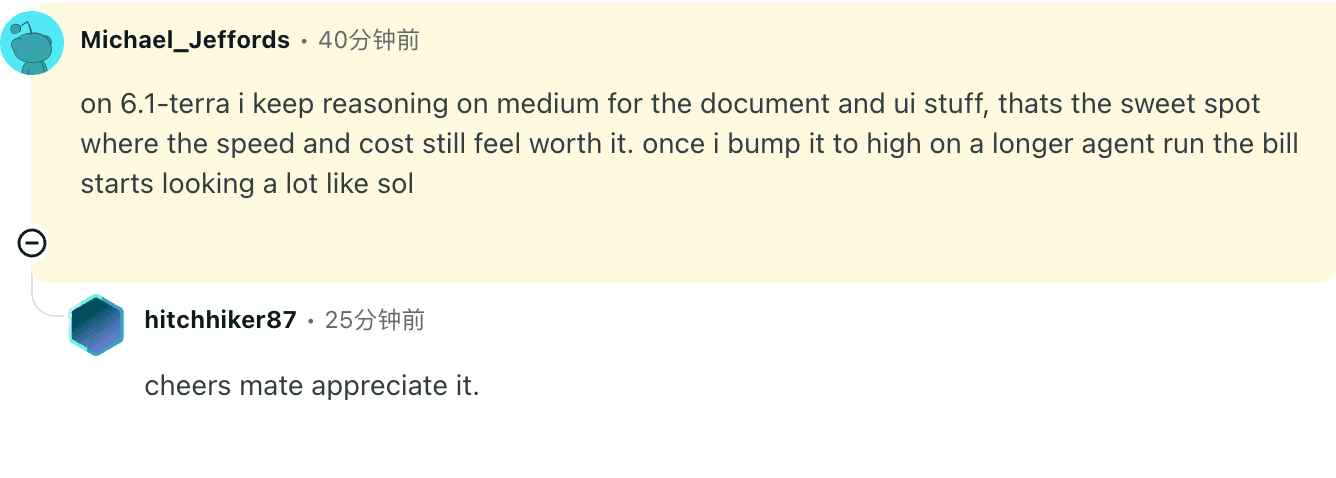
Michael_Jeffords diz manter o Terra em nível médio para tarefas com documentos e interfaces, enquanto execuções longas com esforço alto parecem se aproximar do custo do Sol. O comentário não apresenta fatura nem amostra controlada. Trate o nível como uma opção a testar.
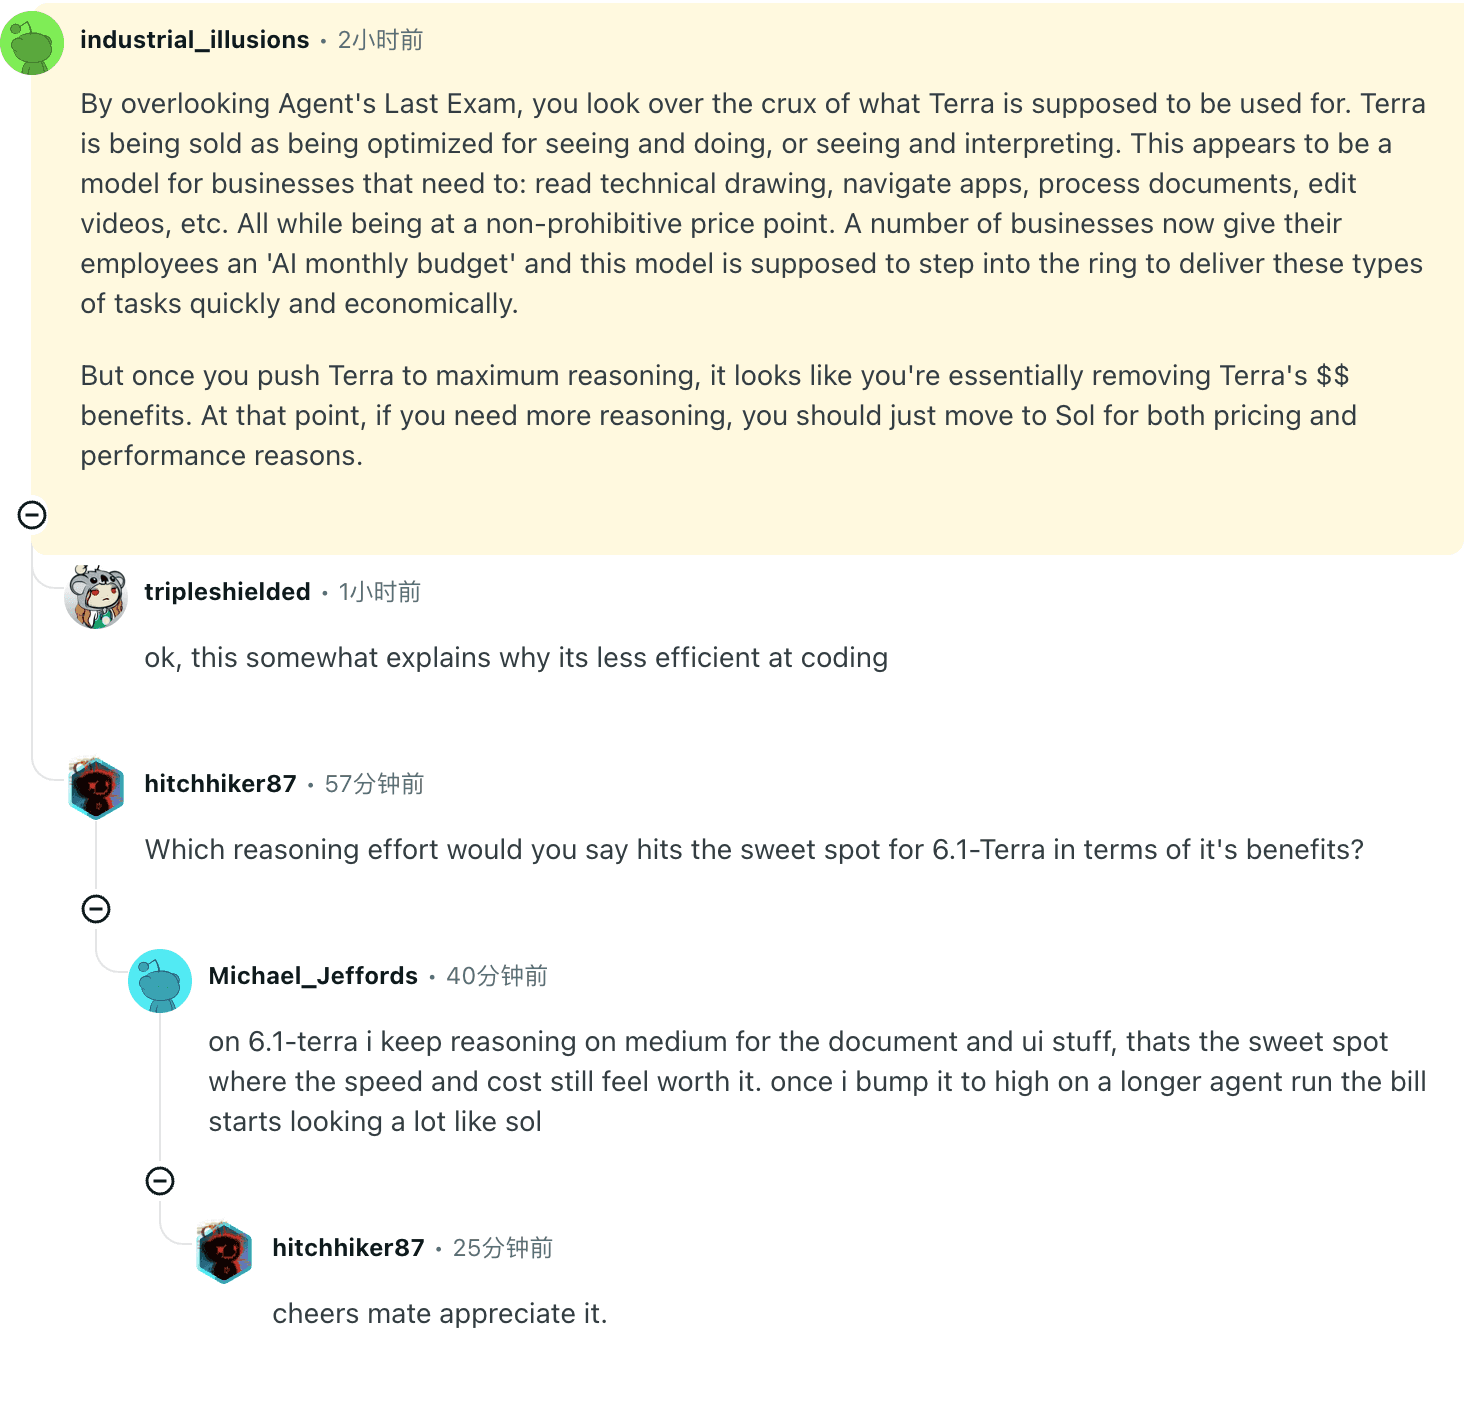
industrial_illusions apresenta argumento semelhante para processar documentos e navegar por aplicativos em escala, mas questiona o benefício do raciocínio máximo. É uma consideração sobre carga de trabalho, não uma validação independente dos benchmarks da OpenAI.
Para escrita, a publicação do Louis-François Bouchard no ToneBench favorece o esforço baixo para rascunhos em lote e questiona os ganhos do esforço mais alto naquela avaliação. A conclusão parte de uma tarefa de escrita e de um método de avaliação específicos; não é uma classificação geral de qualidade.
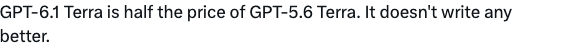
O que não tem cobrança separada e o que não é gratuito
A OpenAI não acrescenta uma tarifa separada pelos endpoints Responses API ou Chat Completions API às cobranças de tokens do modelo. Aumentar o esforço também não aparece como um adicional fixo; o impacto no custo vem do uso. Uma leitura do cache não recebe também uma cobrança de gravação pelo mesmo token na mesma solicitação.
Isso não torna o trabalho malsucedido gratuito. O guia de raciocínio informa que uma resposta incompleta pode consumir tokens de entrada e de raciocínio sem gerar uma resposta final visível. As páginas citadas não garantem isenção para recusas nem crédito automático quando o resultado falha. Consulte o uso da resposta e os registros de cobrança em vez de presumir que não houve custo porque a resposta não foi útil.
As estimativas abaixo excluem chamadas de ferramentas, tokens de conteúdo de pesquisa ainda não contabilizados, armazenamento, novas tentativas, impostos, cobranças regionais aplicáveis e margem do provedor. Imagens seguem as regras de tokenização do modelo; contar capturas de tela não basta para estimar tokens.
Assinaturas do ChatGPT e acesso à API são compras distintas
A OpenAI lista o GPT-6.1 Terra no ChatGPT Work e no Codex para Plus, Pro, Business, Enterprise e Edu, sujeito aos controles do workspace. Ele não aparece na interface comum do Chat. O cartão do modelo da API não indica suporte ao plano gratuito. (Preços do Work e Codex; cartão do Terra)
A página do Work/Codex lista atualmente o Plus por US$ 20 por mês e o Pro a partir de US$ 100 por mês. Ela estima de 35 a 285 mensagens locais do Terra a cada cinco horas para Plus e Business Standard, deixando claro que não é um limite fixo garantido. A escolha do modelo, o contexto, o raciocínio e as ferramentas alteram o consumo. Confira o preço regional no momento da compra e o painel de uso da sua conta.
Créditos comprados têm sua própria tabela, e o Codex não cobra desses créditos uma gravação separada no cache como a API. O uso de chave de API segue a cobrança da API. Portanto, nem o preço do Plus nem uma porcentagem de uso incluído podem ser convertidos em uma quantidade garantida de tarefas de API.
Dois orçamentos que você pode reproduzir
São exemplos aritméticos, não execuções medidas do modelo. Ambos usam os preços Standard para contexto curto e pressupõem 1.000 solicitações, cada uma com 100K de entrada total e 2K de saída total. A saída já inclui tokens de raciocínio.
| Composição da entrada por solicitação | Entrada comum | Leituras do cache | Gravações no cache 30m | Saída | Por solicitação | 1.000 solicitações |
|---|---|---|---|---|---|---|
| Prefixo frio, primeira gravação | 20K | 0 | 80K | 2K | $0.130 | $130 |
| Prefixo quente, leitura posterior | 20K | 80K | 0 | 2K | $0.034 | $34 |
O cálculo frio é 0.02 × $1 + 0.08 × $1.25 + 0.002 × $5 = $0.13. O cálculo quente é 0.02 × $1 + 0.08 × $0.05 + 0.002 × $5 = $0.034. Os mesmos 100K tokens de entrada aparecem distribuídos em três categorias exclusivas; nunca se contam 100K como entrada comum mais outros 80K de gravação.
Uma solicitação inicial fria seguida de 999 leituras quentes custa $0.13 + 999 × $0.034 = $34.096. A conta pressupõe o mesmo prefixo compatível com cache, cache retido e nenhuma nova tentativa. Regravar ou deixar o prefixo expirar altera a composição. Uma gravação fria com retenção de 12 horas custa US$ 0,23; a retenção mais longa só compensa se as leituras posteriores justificarem o custo.
Estime seu orçamento de tokens localmente
Informe a entrada total, a fração lida do cache, os tokens gravados no cache, a saída incluindo raciocínio e a quantidade de solicitações. A calculadora subtrai as leituras e gravações da entrada total, aplica o limite de contexto à solicitação inteira e compara Terra, Sol e Luna nos mesmos volumes de tokens. Volume igual não significa qualidade nem conclusão da tarefa iguais.
Calculadora local
Compare os custos de API de Terra, Sol e Luna
Tarifas oficiais da API em USD verificadas em 27/10/2026. Os valores e o cálculo ficam neste navegador.
Não inclui ferramentas, novas tentativas, impostos, processamento regional nem taxas do provedor ou do aplicativo. Tokens de raciocínio já estão incluídos nos tokens de saída. Créditos de assinatura e uso do ChatGPT não são estimados. Ver tarifas oficiais da API
Os valores calculados permanecem no seu navegador. A página registra um evento genérico de alteração da calculadora sem incluir os valores informados. Eles não são enviados a um modelo nem a um serviço de preços. Os resultados excluem as outras cobranças listadas acima e usam a tarifa de 27 de outubro.
Confira o seletor do Tabbit antes de escolher um cliente
Se o seu trabalho envolve páginas e documentos, o fluxo de trabalho do Tabbit Browser pode ser relevante depois de decidir qual modelo usar. A tarifa do modelo e a disponibilidade em um cliente são partes diferentes dessa decisão.
A verificação real foi feita em 27 de outubro de 2026, no Tabbit em web.tabbit.ai/newtab. O seletor carregado tinha 16 opções, incluindo Kimi-K3.1-Pro e Claude-Sonnet-5.5, mas não listava o GPT-6.1 Terra. A amostra foi uma conta internacional; nenhuma inferência do Terra foi enviada, nenhuma resposta do Terra com indicação de ferramenta foi observada e nenhum custo ou velocidade foi medido. O teste planejado era extrair uma tabela com resposta conhecida; a ausência do modelo impediu a execução.
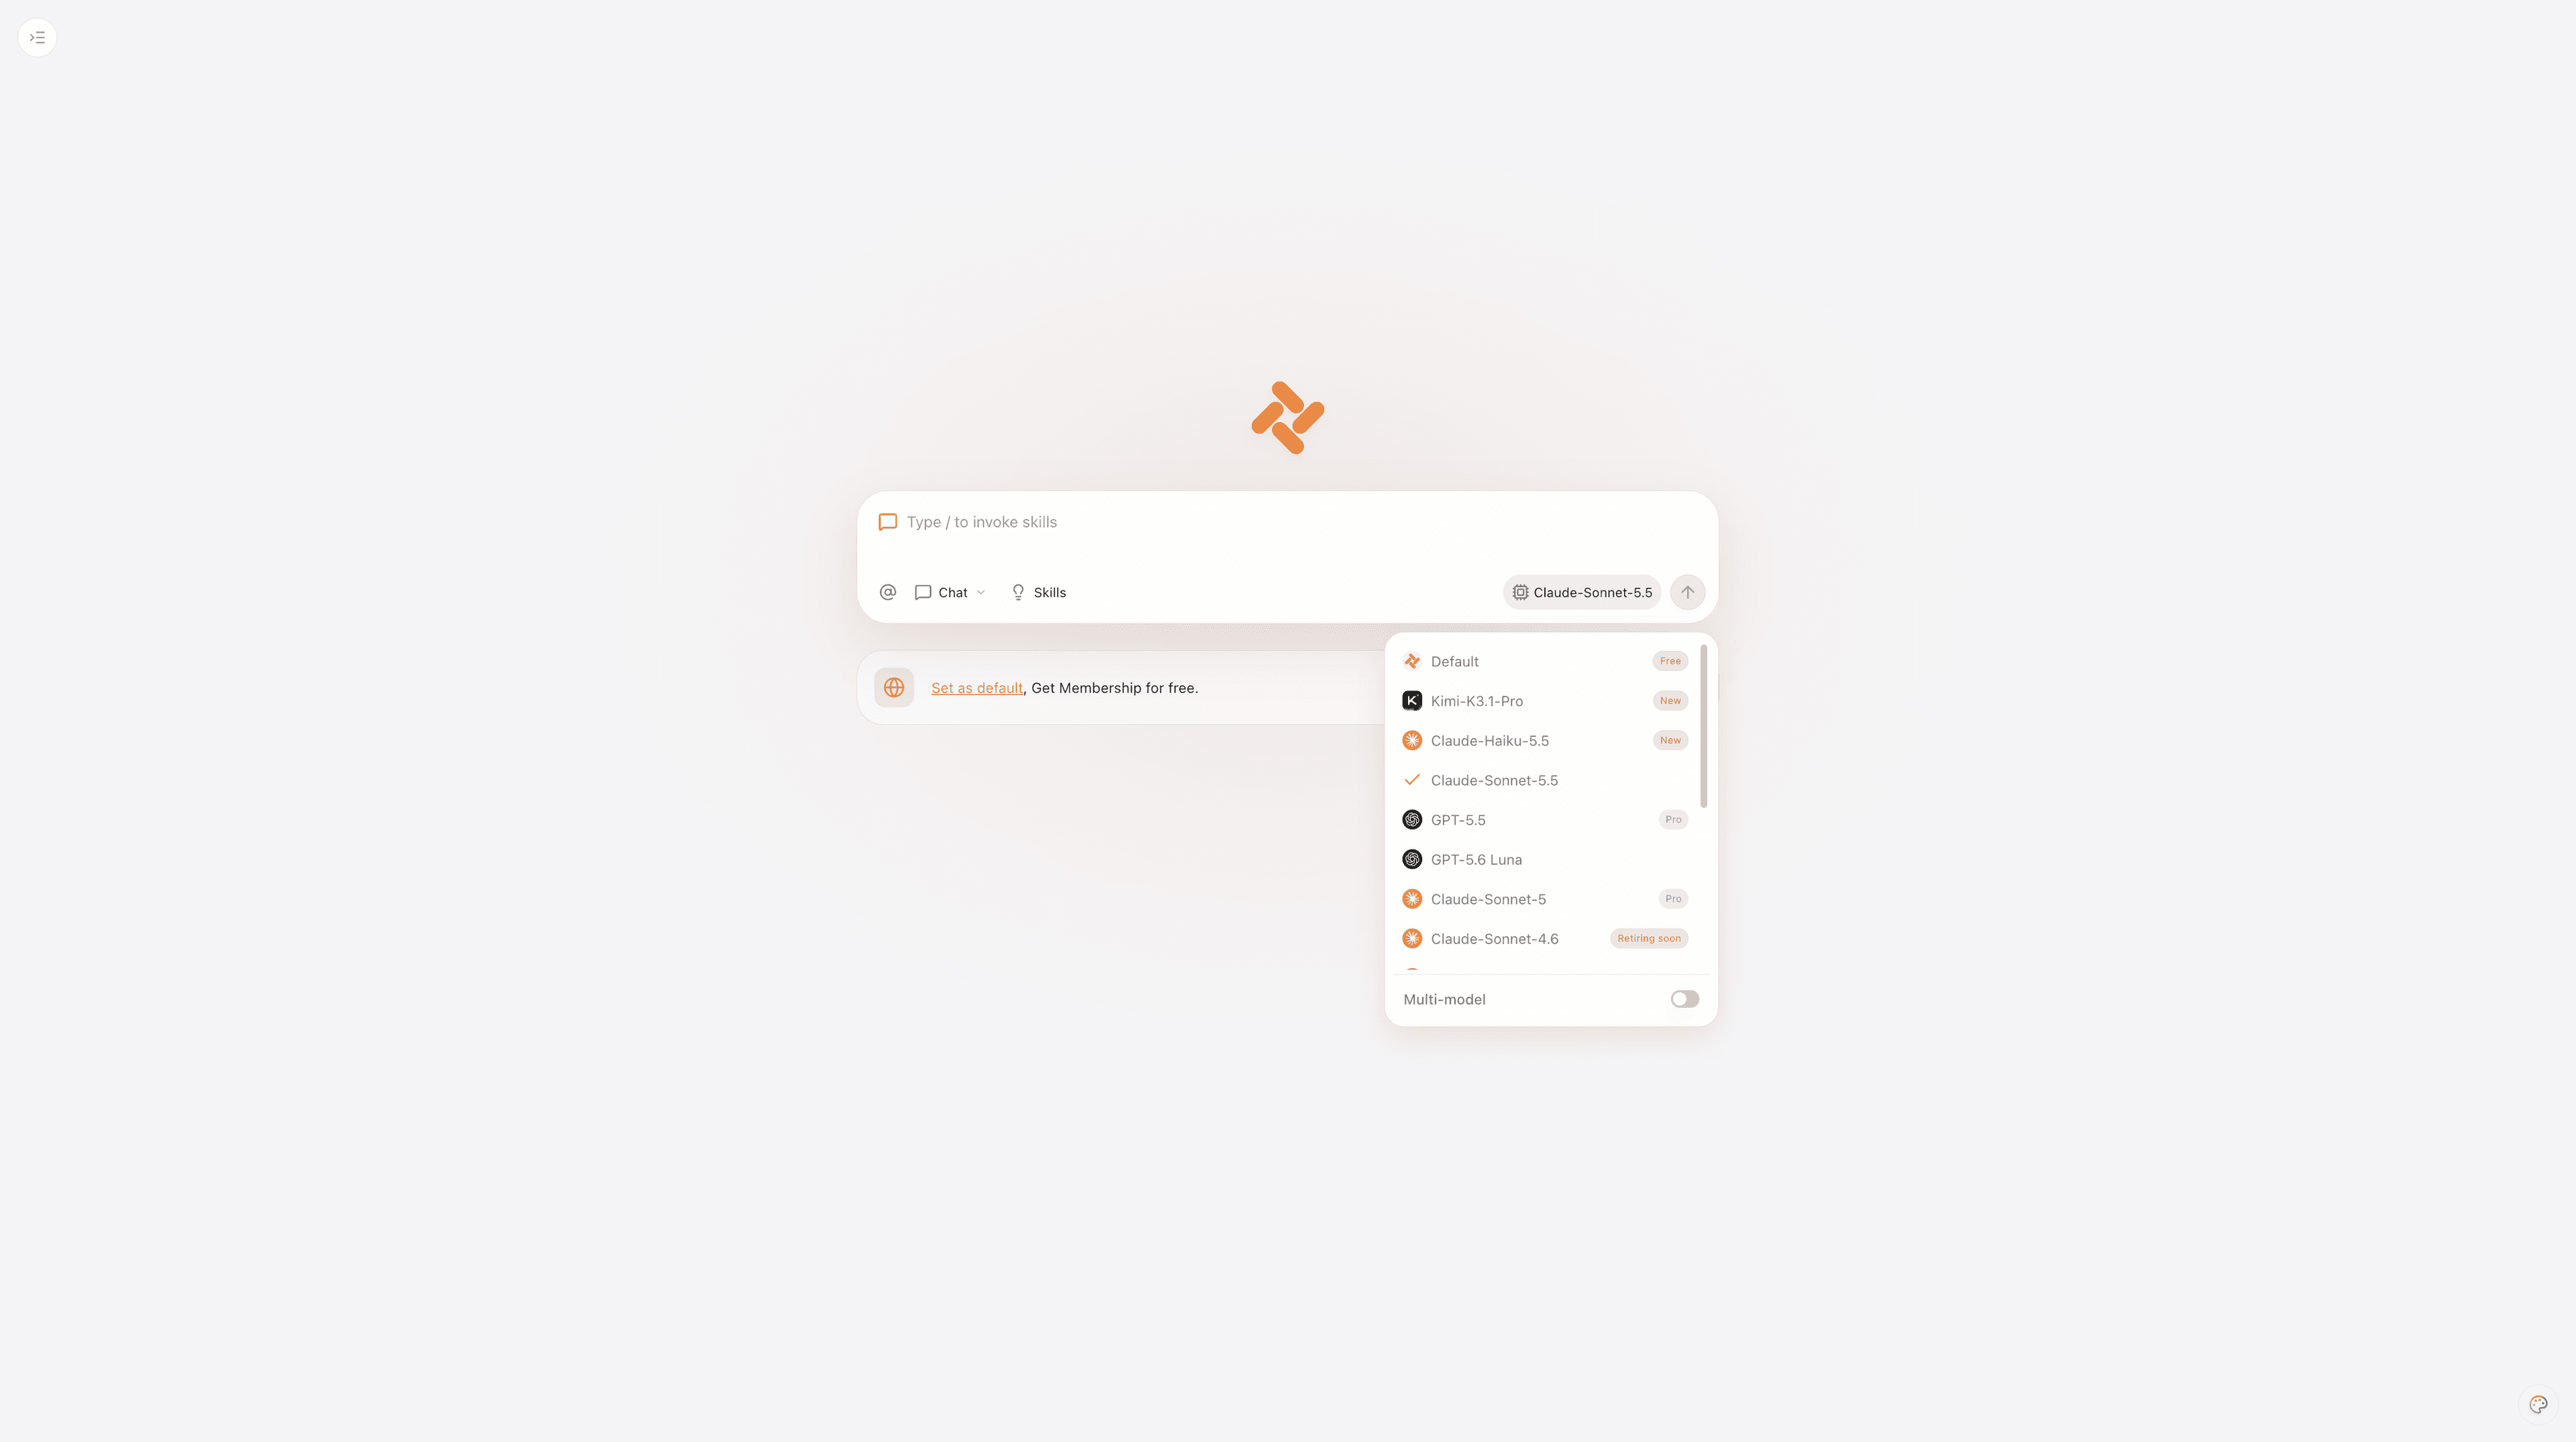
Se o Terra aparecer na sua conta mais tarde, use a mesma tabela de origem e a mesma resposta esperada para comparar os modelos, registre o nome exibido, os indicadores de ferramenta e o resultado, e confira o plano atual do cliente. Até lá, use um cliente cujo acesso ao Terra esteja confirmado. O guia de práticas do Tabbit e a explicação do navegador agêntico descrevem fluxos de trabalho no navegador, mas não comprovam a disponibilidade do Terra.
Veredito: escolha o modelo para a tarefa e depois a tarifa
| Sua condição | Próximo passo sensato | O que verificar |
|---|---|---|
| Tarefas visuais ou com documentos repetidas | Teste o Terra em nível médio e depois reduza o esforço | Resultados aceitos, saída de raciocínio e acertos de cache |
| Rascunhos em lote com revisão humana | Compare o Terra com esforço baixo às alternativas | Tom, tempo de edição e custo total da tarefa |
| Raciocínio prolongado ou programação exigente | Compare o Sol em um nível de esforço adequado | Se menos tokens ou tentativas compensam as tarifas |
| Processamento sem urgência | Avalie Batch ou Flex | Comportamento do serviço e prazo de conclusão |
| Entrada próxima de 272K | Reduza o contexto ou planeje a linha longa | Toda a entrada, incluindo tokens lidos e gravados em cache |
| Assinatura Work/Codex | Compare a franquia e os créditos reais | Painel da conta, não apenas o preço da API |
A tabela de US$ 1/US$ 5 do Terra é um bom preço inicial para tarefas visuais e com documentos. O desconto de 95% nas leituras só tem valor quando as solicitações realmente reutilizam a entrada em cache; o nível de esforço e a conclusão bem-sucedida determinam se a tarefa inteira compensa. Teste a carga de trabalho, confira o uso e então escolha o plano ou nível de serviço da API.
Para trabalhar no navegador, confira o acesso atual no Tabbit antes de depender de um modelo específico. Baixar o cliente não concede acesso ao GPT-6.1 Terra nem substitui as regras de cobrança da OpenAI.
 Tabbit Browser

Perguntas frequentes
Quanto custa o GPT-6.1 Terra por milhão de tokens?
Conforme verificado em 27 de outubro de 2026, a tarifa Standard da API para até 272.000 tokens de entrada é de US$ 1 por milhão de tokens de entrada sem cache, US$ 0,05 para entrada em cache e US$ 5 para saída. As gravações no cache custam US$ 1,25 com retenção de 30 minutos ou US$ 2,50 por 12 horas. Cada token pertence a apenas uma categoria de cobrança de entrada; por isso, a gravação não é somada à cobrança comum de entrada pelos mesmos tokens.
O GPT-6.1 Terra é mais barato que o GPT-5.6 Terra?
Na tarifa Standard atual para contexto curto, a entrada cai de US$ 2 para US$ 1, a saída de US$ 12 para US$ 5 e as leituras do cache de US$ 0,20 para US$ 0,05 por milhão de tokens. As reduções são de 50%, cerca de 58,3% e 75%, respectivamente. O custo da tarefa também depende dos tokens de raciocínio gerados, dos acertos de cache, das novas tentativas e da qualidade de saída que você aceita.
O GPT-6.1 Terra cobra adicional por contexto longo?
Sim. Acima de 272.000 tokens de entrada, a solicitação inteira usa as tarifas de contexto longo: as tarifas de entrada e cache dobram, e a saída custa 1,5 vez mais. Com exatamente 272.000 tokens de entrada, ainda vale a faixa de contexto curto.
Os tokens de raciocínio e as recusas são gratuitos?
Os tokens de raciocínio são cobrados como tokens de saída, mesmo quando nenhuma resposta final fica visível. As páginas oficiais citadas não prometem que recusas sejam gratuitas. Consulte o uso da resposta e a cobrança em vez de presumir que um resultado malsucedido não custa nada.
Posso usar o GPT-6.1 Terra com uma assinatura do ChatGPT?
A OpenAI lista o Terra no ChatGPT Work e no Codex para os planos Plus, Pro, Business, Enterprise e Edu, sujeitos às permissões e aos controles do workspace. Ele não aparece na interface comum do Chat. O uso incluído e os créditos comprados são separados da cobrança por chave de API.
O GPT-6.1 Terra está disponível no Tabbit Browser?
A conta internacional do Tabbit inspecionada em 27 de outubro de 2026 não mostrava o GPT-6.1 Terra entre os 16 modelos carregados. Por isso, este artigo não afirma que testou inferência do Terra no Tabbit nem promete acesso ao modelo. Confira o seletor e o plano atuais antes de escolher um cliente para esse modelo.