
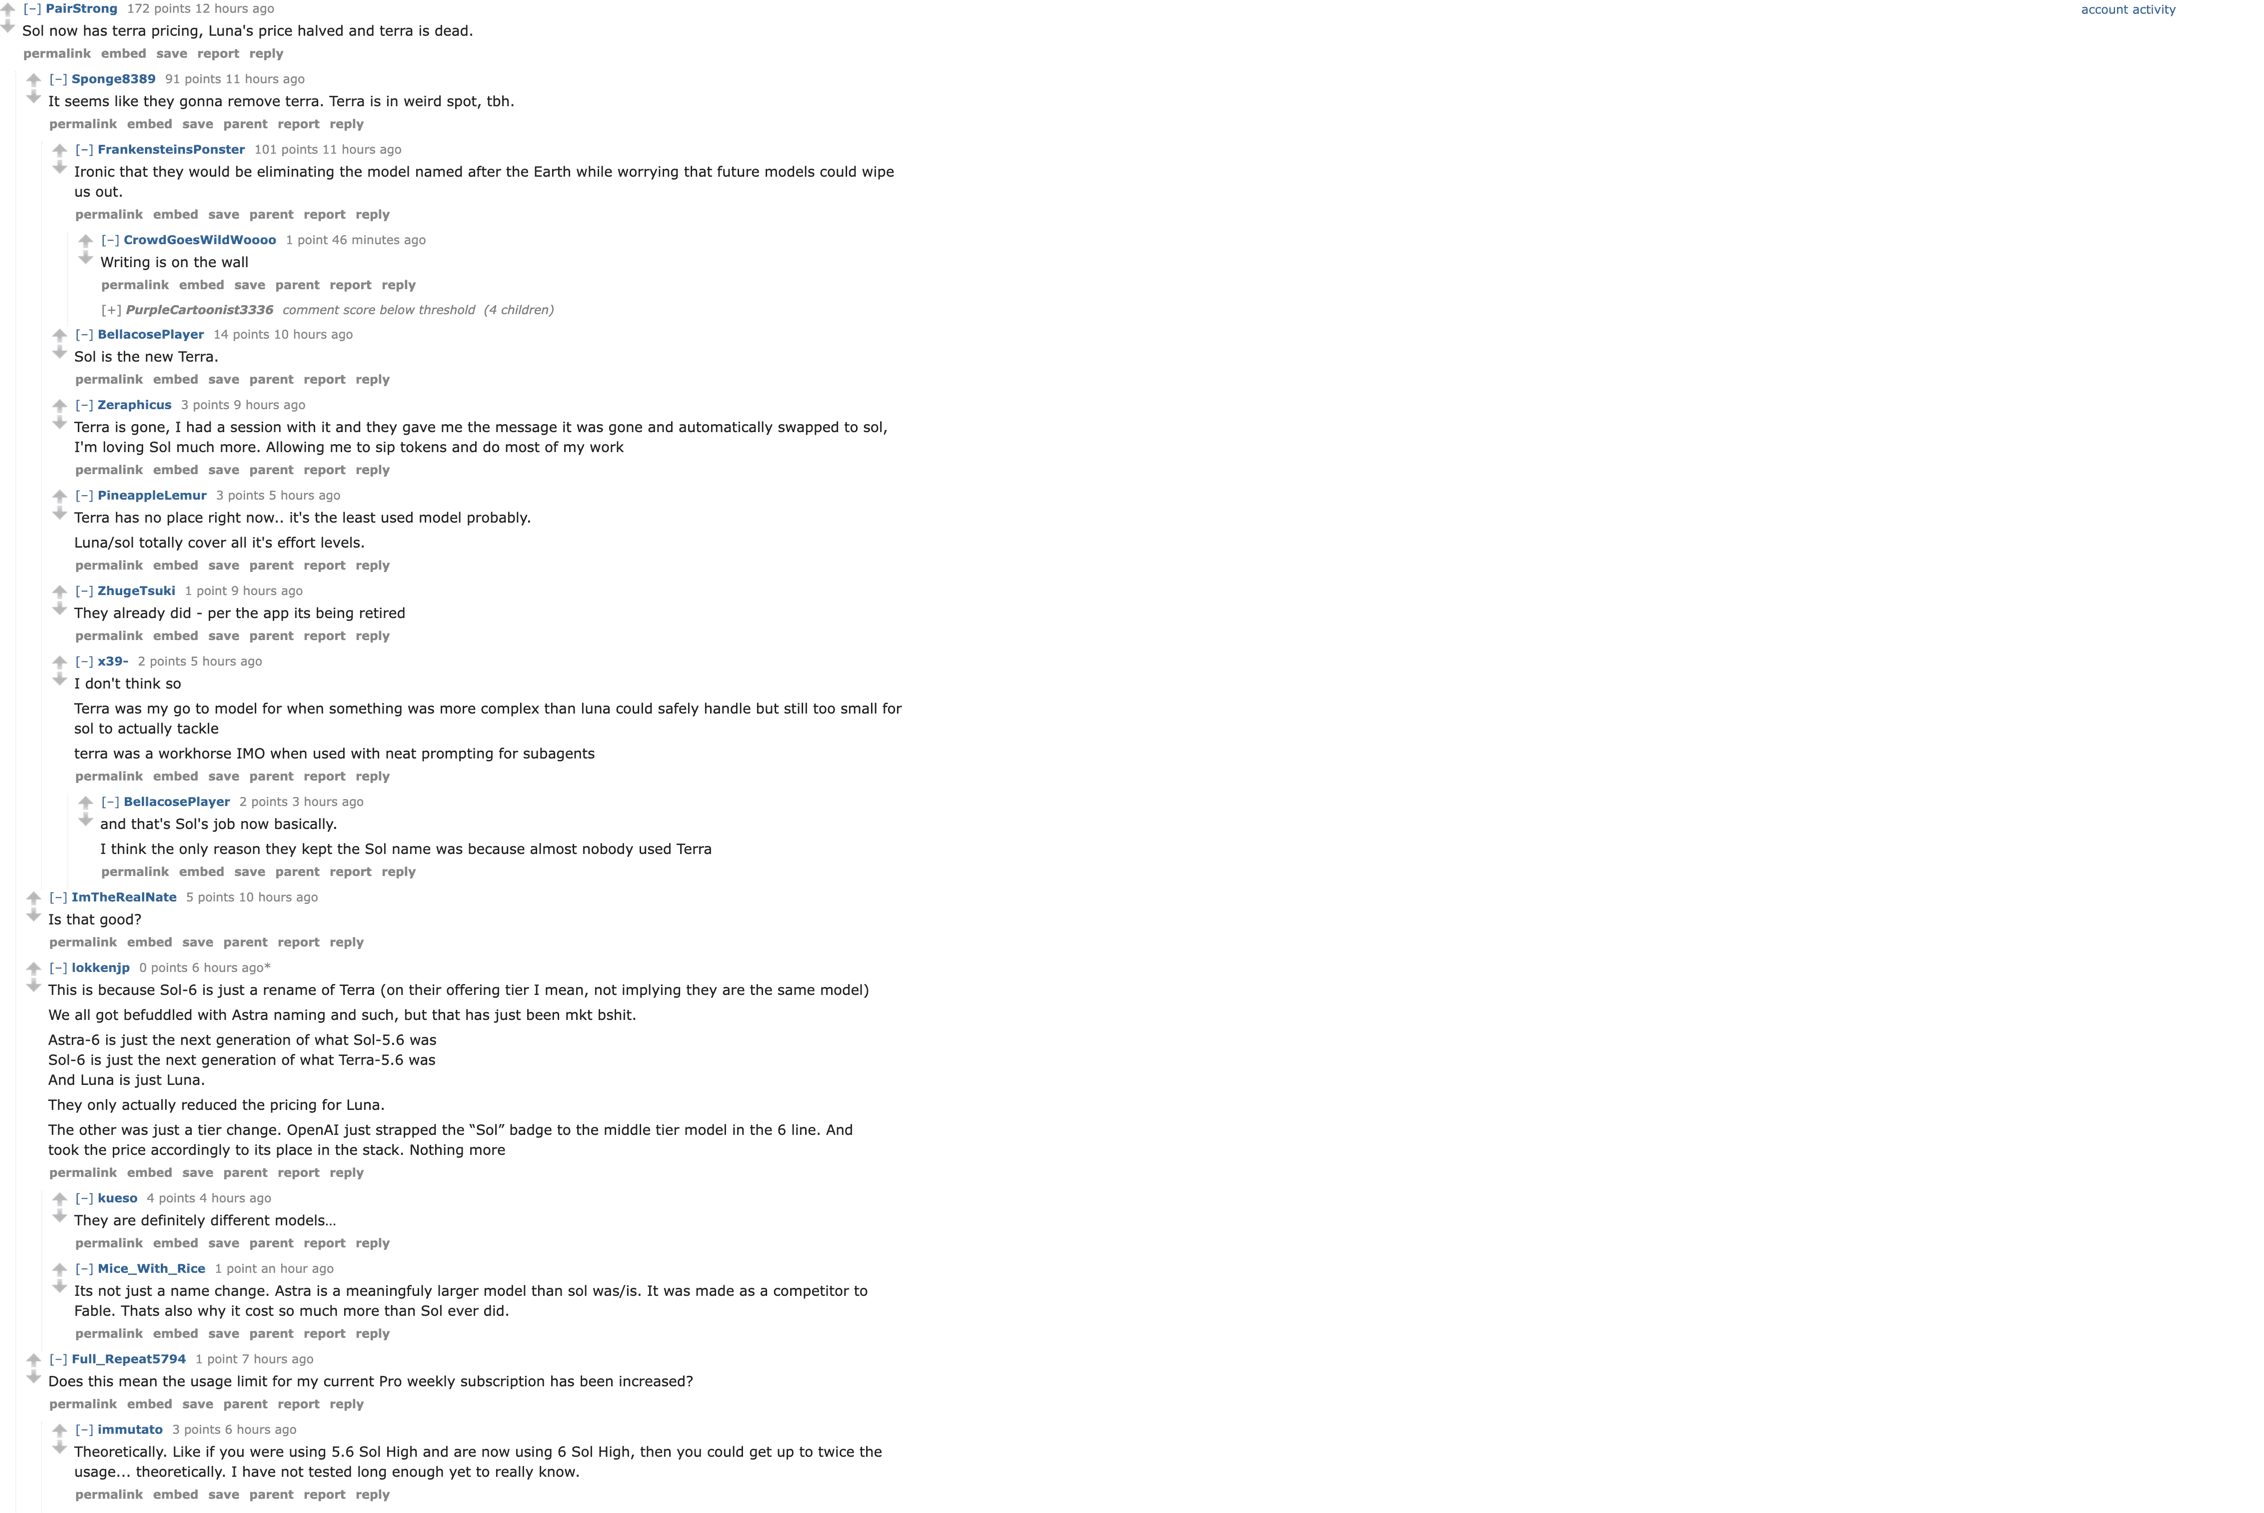
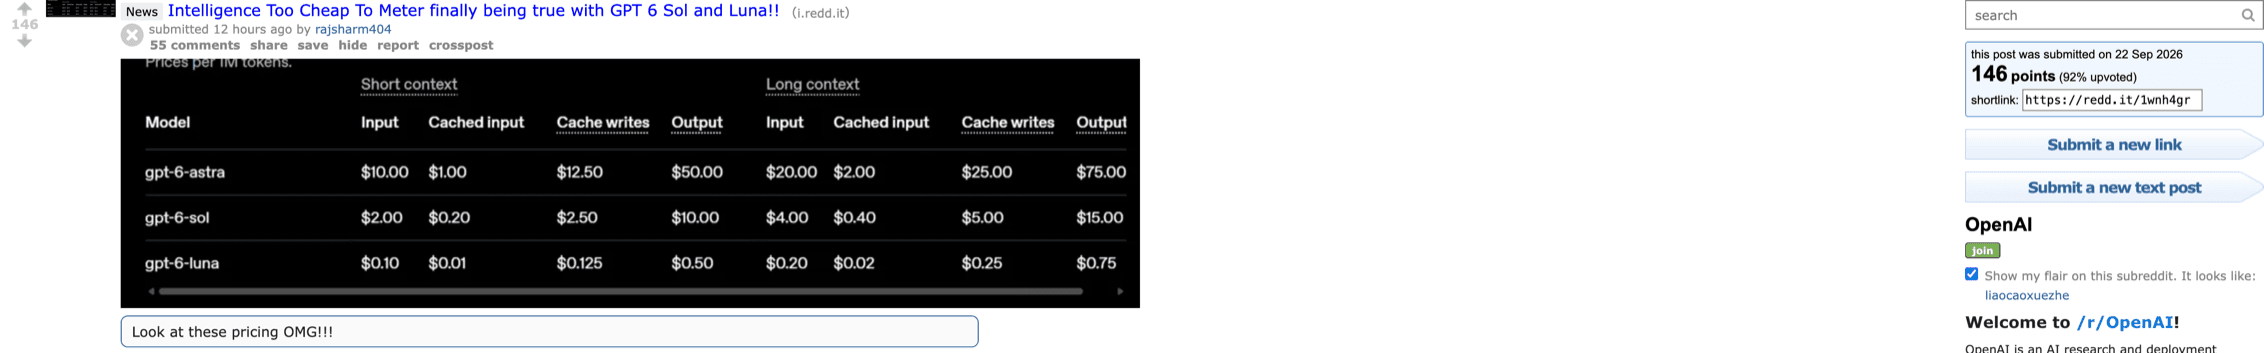
O GPT-6 Luna custa $0.10 por milhão de tokens de entrada e $0.50 por milhão de tokens de saída na tabela de tarifas padrão da API da OpenAI, verificado em 23 de setembro de 2026. A entrada em cache é $0.01, as gravações em cache são $0.125, e prompts acima de 272K tokens de entrada reprecificam toda a solicitação para as tarifas de contexto longo. A reação do dia de lançamento no r/codex leu a tabela em uma linha: "Sol now has terra pricing, Luna's price halved and terra is dead." Frente às tarifas do GPT-5.6 Luna mostradas no anúncio ($0.20/$1.20), a entrada caiu 50% e a saída 58%. (thread do r/codex; preços da OpenAI)
Mas o preço de etiqueta é o número menos interessante desta tabela. A $0.10/$0.50, a tarifa mal aparece na maioria das faturas — o que decide a sua conta é em qual nível de esforço de raciocínio você roda (uma diferença de 15x com preços de token idênticos), sua taxa de acerto de cache, e se um prompt cruza os 272K tokens. Esta página separa a tabela de tarifas da API das assinaturas ChatGPT e Codex, mostra a tabela completa com fontes e datas, e termina com orçamentos calculados e uma calculadora que roda no seu navegador. Se o seu próximo passo depois do orçamento é rodar o Luna em páginas web e arquivos, o Tabbit Browser é uma opção de cliente; ele não muda a cobrança da OpenAI.
Pontos-chave
O contexto curto padrão do GPT-6 Luna custa $0.10 de entrada, $0.01 de entrada em cache, $0.125 de gravações em cache e $0.50 de saída por milhão de tokens; um porta-voz da OpenAI confirmou ao VentureBeat que são tarifas permanentes, não promocionais.
O dial de esforço domina a fatura: a Artificial Analysis mede a mesma tabela entre $0.0045 por tarefa de Index (low) e $0.07 (max) — 15x — e o padrão da API é medium, não max.
Acima de 272K tokens de entrada, todos os tokens da solicitação passam para as tarifas de contexto longo ($0.20 / $0.02 / $0.25 / $0.75 por milhão).
Batch e Flex estão listados pela metade do Standard; Fast é 2x; o processamento regional adiciona 10% onde elegível, e a residência de dados na UE do Luna só existe no Standard.
Uma tarifa de token não é uma cota de assinatura nem um preço por tarefa: o volume de saída (+24% vs. o antecessor nas tarefas de Index da AA), as retentativas e as regressões de qualidade voltam todas para o orçamento.
Preços da API do GPT-6 Luna de relance
Todos os preços são em USD por milhão de tokens, da página de preços da OpenAI e da página do modelo gpt-6-luna, verificadas em 23 de setembro de 2026. As linhas de contexto longo aplicam-se quando a entrada é mais de 272.000 tokens.
| Nível de serviço GPT-6 Luna | Contexto | Entrada | Entrada em cache | Gravações em cache | Saída |
|---|---|---|---|---|---|
| Standard | entrada ≤272K | $0.10 | $0.01 | $0.125 | $0.50 |
| Standard | entrada >272K | $0.20 | $0.02 | $0.25 | $0.75 |
| Batch / Flex | entrada ≤272K | $0.05 | $0.005 | $0.0625 | $0.25 |
| Batch / Flex | entrada >272K | $0.10 | $0.01 | $0.125 | $0.375 |
| Fast | entrada ≤272K | $0.20 | $0.02 | $0.25 | $1.00 |
| Fast | entrada >272K | $0.40 | $0.04 | $0.50 | $1.50 |
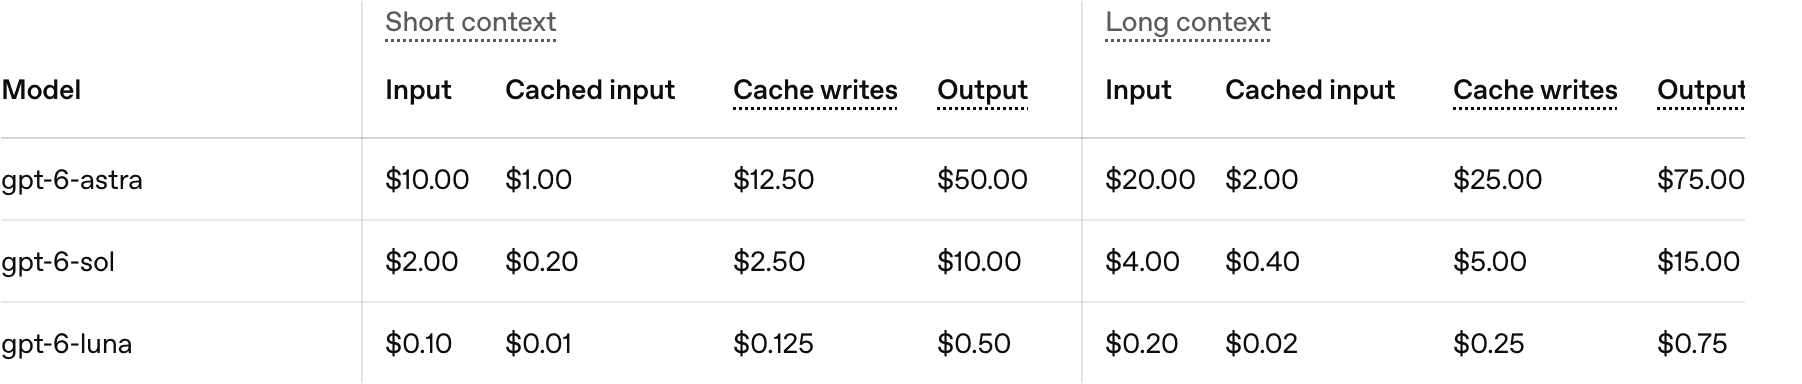
A tabela de tarifas encaixa-se numa escada familiar. Estas são as tarifas Standard de contexto curto da mesma tabela:
| Modelo | Entrada | Entrada em cache | Gravações em cache | Saída | Utilidade da linha |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | Trabalho de alto volume e escopo fechado — o posicionamento do próprio anúncio |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 | Cargas repetidas de código e agentes complexos |
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 | O nível insignia para as tarefas mais difíceis |
| GPT-5.6 Sol (antecessor, promocional) | $4.00 | $0.40 | $5.00 | $20.00 | A base de comparação que a OpenAI ainda lista, promo até pelo menos 21 de nov. |
O Luna é vinte vezes mais barato que o Sol em entrada e saída, e cem vezes mais barato que o Astra. Para a economia dos níveis irmãos, leia a análise de preços do GPT-6 Sol e a do GPT-6 Astra; para o que o nível barato realmente compra em capacidade — e onde regride — leia a resenha do GPT-6 Luna. O histórico de preços do antecessor está no guia de custos do GPT-5.6 Sol.
O número que decide a sua fatura: o dial de esforço
O gpt-6-luna aceita valores de reasoning_effort de none, low, medium (o padrão), high, xhigh e max. Os preços por token não mudam entre eles — o que muda é o número de tokens de raciocínio e de saída. A Artificial Analysis acompanha o Luna como seis entradas, uma por nível, e sua economia medida (instantâneo de 23 de setembro de 2026) é esta:
| Nível de esforço | Intelligence Index | Custo por tarefa de Index da AA | Velocidade de saída |
|---|---|---|---|
| low | 21 | $0.0045 | 175 t/s |
Non-reasoning (none) | 18 | $0.01 | 141 t/s |
| medium (padrão) | 29 | $0.02 | 143 t/s |
| high | 32 | $0.03 | 149 t/s |
| xhigh | 34 | $0.04 | 153 t/s |
| max | 37 | $0.07 | 157 t/s |
Dois detalhes desta tabela importam mais do que as tarifas acima:
A diferença é de 15x. A tabela que parece "$0.10/$0.50" cobra entre meio centavo e sete centavos por tarefa de Index da AA dependendo inteiramente de um parâmetro de solicitação. O padrão é medium ($0.02, Index 29). A inteligência do comunicado (Index 37) só existe no max ($0.07). Se você copia números de benchmark do fornecedor para um caso de negócio, faça o orçamento no nível em que o benchmark rodou.
O esforço low é mais barato que desligar o raciocínio. A $0.0045, o
lowsupera ononea $0.01 na carga da AA, porque as execuções sem raciocínio emitiram mais tokens de saída por tarefa. "Desligar o pensamento para economizar" não é automaticamente a configuração mais barata neste modelo — é uma hipótese a testar nos seus próprios traces.
Os próprios números de lançamento da OpenAI apontam na mesma direção. No AutomationBench — um teste de fluxos de trabalho de negócio com 47 ferramentas — o GPT-6 Luna no esforço high melhorou seu antecessor em 5.4 pontos percentuais com 58% menos custo por tarefa; na factualidade interna, "at higher effort levels it matches GPT-5.6 Sol at about a hundredth its cost". Leia-os como afirmações condicionadas ao esforço: o nível barato as alcança quando você paga o pensamento.
Um usuário do dia de lançamento descreveu assim o efeito do dial na forma da saída: "5.6 Luna yapped a lot about unnecessary stuff, while 6 Luna is much more to the point… 6 Luna just gives you the solution and stops talking." A concisão faz parte da história do custo — mas os inspetores da AA também ligaram as regressões de trabalho de conhecimento (seções de rúbrica omitidas, entregáveis mais finos) à mesma avareza de tokens, então trate a saída enxuta como um trade-off, não como uma vitória grátis. (comentário no r/codex)

Traduzindo a alegação de "50% mais barato"
O cartão de preços do anúncio mostra o Luna indo de $0.20 → $0.10 na entrada e $1.20 → $0.50 na saída, ambos rotulados "50% cheaper". A aritmética da saída é −58.3%; o enquadramento da OpenAI conta degraus de preço em dólares inteiros. Nenhuma leitura está errada, mas a base importa: esses números do GPT-5.6 eram eles mesmos tarifas promocionais, e o VentureBeat relata que um porta-voz confirmou que os novos preços do GPT-6 Sol e Luna são permanentes, não promocionais. (anúncio; VentureBeat)
A medição independente concorda com a direção e acrescenta as letras miúdas. A Artificial Analysis mediu o Luna (max) em $0.07 por tarefa de Index contra $0.18 do GPT-5.6 Luna (max) — cerca de 60% menos — enquanto o modelo novo usou mais tokens de saída por tarefa (51k contra 41k). O corte de preço carregou a economia; a eficiência de tokens, não. Os leitores dos gráficos de lançamento capturaram a mesma forma: "it really looks like luna 6.0 is just as smart as luna 5.6 at less than half the cost." (thread de benchmarks do r/codex)

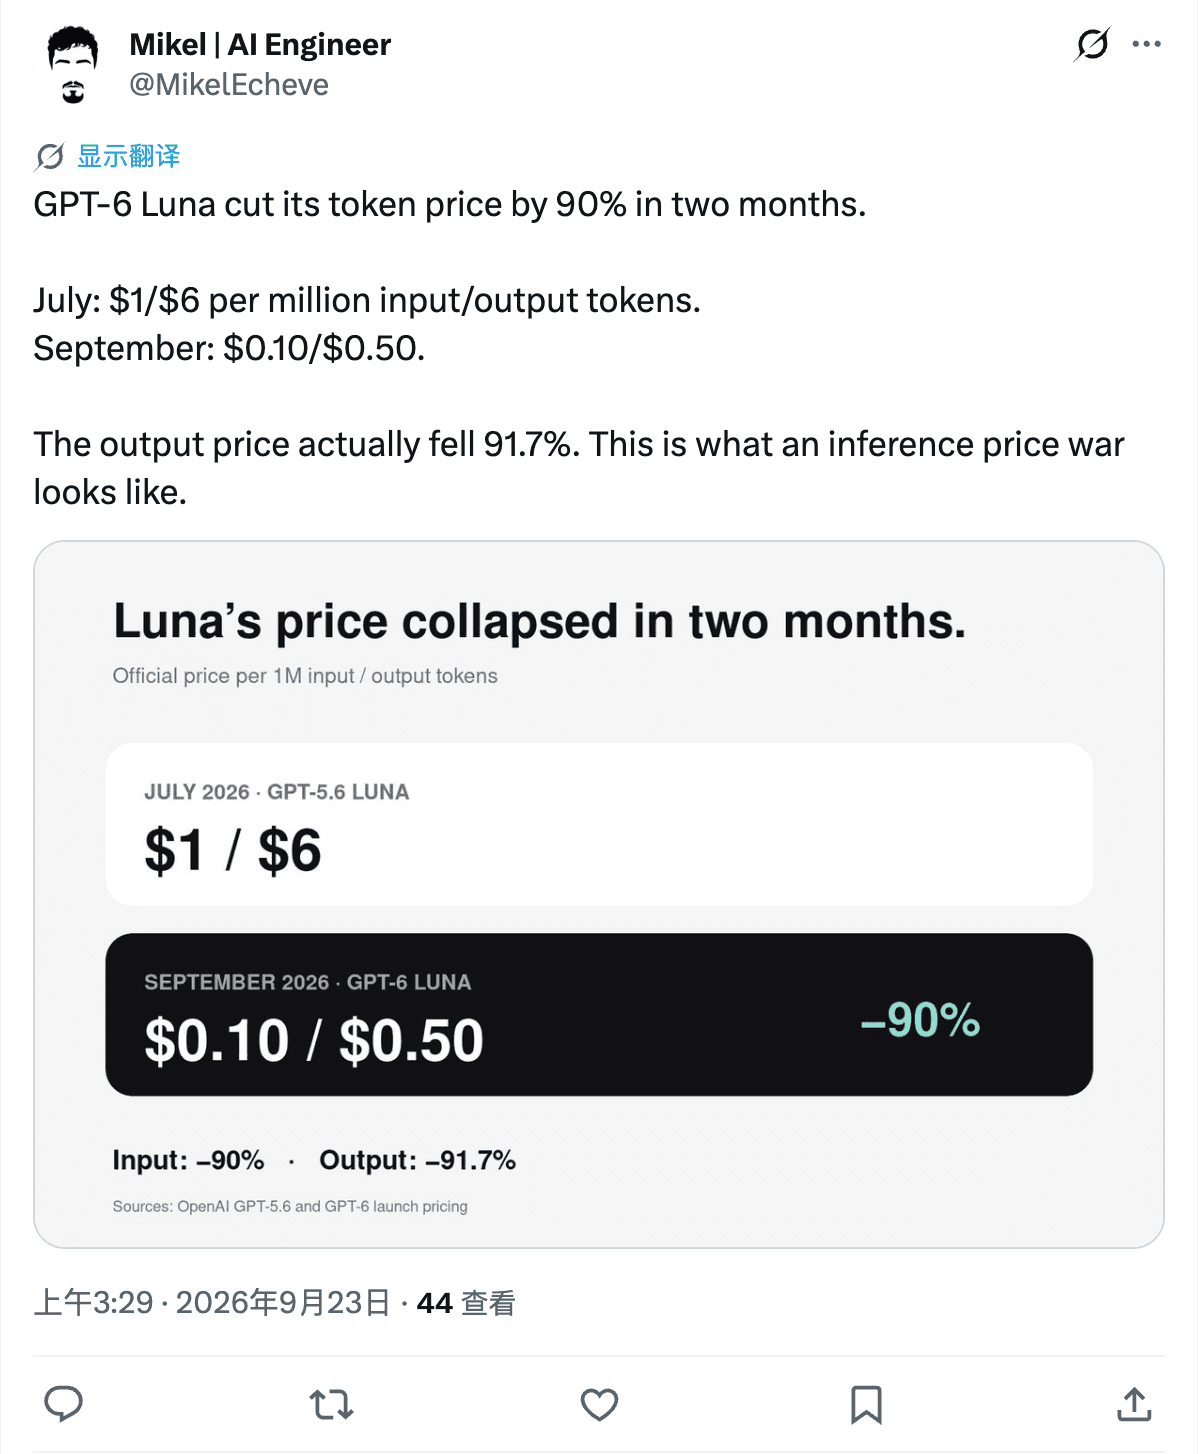
O enquadramento mais amplo usado por alguns profissionais é o de guerra de preços. "GPT-6 Luna cut its token price by 90% in two months. July: $1/$6 per million input/output tokens. September: $0.10/$0.50… This is what an inference price war looks like", publicou um engenheiro de IA. O número de julho — a tarifa padrão anterior do GPT-5.6 Luna, antes de sua própria promo — é uma alegação do autor e não pode mais ser verificada nas páginas atuais da OpenAI, então trate-a como contexto da comunidade, não como histórico oficial de preços. (post no X)
Economia do cache: leituras de $0.01, gravações de $0.125
Para loops de agente que reenviam o mesmo contexto, as linhas de cache importam mais do que as tarifas de manchete. A entrada em cache do Luna é $0.01 por milhão — um décimo da entrada nova, o desconto máximo de 90% que a OpenAI anuncia para o cache do GPT-6 — enquanto as gravações em cache são $0.125, um prêmio de 25% sobre a tarifa de entrada. Daí seguem duas regras contábeis: os volumes de gravação são uma linha separada das leituras, e um token deve ser contado uma vez — como gravação quando o prefixo é armazenado, e à tarifa de cache nos turnos que o reutilizam dentro da janela de elegibilidade de 30 minutos que a OpenAI descreve. (post sobre cache; página de preços)
O GPT-6 também mudou o comportamento do cache, não só o preço: as taxas de acerto são mais altas por padrão, e existem controles novos justamente porque os agentes relêem o contexto a cada turno — um painel de cache, diagnóstico de erros de cache, breakpoints explícitos, pré-aquecimento, e a capacidade de mudar o esforço de raciocínio entre respostas sem quebrar o cache (útil quando você quer max no turno difícil e low no acompanhamento rotineiro). O post da OpenAI credita ao GitHub uma redução de mais de 50% na parcela de tokens de prompt exigindo processamento novo em bilhões de solicitações, e a um cliente um corte de custos de 20% por alguns pontos extras de acerto.
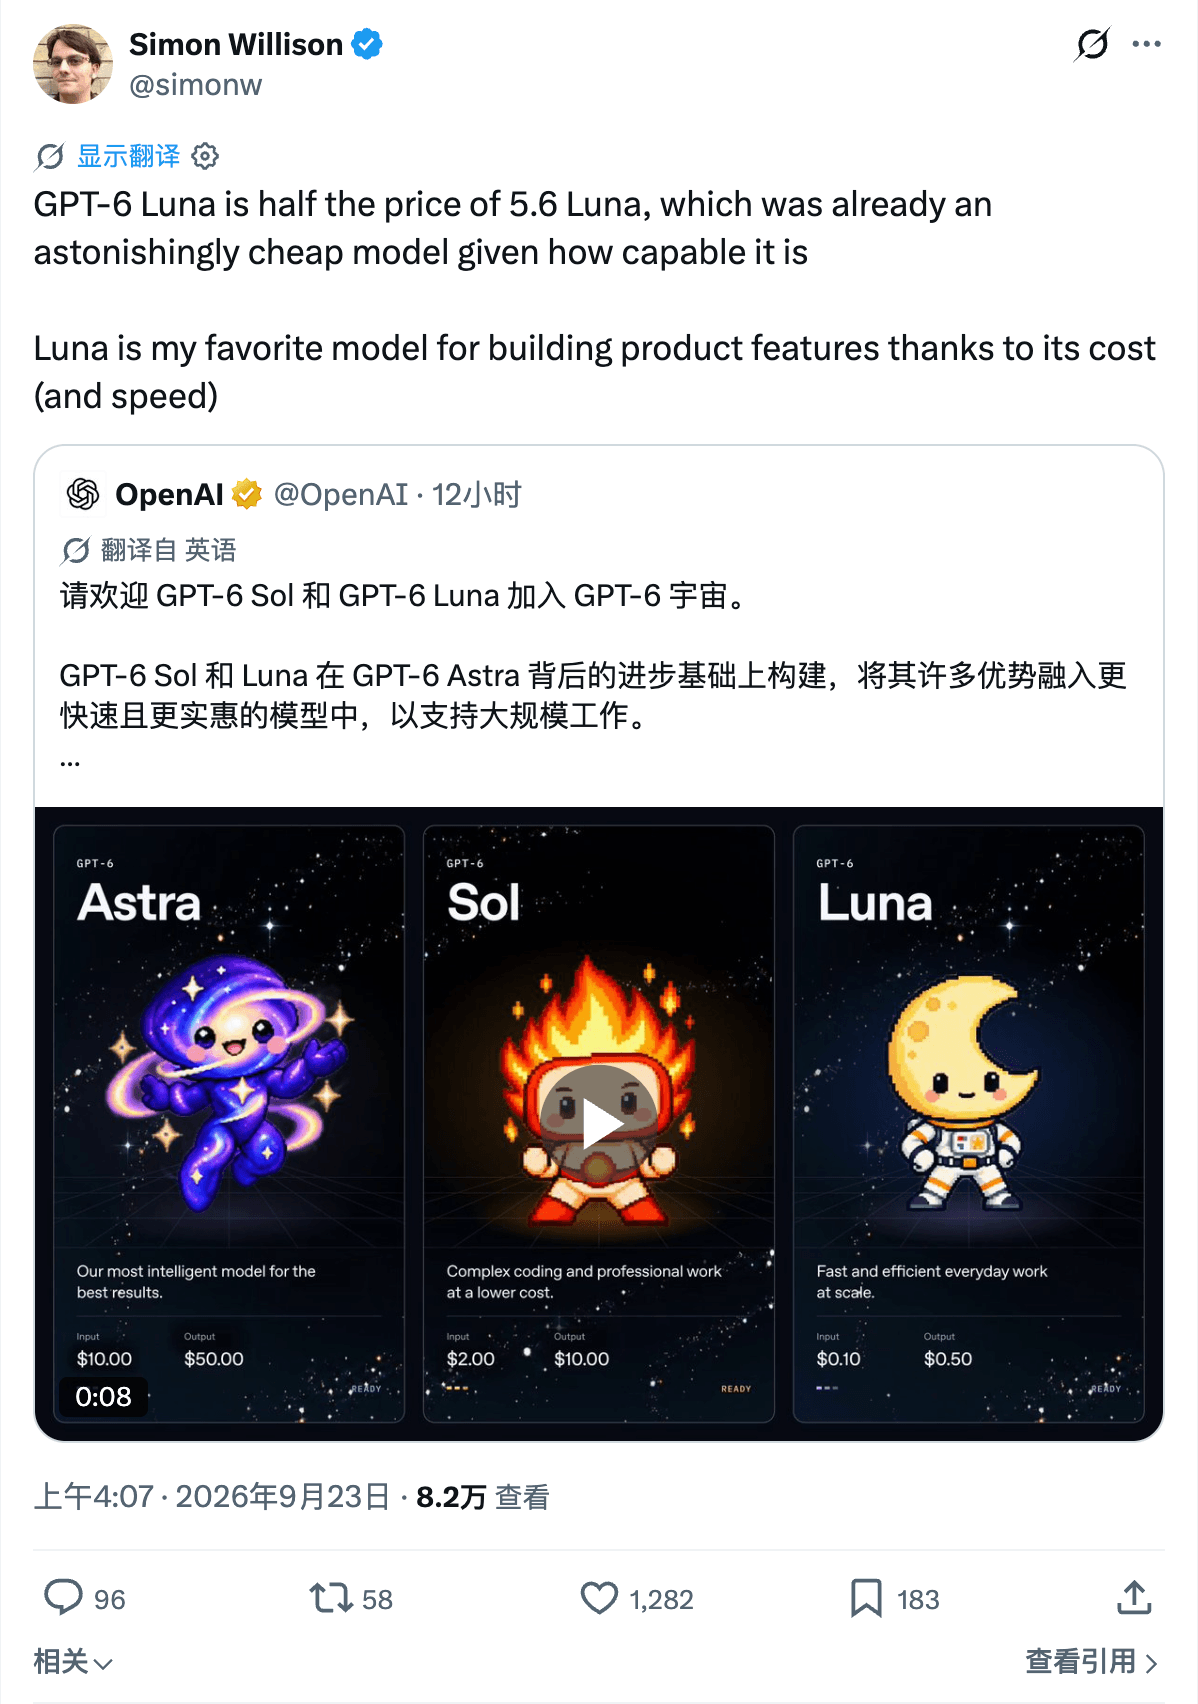
Os profissionais notaram a economia imediatamente. "Luna is my favorite model for building product features thanks to its cost (and speed)", escreveu Simon Willison no dia do lançamento — o padrão de roteamento que torna as leituras em cache a $0.01 e a geração a 141–175 t/s a combinação de trabalho para superfícies de produto. (post no X)
O penhasco de contexto longo de 272K
A frase da página do modelo é curta: prompts com mais de 272K tokens de entrada são precificados a 2x nas tarifas de entrada e cache e 1.5x na saída para toda a solicitação. É um limiar no nível da solicitação, não uma sobretaxa sobre os tokens excedentes. Um prompt de 273.000 tokens não paga a tarifa de contexto curto nos primeiros 272K — cada categoria cobrável, incluindo a saída, usa a linha de contexto longo.
A janela em si é de 1.050.000 tokens com 128.000 de saída máxima. "Cabe no contexto" e "mesmo preço por token" são afirmações distintas. Se seus prompts rondam o limiar, deixe margem: um documento acrescentado pode reprecificar a solicitação inteira. É a mesma estrutura de penhasco do Sol — o guia de preços do GPT-6 Sol a desenvolve em detalhe, e a mesma disciplina se aplica aqui a um décimo da escala.
Itens além da tarifa de manchete
Batch e Flex cortam a tabela pela metade; Fast a dobra. A OpenAI lista Batch e Flex a 50% das tarifas Standard — a maior alavanca única para trabalho tolerante a latência. O modo Fast (Priority foi renomeado para Fast em 30 de julho de 2026) é 2x. Verifique se o seu endpoint realmente usa o nível antes de reservar qualquer um dos multiplicadores.
O processamento regional adiciona 10%. Endpoints elegíveis de residência de dados para modelos lançados em ou após 5 de março de 2026 carregam um acréscimo de 10%, e a residência de dados na UE do GPT-6 Luna só está disponível com processamento Standard.
Tokens de ferramentas são cobrados às tarifas do modelo. Os tokens consumidos por ferramentas integradas são cobrados às tarifas de token do modelo escolhido; algumas ferramentas e sessões hospedadas têm taxas separadas. Tentativas falhadas que consumiram tokens também pertencem ao orçamento.
Existe uma variante "Pro" nos roteadores. O OpenRouter lista o "GPT-6 Luna Pro" — o mesmo modelo subjacente, "served with reasoning.mode set to pro for higher-quality responses on complex tasks" — ao mesmo preço base de $0.10/$0.50. É uma configuração de serviço do provedor, não uma linha adicional da tabela da OpenAI; trate-a como uma opção de roteamento a avaliar, não como um modelo diferente. (OpenRouter)
Limites: o nível gratuito está fechado. A página do modelo marca o gpt-6-luna como "não suportado" no Free, com acesso pago a partir do Tier 1 (500 RPM / 500K TPM / 5M de tokens de fila de Batch) até o Tier 5 (30.000 RPM / 180M TPM). Notavelmente, a OpenAI publica limites de tokens por minuto mais altos para o Luna do que para o Sol nos mesmos níveis pagos — o Tier 2 é 2M TPM para o Luna contra 1M para o Sol — o que se lê como um convite para usar o modelo barato em volume. (página do modelo)
| Nível de API | RPM | TPM | Limite de fila Batch |
|---|---|---|---|
| Free | Não suportado | — | — |
| Tier 1 | 500 | 500.000 | 5M tokens |
| Tier 2 | 5.000 | 2.000.000 | 20M tokens |
| Tier 3 | 5.000 | 4.000.000 | 40M tokens |
Fonte: página do modelo gpt-6-luna da OpenAI, verificada em 23 de setembro de 2026.
A escada familiar e o mercado aberto
Dentro da escada da OpenAI, a lógica de roteamento é direta: teste o Luna primeiro para etapas de alto volume e escopo fechado; escale para o Sol quando uma tentativa falha custa caro; reserve o Astra para o trabalho mais difícil. O próprio anúncio posiciona o Luna para "tarefas mais estreitamente definidas, como sumarização, extração e resposta a perguntas diretas".
A descoberta contraintuitiva é que o Luna não é a API capaz mais barata do mercado aberto. A tabela comparativa do dia de lançamento do VentureBeat lista o Muse Spark 1.2/1.3 Contributor da Meta a $0.10/$0.20 e o MiMo-V2.6-Flash da Xiaomi a $0.14/$0.28 — ambos com taxas combinadas de entrada+saída mais baixas que os $0.60 do Luna — e o V4.1 Flash da DeepSeek a $0.15/$0.60 fora do horário de pico. O que o Luna compra com seu prêmio é o ecossistema da OpenAI: uma janela de 1.05M de tokens, a pilha de ferramentas e cache do GPT-6, e folga de níveis de esforço a partir de tarefas de $0.0045 para cima. Se o único critério for o preço mínimo, o mercado aberto supera. (tabela do VentureBeat)
| Modelo econômico | Entrada / Saída por 1M | Combinado | Restrição notável |
|---|---|---|---|
| Muse Spark 1.2/1.3 (Contributor) | $0.10 / $0.20 | $0.30 | Disponibilidade do nível Contributor |
| MiMo-V2.6-Flash | $0.14 / $0.28 | $0.42 | Ecossistema menor |
| GPT-6 Luna | $0.10 / $0.50 | $0.60 | Nível gratuito de API fechado; trade-offs de formato (ver resenha) |
| DeepSeek-V4.1-Flash (fora do pico) | $0.15 / $0.60 | $0.75 | Tarifas de pico dobradas; só texto |
A leitura da comunidade sobre a trajetória é expansionista: "I feel 2027 will be the year when intelligence will be economical enough to use at most of the places", previu a resposta mais votada da thread de lançamento no r/OpenAI. Direção útil, inverificável como profecia. (thread do r/OpenAI)
O que a tabela de tarifas não diz
Não é uma calculadora de assinatura. Os planos do ChatGPT e do Codex definem seus próprios limites de uso; um corte de 50% no preço do token não dobra matematicamente a alocação de nenhum plano. No lançamento, o GPT-6 Luna chegou ao ChatGPT Work e ao Codex para usuários Plus, Pro, Business, Enterprise e Edu, enquanto os planos Free e Go só o obtiveram no app de desktop. A experiência de assinatura trouxe suas próprias queixas: "it's faster on xhigh and my usage is barely going down", relatou um usuário do Codex, e numa thread de preços o resumo lacônico foi "Reduced pricing and reduced limits." A aritmética da API e as cotas do plano são compras diferentes — consulte a página de uso ao vivo do seu plano. (comentário de uso; thread de preços)

Também não é um preço por tarefa. A AA mediu o Luna usando 24% mais tokens de saída por tarefa de Index que seu antecessor, e seus inspetores atribuíram as regressões de trabalho de conhecimento (~75 Elo no GDPval-AA, ~45 no AA-Briefcase) à apresentação omitida e a elementos de rúbrica ausentes. Uma tarefa que o Luna falha ou trunca é retentada — num modelo mais caro se você escalar — e as retentativas são cobradas. A resenha do GPT-6 Luna cobre a evidência de qualidade; a consequência orçamentária é que a métrica a acompanhar é o custo por tarefa bem-sucedida, não o custo por token: o gasto total incluindo falhas, dividido pelas tarefas que você realmente entregou.
Uma opção prática: Tabbit Browser
Se a questão do orçamento está resolvida e a próxima é onde rodar o Luna em trabalho real — páginas abertas, arquivos, tarefas de pesquisa —, o Tabbit Browser é uma resposta que não exige cablar uma integração de API. Seu seletor de modelos permite escolher modelos como o GPT-6 Luna ao lado das suas abas abertas, e o hub do modelo GPT-6 Luna (English) reúne as referências do lado do navegador: notas de prompts (English) para solicitações em formato de tarefa e notas de resenha (English) sobre o que os usuários relataram.
A fronteira honesta: o Tabbit é um cliente. Ele não muda as tarifas da OpenAI, e uma estimativa de tokens de API nesta página não prevê o uso de nenhuma assinatura ou cliente. A disponibilidade do modelo depende do seletor ao vivo da sua conta e edição. Este artigo não tem fatura medida do Tabbit, taxa de sucesso de tarefas nem resultado de latência para o Luna — se precisar desses números, execute seu próprio conjunto fixo de tarefas e guarde os recibos.
 Tabbit Browser
Para o contexto de fluxo de trabalho — por que um navegador de IA ou um navegador agêntico muda onde um modelo trabalhador barato é útil — esses guias cobrem o lado do cliente; a tabela de tarifas acima continua sendo a fonte para a cobrança de tokens.
Dois exemplos de orçamento
Os exemplos usam tarifas Standard de contexto curto, sem acréscimo regional, taxas de ferramentas, retentativas nem impostos. São ilustrações aritméticas, não cargas de trabalho medidas.
Solicitação curta. 10.000 tokens de entrada sem cache e 2.000 tokens de saída:
(10.000 × $0.10 + 2.000 × $0.50) / 1.000.000 = $0.002Loop de agente aquecido. Uma execução de 40 turnos que reenvia um prompt de 250.000 tokens a cada turno, com 90% servido do cache (gravado uma vez, reutilizado dentro da janela de 30 minutos) e 3.000 tokens de saída por turno. Por turno:
(225.000 × $0.01 + 25.000 × $0.10 + 3.000 × $0.50) / 1.000.000 = $0.00625 por turno...mais a gravação única do prefixo armazenado de 225K tokens a $0.125 por milhão (cerca de $0.03). Em 40 turnos, o loop com cache fatura cerca de $0.28, onde reler o mesmo prompt sem cache a cada turno custaria cerca de $1.06 — quase uma diferença de 4x com preços de token idênticos, decidida inteiramente pela parcela de acerto de cache. Na escala do Luna, ambos são centavos; multiplique por um milhão de turnos mensais e o padrão com cache fatura cerca de $7.000 (gravações incluídas) contra cerca de $26.500 a frio. Essa é a forma de carga de trabalho onde a linha de entrada em cache a $0.01 do Luna, e não o preço de manchete, é a verdadeira notícia.
Para planejar: estimativa mensal = custo médio por tarefa × tarefas mensais; custo por tarefa bem-sucedida = gasto total incluindo tentativas falhas ÷ tarefas bem-sucedidas. Cotas de assinatura e eventuais taxas do cliente não podem ser derivadas dessas fórmulas.
Calculadora local
Estime o custo da API do GPT-6 Luna
Tarifas oficiais em USD verificadas em 23/09/2026. Os valores ficam neste navegador.
Não inclui ferramentas, novas tentativas, impostos ou processamento regional. Escritas e leituras de cache são cobradas separadamente. Ver tarifas atuais
A calculadora roda no seu navegador e não envia nada a lugar nenhum. Ela estima cobranças de tokens a partir do seu volume de entrada, parcela de cache, gravações de cache, saída, número de execuções e nível de serviço; muda para tarifas de contexto longo acima de 272K de entrada. Não inclui processamento regional, taxas de ferramentas, impostos, margens de provedores, retentativas nem limites de assinatura.
Preços do GPT-6 Luna: qual opção você deve escolher?
| Se a sua prioridade é… | Comece com… | Mantenha na estimativa |
|---|---|---|
| Volume máximo, tarefas de escopo fechado | Luna no esforço low ou medium | A faixa de 15x entre níveis, o crescimento de tokens de saída, as retentativas |
| Raciocínio profundo mas barato em etapas difíceis | Luna no high/xhigh, com o prefixo em cache | Janela de 30 minutos; mudar esforço preserva o cache |
| Pipelines em lote ou offline | Batch ou Flex se elegíveis | Tarifa de 50% do nível; restrições de fila e latência |
| Prompts perto de 272K | Cortar contexto ou orçar a linha longa | Reprecificação de toda a solicitação acima do limiar |
| Latência interativa | Esforço low ou none; Fast só se necessário | Fast dobra as tarifas; o TTFT varia por nível |
| Uso consumidor do ChatGPT/Codex | Os limites próprios do plano correspondente | Cotas do plano não são aritmética de tokens de API |
Veredito
A tabela do GPT-6 Luna é a mais barata pela qual a OpenAI já vendeu um modelo de classe GPT-6: $0.10/$0.50 por milhão, permanente segundo o porta-voz da empresa, com a entrada em cache a um décimo. O orçamento honesto trata a etiqueta como o piso, não como a fatura. Só o dial de esforço move o custo medido por tarefa em 15x entre low e max; o volume de saída cresceu frente ao antecessor; o penhasco de 272K reprecifica solicitações inteiras; e as regressões de qualidade convertem-se em custos de retentativa exatamente nas cargas onde você celebraria o preço. Ajuste o esforço deliberadamente, use o cache agressivamente, acompanhe o custo por tarefa bem-sucedida — e compare assinaturas pelas alocações publicadas, nunca por aritmética de tokens.
As reações do dia de lançamento são direcionais, não definitivas: entusiasmo pela "inteligência barata demais para medir", cautela porque "the consequence of its work will not be seen or measured… until a few days". A página de preços da OpenAI é a fonte ao vivo; verifique-a novamente antes de comprometer um orçamento.
Fontes
Preços da API da OpenAI — linhas do Luna, Sol, Astra e GPT-5.6 Sol; notas regionais e do Fast; verificado em 23 de setembro de 2026.
Página do modelo gpt-6-luna da OpenAI — contexto, saída, valores de esforço, cláusula 272K, limites; verificada em 23 de setembro de 2026.
OpenAI: Introducing GPT-6 Sol and Luna — cartão de mudança de preços, alegações de AutomationBench e factualidade, disponibilidade.
OpenAI: Better prompt caching for GPT-6 — desconto de 90%, janela de 30 minutos, controles de cache, resultados do GitHub e de clientes.
Artificial Analysis: painel de lançamento do GPT-6 Luna — instantâneo de Index, custo por tarefa e velocidade por níveis, 23 de setembro de 2026.
Artificial Analysis: GPT-6 Sol and Luna push the cost efficiency frontier — custo por tarefa de $0.18 → $0.07, crescimento de tokens de saída, atribuições de regressão.
VentureBeat: OpenAI releases GPT-6 Sol and Luna — confirmação de permanência; tabela de preços entre fornecedores, 22 de setembro de 2026.
OpenRouter: GPT-6 Luna e GPT-6 Luna Pro (batch) — listagens de provedores e a variante de serviço Luna Pro, 23 de setembro de 2026.
Registros da comunidade com capturas e condições no texto: r/codex 1wngvak, r/codex 1wnhyh0, r/codex 1wnmhnq, r/codex 1wnhuru, r/OpenAI 1wnh4gr, X: Simon Willison, X: Mikel Echeve.

Perguntas frequentes
Quanto custa o GPT-6 Luna por milhão de tokens?
As tarifas padrão de API de contexto curto da OpenAI são $0.10 por milhão de tokens de entrada, $0.01 por milhão de entrada em cache, $0.125 por milhão de gravações em cache e $0.50 por milhão de tokens de saída. Acima de 272.000 tokens de entrada, toda a solicitação usa as tarifas de contexto longo: $0.20, $0.02, $0.25 e $0.75, respectivamente.
O preço da API do GPT-6 Luna é permanente ou promocional?
O anúncio de lançamento apresenta as novas tarifas como 50% abaixo dos preços promocionais do GPT-5.6, e um porta-voz da empresa confirmou ao VentureBeat que as tarifas do GPT-6 Sol e Luna são preços permanentes, não promocionais nem de introdução. A tarifa de comparação do GPT-5.6 Sol continua rotulada como promocional pelo menos até 21 de novembro de 2026.
Qual é a forma mais barata de executar o GPT-6 Luna?
Três alavancas dominam a fatura: o nível de raciocínio, o cache e o nível de serviço. A Artificial Analysis mede a mesma tabela entre $0.0045 por tarefa de Index no esforço low e $0.07 no max, a leitura de cache custa um décimo da entrada nova, e Batch ou Flex estão listados a 50% das tarifas Standard para trabalhos que toleram seus tempos.
O GPT-6 Luna tem precificação de contexto longo?
Tem. Prompts com mais de 272.000 tokens de entrada são cobrados a 2x nas tarifas de entrada e cache e 1.5x na de saída para toda a solicitação, não apenas para os tokens acima do limite. A janela de contexto é de 1.050.000 tokens, então caber no contexto não significa pagar a tarifa de contexto curto.
O preço da API do GPT-6 Luna equivale ao uso do ChatGPT ou Codex?
Não. A API cobra tokens; os planos do ChatGPT e do Codex definem seus próprios limites de uso. No lançamento, o GPT-6 Luna estava disponível no ChatGPT Work e no Codex para usuários Plus, Pro, Business, Enterprise e Edu, enquanto os planos Free e Go só podiam usá-lo no app de desktop. Uma tarifa de token mais barata não significa automaticamente mais uso na assinatura.
Posso usar o GPT-6 Luna no nível gratuito da API?
Não. A tabela de limites da página do modelo marca o gpt-6-luna como "não suportado" no nível Free, com acesso pago a partir do Tier 1 (500 solicitações por minuto, 500.000 tokens por minuto). A OpenAI também publica limites de tokens por minuto mais altos para o Luna do que para o Sol nos mesmos níveis pagos.