
截至 2026 年 10 月 27 日,GPT-6.1 Terra 的 Standard 短上下文 API 价格为每百万普通输入 token 1 美元、缓存读取 0.05 美元、输出 5 美元。缓存写入属于独立的输入计费类别,保留 30 分钟收费 1.25 美元,保留 12 小时收费 2.50 美元。这些是 API 单价,不是 ChatGPT 或 Tabbit 的订阅价格。(OpenAI 价格表)
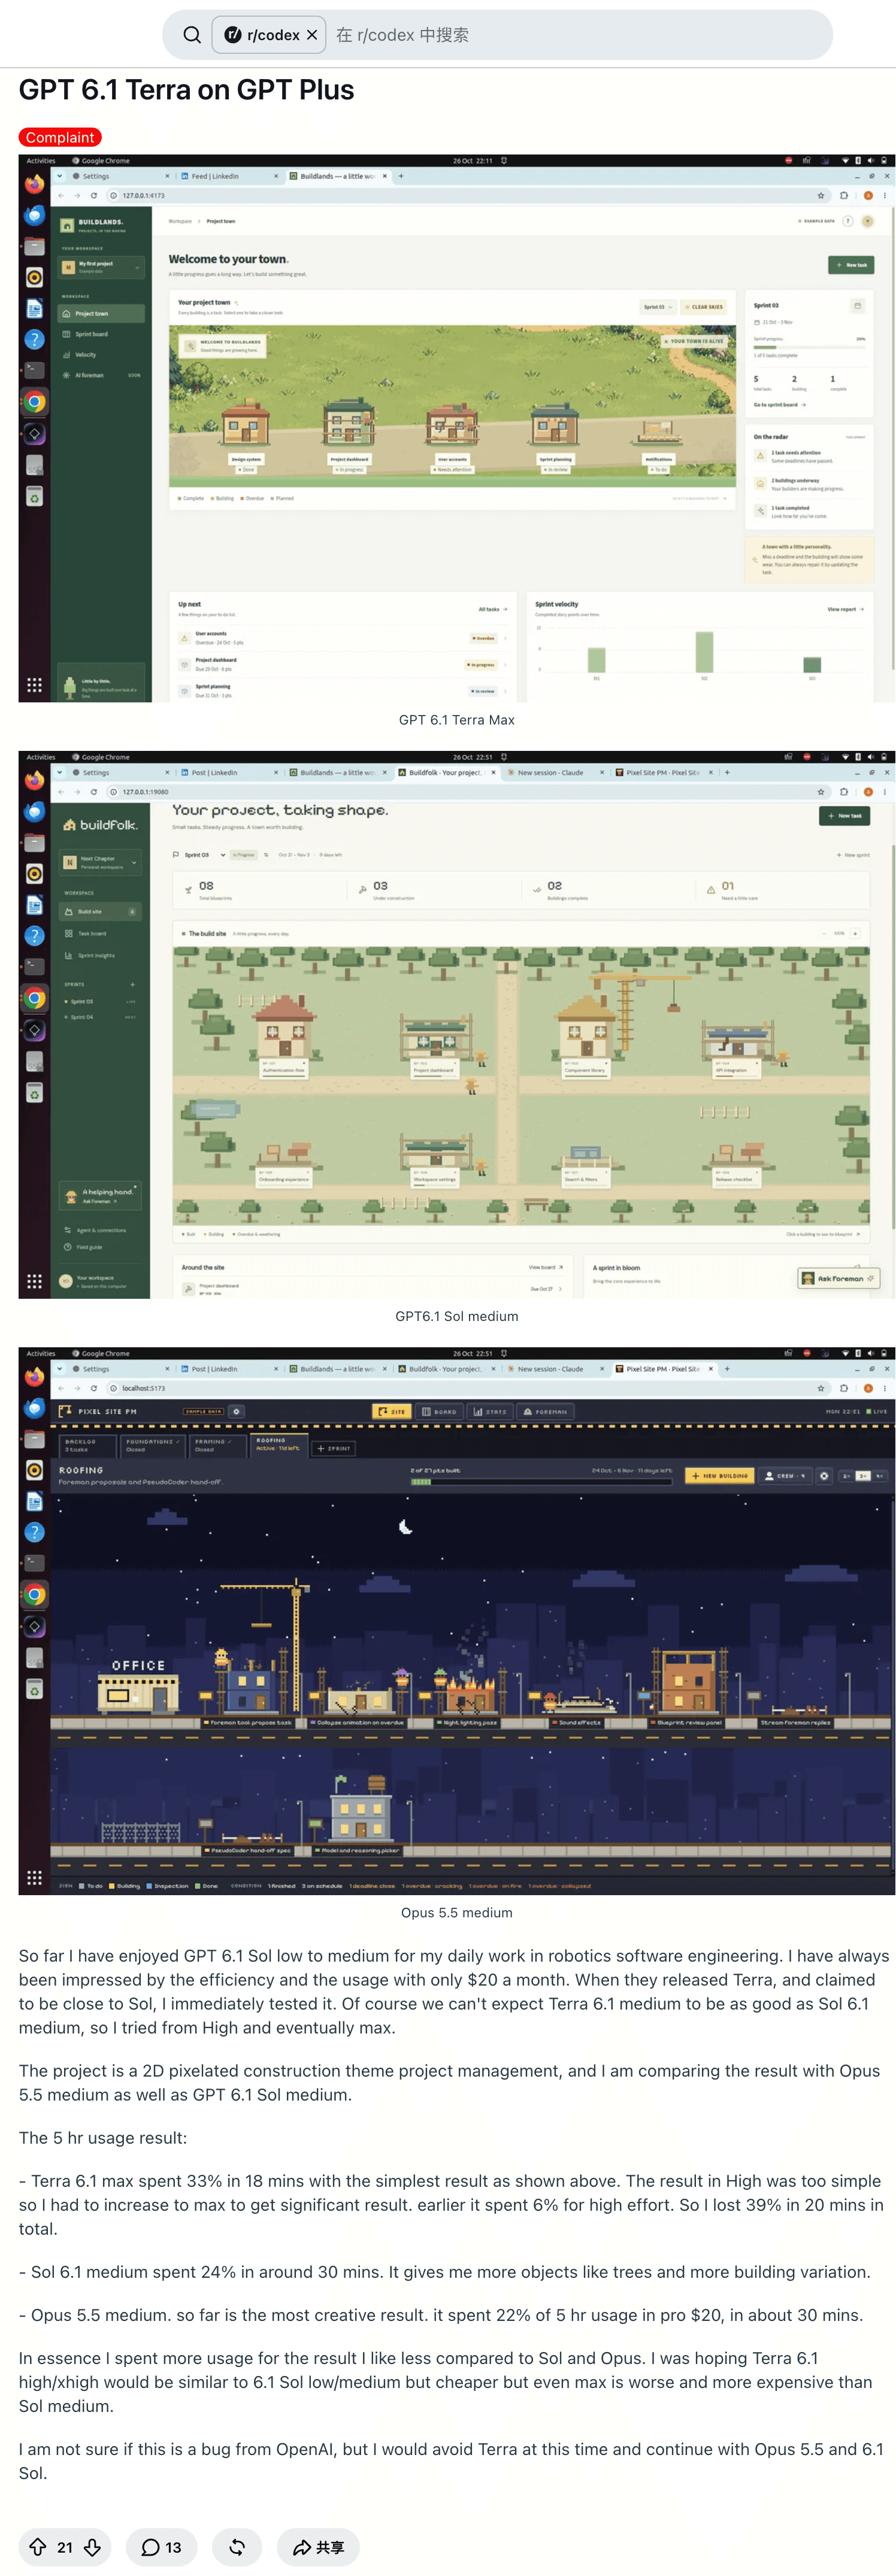
最值得关注的数字是 95%:缓存读取比普通输入便宜 95%。当 Agent 反复读取相同指令和文档时,它可能比普通输入降价更影响账单。但它不能保证完成任务更便宜。一条发布日 Reddit 反馈中,ayudha90 提高 Terra 的推理档位后,反而消耗了更多订阅额度,得到的结果也更不满意。这只是单个用户的体验,不是 API 账单或受控对比。
下文给出当前费率表、优惠的适用条件、两种可复算的预算和本地计算器。Tabbit Browser 部分会先核对真实模型列表,再讨论客户端工作流。
GPT-6.1 Terra API 价格速查
以下单位均为美元/百万 token,核对于 2026 年 10 月 27 日。两款模型均使用 Standard 档,不含区域处理加价。前代价格来自当前的 GPT-5.6 Terra 模型卡与价格表,不是假定的历史价格。
| 短上下文计费项 | GPT-5.6 Terra | GPT-6.1 Terra | 变化 |
|---|---|---|---|
| 普通未缓存输入 | $2.00 | $1.00 | −50% |
| 缓存输入读取 | $0.20 | $0.05 | −75% |
| 缓存写入,保留 30 分钟 | $2.50 | $1.25 | −50% |
| 缓存写入,保留 12 小时 | $5.00 | $2.50 | −50% |
| 输出,含推理 | $12.00 | $5.00 | 约 −58.3% |
本文讨论 GPT-6.1 Terra,API ID 为 gpt-6.1-terra。它接受文本和图片输入,输出文本。OpenAI 将其定位于视觉推理、电脑操作和写作。1,050,000 token 上下文窗口描述的是容量,较低费率的适用范围远小于这个数值。前代 Terra 介绍可用于了解历史背景,当前规格应以最新模型卡为准。
要点
缓存读取每百万 token 为 0.05 美元,相当于 1 美元普通输入单价的 5%。写入更贵,预算中需要单独分类。
普通输入、缓存读取、缓存写入互斥。同一 token 既算普通输入又加写入费,会高估账单。
输入超过 272K 后,整笔请求切换到更高费率。能放进上下文窗口,不代表仍使用短上下文价格。
Batch 和 Flex 按相应 Standard 费率的五折计价,Fast 则为两倍。先确认处理方式适合任务,再计算折扣。
按合适推理档位下的合格结果成本选型。API 美元支出、订阅额度和客户端模型权限需要分开判断。
95% 的优惠只适用于缓存命中
Terra 的缓存读取价格是每百万 token 0.05 美元,等于普通输入的二十分之一。与 GPT-5.6 Terra 的 0.20 美元读取价相比,则下降了 75%。两个百分比使用不同基准,都不表示总账单能下降 95% 或 75%。
可重复使用的前缀可以包括指令、工具和稳定的文档上下文。命中要求前缀匹配,这些模型的缓存前缀至少为 1,024 token。修改前缀或超过保留时间,预期的读取就可能变成写入或普通输入。应检查返回的 usage,不要假设每次重复请求都能命中。提示词缓存指南说明了匹配与保留规则。
对于不涉及缓存写入的输入,若命中比例为 h,每百万总输入 token 的短上下文成本为:
输入成本 = (1 − h) × $1 + h × $0.05
h = 80% → 输入成本 = $0.24
0.24 美元不包含输出或缓存写入。第一次建立前缀与后续读取前缀的请求,使用不同计费项。Agent 研究循环尤其需要区分,因为重复上下文可能占据大量输入。
把降价幅度换算成任务预算
费率表中的变化很明确:与当前列出的前代相比,普通输入减半,输出下降约 58.3%,读取下降 75%。官方表格证明的是单价差异,不能证明你的任务需要多少 token、成功几次,或另一模型是否用更少尝试就能完成。
在同一条 Reddit 反馈里,ayudha90 用像素风项目管理应用对比不同模型和推理档位。他表示,Terra 的 high 和 max 合计约 20 分钟消耗了五小时额度的 39%。不同推理档位、主观结果偏好和订阅计量方式,使它无法成为严格的 API 成本结论。它提醒的是:检查你愿意接受的结果,而不只看最低 token 标价。
更实用的采购指标是:
每个合格结果成本 = 全部尝试的总支出 / 合格结果数使用相同的代表性输入,在测试前定义合格标准,并保留失败尝试的 usage。AI 研究场景指南有助于区分范围明确的提取任务与长篇研究任务,两者需要不同预算。
额外费用与 272K 门槛
Terra 模型卡规定,输入超过 272,000 token 后,输入与缓存费率变为两倍,输出变为 1.5 倍。这个规则覆盖整笔请求,包括最前面的 272K token。
| Terra 处理档位 | 输入上下文 | 普通输入 | 缓存读取 | 30 分钟写入 | 12 小时写入 | 输出 |
|---|---|---|---|---|---|---|
| Standard | ≤272K | $1 | $0.05 | $1.25 | $2.50 | $5 |
| Standard | >272K | $2 | $0.10 | $2.50 | $5 | $7.50 |
| Batch / Flex | ≤272K | $0.50 | $0.025 | $0.625 | $1.25 | $2.50 |
| Batch / Flex | >272K | $1 | $0.05 | $1.25 | $2.50 | $3.75 |
| Fast | ≤272K | $2 | $0.10 | $2.50 | $5 | $10 |
| Fast | >272K | $4 | $0.20 | $5 | $10 | $15 |
恰好 272K 时使用短上下文行,272,001 时则整笔使用长上下文行。例如 Standard 档下,300K 普通输入和 10K 输出为 $0.6 + $0.075 = $0.675,再另算适用费用。只对多出的 28K 加价是错误算法。
Batch 是异步处理,Flex 的处理可用性和时延语义也不同。使用优惠前,应核对 Batch 或 Flex 是否适合应用。当前 API 表没有给 Terra 列出 Ultrafast 费率,不能套用 Sol 或 Astra 的选项。
适用的区域处理加价为 10%。托管工具也可能产生费用,例如网页搜索列价为每 1,000 次 10 美元,搜索内容 token 还按模型费率收费。容器与文件搜索存储另有计费项。引用的价格表没有注明 Terra 优惠到期日;GPT-5.6 Sol 的 11 月 21 日促销说明属于另一款模型。
家族中哪个档位适合你的任务?
下表来自同一张官方价格表,都是当前 Standard 短上下文费率,不代表质量排名。
| 模型 | 普通输入 | 缓存读取 | 30 分钟写入 | 12 小时写入 | 输出 | 建议起点 |
|---|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.25 | $0.50 | 先验证质量,再用于集中、重复的任务 |
| GPT-6.1 Terra | $1 | $0.05 | $1.25 | $2.50 | $5 | 视觉、文档和电脑操作流程 |
| GPT-6.1 Sol | $2 | $0.10 | $2.50 | $5 | $10 | 更复杂的编码和持续推理 |
| GPT-6 Astra | $10 | $1 | $12.50 | $25 | $50 | 额外能力足以抵消费用的困难任务 |
Terra 的普通输入与输出价格是 Luna 的十倍,但缓存读取只贵五倍。因此,在验证质量之前,缓存构成就已经影响选型。Luna 定价指南、前一代 Sol 成本指南和 Astra 定价指南介绍相邻选择。旧文章保留各自的核对日期,当前费率请以今天的官方表为准。
Terra 支持 none、low、medium、high、xhigh 和 max,默认 medium。可先以 medium 测试代表性任务,结果合格就尝试降低档位,只有额外推理确实有帮助时再提高。推理 token 按输出计费,较低输入单价无法无限抵消更长推理或更多重试。(推理指南)
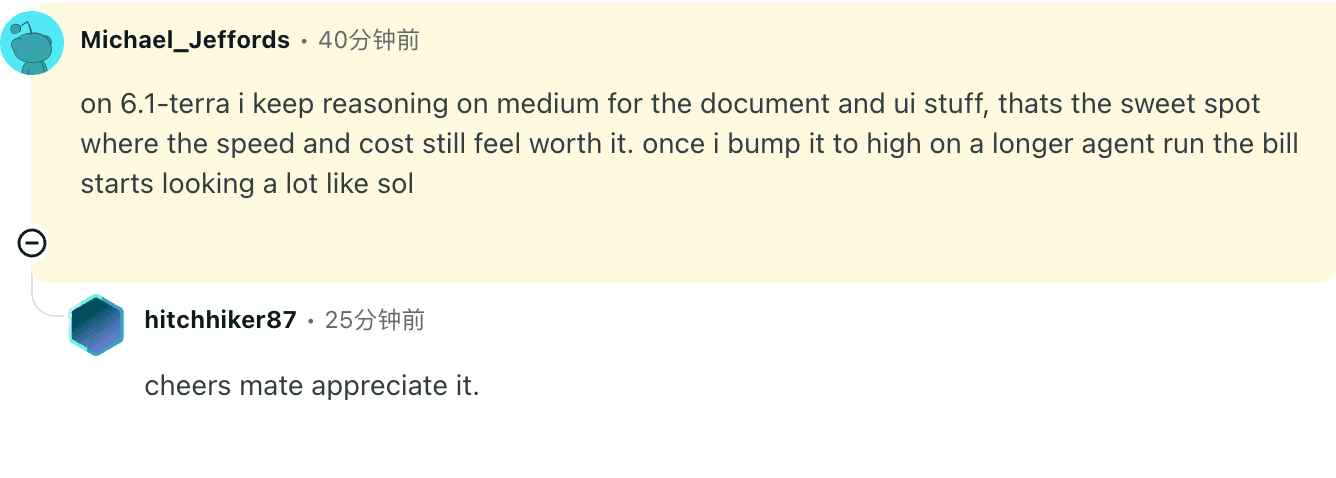
Michael_Jeffords表示,文档与界面任务保留 medium 的速度和成本更合适,长 Agent 任务提高到 high 后,费用感觉接近 Sol。评论没有附账单或受控样本,可把它视为一个值得验证的设置建议。
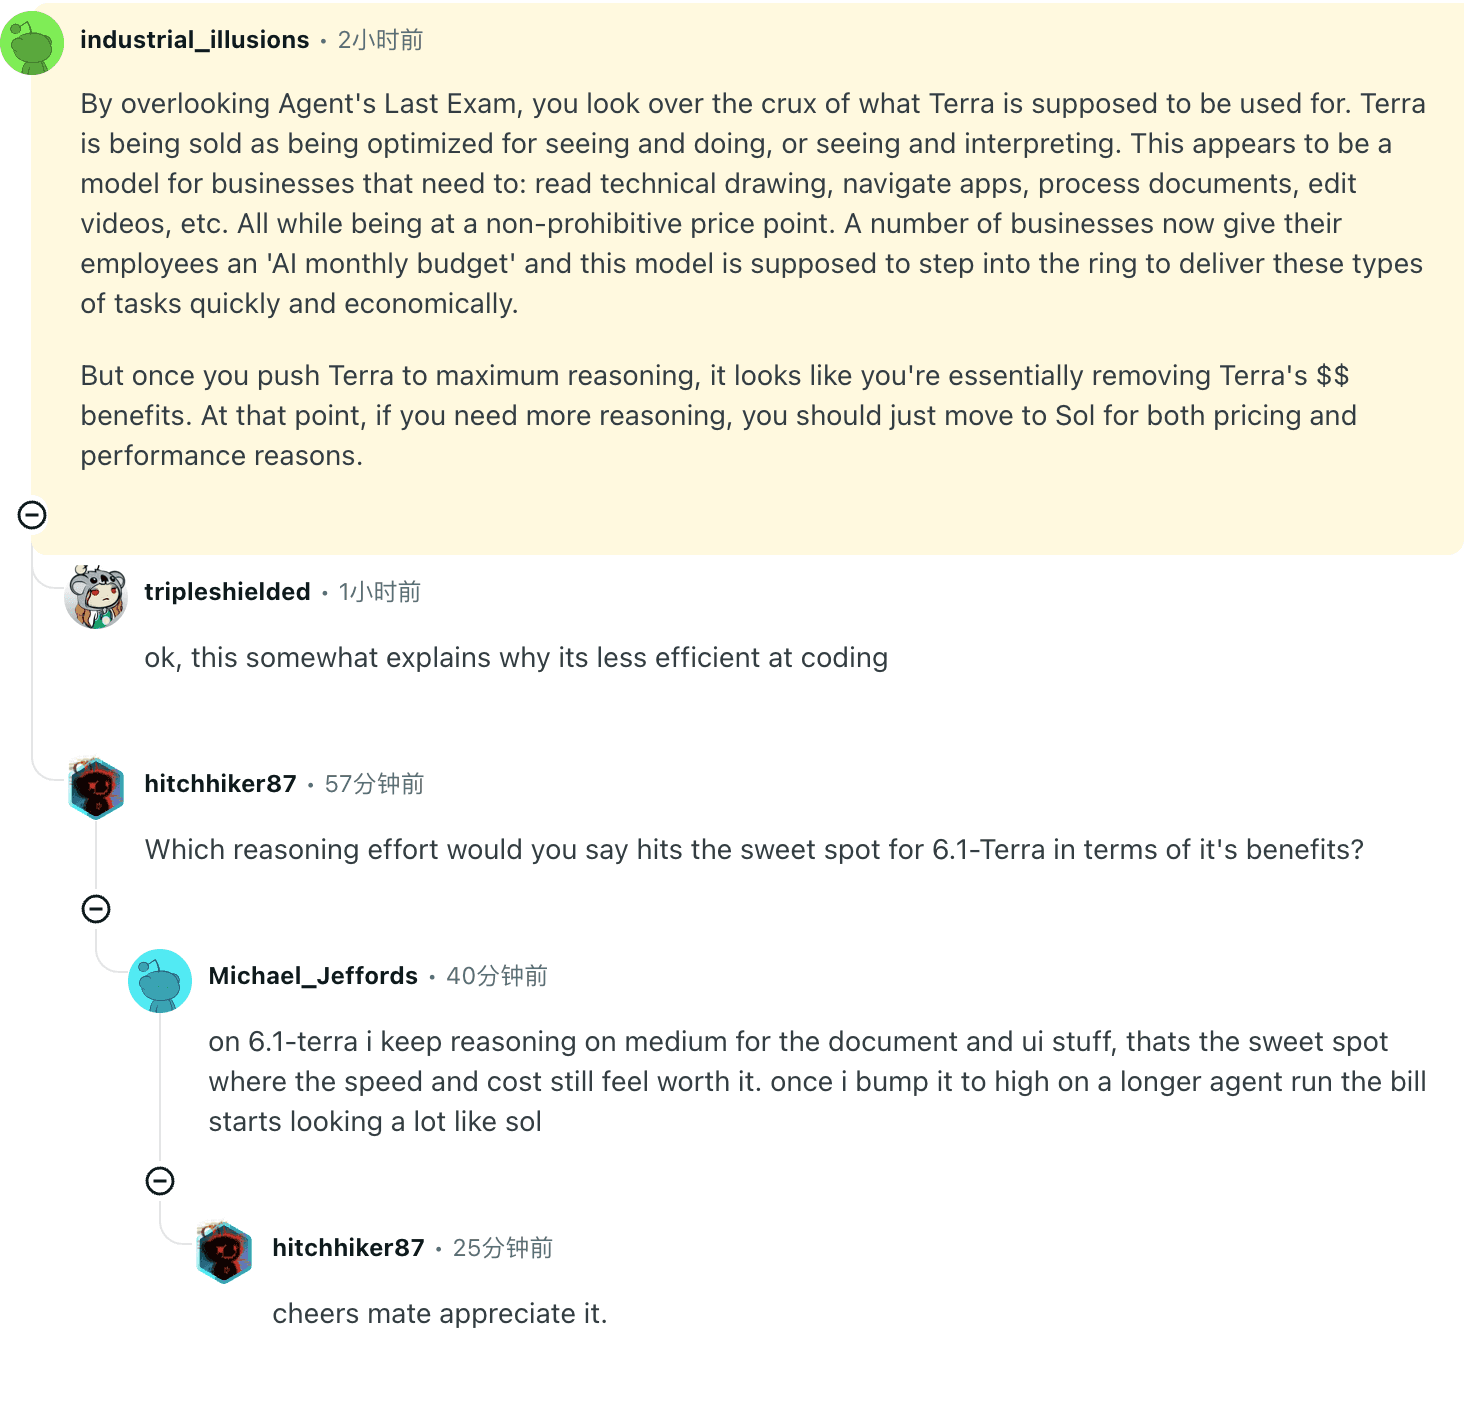
industrial_illusions也认为,规模化文档处理和应用导航符合 Terra 的用途,但质疑 maximum 推理能保留多少成本优势。这是关于工作负载的观点,不是对 OpenAI 基准的独立验证。
写作方面,Louis-François Bouchard 的 ToneBench 帖子倾向于用 low 批量生成初稿,并质疑在该评测中提高档位的收益。结论依赖其写作任务和评审方式,不能当成通用质量排名。
哪些不另收费,哪些不能视为免费
OpenAI 不在这些模型 token 费用之外另收 Responses API 或 Chat Completions 端点调用费。提高 effort 也没有单列固定附加费,成本变化来自实际用量。同一请求中,缓存读取的同一 token 不会再收一次写入费。
但任务失败不等于免费。推理指南说明,不完整响应可能消耗输入与推理 token,却没有最终可见答案。引用的页面没有承诺拒答豁免或自动 fallback 退款。应查看响应 usage 和账单,不能因为没有有用答案就默认零支出。
下文估算不含工具调用、未计入输入的搜索内容 token、存储、重试、税费、适用的区域处理费用及代理商加价。图片使用模型的 token 化规则,仅凭截图张数无法确定预算。
ChatGPT 套餐和 API 权限分开购买
OpenAI 将 GPT-6.1 Terra 列为 ChatGPT Work 与 Codex 的 Plus、Pro、Business、Enterprise 和 Edu 可用模型,实际使用受工作区控制。普通 Chat 不在其列,API 模型卡也未列免费层支持。(Work 与 Codex 价格;Terra 模型卡)
Work/Codex 页面当前列出 Plus 每月 20 美元,Pro 每月 100 美元起。Plus 和 Standard Business 的本地 Terra 消息估算为每五小时 35–285 条,页面明确说明这不是固定保证。模型、上下文、推理和工具都会改变消耗。购买前检查当地结算价格和自己账户的用量面板。
另购 credits 有独立费率表,Codex credits 不单列 API 式的缓存写入费。API key 调用则走 API 账单。因此,不能用 Plus 月费或已用额度百分比换算一个保证可用的 API 任务数。
两种可以复算的预算
以下是算术示例,不是模型运行实测。均使用 Standard 短上下文费率,假设每次总输入 100K、总输出 2K,共 1,000 次请求。输出已包括推理 token。
| 每次输入构成 | 普通输入 | 缓存读取 | 30 分钟缓存写入 | 输出 | 每次成本 | 1,000 次成本 |
|---|---|---|---|---|---|---|
| 冷前缀,首次写入 | 20K | 0 | 80K | 2K | $0.130 | $130 |
| 热前缀,后续读取 | 20K | 80K | 0 | 2K | $0.034 | $34 |
冷写入为 0.02 × $1 + 0.08 × $1.25 + 0.002 × $5 = $0.13;热读取为 0.02 × $1 + 0.08 × $0.05 + 0.002 × $5 = $0.034。100K 总输入分配到三个互斥类别,不能先计 100K 普通输入,再加 80K 写入。
一次冷请求加 999 次热请求为 $0.13 + 999 × $0.034 = $34.096。前提是前缀相同、缓存仍保留且没有重试。重写前缀或缓存过期会改变构成。冷写入若选 12 小时保留,则为 0.23 美元;只有后续命中能抵消增加的写入费用,更长保留才划算。
在本地估算你的 token 预算
填写总输入、缓存读取比例、缓存写入 token、包含推理的输出和请求数。计算器从总输入中减去读取与写入,按整笔请求判断上下文档位,再以相同 token 数量对比 Terra、Sol 与 Luna。相同用量不代表质量或完成任务的能力相同。
本地计算器
对比 Terra、Sol 和 Luna API 成本
费率于 2026-10-27 按官方美元 API 价格核对。输入值保留在此,估算在浏览器内完成。
估算不含工具、重试、税费、区域处理以及服务商或应用费用。推理 token 已计入输出 token。此计算器不估算订阅 credits 或 ChatGPT 使用量。 查看官方 API 费率
计算值留在浏览器里。页面只记录一个不带输入数值的计算器变更事件,不会把这些数值发给模型或价格服务。结果不含上文列出的额外费用,使用 10 月 27 日核对的费率快照。
选择客户端前先检查 Tabbit 模型列表
如果工作涉及浏览器网页和文档,在确定所需模型后,可以进一步了解 Tabbit Browser 工作流。模型单价和一个可实际使用的客户端,是两个不同的选择条件。
本次检查于 2026 年 10 月 27 日在 Tabbit 中打开 web.tabbit.ai/newtab。完整加载的模型列表包含 16 个选项,可见 Kimi-K3.1-Pro、Claude-Sonnet-5.5 等,没有 GPT-6.1 Terra。样本仅为一个国际账户;未提交 Terra 推理,未观察到带工具标记的 Terra 响应,也未测量成本或速度。原计划用一项已知答案的小表格提取任务测试,由于模型缺失,未能执行。
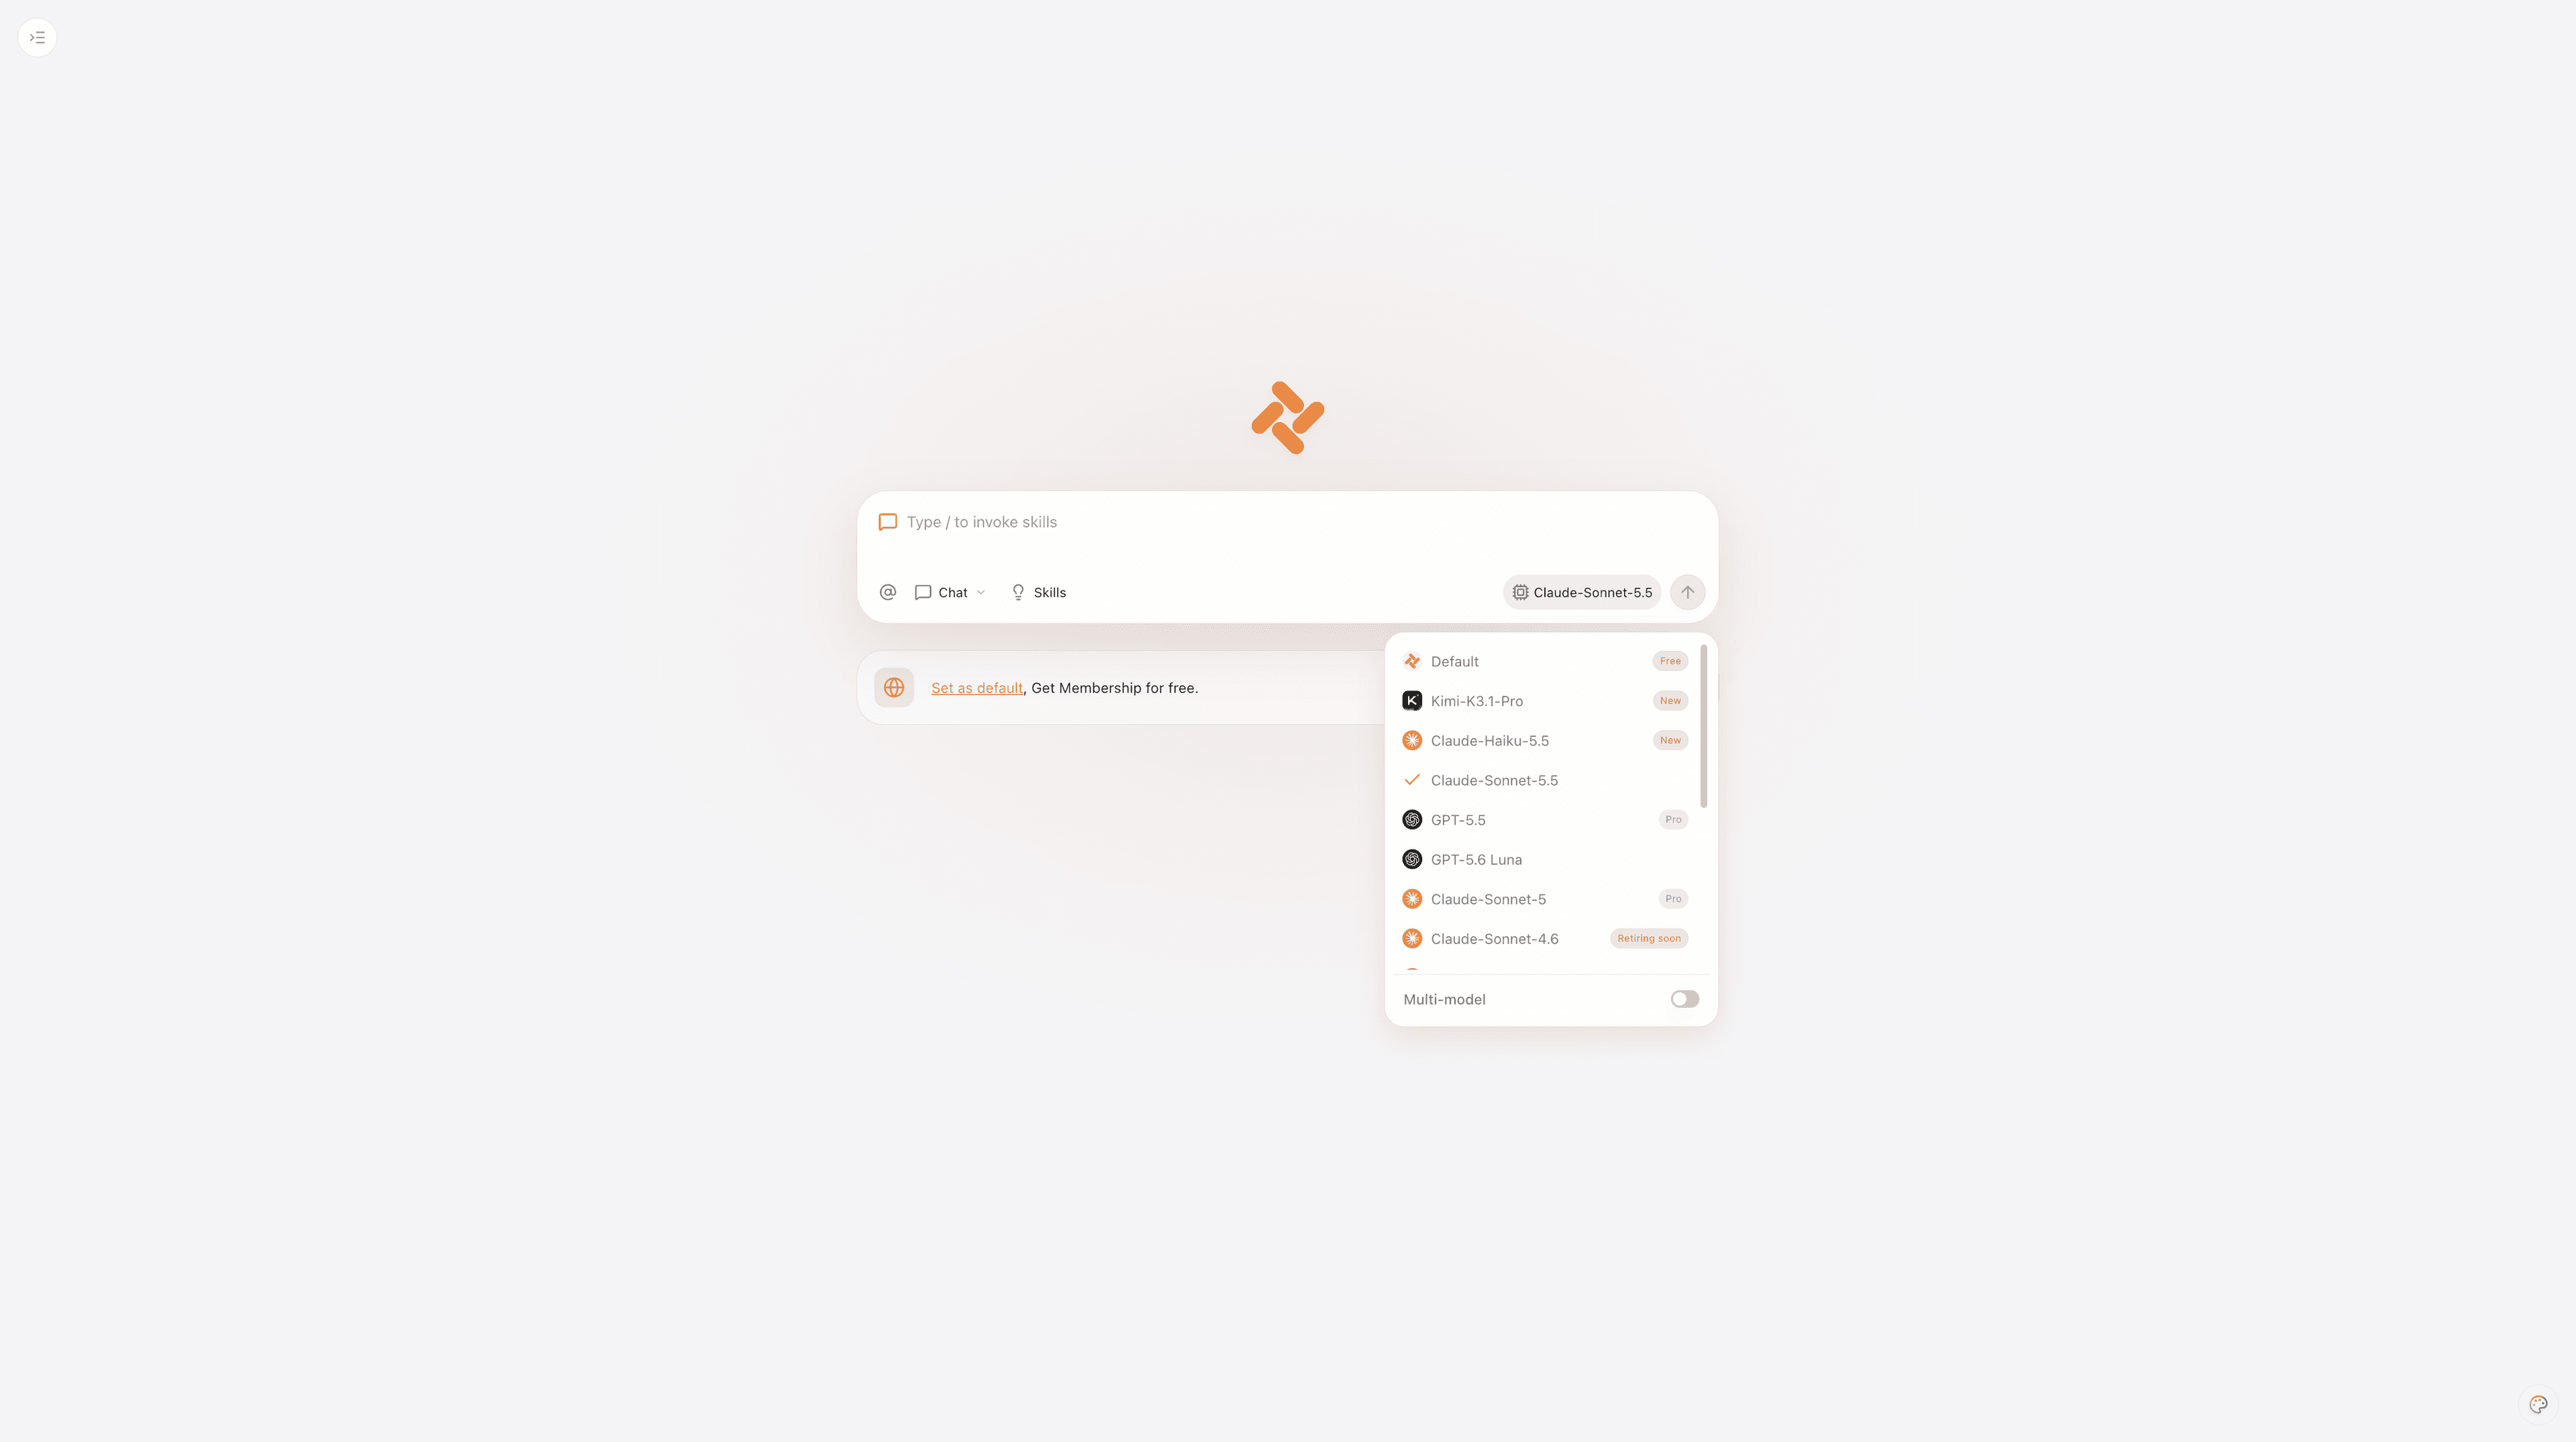
若之后你的账户出现 Terra,可让各模型处理相同原表格和预期答案,记录显示名称、工具标记与结果,同时核对客户端套餐。在此之前,应选择已确认支持 Terra 的客户端。Tabbit 实践指南与 Agentic Browser 说明介绍浏览器流程,不能用来证明 Terra 已可用。
结论:先判断任务是否合适,再看单价
| 你的限制 | 合理下一步 | 需要核对 |
|---|---|---|
| 重复的文档或视觉任务 | 从 Terra medium 开始,再试较低档位 | 合格结果、推理输出、缓存命中 |
| 有人工审核的批量初稿 | 对比 low 档 Terra 与其他模型 | 语气、编辑时间、任务总成本 |
| 长推理或复杂编码 | 用合适档位对比 Sol | 少生成或少重试能否抵消单价 |
| 离线处理 | 评估 Batch 或 Flex | 处理方式与完成时间 |
| 输入接近 272K | 缩短上下文,或按长档预算 | 含读取与写入的全部输入 |
| Work/Codex 订阅 | 对比实际额度和 credits | 账户面板,而不只看 API 价格 |
Terra 的 1 美元输入、5 美元输出费率,是视觉与文档任务可考虑的起点。95% 的读取优惠只有真正命中缓存才有用;推理档位和成功完成任务的情况,决定整体成本。先测工作负载并检查 usage,再选择套餐或 API 处理档位。
浏览器工作请先检查 Tabbit 当前权限,再依赖某个模型。下载客户端不会自动获得 GPT-6.1 Terra,也不改变 OpenAI 的计费规则。
 Tabbit Browser

常见问题
GPT-6.1 Terra 每百万 token 多少钱?
截至 2026 年 10 月 27 日,输入不超过 272,000 token 时,Standard API 每百万普通输入收费 1 美元、缓存读取 0.05 美元、输出 5 美元。缓存写入按保留时间分别收取 1.25 美元(30 分钟)或 2.50 美元(12 小时)。同一输入 token 只使用一种计费类别,写入价格不能再叠加普通输入费。
GPT-6.1 Terra 比 GPT-5.6 Terra 便宜多少?
当前 Standard 短上下文费率中,每百万普通输入从 2 美元降至 1 美元,输出从 12 美元降至 5 美元,缓存读取从 0.20 美元降至 0.05 美元。降幅分别是 50%、约 58.3% 和 75%。实际任务成本还取决于推理输出、缓存命中、重试和结果质量。
GPT-6.1 Terra 的长上下文会加价吗?
会。输入超过 272,000 token 时,整笔请求使用长上下文费率,输入与缓存价格翻倍,输出价格变为 1.5 倍。恰好 272,000 输入 token 仍属于短上下文档。
推理 token 和拒答免费吗?
推理 token 按输出 token 计费,即使最终没有出现可见答案也可能产生费用。本文引用的官方页面没有承诺拒答免费。应核对响应中的 usage 和账单,不能把任务失败视为零费用。
ChatGPT 订阅可以使用 GPT-6.1 Terra 吗?
OpenAI 将 Terra 列为 ChatGPT Work 和 Codex 的 Plus、Pro、Business、Enterprise 和 Edu 可用模型,实际权限还受工作区控制。普通 Chat 界面不在其列。套餐内额度、另购 credits 和 API key 账单是不同的计费口径。
Tabbit Browser 现在能用 GPT-6.1 Terra 吗?
2026 年 10 月 27 日检查的 Tabbit 国际账户在完整加载的 16 个模型选项中没有 GPT-6.1 Terra。因此本文不声称完成了 Tabbit 内的 Terra 推理实测,也不承诺该模型权限。选择客户端前,请检查自己账户的当前模型列表和套餐。