
如果你的工作负载是高用量编码、自动化或以每任务成本定预算的 agent 循环,GPT-6 Sol 值得切换;如果你需要最高的知识工作上限,或者一个绝不半途放弃任务的 agent,那就先别动。半价费率卡是真的:输入每百万 token $2、输出 $10,是 GPT-5.6 Sol 促销价的一半——这是 2026 年 9 月 23 日在 OpenAI 模型卡上核对过的。但这篇测评真正有趣的地方不是价格,而是模型变准的方式:Artificial Analysis 测到它的幻觉率从 92% 降到 60%,同时它尝试回答的问题比例从 99% 降到了 83%。精确地说,新的 Sol 是一个"更少回答"的模型。
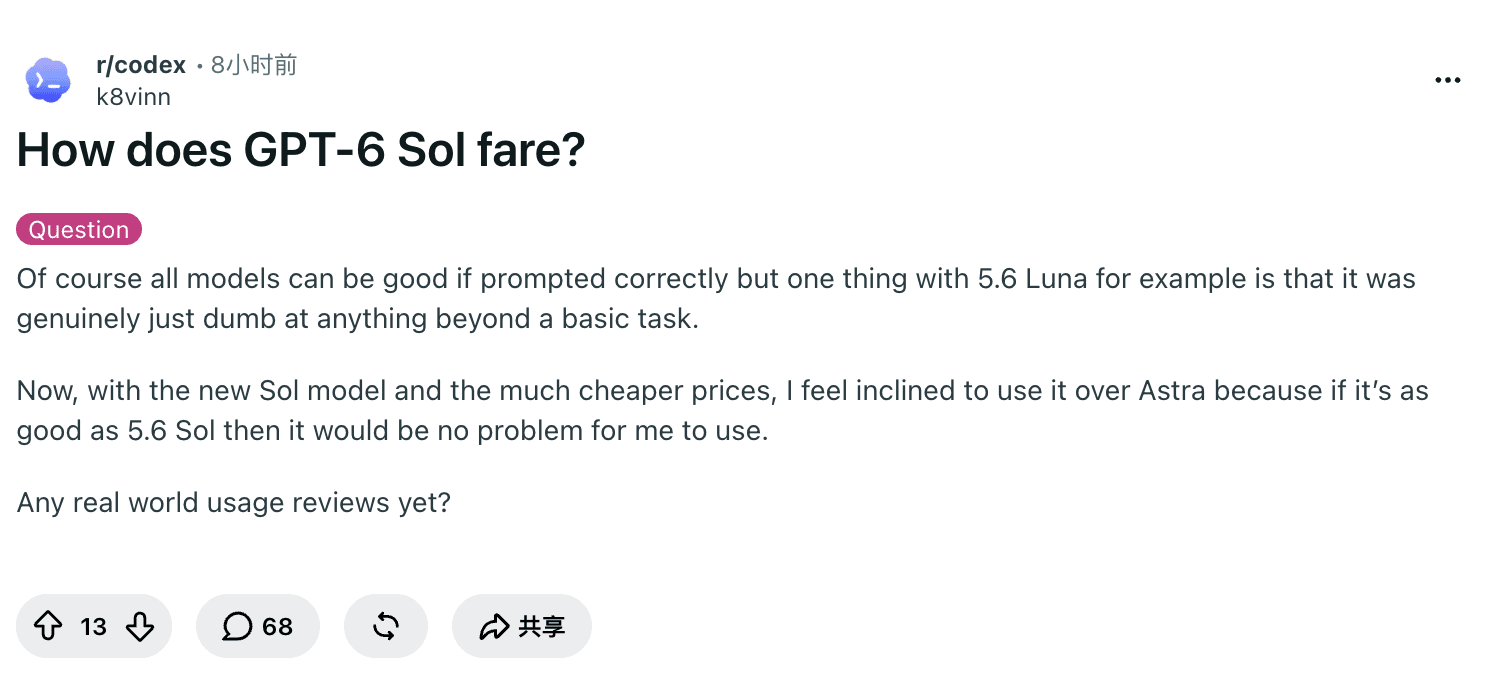
这个交换正是发布社区吵翻天的焦点。发布 4 小时后,u/k8vinn 在 r/codex 开了一个帖子,问的正是这篇测评要回答的问题:"新 Sol 便宜了这么多,我倾向于用它替代 Astra——只要它有 5.6 Sol 那么好,用起来就没问题。有真实使用评测了吗?"("Any real world usage reviews yet?")(Reddit)
GPT-6 Sol 费率卡我们单独拆过,GPT-6 Sol 对 Claude Opus 5.5 的对比负责二选一问题,同门的 GPT-6 Astra 测评也已发布。这一篇负责裁决:GPT-6 Sol 哪里真的变好了,哪里会咬人,哪些工作负载该切、该留、该走。如果你想拿它处理真实网页而不是测试基准,文末会给一条浏览器层的路线。
核心结论
智力持平,价格减半。 Artificial Analysis 给出 GPT-6 Sol (max) 的 Intelligence Index 为 48——与 GPT-5.6 Sol 持平——每任务 $1.06 对 $1.99;费率卡从 $4/$20 降到 $2/$10。
准确率提升是一场弃答交换。 AA-Omniscience 上幻觉率从 92% 降到 60%,代价是尝试率从 99% 降到 83%,已答题目的准确率从 59% 微降到 54%。
token 效率是安静的升级。 Sol (max) 在 AA 全套测试里生成 77M token,低于 88M 的中位数;实践者报告 Codex 任务对周配额的消耗小得多。
它不是知识工作升级。 Sol 在 GDPval-AA v2.1 上跌了约 100 Elo;48 的 II 也低于 GPT-6 Astra(53)和 Claude Opus 5.5(58)。
本周的平台现实很重要。 Sol 进了 ChatGPT Work 和 Codex,但没进 Chat;订阅用户报告 6 代模型的 Plus 配额烧得飞快;走 Chat Completions 的 API 团队在
reasoning_effort高于 none 时没有 function calling。
决定这篇测评的那个数字:靠少答题换来的准确率
基准测试给 GPT-6 Sol 的开场是耸肩:Artificial Analysis 的发布评注写道"Intelligence Index 和 Coding Agent Index 与 GPT-5.6 持平,部分评估有进展,部分退步。"两行之后,同一段文字给出了真正改变行为的数字:在知识与幻觉基准 AA-Omniscience 上,GPT-6 Sol (max) 的幻觉率从 92% 降到 60%,而实现方式是尝试率从 GPT-5.6 Sol (max) 的 99% 降到 83%——答错的大约少了四分之一,但已答题目的准确率从 59% 降到 54%(Artificial Analysis,2026 年 9 月 23 日核对)。
翻译成工程语言:OpenAI 用覆盖率换了正确性。这个模型更少举手,而且举手时每次回答的准确率还比上代略低——但"自信地答错"的总量塌缩了。OpenAI 自己的事实性评测讲的是同一个故事:在用户标记过错误的真实对话样本上,"GPT-6 Sol 的错误数量大约是上代的一半,接近 Astra 级的可靠性"(官方公告)。注意 OpenAI 附带的边界:这些对话是筛出来"会诱发错误"的,不代表典型用量;分数也没有控制长度。
这篇测评的每个判断都按同一个问题分拣:你的成本是被"答错"主导,还是被"答不出"主导?如果答错代价高——代码评审、合规、给下游系统喂数据的抽取——弃答交换是实打实的升级。如果覆盖率才是本职——agent 管线里一次拒答就意味着卡死任务和永远做不完的页面——同一个设计就表现为退步。记住这根轴,裁决环节它还会回来。
基准数据,以及该信几分
下面所有独立数据来自 2026 年 9 月 23 日的同一次 Artificial Analysis 快照,并标注 effort 档位——因为 effort 正是发布周对比里最常见的作弊点。价格行来自 OpenAI 模型卡与同日发布的定价指南。
| 维度 | GPT-6 Sol (max) | GPT-5.6 Sol (max) | GPT-6 Astra (max) | Claude Opus 5.5 (max w/ fallback) | 这意味着什么 |
|---|---|---|---|---|---|
| API 价格,输入/输出每百万 | $2 / $10 | $4 / $20(促销至 11 月 21 日) | $10 / $50 | $4 / $20 | Sol 输入价与 Opus 5.5 持平,输出只有它一半。 |
| AA Intelligence Index | 48 | 与 Sol 持平 | 53 | 58 | 你买到的是更便宜的同档智力,不是更多智力。 |
| AA 每任务成本(II) | $1.06 | $1.99 | $3.26 | $5.98 | 5.6 Sol 的一半、Astra 的三分之一、Opus 5.5 max 档的约 18%。 |
| 幻觉率,AA-Omniscience | 60% | 92% | 未报告 | 未报告 | 头条的准确率胜利。 |
| 同基准尝试率 | 83% | 99% | — | — | ……以及代价:它答得更少。 |
| GDPval-AA v2.1(知识工作) | 较前沿约 −100 Elo | 未报告 | 未报告 | 1846 Elo(Anthropic 报告) | 别雇 Sol 做专家级知识工作。 |
| 输出速度(AA 中位) | 131 tok/s | 未报告 | 58 tok/s | 未报告 | 中游:比 Astra、Fable 5.1 快,远慢于 Flash 级。 |
| 上下文 / 最大输出 | 1.05M / 128K | 1M / 32K | 1.05M / 128K | 1M / 128K | 规格来自厂商模型页;272K 计费阈值全家通用。 |
在相信任何一行之前,先泼三盆冷水:
厂商分数跑在自家 harness 上。 OpenAI 发布的 AutomationBench、Agents' Last Exam(Sol max 56.4%,成本只有 Opus 5 最佳的 40%)、DeepSWE(68.8% 对 Fable 5 的 69.9%,成本低约 80%)、OSWorld 2.0 offline(60.5% ≈ Opus 5 medium 的 60.3%,成本低约 80%)全部是自报成绩;公告自己的脚注承认评测跑在"可能与生产 ChatGPT 输出略有不同"的研究环境或 API 里,竞品分数取自公开报告。方向性有用,不是福音。
指数数值会漂移。 我们一天前发布的 GPT-6 Astra 测评引用的 AA Intelligence Index 还是 Astra 61.2、5.6 Sol 60.9;同一个追踪器现在列的是 Astra 53、Sol 48。Artificial Analysis 会对指数做版本化重定基——只在同一次快照内比较模型,永远不要跨周比。
effort 错位是发布周的作弊码。 Sol 公开的成绩多是 max 档;Opus 5.5 的头条数字常是 medium 默认档。任何不标明双方档位的"Sol 赢了/输了"都是营销。我们的对比文做了成本对齐版的那道数学。
基准在这里是方向针,不是尺子。这个阶段更有分量的是真实任务的实测——而发布后 24 小时给出了一组出奇一致的信号。
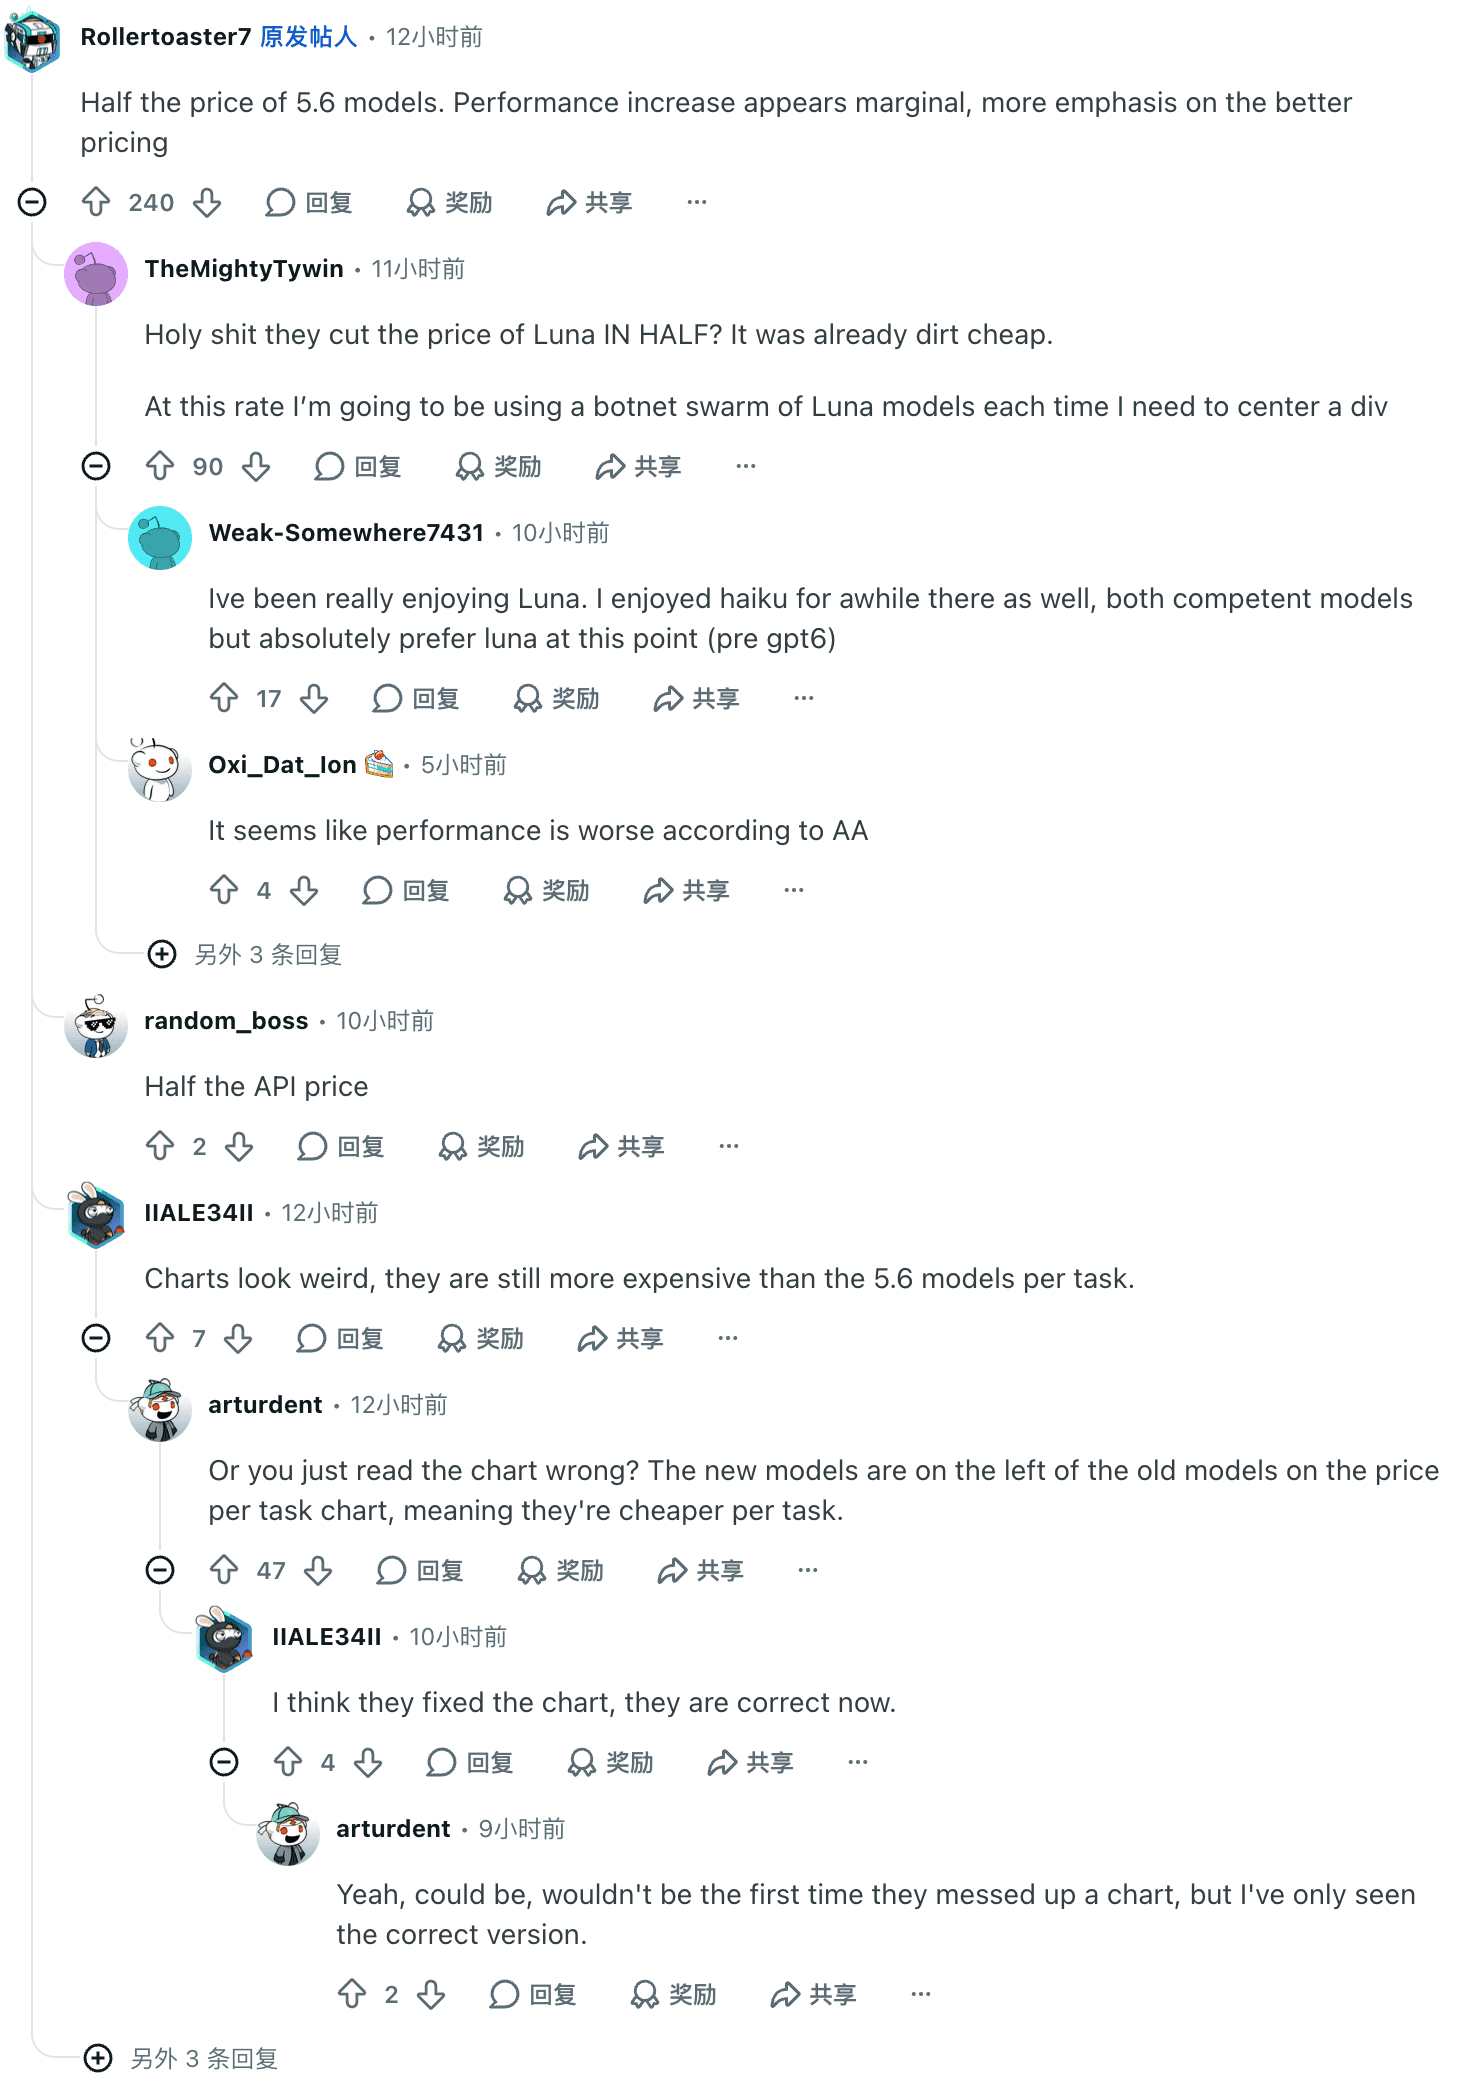
"价格减半、性能平平"是 r/codex 发布讨论串几小时内的最高赞评论:楼主 u/Rollertoaster7 一句"Half the price of 5.6 models. Performance increase appears marginal, more emphasis on the better pricing"(半价,性能提升看起来微乎其微,重点在更好的定价)拿了 240 赞,还有用户直接引用了 AA 的喜忧参半(Reddit)。独立评测机构 Vals AI 从自己的基准 得出同一个平台期:"GPT-6 Sol……在 Vals Index 排名第 8,与 GPT 5.6 Sol 大致持平,成本是一半"(X)。
GPT-6 Sol 真正好的地方
1. 事实性:更少的自信错误
弃答机制不只是基准现象——它在真实管线里的样子,是一个"会反驳而不是顺着说"的模型。一位 Hacker News 用户描述了把 Sol 当成另一个模型代码评审的"第二意见":"i used it for code review and it flagged twenty issues, sol checked the review and found 75% of them were hallucinations. sol was much closer to reality."(我用它做代码评审:那个模型标了 20 个问题,Sol 复查后发现其中 75% 是幻觉,Sol 离现实近得多。)(HN)。单一轶事证明不了比率,但它与 AA 测量和 OpenAI"错误减半"的说法从三个独立方向互相印证。如果你的工作负载惩罚错误——评审、抽取、合规——这才是比任何指数分都重要的升级。
2. Token 效率:安静的账单削减
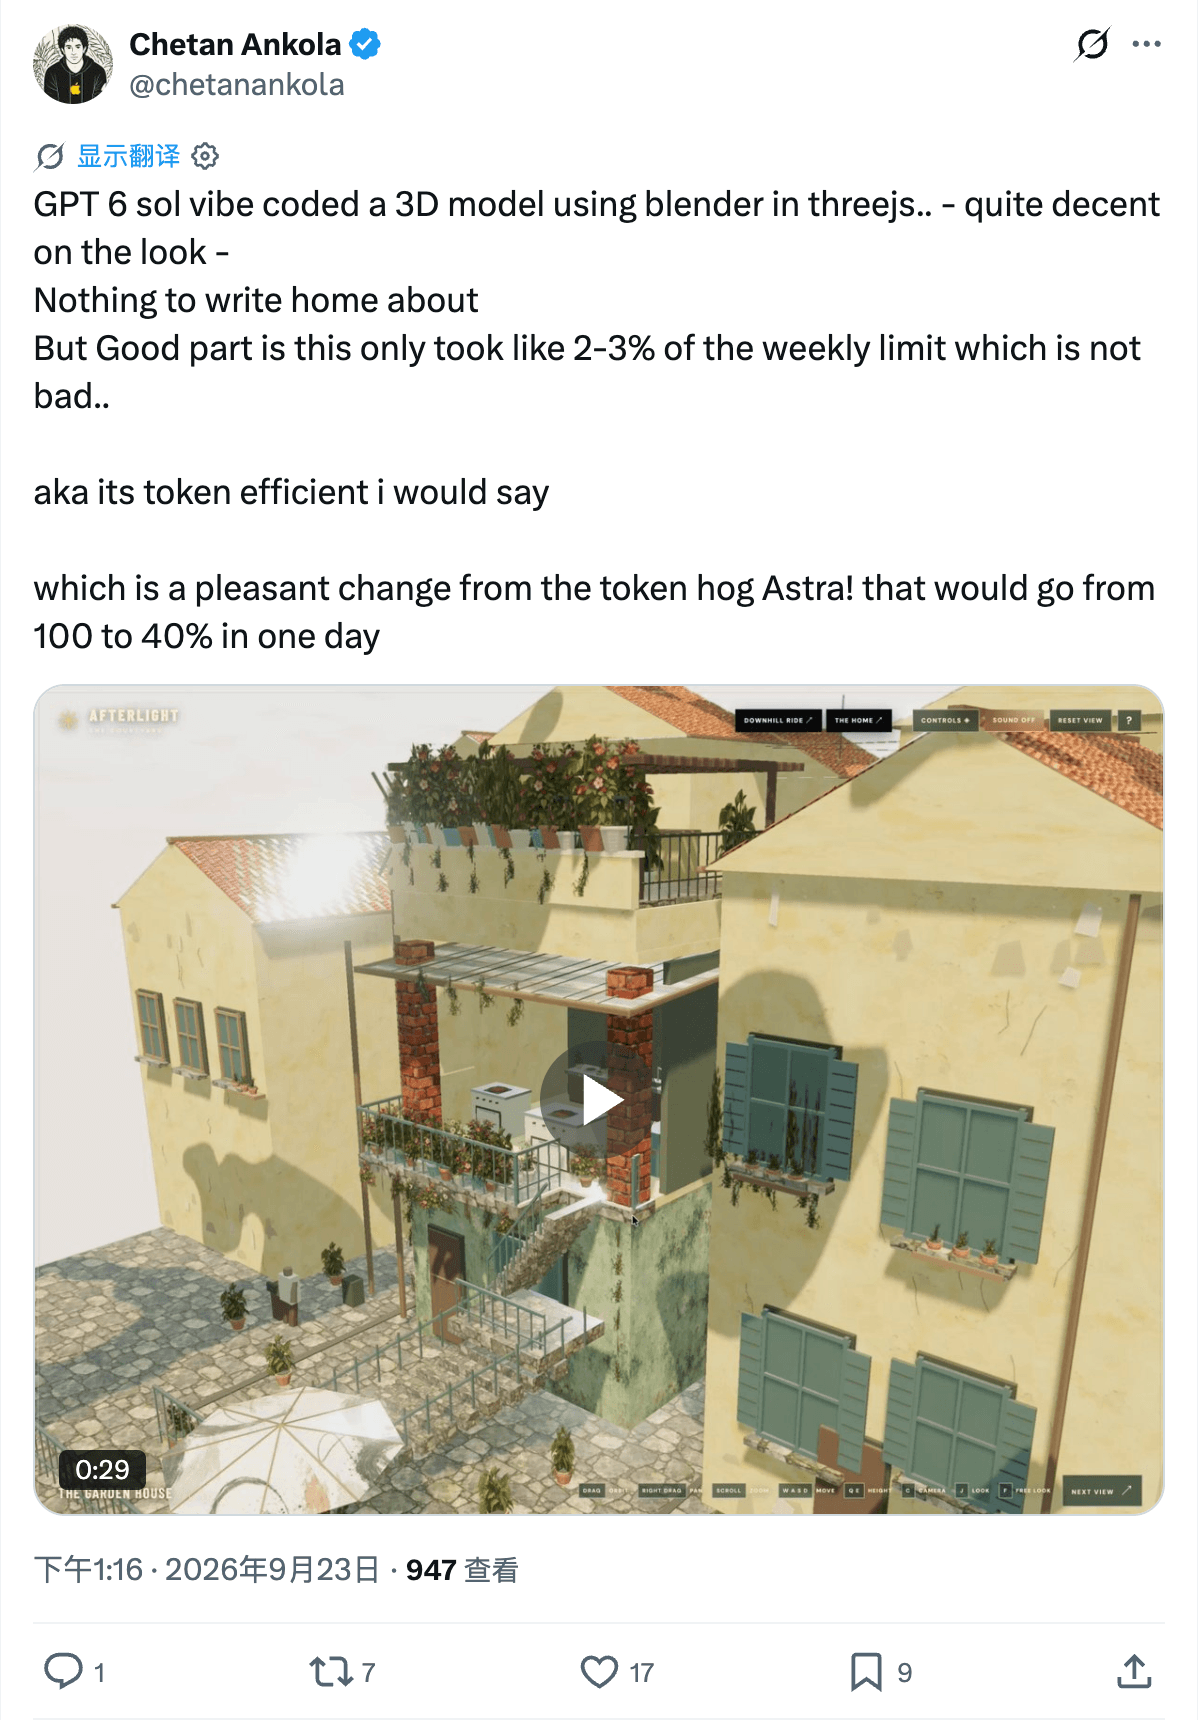
推理模型收两次钱——一次是答案,一次是思考。Sol 在 AA 套件上的生成量为 77M token,低于 88M 的中位数;订阅用户也注意到了同样的"瘦":r/codex 调侃"我的 Codex token 用量 < 黑洞";X 上一位开发者量了一个 Blender/Three.js 任务:"只花了周配额的 2-3%……它的 token 效率我得说个好——和一天从 100% 烧到 40% 的吞 token 怪兽 Astra 相比,令人愉快"(X)。叠上费率卡,这就是为什么 OpenAI 宣称 Sol(xhigh) 在 AutomationBench 上以 Opus 5 (max) 每任务 9% 的成本胜出至少是可信的:更少的 token、更便宜的 token,正对自动化形状的工作。
3. 写作与协作风格
OpenAI 说 Astra 改进的沟通风格——"更清晰、更少黑话"——延续到了 Sol;而这是罕见的在一天内就被独立盲测印证的厂商声明:How I AI 的盲测把"清晰的写作、可读的 PRD 和价格"列为 Sol 仍然胜出的地方(Lenny's Newsletter)。对那些代码之外还要交付文档的团队——规格、PRD、评审纪要——这是没有任何榜单行能捕捉的日常质量改进。
GPT-6 Sol 会咬人的地方
1. 弃答税
上面每一条优点都有镜像。一个只尝试 83% 问题的模型,放进无人值守的 agent 管线,就是一个会交回 17% 空位的模型——每个空位都是一次卡死、一次重试或一次人工升级。AA 还量出了每答案的代价:已答题目的准确率从 59% 降到 54%;在度量"经济价值知识工作"的 GDPval-AA v2.1 上,Sol 较前沿同行跌了约 100 Elo。知识工作的上限压根不是这个模型的目标。如果你的管线无法容忍拒答,从第一天就预留一个兜底模型。
2. 一部分社区把它读成"Terra 换皮"
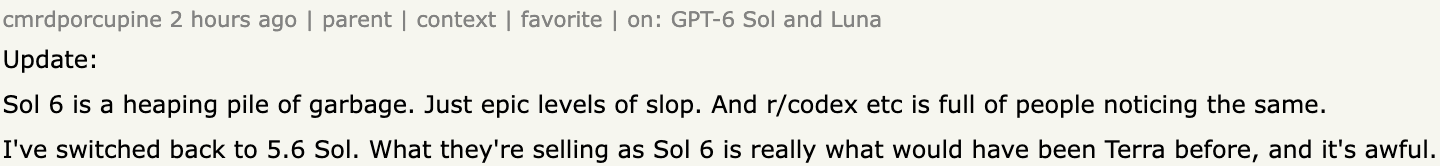
最尖锐的负面报告汇聚在同一主题:这是重新定价,不是换代。一位 Hacker News 开发者已经回退:"Update: Sol 6 is a heaping pile of garbage... I've switched back to 5.6 Sol. What they're selling as Sol 6 is really what would have been Terra before."(更新:Sol 6 是一堆垃圾……我换回了 5.6 Sol。他们当作 Sol 6 卖的东西,其实就是以前的 Terra。)(HN)。r/codex 上同一种直觉:"用过之后,它确实更笨。感觉更像 Terra。"测量的中间地带是:指数在平均意义上持平,但"部分评估有进展、部分退步"意味着单个工作负载完全可能踩在退步的那一半上。如果你的 prompt 组合恰好落在退步的评估上,你的体感就会和平均数矛盾——两边都对,并不冲突。
3. 发布周的平台摩擦
三处现实摩擦会给本周的切换降温。第一,可用性:Sol 进了付费计划的 ChatGPT Work 和 Codex,但还没进 Chat,Free/Go 用户只有 GPT-6 Luna(官方公告)。第二,订阅经济学:一位 Plus 用户报告"它几分钟就烧穿了我的 Plus 用量,而 5.6 我能悠哉用几小时。它会在一个简单提示上空转几分钟,然后在用量限制前放弃"(HN)——API 降价了,推理 token 照样烧配额。第三,API 面:在旧的 Chat Completions 端点上,function calling 只在 reasoning_effort: none 下可用——工具调用工作流请走 Responses API——并且不支持微调(模型卡)。如果你因为用量行为留在 5.6 Sol,注意它的促销价至少持续到 2026 年 11 月 21 日,我们的 1M 上下文配置指南也仍然适用。

社区到底怎么说
24 小时的社区信号沿着第二节的那根轴干净地分成两半——而不是按技术水平或资深程度。
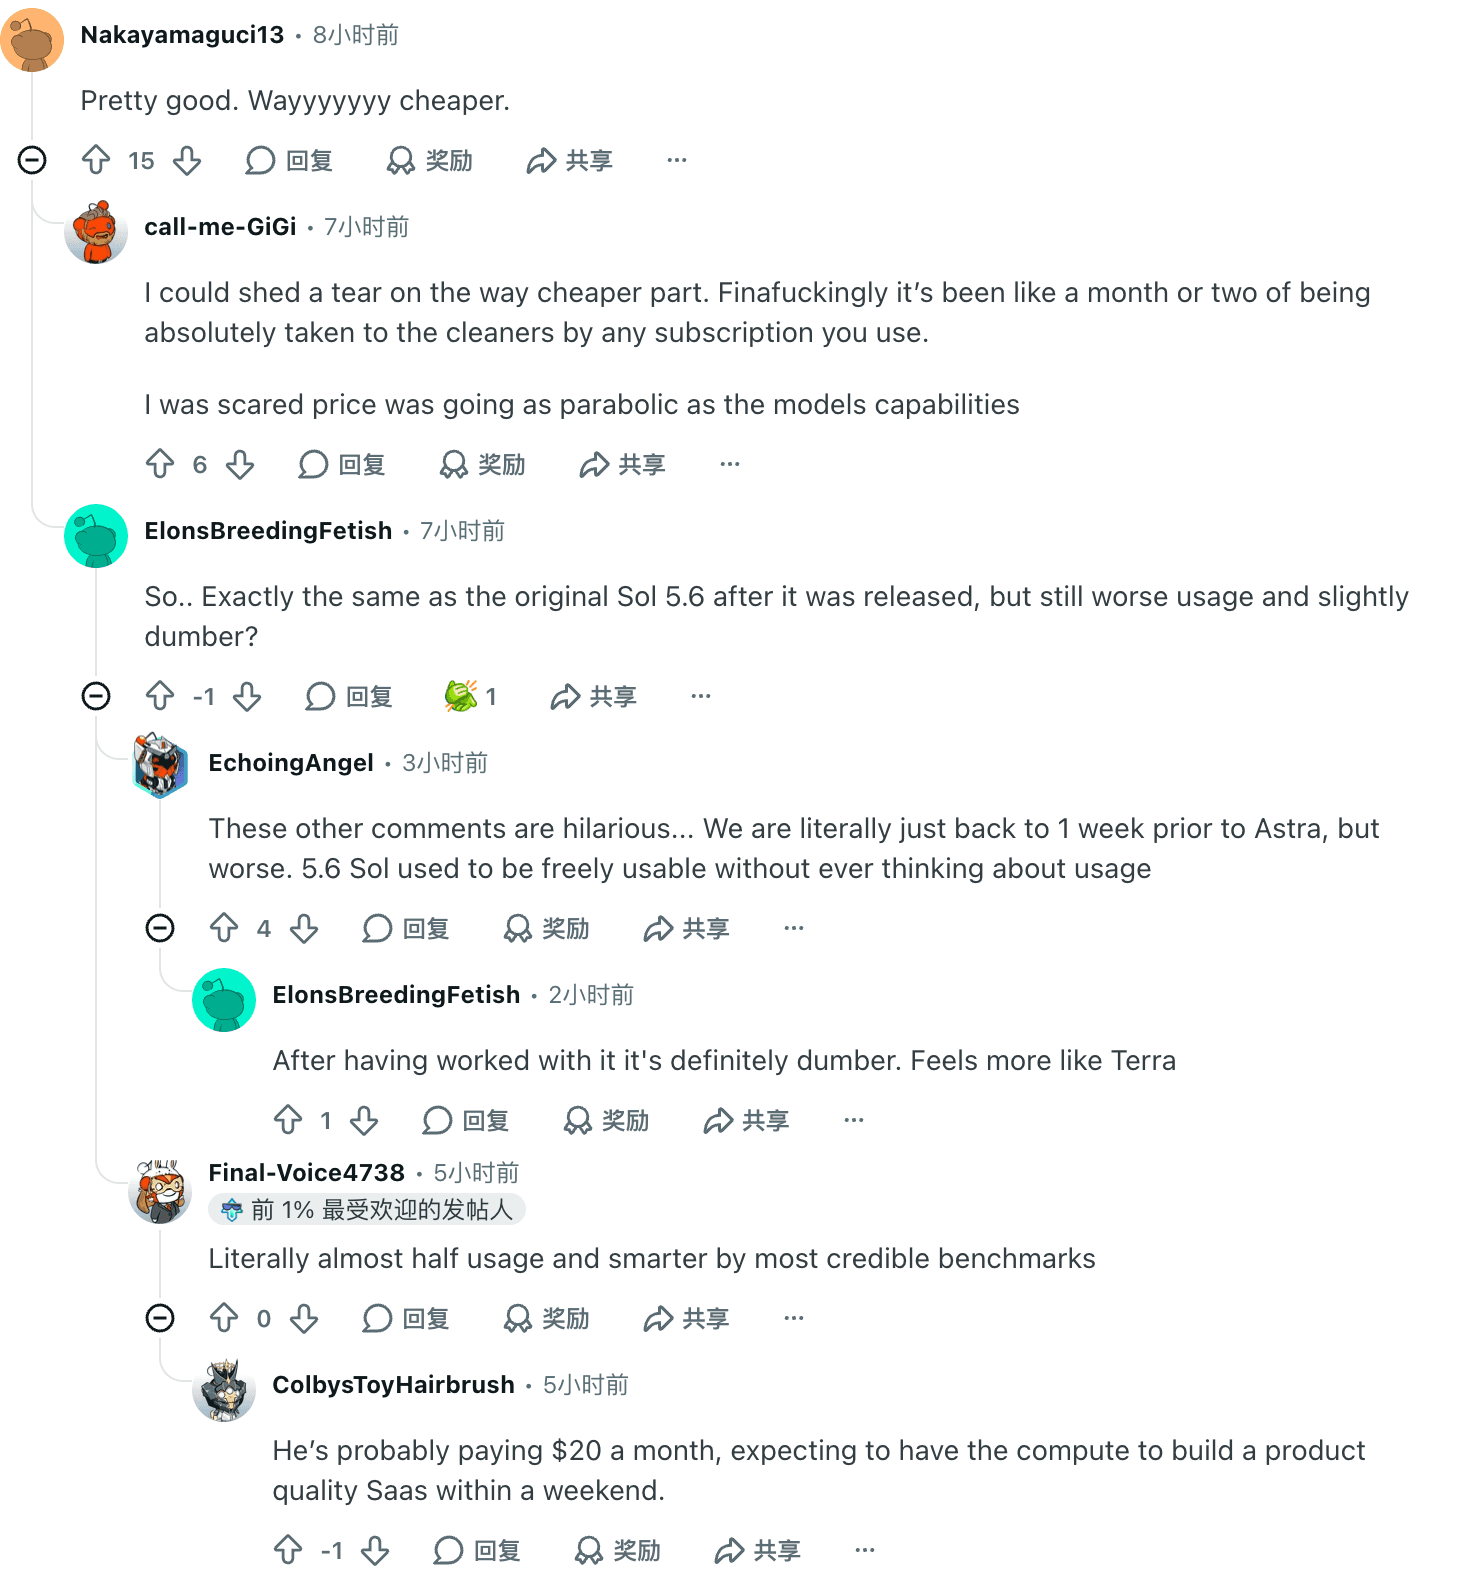
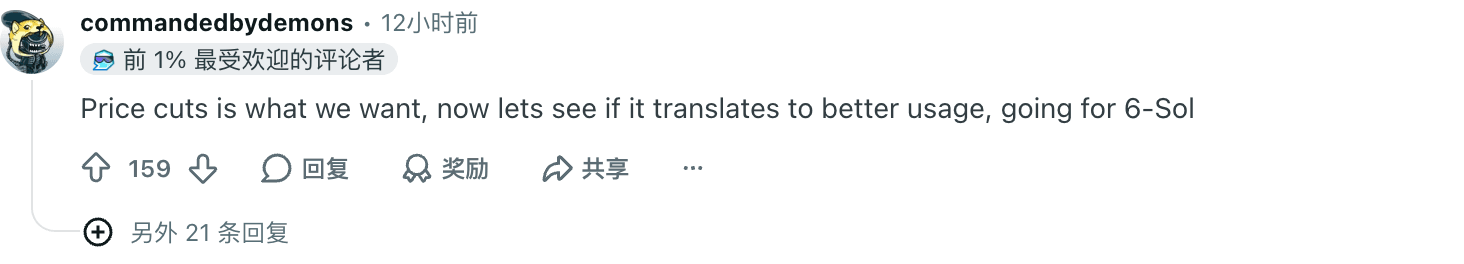
阵营一:"半价就是升级。" "Pretty good. Wayyyyyyy cheaper."(好得很,便宜太多了。)(u/Nakayamaguci13)。"Literally almost half usage and smarter by most credible benchmarks"(用量几乎减半,多数可信基准还更聪明)(u/Final-Voice4738)。观望的大多数把 r/codex 串顶到 159 赞:"Price cuts is what we want, now lets see if it translates to better usage, going for 6-Sol"(降价就是我们要的,接下来看它能不能转化为更好的使用体验,我上 6-Sol 了)(u/commandedbydemons)。
阵营二:"这是重新定价,不是继任者。" "它确实更笨。感觉更像 Terra。"(u/ElonsBreedingFetish)。"According to AA,性能反而更差了。"(u/Oxi_Dat_Ion)。cmrdporcupine 的回退是这个阵营最重的表态,见上文。
中间派握着真正的信息。 Hacker News 的 u/mchusma 说出了大多数团队面对的真实对比:"I personally am preferring Opus 5.5 at medium over GPT-6 Sol Max, in very very early tests. Similar price range, more capability."(非常早期的测试里,我个人更偏好 medium 档的 Opus 5.5 而不是 max 档的 GPT-6 Sol。价位相近,能力更多。)(HN)。
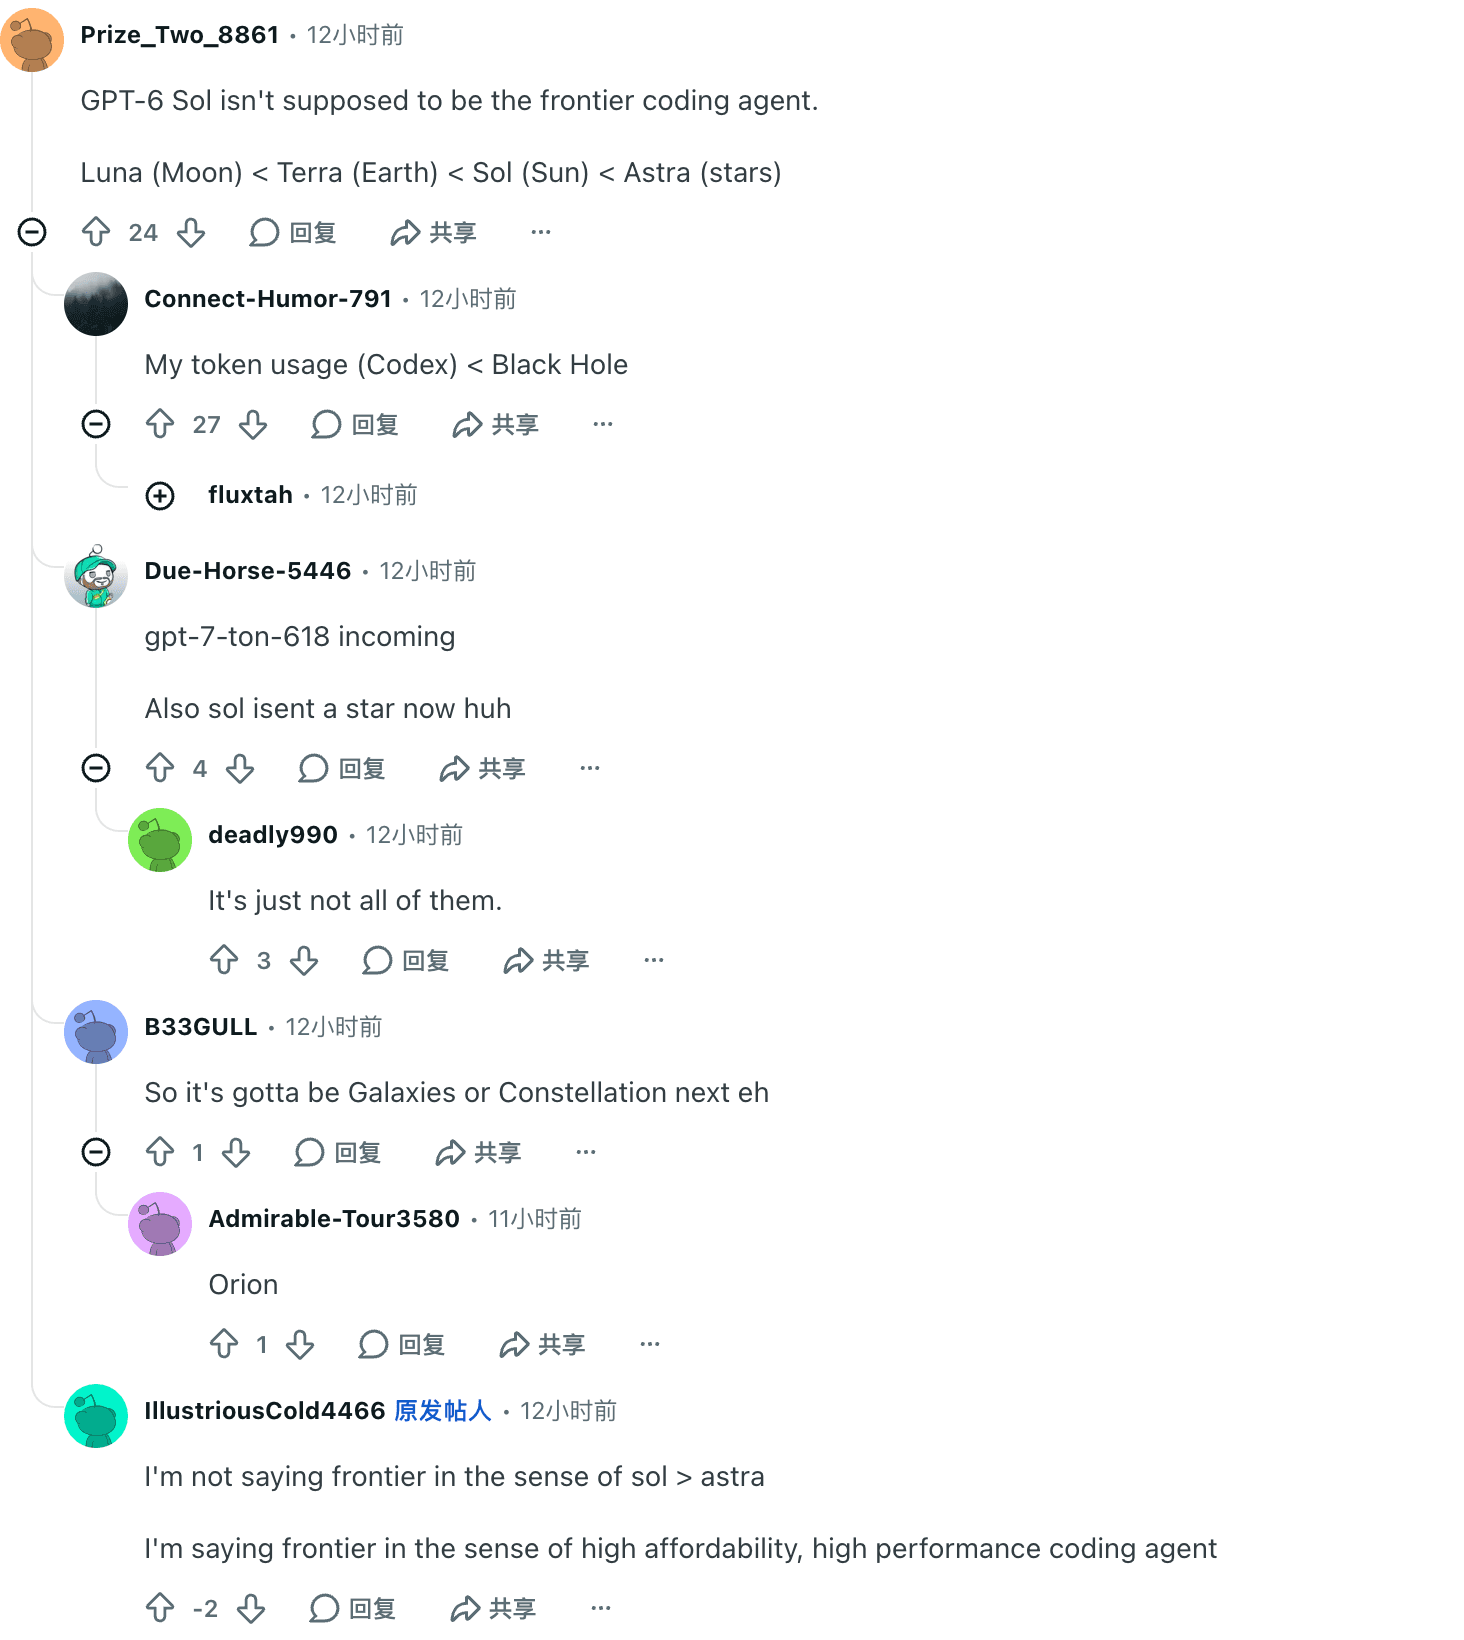

我们的编辑判断:两个阵营描述的是同一个设计选择,只是站在各自的工作负载一侧。答错代价高的地方,Sol 比上代显得更聪明;覆盖率珍贵的地方,它显得更笨。基准说"持平",而两个阵营都对——各自对上了平均值属于自己的一半。
裁决:按工作负载选
| 你的工作负载 | 最佳选择 | 理由 | 注意 |
|---|---|---|---|
| 高用量例行自动化、预算敏感的 agent 循环 | GPT-6 Sol(xhigh) | AutomationBench 上以 Opus 5 (max) 每任务 9% 的成本胜出;xhigh 档约 $0.53/任务 | 上下文压在 272K 计费断崖之下;缓存窗口 30 分钟 |
| 日常编码与"第二意见"代码评审 | GPT-6 Sol(high–max) | FrontierCode 与 Fable 5.1 xhigh 持平且成本低得多;能揪出幻觉结论 | 给弃答留兜底路径;引用要核验 |
| 30 分钟以上的顽固自调试、长时程自主 | GPT-6 Astra | 溢价买的就是顽固——见 Astra 总览与 Astra 测评 | 每任务成本 3 倍以上;高 effort 下首字延迟拉长 |
| 专家知识工作:法律、金融、深度分析 | Claude Opus 5.5 | Sol 在 GDPval 上跌约 100 Elo;Opus 以 58 领跑 II | 每任务成本最高;max 档话痨 |
| ChatGPT 端的日常聊天 | 暂留 5.6(免费档 Luna,Plus 用 5.6 Sol) | Sol 还没进 Chat;6 代配额烧穿是真的 | 留守则促销价与 1M 上下文配置仍然适用 |
| 跨实时浏览器标签页的研究与自动化 | Tabbit + Sol(出现在你的选择器时) | 模型就贴着你的标签页和文件跑——见下文 | 可用性取决于账号的模型选择器 |
一句话裁决:把自动化和编码的预算切到 GPT-6 Sol;不要切知识工作的上限和无人值守的长时程 agent。它就是你一直在向 OpenAI 购买的同一档智力,标价减半,附带一种新性格:宁可留下一个不回答的问题,也不愿意答错。就照这个岗位说明书雇它。下单预算前再注意一行小字:每一句"便宜 50%"用来对比的 GPT-5.6 基准价,都是至少持续到 2026 年 11 月 21 日的促销价。
让 GPT-6 Sol 在你工作已经在的地方跑起来:Tabbit
成绩单不是浏览器工作流。真实的工作——调研、比价、抽取、评审——散落在二十个打开的标签页、本地文件和网页应用里,裸 API 调用一个都看不见。手动把 Sol 接进去,意味着把页面内容复制进提示词、自己管理上下文窗口,每次都重搭一遍管道。
这正是 Tabbit 浏览器在一篇模型测评里值得占据一节的原因。Tabbit 是一款 agentic AI 浏览器,让模型工作流直接跑在你的浏览上下文上:跨标签页研究、agentic 推理与深度研究任务、跨实时页面的自动化。当 GPT-6 Sol 出现在你账号的模型选择器里,这些工作流可以直接指向它,不用写任何编排代码——而且可以按任务切换更便宜或更强的模型,这恰好是一台"半价、智力持平"的模型最奖励的使用纪律。
两条诚实的边界:Tabbit 内的模型可用性取决于你的关联账号和套餐——围绕 Sol 搭工作流之前先看选择器;客户端不改变 OpenAI 的计费,$2/$10 的费率卡怎么都是那张。想看这个模型在实践中到底被怎么用,可以浏览 GPT-6 Sol 模型页、提示词目录和社区评审证据库。
准备好让 GPT-6 Sol 跑在你自己的标签页上,而不是基准里了吗?
 Tabbit Browser

常见问题
GPT-6 Sol 比 GPT-5.6 Sol 更强吗?
独立测量显示两者智力大致持平:Artificial Analysis 给出 GPT-6 Sol (max) 的 Intelligence Index 为 48,与 GPT-5.6 Sol 持平,但每任务成本减半($1.06 对 $1.99)。GPT-6 Sol 在 AA-Omniscience 上的幻觉率从 92% 降到 60%,但实现方式是只尝试 83% 的问题(上代为 99%)。这个交换是否划算,取决于你的场景里答错和答不出哪个代价更大。
GPT-6 Sol 为什么拒答或跳过更多问题?
Artificial Analysis 把幻觉率改善归因于弃答:GPT-6 Sol (max) 在 AA-Omniscience 上只尝试 83% 的问题(GPT-5.6 Sol 为 99%),答错的少了,但已答题目的准确率也从 59% 降到 54%。在 agent 管线里,弃答通常表现为任务卡死或升级人工,所以应该预留兜底路径,而不是把拒答当成失败。
GPT-6 Sol 每个任务多少钱?
在 Artificial Analysis 的 Intelligence Index 上,GPT-6 Sol max 档每任务约 $1.06;同一张 $2/$10 费率卡上,effort 从 low 到 max 的成本阶梯约为 $0.13 到 $1.06,光调 effort 就能让成本摆动约 8 倍。完整费率、缓存规则和 272K 长上下文阈值见我们的 GPT-6 Sol 定价指南。
GPT-6 Sol 和 GPT-6 Astra 怎么选?
高用量编码、自动化和成本敏感的 agent 循环选 GPT-6 Sol;长时程自主任务、需要顽固坚持的场景选 GPT-6 Astra。Sol 的 AA Intelligence Index 是 48,Astra 是 53,但 Sol 每任务成本约为 Astra 的三分之一;两者共用 272K 长上下文计费阈值。什么时候值得为 Astra 付溢价,见我们的 GPT-6 Astra 测评。
GPT-6 Sol 在 ChatGPT 里能用吗?
Chat 端还没有。发布时 GPT-6 Sol 面向 Plus、Pro、Business、Enterprise 和 Edu 用户在 ChatGPT Work 与 Codex 中可用,Free 和 Go 用户在桌面端拿到的是 GPT-6 Luna。OpenAI 说 Chat 端会逐步放量,API 侧模型 ID 是 gpt-6-sol。把工作流押上去之前,先在自己的套餐模型选择器里确认。
能在 Tabbit 浏览器里用 GPT-6 Sol 吗?
Tabbit 浏览器支持跨标签页、本地文件和实时网页的多模型工作流,当你的账号或 API 权限包含 GPT-6 Sol 时,它会出现在模型选择器里。可用性取决于账号,使用客户端也不会改变 OpenAI 的计费。下载前可以先在 GPT-6 Sol 提示词目录里浏览任务配方。