
2026 年 9 月 22 日,两个前沿模型在同一天落地。OpenAI 发布了 GPT-6 Sol(gpt-6-sol),这是 GPT-6 家族中与 GPT-6 Luna 同步推出、面向编程与智能体的专用模型;Anthropic 发布了 Claude Opus 5.5(claude-opus-5-5),作为 Opus 5 的继任者,以更低的价格定位为自家最强的全能模型。如果你这一周正在两者之间做选择,你面对的不是谁赢谁输,而是两种截然不同的模型定价与调校理念。
作为一名每天把基础模型接入自主智能体与多页研究系统的工程师,我不会根据新闻稿评估发布当天的模型。以下内容基于官方模型卡与公告,加上发布最初 24 小时内的独立测量——并且每个基准都明确标注努力档位,因为大多数发布日对比都在这个地方悄悄作弊。
如果你只需要 GPT-6 Sol 的费率表,请读我们专门的 GPT-6 Sol 定价指南。OpenAI 这边的姊妹款,见我们的 GPT-6 Astra 评测与 GPT-6 Astra 概览。Anthropic 这边,我们的 Claude Fable 5.1 评测覆盖了 Opus 5.5 之下中端产品线的进展。你也可以在 GPT-6 Sol 模型页与 Claude Opus 5.5 模型页查看原始规格。本文是直接的工程对比。
关键结论
一家厂商的默认档击败另一家的最高档:Claude Opus 5.5 在默认 medium 档位下智能指数每任务 51.2 分、$1.34,高于 GPT-6 Sol 最高 max 档位的 47.5 分、$1.06。在约 44 分以上的智能需求区间,Opus 5.5 以相近花费胜出。
Sol 头条上的 2 倍差价有明确的失效点:未缓存费率为 Opus 5.5 的一半(每百万 token $2.00/$10.00 对 $4.00/$20.00),但一旦请求输入超过 272K token,整个 Sol 请求改按长上下文费率 $4.00/$15.00 计费——不再是折扣,而是平价。
日常自动化是 Sol 的主场:在 AutomationBench-AA 上,Sol xhigh 档(61.7%)以约低 40% 的成本追平 Opus 5.5 medium 档(61.2%),且其
none档位可以完全关闭扩展思考。终端与前沿编程工作属于 Opus 5.5:即使在 medium 档,它在 Terminal-Bench 4.0 上也领先 8.6 个百分点(52.5% 对 Sol max 的 43.9%),Anthropic 公布的 xhigh 档为 66.4%。
输出冗长度是一个计费变量:max 档下 Opus 5.5 每任务产生约 119K 输出 token,Sol 约为 31K。按输出每百万 token $20 计费,这 3.8 倍差距会叠加成开放式任务上真实的发票差额。
决定这场对决的一个数字:默认档击败最高档
这场对比的核心张力,是发布日报道大多遗漏的一组配对。截至 2026 年 9 月 23 日的独立测量显示,Claude Opus 5.5 在默认 medium 档位下智能指数 51.2 分、每任务 $1.34;GPT-6 Sol 在最高的 max 档位下为 47.5 分、每任务 $1.06。
每美元得分(独立测量,2026-09-23):
Claude Opus 5.5  medium(默认档):  51.2 分   $1.34/任务
GPT-6 Sol        max   (最高档):  47.5 分   $1.06/任务

交叉点:智能需求低于约 44 分时 Sol 更便宜;
高于 44 分时 Opus 5.5 以相近花费直接胜出。
一家厂商的开箱配置在交叉点以上同时赢下分数与每美元得分,压过另一家的最大档位。这就是"默认档击败最高档"悖论,并且在发布后数小时内的社区早期测试中得到了印证。
第二个数字决定 Sol 的价格优势到底在哪里成立。OpenAI 的费率表很干净:标准短上下文请求每百万 token 输入 $2.00、输出 $10.00——恰好是 Opus 5.5 $4.00/$20.00 的一半。但模型卡里有一个大多数标题都漏掉的阈值:一旦请求输入超过 272K token,整个请求改按长上下文费率计费——输入 $4.00、缓存读 $0.40、缓存写 $5.00、输出 $15.00。此时 Sol 在自己宣传的 1,050,000 token 上下文窗口内,用得比 Opus 5.5 还贵或一样贵,而 Opus 5.5 的 1M 上下文没有同等的悬崖。
每 1M token 的有效输入成本:
272K 输入以内:  Sol $2.00  对  Opus 5.5 $4.00  --> Sol 便宜一半
272K 输入以上:  Sol $4.00  对  Opus 5.5 $4.00  --> 平价(输出 $15 对 $20)
如果你的负载是紧凑上下文下的智能体循环——也就是 智能体推理系统的典型形态——Sol 的折扣是实实在在的钱。如果你的负载是把整个代码库或长篇文档语料塞进提示词,折扣恰恰在你最需要上下文窗口的那一刻蒸发。
规格与定价一览
两个模型都宣传百万级上下文和分档的努力档位,但机制差异对成本工程有实际影响。下表为每百万 token 的美元费率,已于 2026 年 9 月 23 日对照两份官方模型卡核实。
| 维度 | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| API 标识 | gpt-6-sol | claude-opus-5-5 |
| 上下文窗口 | 1,050,000 token | 1,000,000 token |
| 最大输出 | 未在上下文以下单独设限 | 128,000 token(Batch 测试版 300K) |
| 努力档位 | none / low / medium(默认)/ high / xhigh / max | low / medium(默认)/ high / xhigh / max |
| 扩展思考开关 | 可关闭(none) | 不可关闭 |
| 输入(未缓存) | $2.00(272K 输入以上 $4.00) | $4.00 |
| 缓存输入读 | $0.20(272K 输入以上 $0.40) | $0.20(较 Opus 5 折让约 60%) |
| 缓存输入写 | $2.50(272K 输入以上 $5.00) | $5.00 |
| 输出 | $10.00(272K 输入以上 $15.00) | $20.00 |
| Batch 定价 | 标准价 50%(Flex) | 输入 $2.00 / 输出 $10.00 |
| 快速档 | 标准价 2× | $8.00 / $40.00(约 2.5× 速度) |
| 知识截止 | GPT-6 家族代际 | 2026-06 |
| 厂商成本宣称 | — | 典型负载较 Opus 5 便宜约 40%(厂商口径) |
有三个工程细节值得注意。第一,Sol 的 none 档位是独家的:它彻底关闭扩展思考,提供一种 Opus 5.5 无法复制的确定性低延迟模式——后者的思考永远在线。第二,两个模型的缓存读取价都是每百万 token $0.20,因此在高缓存命中率的生产管线里,发票的输入侧打平,输出冗长度成为决定性变量。第三,Anthropic"比 Opus 5 便宜约 40%"的说法是厂商口径;本文后面会写到,社区复算在一种真实负载上得到的结论更接近持平。
一个算例可以把档位机制讲具体。假设一条自动化管线每月跑 50,000 个任务,每个任务 40K 输入 token(缓存命中率 90%)、2K 输出 token,档位对齐到 medium 档,且全部在 272K 阈值以内:
GPT-6 Sol(每任务:4K 未缓存输入 × $2.00 + 36K 缓存读 × $0.20 + 2K 输出 × $10.00):$0.008 + $0.0072 + $0.020 = $0.0352 → 每月 $1,760
Claude Opus 5.5(每任务:4K 未缓存输入 × $4.00 + 36K 缓存读 × $0.20 + 2K 输出 × $20.00):$0.016 + $0.0072 + $0.040 = $0.0632 → 每月 $3,160
Sol 跑同一条管线便宜约 44%(成本约为 Opus 5.5 账单的 56%)。现在把输入换成每任务 300K token:Sol 的整个请求翻转到长上下文费率(未缓存 $4.00、缓存读 $0.40、输出 $15.00),结果为 $12,900 对 Opus 5.5 的 $10,700——名义上更便宜的模型反而贵出 20%。这个阈值不是脚注,而是长上下文架构的决定性变量。
基准测试,以及该信多少
发布日的基准表在独立实验室复现之前都是营销材料。下表混合了厂商口径(已标注)与独立测量,而后面四条校准说明比任何单一数字都重要。
| 基准 | Claude Opus 5.5 | GPT-6 Sol | 解读 |
|---|---|---|---|
| 智能指数(得分 / 每任务美元) | 51.2 / $1.34(medium) | 47.5 / $1.06(max) | Opus 默认档高于 Sol 最高档;44 分以下 Sol 更便宜 |
| Terminal-Bench 4.0 | 52.5%(medium);66.4%(xhigh,厂商,±2.6 标准误) | 43.9%(max);44%(独立) | Opus 在终端/智能体 CLI 场景领先约 9 分 |
| AutomationBench-AA | 61.2%(medium) | 61.7%(xhigh) | 统计打平;Sol 成本低约 40% |
| GDPval-AA v2.1 | 1846 Elo(厂商) | 较前沿模型回退约 100 Elo(独立) | Opus 在知识工作评测上更强 |
| Humanity's Last Exam(带工具) | 67.7%(max,厂商) | 本周期未经独立核实 | 仅作方向性参考 |
在把任何一条当作结论之前,有四条校准提醒:
档位不对齐是最常见的作弊。 发布时流传的 Sol 数字大多来自 max 或 xhigh 档,而 Opus 数字来自 medium 默认档。任何不写明双方档位的结论,都是拿调校过的设置对比未调校的设置。本文始终标注档位。
厂商口径带着厂商口径的乐观。 Opus 5.5 的 Terminal-Bench 66.4% 与 HLE 67.7% 是 Anthropic 在标注条件下的公布值;其中 Terminal-Bench 带有 ±2.6 的标准误。Sol 的 $1.06/任务与幻觉率数字由 Artificial Analysis 独立测量。独立数字权重应更高。
Sol 的幻觉率改善有一部分是拒答换来的。 独立测量显示 Sol 的幻觉率从 92% 降到 60%——但很大程度上靠更频繁地拒答实现。在智能体管线里,拒答不是免费的:它表现为任务卡死或升级到人工,而基准百分比把这部分藏了起来。
冗长度会放大 Opus 的输出费率溢价。 max 档下 Opus 5.5 每任务产生约 119K 输出 token,Sol 约 31K。叠加 $20/M 对 $10/M 的输出费率,高努力档位下的开放式任务成本可能是标价差距的好几倍。低档时差距明显收窄。
Claude Opus 5.5 真正赢在哪里
Opus 5.5 不是更便宜的模型,它也没打算做便宜的模型。它在任务质量天花板、而不是发票成为约束条件的地方获胜。
1. 终端与前沿编程智能体工作
最清晰的结构性优势在 Terminal-Bench 4.0——它衡量的是自主命令行软件工程。Opus 5.5 在 medium 档拿下 52.5%,Sol 在 max 档为 43.9%。在两家厂商都明确瞄准的负载类别——多步 shell 环境、构建-修复循环、测试驱动的修复——这是约 17% 的相对差距。Anthropic 公布的 xhigh 档 66.4% 进一步拉大了差距,不过带有前述厂商口径的保留条件。
2. 知识工作与通用智能评测
在职业知识工作评测 GDPval-AA v2.1 上,Anthropic 公布 1846 Elo。独立测量发现 Sol 在同族评测上较可比前沿模型回退约 100 Elo。这与 Sol 的定位一致:它是一个编程与自动化专用模型,拿通用知识面的宽度换成本效率。在研究综合、文档分析与开放域推理上,Opus 5.5 的上限更高。我们关于 Anthropic 中端 Claude Fable 5.1 的报道,有助于理解这个家族在 Opus 价位之下把通用能力推到了多远。
3. 默认档体验
Opus 5.5 最被低估的特性是:它的默认档就是它的强档。Medium 档在交叉点以上的每美元得分胜过 Sol 的 max,意味着没有精力调校预算的团队开箱即得前沿表现。而 Sol 的最优价值需要主动配置——确定性任务选 none,自动化选 xhigh,并接受 max 档在通用能力上仍落后 Opus 默认档。
GPT-6 Sol 真正赢在哪里
Sol 的卖点不是"便宜点但差不多好"。它是一种不同的成本架构,有三项具体优势。
1. 标价恰好一半,还附赠思考关闭开关
未缓存短上下文每百万 token $2.00 输入、$10.00 输出,Sol 比 Opus 5.5 便宜 50%——而且它提供了一个前沿竞品都没有的东西:none 档位彻底关闭扩展思考。对高吞吐的结构化抽取、分类与模板化生成来说,为一台停不下来的模型付费是浪费,Sol 让你把推理表关掉。想看这份费率表与其他厂商的横向比较,我们的 Kimi K3 定价 分析用的是同一套总成本方法。
2. 在能力打平处的自动化成本效率
在 AutomationBench-AA 上,Sol xhigh 档 61.7%,Opus 5.5 medium 档 61.2%——统计打平,而每任务成本低约 40%。如果你的管线是浏览器自动化、DOM 抽取、表单导航与工具编排,Sol 是理性默认:能力相同,账单不同。
3. 输出纪律
Sol 在 max 档每任务产生约 31K 输出 token,Opus 5.5 约 119K。对必须产出有界产物的智能体——JSON 载荷、补丁 diff、结构化摘要——Sol 的简洁是特性而非限制:更少的 token 要解析,更少的 token 要付费,更少的返工循环。
开发者与社区真实怎么说
双发布后的 24 小时内,开发者论坛产出的信号多于大多数发布日报道。以下是 6 条代表性声音,采集于 2026 年 9 月 23 日:
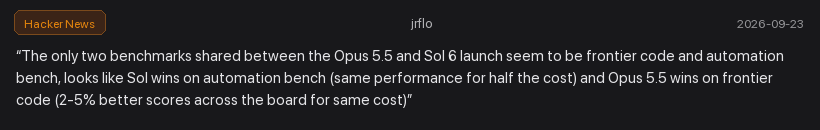
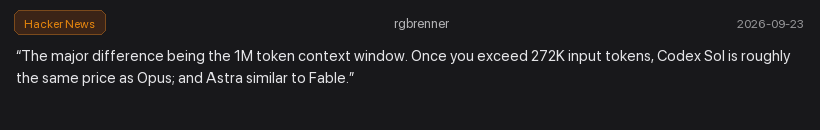
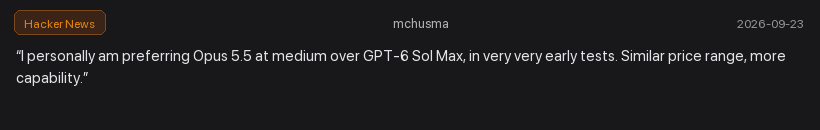
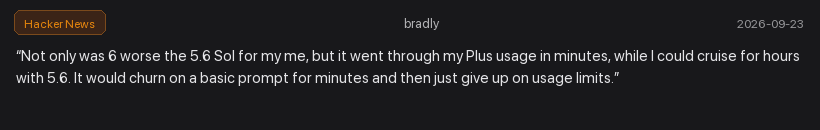
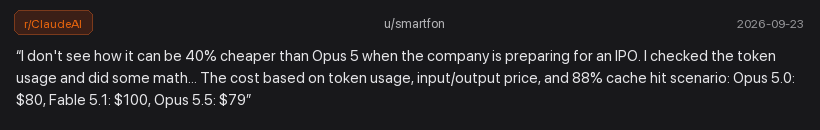
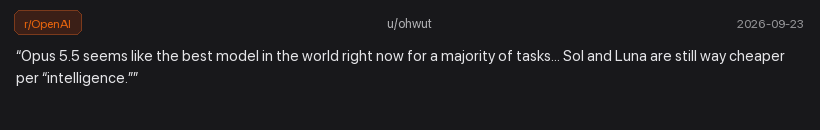
这六条声音呈现出的模式与测量数据一致:社区没有加冕唯一的胜者,而是沿负载边界分裂——自动化与成本效率偏向 Sol,前沿编程与通用能力偏向 Opus 5.5——并且立刻把注意力放在档位对齐与总成本核算上,而不是原始榜单名次。
结论:负载决策矩阵
| 负载画像 | 推荐模型 | 决定性理由 | 成本说明 |
|---|---|---|---|
| 终端智能体与 CLI 驱动的编程 | Claude Opus 5.5 | medium 档在 Terminal-Bench 4.0 领先约 9 分(52.5% 对 Sol max 的 43.9%) | 标价 2 倍,能力差距足以支撑 |
| 高吞吐浏览器自动化与抽取 | GPT-6 Sol | AutomationBench-AA 打平(61.7% xhigh 对 61.2% medium),none 档适合确定性任务 | 每任务便宜约 40% |
| 紧凑上下文智能体循环(输入 < 272K) | GPT-6 Sol | 2 倍未缓存折扣完整成立;缓存读同价($0.20/M) | Opus 5.5 标价的一半 |
| 长上下文任务(输入 > 272K) | Claude Opus 5.5 | Sol 长上下文翻转($4/$15)抹平折扣;Opus 无同等悬崖 | 与翻转后的 Sol 费率相比持平或更优 |
| 开放式研究与知识工作 | Claude Opus 5.5 | GDPval-AA 与 HLE 上限更高;默认 medium 在 44 分以上胜过 Sol max | max 档冗长度税更高 |
| 预算受限的通用助手 | GPT-6 Sol | max 档智能指数 $1.06/任务;44 分交叉点以下最便宜 | 单位智能成本最低 |
从原始 token 到浏览器执行:Tabbit 工作流
基准分数不会替你抓网页、维持登录态,或在四十个打开的标签页之间核对互相矛盾的文档。原始基础模型对文本进行推理;它们不会自己管理标签爆炸、动态 shadow DOM 或多步网页工作流。
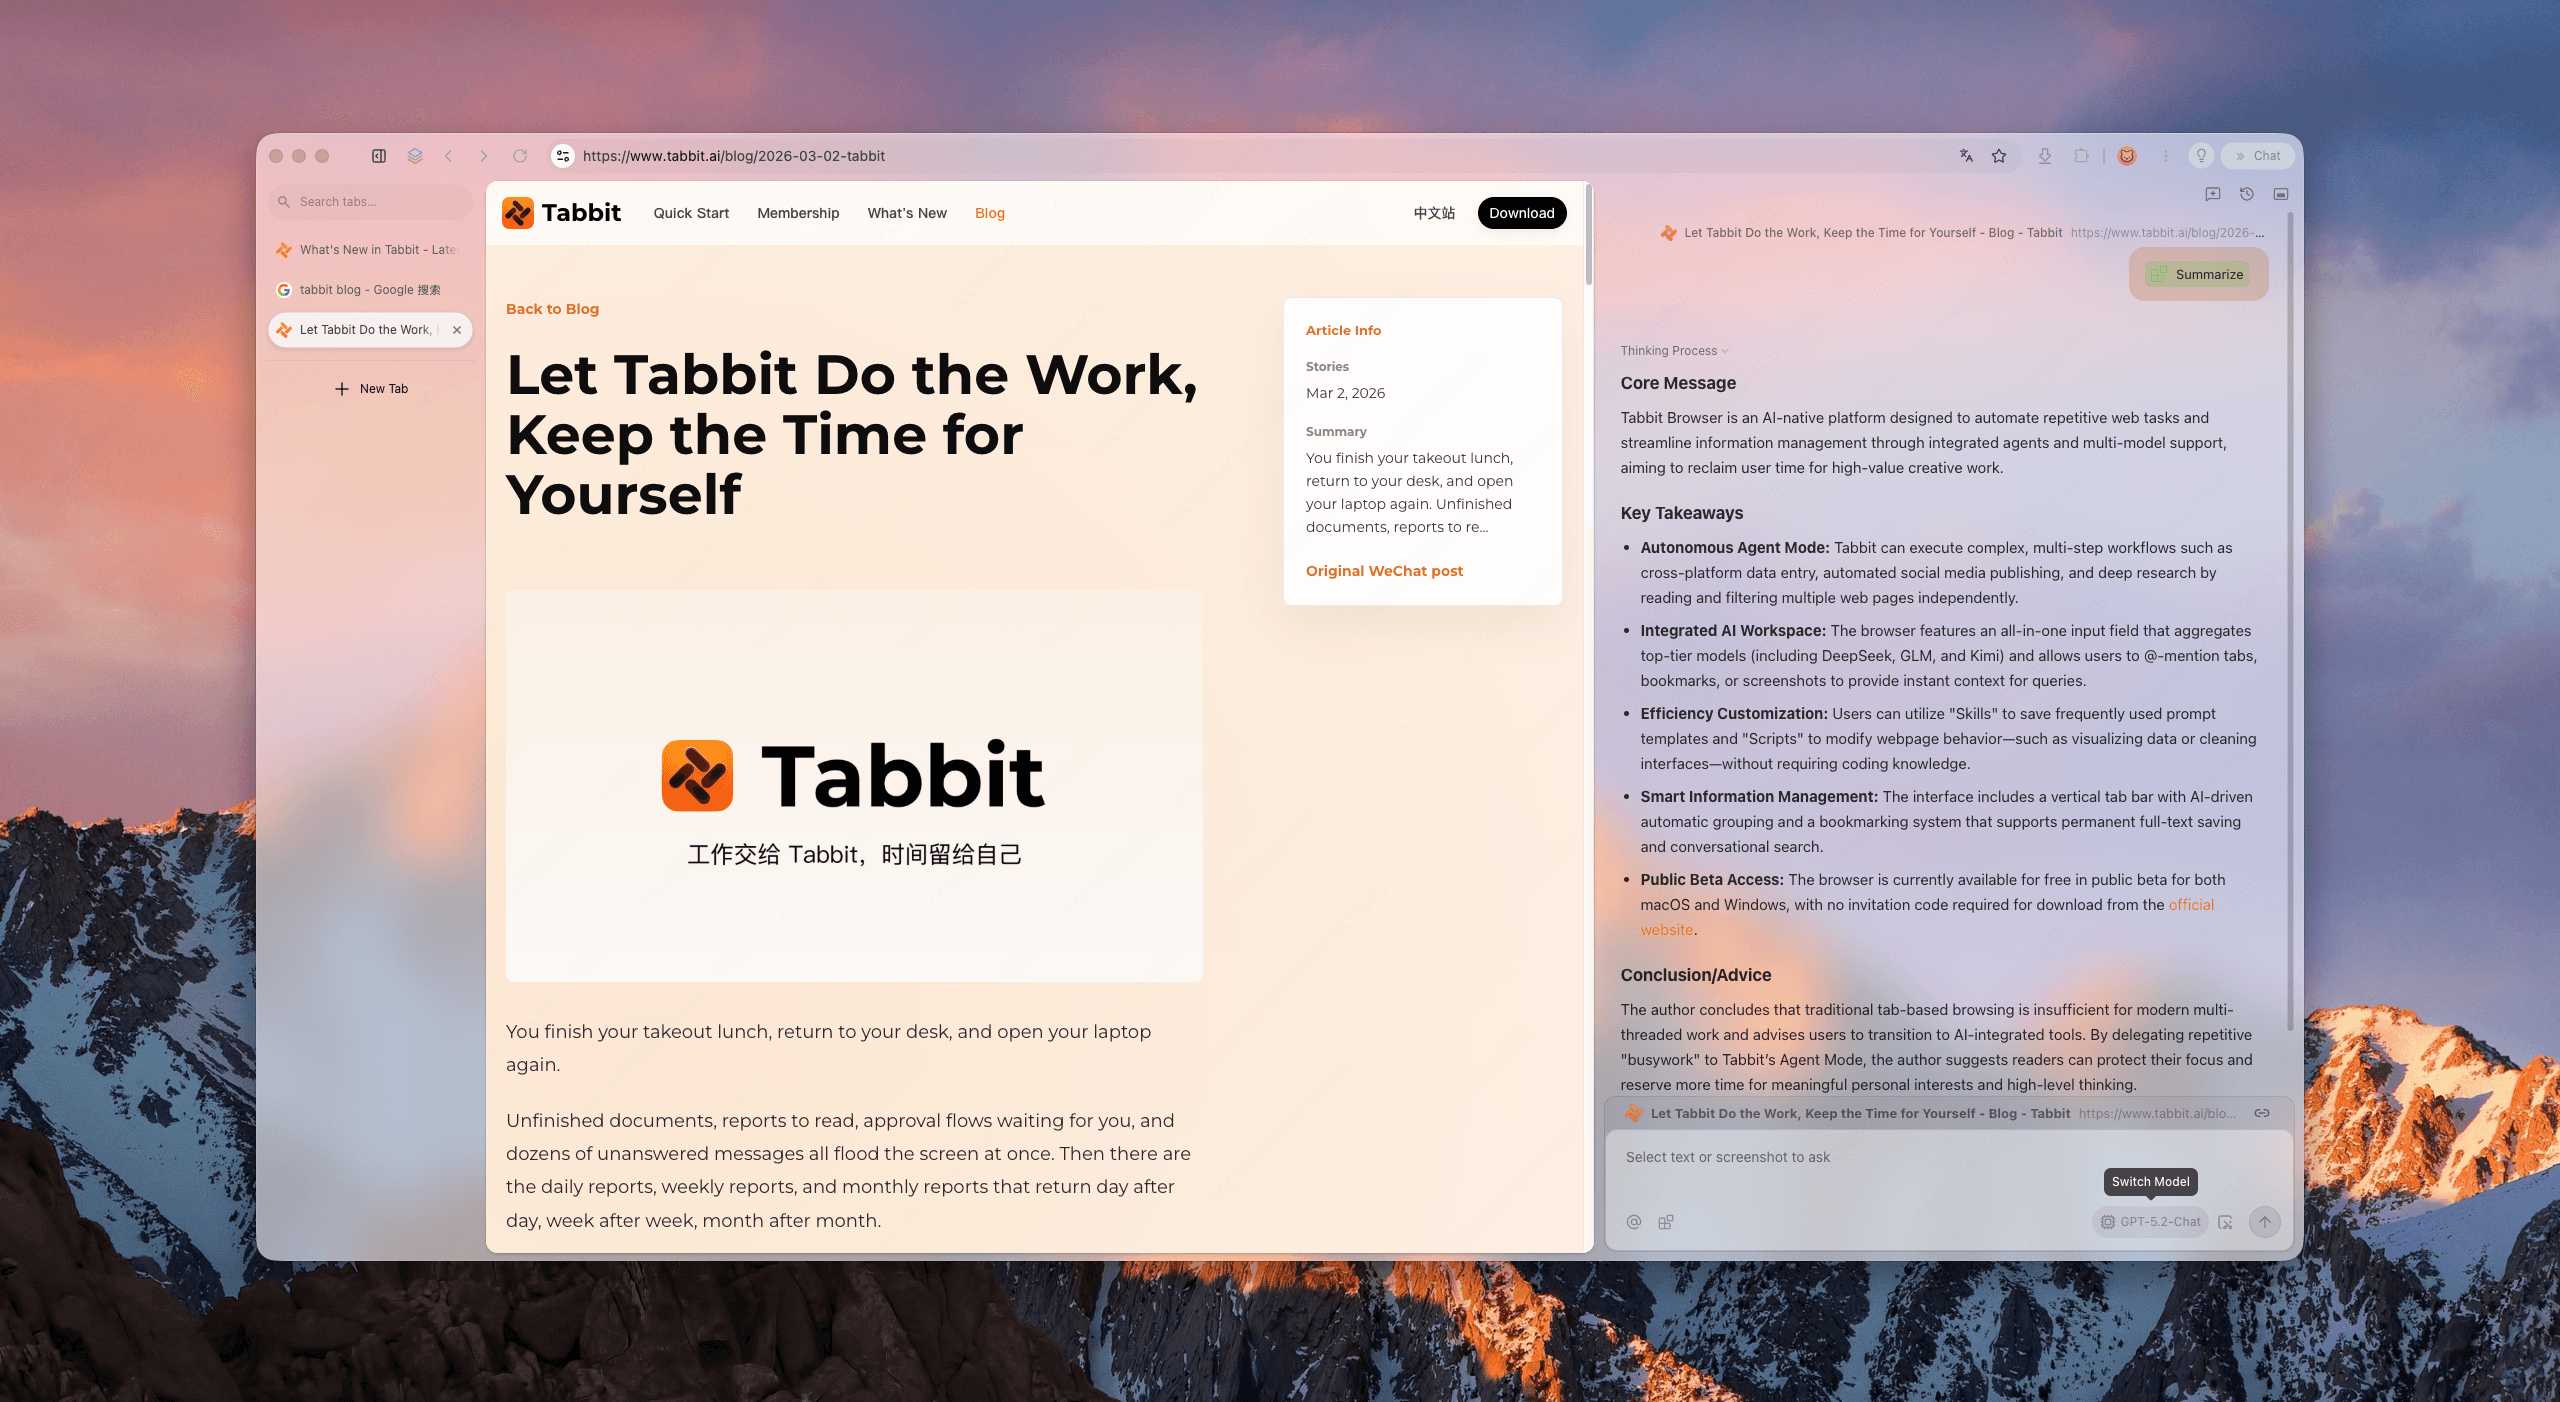
这正是编排环境的价值所在。在 Tabbit Browser 中运行浏览器智能体时,模型负责推理,浏览器层负责记忆、导航与执行。无论你是让 GPT-6 Sol 跑紧凑的自动化循环,还是用 Claude Opus 5.5 驱动终端级编程智能体,AI 原生的智能体浏览器 才是把 token 定价变成完工交付的东西。2026 年的全景扫描见我们的 2026 最佳 AI 浏览器 盘点。
说明:根据平台政策,Tabbit 中的实时模型可用性取决于你账号的模型选择器、支持的集成与平台条款。本文基于官方材料与独立测量,而非内部基准实测。
 Tabbit Browser

常见问题
GPT-6 Sol 和 Claude Opus 5.5 哪个更便宜?
在未缓存的短上下文费率上,GPT-6 Sol 恰好是 Opus 5.5 的一半:每百万 token 输入 $2.00、输出 $10.00,而 Opus 5.5 为 $4.00 和 $20.00。但当一个请求的输入超过 272K token 后,Sol 的整个请求会改按长上下文费率计费(输入 $4.00、输出 $15.00),折扣随即消失。两者的缓存读取价均为每百万 token $0.20。
两个模型谁的基准测试分数更高?
取决于对比的努力档位。Claude Opus 5.5 在默认的 medium 档位下,智能指数每任务 51.2 分、成本 $1.34;GPT-6 Sol 在最高的 max 档位下为 47.5 分、$1.06。Opus 5.5 在 Terminal-Bench 4.0 上也领先(medium 档 52.5%、Anthropic 口径 xhigh 档 66.4%),而 Sol 在 AutomationBench-AA 上以约低 40% 的成本追平 Opus medium 档(61.7% 对 61.2%)。
GPT-6 Sol 和 Claude Opus 5.5 各有哪些努力档位?
GPT-6 Sol 提供 none、low、medium(默认)、high、xhigh、max 六档,其中 none 可以完全关闭扩展思考。Claude Opus 5.5 提供 low、medium(默认)、high、xhigh、max 五档,且扩展思考无法关闭。努力档位同时影响能力与每任务成本,因此任何对比都必须写明双方档位。
为什么很多对比都把 Opus 5.5 medium 和 GPT-6 Sol max 放在一起比?
因为这两个档位下两模型的每任务总成本最接近。对齐成本的测量显示,在约 44 分以上的智能需求区间,Opus 5.5 medium 胜过 Sol max;低于该阈值时 Sol 更便宜。凡是不写明双方档位的对比,通常都是营销而非测量。
Claude Opus 5.5 真的比 Claude Opus 5 便宜 40% 吗?
这是 Anthropic 公布的厂商口径(典型负载)。有社区用户用真实用量日志按 88% 缓存命中率复算,得到 Opus 5.5 每单位工作约 $79、Opus 5.0 约 $80——基本持平,而非便宜 40%。对厂商的成本宣称应按自己的 token 结构重新核算。
我可以在 Tabbit Browser 里使用 GPT-6 Sol 和 Claude Opus 5.5 吗?
Tabbit Browser 提供面向研究、数据提取与多模型对比的 AI 原生工作区。具体模型在 Tabbit 中的可用性取决于你账号的实时模型选择器与平台条款。