
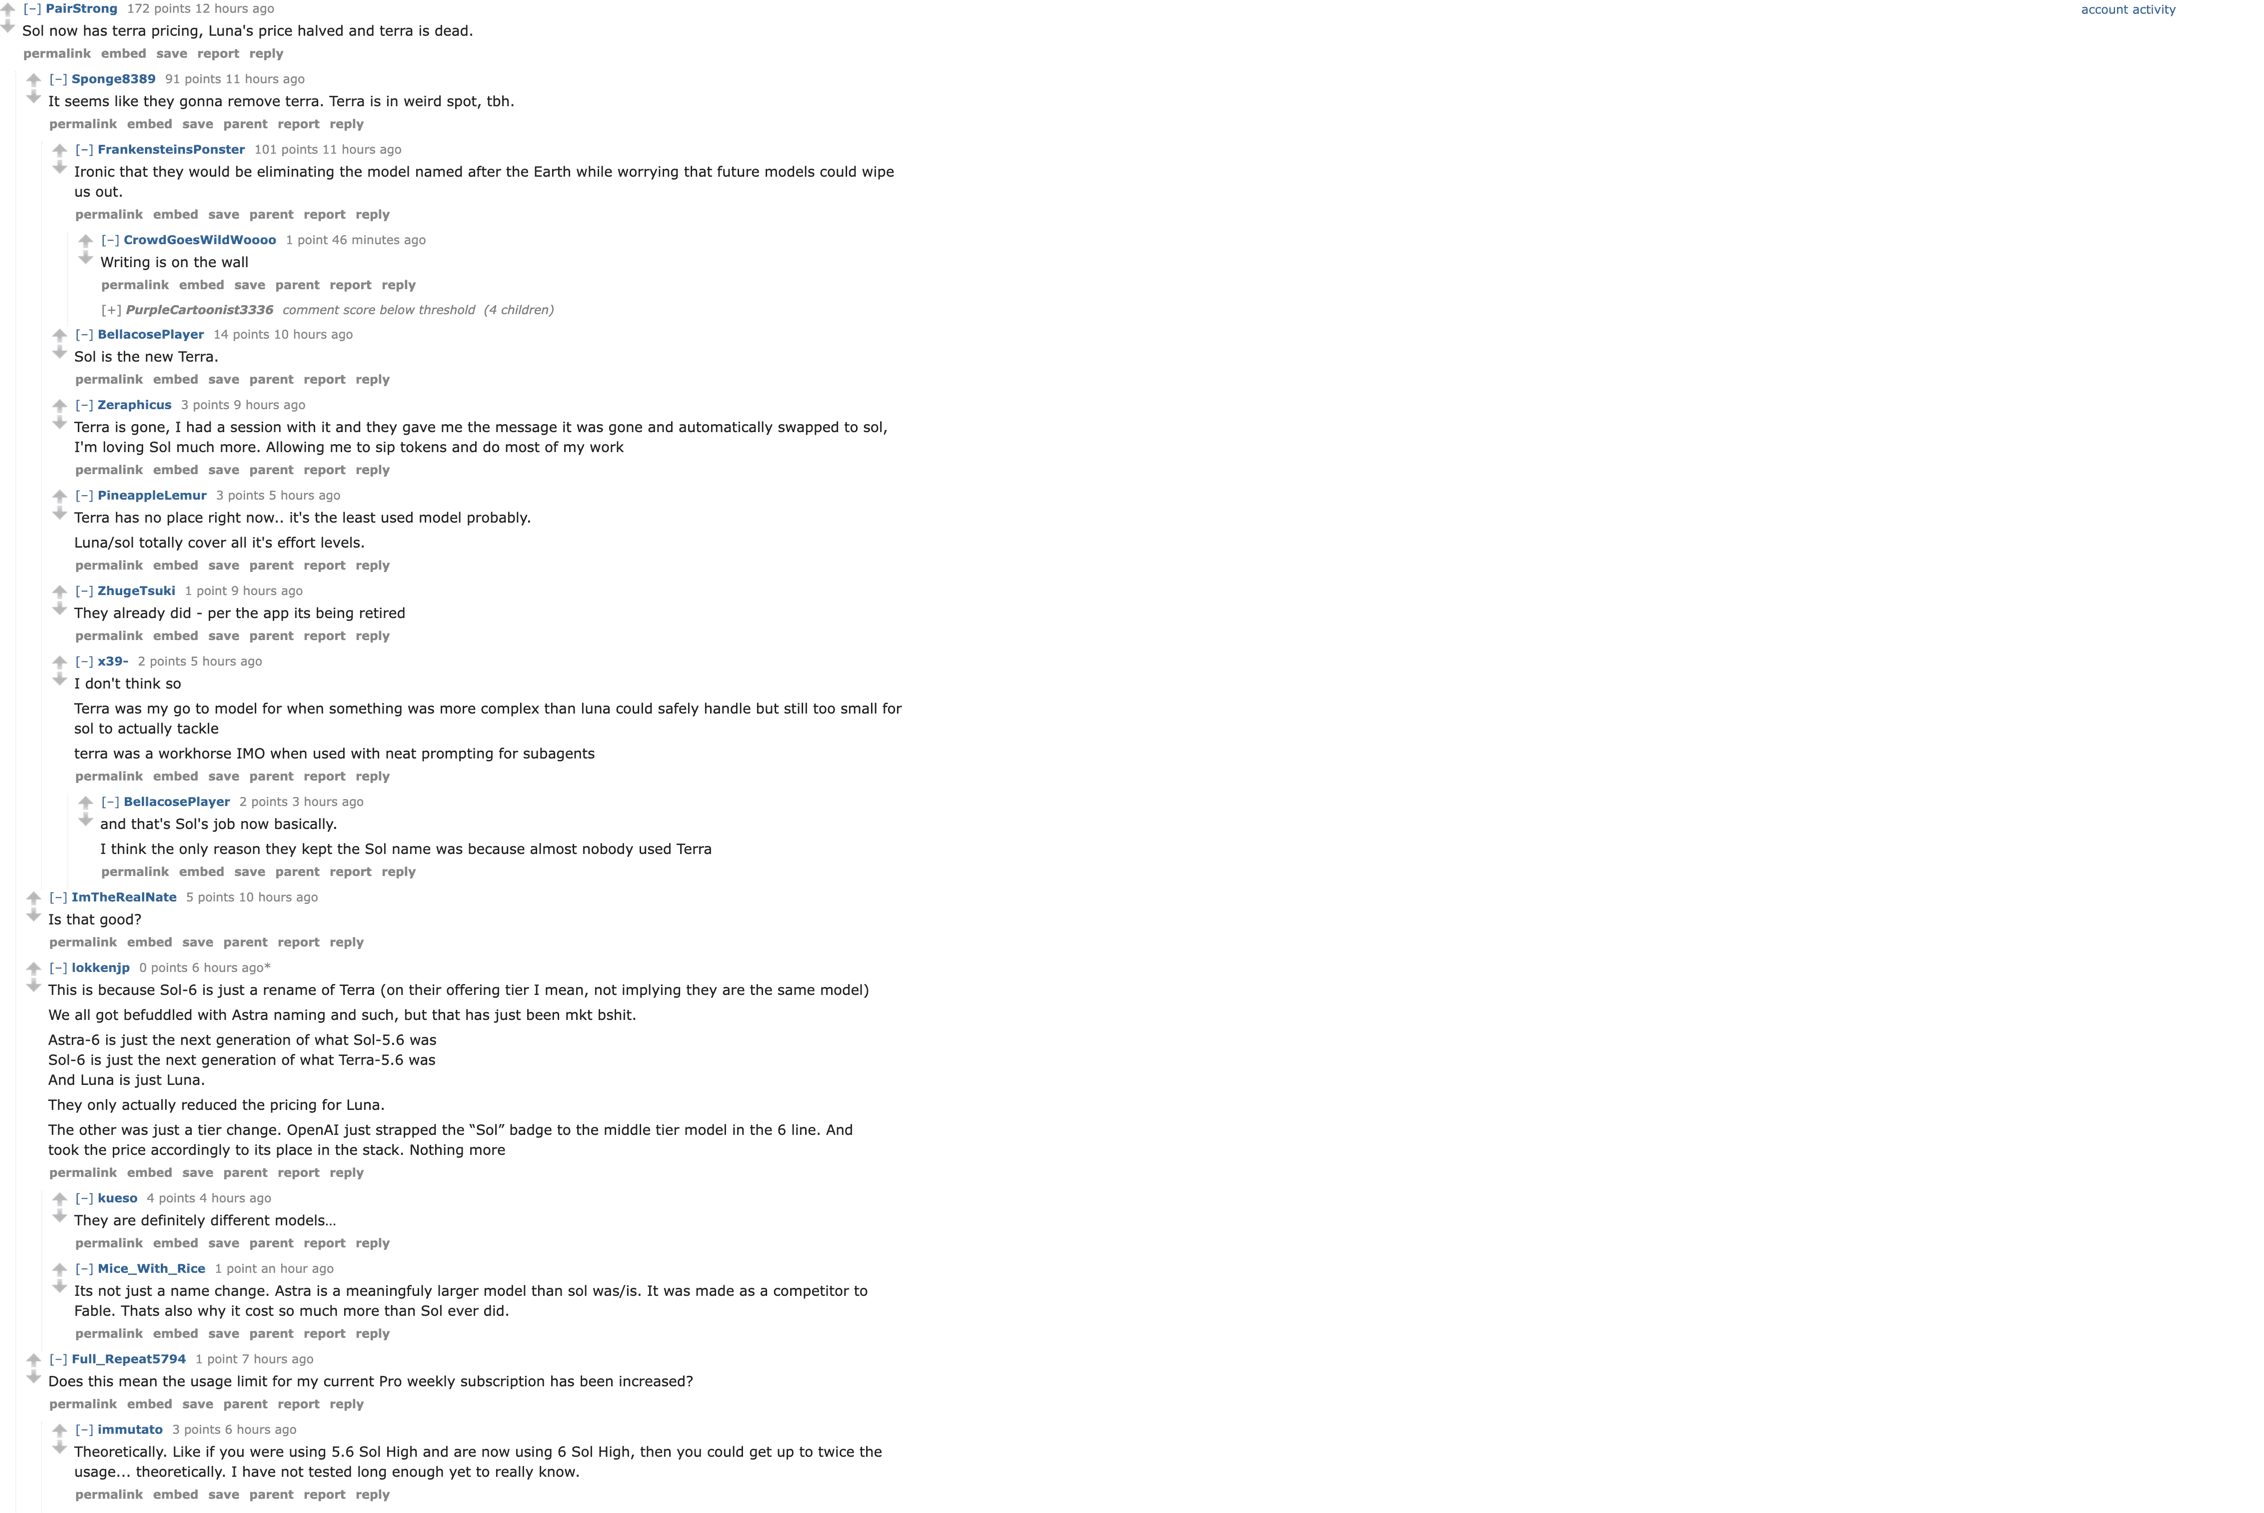
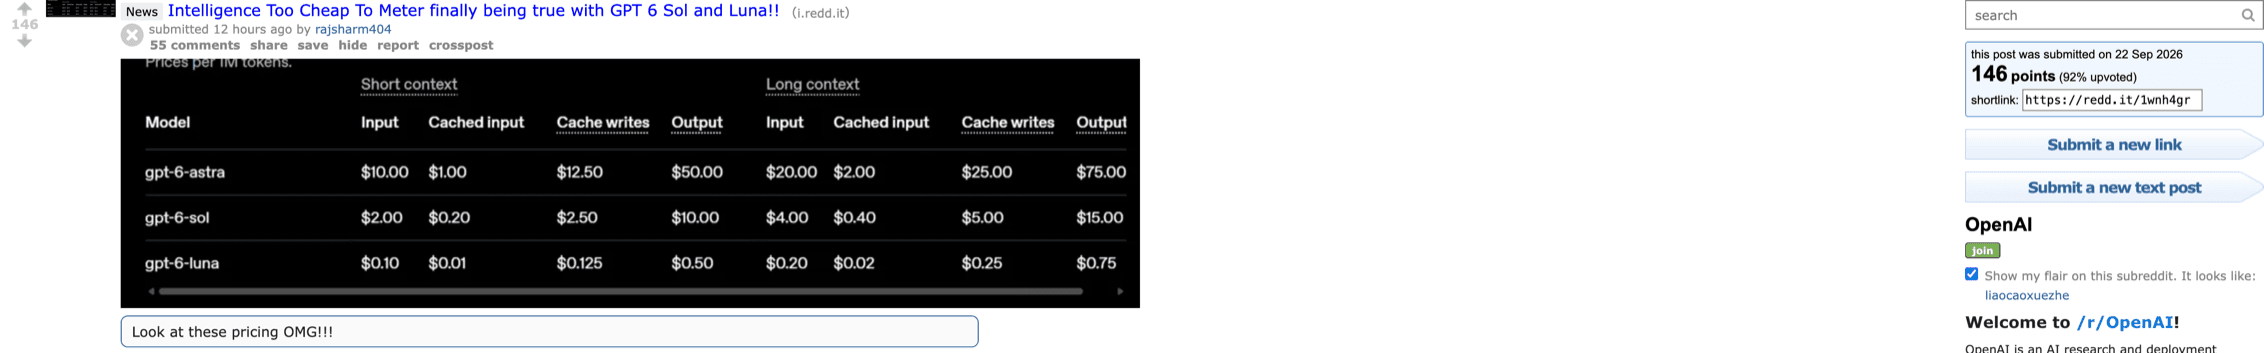
GPT-6 Luna cuesta $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida en la tarjeta de tarifas estándar de la API de OpenAI, comprobado el 23 de septiembre de 2026. La entrada en caché es $0.01, las escrituras en caché $0.125, y los prompts de más de 272K tokens de entrada reprecian toda la solicitud a tarifas de contexto largo. La reacción del día de lanzamiento en r/codex resumió la tarjeta en una línea: "Sol now has terra pricing, Luna's price halved and terra is dead." Frente a las tarifas de GPT-5.6 Luna mostradas en el anuncio ($0.20/$1.20), la entrada cayó un 50% y la salida un 58%. (hilo de r/codex; precios de OpenAI)
Pero el precio de etiqueta es el número menos interesante de esta tarjeta. A $0.10/$0.50, la tarifa apenas se nota en la mayoría de facturas — lo que decide tu gasto es qué nivel de esfuerzo de razonamiento usas (una diferencia de 15x con precios de token idénticos), tu proporción de aciertos de caché, y si un prompt cruza los 272K tokens. Esta página separa la tarjeta de tarifas de la API de las suscripciones de ChatGPT y Codex, muestra la tabla completa con fuentes y fechas, y termina con presupuestos calculados y una calculadora que corre en tu navegador. Si tu siguiente paso tras presupuestar es ejecutar Luna sobre páginas web y archivos, Tabbit Browser es una opción de cliente; no cambia la facturación de OpenAI.
Puntos clave
El contexto corto estándar de GPT-6 Luna cuesta $0.10 de entrada, $0.01 de entrada en caché, $0.125 de escrituras en caché y $0.50 de salida por millón de tokens; un portavoz de OpenAI confirmó a VentureBeat que son tarifas permanentes, no promocionales.
El dial de esfuerzo domina la factura: Artificial Analysis mide la misma tarjeta entre $0.0045 por tarea de Index (low) y $0.07 (max) — 15x — y el valor por defecto de la API es medium, no max.
Por encima de 272K tokens de entrada, todos los tokens de la solicitud pasan a tarifas de contexto largo ($0.20 / $0.02 / $0.25 / $0.75 por millón).
Batch y Flex figuran a la mitad del precio Standard; Fast es 2x; el procesamiento regional añade un 10% donde aplica, y la residencia de datos en la UE de Luna solo admite Standard.
Una tarifa de token no es una cuota de suscripción ni un precio por tarea: el volumen de salida (+24% frente al predecesor en las tareas de Index de AA), los reintentos y las regresiones de calidad vuelven a entrar en el presupuesto.
Precios de la API de GPT-6 Luna de un vistazo
Todos los precios son en USD por millón de tokens, de la página de precios de OpenAI y la página del modelo gpt-6-luna, comprobadas el 23 de septiembre de 2026. Las filas de contexto largo se aplican cuando la entrada es más de 272.000 tokens.
| Nivel de servicio GPT-6 Luna | Contexto | Entrada | Entrada en caché | Escrituras en caché | Salida |
|---|---|---|---|---|---|
| Standard | entrada ≤272K | $0.10 | $0.01 | $0.125 | $0.50 |
| Standard | entrada >272K | $0.20 | $0.02 | $0.25 | $0.75 |
| Batch / Flex | entrada ≤272K | $0.05 | $0.005 | $0.0625 | $0.25 |
| Batch / Flex | entrada >272K | $0.10 | $0.01 | $0.125 | $0.375 |
| Fast | entrada ≤272K | $0.20 | $0.02 | $0.25 | $1.00 |
| Fast | entrada >272K | $0.40 | $0.04 | $0.50 | $1.50 |
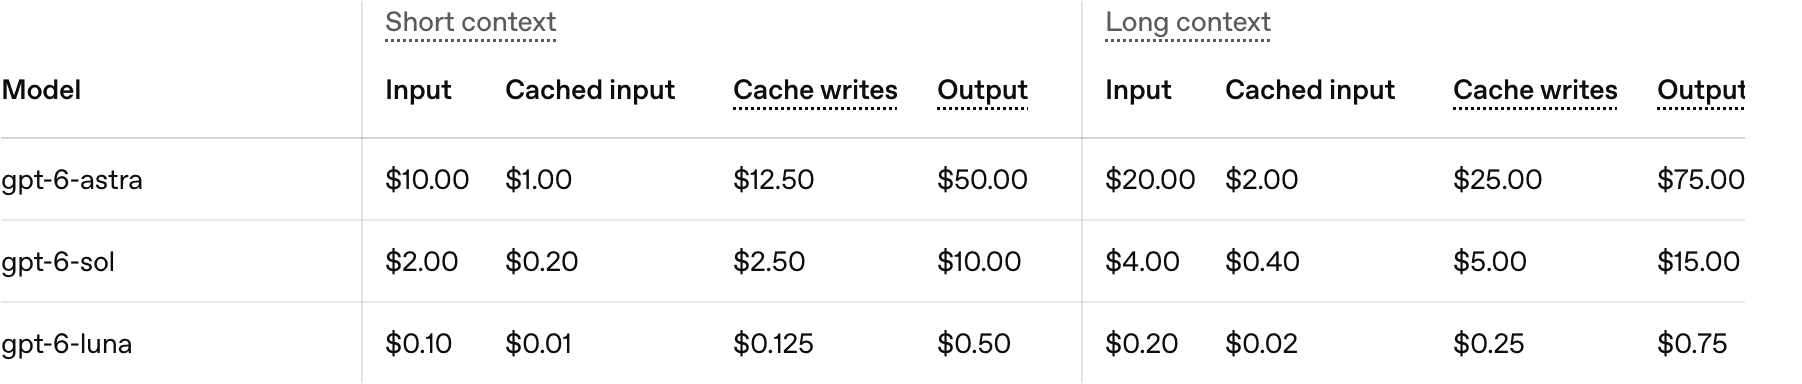
La tarjeta de tarifas encaja en una escalera familiar. Estas son tarifas Standard de contexto corto de la misma tabla:
| Modelo | Entrada | Entrada en caché | Escrituras en caché | Salida | Para qué sirve la fila |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | Trabajo de gran volumen y alcance limitado — el posicionamiento del propio anuncio |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 | Carga repetida de codificación y agentes complejos |
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 | El nivel insignia para las tareas más difíciles |
| GPT-5.6 Sol (predecesor, promocional) | $4.00 | $0.40 | $5.00 | $20.00 | La base de comparación que OpenAI aún lista, promo al menos hasta el 21 de nov |
Luna es veinte veces más barata que Sol en entrada y salida, y cien veces más barata que Astra. Para la economía de los niveles hermanos, lee el desglose de precios de GPT-6 Sol y el desglose de precios de GPT-6 Astra; para lo que el nivel barato realmente compra en capacidad — y dónde retrocede — lee la reseña de GPT-6 Luna. El historial de precios del predecesor está en la guía de costes de GPT-5.6 Sol.
El número que decide tu factura: el dial de esfuerzo
gpt-6-luna acepta valores de reasoning_effort de none, low, medium (el predeterminado), high, xhigh y max. Los precios por token no cambian entre ellos — cambia el número de tokens de razonamiento y de salida. Artificial Analysis sigue a Luna como seis entradas, una por nivel, y su economía medida (instantánea del 23 de septiembre de 2026) es esta:
| Nivel de esfuerzo | Intelligence Index | Coste por tarea de Index de AA | Velocidad de salida |
|---|---|---|---|
| low | 21 | $0.0045 | 175 t/s |
Non-reasoning (none) | 18 | $0.01 | 141 t/s |
| medium (predeterminado) | 29 | $0.02 | 143 t/s |
| high | 32 | $0.03 | 149 t/s |
| xhigh | 34 | $0.04 | 153 t/s |
| max | 37 | $0.07 | 157 t/s |
Dos detalles de esta tabla importan más que las tarifas de arriba:
La diferencia es de 15x. La tarjeta que parece "$0.10/$0.50" factura entre medio centavo y siete centavos por tarea de Index de AA dependiendo enteramente de un parámetro de solicitud. El valor por defecto es medium ($0.02, Index 29). La inteligencia del titular (Index 37) solo existe en max ($0.07). Si copias los números de benchmark del proveedor a un caso de negocio, presupuesta el nivel al que corrió el benchmark.
El esfuerzo low es más barato que no razonar. Con $0.0045,
lowsupera anonecon $0.01 en la carga de AA, porque las ejecuciones sin razonamiento emitieron más tokens de salida por tarea. "Apaga el pensamiento para ahorrar" no es automáticamente el ajuste más barato en este modelo — es una hipótesis a probar con tus propios traces.
Los propios números de lanzamiento de OpenAI apuntan en la misma dirección. En AutomationBench — una prueba de flujos de trabajo de negocio con 47 herramientas — GPT-6 Luna en esfuerzo high mejoró a su predecesor en 5.4 puntos porcentuales con un 58% menos de coste por tarea; en factualidad interna, "at higher effort levels it matches GPT-5.6 Sol at about a hundredth its cost". Léelos como afirmaciones condicionadas al esfuerzo: el nivel barato las alcanza cuando pagas el pensamiento.
Un usuario del día de lanzamiento describió así el efecto del dial en la forma de la salida: "5.6 Luna yapped a lot about unnecessary stuff, while 6 Luna is much more to the point… 6 Luna just gives you the solution and stops talking." La concisión forma parte de la historia del coste — pero los inspectores de AA también vincularon las regresiones de trabajo del conocimiento (secciones de rúbrica omitidas, entregables más finos) con la misma tacañería de tokens, así que trata la salida breve como un trade-off, no como una victoria gratuita. (comentario de r/codex)

Traduciendo la afirmación de "50% más barato"
La tarjeta de precios del anuncio muestra a Luna pasando de $0.20 → $0.10 en entrada y $1.20 → $0.50 en salida, ambas etiquetadas "50% cheaper". La aritmética de la salida es −58.3%; el encuadre de OpenAI cuenta escalones de precio en dólares enteros. Ninguna lectura es incorrecta, pero la base importa: esas cifras de GPT-5.6 eran a su vez tarifas promocionales, y VentureBeat recoge que un portavoz confirmó que los nuevos precios de GPT-6 Sol y Luna son permanentes, no promocionales. (anuncio; VentureBeat)
La medición independiente coincide en la dirección y añade la letra pequeña. Artificial Analysis midió a Luna (max) en $0.07 por tarea de Index frente a $0.18 de GPT-5.6 Luna (max) — un 60% menos — mientras el modelo nuevo usó más tokens de salida por tarea (51k frente a 41k). El recorte de precio llevó el ahorro; la eficiencia de tokens no. Los lectores que miraban los gráficos del lanzamiento captaron la misma forma: "it really looks like luna 6.0 is just as smart as luna 5.6 at less than half the cost." (hilo de benchmarks de r/codex)

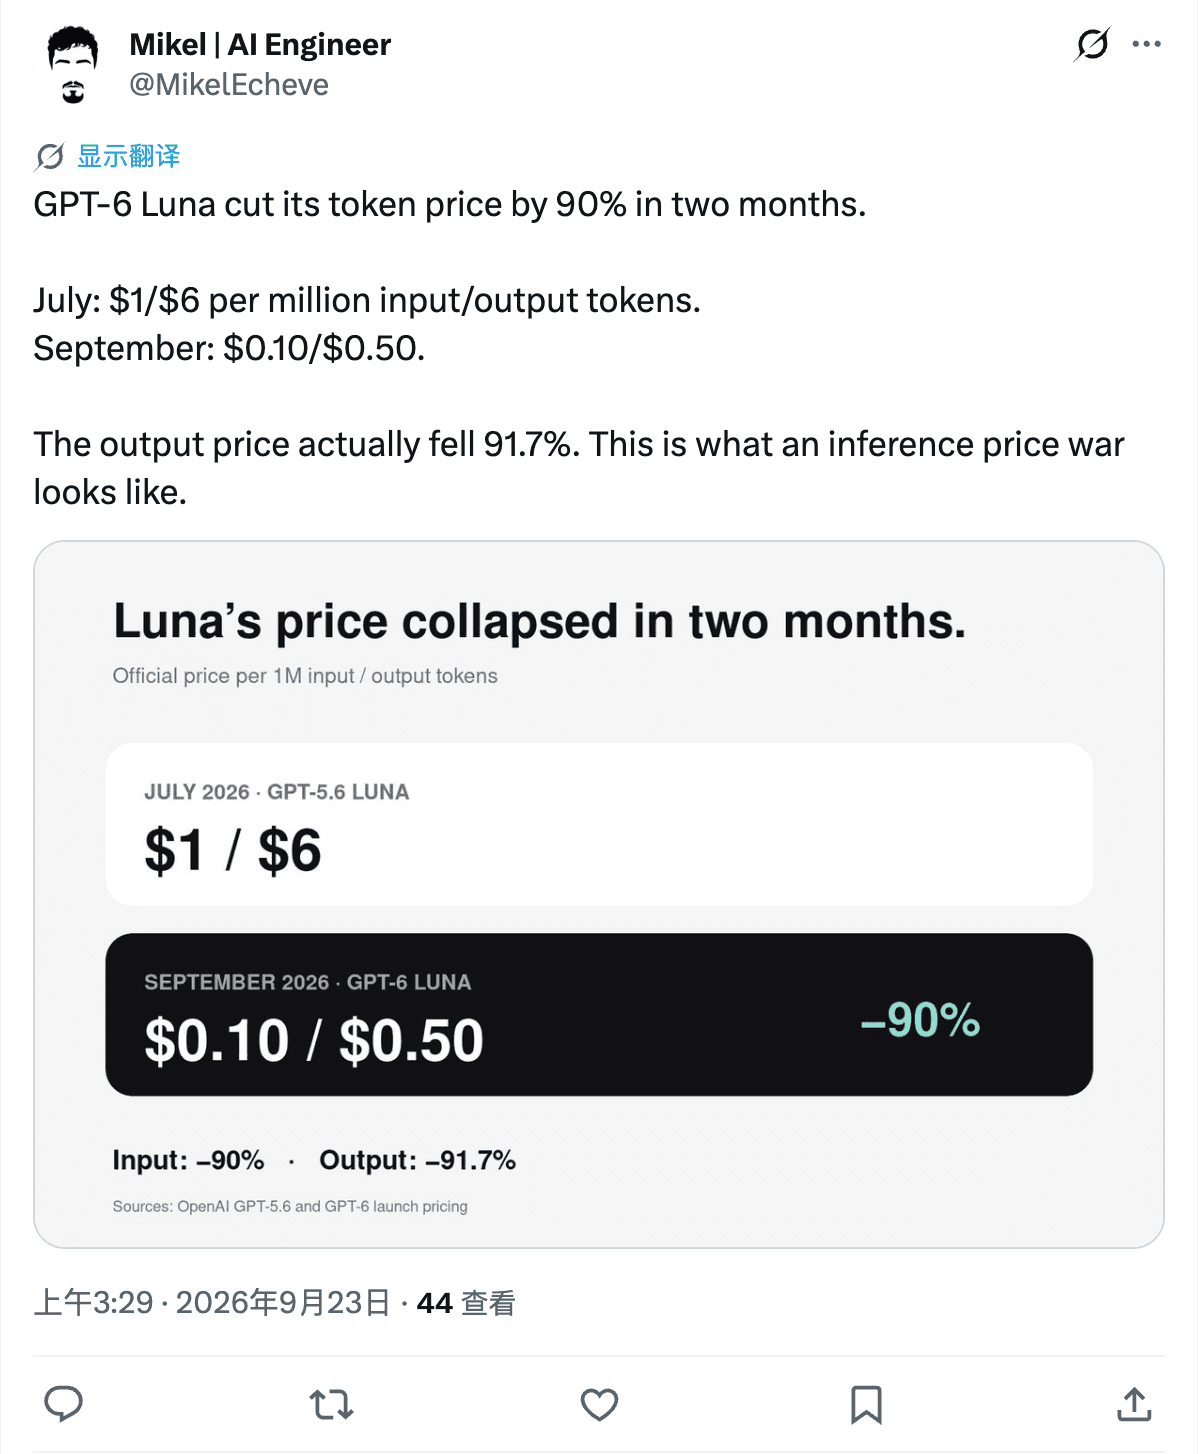
El encuadre más amplio que usaron algunos profesionales es el de guerra de precios. "GPT-6 Luna cut its token price by 90% in two months. July: $1/$6 per million input/output tokens. September: $0.10/$0.50… This is what an inference price war looks like", publicó un ingeniero de IA. La cifra de julio — la tarifa estándar anterior de GPT-5.6 Luna, antes de su propio recorte promocional — es una afirmación del autor y ya no puede verificarse en las páginas actuales de OpenAI, así que trátala como contexto de la comunidad, no como historial oficial de precios. (publicación en X)
Economía de la caché: lecturas de $0.01, escrituras de $0.125
Para los bucles de agente que reenvían el mismo contexto, las filas de caché importan más que las tarifas de cabecera. La entrada en caché de Luna es $0.01 por millón — una décima parte de la entrada nueva, el descuento máximo del 90% que OpenAI anuncia para la caché de GPT-6 — mientras que las escrituras en caché son $0.125, una prima del 25% sobre la tarifa de entrada. Siguen dos reglas contables: los volúmenes de escritura son una línea separada de las lecturas, y un token debe contarse una vez — como escritura cuando se almacena el prefijo, y a la tarifa de caché en los turnos que lo reutilizan dentro de la ventana de elegibilidad de 30 minutos que describe OpenAI. (entrada sobre caché; página de precios)
GPT-6 también cambió el comportamiento de la caché, no solo los precios: las tasas de acierto son más altas por defecto, y existen controles nuevos precisamente porque los agentes releen el contexto en cada turno — un panel de caché, diagnóstico de fallos de caché, breakpoints explícitos, precalentamiento, y la capacidad de cambiar el esfuerzo de razonamiento entre respuestas sin romper la caché (útil cuando quieres max en el turno difícil y low en el seguimiento rutinario). La entrada de OpenAI atribuye a GitHub una reducción de más del 50% en la proporción de tokens de prompt que requerían procesamiento nuevo a lo largo de miles de millones de solicitudes, y a un cliente un recorte de costes del 20% por unos pocos puntos extra de acierto.
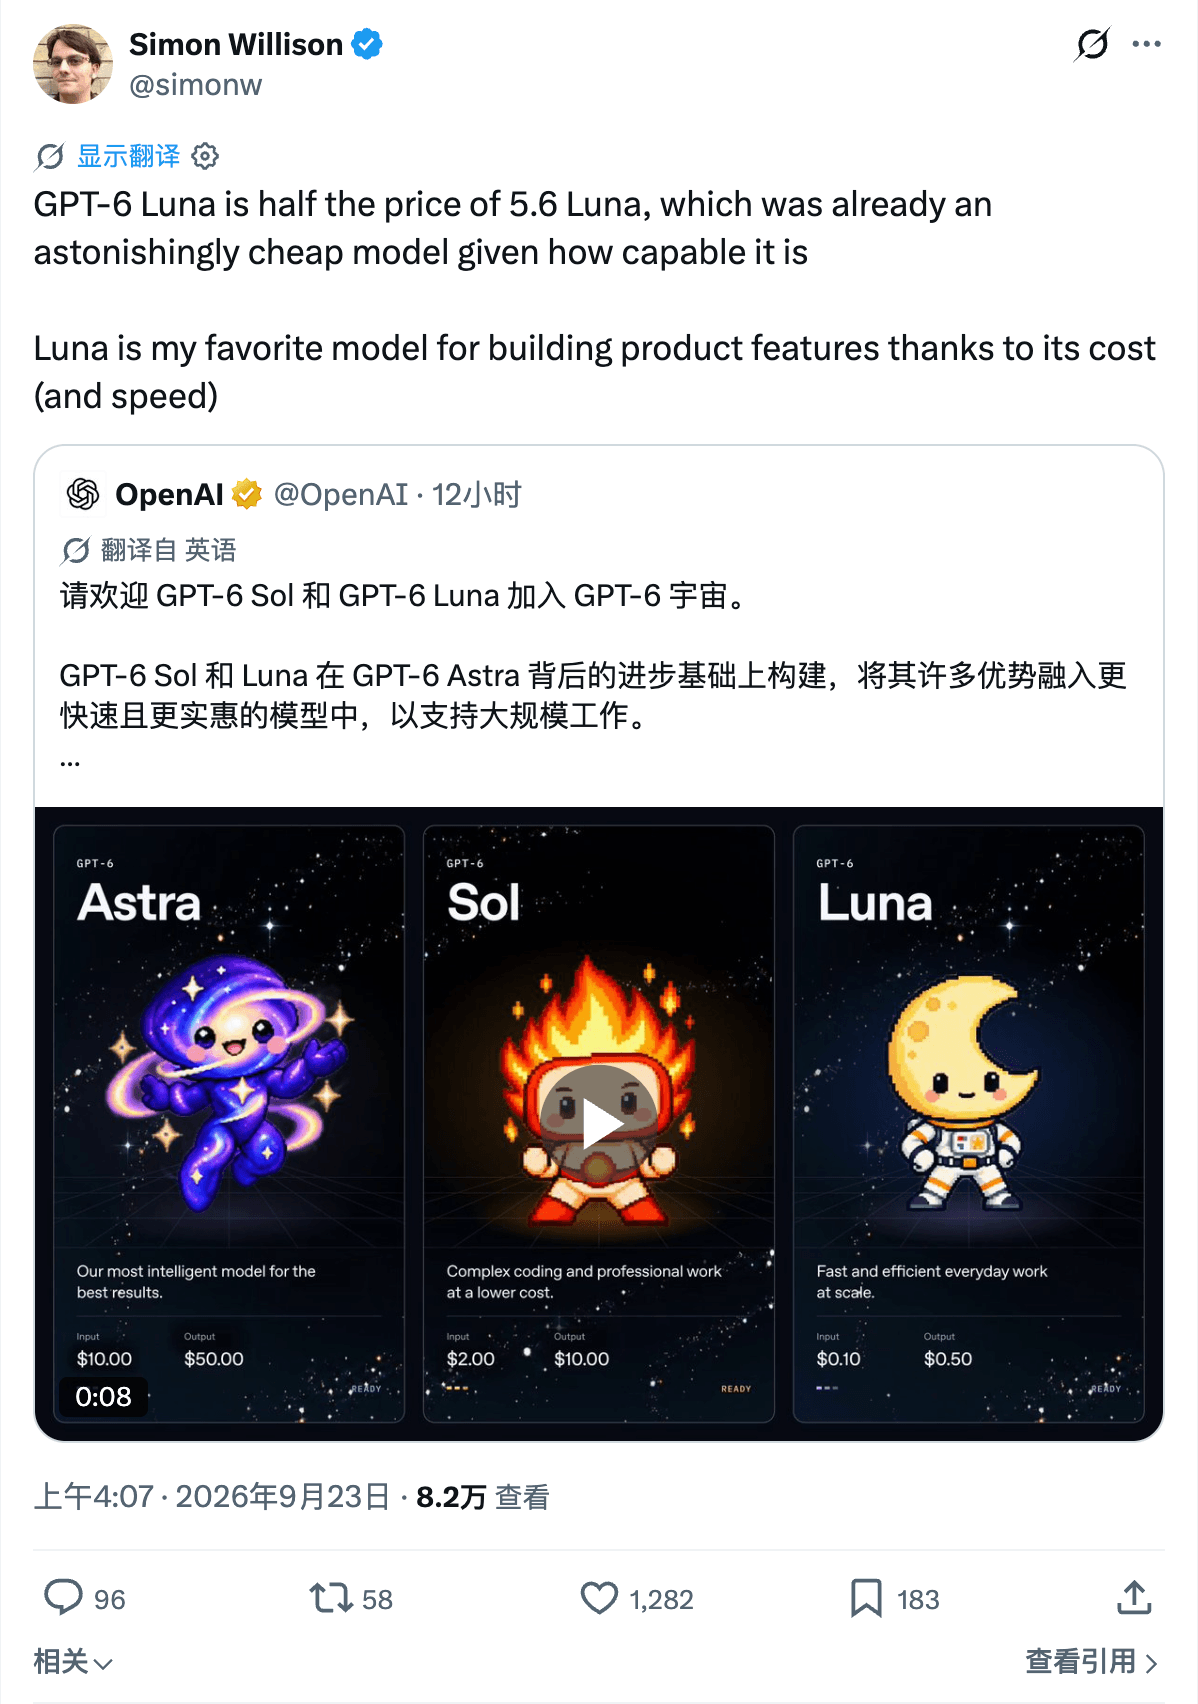
Los profesionales notaron la economía de inmediato. "Luna is my favorite model for building product features thanks to its cost (and speed)", escribió Simon Willison el día del lanzamiento — el patrón de enrutamiento que convierte las lecturas en caché de $0.01 y la generación de 141–175 t/s en la combinación de trabajo para superficies de producto. (publicación en X)
El acantilado de contexto largo de 272K
La frase de la página del modelo es corta: los prompts con más de 272K tokens de entrada se cobran a 2x en las tarifas de entrada y caché y 1.5x en la salida para toda la solicitud. Es un umbral a nivel de solicitud, no un recargo sobre los tokens excedidos. Un prompt de 273.000 tokens no paga tarifas de contexto corto en sus primeros 272K — cada categoría facturable, incluida la salida, usa la fila de contexto largo.
La ventana en sí es de 1.050.000 tokens con 128.000 de salida máxima. "Cabe en el contexto" y "mismo precio por token" son afirmaciones distintas. Si tus prompts rondan el umbral, deja margen: un documento añadido puede repreciar la solicitud entera. Es la misma estructura de acantilado que la de Sol — la guía de precios de GPT-6 Sol la desarrolla en detalle, y la misma disciplina se aplica aquí a un décimo de la escala.
Partidas más allá de la tarifa de cabecera
Batch y Flex parten la tarjeta por la mitad; Fast la duplica. OpenAI lista Batch y Flex al 50% de las tarifas Standard — la palanca plana más grande para trabajo tolerante a la latencia. El modo Fast (Priority fue renombrado a Fast el 30 de julio de 2026) es 2x. Verifica que tu endpoint realmente use el nivel antes de reservar cualquiera de los dos multiplicadores.
El procesamiento regional añade un 10%. Los endpoints elegibles de residencia de datos para modelos lanzados el 5 de marzo de 2026 o después llevan un recargo del 10%, y la residencia de datos en la UE de GPT-6 Luna solo está disponible con procesamiento Standard.
Los tokens de herramientas se facturan a tarifas del modelo. Los tokens consumidos por herramientas integradas se cobran a las tarifas de token del modelo elegido; algunas herramientas y sesiones alojadas llevan tarifas separadas. Los intentos fallidos que consumieron tokens también pertenecen al presupuesto.
Existe una variante "Pro" en los enrutadores. OpenRouter lista "GPT-6 Luna Pro" — el mismo modelo subyacente, "served with reasoning.mode set to pro for higher-quality responses on complex tasks" — al mismo precio base de $0.10/$0.50. Es una configuración de servicio del proveedor, no una fila adicional de la tarjeta de OpenAI; trátala como una opción de enrutamiento a evaluar, no como un modelo distinto. (OpenRouter)
Límites: el nivel gratuito está cerrado. La página del modelo marca gpt-6-luna como "no compatible" en Free, con acceso de pago desde el Tier 1 (500 RPM / 500K TPM / 5M de tokens de cola de Batch) hasta el Tier 5 (30.000 RPM / 180M TPM). Nótese que OpenAI publica límites de tokens por minuto más altos para Luna que para Sol en los mismos niveles de pago — el Tier 2 es 2M TPM para Luna frente a 1M para Sol — lo que se lee como una invitación a usar el modelo barato en volumen. (página del modelo)
| Nivel API | RPM | TPM | Límite de cola Batch |
|---|---|---|---|
| Free | No compatible | — | — |
| Tier 1 | 500 | 500.000 | 5M tokens |
| Tier 2 | 5.000 | 2.000.000 | 20M tokens |
| Tier 3 | 5.000 | 4.000.000 | 40M tokens |
Fuente: página del modelo gpt-6-luna de OpenAI, comprobada el 23 de septiembre de 2026.
La escalera familiar y el mercado abierto
Dentro de la escalera de OpenAI, la lógica de enrutamiento es directa: prueba Luna primero para pasos de gran volumen y alcance limitado; escala a Sol cuando un intento fallido sea caro; reserva Astra para el trabajo más difícil. El propio anuncio posiciona a Luna para "more tightly defined jobs such as summarization, extraction and answering straightforward questions".
El hallazgo contraintuitivo es que Luna no es la API capaz más barata del mercado abierto. La tabla comparativa del día de lanzamiento de VentureBeat lista el Muse Spark 1.2/1.3 Contributor de Meta en $0.10/$0.20 y el MiMo-V2.6-Flash de Xiaomi en $0.14/$0.28 — ambos con tasas combinadas de entrada+salida más bajas que los $0.60 de Luna — y el V4.1 Flash de DeepSeek en $0.15/$0.60 fuera de horas punta. Lo que Luna compra con su prima es el ecosistema de OpenAI: una ventana de 1.05M de tokens, la pila de herramientas y caché de GPT-6, y margen de niveles de esfuerzo desde tareas de $0.0045 hacia arriba. Si el único criterio es el precio mínimo, el mercado abierto la supera. (tabla de VentureBeat)
| Modelo económico | Entrada / Salida por 1M | Combinado | Restricción notable |
|---|---|---|---|
| Muse Spark 1.2/1.3 (Contributor) | $0.10 / $0.20 | $0.30 | Disponibilidad de nivel Contributor |
| MiMo-V2.6-Flash | $0.14 / $0.28 | $0.42 | Ecosistema más pequeño |
| GPT-6 Luna | $0.10 / $0.50 | $0.60 | Nivel gratuito de API cerrado; trade-offs de formato (ver reseña) |
| DeepSeek-V4.1-Flash (fuera de punta) | $0.15 / $0.60 | $0.75 | Tarifas punta al doble; solo texto |
La lectura de la comunidad sobre la trayectoria es expansiva: "I feel 2027 will be the year when intelligence will be economical enough to use at most of the places", predijo la respuesta más votada del hilo de lanzamiento en r/OpenAI. Dirección útil, invérificable como pronóstico. (hilo de r/OpenAI)
Lo que la tarjeta de tarifas no te dice
No es una calculadora de suscripción. Los planes de ChatGPT y Codex fijan sus propios límites de uso; un recorte del 50% en el precio del token no duplica matemáticamente la asignación de ningún plan. En el lanzamiento, GPT-6 Luna llegó a ChatGPT Work y Codex para usuarios Plus, Pro, Business, Enterprise y Edu, mientras que los planes Free y Go solo lo obtuvieron en la app de escritorio. La experiencia de suscripción sacó sus propias quejas: "it's faster on xhigh and my usage is barely going down", informó un usuario de Codex, y en un hilo de precios el resumen lacónico fue "Reduced pricing and reduced limits." La aritmética de la API y las cuotas del plan son compras distintas — consulta la página de uso en vivo de tu plan. (comentario de uso; hilo de precios)

Tampoco es un precio por tarea. AA midió a Luna usando un 24% más de tokens de salida por tarea de Index que su predecesor, y sus inspectores atribuyeron las regresiones de trabajo del conocimiento (~75 Elo en GDPval-AA, ~45 en AA-Briefcase) a la presentación omitida y a elementos de rúbrica. Una tarea que Luna falla o trunca se reintenta — en un modelo más caro si escalas — y los reintentos se facturan. La reseña de GPT-6 Luna cubre la evidencia de calidad; la consecuencia presupuestaria es que la métrica a seguir es el coste por tarea exitosa, no el coste por token: el gasto total incluyendo fallos, dividido por las tareas que realmente entregaste.
Una opción práctica: Tabbit Browser
Si la cuestión del presupuesto está resuelta y la siguiente es dónde ejecutar Luna sobre trabajo real — páginas abiertas, archivos, tareas de investigación —, Tabbit Browser es una respuesta que no requiere cablear una integración de API. Su selector de modelos te permite elegir modelos como GPT-6 Luna junto a tus pestañas abiertas, y el centro del modelo GPT-6 Luna (English) reúne las referencias del lado del navegador: notas de prompts (English) para solicitudes con forma de tarea y notas de reseñas (English) sobre lo que reportaron los usuarios.
El límite honesto: Tabbit es un cliente. No cambia las tarifas de OpenAI, y una estimación de tokens de API en esta página no predice el uso de ninguna suscripción o cliente. La disponibilidad del modelo depende del selector en vivo de tu cuenta y edición. Este artículo no tiene una factura medida de Tabbit, una tasa de éxito de tareas ni un resultado de latencia para Luna — si necesitas esos números, ejecuta tu propio conjunto fijo de tareas y guarda los recibos.
 Tabbit Browser
Para el contexto del flujo de trabajo — por qué un navegador de IA o un navegador agéntico cambia dónde es útil un modelo trabajador barato — esas guías cubren el lado del cliente; la tarjeta de tarifas de arriba sigue siendo la fuente para la facturación de tokens.
Dos ejemplos de presupuesto
Los ejemplos usan tarifas Standard de contexto corto, sin recargo regional, tarifas de herramientas, reintentos ni impuestos. Son ilustraciones aritméticas, no cargas de trabajo medidas.
Solicitud corta. 10.000 tokens de entrada sin caché y 2.000 tokens de salida:
(10.000 × $0.10 + 2.000 × $0.50) / 1.000.000 = $0.002Bucle de agente caliente. Una ejecución de 40 turnos que reenvía un prompt de 250.000 tokens en cada turno, con el 90% servido desde caché (escrito una vez, reutilizado dentro de la ventana de 30 minutos) y 3.000 tokens de salida por turno. Por turno:
(225.000 × $0.01 + 25.000 × $0.10 + 3.000 × $0.50) / 1.000.000 = $0.00625 por turno...más la escritura única del prefijo almacenado de 225K tokens a $0.125 por millón (unos $0.03). En 40 turnos, el bucle con caché factura unos $0.28, donde releer el mismo prompt sin caché en cada turno costaría unos $1.06 — casi una diferencia de 4x con precios de token idénticos, decidida enteramente por la proporción de aciertos de caché. A la escala de Luna ambos son céntimos; multiplícalo por un millón de turnos mensuales y el patrón con caché factura unos $7.000 (escrituras incluidas) frente a unos $26.500 en frío. Esa es la forma de carga de trabajo donde la fila de entrada en caché de $0.01 de Luna, no su precio de cabecera, es la verdadera noticia.
Para planificar: estimación mensual = coste medio por tarea × tareas mensuales; coste por tarea exitosa = gasto total incluidos los intentos fallidos ÷ tareas exitosas. Las cuotas de suscripción y cualquier tarifa del cliente no pueden derivarse de estas fórmulas.
Calculadora local
Estima el coste de la API de GPT-6 Luna
Tarifas oficiales en USD verificadas el 23-09-2026. Los valores permanecen en este navegador.
No incluye herramientas, reintentos, impuestos ni procesamiento regional. Las escrituras y lecturas de caché se cobran por separado. Ver tarifas actuales
La calculadora corre en tu navegador y no envía nada a ninguna parte. Estima los cargos de tokens a partir de tu volumen de entrada, proporción de caché, escrituras de caché, salida, número de ejecuciones y nivel de servicio; cambia a tarifas de contexto largo por encima de 272K de entrada. No incluye procesamiento regional, tarifas de herramientas, impuestos, márgenes de proveedores, reintentos ni límites de suscripción.
Precios de GPT-6 Luna: ¿qué opción deberías elegir?
| Si tu prioridad es… | Empieza con… | Ten en cuenta en la estimación |
|---|---|---|
| Máximo volumen, tareas de alcance limitado | Luna en esfuerzo low o medium | La horquilla de 15x entre niveles, el crecimiento de tokens de salida, los reintentos |
| Razonamiento profundo pero barato en pasos difíciles | Luna en high/xhigh, con el prefijo en caché | Ventana de 30 minutos; cambiar esfuerzo conserva la caché |
| Pipelines por lotes o sin conexión | Batch o Flex si son elegibles | Tarifa del 50% del nivel; restricciones de cola y latencia |
| Prompts cerca de 272K | Recortar contexto o presupuestar la fila larga | Reprecio de toda la solicitud sobre el umbral |
| Latencia interactiva | Esfuerzo low o none; Fast solo si hace falta | Fast duplica las tarifas; el TTFT varía por nivel |
| Uso consumidor de ChatGPT/Codex | Los límites propios del plan correspondiente | Las cuotas del plan no son aritmética de tokens de API |
Veredicto
La tarjeta de tarifas de GPT-6 Luna es la más barata a la que OpenAI ha vendido un modelo de clase GPT-6: $0.10/$0.50 por millón, permanente según el portavoz de la empresa, con la entrada en caché a una décima parte. El presupuesto honesto trata la etiqueta como el suelo, no como la factura. Solo el dial de esfuerzo mueve el coste medido por tarea 15x entre low y max; el volumen de salida creció frente al predecesor; el acantilado de 272K reprecia solicitudes enteras; y las regresiones de calidad se convierten en costes de reintento justo en las cargas donde celebrarías el precio. Ajusta el esfuerzo deliberadamente, usa la caché agresivamente, vigila el coste por tarea exitosa — y compara suscripciones por sus asignaciones publicadas, nunca por aritmética de tokens.
Las reacciones del día de lanzamiento son direccionales, no definitivas: entusiasmo por la "inteligencia demasiado barata para medir", cautela porque "the consequence of its work will not be seen or measured… until a few days". La página de precios de OpenAI es la fuente en vivo; revísala antes de comprometer un presupuesto.
Fuentes
Precios de la API de OpenAI — filas de Luna, Sol, Astra y GPT-5.6 Sol; notas regionales y de Fast; comprobado el 23 de septiembre de 2026.
Página del modelo gpt-6-luna de OpenAI — contexto, salida, valores de esfuerzo, cláusula 272K, límites; comprobada el 23 de septiembre de 2026.
OpenAI: Introducing GPT-6 Sol and Luna — tarjeta de cambios de precio, afirmaciones de AutomationBench y factualidad, disponibilidad.
OpenAI: Better prompt caching for GPT-6 — descuento del 90%, ventana de 30 minutos, controles de caché, resultados de GitHub y clientes.
Artificial Analysis: panel de lanzamiento de GPT-6 Luna — instantánea de Index, coste por tarea y velocidad por niveles, 23 de septiembre de 2026.
Artificial Analysis: GPT-6 Sol and Luna push the cost efficiency frontier — coste por tarea de $0.18 → $0.07, crecimiento de tokens de salida, atribuciones de regresión.
VentureBeat: OpenAI releases GPT-6 Sol and Luna — confirmación de permanencia; tabla de precios entre proveedores, 22 de septiembre de 2026.
OpenRouter: GPT-6 Luna y GPT-6 Luna Pro (batch) — listados de proveedores y la variante de servicio Luna Pro, 23 de septiembre de 2026.
Registros de la comunidad con capturas y condiciones en el texto: r/codex 1wngvak, r/codex 1wnhyh0, r/codex 1wnmhnq, r/codex 1wnhuru, r/OpenAI 1wnh4gr, X: Simon Willison, X: Mikel Echeve.

Preguntas frecuentes
¿Cuánto cuesta GPT-6 Luna por millón de tokens?
Las tarifas API estándar de contexto corto de OpenAI son $0.10 por millón de tokens de entrada, $0.01 por millón de entrada en caché, $0.125 por millón de escrituras en caché y $0.50 por millón de tokens de salida. Por encima de 272.000 tokens de entrada, toda la solicitud usa las tarifas de contexto largo: $0.20, $0.02, $0.25 y $0.75 respectivamente.
¿El precio de la API de GPT-6 Luna es permanente o promocional?
El anuncio de lanzamiento presenta las nuevas tarifas como un 50% por debajo de los precios promocionales de GPT-5.6, y un portavoz de la empresa dijo a VentureBeat que las tarifas de GPT-6 Sol y Luna son precios permanentes, no promocionales ni de introducción. La tarifa de comparación de GPT-5.6 Sol sigue etiquetada como promocional al menos hasta el 21 de noviembre de 2026.
¿Cuál es la forma más barata de ejecutar GPT-6 Luna?
Tres palancas dominan la factura: el nivel de razonamiento, la caché y el nivel de servicio. Artificial Analysis mide la misma tarjeta entre $0.0045 por tarea de Index en esfuerzo low y $0.07 en max, la lectura de caché cuesta una décima parte de la entrada nueva, y Batch o Flex figuran al 50% de las tarifas Standard para trabajos que toleran sus tiempos.
¿GPT-6 Luna tiene precios de contexto largo?
Sí. Los prompts con más de 272.000 tokens de entrada se cobran a 2x en las tarifas de entrada y caché y 1.5x en la de salida para toda la solicitud, no solo para los tokens que exceden el umbral. La ventana de contexto es de 1.050.000 tokens, por lo que caber en el contexto no significa pagar la tarifa de contexto corto.
¿El precio de la API de GPT-6 Luna equivale al uso de ChatGPT o Codex?
No. La API factura tokens; los planes de ChatGPT y Codex definen sus propios límites de uso. En el lanzamiento, GPT-6 Luna estaba disponible en ChatGPT Work y Codex para usuarios Plus, Pro, Business, Enterprise y Edu, mientras que los planes Free y Go solo podían usarlo en la app de escritorio. Una tarifa más barata por token no implica automáticamente más uso de la suscripción.
¿Puedo usar GPT-6 Luna en el nivel gratuito de la API?
No. La tabla de límites de la página del modelo marca gpt-6-luna como "no compatible" en el nivel Free, con acceso de pago desde el Tier 1 (500 solicitudes por minuto, 500.000 tokens por minuto). OpenAI también publica límites de tokens por minuto más altos para Luna que para Sol en los mismos niveles de pago.