
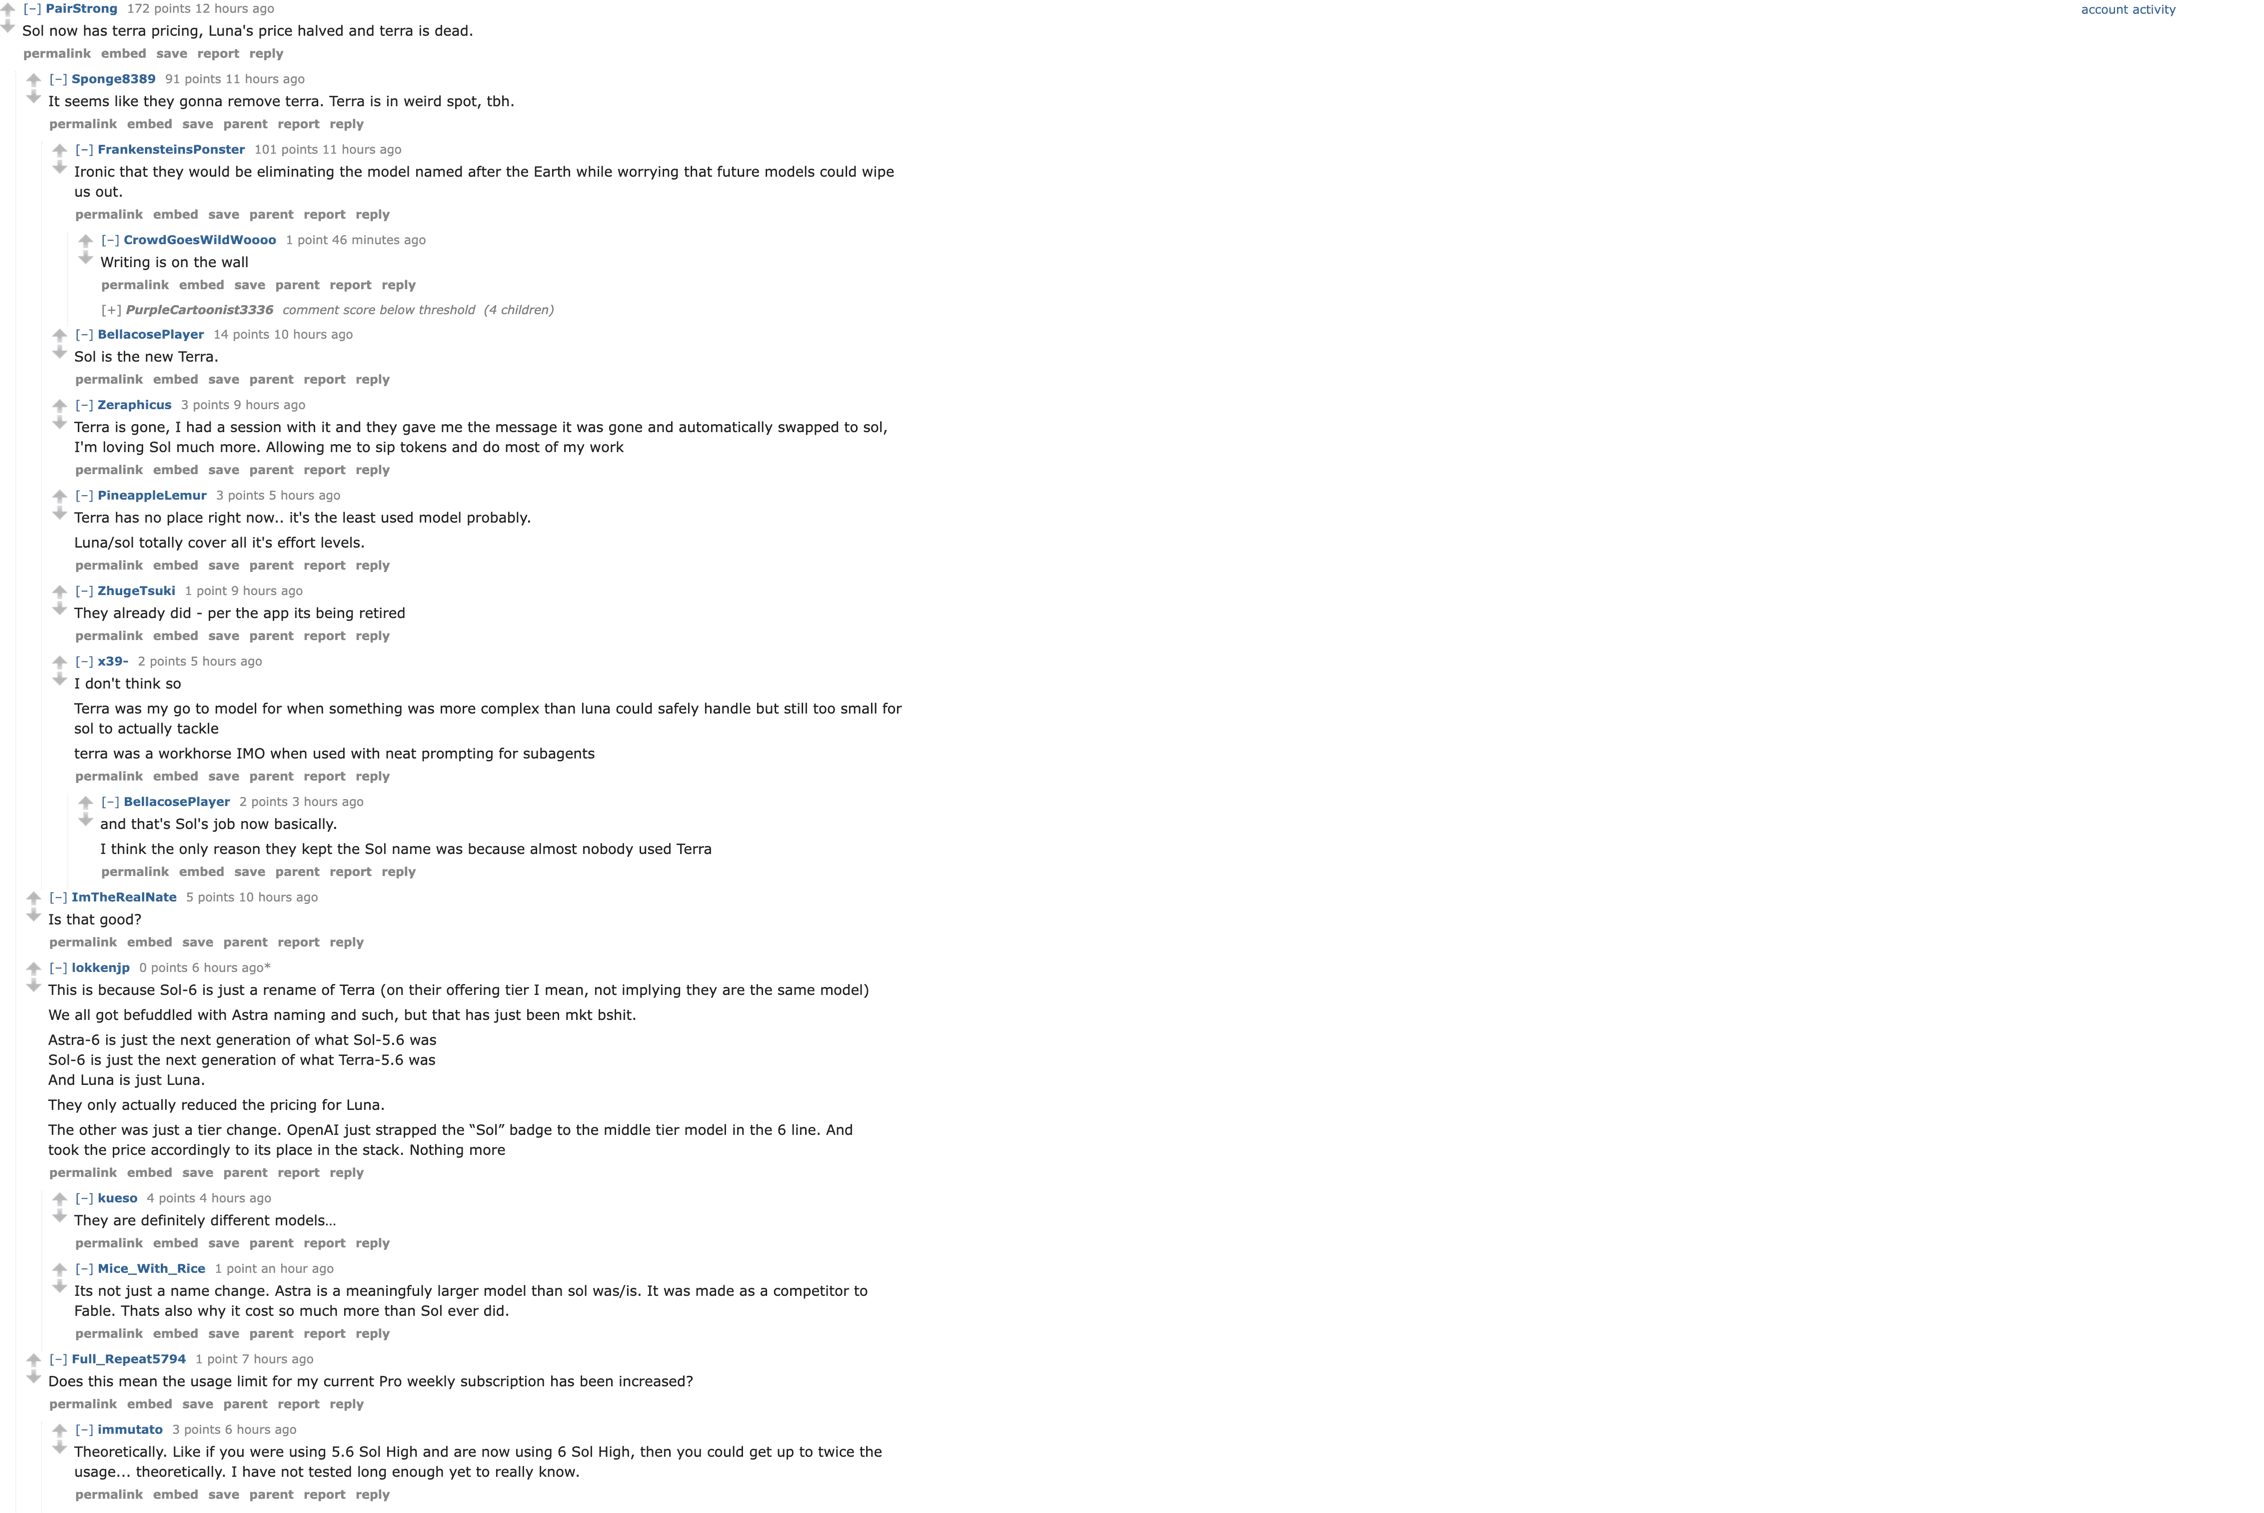
GPT-6 Luna 在 OpenAI 标准 API 费率卡上的价格是输入每百万 token $0.10、输出 $0.50,2026 年 9 月 23 日核对。缓存输入 $0.01,缓存写入 $0.125,输入超过 272K 的请求整笔转入长上下文费率。发布当天 r/codex 的一条评论一句话读完了这张卡:"Sol now has terra pricing, Luna's price halved and terra is dead."——对照发布公告里 GPT-5.6 Luna 的 $0.20/$1.20,输入降了 50%,输出降了 58%。(r/codex 讨论,OpenAI 价格表)
但标价是这张卡上最不重要的数字。在 $0.10/$0.50 的价位上,费率本身几乎不会出现在账单显著位置——真正决定账单的是你跑哪个推理档位(相同 token 单价下实测相差 15 倍)、缓存命中率,以及提示词是否越过 272K。本文把 API 费率与 ChatGPT/Codex 订阅分开讲,给出带来源和核对日期的完整费率表,并以可复算的预算算例和浏览器本地计算器收尾。如果你算完账的下一步是让 Luna 真正跑在网页和文件上,Tabbit Browser 是一个客户端选项;它不改变 OpenAI 的计费。
要点速览
标准短上下文 GPT-6 Luna:输入 $0.10、缓存输入 $0.01、缓存写入 $0.125、输出 $0.50(每百万 token);OpenAI 发言人已向 VentureBeat 确认这是永久价格,不是促销。
effort 旋钮主导账单:Artificial Analysis 实测同一张卡在每个 Index 任务 $0.0045(low)到 $0.07(max)之间——15 倍——而 API 默认档是 medium,不是 max。
输入超过 272K token 后,请求内每个 token 都按长上下文费率计(每百万 $0.20 / $0.02 / $0.25 / $0.75)。
Batch 和 Flex 标价为标准费率五折;Fast 为 2 倍;符合条件的区域处理加收 10%,Luna 的 EU 数据驻留仅支持 Standard。
token 单价既不是订阅配额也不是任务单价:输出量(AA Index 任务上比上一代多 24%)、重试和质量回退都会重新进入预算。
GPT-6 Luna API 费率总览
以下价格均为每百万 token 美元数,来自 OpenAI 价格页与 gpt-6-luna 模型页,核对日期 2026 年 9 月 23 日。长上下文行在输入超过 272,000 token 时生效。
| GPT-6 Luna 服务档位 | 上下文 | 输入 | 缓存输入 | 缓存写入 | 输出 |
|---|---|---|---|---|---|
| Standard | 输入 ≤272K | $0.10 | $0.01 | $0.125 | $0.50 |
| Standard | 输入 >272K | $0.20 | $0.02 | $0.25 | $0.75 |
| Batch / Flex | 输入 ≤272K | $0.05 | $0.005 | $0.0625 | $0.25 |
| Batch / Flex | 输入 >272K | $0.10 | $0.01 | $0.125 | $0.375 |
| Fast | 输入 ≤272K | $0.20 | $0.02 | $0.25 | $1.00 |
| Fast | 输入 >272K | $0.40 | $0.04 | $0.50 | $1.50 |
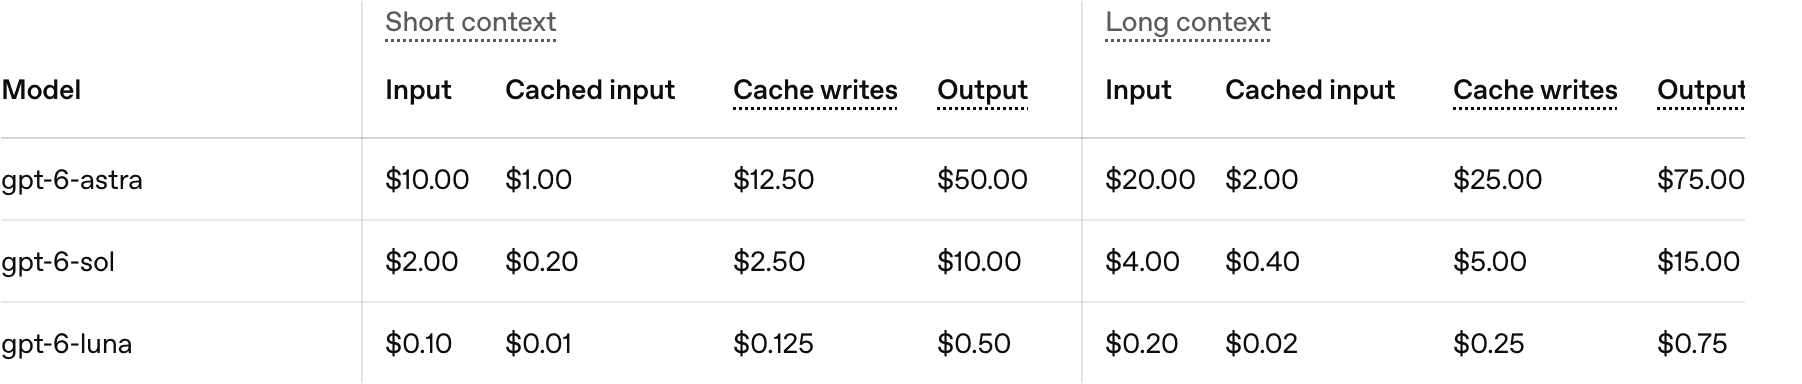
这张费率卡嵌在家族阶梯里。以下是同一张表中的标准短上下文费率:
| 模型 | 输入 | 缓存输入 | 缓存写入 | 输出 | 这一行的用途 |
|---|---|---|---|---|---|
| GPT-6 Luna | $0.10 | $0.01 | $0.125 | $0.50 | 高频、边界清晰的批量任务——发布公告自己的定位 |
| GPT-6 Sol | $2.00 | $0.20 | $2.50 | $10.00 | 反复出现的复杂编码与 agent 工作负载 |
| GPT-6 Astra | $10.00 | $1.00 | $12.50 | $50.00 | 最难任务的旗舰档 |
| GPT-5.6 Sol(上一代,促销价) | $4.00 | $0.40 | $5.00 | $20.00 | OpenAI 仍列出的对照基准,促销至少持续至 11 月 21 日 |
Luna 的输入输出价格是 Sol 的二十分之一、Astra 的百分之一。兄弟档位的经济账见 GPT-6 Sol 定价拆解与 GPT-6 Astra 定价拆解;便宜档实际买到什么能力、在哪里回退,见 GPT-6 Luna 测评。上一代的价格史见 GPT-5.6 Sol 成本指南。
决定账单的那个数字:effort 旋钮
gpt-6-luna 接受 none、low、medium(默认)、high、xhigh、max 六档 reasoning_effort。档位之间 token 单价不变——变的是推理与输出 token 的数量。Artificial Analysis 把 Luna 按六档分别追踪,2026 年 9 月 23 日快照的实测经济数据如下:
| 推理档位 | Intelligence Index | 每个 AA Index 任务成本 | 输出速度 |
|---|---|---|---|
| low | 21 | $0.0045 | 175 t/s |
Non-reasoning(none) | 18 | $0.01 | 141 t/s |
| medium(默认) | 29 | $0.02 | 143 t/s |
| high | 32 | $0.03 | 149 t/s |
| xhigh | 34 | $0.04 | 153 t/s |
| max | 37 | $0.07 | 157 t/s |
表里有两个比费率更要紧的细节:
档位间相差 15 倍。看起来是"$0.10/$0.50"的卡,按请求参数不同,每个 AA Index 任务实际计费从不到半美分到 7 美分。默认档是 medium($0.02,Index 29);宣传里的智能水平(Index 37)只在 max($0.07)存在。把厂商基准分抄进商业方案时,请按跑基准的档位做预算。
low 档比关掉推理还便宜。在 AA 的工作负载上,$0.0045 的
low低于 $0.01 的none,因为 non-reasoning 每任务输出了更多 token。"关掉思考省钱"在这个模型上不自动成立——它是需要在自己的任务轨迹上验证的假设。
OpenAI 自己的发布数字指向同一方向:在覆盖 47 个工具的 AutomationBench 上,GPT-6 Luna high 档以每任务成本低 58% 的条件比上一代提升 5.4 个百分点;内部事实性评测中"更高档位下以约百分之一的成本追平 GPT-5.6 Sol"。把这些读成带档位条件的主张:便宜的价格是在你为思考付费时达到的。
一位发布日用户这样描述档位对输出形态的实际影响:"5.6 Luna yapped a lot about unnecessary stuff, while 6 Luna is much more to the point… 6 Luna just gives you the solution and stops talking."简洁本身就是成本故事的一部分——但 AA 的检查者也把知识工作回退(跳过评分细则、交付物变薄)归因于同一种 token 吝啬,所以把"话少"当作权衡而非纯赚。(r/codex 评论)

翻译"便宜 50%"的官方口径
发布公告的价格卡显示 Luna 从 $0.20 → $0.10(输入)、$1.20 → $0.50(输出),两行都标注"50% cheaper"。输出的算术值是 −58.3%;OpenAI 的口径按整美元价格档位计数。两种读法都不算错,但基准很重要:那些 GPT-5.6 数字本身就是促销价,而 VentureBeat 报道发言人确认新的 GPT-6 Sol 和 Luna 价格是永久的,非促销。(发布公告,VentureBeat)
独立测量同意方向,并补上了小字。Artificial Analysis 实测 Luna(max)每个 Index 任务 $0.07,对比 GPT-5.6 Luna(max)的 $0.18——约低 60%——而新模型每任务用了更多输出 token(51k 对 41k)。降价靠的是价格,不是 token 效率。看发布图的读者也读出了同样的形状:"it really looks like luna 6.0 is just as smart as luna 5.6 at less than half the cost."(luna 6.0 看起来和 5.6 一样聪明,成本不到一半)(r/codex 基准讨论帖)

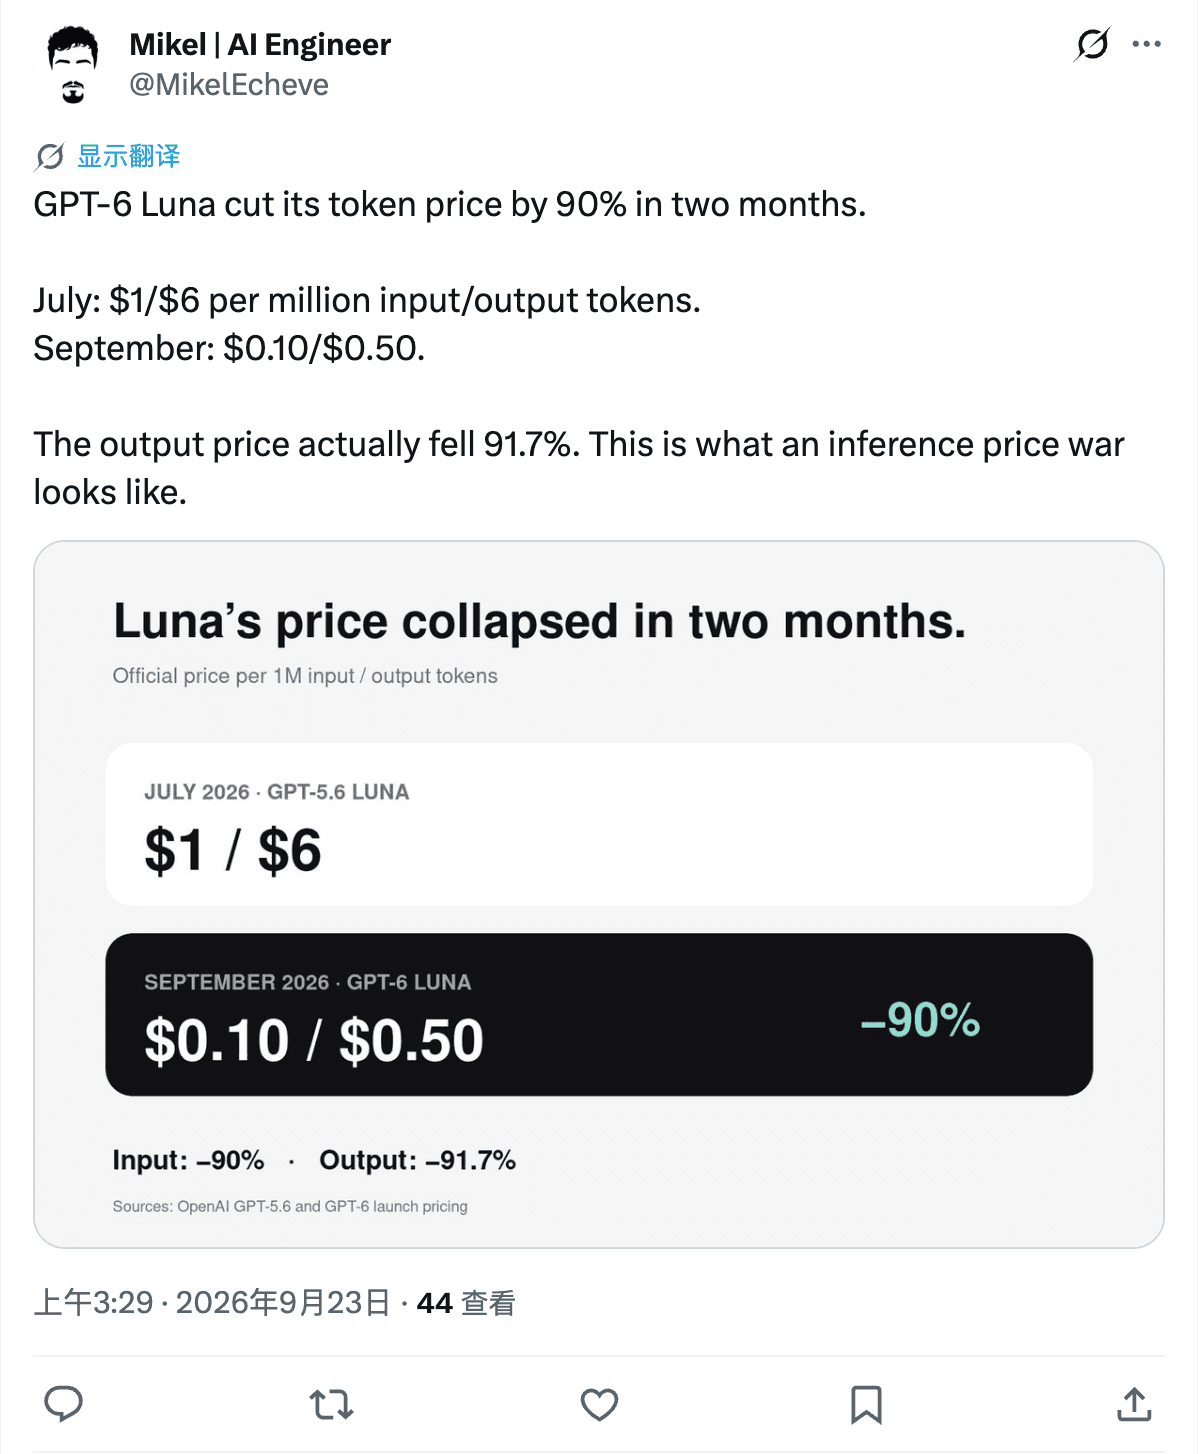
一些从业者用了更大的框架:价格战。"GPT-6 Luna cut its token price by 90% in two months. July: $1/$6… September: $0.10/$0.50… This is what an inference price war looks like."(两个月降 90%:7 月 $1/$6,9 月 $0.10/$0.50——这就是推理价格战的样子。)其中 7 月数字——GPT-5.6 Luna 更早的标准价、在其自身促销之前——是发帖者的说法,已无法在 OpenAI 当前页面上核实,请把它当作社区语境而非官方价格史。(X 帖子)
缓存经济学:$0.01 的读与 $0.125 的写
对反复重发同一上下文的 agent 循环,缓存行比标价更重要。Luna 的缓存输入是每百万 $0.01——全新输入的十分之一,即 OpenAI 为 GPT-6 缓存宣传的最高 90% 折扣——而缓存写入是$0.125,比输入费率高 25%。由此有两条记账规则:写入量与读取量是两行,不能混算;一个 token 只计一次——存前缀时算写入,在 OpenAI 描述的 30 分钟资格窗口内复用时按缓存价计。(缓存公告,价格页)
GPT-6 改变的不只是缓存价格,还有行为:默认命中率更高,并且正因为 agent 每轮重读上下文而新增了一批控制项——缓存仪表盘、缓存未命中诊断、显式断点、预热,以及在响应之间改推理档位而不破坏缓存(难的那轮开 max、例行跟进降 low 时很有用)。OpenAI 的公告提到 GitHub 在数十亿请求中把需要新处理的提示词 token 份额降低了 50% 以上,一位客户靠几个百分点的命中率提升省了 20%。
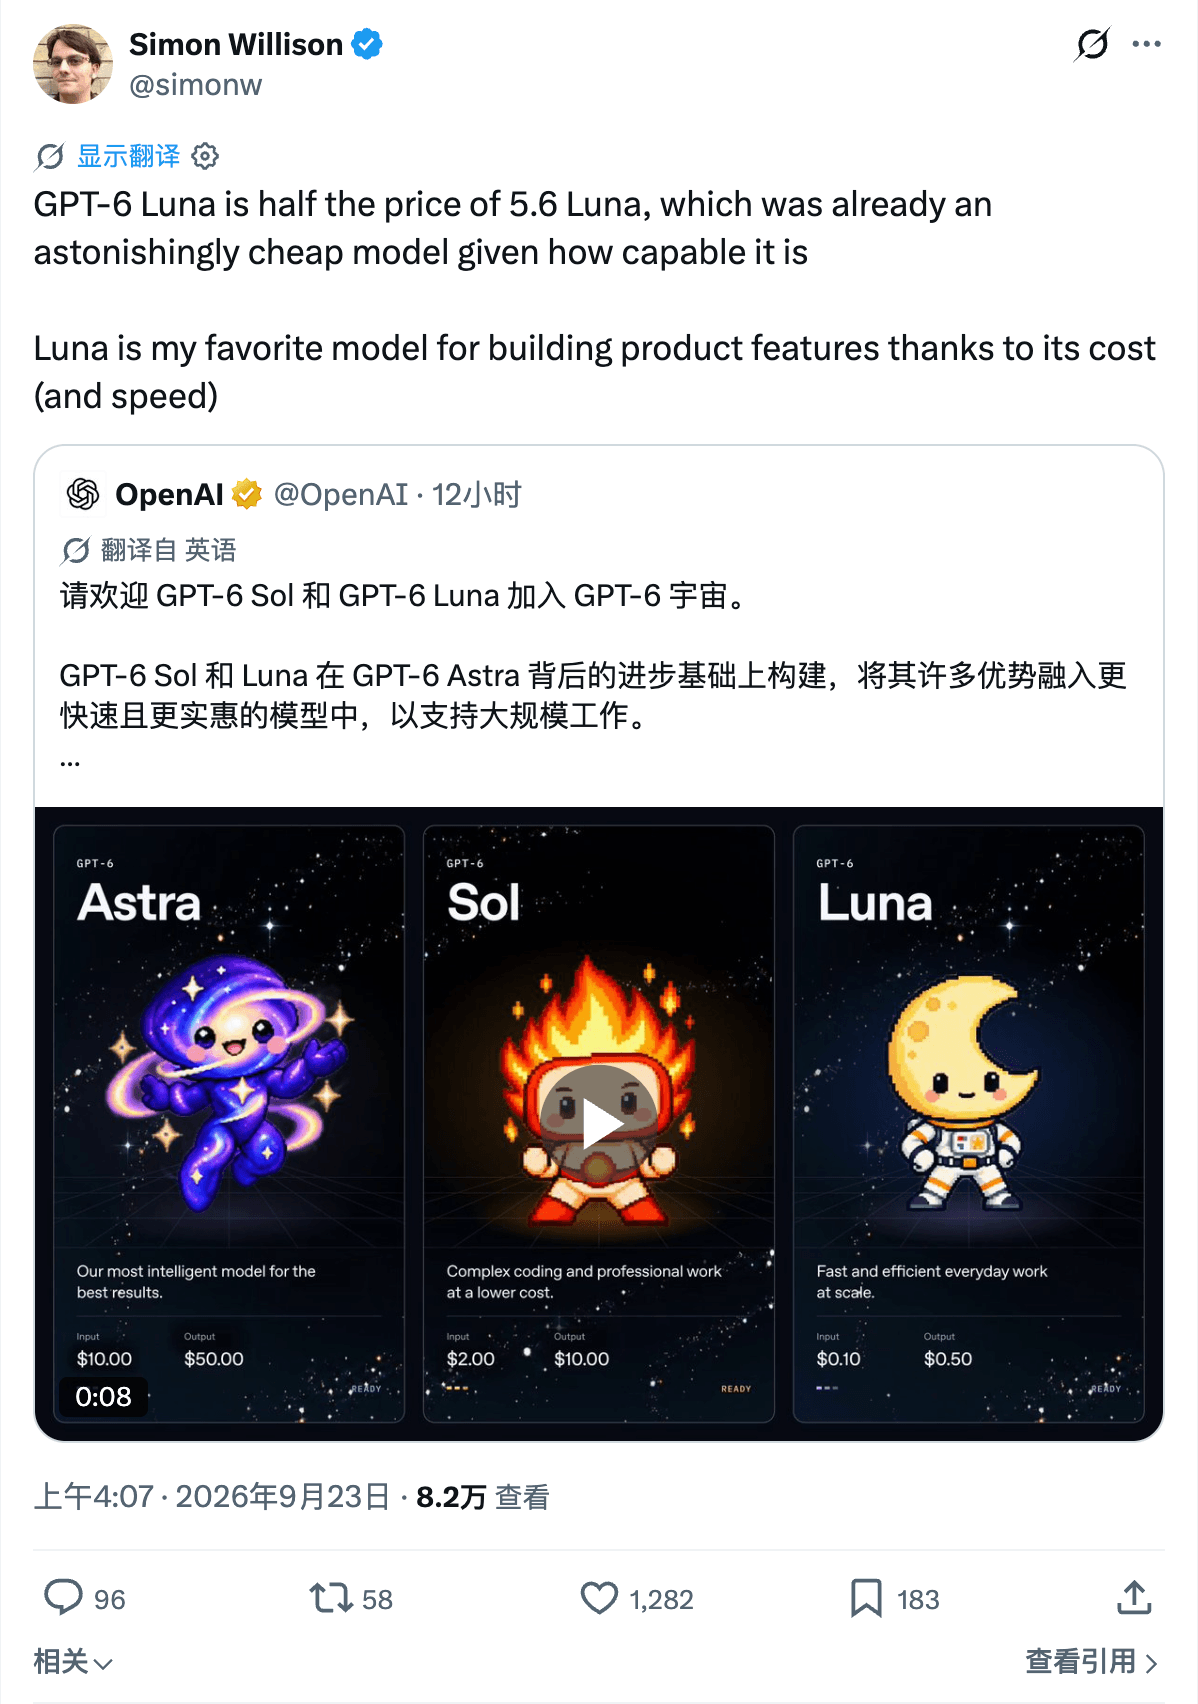
从业者立刻注意到了这套经济学。发布日 Simon Willison 写道:"Luna is my favorite model for building product features thanks to its cost (and speed)."(凭成本和速度,Luna 是我最喜欢用来做产品功能的模型)——这正是让 $0.01 缓存读取与 141–175 t/s 生成速度成为产品界面工作组合的路由模式。(X 帖子)
272K 长上下文悬崖
模型卡的句子很短:输入超过 272K token 的提示词按输入与缓存费率 2 倍、输出 1.5 倍对整笔请求计价。这是请求级阈值,不是对超出部分加价。273,000 token 的提示词不会让前 272K 享受短上下文档——包括输出在内的每个计费类目都用长上下文行。
窗口本身是 1,050,000 token,最大输出 128,000。"放得进上下文"和"每 token 同价"是两个命题。如果你的提示词在阈值附近徘徊,请留出余量:追加一份文档就可能让整笔请求重新计价。这与 Sol 的悬崖结构相同——GPT-6 Sol 定价指南有详细展开,同样的纪律在这里以十分之一的量级适用。
标价之外的计费线项
Batch 和 Flex 对半砍卡;Fast 翻倍。OpenAI 把 Batch 和 Flex 标为标准费率的 50%——对时延不敏感的工作这是最大的单一杠杆。Fast 模式(Priority 于 2026 年 7 月 30 日更名)是 2 倍。先把折扣或加价记入预算之前,确认你的端点真的在用对应档位。
区域处理加收 10%。2026 年 3 月 5 日及之后发布、符合数据驻留条件的端点加收 10%,且 Luna 的 EU 数据驻留仅支持 Standard 处理。
工具 token 按模型费率计。内置工具消耗的 token 按所选模型的 token 费率计费;部分工具和托管会话另有费用。消耗了 token 的失败尝试同样要进预算。
路由上存在"Pro"变体。OpenRouter 列出"GPT-6 Luna Pro"——同一个底层模型,"以 reasoning.mode 设为 pro 提供,在复杂任务上响应质量更高"——基础价同样是 $0.10/$0.50。这是提供方侧的serving配置,不是 OpenAI 费率卡的额外一行;把它当作待评估的路由选项,而不是另一个模型。(OpenRouter)
限流:免费层关闭。模型页把 gpt-6-luna 标为免费层"不支持",付费访问从 Tier 1(500 RPM / 500K TPM / 500 万 batch 队列 token)到 Tier 5(30,000 RPM / 1.8 亿 TPM)。值得注意的是,OpenAI 为 Luna 公布的同档付费层 token 限额高于 Sol——Tier 2 的 TPM 是 200 万对 Sol 的 100 万——读起来像是在邀请以量使用便宜模型。(模型页)
| API 层级 | RPM | TPM | Batch 队列上限 |
|---|---|---|---|
| Free | 不支持 | — | — |
| Tier 1 | 500 | 500,000 | 500 万 token |
| Tier 2 | 5,000 | 2,000,000 | 2,000 万 token |
| Tier 3 | 5,000 | 4,000,000 | 4,000 万 token |
来源:OpenAI gpt-6-luna 模型页,核对于 2026 年 9 月 23 日。
家族阶梯与开放市场
在 OpenAI 的阶梯内,路由逻辑很直白:边界清晰的高频步骤先试 Luna;失败代价高时升级 Sol;最难的工作留给 Astra。发布公告自己就把 Luna 定位在"总结、抽取和回答直接问题这类边界更窄的任务"。
反直觉的发现是:Luna 并不是开放市场上最便宜的可用 API。VentureBeat 的发布日对比表列出 Meta 的 Muse Spark 1.2/1.3 Contributor 为 $0.10/$0.20、小米的 MiMo-V2.6-Flash 为 $0.14/$0.28——输入输出合计都低于 Luna 的 $0.60——以及 DeepSeek V4.1 Flash 非高峰 $0.15/$0.60。Luna 的溢价买到的是 OpenAI 生态:1.05M token 窗口、GPT-6 的工具与缓存栈、以及从 $0.0045 任务向上的档位余量。如果唯一起作用的标准是地板价,开放市场能压过它。(VentureBeat 表格)
| 预算型模型 | 输入 / 输出(每百万) | 合计 | 主要限制 |
|---|---|---|---|
| Muse Spark 1.2/1.3(Contributor) | $0.10 / $0.20 | $0.30 | Contributor 档可用性 |
| MiMo-V2.6-Flash | $0.14 / $0.28 | $0.42 | 生态较小 |
| GPT-6 Luna | $0.10 / $0.50 | $0.60 | 免费 API 层关闭;格式权衡见测评 |
| DeepSeek-V4.1-Flash(非高峰) | $0.15 / $0.60 | $0.75 | 高峰费率翻倍;纯文本 |
社区对轨迹的读法很乐观:"I feel 2027 will be the year when intelligence will be economical enough to use at most of the places."(我觉得 2027 年会是智能便宜到大多数地方都用得起的一年)——r/OpenAI 发布帖最高赞回复的预测。方向有用,作为预言不可验证。(r/OpenAI 帖子)
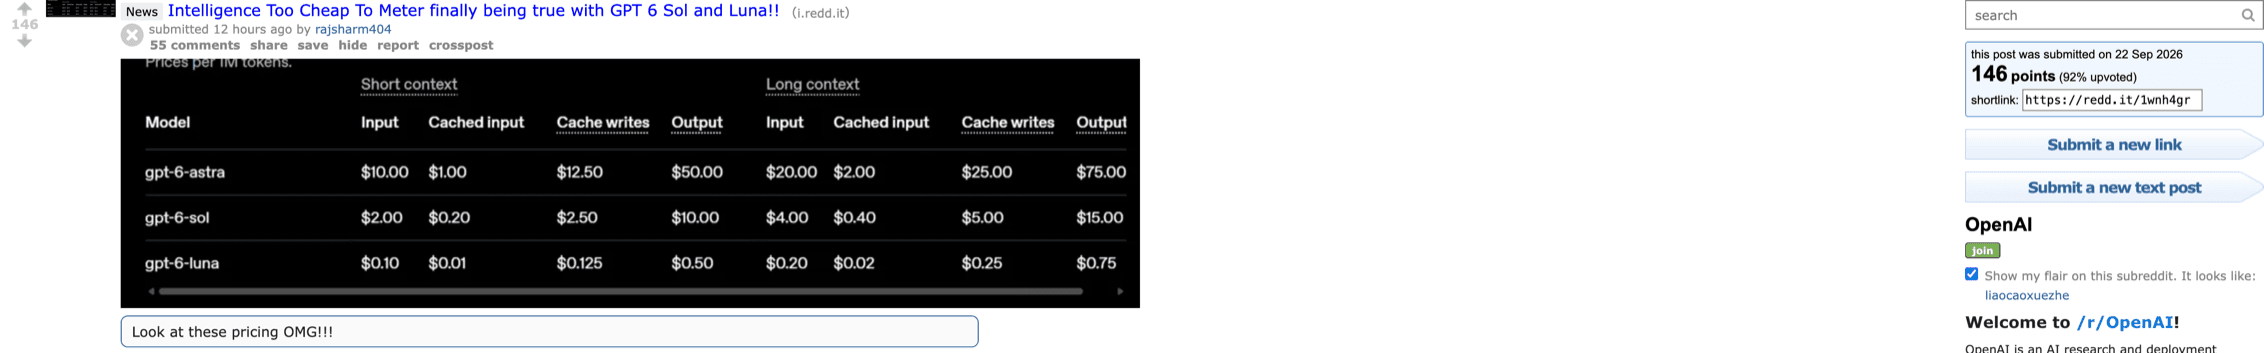
费率卡不会告诉你的事
它不是订阅计算器。ChatGPT 和 Codex 套餐有各自的使用上限;token 降价 50% 不会数学地把任何套餐的额度翻倍。发布时 GPT-6 Luna 面向 Plus、Pro、Business、Enterprise、Edu 用户的 ChatGPT Work 和 Codex 开放,Free 和 Go 只能在桌面应用里用。订阅侧的抱怨也浮出水面:"it's faster on xhigh and my usage is barely going down."(xhigh 更快了,但我的用量几乎没降)一位 Codex 用户报告;定价讨论帖里的简短总结是"Reduced pricing and reduced limits."(价格降了,限额也降了)API 算术和套餐配额是两种购买——查你套餐的实时用量页。(用量评论,定价讨论)

它也不是任务单价。AA 实测 Luna 每个 Index 任务的输出 token 比上一代多 24%,其检查者把知识工作回退(GDPval-AA 约 −75 Elo、AA-Briefcase 约 −45)归因于跳过展示格式和评分细则。一个被 Luna 失败或截断的任务会被重试——升级到更贵模型时更是如此——而重试要计费。质量证据见 GPT-6 Luna 测评;预算上的推论是:要追踪的是每个成功任务的成本,不是每 token 成本——含失败在内的总花费,除以真正交付的任务数。
一个实践选项:Tabbit Browser
如果预算问题已经解决,下一个问题是让 Luna 跑在真实工作——打开的网页、文件、调研任务——上,Tabbit Browser 是不需要自己接 API 的一个答案。它的模型选择器让你在打开的标签页旁边选用 GPT-6 Luna 这样的模型,GPT-6 Luna 模型中心整理了浏览器侧的参考资料:面向任务化请求的提示词笔记,以及用户报告的测评笔记。
诚实的边界:Tabbit 是客户端。它不改变 OpenAI 的费率,本页的 API token 估算也预测不了任何订阅或客户端的用量。模型可用性取决于你账户和版本的实时选择器。本文没有 Tabbit 侧的 Luna 实测账单、任务成功率或延迟结果——需要这些数字的话,跑你自己的固定任务集并留下记录。
 Tabbit Browser
至于工作流语境——为什么 AI 浏览器或智能体浏览器会改变便宜工作模型的用武之地——那两篇指南讲客户端这一侧;token 计费的权威来源仍是上面的费率卡。
两个预算算例
算例使用标准短上下文费率,不含区域加价、工具费、重试和税费。它们是算术演示,不是实测工作负载。
短请求。10,000 个未缓存输入 token、2,000 个输出 token:
(10,000 × $0.10 + 2,000 × $0.50) / 1,000,000 = $0.002预热的 agent 循环。一个 40 轮的运行,每轮重发 250,000 token 的提示词,其中 90% 由缓存提供(写入一次,在 30 分钟窗口内复用),每轮 3,000 个输出 token。每轮:
(225,000 × $0.01 + 25,000 × $0.10 + 3,000 × $0.50) / 1,000,000 = 每轮 $0.00625……再加上一次性写入 225K token 前缀的费用(每百万 $0.125,约 $0.03)。40 轮下来,缓存循环大约计费 $0.28;而每轮都全新重读同一提示词大约花 $1.06——相同 token 单价下接近 4 倍的差距,完全由缓存命中比例决定。在 Luna 的量级上两边都是几美分;换成每月一百万轮,缓存模式约 $7,000(含写入),冷读约 $26,500。这才是 Luna 那行 $0.01 缓存输入——而非标价——真正成为新闻的工作负载形态。
规划公式:月估算 = 单任务平均成本 × 月任务数;每成功任务成本 = 含失败尝试的总花费 ÷ 成功任务数。订阅配额和任何客户端费用都无法从这些公式推导。
本地计算器
估算 GPT-6 Luna API 成本
使用 2026-09-23 核对的官方美元费率。输入值仅在此浏览器处理。
不含工具、重试、税费和区域处理费用。缓存写入与缓存读取分开计费。 查看当前费率
计算器在你的浏览器里运行,不会向任何地方发送数据。它根据你输入的输入量、缓存命中比例、缓存写入、输出、运行次数和服务档估算 token 费用;输入超过 272K 时自动切换长上下文费率。它不包含区域处理、工具费、税费、提供方加价、重试或订阅限额。
GPT-6 Luna 定价:你该选哪种方式?
| 如果你的优先级是… | 从…开始 | 记入估算 |
|---|---|---|
| 最大量、边界清晰的任务 | Luna 的 low 或 medium 档 | 档位间 15 倍差、输出 token 增长、重试 |
| 便宜但深入的难步骤推理 | Luna 的 high/xhigh,前缀入缓存 | 30 分钟窗口;改档位不破坏缓存 |
| 离线或批处理流水线 | 符合条件时用 Batch 或 Flex | 五折档位费率;排队与时延约束 |
| 提示词接近 272K | 裁剪上下文或按长上下文行做预算 | 越过阈值后整笔请求重新计价 |
| 交互式时延 | low 档或 none;确需再用 Fast | Fast 费率翻倍;各档 TTFT 不同 |
| 消费端 ChatGPT/Codex | 对应套餐自身的限额 | 套餐配额不是 API token 算术 |
结论
GPT-6 Luna 的费率卡是 OpenAI 卖过的最便宜的 GPT-6 级模型:每百万 $0.10/$0.50,公司发言人称其为永久价格,缓存输入再降至十分之一。诚实的预算应把标价当地板而不是账单。仅 effort 旋钮就能让实测每任务成本在 low 与 max 之间相差 15 倍;输出量相对上一代增长;272K 悬崖会让整笔请求重新计价;质量回退会在你最想庆祝价格的工作负载上转化为重试成本。有意识地设置档位、积极地使用缓存、盯住每个成功任务的成本——订阅则按其公布的额度比较,永远不要用 token 算术。
发布日的反应是方向性的、未定型的:有"智能便宜到不计成本"的兴奋,也有"它的成果要过几天才能被看见和衡量"的谨慎。OpenAI 的价格页是实时来源;承诺预算前请再核对一次。
来源
OpenAI API 价格页——Luna、Sol、Astra 与 GPT-5.6 Sol 行;区域与 Fast 说明;核对于 2026 年 9 月 23 日。
OpenAI gpt-6-luna 模型页——上下文、输出、档位值、272K 条款、限流;核对于 2026 年 9 月 23 日。
OpenAI:Introducing GPT-6 Sol and Luna——价格变化卡、AutomationBench 与事实性主张、可用性。
OpenAI:Better prompt caching for GPT-6——90% 折扣、30 分钟窗口、缓存控制项、GitHub 与客户结果。
Artificial Analysis:GPT-6 Luna 发布仪表盘——六档 Index、每任务成本与速度快照,2026 年 9 月 23 日。
Artificial Analysis:GPT-6 Sol and Luna push the cost efficiency frontier——$0.18 → $0.07 任务成本、输出 token 增长、回退归因。
VentureBeat:OpenAI releases GPT-6 Sol and Luna——永久性确认;跨厂商价格表,2026 年 9 月 22 日。
OpenRouter:GPT-6 Luna与GPT-6 Luna Pro (batch)——提供方列表与 Luna Pro serving 变体,2026 年 9 月 23 日。
社区记录(截图与条件随文内联):r/codex 1wngvak、r/codex 1wnhyh0、r/codex 1wnmhnq、r/codex 1wnhuru、r/OpenAI 1wnh4gr、X:Simon Willison、X:Mikel Echeve。

常见问题
GPT-6 Luna 每百万 token 收费多少?
OpenAI 标准短上下文 API 费率为输入 $0.10、缓存输入 $0.01、缓存写入 $0.125、输出 $0.50,单位均为每百万 token。输入超过 272,000 token 后,整笔请求按 $0.20、$0.02、$0.25、$0.75 的长上下文费率计费。
GPT-6 Luna 的 API 价格是永久的还是促销价?
OpenAI 发布公告把新费率定位为比 GPT-5.6 促销价低 50%,且公司发言人向 VentureBeat 确认 GPT-6 Sol 和 Luna 的费率是永久价格,不是促销或导入价。价格页上作为对照的 GPT-5.6 Sol 费率仍标注为促销价,至少持续到 2026 年 11 月 21 日。
跑 GPT-6 Luna 最便宜的方式是什么?
三个杠杆最影响账单:推理档位、缓存和服务档。Artificial Analysis 实测同一张费率卡在 low 档每个 Index 任务约 $0.0045、max 档 $0.07;缓存读取是全新输入价格的十分之一;能接受排队时延的任务可用五折的 Batch 或 Flex。
GPT-6 Luna 有长上下文计价吗?
有。输入超过 272,000 token 的请求按输入与缓存费率 2 倍、输出费率 1.5 倍对整笔请求计费,而不是只对超出部分加价。上下文窗口为 1,050,000 token,“放得进上下文”不等于“按短上下文价格计费”。
GPT-6 Luna 的 API 价格等同于 ChatGPT 或 Codex 用量吗?
不等同。API 按 token 计费,ChatGPT 和 Codex 套餐有各自的使用上限。发布时 GPT-6 Luna 面向 Plus、Pro、Business、Enterprise 和 Edu 用户开放 ChatGPT Work 与 Codex,Free 和 Go 套餐只能在桌面应用中使用。token 降价不自动等于套餐用量增加。
免费 API 层能用 GPT-6 Luna 吗?
不能。模型页的限流表把 gpt-6-luna 标为免费层“不支持”,付费访问从 Tier 1 开始(每分钟 500 次请求、50 万 token)。OpenAI 还为 Luna 公布了比 Sol 更高的付费层 token 限额。