
Grok 4.7 在公开 xAI API 上,提示词不足 20 万 token 时,是每百万输入 token $2、缓存输入 $0.50、输出 $6。长上下文一行是 $4 / $1 / $12。2026 年 9 月 22 日打开的 API 价格页 上,这三档和长上下文行都与 Grok 4.6 相同。标价没动。账单仍会动。
同一篇发布说明里,xAI 的 CursorBench 4.0 把一个 Grok 4.7 任务标成 Low $1.58、Extra High $6.01。费率卡一字未改,单任务成本大约差 3.8 倍。一位 Cursor Ultra 用户在 extra high、关闭 fast mode 的条件下把体感写成一句:“Grok 4.7 is about 2.5 times as expensive as 4.6.”(r/cursor,2026-09-21)。账单算清之后,Tabbit 是试一条路线的地方。先看费率卡。
先记住这几件事
标价与 Grok 4.6 相同。 短上下文是每百万 token $2 / $0.50 / $6。输入达到 20 万 token 时,整次请求改为 $4 / $1 / $12。
真正拉开的是推理档位。 xAI 的 CursorBench 从 Low 到 Extra High 依次是每任务 $1.58、$3.49、$4.69、$6.01。API 默认推理档是 high。
Fast 是第二张表,不是一句口号。 印出的 Fast 费率是 20 万以下 $4 / $1 / $12,以上 $6 / $1.50 / $18。它只在 Cursor 和 Grok Build,不在公开 API。
Cursor 的门槛是 25.6 万,不是 20 万。 Cursor 模型页在输入超过 25.6 万 token 后把标准按需费率翻倍,并把 50 万上下文的 Fast 标成 $6 / $1.50 / $18。缓存写入列是横线,不是单独一笔费用。
grok-4.7 没有 Batch 折扣。 模型页写明 Batch API 不支持。工具调用、美国端点 10%,以及生成前 $0.05 的违规费,都不在标题价里。
费率一览
下表单位是每百万 token 的美元,取自 xAI 价格页,采集于 2026 年 9 月 22 日。Grok 4.6 总览 讲的是上一代模型。这张表只谈钱。
| 模型 | 上下文 | 短输入 | 短缓存 | 短输出 | 长输入 | 长缓存 | 长输出 | 长上下文门槛 |
|---|---|---|---|---|---|---|---|---|
| grok-4.7 | 500k | $2.00 | $0.50 | $6.00 | $4.00 | $1.00 | $12.00 | ≥ 20 万 token |
| grok-4.6 | 500k | $2.00 | $0.50 | $6.00 | $4.00 | $1.00 | $12.00 | ≥ 20 万 token |
| grok-4.5 | 500k | $2.00 | $0.30 | $6.00 | $4.00 | $0.60 | $12.00 | ≥ 20 万 token |
| grok-build-0.1 | 256k | $1.00 | $0.20 | $2.00 | $2.00 | $0.40 | $4.00 | ≥ 20 万 token |
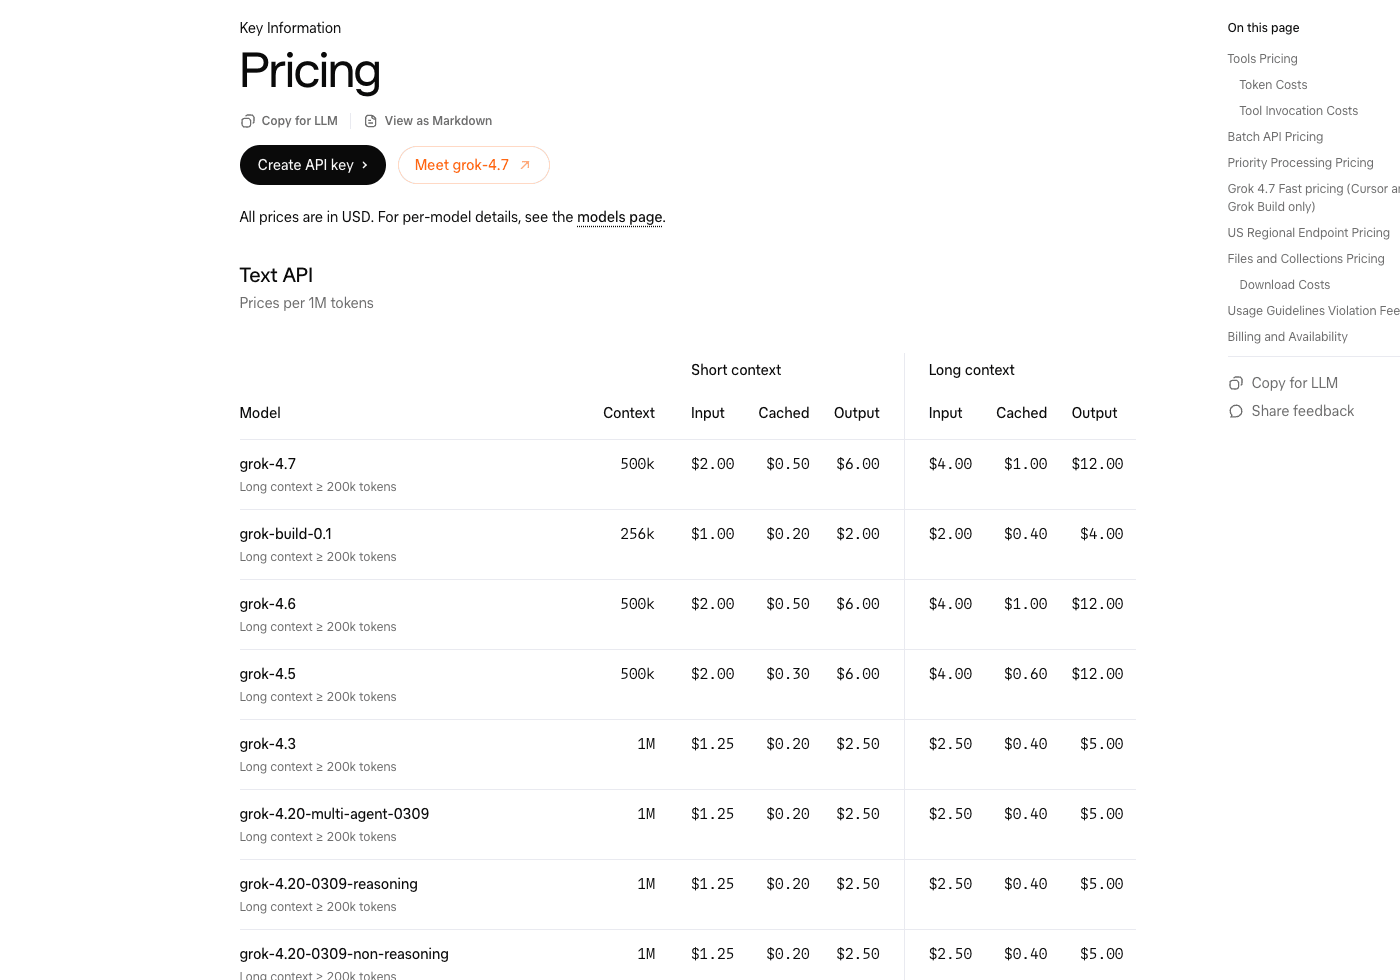
grok-4.7 的四个短上下文数字与 grok-4.6 完全一样。价格页写明:带长上下文定价的模型,一旦提示词到达门槛,该请求里的全部 token 都按长上下文费率计。越过 20 万,不是只给超出的部分涨价。
模型详情页重复短上下文:$2.00 输入、$0.50 缓存、$6.00 输出。打开 “Higher context pricing” 后,数字换成 $4.00、$1.00、$12.00。上下文窗口 50 万。推理档为 low、medium、high、xhigh,默认 high。Batch API 标为不支持。核对时区域是 us-east-1,该页限额为每秒 150 个请求、每分钟 5,000 万 token。
一个数字:每任务 $1.58 到 $6.01
如果只留一个数,留这个跨度,而不是 $2。Grok 4.7 发布页 写模型 “priced starting at $2 per million input tokens and $6 per million output tokens”,并说快速变体是 “twice the output speed at twice the price”。同一页的 CursorBench 4.0 成本视图,2026 年 9 月 22 日从图表控件读出:
| Grok 4.7 推理档 | CursorBench 4.0 分数 | 每任务平均成本 |
|---|---|---|
| Extra High | 46.3% | $6.01 |
| High | 43.9% | $4.69 |
| Medium | 41.6% | $3.49 |
| Low | 33.1% | $1.58 |
在这张厂商图上,Extra High 的花费是 Low 的 3.8 倍,分数高 13.2 个百分点。控件没有印出样本量、测试框架,也没有说明这几美元由哪些 token 构成。这是 xAI 报告的任务成本,不是 API 控制台的发票,也不能拿来和每百万 token 的裸价直接对比。
所以 “和 4.6 同价” 仍然可能显得贵。默认档是 high。这张图上 high 已经是 $4.69,Low 是 $1.58。代理式推理说明 适合讨论循环该在哪里停;定价上更窄的一点是:按你实际留下的推理档,给每个完成的任务设预算。
“贵 2.5 倍” 量的是什么
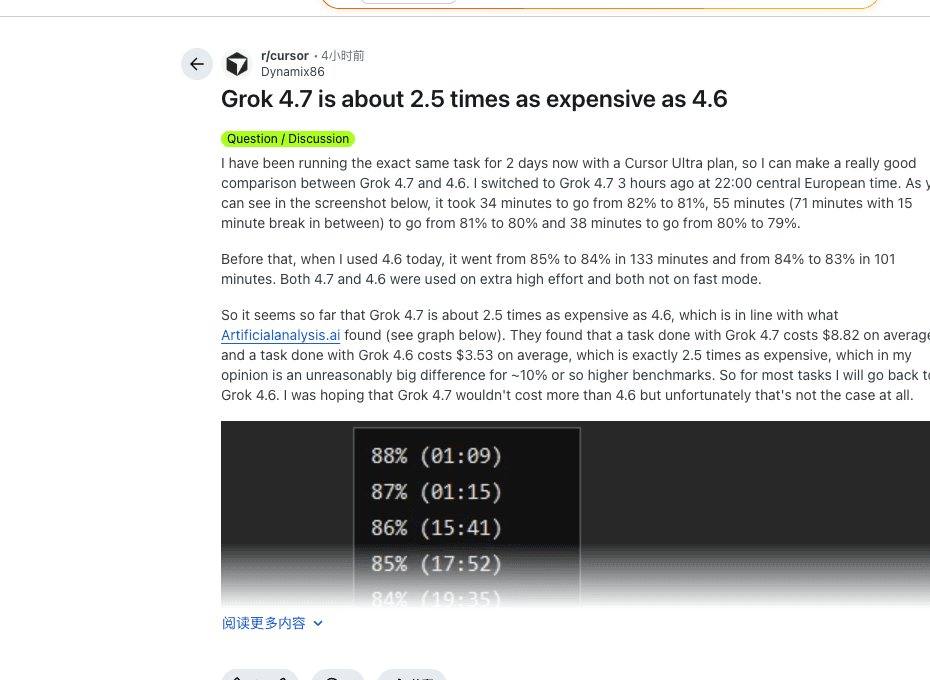
Dynamix86 在 Cursor Ultra 上把同一个任务跑了两天,于欧洲中部时间 22:00 从 Grok 4.6 换到 Grok 4.7,并记录每个用量百分点能撑多久。两次都是 extra high,且没有开 fast mode。4.7 的三段大约是每个百分点 34、55、38 分钟。当天更早的 4.6 是 133 和 101 分钟。作者由此估成大约 2.5 倍。帖子还把一张 Artificial Analysis 图读成每任务 $8.82 对 $3.53。这两个美元数只当作作者对截图的读法。本文没有重测那张图,Cursor 的额度百分比也不是 xAI API 的一行账单。
两条回复仍在谈成本:
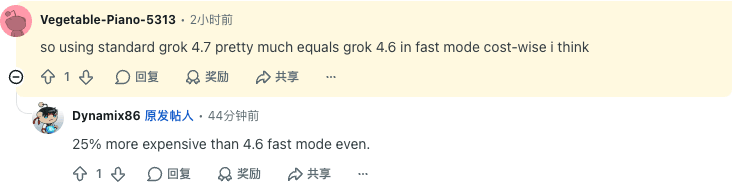
Vegetable-Piano-5313 写道:“so using standard grok 4.7 pretty much equals grok 4.6 in fast mode cost-wise i think”。Dynamix86 回复:“25% more expensive than 4.6 fast mode even.” 两条都没有贴出 token 日志。它们提醒的是套餐额度,不是第二张官方费率卡。
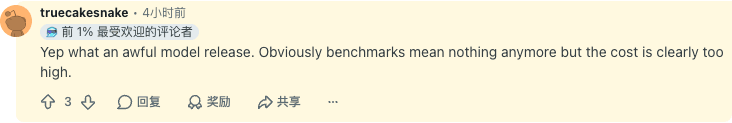
“Yep what an awful model release. Obviously benchmarks mean nothing anymore but the cost is clearly too high.” 这句是标价冲击。它没有写推理档、fast mode 或 token 数。上面那张发布图,才是不必把这条评论的结论当成事实也能核对的部分。
标题上的 $2 没有写出的行
20 万门槛作用在整次请求。 19.9 万 token 的提示词仍走 $2 / $0.50 / $6。20 万 token 的提示词把每一个 token,包括输出,都改到 $4 / $1 / $12。价格页没有 “只计超出部分” 这一行。
印出的长上下文 Fast 行,不是长上下文标准行的两倍。 价格页说 Grok 4.7 Fast 是同一模型跑在更快的基础设施上,“at twice the standard token rates”,只在 Cursor 和 Grok Build,不在公开 API,也不在 Grok Build 免费额度里。这句话下面的表是:
| 提示词规模 | Fast 输入 | Fast 缓存输入 | Fast 输出 |
|---|---|---|---|
| 20 万以下 | $4.00 | $1.00 | $12.00 |
| 20 万及以上 | $6.00 | $1.50 | $18.00 |
20 万以下,$4 / $1 / $12 正好是短上下文卡的 2 倍。20 万以上,长上下文卡的 2 倍会是 $8 / $2 / $24。印出的一行是 $6 / $1.50 / $18,即长上下文标准费率的 1.5 倍、短上下文标准费率的 3 倍。按印出的行做预算。不要把长上下文标准行乘二,再把它叫做 Fast。
Cursor 用 25.6 万,而且 Pro 及以上默认就是 Fast。 Cursor 的 Grok 4.7 文档 于 2026 年 9 月 22 日打开,标准按需用量是每百万输入 $2、缓存输入 $0.50、输出 $6。Fast 是 $4 / $1 / $12。输入超过 25.6 万 token 后,标准请求按这些标准费率的 2 倍计,Fast 请求按 3 倍计,上限 50 万。表中各行是 Grok 4.7 $2 / — / $0.50 / $6,Fast $4 / — / $1 / $12,50 万 $4 / — / $1 / $12,50 万 Fast $6 / — / $1.50 / $18。缓存写入列是横线。Cursor 还写明,Pro 及以上的默认速度档是 Fast;Start 套餐(仅印度)把 Grok 4.7 锁在 medium 推理和标准速度。一个 22 万 token 的提示词,在 xAI API 上已经是长上下文,在 Cursor 里仍可能走标准档。
Batch 不是这张卡的折扣杠杆。 价格页把 20% 批量折扣只给 grok-4.3 和 grok-4.20 系列,并写明未列出的模型没有批量折扣。grok-4.7 自己的页面写 Batch API 不支持。放到隔夜队列,不会把这个模型打对折。
工具是第二只计量表。 使用 xAI 服务端工具的请求,token 和调用次数都要付。网页搜索(web_search)和代码执行是每 1,000 次 $5。集合搜索是每 1,000 次 $2.50。文件附件(attachment_search)是每 1,000 次 $10。自 2026 年 9 月 21 日太平洋时间中午 12 点起,X Search 改为每 1,000 条帖子 $5、每 1,000 个用户资料 $10,不再是每 1,000 次调用 $5。view_image、view_x_video 和远程 MCP 没有调用费,只计 token。图像搜索算在网页搜索里。
美国端点是 1.1 倍。 发往 https://us.api.x.ai/v1 的请求按全球 token 费率的 1.1 倍计。价格页为 grok-4.7 印出的是 20 万以下 $2.20 / $0.55 / $6.60,以上 $4.40 / $1.10 / $13.20。先应用缓存折扣,再乘系数。该页写明这个端点目前覆盖 grok-4.7 和 grok-4.6。
优先处理是另外的 2 倍,而且只有响应写明时才算。 Priority 对输入、输出、缓存和推理 token 按标准费率的 2 倍计,缓存折扣在乘数之前。只有响应确认 "service_tier": "priority" 时才按优先价付。它不用于 Batch。Fast 是另一件产品,不是这个 API 开关。
家族阶梯里,真正更便宜的那一行
反直觉的一行不是 Grok 4.7 的新折扣。Grok 4.5 的缓存输入是 $0.30,4.6 和 4.7 是 $0.50,20 万以下的输入和输出仍是 $2 和 $6。如果循环很吃缓存,而且 4.5 已经够用,新卡是缓存读取变贵,不是降价。grok-build-0.1 的每个短上下文数字大约是 4.7 的一半($1 / $0.20 / $2),上下文窗口是 25.6 万,不是 50 万。它是另一个模型 id,不是 4.7 的一个推理档。
另一件反直觉的事是推理档。Extra High 没有单独的输入价。它花的是更多按 $6 计费的输出 token。Cursor 文档写,xhigh、high、medium、low 之间的差距比 Grok 4.6 更宽,更难的任务会想得更久。把默认留在 high,本身就是一次采购决定。
模型拒绝时,你仍然在付钱
这张卡上,拒绝不是免费的一行。
如果系统在 Responses API 生成之前 抓住使用准则违规,xAI 收 每请求 $0.05。
如果请求被判定违规,但生成已经跑完,这次生成仍然计费。
缓存输入是折扣(20 万以下是 $0.50 而不是 $2.00)。文本费率卡没有单独的缓存写入价。Cursor 的写入列是横线。未命中缓存的输入按完整输入价计。
产生了 token 的重试和失败尝试仍然是用量。费率卡没有把它们免掉。
Grok 聊天订阅、Cursor 套餐额度和 API 发票是三件不同的东西。本文不把消费者套餐的月费换算成 API 美元;2026 年 9 月 22 日没有把那个月费当作实时结账数字重新核对。
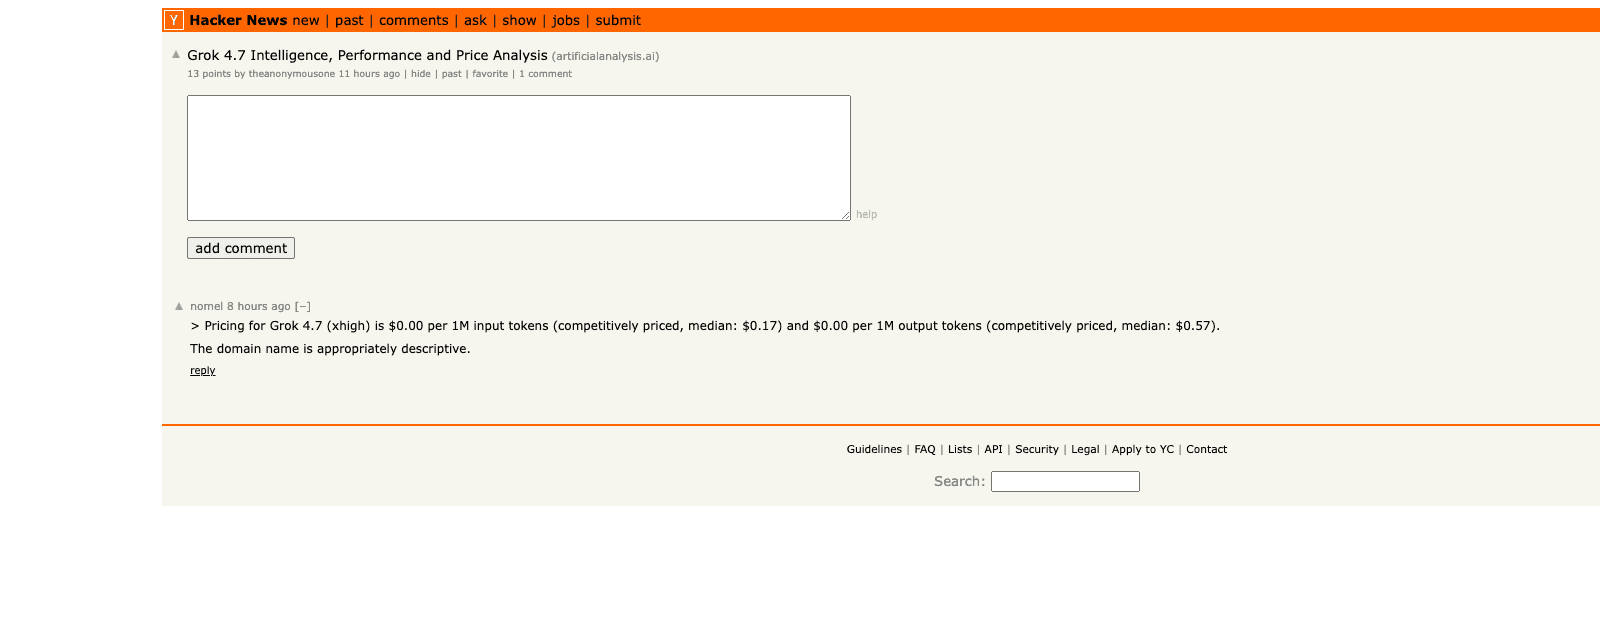
一条 Hacker News 评论引用某页,称 Grok 4.7(xhigh)是 “$0.00 per 1M input tokens” 和 “$0.00 per 1M output tokens”,然后说域名 “appropriately descriptive”。第三方小部件上的零,不是降价。上面的 API 卡才是用来做预算的。
模型实际跑在哪里
Grok 4.7 文档 列出公开 API(grok-4.7)、美国区域端点、作为默认编程代理模型的 Grok Build、所有套餐上的 Cursor,以及 OpenRouter、Vercel、Cloudflare 这些网关。本文没有重审网关牌价;和 $2 / $6 对不上的搜索摘要,不是抛开官方卡的理由。
Cursor 个人和团队套餐的用量池包含 Grok 4.7、Grok 4.6、Grok 4.5 和 Composer 2.5。这个池是额度,不是预先买好的一叠 API token。Pro 及以上默认 Fast,意味着套餐可以在每一轮都没有单独打开的情况下,按 Fast 那一行消耗。
Grok Build 的免费层不含 Fast。发布页还说可以在 x.ai/build 试用 Grok Build。那个页面上的 “try for free” 并不是说 grok-4.7 的 API token 免费。
两笔 API 预算
下面只用 xAI 的卡:没有工具、没有美国 10%、没有 priority 开关、没有重试。这是算术,不是预测。
门槛以下、默认卡上的一次短回答。 1 万未缓存输入 token,2,000 输出 token:
(10,000 × $2 + 2,000 × $6) / 1,000,000 = $0.032同一形状走印出的短上下文 Fast,是 $0.064。输出价是输入价的 3 倍,所以提示词很小的时候,想得久仍然占大头。
越过 20 万的一次冷启动代理提示词。 25 万未缓存输入 token,8,000 输出 token。长上下文费率作用于全部 token:
(250,000 × $4 + 8,000 × $12) / 1,000,000 = $1.096同样的 token 数如果仍按短上下文计价,会是 $0.548。差额就是这条门槛。缓存命中 90%、仍走长上下文时:
(25,000 × $4 + 225,000 × $1 + 8,000 × $12) / 1,000,000 = $0.421印出的 20 万以上 Fast、冷输入,是 (250,000 × $6 + 8,000 × $18) / 1,000,000 = $1.644。若把长上下文标准行直接翻倍,会算出并不存在的 $2.192。用 $1.644。
本地计算
估算每月 API 账单
费率核对于 2026 年 9 月 22 日的 xAI 官方页面。输出只计一次,并按输出价覆盖思考 token。你输入的数字不会离开这个页面。
输入达到或超过 20 万 token 时,整次请求改用该模型的长上下文费率。Fast 使用价目表上的 Fast 行,不是长上下文费率的简单两倍。不含工具调用、美国端点 10% 加价、优先处理、重试,以及 Cursor 单独的 25.6 万门槛。 核对费率表
计算器留在浏览器里。输入达到 20 万 token 时,它把整次请求切到长上下文费率;Fast 选项只对 grok-4.7 使用印出的 Fast 表。grok-4.6 和 grok-4.5 留在各自的标准行上,这样 4.5 的缓存差价仍然看得见。它不算工具费、美国 10%、priority、重试,也不算 Cursor 的 25.6 万门槛。锁定预算前,重新打开 官方价格页。
费率卡之后,有一个地方可以跑这个模型
知道费率卡,并不会把模型接到你已经打开的页面和文件上。Tabbit 浏览器 做的是这一步:模型选择器、当前页面和本地文件在同一个界面里,比较一条路线是一次选择,而不是再接一套计费。
边界就是这一节的重点。Tabbit 不替代 xAI 的发票,也不改变 Cursor 的 25.6 万规则。Grok 4.7 模型页 列出了这个模型,并说明它在 Tabbit 里是否出现,取决于账号当时的选择器。提示词笔记 和 评测笔记 记录的是 API 怎么调用、公开基准怎么读。它们不是一份测过的 Tabbit 账单。本文没有在 Tabbit 里跑过计时任务,所以不声称 Tabbit 的费用、延迟或成功率。
 Tabbit Browser
如果工作本身就是浏览器会话,从 AI 浏览器指南、代理式浏览器概览、什么是代理式浏览器 和 浏览器自动化指南 开始。2026 浏览器比较 和 Tabbit 使用笔记 把客户端选择和 token 费率分开讲。
你实际在选的是哪一种账单
| 工作负载 | 账单主要由什么决定 | 从这里开始 | 要注意 |
|---|---|---|---|
| 短 API 调用 | 每百万 $6 的输出 token | grok-4.7,low 或 medium | 默认档是 high |
| 20 万以下的重复提示词 | $0.50 的缓存读取 | 稳定缓存键的标准 API | 若质量允许,4.5 的缓存读取是 $0.30 |
| API 上达到或超过 20 万的提示词 | 整次请求的门槛 | 先改结构,或按 $4 / $12 做预算 | 不是 “只计超出部分” |
| 同一条提示词放在 Cursor 里 | Cursor 的 25.6 万线和 Fast 默认 | 除非延迟需要,否则用标准速度 | Pro 及以上默认 Fast |
| 延迟优先于成本 | 印出的 Fast 卡 | Cursor 或 Grok Build 的 Fast | 不在公开 API;没有 Grok Build 免费额度 |
| 工具很多的代理 | 每千次 $5 再加 token | 限制搜索和代码执行 | X Search 的计费在 2026-09-21 改过 |
结论
当任务长到额外的推理档配得上它花掉的 token 时,再买 Grok 4.7,并且有意识地买 推理档和运行表面。API 卡仍是 Grok 4.6 那张卡。这张图上 Low 是每任务 $1.58,Extra High 是 $6.01。除非你已经为整次请求按 $4 / $12 算过价,否则在 API 上把提示词留在 20 万 token 以下。Fast 按印出的 $4 / $1 / $12 和 $6 / $1.50 / $18 表来看,并记住 Cursor 在 25.6 万翻转,不是 20 万。更便宜的缓存或半价那一行已经够用时,用 grok-4.5 或 grok-build-0.1。不要等一个模型页已经写明不存在的 Batch 折扣。
这个模型的总览、评测和替代品文章还没有发布。在那之前,Grok 4.6 文章、模型笔记 和下面的官方页面是可核对的路径。按月承诺之前再看一次费率卡;同一张价格页上的 X Search 变更日期就是 2026 年 9 月 21 日。
来源
xAI API 价格:文本费率、Fast 表、工具、Batch 名单、美国端点、priority、违规费;2026-09-22 核对
grok-4.7 模型页:$2 / $0.50 / $6、长上下文开关、Batch 不支持、默认推理档 high
Grok 4.7 文档:模型 id、Fast 在哪里、美国 10%、运行位置;最后更新 2026-09-21
Introducing Grok 4.7:起步价、快速变体那一句、CursorBench 成本点
Cursor Grok 4.7 文档:25.6 万门槛、Fast 默认、费率行;2026-09-22 打开
社区记录及图注中的条件:r/cursor 1wmswj9、HN 49789558

常见问题
Grok 4.7 多少钱?
2026 年 9 月 22 日核对的 xAI API 上,提示词不足 20 万 token 时,grok-4.7 为每百万输入 token $2、缓存输入 $0.50、输出 $6。达到或超过该门槛后,整次请求改为 $4、$1 和 $12。公开 API 的模型 id 是 grok-4.7。
Grok 4.7 和 Grok 4.6 是同一个价吗?
短上下文和长上下文两行与 Grok 4.6 相同:20 万输入 token 以下是 $2/$0.50/$6,达到或超过则为 $4/$1/$12。这是标价。xAI 自己的 CursorBench 仍把 Grok 4.7 Extra High 标成每任务 $6.01、Low 标成 $1.58,推理档位会改账单,但不改费率卡。一位 Cursor Ultra 用户在 extra high、关闭 fast mode 的条件下,把同一任务的额度消耗估成大约是 Grok 4.6 的 2.5 倍。
Grok 4.7 的长上下文怎么计价?
在 xAI API 上,提示词一旦达到 20 万 token,该请求里的每个 token 都按每百万 $4 输入、$1 缓存输入、$12 输出计费。Cursor 的门槛不同:标准按需用量要到 25.6 万输入 token 之后才翻倍,上下文最多 50 万。不要把两条线混成一条。
Grok 4.7 Fast 多少钱?
xAI 价格页列出的 Fast 只在 Cursor 和 Grok Build 提供:提示词 20 万 token 以下是每百万 $4/$1/$12,达到或超过则为 $6/$1.50/$18。正文另写着标准 token 费率的两倍。印出的长上下文 Fast 行是长上下文标准行的 1.5 倍,不是两倍。Fast 不在公开 xAI API 上,也不计入 Grok Build 的免费额度。
Batch API 会给 Grok 4.7 打折吗?
不会。grok-4.7 模型页把 Batch API 标为不支持。价格页的 20% 批量折扣只给 grok-4.3 和 grok-4.20 系列等更早的模型,并写明不在名单上的模型没有批量折扣。
工具调用和拒绝回答要额外花钱吗?
服务端工具在 token 之外另计。网页搜索和代码执行为每 1,000 次调用 $5。自 2026 年 9 月 21 日太平洋时间中午 12 点起,X Search 改为每 1,000 条抓取的帖子 $5、每 1,000 个用户资料 $10。生成前就被判定违反使用准则的 Responses API 请求收 $0.05。已经生成完成再被判定违规的,token 仍然计费。