
Grok 4.7 es el modelo para probar cuando la tarea es larga, usa muchas herramientas y justifica una factura de tokens más alta. Grok 4.6 sigue siendo el predeterminado cuando el trabajo es rutinario y quieres la traza más corta. La tarifa de la API no cambió.
xAI publicó Grok 4.7 el 21 de septiembre de 2026 y dijo que se sirve al mismo precio y a la misma velocidad que Grok 4.6. Las fichas abiertas el 22 de septiembre coinciden en la tarifa y en la ventana de 500K. No coinciden en que una tarea terminada cueste lo mismo. Artificial Analysis, al evaluar Grok 4.7 en xhigh, contó unos 81.000 tokens de salida por tarea del Intelligence Index, frente a unos 36.000 de Grok 4.6 en high. Ese es el número que decide el cambio. (lanzamiento de xAI, ficha de Grok 4.7, ficha de Grok 4.6, Artificial Analysis)
La misma tensión apareció enseguida en Cursor. El 21 de septiembre, u/Dynamix86 escribió que una cuenta Ultra, en extra high y con Fast apagado, quemaba el porcentaje del plan unas 2,5 veces más rápido con Grok 4.7 que con Grok 4.6 en la misma tarea no nombrada, y que la mayor parte del trabajo volvería a 4.6.
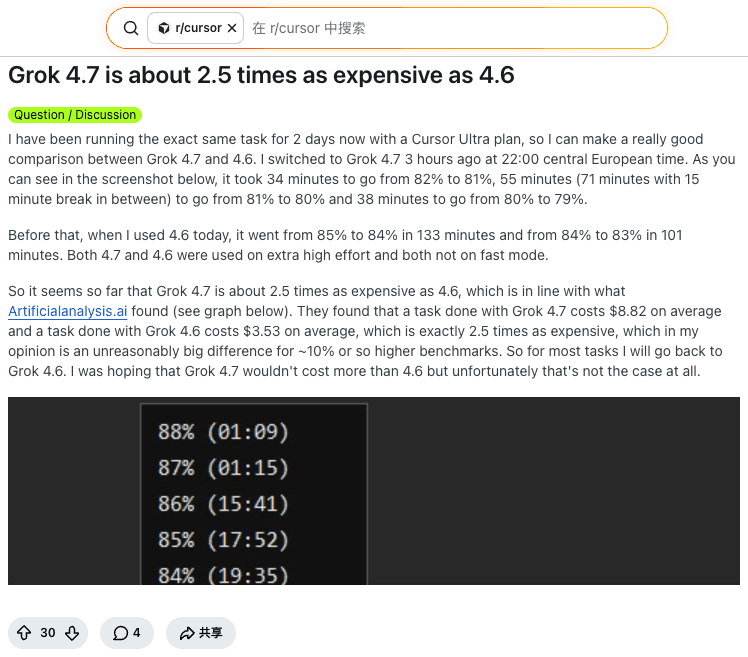
Esa publicación es una cuenta y una tarea. No prueba facturas de API ni la calidad de la respuesta. Sí muestra por qué «el mismo precio» es la primera pregunta equivocada. La visión general de Grok 4.6 cubre el modelo anterior por sí solo. Esta página solo trata la elección entre los dos. Las especificaciones también están en la página de Grok 4.7 (English) y la página de Grok 4.6 (English).
Ideas clave
Las dos fichas de API listan $2 / $0,50 en caché / $6 por millón de tokens por debajo de 200K de contexto, y $4 / $1 / $12 por encima de 200K. La ventana de 500K coincide.
Grok 4.7 xhigh usó unos 81.000 tokens de salida por tarea de inteligencia de Artificial Analysis, frente a unos 36.000 de Grok 4.6 high y unos 38.000 de Grok 4.6 xhigh. Solo la salida, a $6, sale a unos $0,49 frente a $0,22–$0,23.
El movimiento del Intelligence Index es +2, y compara xhigh con high (46 frente a 44). El del Coding Agent Index es +9 con xhigh alineado dentro de Grok Build (56 frente a 47).
La tabla de lanzamiento de xAI mejora en cada fila listada, pero las columnas son Grok 4.7 xHigh y Grok 4.6 High. DeepSWE en esa tabla marca high effort para 4.7. Esas brechas no son un experimento del mismo peldaño.
Deja Grok 4.6 para el trabajo corto y repetido. Prueba Grok 4.7 cuando una ejecución larga de código o una tarea cargada de documentos falle en 4.6 con la frecuencia suficiente para pagar los tokens extra.
Para este artículo no se completó una ejecución de la misma tarea en Tabbit. Una página de modelo no es una victoria medida.
El número que decide: misma tarifa de $2/$6, unos 81.000 frente a 36.000 tokens de salida
El titular del lanzamiento dice que Grok 4.7 es «el doble de rápido, a la mitad del precio de los modelos comparables», y el cuerpo dice que se sirve al mismo precio y a la misma velocidad que Grok 4.6. La primera frase no nombra los modelos comparables ni la unidad de velocidad. La segunda es la que sostienen las fichas de tarifa.
Lo que cambió es cuántos tokens gasta el modelo nuevo. Artificial Analysis escribió que Grok 4.7 xhigh usa aproximadamente 81.000 tokens de salida por tarea del Intelligence Index, frente a 36.000 de Grok 4.6 high, lo que llaman un 125% más. Más adelante en el mismo artículo dicen que 81.000 es más del doble de los 38.000 usados por Grok 4.6 xhigh. Las dos comparaciones importan. La cifra de 36.000 no es un par del mismo esfuerzo. La de 38.000 sí.
Tokens de salida por tarea del Intelligence Index (Artificial Analysis, 21 sep 2026)
Grok 4.7 xhigh     ~81k
Grok 4.6 high      ~36k     (+125% de tokens con una etiqueta de esfuerzo más alta)
Grok 4.6 xhigh     ~38k     (más de 2× tokens con la misma etiqueta de esfuerzo)

Cargo solo de salida a la tarifa compartida de $6 / 1M
81k × $6 / 1M  ≈  $0,49
36k × $6 / 1M  ≈  $0,22
38k × $6 / 1M  ≈  $0,23
Esa cuenta no es una factura. Ignora tokens de entrada, aciertos de caché, llamadas a herramientas, reintentos y cualquier cliente que cobre un porcentaje del plan en lugar de la API. También ignora la puntuación que compraron esos tokens.
En el Intelligence Index la puntuación pasó de 44 para Grok 4.6 high a 46 para Grok 4.7 xhigh. Fuera del trabajo de conocimiento agéntico, Artificial Analysis dijo que Grok 4.7 coincidía en líneas generales con Grok 4.6 high, con Terminal-Bench 4.0 +4,5 puntos y GDP.pdf +3,0 puntos, y con retrocesos en AA-LCR (−3,7 puntos) y AutomationBench-AA (−1,1 puntos). Las puntuaciones absolutas de esas cuatro filas no se imprimieron en el texto del artículo.
El movimiento mayor es el índice de agente de código, y sí es una comparación del mismo esfuerzo. Grok 4.7 xhigh con Grok Build obtuvo 56, frente a 47 de Grok 4.6 xhigh con Grok Build. Dentro de ese harness, DeepSWE v1.1 pasó del 65% al 73%, Terminal-Bench 4.0 del 18% al 33% y SWE-Atlas-QnA del 58% al 63%. Esos números de terminal no son el 38,0% y el 20,3% de la tabla de lanzamiento de xAI, ni el delta de +4,5 puntos del harness unificado. Tres lecturas distintas de Terminal-Bench pueden ser reales si el harness y el esfuerzo difieren.
Usa Grok 4.7 cuando los tokens extra compran una ejecución larga que de otro modo repetirías. Quédate en Grok 4.6 cuando un índice +2, medido entre etiquetas de esfuerzo distintas, no valga aproximadamente el doble de salida.
Especificaciones y precio de un vistazo
Comprobado el 22 de septiembre de 2026 en las dos fichas. «Higher context» en esas fichas significa una petición por encima de 200K tokens. La documentación de Cursor usa un límite de 256K y no es esta tabla.
| Dimensión | Grok 4.7 | Grok 4.6 | Cómo usar la fila |
|---|---|---|---|
| ID del modelo en la API | grok-4.7 | grok-4.6 | Fija el ID. No uses un alias «latest» para comparar. |
| Ventana de contexto | 500.000 | 500.000 | Un cliente puede exponer menos. La página de Grok 4.7 en Cursor describe 256K estándar y 500K de contexto largo. |
| Modalidades | Texto e imagen de entrada, texto de salida | Texto e imagen de entrada, texto de salida | Los límites de tamaño de imagen están en la documentación compartida, no son un motivo para elegir un ID. |
| Entrada / caché / salida, hasta 200K | $2 / $0,50 / $6 por 1M | $2 / $0,50 / $6 por 1M | Misma tarifa de lista. |
| Entrada / caché / salida, por encima de 200K | $4 / $1 / $12 por 1M | $4 / $1 / $12 por 1M | El multiplicador de contexto largo también coincide. |
| Corte de conocimiento | Mayo de 2026, en el índice de modelos | No se repite en la ficha abierta esta fecha | No copies un corte anterior. |
| Opción Fast | Publicación de lanzamiento: una variante rápida al doble de velocidad de salida y al doble de precio, sin fila de benchmark | No consta en la ficha abierta esta fecha | No des por hecho que los dos interruptores Fast son el mismo producto. |
La tabla de lanzamiento de xAI también imprime $2 de entrada y $6 de salida para las dos columnas de Grok, junto a GPT-5.6 Sol a $4 / $20 y Fable 5.1 a $10 / $50. Esa tabla compara tarifas de lista. No compara tareas terminadas. Fable 5.1 sigue liderando varias filas propias de xAI; la reseña de Fable 5.1 es el lugar para esas compensaciones, no una afirmación de que Grok lo sustituyó.
La documentación de Grok 4.7 en Cursor, abierta el mismo día y servida en chino en cursor.com/cn/docs/models/grok-4-7, coloca a Grok 4.7 en un pool de uso con Grok 4.6, Grok 4.5 y Composer 2.5. Las tarifas bajo demanda que muestra coinciden con la ficha de API de contexto corto: $2 de entrada, $0,50 en caché, $6 de salida. Fast aparece a $4 / $1 / $12, y la página dice que Fast es la velocidad predeterminada en Pro y superior. La entrada por encima de 256K se factura a 2× en estándar y a 3× la tarifa estándar en Fast, hasta 500K. Un porcentaje de Cursor y un dólar de API son medidores distintos. Compáralos solo después de fijar el esfuerzo y Fast en los dos lados.
Benchmarks, y cuánto confiar en ellos
Dos tablas. La primera es la de lanzamiento de xAI, con las etiquetas de esfuerzo que la página imprimió. La segunda es Artificial Analysis donde las etiquetas coinciden, más las puntuaciones de índice que no.
| Tabla de lanzamiento de xAI, 21 de septiembre de 2026 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Etiqueta de esfuerzo de la columna | xHigh; DeepSWE marcado high effort | High | Max | Max |
| Tarifa de lista, entrada / salida por 1M | $2 / $6 | $2 / $6 | $4 / $20 | $10 / $50 |
| CursorBench 4.0 | 46,3% | 40,4% | 41,7% | 51,8% |
| DeepSWE v1.1 | 71,0% | 65,2% | 72,7% | 70,0% |
| EEBench | 64,0% | 53,0% | 39,4% | 56,4% |
| AA Briefcase v1.1 | 1.657 | 1.546 | 1.487 | 1.678 |
| Terminal-Bench 4.0 | 38,0% | 20,3% | 37,3% | 57,9% |
| Harvey Legal Agent Benchmark | 19,6% | 15,8% | 2,5% | 6,7% |
| HealthBench Professional | 56,7% | 48,5% | 60,5% | 62,1% |
Grok 4.7 va por delante de Grok 4.6 en cada fila de esa tabla. No va por delante de Fable 5.1 en CursorBench, AA Briefcase, Terminal-Bench ni HealthBench Professional. Va por delante de GPT-5.6 Sol en cinco de las siete filas de puntuación y por detrás en DeepSWE y HealthBench. El tamaño de muestra, el harness y los intervalos de confianza no están en la página. El pie del gráfico dice que los benchmarks son resultados direccionales del proveedor.
El diagrama de dispersión de CursorBench en la misma página no incluye Grok 4.6. Para Grok 4.7 muestra una escalera de esfuerzo pronunciada: Extra High 46,3% a unos $6,01 y 70.141 tokens de salida por tarea; High 43,9% a $4,69; Medium 41,6% a $3,49; Low 33,1% a $1,58. «Grok 4.7» sin etiqueta de esfuerzo no es una sola puntuación.
| Artificial Analysis, artículo del 21 de septiembre de 2026 | Grok 4.7 | Grok 4.6 | Par de esfuerzo | Qué se puede decir |
|---|---|---|---|---|
| Intelligence Index v4.3 | 46 | 44 | xhigh vs high | +2 puntos, no un resultado del mismo peldaño |
| Tokens de salida por tarea de inteligencia | ~81k | ~36k high; ~38k xhigh | mixto | La factura se mueve más que el índice |
| Coding Agent Index, Grok Build | 56 | 47 | xhigh vs xhigh | +9 en el agente de código del proveedor |
| DeepSWE v1.1, Grok Build | 73% | 65% | xhigh vs xhigh | No es el par 71,0 / 65,2 de la tabla de lanzamiento |
| Terminal-Bench 4.0, Grok Build | 33% | 18% | xhigh vs xhigh | No es el par 38,0 / 20,3 de xAI |
| SWE-Atlas-QnA, Grok Build | 63% | 58% | xhigh vs xhigh | Más estrecho que el salto de terminal |
| Elo de AA-Briefcase | 1.657 | 1.546 en high | xhigh vs high | Sube la calidad analítica, baja la presentación |
| Elo de GDPval-AA | 1.695 | 1.605 en high | xhigh vs high | Ganancia en trabajo de conocimiento; Fable 5.1 sigue en 1.735 en el gráfico de xAI |
| Tasa de alucinación, AA-Omniscience | 29% | 34% en high | xhigh vs high | La precisión se quedó en 47% frente a 48% |
Lee el bloque del agente de código si te importa Grok Build. Lee el bloque de inteligencia si te importa un harness compartido. No los promedies en una frase de «Grok es un 10% mejor». Un comentario de Hacker News hizo la pregunta obvia: ¿por qué comparar 4.7 xhigh con 4.6 high? Las respuestas de ese hilo no coinciden sobre cuándo llegó xhigh a 4.6. Artificial Analysis sí publica una puntuación de agente de código de Grok 4.6 xhigh, así que la etiqueta existe en al menos una evaluación actual. La tabla de lanzamiento sigue sin usarla.
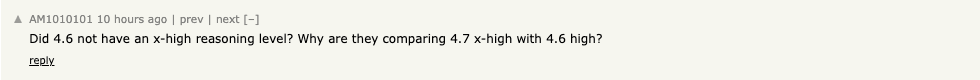
Dónde Grok 4.7 sí se adelanta
Ejecuciones largas de código dentro de un agente
La ganancia más limpia es la del esfuerzo alineado. En Grok Build, el índice de agente de código subió 9 puntos y cada componente subió. El trabajo de terminal se movió más, del 18% al 33% en ese harness. Si tu modo de fallo es una tarea de repositorio de varias horas que se atasca, esta es la fila que justifica una prueba. No dice que Grok Build vaya a ganar a Claude Code o a Codex. Artificial Analysis situó a Grok 4.7 más Grok Build en cuarto lugar entre harness nativos, por detrás de Claude Fable 5.1, GPT-6 Astra y Claude Opus 5.
El salto propio de xAI en Terminal-Bench 4.0, del 20,3% al 38,0%, apunta en la misma dirección y usa etiquetas de esfuerzo no alineadas. Trátalo como evidencia de apoyo del proveedor, no como una segunda medición independiente del resultado de 18 a 33.
Documentos y análisis, con una salvedad de presentación
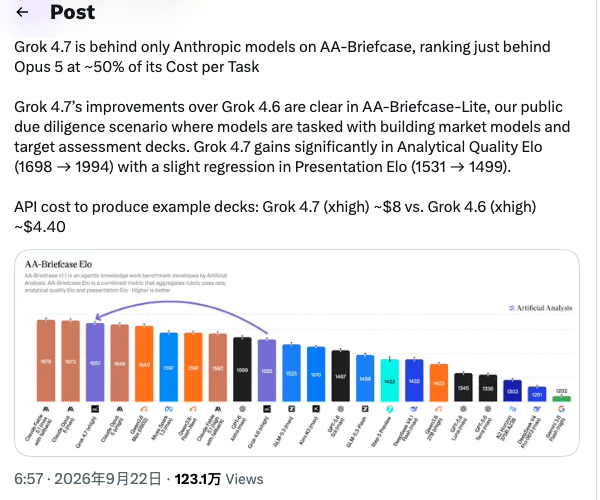
En AA-Briefcase, Grok 4.7 obtuvo 1.657 Elo, 111 por encima de Grok 4.6 high, justo por detrás de Claude Opus 5 y Claude Fable 5.1 en el texto de Artificial Analysis. La calidad analítica fue 1.994 Elo frente a 1.690. La calidad de presentación fue 1.499 frente a 1.519. El modelo mejoró en el análisis y empeoró un poco en la presentación.
Artificial Analysis describió la misma división con más nitidez en el escenario público de diligencia debida de AA-Briefcase-Lite: Elo analítico de 1.698 a 1.994, Elo de presentación de 1.531 a 1.499. Las presentaciones de ejemplo costaron unos $8 para Grok 4.7 xhigh y unos $4,40 para Grok 4.6 xhigh. Ese par es del mismo esfuerzo y unas 1,8 veces el coste de API a cambio de un análisis más fuerte y una presentación más débil. Es un escenario, no un benchmark universal de oficina. GDPval-AA pasó de 1.605 a 1.695 Elo en el par high frente a xhigh, y el gráfico GDPval de xAI sitúa a Fable 5.1 max en 1.735.
Una tasa de alucinación más baja, no una precisión más alta
La tasa de alucinación de AA-Omniscience fue del 29% para Grok 4.7 xhigh y del 34% para Grok 4.6 high. La precisión fue del 47% frente al 48%. El índice pasó de 30 a 32. Si necesitas menos respuestas erróneas dichas con seguridad, eso es un cambio real. Si necesitas más respuestas correctas, este par no lo muestra. Las etiquetas de esfuerzo siguen siendo distintas.
Dónde Grok 4.6 sigue siendo el mejor predeterminado
Trabajo corto, donde el pensamiento extra es el producto
Pagar la misma tarifa por aproximadamente el doble de salida es un buen intercambio solo cuando esa salida evita un reintento. Para una extracción acotada, un parche corto o un JSON de estado, la traza más corta de Grok 4.6 es la función. Lectores de Hacker News que miraban el gráfico de tokens de inteligencia llamaron al cambio una regresión de eficiencia de tokens. Ese comentario no añade una medición nueva. Es el mismo gráfico de Artificial Analysis, leído como un problema de coste y no como una subida de capacidad.

En las tareas que Artificial Analysis señaló como retrocesos frente a Grok 4.6 high, AA-LCR y AutomationBench-AA, no hay motivo para dejar 4.6. No se publicaron puntuaciones absolutas, así que el tamaño de esas caídas es solo el delta publicado: 3,7 y 1,1 puntos.
Planes de Cursor, si Fast y el esfuerzo no están fijados
Una tarifa de lista de $2/$6 no describe un porcentaje de Cursor Ultra. Los tiempos de Dynamix86 son un registro de un solo usuario: intervalos de Grok 4.7 de 34, 55 y 38 minutos por punto porcentual, frente a 133 y 101 minutos de Grok 4.6 más temprano el mismo día, ambos en extra high con Fast apagado. El autor también leyó un gráfico de Artificial Analysis como $8,82 frente a $3,53 por tarea de agente de código. Esas cifras en dólares fueron la lectura del autor de un gráfico. No se imprimieron como una frase en el artículo de Artificial Analysis abierto para esta página, así que se quedan atribuidas a la publicación.
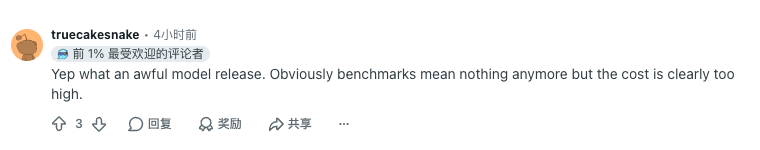
Una respuesta en el mismo hilo fue más directa: el lanzamiento parecía flojo porque el coste era claramente demasiado alto aunque se dejaran de lado los benchmarks.
La documentación de Cursor también dice que Fast es el predeterminado en Pro y superior, al doble de las tarifas de token. Si un lado de una prueba personal es Fast y el otro no, el precio 2× es un ajuste, no un cambio de modelo. El registro de Reddit dice que Fast estaba apagado. Muchas comparaciones casuales no lo estarán.
Cualquier trabajo que ya aceptas de Grok 4.6
Las notas de reseña (English) de Grok 4.6 ya describen un modelo agente de 500K a esta tarifa. Grok 4.7 no añade un nuevo tramo de contexto en la ficha de API, y no baja la tarifa de lista. Si 4.6 ya termina el trabajo y no estás bloqueado en terminales largos o documentos largos, la actualización es opcional. HealthBench Professional sigue por detrás de GPT-5.6 Sol y Fable 5.1 en la propia tabla de xAI (56,7 frente a 60,5 y 62,1), así que un cambio por razonamiento clínico tampoco es la historia.
Lo que la gente dijo de verdad
Los comentarios tempranos se parten en un campo del coste y un campo de la sensación. Los dos tienen horas de vida. Ninguno publicó un prompt, un repositorio o una puntuación.
La factura. La estimación de 2,5× de uso del plan de Dynamix86 y el «el coste es claramente demasiado alto» de truecakesnake se sientan junto al gráfico de tokens. Otro comentarista de Hacker News, notduckrabbit, señaló la misma brecha de eficiencia. Juntos dicen: no migres una ruta de alto volumen el día del lanzamiento.
La sensación. Otros comentarios de r/cursor, publicados la misma tarde, gustaron del modelo y no mencionaron el precio.
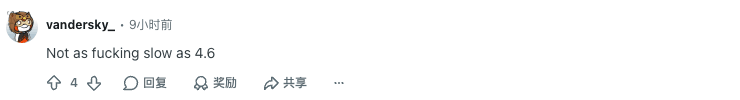
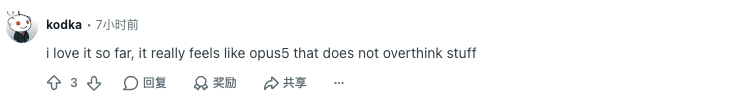
Los comentarios de velocidad y de «no piensa de más» pueden ser ciertos en una sesión de chat y seguir siendo falsos para un agente de código xhigh que emite 81.000 tokens. «No tan lento como 4.6» no iba acompañado de un recuento de tokens. Artificial Analysis midió unos 188 tokens por segundo en prompts largos y unos 7,1 minutos de tiempo de decodificación por tarea de inteligencia, sin contar el tiempo hasta el primer token ni la sobrecarga. Una primera impresión rápida y una traza larga de agente son compatibles.
La búsqueda en YouTube de «Grok 4.7 vs Grok 4.6» el 22 de septiembre devolvió explicaciones del lanzamiento, incluidos vídeos previos que adivinan recuentos de parámetros. Esos recuentos no están en la página de lanzamiento de xAI, que solo dice «un modelo base nuevo y más grande». Aquí no se usa ningún comentario de vídeo.
El veredicto
No hay un ganador global. Elige según la forma del trabajo y deja la etiqueta de esfuerzo dentro de la decisión.
| Carga de trabajo | Elige | Por qué | Qué vigilar |
|---|---|---|---|
| Extracción corta, clasificación o un parche pequeño | Grok 4.6 | La ganancia del índice es pequeña y la traza de salida es mucho más corta | No pagues xhigh por una respuesta de una línea |
| Trabajo repetido de Cursor en un pool de uso | Grok 4.6, salvo que una tarea esté fallando | Un registro Ultra mostró unas 2,5× de uso del plan en extra high con Fast apagado | Fija Fast y el esfuerzo antes de culpar al modelo |
| Código de varias horas en Grok Build o un agente similar | Prueba Grok 4.7 xhigh | Coding Agent Index 56 frente a 47 con xhigh alineado | Compara tareas terminadas, no solo el índice |
| Modelos de mercado, memorandos y presentaciones objetivo | Prueba Grok 4.7 y luego edita la presentación | El Elo analítico subió; el Elo de presentación bajó; los ejemplos costaron unos $8 frente a $4,40 | Reserva una pasada humana en las diapositivas |
| Llamadas de API de contexto largo por encima de 200K | Cualquiera, en precio | Las dos fichas duplican las tarifas pasados 200K | El límite de 256K de Cursor es otro medidor |
| Necesitas CursorBench o Terminal-Bench al nivel de Fable | No este par | Fable 5.1 Max está en 51,8% y 57,9% en la tabla de xAI | Precia esa elección en la ficha de Fable, no en la de Grok |
Una prueba práctica es una tarea ya aceptada, mismo esfuerzo, Fast apagado, mismo harness. Anota si se completó, las ediciones humanas, los tokens de salida y los dólares de API o el porcentaje del plan. Un acierto no es una tasa.
Ejecuta la misma tarea en Tabbit antes de migrar una ruta
Una fila de benchmark no dice cómo se comporta cada modelo en tus pestañas, documentos e investigación a medias. Tabbit Browser es el espacio de trabajo para esa comprobación: el modelo puede sentarse junto a las páginas que ya estás leyendo, en lugar de un chat aparte que nunca las ve. La guía del navegador agéntico y la guía de razonamiento agéntico separan una puntuación de modelo de un flujo de varios pasos ya terminado. La comparación de navegadores de IA y la guía de Tabbit Browser cubren el producto alrededor del modelo. El recorrido de navegadores de IA de 2026 es el conjunto más amplio si Tabbit no es el cliente que quieres.
Los dos ID de Grok están registrados para Tabbit. Que Grok 4.7 o Grok 4.6 aparezca en tu selector depende de la cuenta y del listado actual. Este artículo no incluye una transcripción de Tabbit, un registro de tokens ni un ganador. Si los dos ID están disponibles, ejecuta una tarea que ya sepas calificar, mantén el esfuerzo y las herramientas iguales, y quédate en Grok 4.6 si el único cambio es una traza más larga. La guía de prácticas de Tabbit trata el flujo de trabajo del navegador, no afirma que una compilación de Grok venga preinstalada en cada cuenta.
La tarifa de lista de la API, un pool de Cursor y el acceso en Tabbit son tres facturas distintas. No las sumes.
 Tabbit Browser

Preguntas frecuentes
¿Grok 4.7 es mejor que Grok 4.6?
Depende de la tarea y del nivel de razonamiento. En el Coding Agent Index de Artificial Analysis, Grok 4.7 xhigh con Grok Build obtuvo 56 frente a 47 de Grok 4.6 xhigh. El Intelligence Index solo pasó de 44 en Grok 4.6 high a 46 en Grok 4.7 xhigh, y algunas tareas no agénticas empeoraron. No hay un ganador único.
¿Grok 4.7 y Grok 4.6 cuestan lo mismo?
En las fichas de modelo de xAI abiertas el 22 de septiembre de 2026, ambos listan $2 por millón de tokens de entrada, $0,50 de entrada en caché y $6 de salida por debajo de 200K de contexto, y $4, $1 y $12 por encima de 200K. Cursor documenta un pool de uso aparte y un nivel Fast. Que la tarifa coincida no significa que una tarea terminada cueste igual.
¿Por qué Grok 4.7 puede costar más si el precio por token no cambió?
Artificial Analysis midió unos 81.000 tokens de salida por tarea del Intelligence Index para Grok 4.7 xhigh, frente a unos 36.000 de Grok 4.6 high y unos 38.000 de Grok 4.6 xhigh. A $6 por millón de tokens de salida, solo esa salida es unos $0,49 frente a $0,22 o $0,23, antes de entrada, caché, herramientas o reintentos.
¿Qué mejoras de benchmark de Grok 4.7 están en el mismo nivel de esfuerzo?
La comparación del Coding Agent Index es xhigh contra xhigh: 56 frente a 47, con DeepSWE 73% frente a 65%, Terminal-Bench 4.0 33% frente a 18% y SWE-Atlas-QnA 63% frente a 58% dentro de Grok Build. La tabla de lanzamiento de xAI compara Grok 4.7 xHigh con Grok 4.6 High, y DeepSWE en esa tabla marca high effort para Grok 4.7. No trates esas filas como una prueba del mismo peldaño.
¿Debo pasar de Grok 4.6 a Grok 4.7 en Cursor?
Prueba una tarea larga de código o de documentos si aceptas un mayor gasto del plan. Un usuario de Cursor Ultra, en extra high y con Fast apagado, estimó unas 2,5 veces el uso del plan y pensaba devolver la mayor parte del trabajo a 4.6. Otros comentarios tempranos dijeron que 4.7 se sentía más rápido o menos propenso a pensar de más. Fija el esfuerzo y Fast antes de comparar.
¿Puedo comparar Grok 4.7 y Grok 4.6 en Tabbit Browser?
Los dos modelos tienen páginas de modelo en Tabbit. Que aparezcan en el selector depende de la cuenta y del listado en vivo. Este artículo no incluye una ejecución de la misma tarea en Tabbit, así que una entrada en el selector no demuestra que un modelo gane un flujo de trabajo.