
과제가 길고, 도구를 많이 쓰며, 더 긴 토큰 청구를 낼 가치가 있을 때 시험할 모델은 Grok 4.7입니다. 일상적인 짧은 작업의 기본값은 Grok 4.6입니다. API 표시 단가는 변하지 않았습니다.
xAI는 2026년 9월 21일 Grok 4.7을 공개하며 Grok 4.6과 같은 가격, 같은 속도로 제공한다고 썼습니다. 9월 22일에 연 두 모델 카드는 요율과 500K 컨텍스트에서 일치합니다. 끝난 과제의 비용까지 같다는 뜻은 아닙니다. Artificial Analysis는 Grok 4.7을 xhigh로 평가해 Intelligence Index 과제당 출력 약 81,000토큰, Grok 4.6 high는 약 36,000토큰으로 셌습니다. 바꿀지를 정하는 숫자는 이것입니다. (xAI 발표, Grok 4.7 모델 카드, Grok 4.6 모델 카드, Artificial Analysis)
같은 긴장은 Cursor에서 바로 나타났습니다. 9월 21일 u/Dynamix86는 Ultra 계정 하나, extra high, Fast 끔에서 이름 없는 같은 과제에 Grok 4.7이 Grok 4.6보다 약 2.5배 빠르게 플랜 비율을 소모했고, 대부분의 작업은 4.6으로 돌아가겠다고 썼습니다.
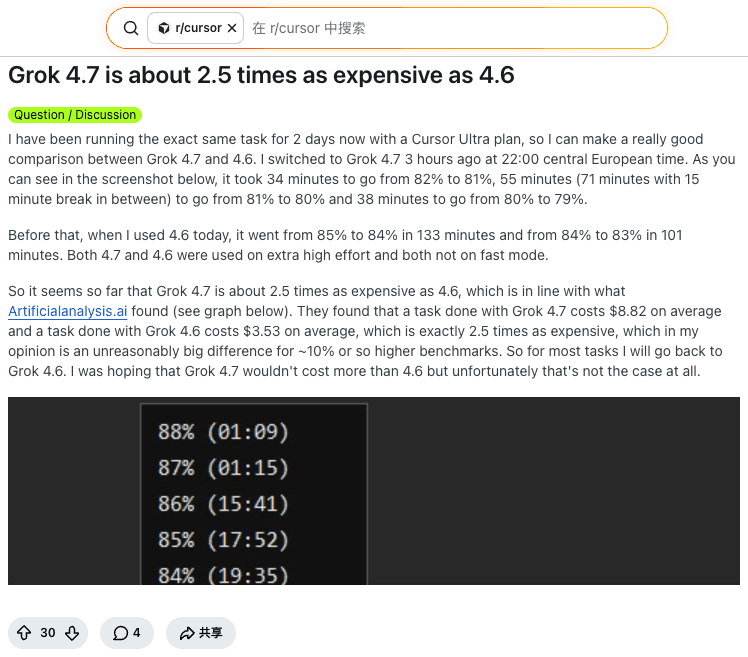
이 글은 계정 하나, 과제 하나입니다. API 청구서나 답변 품질을 증명하지 않습니다. ‘같은 가격’이 첫 질문으로 틀린 이유는 보여 줍니다. Grok 4.6 개요는 이전 모델 자체입니다. 이 페이지는 둘 중 무엇을 고를지만 다룹니다. 사양은 Grok 4.7 모델 페이지 (English)와 Grok 4.6 모델 페이지 (English)에도 있습니다.
핵심
두 API 카드는 컨텍스트 20만 미만에서 백만 토큰당 $2 / 캐시 $0.50 / 출력 $6, 20만 초과에서 $4 / $1 / $12입니다. 500K 창은 같습니다.
Grok 4.7 xhigh는 지능 과제당 출력 약 8.1만 토큰, Grok 4.6 high는 약 3.6만, Grok 4.6 xhigh는 약 3.8만입니다. 출력 $6만 계산하면 약 $0.49 대 $0.22–$0.23입니다.
Intelligence Index 움직임은 +2이고 xhigh 대 high입니다(46 대 44). Coding Agent Index 움직임은 Grok Build 안의 맞춰진 xhigh에서 +9입니다(56 대 47).
xAI 출시 표는 적힌 모든 행에서 앞섭니다. 열 머리는 Grok 4.7 xHigh와 Grok 4.6 High입니다. 그 표의 DeepSWE는 4.7을 high effort로 표시합니다. 그 차이는 같은 단의 실험이 아닙니다.
짧고 반복되는 작업은 Grok 4.6에 두십시오. 긴 코딩이나 문서 중심 과제가 4.6에서 자주 실패해 추가 토큰 값을 할 때만 Grok 4.7을 시험합니다.
이 글을 위해 같은 과제의 Tabbit 실행은 하지 않았습니다. 모델 페이지는 측정된 승리가 아닙니다.
이 비교를 정하는 숫자: 같은 $2/$6, 출력 약 8.1만 대 3.6만 토큰
출시 제목은 Grok 4.7이 “비교 가능한 모델보다 두 배 빠르고 절반 가격”이라고 쓰고, 본문은 Grok 4.6과 같은 가격과 속도로 제공된다고 씁니다. 앞 문장은 비교 대상과 속도 단위를 밝히지 않습니다. 요율 카드가 받치는 문장은 뒤의 것입니다.
바뀐 것은 새 모델이 쓰는 토큰 수입니다. Artificial Analysis는 Grok 4.7 xhigh가 Intelligence Index 과제당 출력 약 81k 토큰, Grok 4.6 high가 36k라며 125% 더 많다고 썼습니다. 같은 글 뒤에서는 81k가 Grok 4.6 xhigh의 38k보다 두 배가 넘는다고도 합니다. 둘 다 남겨야 합니다. 36k는 같은 강도의 쌍이 아닙니다. 38k가 같은 강도입니다.
Intelligence Index 과제당 출력 토큰 (Artificial Analysis, 2026-09-21)
Grok 4.7 xhigh     약 81k
Grok 4.6 high      약 36k     (토큰 +125%, 강도 라벨은 더 높음)
Grok 4.6 xhigh     약 38k     (같은 강도 라벨에서 토큰 2배 초과)

공유 출력 $6 / 100만, 출력만
81k × $6 / 1M  ≈  $0.49
36k × $6 / 1M  ≈  $0.22
38k × $6 / 1M  ≈  $0.23
이 산술은 청구서가 아닙니다. 입력 토큰, 캐시 적중, 도구 호출, 재시도, API 대신 플랜 비율로 청구하는 클라이언트를 빼 둡니다. 그 토큰이 산 점수도 빼 둡니다.
Intelligence Index 점수는 Grok 4.6 high 44에서 Grok 4.7 xhigh 46으로 움직였습니다. 에이전트형 지식 작업 밖에서 Artificial Analysis는 Grok 4.7이 Grok 4.6 high와 대체로 맞고, Terminal-Bench 4.0은 4.5포인트, GDP.pdf는 3.0포인트 올랐으며, AA-LCR은 3.7포인트, AutomationBench-AA는 1.1포인트 내렸다고 했습니다. 이 네 행의 절대 점수는 본문에 인쇄되지 않았습니다.
더 큰 움직임은 코딩 에이전트 지수이고, 이것은 같은 강도입니다. Grok 4.7 xhigh와 Grok Build는 56, Grok 4.6 xhigh와 Grok Build는 47입니다. 그 하네스 안에서 DeepSWE v1.1은 65%에서 73%, Terminal-Bench 4.0은 18%에서 33%, SWE-Atlas-QnA는 58%에서 63%입니다. 이 터미널 숫자는 xAI 출시 표의 38.0%와 20.3%가 아니고, 통합 하네스의 +4.5포인트도 아닙니다. 하네스와 강도가 다르면 Terminal-Bench 세 읽기는 동시에 사실일 수 있습니다.
추가 토큰이 다시 할 긴 실행을 살 때 Grok 4.7을 씁니다. 강도 라벨을 건너뛴 지수 +2가 대략 두 배 출력의 값이 아니면 Grok 4.6에 남습니다.
사양과 가격 한눈에
2026년 9월 22일 두 모델 카드에서 확인했습니다. 카드의 “더 높은 컨텍스트”는 요청이 20만 토큰을 넘는다는 뜻입니다. Cursor 문서는 256K 경계를 쓰며 이 표에 넣지 않습니다.
| 항목 | Grok 4.7 | Grok 4.6 | 이 행을 쓰는 법 |
|---|---|---|---|
| API 모델 ID | grok-4.7 | grok-4.6 | ID를 고정합니다. 비교에 latest 별칭을 쓰지 않습니다. |
| 컨텍스트 창 | 500,000 | 500,000 | 클라이언트는 더 짧게 열 수 있습니다. Cursor의 Grok 4.7 페이지는 표준 256K, 긴 컨텍스트 500K라고 씁니다. |
| 모달리티 | 텍스트와 이미지 입력, 텍스트 출력 | 텍스트와 이미지 입력, 텍스트 출력 | 이미지 크기 제한은 공유 문서에 있으며 ID를 고르는 이유가 아닙니다. |
| 입력 / 캐시 / 출력, 20만 이하 | 백만당 $2 / $0.50 / $6 | 백만당 $2 / $0.50 / $6 | 표시 단가가 같습니다. |
| 입력 / 캐시 / 출력, 20만 초과 | 백만당 $4 / $1 / $12 | 백만당 $4 / $1 / $12 | 긴 컨텍스트 배수도 같습니다. |
| 지식 컷오프 | 모델 색인에 May 2026 | 이날 연 카드에는 다시 적히지 않음 | 예전 글의 날짜를 가져오지 않습니다. |
| Fast | 발표문: 출력 속도 두 배, 가격 두 배인 빠른 변형. 벤치마크 행은 없음 | 이날 연 카드에는 없음 | 두 Fast 스위치를 같은 제품으로 보지 않습니다. |
xAI 출시 표도 두 Grok 열에 입력 $2, 출력 $6을 찍고, 옆에 GPT-5.6 Sol $4 / $20, Fable 5.1 $10 / $50을 둡니다. 표시 가격 비교입니다. 끝난 과제 비교가 아닙니다. Fable 5.1은 xAI 자신의 여러 행에서 여전히 앞섭니다. 그 트레이드오프는 Fable 5.1 리뷰의 자리이지, Grok가 그것을 대체했다는 주장이 아닙니다.
같은 날 연 Cursor Grok 4.7 문서는 중국어 cursor.com/cn/docs/models/grok-4-7로 넘어갔습니다. 페이지는 Grok 4.7을 Grok 4.6, Grok 4.5, Composer 2.5와 공유하는 사용량 풀에 넣습니다. 온디맨드 요율은 짧은 컨텍스트 API 카드와 같습니다. 입력 $2, 캐시 $0.50, 출력 $6입니다. Fast는 $4 / $1 / $12이고, Pro 이상에서 Fast가 기본 속도라고 페이지는 씁니다. 256K를 넘는 입력은 표준 2배, Fast는 표준 요율의 3배이며 상한은 500K입니다. Cursor 퍼센트와 API 달러는 다른 계량기입니다. 양쪽의 강도와 Fast를 고정한 뒤에 비교합니다.
벤치마크, 그리고 얼마나 믿을지
표는 두 개입니다. 첫째는 xAI 출시 표이고, 페이지가 실제로 찍은 강도 라벨을 그대로 둡니다. 둘째는 Artificial Analysis에서 강도가 맞는 점수와, 맞지 않는 지수입니다.
| xAI 출시 표, 2026-09-21 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| 열의 강도 라벨 | xHigh. DeepSWE는 high effort | High | Max | Max |
| 표시 가격, 백만당 입력 / 출력 | $2 / $6 | $2 / $6 | $4 / $20 | $10 / $50 |
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0% | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
그 표에서 Grok 4.7은 모든 행이 Grok 4.6보다 앞입니다. CursorBench, AA Briefcase, Terminal-Bench, HealthBench Professional에서는 Fable 5.1보다 앞이 아닙니다. GPT-5.6 Sol에 대해서는 점수 행 일곱 개 중 다섯 개에서 앞서고 DeepSWE와 HealthBench에서는 뒤집니다. 표본 수, 하네스, 신뢰구간은 페이지에 없습니다. 차트 설명은 벤치마크를 방향성 있는 공급자 결과라고 합니다.
같은 페이지의 CursorBench 산점도에 Grok 4.6은 없습니다. Grok 4.7은 가파른 강도 계단입니다. Extra High 46.3%, 과제당 약 $6.01, 출력 70,141토큰. High 43.9%, $4.69. Medium 41.6%, $3.49. Low 33.1%, $1.58입니다. 강도 라벨 없는 “Grok 4.7”은 점수 하나가 아닙니다.
| Artificial Analysis, 기사 날짜 2026-09-21 | Grok 4.7 | Grok 4.6 | 강도 쌍 | 말해도 되는 것 |
|---|---|---|---|---|
| Intelligence Index v4.3 | 46 | 44 | xhigh 대 high | +2점. 같은 단의 결과가 아님 |
| 지능 과제당 출력 토큰 | 약 81k | high 약 36k, xhigh 약 38k | 혼합 | 청구가 지수보다 더 움직임 |
| Coding Agent Index, Grok Build | 56 | 47 | xhigh 대 xhigh | 공급자 코딩 에이전트에서 +9 |
| DeepSWE v1.1, Grok Build | 73% | 65% | xhigh 대 xhigh | 출시 표의 71.0 / 65.2가 아님 |
| Terminal-Bench 4.0, Grok Build | 33% | 18% | xhigh 대 xhigh | xAI의 38.0 / 20.3이 아님 |
| SWE-Atlas-QnA, Grok Build | 63% | 58% | xhigh 대 xhigh | 터미널 점프보다 좁음 |
| AA-Briefcase Elo | 1,657 | high에서 1,546 | xhigh 대 high | 분석 품질은 오르고 발표 품질은 내림 |
| GDPval-AA Elo | 1,695 | high에서 1,605 | xhigh 대 high | 지식 작업은 향상. xAI 그림의 Fable 5.1은 1,735 |
| 환각률, AA-Omniscience | 29% | high에서 34% | xhigh 대 high | 정확도는 47% 대 48%로 남음 |
Grok Build가 중요하면 코딩 에이전트 블록을 읽습니다. 공유 하네스가 중요하면 지능 지수 블록을 읽습니다. “Grok가 10% 더 좋다”로 평균하지 마십시오. Hacker News에서는 왜 4.7 xhigh를 4.6 high와 비교하느냐는 질문이 나왔습니다. 그 스레드의 답은 4.6에 xhigh가 언제 생겼는지에서 갈립니다. Artificial Analysis는 Grok 4.6 xhigh 코딩 에이전트 점수를 발표하므로, 적어도 하나의 현재 평가에 그 라벨은 있습니다. 출시 표는 아직 쓰지 않습니다.
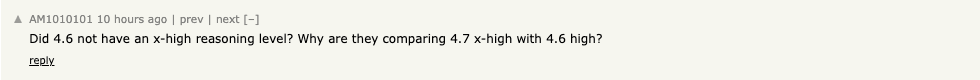
Grok 4.7이 실제로 벌어지는 곳
코딩 에이전트 안의 긴 실행
가장 깨끗한 향상은 강도가 맞은 쪽입니다. Grok Build에서 코딩 에이전트 지수는 9점 올랐고 구성 요소도 모두 올랐습니다. 터미널 작업이 가장 많이 움직여 그 하네스에서 18%에서 33%입니다. 실패 형태가 몇 시간짜리 저장소 작업이 중간에 멈추는 것이라면, 이 행이 파일럿의 이유입니다. Grok Build가 Claude Code나 Codex를 이긴다는 말은 아닙니다. Artificial Analysis는 Grok 4.7과 Grok Build를 네이티브 하네스 4위로 두었고, 앞은 Claude Fable 5.1, GPT-6 Astra, Claude Opus 5입니다.
xAI 자신의 Terminal-Bench 4.0, 20.3%에서 38.0%도 같은 방향이지만 강도 라벨은 맞지 않습니다. 18에서 33의 독립된 두 번째 측정이 아니라 공급자 쪽 뒷받침 증거로 봅니다.
문서와 분석. 발표 품질은 따로 본다
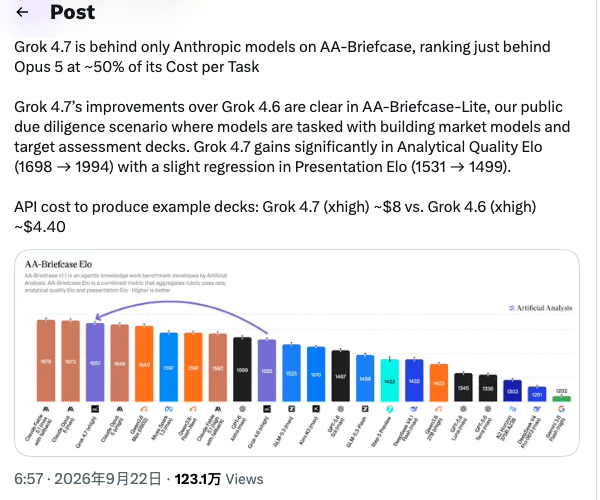
AA-Briefcase에서 Grok 4.7은 1,657 Elo로 Grok 4.6 high보다 111 높고, Artificial Analysis 서술에서는 Claude Opus 5와 Claude Fable 5.1 바로 뒤입니다. 분석 품질은 1,994 Elo 대 1,690입니다. 발표 품질은 1,499 대 1,519입니다. 분석은 나아지고 덱은 조금 나빠졌습니다.
공개 AA-Briefcase-Lite 실사 시나리오에서는 이 갈림이 더 분명합니다. 분석 Elo는 1,698에서 1,994, 발표 Elo는 1,531에서 1,499입니다. 예시 덱의 API 비용은 Grok 4.7 xhigh 약 $8, Grok 4.6 xhigh 약 $4.40입니다. 같은 강도이고 API 비용은 약 1.8배이며, 분석은 더 강하고 발표는 더 약합니다. 한 시나리오지 사무실 전체 벤치마크가 아닙니다. GDPval-AA는 high 대 xhigh에서 1,605에서 1,695 Elo로 움직였고, xAI GDPval 그림은 Fable 5.1 max를 1,735에 둡니다.
환각률은 낮아졌고 정확도는 높아지지 않았다
AA-Omniscience 환각률은 Grok 4.7 xhigh 29%, Grok 4.6 high 34%입니다. 정확도는 47% 대 48%입니다. 지수는 30에서 32로 움직였습니다. 자신 있는 오답을 줄이려면 실제 변화입니다. 정답을 더 원하면 이 쌍은 그것을 보여 주지 않습니다. 강도 라벨은 여전히 다릅니다.
Grok 4.6을 기본으로 둘 곳
짧은 작업. 추가 사고 자체가 비용이다
같은 단가로 약 두 배 출력을 사는 교환은, 그 출력이 재시도를 막을 때만 이득입니다. 범위가 정해진 추출, 짧은 패치, 상태 JSON에서는 Grok 4.6의 짧은 궤적이 기능입니다. 지능 토큰 차트를 본 Hacker News 독자는 이것을 토큰 효율 후퇴라고 불렀습니다. 그 댓글은 새 측정을 더하지 않습니다. 같은 Artificial Analysis 차트를 능력 향상이 아니라 비용 문제로 읽은 것입니다.

Artificial Analysis가 Grok 4.6 high 대비 후퇴로 짚은 AA-LCR과 AutomationBench-AA에서는 4.6을 떠날 이유가 없습니다. 절대 점수는 공개되지 않았으므로 하락 폭은 발표된 차이뿐입니다. 3.7포인트와 1.1포인트입니다.
Cursor 플랜. Fast와 강도를 고정하지 않았을 때
$2/$6 표시 단가는 Cursor Ultra 퍼센트를 설명하지 않습니다. Dynamix86의 시간은 사용자 한 명의 기록입니다. Grok 4.7은 퍼센트 포인트당 34분, 55분, 38분. 같은 날 더 이른 Grok 4.6은 133분과 101분. 둘 다 extra high이고 Fast는 꺼져 있습니다. 저자는 Artificial Analysis 차트를 코딩 에이전트 과제당 $8.82 대 $3.53으로도 읽었습니다. 그 달러는 저자의 차트 읽기입니다. 이 페이지를 위해 연 Artificial Analysis 기사 본문에는 그 문장이 없으므로 게시물에만 돌립니다.
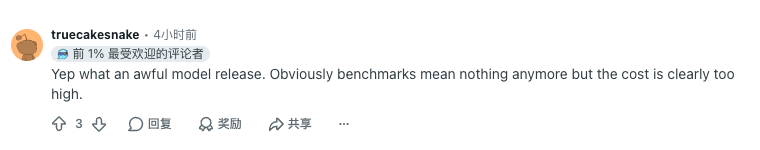
같은 스레드의 답은 더 직설적이었습니다. 벤치마크를 제쳐 두어도 비용이 분명히 너무 높아 이번 출시가 나빠 보인다는 내용입니다.
Cursor 문서도 Pro 이상에서 Fast가 기본이고 토큰 요율이 두 배라고 합니다. 개인 테스트의 한쪽만 Fast라면 2배 가격은 설정이지 모델 변경이 아닙니다. Reddit 기록은 Fast가 꺼져 있었다고 씁니다. 가벼운 비교는 대개 그렇게 하지 않습니다.
이미 Grok 4.6으로 받아들이는 작업
Grok 4.6 리뷰 노트 (English)는 이 단가의 500K 에이전트 모델을 이미 설명합니다. Grok 4.7은 API 카드에 새 컨텍스트 구간을 더하지 않고 표시 가격도 내리지 않습니다. 4.6이 이미 일을 끝내고 긴 터미널 작업이나 긴 문서에서 막히지 않았다면 업그레이드는 선택입니다. HealthBench Professional은 xAI 자신의 표에서 GPT-5.6 Sol과 Fable 5.1 뒤에 있습니다(56.7 대 60.5와 62.1). 임상 추론을 위한 전환도 이 이야기의 이유가 아닙니다.
사람들이 실제로 한 말
초기 댓글은 비용 쪽과 체감 쪽으로 갈립니다. 둘 다 몇 시간짜리입니다. 어느 쪽도 프롬프트, 저장소, 점수를 공개하지 않았습니다.
청구. Dynamix86의 약 2.5배 플랜 사용량과 truecakesnake의 “비용이 분명히 너무 높다”는 토큰 차트 옆에 둡니다. 다른 Hacker News 댓글 notduckrabbit는 같은 효율 차이를 가리켰습니다. 합치면, 출시 당일에 대량 경로를 옮기지 말라는 뜻입니다.
체감. 같은 오후 다른 r/cursor 댓글은 모델을 좋아했고 가격은 말하지 않았습니다.
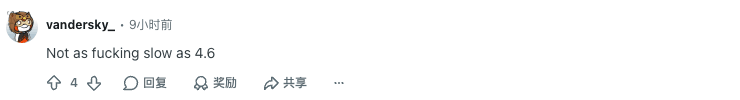
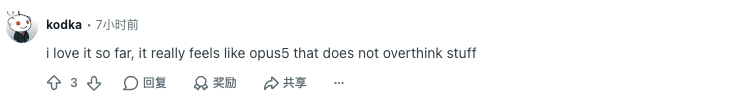
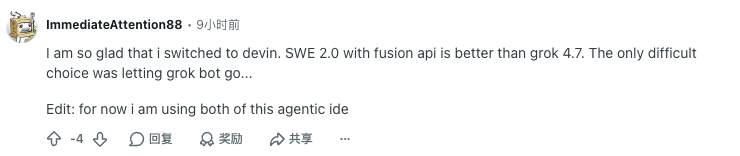
“더 빠르다”와 “과하게 생각하지 않는다”는 채팅에서는 맞고, 8.1만 토큰을 내는 xhigh 코딩 에이전트에서는 동시에 틀릴 수 있습니다. “4.6만큼 느리지 않다”에는 토큰 수가 붙지 않았습니다. Artificial Analysis는 긴 프롬프트에서 초당 약 188토큰, 지능 과제당 디코드 약 7.1분을 측정했습니다. 첫 토큰까지의 시간과 오버헤드는 뺍니다. 빠른 첫인상과 긴 에이전트 궤적은 같이 있을 수 있습니다.
2026년 9월 22일 YouTube에서 “Grok 4.7 vs Grok 4.6”을 검색하면 출시 해설이 나오고, 파라미터 수를 짐작하는 출시 전 영상도 있습니다. xAI 발표 페이지는 “새롭고 더 큰 기반 모델”이라고만 쓰며 파라미터 수는 없습니다. 영상 발언은 쓰지 않습니다.
어떻게 고를까
종합 승자는 없습니다. 작업 모양으로 고르고, 결정 안에 강도 라벨을 남깁니다.
| 작업 | 선택 | 이유 | 볼 것 |
|---|---|---|---|
| 짧은 추출, 분류, 작은 패치 | Grok 4.6 | 지수 향상은 작고 출력 궤적은 훨씬 짧다 | 한 줄 답에 xhigh를 내지 않는다 |
| 사용량 풀의 반복 Cursor 작업 | 실패하지 않으면 Grok 4.6 | Ultra 기록 하나가 extra high, Fast 끔에서 플랜 사용량 약 2.5배 | 모델을 탓하기 전에 Fast와 강도를 고정한다 |
| Grok Build나 비슷한 에이전트의 몇 시간 코딩 | Grok 4.7 xhigh를 시험 | 맞춰진 xhigh에서 Coding Agent Index 56 대 47 | 지수만이 아니라 끝난 과제를 비교한다 |
| 시장 모델, 메모, 목표 덱 | Grok 4.7을 시험한 뒤 덱을 고친다 | 분석 Elo는 오르고 발표 Elo는 내리며 예시는 약 $8 대 $4.40 | 슬라이드에 사람 검토를 한 번 둔다 |
| 20만 초과 긴 컨텍스트 API | 가격으로는 어느 쪽이든 같다 | 두 카드 모두 20만을 넘으면 요율이 두 배 | Cursor의 256K 경계는 다른 계량기 |
| Fable 수준의 CursorBench나 Terminal-Bench가 필요 | 이 쌍이 아님 | xAI 표에서 Fable 5.1 Max는 51.8%와 57.9% | 그 선택은 Grok가 아니라 Fable 가격 카드로 본다 |
실용 테스트는 채점법을 이미 아는 과제 하나입니다. 같은 강도, Fast 끔, 같은 하네스. 완료 여부, 사람 수정, 출력 토큰, API 달러 또는 플랜 비율을 적습니다. 한 번의 성공은 성공률이 아닙니다.
경로를 옮기기 전에 Tabbit에서 같은 과제를 실행한다
벤치마크 한 행은 내 탭, 문서, 끝나지 않은 조사에서 모델이 어떻게 움직이는지 말하지 않습니다. Tabbit Browser는 그 확인의 작업 공간입니다. 모델은 이미 읽고 있는 페이지 옆에 둘 수 있습니다. 그 페이지를 보지 못하는 별도 채팅에 둘 필요가 없습니다. 에이전트 브라우저 가이드와 에이전트 추론 가이드는 모델 점수와 끝난 여러 단계 흐름을 나눕니다. AI 브라우저 비교와 Tabbit 브라우저 가이드는 모델 바깥의 제품입니다. Tabbit이 원하는 클라이언트가 아니면 2026 AI 브라우저 정리가 더 넓은 집합입니다.
두 Grok ID는 Tabbit에 등록되어 있습니다. 선택기에 Grok 4.7이나 Grok 4.6이 나오는지는 계정과 현재 목록에 달렸습니다. 이 글에는 Tabbit 기록, 토큰 로그, 승자가 없습니다. 두 ID가 있으면 채점법을 아는 과제 하나를 강도와 도구를 같게 실행하고, 변화가 궤적 길이뿐이라면 Grok 4.6을 남깁니다. Tabbit 실천 가이드는 브라우저에서의 일하는 방식이지, 모든 계정에 특정 Grok가 미리 설치되어 있다는 주장이 아닙니다.
API 표시 가격, Cursor 사용량 풀, Tabbit 이용 가능 여부는 서로 다른 청구 세 가지입니다. 더하지 마십시오.
 Tabbit Browser

자주 묻는 질문
Grok 4.7이 Grok 4.6보다 더 낫습니까?
과제와 추론 강도에 달렸습니다. Artificial Analysis의 Coding Agent Index에서 Grok 4.7 xhigh와 Grok Build는 56, Grok 4.6 xhigh는 47입니다. Intelligence Index는 Grok 4.6 high의 44에서 Grok 4.7 xhigh의 46으로만 움직였고, 일부 비에이전트 과제는 후퇴했습니다. 종합 승자는 없습니다.
Grok 4.7과 Grok 4.6 가격은 같습니까?
2026년 9월 22일에 연 xAI 모델 카드에서 둘 다 컨텍스트 20만 이하는 입력 백만 토큰 $2, 캐시 입력 $0.50, 출력 $6이고, 20만 초과는 $4, $1, $12입니다. Cursor는 별도의 사용량 풀과 Fast를 적습니다. 표시 단가가 같다고 끝난 과제의 비용까지 같은 것은 아닙니다.
토큰 단가가 그대로인데 Grok 4.7이 더 비쌀 수 있는 이유는 무엇입니까?
Artificial Analysis는 Intelligence Index 과제당 출력 토큰을 Grok 4.7 xhigh 약 81,000, Grok 4.6 high 약 36,000, Grok 4.6 xhigh 약 38,000으로 측정했습니다. 출력 백만 토큰 $6이면 출력만 약 $0.49 대 $0.22 또는 $0.23입니다. 입력, 캐시, 도구, 재시도는 빼기 전입니다.
어떤 Grok 4.7 벤치마크 향상이 같은 추론 강도입니까?
Coding Agent Index 비교는 xhigh 대 xhigh입니다. 56 대 47이고, Grok Build 안에서 DeepSWE 73% 대 65%, Terminal-Bench 4.0 33% 대 18%, SWE-Atlas-QnA 63% 대 58%입니다. xAI 출시 표는 Grok 4.7 xHigh와 Grok 4.6 High를 비교하고, 그 표의 DeepSWE는 4.7을 high effort로 표시합니다. 그 행을 같은 단의 실험으로 보지 마십시오.
Cursor에서 Grok 4.6을 Grok 4.7로 바꿔야 합니까?
긴 코딩이나 문서 과제는 사용량이 더 빨리 줄어드는 것을 받아들일 수 있을 때 시험합니다. Cursor Ultra 사용자 한 명이 extra high, Fast 끔에서 플랜 사용량이 약 2.5배라고 보고 대부분의 작업을 4.6으로 되돌리겠다고 했습니다. 4.7이 더 빠르거나 덜 과하게 생각한다는 초기 댓글도 있습니다. 비교 전에 강도와 Fast를 고정하십시오.
Tabbit Browser에서 Grok 4.7과 Grok 4.6을 비교할 수 있습니까?
두 모델 모두 Tabbit 모델 페이지가 있습니다. 선택기에 나오는지는 계정과 현재 목록에 달렸습니다. 이 글에는 같은 과제의 Tabbit 실행이 없으므로, 선택기에 이름이 있다는 사실만으로 어떤 작업 흐름의 승자가 되지는 않습니다.