
任务又长、又依赖工具、而且你愿意为更长的 token 账单付钱时,Grok 4.7 值得拿来试点。日常短任务仍应默认 Grok 4.6。API 标价没有变。
xAI 在 2026 年 9 月 21 日发布 Grok 4.7,并写它与 Grok 4.6 同价、同速。9 月 22 日打开的两张模型卡,在费率和 50 万上下文上是一致的。它们没有证明做完一个任务的花费也一样。Artificial Analysis 以 xhigh 评测 Grok 4.7,智能指数每题大约 8.1 万输出 token,Grok 4.6 在 high 档大约 3.6 万。决定要不要换模型的是这个数字,不是单价。(xAI 发布页,Grok 4.7 模型卡,Grok 4.6 模型卡,Artificial Analysis)
Cursor 里马上出现了同一组张力。9 月 21 日,u/Dynamix86 写道:同一个 Ultra 账号、extra high、关闭 Fast,同一项未公开的任务上,Grok 4.7 打掉套餐百分比的速度大约是 Grok 4.6 的 2.5 倍,多数工作会改回 4.6。
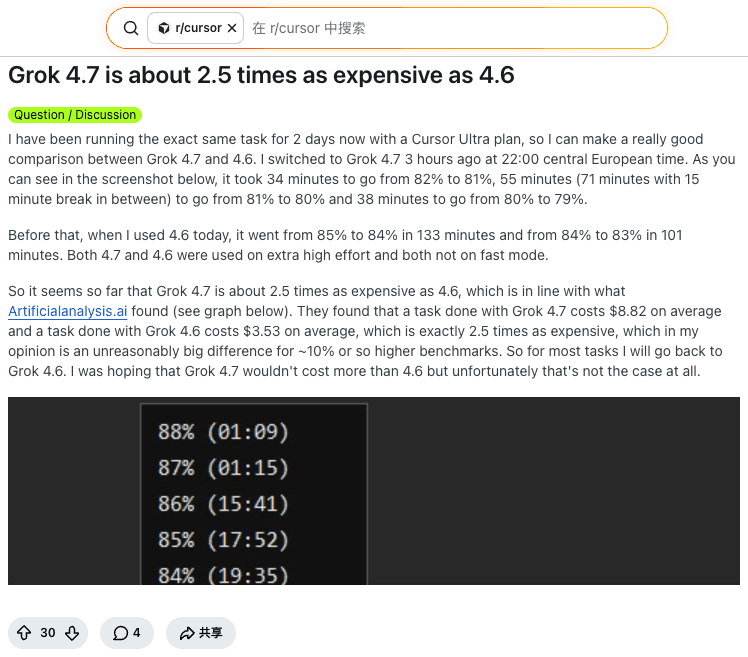
这是一个账号、一项任务。它不能证明 API 账单,也不能证明回答质量。它说明“同价”不是该先问的问题。Grok 4.6 总览 讲的是上一代本身。本页只处理两者怎么选。规格入口在 Grok 4.7 模型页 和 Grok 4.6 模型页。
要点
两张 API 卡在 20 万上下文以内都是每百万 token $2 / 缓存 $0.50 / 输出 $6,超过 20 万是 $4 / $1 / $12。上下文窗口都是 50 万。
Grok 4.7 xhigh 每道智能指数题约 8.1 万输出 token,Grok 4.6 high 约 3.6 万,Grok 4.6 xhigh 约 3.8 万。按输出 $6 计算,仅输出大约 $0.49 对 $0.22–$0.23。
智能指数 +2,而且是 xhigh 对 high(46 对 44)。编码代理指数 +9,两边都是 xhigh,且都在 Grok Build 里(56 对 47)。
xAI 发布表每一行都高于 Grok 4.6,但列头是 Grok 4.7 xHigh 和 Grok 4.6 High。表上 DeepSWE 把 4.7 标成 high effort。这些差距不是同档实验。
短而重复的工作留在 Grok 4.6。只有当长编码或长文档在 4.6 上经常失败、失败成本盖过额外 token 时,再试点 Grok 4.7。
本文没有 Tabbit 同题运行。模型页不是实测胜负。
决定这篇对比的数字:同为 $2/$6,输出大约 8.1 万对 3.6 万 token
发布标题写 Grok 4.7 “比同类模型快一倍、价格一半”,正文又写它与 Grok 4.6 同价同速。前一句没有点名比较对象,也没有速度单位。后一句才是费率卡能支持的说法。
变的是新模型花掉多少 token。Artificial Analysis 写 Grok 4.7 xhigh 每道智能指数题大约 8.1 万输出 token,Grok 4.6 high 大约 3.6 万,他们称为多 125%。同一篇文章后文又写,8.1 万是 Grok 4.6 xhigh 约 3.8 万的两倍多。两个对照都要留着。3.6 万不是同档对比。3.8 万才是。
每道智能指数题的输出 token(Artificial Analysis,2026-09-21)
Grok 4.7 xhigh     约 8.1 万
Grok 4.6 high      约 3.6 万    (token 多 125%,档位更高)
Grok 4.6 xhigh     约 3.8 万    (同档,token 超过 2 倍)

按共享的每百万输出 $6,只算输出
8.1 万 × $6 / 100 万  ≈  $0.49
3.6 万 × $6 / 100 万  ≈  $0.22
3.8 万 × $6 / 100 万  ≈  $0.23
这不是发票。它没算输入、缓存命中、工具调用、重试,也没算按套餐百分比而不是 API 美元计费的客户端。它也没说明这些 token 买到了什么分数。
智能指数从 Grok 4.6 high 的 44 分到 Grok 4.7 xhigh 的 46 分。代理式知识工作之外,Artificial Analysis 认为 Grok 4.7 大体对齐 Grok 4.6 high:Terminal-Bench 4.0 高 4.5 个百分点,GDP.pdf 高 3.0 个百分点,AA-LCR 低 3.7 个百分点,AutomationBench-AA 低 1.1 个百分点。这四项的绝对分没有印在正文里。
移动更大的是编码代理指数,而且档位对齐。Grok 4.7 xhigh 加 Grok Build 为 56,Grok 4.6 xhigh 加 Grok Build 为 47。该 harness 内 DeepSWE v1.1 从 65% 到 73%,Terminal-Bench 4.0 从 18% 到 33%,SWE-Atlas-QnA 从 58% 到 63%。这些终端数字不是发布表上的 38.0% 和 20.3%,也不是统一 harness 里的 +4.5 个百分点。三组 Terminal-Bench 可以同时为真,只要 harness 和档位不同。
额外 token 能少一次返工时,用 Grok 4.7。如果跨档位的 +2 分指数不值得大约两倍输出,留在 Grok 4.6。
规格和价格一览
2026 年 9 月 22 日核对两张模型卡。“更高上下文”指请求超过 20 万 token。Cursor 文档用的是 25.6 万这条边界,不在本表里。
| 维度 | Grok 4.7 | Grok 4.6 | 怎么用这一行 |
|---|---|---|---|
| API 模型 ID | grok-4.7 | grok-4.6 | 固定 ID。对比时不要用 latest 别名。 |
| 上下文窗口 | 500,000 | 500,000 | 客户端可以暴露得更短。Cursor 的 Grok 4.7 页写标准 256K、长上下文 500K。 |
| 模态 | 文本和图像输入,文本输出 | 文本和图像输入,文本输出 | 图像大小限制在共享文档里,不是挑选 ID 的理由。 |
| 输入 / 缓存 / 输出,不超过 20 万 | 每百万 $2 / $0.50 / $6 | 每百万 $2 / $0.50 / $6 | 标价相同。 |
| 输入 / 缓存 / 输出,超过 20 万 | 每百万 $4 / $1 / $12 | 每百万 $4 / $1 / $12 | 长上下文倍率也相同。 |
| 知识截止 | 模型索引写 May 2026 | 本次打开的模型卡没有重述 | 不要把旧文的截止日期抄过来。 |
| Fast | 发布页:输出速度两倍、价格两倍,没有基准行 | 本次打开的卡片没有写 | 不要把两个 Fast 开关当成同一产品。 |
xAI 发布表也给两列 Grok 印了输入 $2、输出 $6,旁边是 GPT-5.6 Sol 的 $4 / $20 和 Fable 5.1 的 $10 / $50。那是标价对照,不是做完任务的对照。Fable 5.1 在 xAI 自己的好几行上仍然领先;取舍写在 Fable 5.1 测评,不是“Grok 已经换掉它”。
同一天打开的 Cursor Grok 4.7 文档会跳到 cursor.com/cn/docs/models/grok-4-7。页上把 Grok 4.7 放进与 Grok 4.6、Grok 4.5、Composer 2.5 共享的用量池。按需价格与短上下文 API 卡一致:输入 $2、缓存 $0.50、输出 $6。Fast 为 $4 / $1 / $12,且 Pro 及以上默认 Fast。输入超过 256K 时,标准按 2 倍、Fast 按标准费率的 3 倍计,直到 500K。Cursor 的百分比和 API 的美元是两把尺子。先把两边的档位和 Fast 固定,再比较。
基准,以及该信多少
下面两张表。第一张是 xAI 发布表,档位按页面原文。第二张是 Artificial Analysis:能对齐档位的分开放,不能对齐的标明。
| xAI 发布表,2026-09-21 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| 列头档位 | xHigh;DeepSWE 标为 high effort | High | Max | Max |
| 标价,每百万输入 / 输出 | $2 / $6 | $2 / $6 | $4 / $20 | $10 / $50 |
| CursorBench 4.0 | 46.3% | 40.4% | 41.7% | 51.8% |
| DeepSWE v1.1 | 71.0% | 65.2% | 72.7% | 70.0% |
| EEBench | 64.0% | 53.0% | 39.4% | 56.4% |
| AA Briefcase v1.1 | 1,657 | 1,546 | 1,487 | 1,678 |
| Terminal-Bench 4.0 | 38.0% | 20.3% | 37.3% | 57.9% |
| Harvey Legal Agent Benchmark | 19.6% | 15.8% | 2.5% | 6.7% |
| HealthBench Professional | 56.7% | 48.5% | 60.5% | 62.1% |
这张表上 Grok 4.7 每一行都高于 Grok 4.6。它没有在 CursorBench、AA Briefcase、Terminal-Bench、HealthBench Professional 上超过 Fable 5.1。对 GPT-5.6 Sol,七个分数行里它赢五行,DeepSWE 和 HealthBench 落后。页面没有样本量、harness 和置信区间。图注把这些基准写成厂商结果。
同一页的 CursorBench 散点图没有 Grok 4.6。Grok 4.7 的档位阶梯很陡:Extra High 46.3%,约每任务 $6.01、70,141 输出 token;High 43.9%,$4.69;Medium 41.6%,$3.49;Low 33.1%,$1.58。不写档位的“Grok 4.7”不是一个分数。
| Artificial Analysis,文章日期 2026-09-21 | Grok 4.7 | Grok 4.6 | 档位 | 可以怎么说 |
|---|---|---|---|---|
| Intelligence Index v4.3 | 46 | 44 | xhigh 对 high | +2,不是同档 |
| 每道智能题输出 token | 约 8.1 万 | high 约 3.6 万;xhigh 约 3.8 万 | 混合 | 账单比指数动得大 |
| Coding Agent Index,Grok Build | 56 | 47 | xhigh 对 xhigh | 一方编码代理 +9 |
| DeepSWE v1.1,Grok Build | 73% | 65% | xhigh 对 xhigh | 不是发布表的 71.0 / 65.2 |
| Terminal-Bench 4.0,Grok Build | 33% | 18% | xhigh 对 xhigh | 不是 xAI 的 38.0 / 20.3 |
| SWE-Atlas-QnA,Grok Build | 63% | 58% | xhigh 对 xhigh | 升幅小于终端题 |
| AA-Briefcase Elo | 1,657 | high 为 1,546 | xhigh 对 high | 分析质量升,展示质量降 |
| GDPval-AA Elo | 1,695 | high 为 1,605 | xhigh 对 high | 知识工作有提升;xAI 图上 Fable 5.1 为 1,735 |
| 幻觉率,AA-Omniscience | 29% | high 为 34% | xhigh 对 high | 准确率仍是 47% 对 48% |
关心 Grok Build 时读编码代理那一块。关心统一 harness 时读智能指数那一块。不要合成一句“Grok 好了 10%”。Hacker News 上有人直接问:为什么拿 4.7 xhigh 比 4.6 high?该楼回复对 4.6 何时有 xhigh 并不一致。Artificial Analysis 的编码指数确实有 Grok 4.6 xhigh,所以至少有一套当前评测使用这个标签。发布表仍然没用它。
Grok 4.7 真正拉开差距的地方
编码代理里的长任务
最干净的提升是档位对齐的那一组。Grok Build 上编码代理指数高 9 分,三个分项都上升。终端任务升得最多,该 harness 里从 18% 到 33%。如果你的失败模式是多小时仓库任务中途停住,这一行值得试点。它没有说 Grok Build 会胜过 Claude Code 或 Codex。Artificial Analysis 把 Grok 4.7 加 Grok Build 排在原生 harness 的第四,后面是第一名到第三名:Claude Fable 5.1、GPT-6 Astra、Claude Opus 5。
xAI 自己的 Terminal-Bench 4.0 从 20.3% 到 38.0%,方向一致,但档位不对齐。把它当作厂商侧证,不要当成 18 到 33 的另一次独立测量。
文档和分析,展示质量要单独看
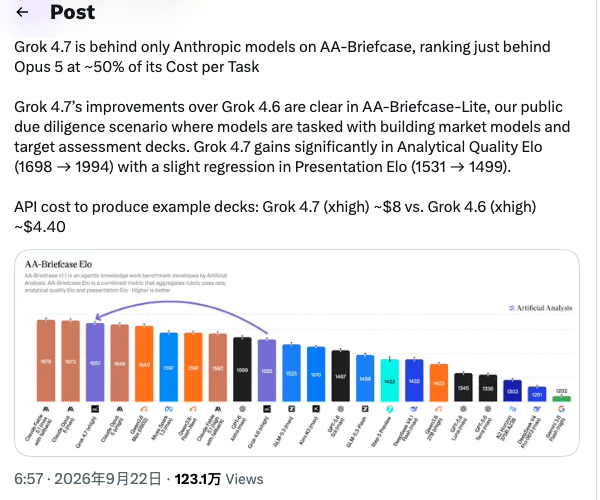
AA-Briefcase 上 Grok 4.7 为 1,657 Elo,比 Grok 4.6 high 高 111,在 Artificial Analysis 的写法里紧跟 Claude Opus 5 和 Claude Fable 5.1。分析质量 1,994 对 1,690。展示质量 1,499 对 1,519。分析更好,幻灯片略差。
公开的 AA-Briefcase-Lite 尽职调查场景把这个分裂写得更明确:分析 Elo 从 1,698 到 1,994,展示 Elo 从 1,531 到 1,499。示例演示稿的 API 成本,Grok 4.7 xhigh 约 $8,Grok 4.6 xhigh 约 $4.40。这是同档,大约 1.8 倍成本,换来更强的分析和更弱的展示。它是一个场景,不是全部办公室基准。GDPval-AA 在 high 对 xhigh 的对照里从 1,605 到 1,695;xAI 的 GDPval 图上 Fable 5.1 max 为 1,735。
幻觉率更低,准确率没有更高
AA-Omniscience 幻觉率是 Grok 4.7 xhigh 的 29%,Grok 4.6 high 的 34%。准确率是 47% 对 48%。指数从 30 到 32。如果你要的是更少的自信错答,这是变化。如果你要的是更多答对,这组数字没有显示。档位仍然不同。
Grok 4.6 仍然该当默认的地方
短任务:多出来的思考本身就是成本
同价买大约两倍输出,只有在这些 token 能少一次返工时才划算。有界抽取、小补丁、状态 JSON,Grok 4.6 更短的轨迹才是优点。看过智能指数 token 图的 Hacker News 读者把这称为 token 效率退步。这条评论没有新测量,它是把同一张 Artificial Analysis 图读成成本问题,而不是能力升级。

Artificial Analysis 点名相对 Grok 4.6 high 退步的 AA-LCR 和 AutomationBench-AA,没有理由离开 4.6。绝对分没公布,所以降幅只按已发表的 3.7 和 1.1 个百分点理解。
Cursor 套餐:如果 Fast 和档位没固定
$2/$6 的标价描述不了 Cursor Ultra 的百分比。Dynamix86 的计时是单人日志:Grok 4.7 每掉 1 个百分点用了 34、55、38 分钟,当天更早的 Grok 4.6 是 133 和 101 分钟,两边都是 extra high 且关闭 Fast。作者还把一张 Artificial Analysis 图读成编码代理每任务 $8.82 对 $3.53。这两个美元数是作者的读图。为本页打开的 Artificial Analysis 文章正文没有这两句,所以它们只属于那篇帖子。
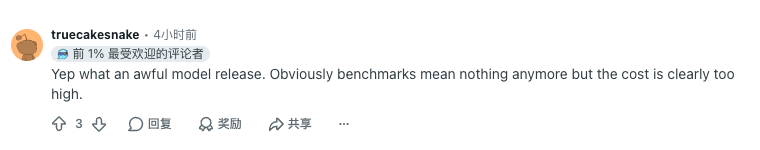
同一帖的一条回复更直接:就算先不谈基准,这个发布的成本也明显太高。
Cursor 文档还写 Pro 及以上默认 Fast,token 费率加倍。如果个人测试一边开了 Fast、另一边没有,两倍价格是设置,不是换模型。Reddit 这条日志写了 Fast 关闭。随意对比常常不会这么做。
你已经接受 Grok 4.6 的那些工作
Grok 4.6 的测评笔记已经描述过这个价位上的 50 万上下文代理模型。Grok 4.7 没有在 API 卡上增加新的上下文档位,也没有降价。如果 4.6 已经做完,而且你没有卡在长终端任务或长文档上,升级是可选的。HealthBench Professional 在 xAI 自己的表上仍落后于 GPT-5.6 Sol 和 Fable 5.1(56.7 对 60.5 和 62.1),临床推理也不是这次切换的理由。
人们实际怎么说
早期评论分成账单阵营和手感阵营。两边都只有几小时。两边都没有公布提示词、仓库或评分。
账单。 Dynamix86 大约 2.5 倍的套餐用量,加上 truecakesnake 的“成本明显太高”,和 token 图放在一起。Hacker News 的 notduckrabbit 指向同一个效率差。合在一起的意思是:不要在发布当天迁移高流量路线。
手感。 同一天下午的另一些 r/cursor 评论喜欢这个模型,而且没提价格。
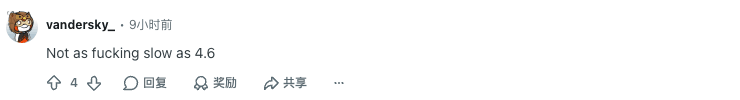
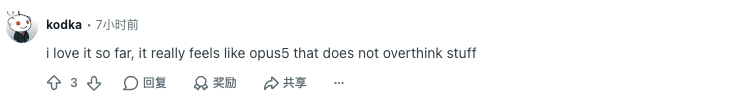
“更快”和“没那么过度思考”可以在一次聊天里成立,同时在吐出 8.1 万 token 的 xhigh 编码代理里不成立。“没有 4.6 那么慢”没有配 token 数。Artificial Analysis 在长提示上测到大约每秒 188 token,每道智能指数题大约 7.1 分钟解码时间,不含首 token 和额外开销。第一印象很快,和一条很长的代理轨迹,可以同时存在。
2026 年 9 月 22 日在 YouTube 搜索 “Grok 4.7 vs Grok 4.6”,出来的是发布解说,其中还有发布前猜测参数量的视频。xAI 发布页只写“新的、更大的基座”,没有参数量。这里不引用视频口播。
怎么选
没有总冠军。按工作形状选,并把推理档位写进决定里。
| 工作负载 | 选择 | 原因 | 要盯住什么 |
|---|---|---|---|
| 短抽取、分类或小补丁 | Grok 4.6 | 指数提升小,输出轨迹短得多 | 不要为一句回答付 xhigh |
| Cursor 用量池上的重复工作 | 任务没失败就留 Grok 4.6 | 一份 Ultra 日志在 extra high、关闭 Fast 时大约 2.5 倍用量 | 先固定 Fast 和档位,再怪模型 |
| Grok Build 或同类代理里的多小时编码 | 试点 Grok 4.7 xhigh | 同档编码指数 56 对 47 | 比做完的任务,不只比指数 |
| 市场模型、备忘录、目标评估演示稿 | 试点 Grok 4.7,然后改幻灯片 | 分析 Elo 上升,展示 Elo 下滑;示例稿约 $8 对 $4.40 | 幻灯片留一轮人工 |
| 超过 20 万的长上下文 API | 价格上两者一样 | 两张卡超过 20 万都加倍 | Cursor 的 256K 边界是另一把尺子 |
| 你需要 Fable 那种 CursorBench 或 Terminal-Bench | 不是这一对 | Fable 5.1 Max 在 xAI 表上是 51.8% 和 57.9% | 用 Fable 的价卡,不用 Grok 的 |
实用测试是一道你已经知道怎么打分的任务:同档、关闭 Fast、同一 harness。记下是否做完、人工修改、输出 token,以及 API 美元或套餐百分比。一次做对不是成功率。
迁移整条路线之前,先在 Tabbit 里跑同一道题
基准行不会告诉你模型在你的标签页、文档和没做完的调研里是什么样。Tabbit Browser 是做这次检查的工作台:模型可以挨着你正在读的页面,而不是待在一个看不见这些页面的聊天窗口里。代理浏览器指南和代理推理指南把模型分数和做完的多步流程分开。AI 浏览器对比和 Tabbit 浏览器指南讲的是模型外面的产品。如果 Tabbit 不是你要的客户端,2026 AI 浏览器盘点是更大的集合。
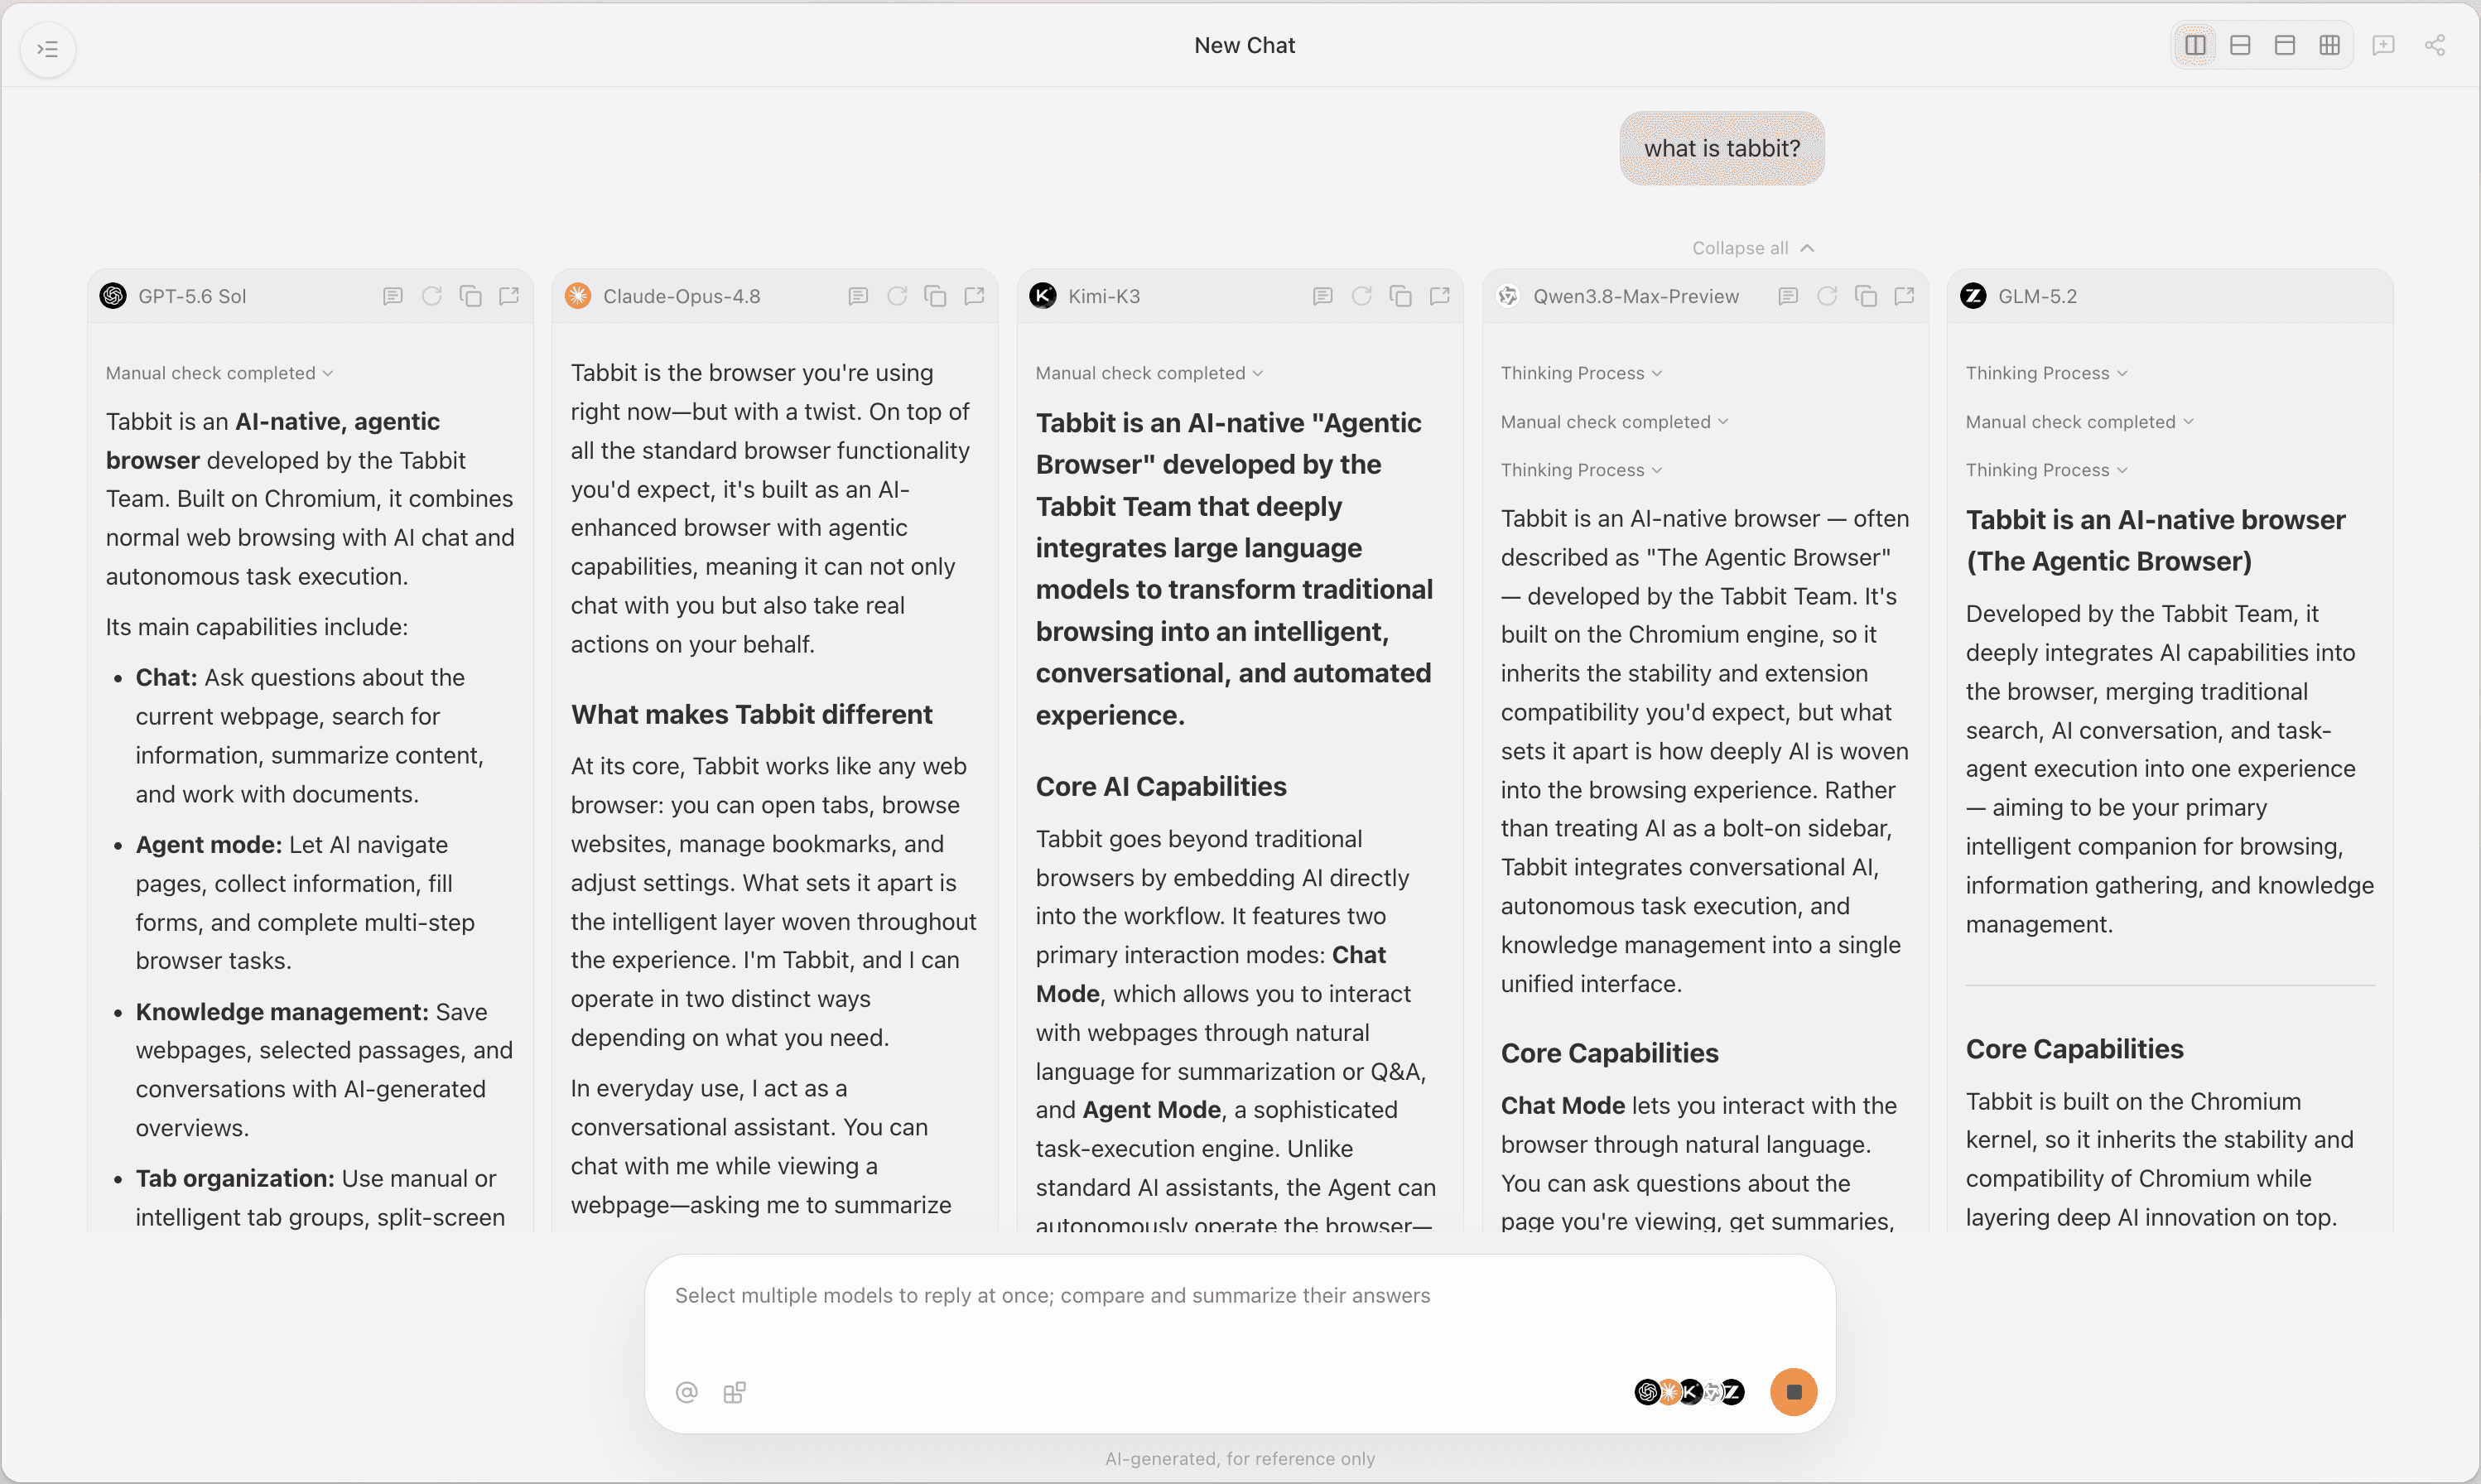
两个 Grok ID 都已在 Tabbit 注册。选择器里有没有 Grok 4.7 或 Grok 4.6,取决于账号和当前列表。本文没有 Tabbit 记录、token 日志或胜者。如果两个 ID 都在,就拿一道你知道怎么打分的任务,档位和工具保持一致;如果变化只是轨迹更长,就留在 Grok 4.6。Tabbit 实践指南讲的是浏览器里的工作方式,不是说每个账号都预装了某一个 Grok。
API 标价、Cursor 用量池和 Tabbit 的使用权限是三笔不同的账。不要加在一起。
 Tabbit Browser

常见问题
Grok 4.7 比 Grok 4.6 更好吗?
要看任务和推理档位。Artificial Analysis 的 Coding Agent Index 上,Grok 4.7 xhigh 配 Grok Build 是 56 分,Grok 4.6 xhigh 是 47 分。智能指数只从 Grok 4.6 high 的 44 分到 Grok 4.7 xhigh 的 46 分,而且有些非代理任务是退步的。没有总冠军。
Grok 4.7 和 Grok 4.6 价格一样吗?
2026 年 9 月 22 日打开的 xAI 模型卡上,两者在 20 万上下文以内都是输入 $2、缓存输入 $0.50、输出 $6,超过 20 万则是 $4、$1、$12。Cursor 另有用量池和 Fast 档。标价相同不等于做完一个任务的花费相同。
单价没变,为什么 Grok 4.7 可能更贵?
Artificial Analysis 测得 Grok 4.7 xhigh 每道智能指数题约 8.1 万输出 token,Grok 4.6 high 约 3.6 万,Grok 4.6 xhigh 约 3.8 万。按每百万输出 $6 计算,仅输出大约是 $0.49 对 $0.22 或 $0.23,还没算输入、缓存、工具和重试。
哪些 Grok 4.7 的基准提升是同一推理档位?
编码代理指数是 xhigh 对 xhigh:56 对 47。Grok Build 里 DeepSWE 73% 对 65%,Terminal-Bench 4.0 33% 对 18%,SWE-Atlas-QnA 63% 对 58%。xAI 发布表是 Grok 4.7 xHigh 对 Grok 4.6 High,而且表上的 DeepSWE 把 4.7 标成 high effort。不要把这些行当成同档实验。
在 Cursor 里要从 Grok 4.6 换成 Grok 4.7 吗?
长编码或长文档可以试点,但要接受用量掉得更快。一位 Cursor Ultra 用户在 extra high、关闭 Fast 的条件下,估计套餐用量大约是 2.5 倍,并准备把多数任务改回 4.6。也有人觉得 4.7 更快、没那么过度思考。比较前先固定档位和 Fast。
能在 Tabbit 浏览器里对比 Grok 4.7 和 Grok 4.6 吗?
两个模型都有 Tabbit 模型页。选择器里是否出现,取决于账号和当前模型列表。本文没有同题实测,所以选择器里有这个名字,不能当成某个工作流已经分出胜负。