
Grok 4.7 est le modèle à essayer quand la tâche est longue, riche en outils, et qu’une facture de tokens plus élevée se justifie. Grok 4.6 reste le choix par défaut quand le travail est routinier et que vous voulez la trace la plus courte. Le tarif affiché de l’API n’a pas changé.
xAI a publié Grok 4.7 le 21 septembre 2026 et a écrit qu’il est servi au même prix et à la même vitesse que Grok 4.6. Les fiches ouvertes le 22 septembre s’accordent sur le tarif et la fenêtre de 500K. Elles ne montrent pas qu’une tâche terminée coûte la même chose. Artificial Analysis, en évaluant Grok 4.7 en xhigh, a compté environ 81 000 tokens de sortie par tâche d’Intelligence Index, contre environ 36 000 pour Grok 4.6 en high. C’est ce chiffre qui décide du basculement. (lancement xAI, fiche Grok 4.7, fiche Grok 4.6, Artificial Analysis)
La même tension est apparue tout de suite dans Cursor. Le 21 septembre, u/Dynamix86 a écrit qu’un compte Ultra, en extra high et Fast désactivé, consommait le pourcentage du forfait environ 2,5 fois plus vite avec Grok 4.7 qu’avec Grok 4.6 sur la même tâche non nommée, et que la plupart du travail reviendrait à 4.6.
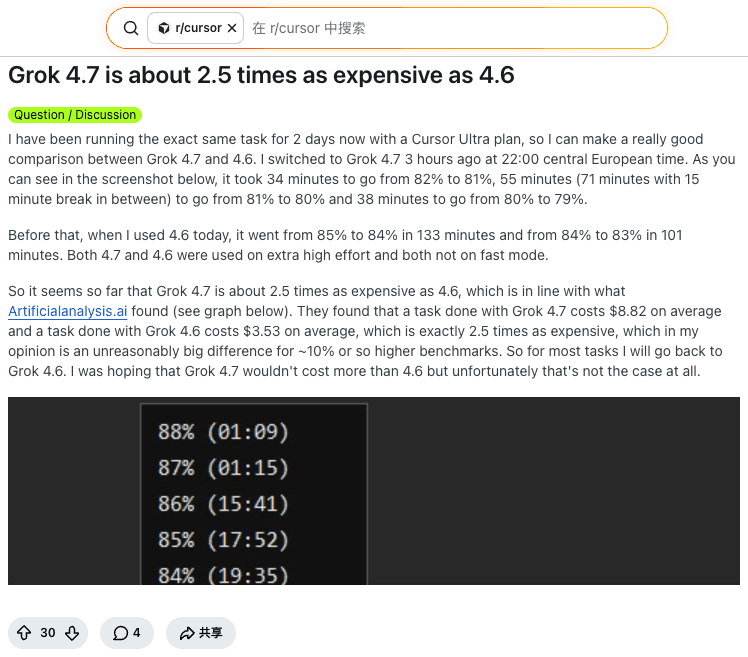
Cette publication, c’est un compte et une tâche. Elle ne prouve ni les factures d’API ni la qualité des réponses. Elle montre pourquoi « le même prix » est la mauvaise première question. La vue d’ensemble de Grok 4.6 porte sur le modèle précédent en lui-même. Cette page ne traite que le choix entre les deux. Les spécifications sont aussi sur la page Grok 4.7 (English) et la page Grok 4.6 (English).
À retenir
Les deux fiches API affichent 2 $ / 0,50 $ en cache / 6 $ par million de tokens sous 200K de contexte, et 4 $ / 1 $ / 12 $ au-dessus de 200K. La fenêtre de 500K est la même.
Grok 4.7 xhigh a utilisé environ 81k tokens de sortie par tâche d’intelligence Artificial Analysis, contre environ 36k pour Grok 4.6 high et environ 38k pour Grok 4.6 xhigh. Le calcul sortie seule à 6 $ donne environ 0,49 $ contre 0,22–0,23 $.
Le mouvement de l’Intelligence Index est de +2, et il compare xhigh à high (46 contre 44). Celui du Coding Agent Index est de +9 en xhigh aligné dans Grok Build (56 contre 47).
Le tableau de lancement xAI progresse sur chaque ligne listée, mais les colonnes sont Grok 4.7 xHigh et Grok 4.6 High. DeepSWE y est marqué high effort pour 4.7. Ces écarts ne sont pas une expérience du même barreau.
Gardez Grok 4.6 pour le travail court et répété. Essayez Grok 4.7 quand une longue exécution de code ou une tâche chargée de documents échoue assez souvent sur 4.6 pour payer les tokens en plus.
Aucune exécution Tabbit de la même tâche n’a été faite pour cet article. Une page de modèle n’est pas une victoire mesurée.
Le chiffre qui décide : même tarif 2 $/6 $, environ 81k contre 36k tokens de sortie
Le titre du lancement dit que Grok 4.7 est « deux fois plus rapide, à la moitié du prix des modèles comparables », et le corps dit qu’il est servi au même prix et à la même vitesse que Grok 4.6. La première phrase ne nomme ni les modèles comparables ni l’unité de vitesse. La seconde est celle que les fiches de tarif soutiennent.
Ce qui change, c’est le nombre de tokens dépensés par le modèle plus récent. Artificial Analysis a écrit que Grok 4.7 xhigh utilise environ 81k tokens de sortie par tâche d’Intelligence Index, contre 36k pour Grok 4.6 high, soit 125 % de plus selon eux. Plus loin dans le même article, 81k est plus du double des 38k utilisés par Grok 4.6 xhigh. Les deux comparaisons comptent. Le chiffre de 36k n’est pas une paire au même effort. Celui de 38k l’est.
Tokens de sortie par tâche d’Intelligence Index (Artificial Analysis, 21 sept. 2026)
Grok 4.7 xhigh     ~81k
Grok 4.6 high      ~36k     (+125 % de tokens, étiquette d’effort plus haute)
Grok 4.6 xhigh     ~38k     (plus de 2× tokens, même étiquette d’effort)

Coût sortie seule au tarif partagé de 6 $ / 1M
81k × 6 $ / 1M  ≈  0,49 $
36k × 6 $ / 1M  ≈  0,22 $
38k × 6 $ / 1M  ≈  0,23 $
Ce calcul n’est pas une facture. Il ignore les tokens d’entrée, les hits de cache, les appels d’outils, les reprises, et tout client qui facture un pourcentage de forfait plutôt que l’API. Il ignore aussi le score que ces tokens ont acheté.
Sur l’Intelligence Index, le score est passé de 44 pour Grok 4.6 high à 46 pour Grok 4.7 xhigh. En dehors du travail de connaissance agentique, Artificial Analysis a dit que Grok 4.7 rejoignait globalement Grok 4.6 high, avec Terminal-Bench 4.0 à +4,5 points et GDP.pdf à +3,0 points, et des reculs sur AA-LCR (−3,7 points) et AutomationBench-AA (−1,1 point). Les scores absolus de ces quatre lignes ne sont pas imprimés dans le texte.
Le mouvement plus large est l’indice d’agent de code, et c’est une comparaison au même effort. Grok 4.7 xhigh avec Grok Build obtient 56, contre 47 pour Grok 4.6 xhigh avec Grok Build. Dans ce harness, DeepSWE v1.1 passe de 65 % à 73 %, Terminal-Bench 4.0 de 18 % à 33 %, et SWE-Atlas-QnA de 58 % à 63 %. Ces chiffres de terminal ne sont pas les 38,0 % et 20,3 % du tableau de lancement xAI, ni le delta de +4,5 points du harness unifié. Trois lectures de Terminal-Bench peuvent toutes être vraies si le harness et l’effort diffèrent.
Utilisez Grok 4.7 quand les tokens en plus achètent une longue exécution que vous referiez autrement. Restez sur Grok 4.6 quand un indice +2, mesuré à travers des étiquettes d’effort différentes, ne vaut pas environ le double de sortie.
Spécifications et prix d’un coup d’œil
Vérifié le 22 septembre 2026 sur les deux fiches. « Higher context » sur ces fiches signifie une requête au-dessus de 200K tokens. La documentation Cursor utilise une limite de 256K et n’est pas ce tableau.
| Dimension | Grok 4.7 | Grok 4.6 | Comment lire la ligne |
|---|---|---|---|
| ID du modèle API | grok-4.7 | grok-4.6 | Fixez l’ID. N’utilisez pas un alias « latest » pour comparer. |
| Fenêtre de contexte | 500 000 | 500 000 | Un client peut en exposer moins. La page Grok 4.7 de Cursor décrit 256K en standard et 500K en contexte long. |
| Modalités | Texte et image en entrée, texte en sortie | Texte et image en entrée, texte en sortie | Les limites de taille d’image sont dans la doc partagée, pas une raison de choisir un ID. |
| Entrée / cache / sortie, jusqu’à 200K | 2 $ / 0,50 $ / 6 $ par 1M | 2 $ / 0,50 $ / 6 $ par 1M | Même tarif affiché. |
| Entrée / cache / sortie, au-dessus de 200K | 4 $ / 1 $ / 12 $ par 1M | 4 $ / 1 $ / 12 $ par 1M | Le multiplicateur de long contexte est le même. |
| Coupure de connaissance | Mai 2026, sur l’index des modèles | Non reprise sur la fiche ouverte ce jour | Ne recopiez pas une coupure plus ancienne. |
| Option Fast | Article de lancement : une variante rapide à deux fois la vitesse de sortie et deux fois le prix, sans ligne de benchmark | Absente de la fiche ouverte ce jour | Ne supposez pas que les deux interrupteurs Fast sont le même produit. |
Le tableau de lancement xAI imprime aussi 2 $ d’entrée et 6 $ de sortie pour les deux colonnes Grok, à côté de GPT-5.6 Sol à 4 $ / 20 $ et de Fable 5.1 à 10 $ / 50 $. C’est une comparaison de tarifs affichés. Ce n’est pas une comparaison de tâches terminées. Fable 5.1 mène encore plusieurs lignes propres à xAI ; le test de Fable 5.1 est l’endroit pour ces arbitrages, pas une affirmation que Grok l’a remplacé.
La documentation Cursor de Grok 4.7, ouverte le même jour et servie en chinois à cursor.com/cn/docs/models/grok-4-7, place Grok 4.7 dans un pool d’usage avec Grok 4.6, Grok 4.5 et Composer 2.5. Les tarifs à la demande affichés rejoignent la fiche API de contexte court : 2 $ d’entrée, 0,50 $ en cache, 6 $ de sortie. Fast est listé à 4 $ / 1 $ / 12 $, et la page dit que Fast est la vitesse par défaut à partir de Pro. L’entrée au-delà de 256K est facturée à 2× en standard et à 3× le tarif standard en Fast, jusqu’à 500K. Un pourcentage Cursor et un dollar d’API sont deux compteurs différents. Comparez-les seulement après avoir fixé l’effort et Fast des deux côtés.
Les benchmarks, et ce qu’on peut en tirer
Deux tableaux. Le premier est celui du lancement xAI, avec les étiquettes d’effort réellement imprimées. Le second est Artificial Analysis là où les étiquettes correspondent, plus les scores d’indice qui ne correspondent pas.
| Tableau de lancement xAI, 21 septembre 2026 | Grok 4.7 | Grok 4.6 | GPT-5.6 Sol | Fable 5.1 |
|---|---|---|---|---|
| Étiquette d’effort de la colonne | xHigh ; DeepSWE marqué high effort | High | Max | Max |
| Tarif affiché, entrée / sortie par 1M | 2 $ / 6 $ | 2 $ / 6 $ | 4 $ / 20 $ | 10 $ / 50 $ |
| CursorBench 4.0 | 46,3 % | 40,4 % | 41,7 % | 51,8 % |
| DeepSWE v1.1 | 71,0 % | 65,2 % | 72,7 % | 70,0 % |
| EEBench | 64,0 % | 53,0 % | 39,4 % | 56,4 % |
| AA Briefcase v1.1 | 1 657 | 1 546 | 1 487 | 1 678 |
| Terminal-Bench 4.0 | 38,0 % | 20,3 % | 37,3 % | 57,9 % |
| Harvey Legal Agent Benchmark | 19,6 % | 15,8 % | 2,5 % | 6,7 % |
| HealthBench Professional | 56,7 % | 48,5 % | 60,5 % | 62,1 % |
Grok 4.7 est devant Grok 4.6 sur chaque ligne de ce tableau. Il n’est pas devant Fable 5.1 sur CursorBench, AA Briefcase, Terminal-Bench ni HealthBench Professional. Il est devant GPT-5.6 Sol sur cinq des sept lignes de score, et derrière sur DeepSWE et HealthBench. Taille d’échantillon, harness et intervalles de confiance ne sont pas sur la page. La légende dit que les benchmarks sont des résultats fournisseur à valeur indicative.
Le nuage CursorBench de la même page n’inclut pas Grok 4.6. Pour Grok 4.7, il montre une échelle d’effort raide : Extra High 46,3 % à environ 6,01 $ et 70 141 tokens de sortie par tâche ; High 43,9 % à 4,69 $ ; Medium 41,6 % à 3,49 $ ; Low 33,1 % à 1,58 $. « Grok 4.7 » sans étiquette d’effort n’est pas un seul score.
| Artificial Analysis, article du 21 septembre 2026 | Grok 4.7 | Grok 4.6 | Paire d’effort | Ce qu’on peut dire |
|---|---|---|---|---|
| Intelligence Index v4.3 | 46 | 44 | xhigh vs high | +2 points, pas un résultat du même barreau |
| Tokens de sortie par tâche d’intelligence | ~81k | ~36k high ; ~38k xhigh | mixte | La facture bouge plus que l’indice |
| Coding Agent Index, Grok Build | 56 | 47 | xhigh vs xhigh | +9 sur l’agent de code du fournisseur |
| DeepSWE v1.1, Grok Build | 73 % | 65 % | xhigh vs xhigh | Pas la paire 71,0 / 65,2 du tableau de lancement |
| Terminal-Bench 4.0, Grok Build | 33 % | 18 % | xhigh vs xhigh | Pas la paire 38,0 / 20,3 de xAI |
| SWE-Atlas-QnA, Grok Build | 63 % | 58 % | xhigh vs xhigh | Plus étroit que le saut terminal |
| Elo AA-Briefcase | 1 657 | 1 546 en high | xhigh vs high | Qualité analytique en hausse, présentation en baisse |
| Elo GDPval-AA | 1 695 | 1 605 en high | xhigh vs high | Gain de travail de connaissance ; Fable 5.1 reste à 1 735 sur le graphique xAI |
| Taux d’hallucination, AA-Omniscience | 29 % | 34 % en high | xhigh vs high | La justesse reste à 47 % contre 48 % |
Lisez le bloc agent de code si Grok Build vous importe. Lisez le bloc intelligence si un harness partagé vous importe. Ne les moyennez pas en une phrase « Grok est 10 % meilleur ». Un commentaire Hacker News a posé la question évidente : pourquoi comparer 4.7 xhigh à 4.6 high ? Les réponses du fil ne s’accordent pas sur le moment où xhigh est arrivé pour 4.6. Artificial Analysis publie bien un score d’agent de code Grok 4.6 xhigh, donc l’étiquette existe dans au moins une évaluation actuelle. Le tableau de lancement ne l’utilise toujours pas.
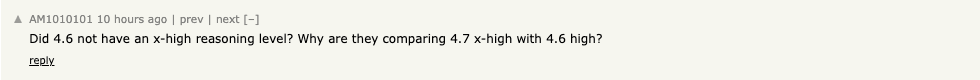
Là où Grok 4.7 prend vraiment de l’avance
Les longues exécutions de code dans un agent
Le gain le plus net est celui dont l’effort est aligné. Sur Grok Build, l’indice d’agent de code a gagné 9 points, et chaque composante a monté. Le travail terminal a le plus bougé, de 18 % à 33 % dans ce harness. Si votre mode d’échec est une tâche de dépôt de plusieurs heures qui cale, cette ligne justifie un essai. Elle ne dit pas que Grok Build battra Claude Code ou Codex. Artificial Analysis a classé Grok 4.7 plus Grok Build quatrième parmi les harness natifs, derrière Claude Fable 5.1, GPT-6 Astra et Claude Opus 5.
Le saut propre à xAI sur Terminal-Bench 4.0, de 20,3 % à 38,0 %, va dans le même sens et utilise des étiquettes d’effort non alignées. Traitez-le comme un appui fournisseur, pas comme une seconde mesure indépendante du résultat 18 à 33.
Documents et analyse, avec une réserve sur la présentation
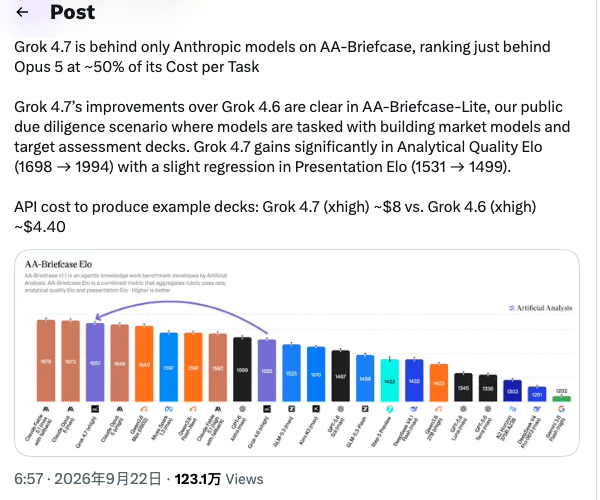
Sur AA-Briefcase, Grok 4.7 obtient 1 657 Elo, 111 au-dessus de Grok 4.6 high, juste derrière Claude Opus 5 et Claude Fable 5.1 dans le texte d’Artificial Analysis. La qualité analytique était de 1 994 Elo contre 1 690. La qualité de présentation était de 1 499 contre 1 519. Le modèle s’est amélioré sur l’analyse et a un peu reculé sur le support.
Artificial Analysis a décrit le même partage plus nettement sur le scénario public de due diligence AA-Briefcase-Lite : Elo analytique de 1 698 à 1 994, Elo de présentation de 1 531 à 1 499. Les supports d’exemple ont coûté environ 8 $ pour Grok 4.7 xhigh et environ 4,40 $ pour Grok 4.6 xhigh. Cette paire est au même effort, pour environ 1,8 fois le coût d’API, avec une analyse plus forte et une présentation plus faible. C’est un scénario, pas un benchmark universel de bureau. GDPval-AA est passé de 1 605 à 1 695 Elo sur la paire high contre xhigh, et le graphique GDPval de xAI place Fable 5.1 max à 1 735.
Un taux d’hallucination plus bas, pas un taux de justesse plus haut
Le taux d’hallucination AA-Omniscience était de 29 % pour Grok 4.7 xhigh et de 34 % pour Grok 4.6 high. La justesse était de 47 % contre 48 %. L’indice est passé de 30 à 32. Si vous voulez moins de mauvaises réponses affirmées, c’est un vrai déplacement. Si vous voulez plus de bonnes réponses, cette paire ne le montre pas. Les étiquettes d’effort diffèrent encore.
Là où Grok 4.6 reste le meilleur défaut
Le travail court, où la réflexion en plus est le produit
Payer le même tarif pour environ le double de sortie n’est un bon échange que si cette sortie évite une reprise. Pour une extraction bornée, un correctif court ou un JSON d’état, la trace plus courte de Grok 4.6 est la fonction. Des lecteurs de Hacker News devant le graphique de tokens d’intelligence ont appelé le changement une régression d’efficacité des tokens. Ce commentaire n’ajoute pas une mesure. C’est le même graphique Artificial Analysis, lu comme un problème de coût plutôt que comme une hausse de capacité.

Sur les tâches qu’Artificial Analysis a signalées en recul face à Grok 4.6 high, AA-LCR et AutomationBench-AA, il n’y a pas de raison de quitter 4.6. Les scores absolus n’ont pas été publiés, donc l’ampleur de ces baisses est seulement le delta publié : 3,7 et 1,1 points.
Les forfaits Cursor, si Fast et l’effort ne sont pas fixés
Un tarif affiché de 2 $/6 $ ne décrit pas un pourcentage Cursor Ultra. Les durées de Dynamix86 sont un journal d’un seul utilisateur : intervalles Grok 4.7 de 34, 55 et 38 minutes par point de pourcentage, contre 133 et 101 minutes pour Grok 4.6 plus tôt le même jour, les deux en extra high avec Fast désactivé. L’auteur a aussi lu un graphique Artificial Analysis comme 8,82 $ contre 3,53 $ par tâche d’agent de code. Ces montants sont la lecture de l’auteur. Ils n’étaient pas imprimés comme une phrase dans l’article Artificial Analysis ouvert pour cette page, donc ils restent attribués à la publication.
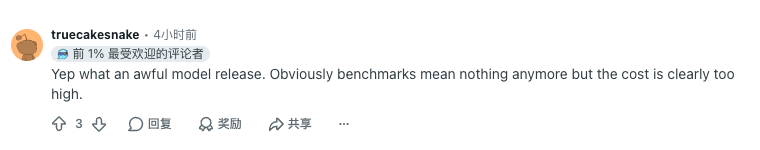
Une réponse sur le même fil était plus directe : la sortie semblait faible parce que le coût était clairement trop élevé, même en mettant les benchmarks de côté.
La documentation Cursor dit aussi que Fast est le défaut à partir de Pro, au double des tarifs de tokens. Si un côté d’un test personnel est en Fast et l’autre non, le prix 2× est un réglage, pas un changement de modèle. Le journal Reddit dit que Fast était désactivé. Beaucoup de comparaisons rapides ne le seront pas.
Tout ce que vous acceptez déjà de Grok 4.6
Les notes de test (English) de Grok 4.6 décrivent déjà un modèle agent de 500K à ce tarif. Grok 4.7 n’ajoute pas un nouveau palier de contexte sur la fiche API, et il ne baisse pas le tarif affiché. Si 4.6 termine déjà le travail et que vous n’êtes pas bloqué sur de longs terminaux ou de longs documents, la mise à niveau est facultative. HealthBench Professional reste derrière GPT-5.6 Sol et Fable 5.1 sur le tableau même de xAI (56,7 contre 60,5 et 62,1) : un basculement pour le raisonnement clinique n’est pas non plus l’histoire.
Ce que les gens ont vraiment dit
Les premiers commentaires se partagent entre un camp du coût et un camp du ressenti. Les deux datent de quelques heures. Aucun n’a publié un prompt, un dépôt ou un score.
La facture. L’estimation d’usage du forfait à 2,5× de Dynamix86 et le « le coût est clairement trop élevé » de truecakesnake se placent à côté du graphique de tokens. Un autre commentateur Hacker News, notduckrabbit, a pointé le même écart d’efficacité. Ensemble, ils disent : ne migrez pas une route à fort volume le jour du lancement.
Le ressenti. D’autres commentaires r/cursor, postés le même après-midi, ont aimé le modèle et n’ont pas parlé du prix.
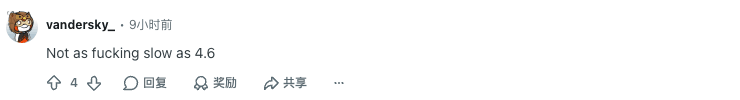
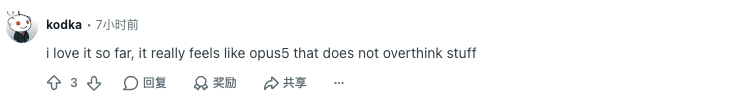
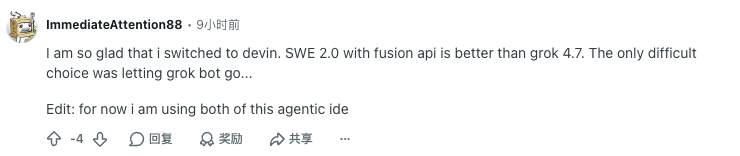
Les commentaires sur la vitesse et sur « il ne réfléchit pas trop » peuvent être vrais dans un chat et faux pour un agent de code xhigh qui émet 81k tokens. « Pas aussi lent que 4.6 » n’était pas associé à un nombre de tokens. Artificial Analysis a mesuré environ 188 tokens par seconde sur de longs prompts et environ 7,1 minutes de décodage par tâche d’intelligence, hors temps jusqu’au premier token et hors surcharge. Une première impression rapide et une longue trace d’agent sont compatibles.
La recherche YouTube « Grok 4.7 vs Grok 4.6 » du 22 septembre a renvoyé des explications de lancement, y compris des vidéos d’avant publication qui devinent des nombres de paramètres. Ces nombres ne sont pas sur la page de lancement xAI, qui dit seulement « un nouveau modèle de base, plus grand ». Aucun commentaire vidéo n’est utilisé ici.
Le verdict
Il n’y a pas de vainqueur global. Choisissez selon la forme du travail, et gardez l’étiquette d’effort dans la décision.
| Charge | Choix | Pourquoi | À surveiller |
|---|---|---|---|
| Extraction courte, classement ou petit correctif | Grok 4.6 | Le gain d’indice est petit et la trace de sortie est bien plus courte | Ne payez pas xhigh pour une réponse d’une ligne |
| Travail Cursor répété sur un pool d’usage | Grok 4.6, sauf si une tâche échoue | Un journal Ultra a montré environ 2,5× d’usage du forfait en extra high, Fast désactivé | Fixez Fast et l’effort avant d’incriminer le modèle |
| Code de plusieurs heures dans Grok Build ou un agent proche | Essayer Grok 4.7 xhigh | Coding Agent Index 56 contre 47 en xhigh aligné | Comparez les tâches terminées, pas seulement l’indice |
| Modèles de marché, notes et supports cibles | Essayer Grok 4.7, puis éditer le support | L’Elo analytique a bondi ; l’Elo de présentation a glissé ; les exemples coûtaient environ 8 $ contre 4,40 $ | Prévoyez une passe humaine sur les diapositives |
| Appels API de long contexte au-dessus de 200K | L’un ou l’autre, sur le prix | Les deux fiches doublent les tarifs au-delà de 200K | La limite 256K de Cursor est un autre compteur |
| Il vous faut un CursorBench ou un Terminal-Bench au niveau de Fable | Pas cette paire | Fable 5.1 Max est à 51,8 % et 57,9 % sur le tableau xAI | Prix ce choix sur la fiche de Fable, pas sur celle de Grok |
Un test pratique, c’est une tâche dont vous savez déjà la notation : même effort, Fast désactivé, même harness. Notez si elle est terminée, les corrections humaines, les tokens de sortie, et soit les dollars d’API soit le pourcentage du forfait. Un succès n’est pas un taux.
Lancez la même tâche dans Tabbit avant de migrer une route
Une ligne de benchmark ne dit pas comment chaque modèle se comporte sur vos onglets, vos documents et une recherche à moitié faite. Tabbit Browser est l’espace de travail pour cette vérification : le modèle peut rester à côté des pages que vous lisez déjà, au lieu d’un chat séparé qui ne les voit jamais. Le guide du navigateur agentique et le guide du raisonnement agentique séparent un score de modèle d’un flux à plusieurs étapes déjà terminé. La comparaison de navigateurs IA et le guide Tabbit Browser couvrent le produit autour du modèle. Le panorama 2026 des navigateurs IA est l’ensemble plus large si Tabbit n’est pas le client voulu.
Les deux ID Grok sont enregistrés pour Tabbit. Que Grok 4.7 ou Grok 4.6 apparaisse dans votre sélecteur dépend du compte et de la liste actuelle. Cet article ne contient ni transcription Tabbit, ni journal de tokens, ni vainqueur. Si les deux ID sont disponibles, lancez une tâche dont vous savez déjà la notation, gardez l’effort et les outils identiques, et restez sur Grok 4.6 si le seul changement est une trace plus longue. Le guide des pratiques Tabbit porte sur le flux dans le navigateur, pas sur l’idée qu’une compilation Grok est préinstallée pour chaque compte.
Le tarif affiché de l’API, un pool Cursor et l’accès Tabbit sont trois factures différentes. Ne les additionnez pas.
 Tabbit Browser

Questions fréquentes
Grok 4.7 est-il meilleur que Grok 4.6 ?
Cela dépend de la tâche et du niveau d’effort. Sur le Coding Agent Index d’Artificial Analysis, Grok 4.7 xhigh avec Grok Build obtient 56 contre 47 pour Grok 4.6 xhigh. L’Intelligence Index ne passe que de 44 en Grok 4.6 high à 46 en Grok 4.7 xhigh, et certaines tâches non agentiques reculent. Il n’y a pas de vainqueur unique.
Grok 4.7 et Grok 4.6 coûtent-ils le même prix ?
Sur les fiches xAI ouvertes le 22 septembre 2026, les deux affichent 2 $ par million de tokens d’entrée, 0,50 $ d’entrée en cache et 6 $ en sortie sous 200K de contexte, puis 4 $, 1 $ et 12 $ au-dessus de 200K. Cursor documente un pool d’usage séparé et un palier Fast. Le tarif affiché identique ne signifie pas qu’une tâche terminée coûte la même chose.
Pourquoi Grok 4.7 peut-il coûter plus cher si le prix du token n’a pas changé ?
Artificial Analysis a mesuré environ 81 000 tokens de sortie par tâche d’Intelligence Index pour Grok 4.7 xhigh, contre environ 36 000 pour Grok 4.6 high et environ 38 000 pour Grok 4.6 xhigh. À 6 $ le million de tokens de sortie, cette sortie seule vaut environ 0,49 $ contre 0,22 $ ou 0,23 $, avant l’entrée, le cache, les outils ou les reprises.
Quels gains de benchmark de Grok 4.7 sont au même niveau d’effort ?
La comparaison du Coding Agent Index est xhigh contre xhigh : 56 contre 47, avec DeepSWE 73 % contre 65 %, Terminal-Bench 4.0 33 % contre 18 % et SWE-Atlas-QnA 63 % contre 58 % dans Grok Build. Le tableau de lancement xAI compare Grok 4.7 xHigh à Grok 4.6 High, et DeepSWE y est marqué high effort pour Grok 4.7. Ne traitez pas ces lignes comme un test du même barreau.
Faut-il passer de Grok 4.6 à Grok 4.7 dans Cursor ?
Essayez une tâche longue de code ou de documents si vous acceptez une baisse plus rapide du forfait. Un utilisateur Cursor Ultra, en extra high et Fast désactivé, a estimé environ 2,5 fois l’usage du forfait et prévoyait de ramener la plupart du travail vers 4.6. D’autres commentaires précoces ont trouvé 4.7 plus rapide ou moins enclin à trop réfléchir. Fixez l’effort et Fast avant de comparer.
Puis-je comparer Grok 4.7 et Grok 4.6 dans Tabbit Browser ?
Les deux modèles ont une page Tabbit. Leur présence dans le sélecteur dépend du compte et de la liste en cours. Cet article ne contient pas d’exécution Tabbit de la même tâche : une entrée au sélecteur ne prouve pas qu’un modèle gagne un flux de travail.