
Essayez d’abord LongCat 2.5 si votre agent doit lire une capture d’écran ou si vous cherchez un tarif API publié plus bas. Commencez par GLM-5.3 si vous avez besoin des poids du modèle. Pour le code, soumettez les mêmes tâches aux deux modèles et inspectez leurs modifications : les chiffres de lancement ne suffisent pas à décider pour votre dépôt.
Le 3 novembre 2026, LongCat affichait un tarif temporaire de 0,30 dollar par million de tokens d’entrée hors cache et de 1,20 dollar en sortie. Z.ai affichait 1,40 et 4,40 dollars. Ce sont des prix d’API des fournisseurs, pas des prix d’abonnement Tabbit, et ils ne disent pas combien de tokens chaque tâche consommera.
Un utilisateur Reddit a demandé à LongCat 2.5 Preview d’analyser cinq classes C# dans OpenCode. Il rapporte des raisonnements répétés et une tâche inachevée. C’est un seul essai de Preview, pas une mesure de la version finale. Il rappelle l’intérêt d’un critère d’arrêt et de tests d’acceptation. Plus loin, nous montrons un calcul effectué dans Tabbit Browser.
À retenir
LongCat 2.5 accepte des images ; Z.ai documente GLM-5.3 comme modèle à entrée textuelle.
Lors de notre recherche, les poids de LongCat 2.5 étaient annoncés comme à venir. Ceux de GLM-5.3 sont publics sous une licence propre.
Dans le tableau de Meituan, chaque modèle mène sur certaines tâches. Plusieurs chiffres GLM viennent de rapports externes et ne constituent pas un test commun contrôlé.
Le tarif API officiel de LongCat est inférieur mais temporaire. Comparez le coût par tâche acceptée.
Les retours sur Preview indiquent des risques à tester, pas la performance de la version finale.
Comparaison rapide
| Critère | LongCat 2.5 | GLM-5.3 | Vérification |
|---|---|---|---|
| Entrée | Texte et images | Texte | Le client et le point d’accès doivent accepter le type voulu. |
| Contexte | 1 048 576 tokens, entrée et sortie comprises | 1 million de tokens | Une grande fenêtre ne garantit pas la précision. |
| Raisonnement | Activable ou désactivable selon le guide | Toujours actif, effort low, high ou max | Le réglage influence consommation et résultat. |
| Poids | GitHub et Hugging Face annoncés à venir | Poids et instructions publics | Vérifiez licence et matériel. |
| API officielle par million en entrée / sortie | 0,30 / 1,20 dollar, promotion temporaire | 1,40 / 4,40 dollars | Vérifiez les tarifs et conditions de cache actuels. |
Sources : annonce LongCat, paramètres, guide GLM-5.3 et fiche du modèle. Voir aussi notre présentation de GLM-5.3 et celle de LongCat 2.0, qui concerne la génération précédente.
Benchmarks de code : des conditions différentes
Dans le tableau de lancement de Meituan, l’astérisque signale un chiffre GLM issu d’un rapport ou classement public, pas nécessairement une nouvelle exécution dans les mêmes conditions que LongCat.
| Benchmark | LongCat 2.5 | GLM-5.3 dans le tableau Meituan | Type de tâche |
|---|---|---|---|
| Terminal-Bench 2.1 | 88,4 | 88,2* | Travail en terminal à plusieurs étapes |
| Terminal-Bench 4.0 | 38,5 | 41,8* | Tâches de terminal plus difficiles |
| DeepSWE v1.1 | 64,6 | 66,9* | Problèmes d’ingénierie logicielle |
| NL2Repo | 60,5 | 58,0* | Créer un dépôt à partir d’une description |
Source : évaluation Meituan, consultée le 3 novembre 2026. LongCat indique une moyenne de trois essais Terminal-Bench 2.1 avec Claude Code 2.1.280. La fiche GLM cite Claude Code 2.1.207. L’agent, les outils, le délai, le prompt et le budget de sortie peuvent changer le résultat. Le faible écart de la première ligne ne désigne pas un gagnant pour votre dépôt.
Transformez ces données en tâches vérifiables. Sur un dépôt existant, partez d’un bug accompagné d’un test en échec, puis vérifiez le test et les modifications sans rapport. Pour un nouveau projet, définissez le comportement attendu avant de lancer les modèles. Les prompts GLM et les ressources de test peuvent aider à préparer vos essais sans remplacer vos critères d’acceptation.
Prix API : calculer le coût d’une tâche
La tarification LongCat est une promotion temporaire. La tarification Z.ai et celle de LongCat ont été vérifiées le 3 novembre 2026. Les montants sont en dollars par million de tokens, hors autres outils et frais.
| API officielle | Entrée hors cache | Entrée en cache | Sortie |
|---|---|---|---|
| LongCat 2.5, promotion temporaire | $0.30 | $0.006 | $1.20 |
| Z.ai GLM-5.3 | $1.40 | $0.26 | $4.40 |
Pour un million de tokens d’entrée hors cache et 200 000 de sortie, sans outil ni autre frais, le calcul donne $0.54 pour LongCat et $2.28 pour GLM-5.3. Cet exemple fixe la même quantité de tokens ; il ne suppose ni consommation réelle ni taux de réussite identiques.
coût par tâche acceptée = dépenses totales de modèles et d’outils / tâches validéesAjoutez les essais ratés, reprises, contextes répétés, défauts de cache et temps de revue humaine si vous pouvez les mesurer. Z.ai facture séparément son outil de recherche. Un Coding Plan, un fournisseur tiers et un compte Tabbit ont chacun leurs propres conditions.
Images, contexte et sortie maximale
L’annonce LongCat décrit une compréhension visuelle native. Pour tester une interface, fournissez une capture, les fichiers utiles et un critère visuel vérifiable, puis contrôlez le résultat et son accessibilité dans le navigateur.
Le guide Z.ai indique que GLM-5.3 ne prend que du texte en entrée. Pour une image, ajoutez un composant visuel distinct ou fournissez une description vérifiée. Cela ne signifie pas que toute application utilisant GLM est dépourvue de fonctions visuelles.
Les deux fournisseurs annoncent environ un million de tokens de contexte. LongCat précise que l’entrée et la sortie partagent ce budget. Sa référence de paramètres fixe max_tokens à 262 144 au maximum, tandis que son guide de démarrage indique une sortie maximale de 128K. Vérifiez le point d’accès concerné. Z.ai documente 128K pour GLM-5.3 ; un client peut imposer moins.
Poids et déploiement
Lors de la recherche, les liens GitHub et Hugging Face de LongCat 2.5 étaient annoncés comme à venir. Cela ne confirme ni date ni future licence. Si l’auto-hébergement est indispensable, revérifiez le dépôt et les conditions. La licence MIT de LongCat 2.0 ne s’étend pas automatiquement à 2.5.
La fiche Hugging Face de GLM-5.3 publie les poids et cite notamment vLLM et SGLang. L’étiquette de licence est glm-5.3 : lisez les conditions applicables. Les poids téléchargeables n’effacent pas les coûts de matériel, exploitation, sécurité et support. La fiche indique 753 milliards de paramètres ; estimez la mémoire avec votre quantification et votre contexte.
Ce que disent les utilisateurs de Preview
Dans le cas C#, l’auteur décrit des répétitions et une tâche non terminée. Cela suggère de journaliser les appels d’outils et d’arrêter les boucles sans progrès ; cela ne prouve pas que la version finale se comporte ainsi.
Un autre utilisateur Reddit a testé Preview trois fois par tâche sur Terminal-Bench 2.1 et observé moins d’exceptions et de délais dépassés que pour les autres modèles de son essai. Il signale aussi un échec récurrent de sa machine sur une tâche. GLM-5.3 n’était pas testé. Ces deux récits ne classent donc pas les versions finales.
Préparer une comparaison équitable
Choisissez cinq tâches représentatives et réversibles : bug courant, modification de plusieurs fichiers et reprise après erreur si ces cas vous concernent.
Fixez la révision du dépôt, les permissions, le délai et les tests d’acceptation. Excluez secrets et identifiants de production.
Notez version du modèle, fournisseur, agent, effort, prompt, contexte, tokens, erreurs d’outils, durée et diff final.
Contrôlez les tests et les changements hors sujet avant de lire l’auto-évaluation. Pour une interface, examinez aussi le rendu.
Répétez pour observer la variabilité et incluez les essais ratés dans le coût.
Une réussite isolée est un exemple, pas un taux de réussite. Notre guide des navigateurs agentiques explique le rôle des outils et de l’application dans une tâche longue.
Organiser la comparaison dans Tabbit Browser
Pour la recherche documentaire, ouvrez les documents et tarifs officiels dans Tabbit Browser et demandez un tableau avec source, date, version et questions ouvertes. Vérifiez ensuite chaque chiffre sur sa page d’origine, notamment la promotion et le désaccord sur la sortie maximale.
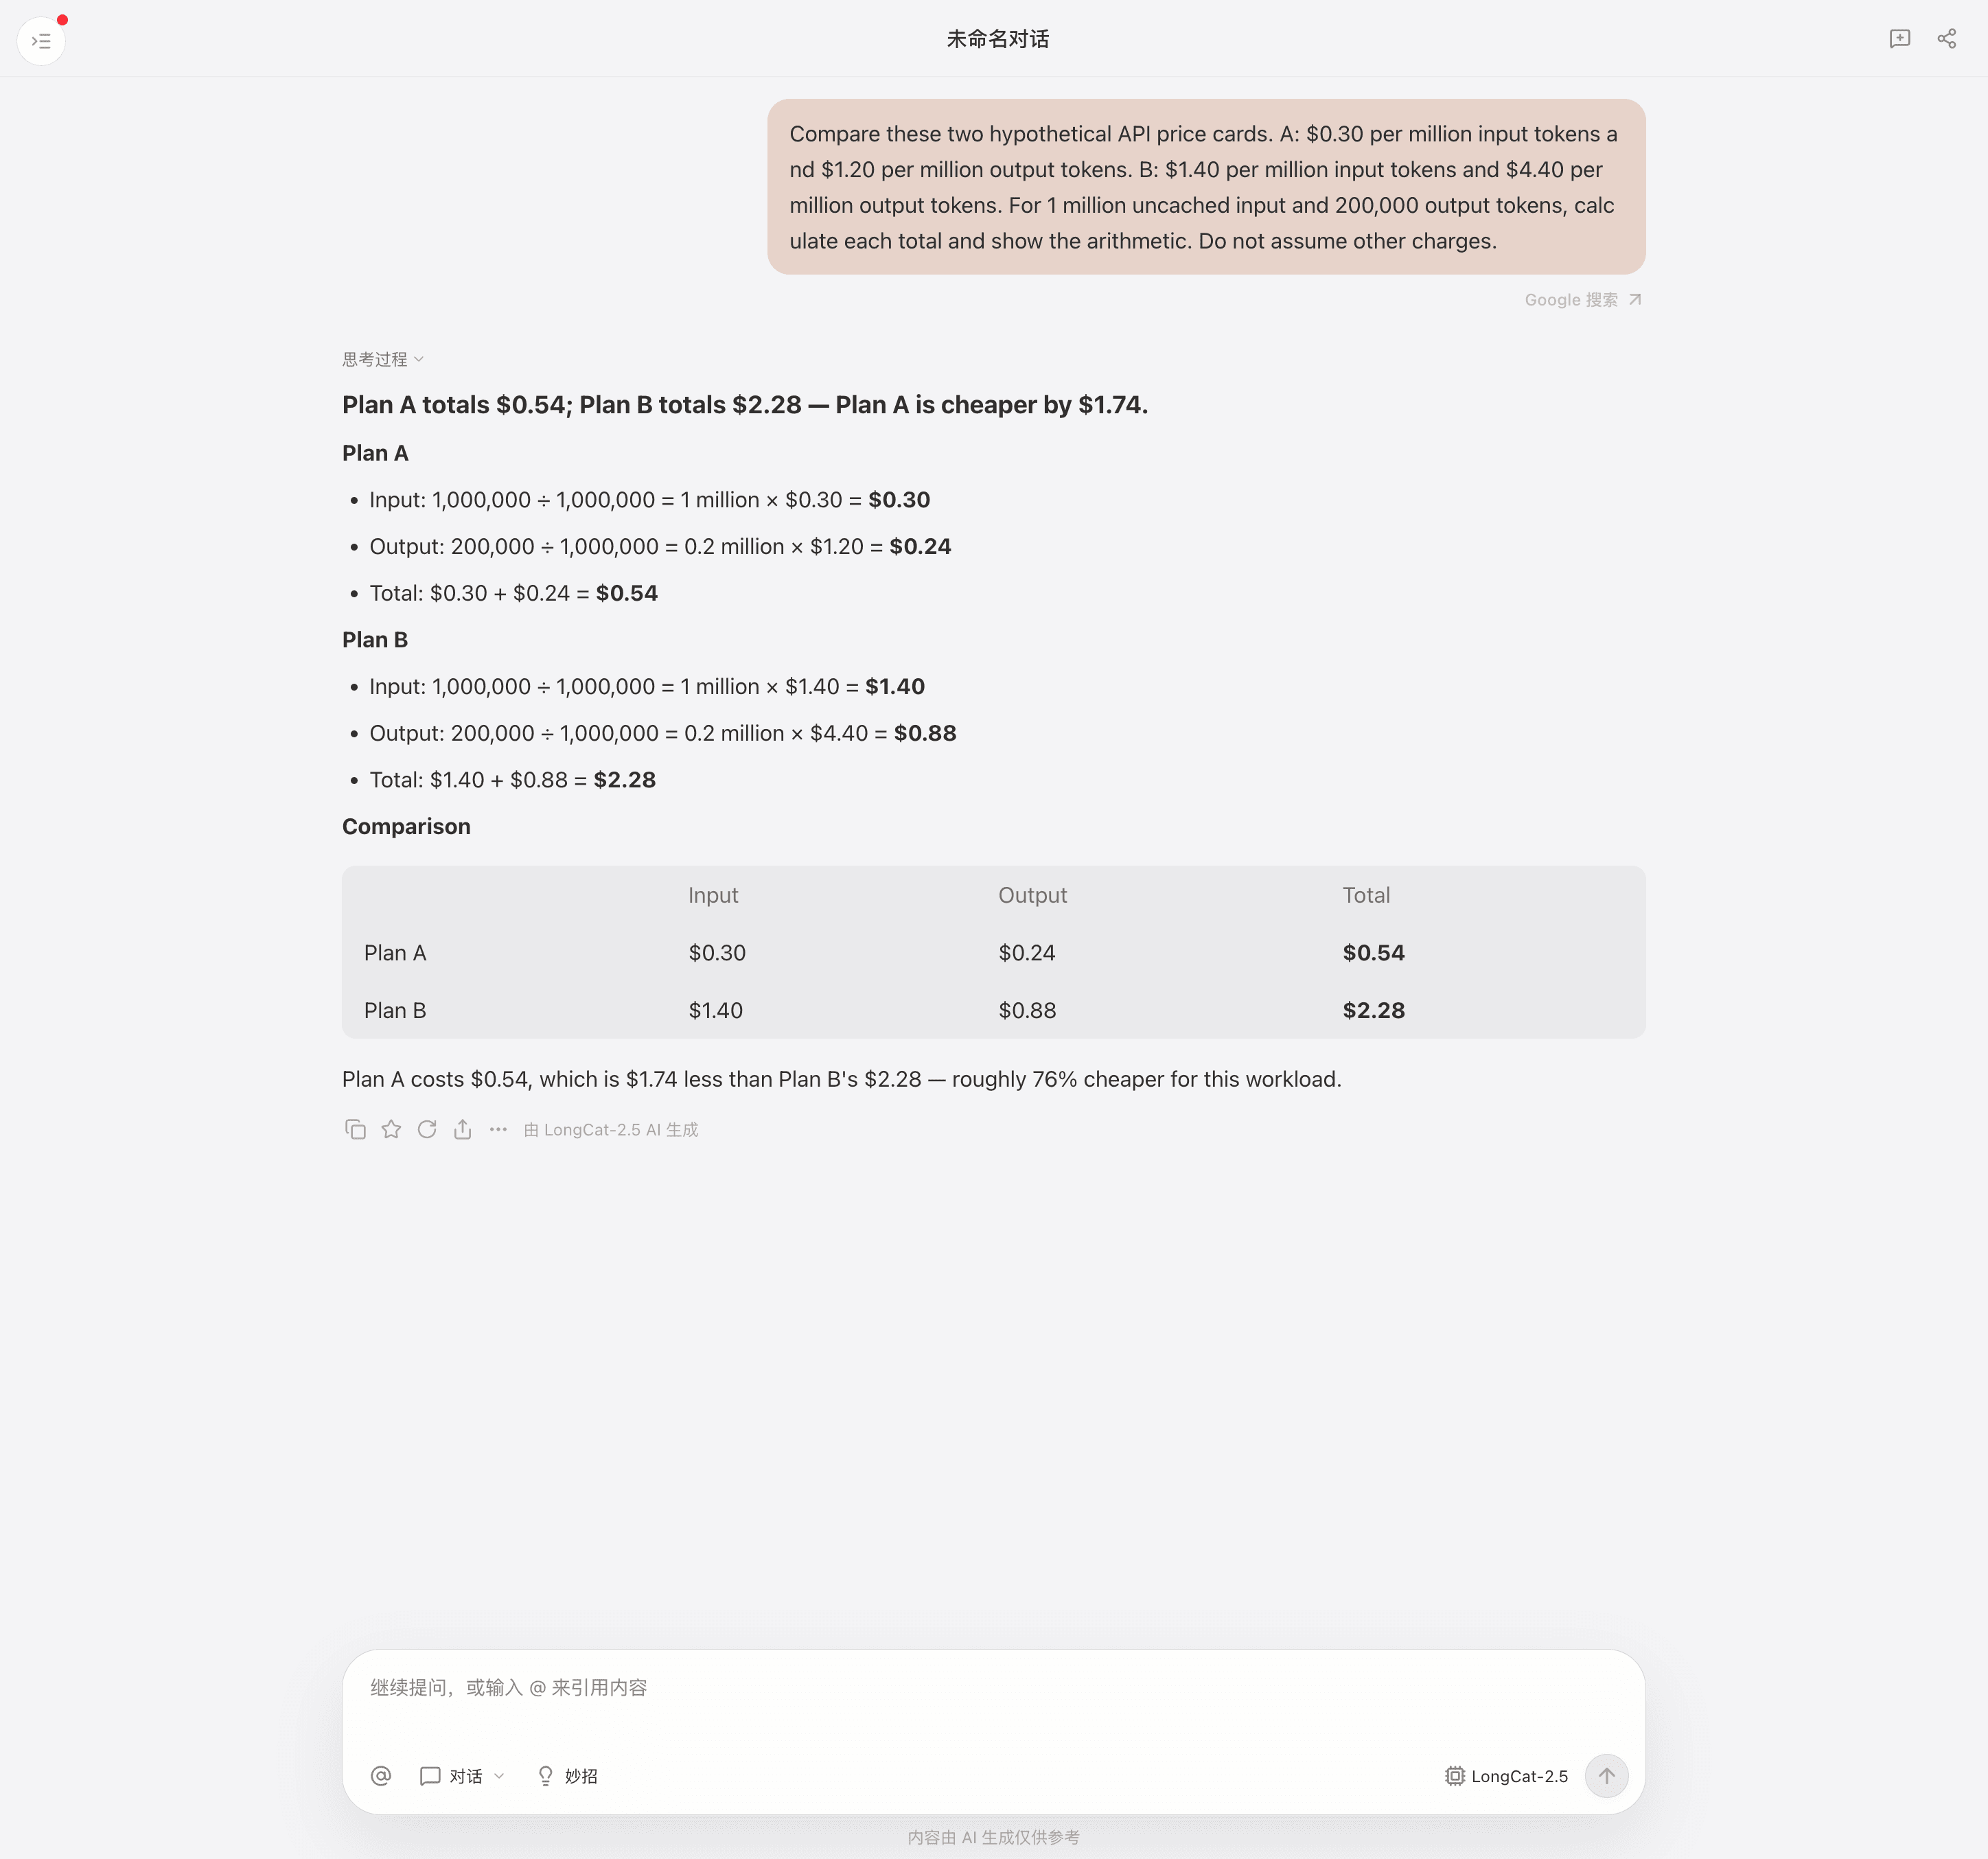
Le 3 novembre, nous avons effectué un calcul dans un environnement de test Tabbit avec LongCat-2.5 sélectionné. Nous avons fourni les deux grilles et demandé le coût pour un million de tokens d’entrée et 200 000 de sortie. La réponse indiquait $0.54 et $2.28, ce qui correspond au calcul. Les tarifs étaient fournis dans le prompt, pas vérifiés par le modèle. Un seul résultat ne mesure ni la fiabilité générale ni la qualité du code.
Le sélecteur de ce compte de test affichait LongCat-2.5, mais pas GLM-5.3 complet. GLM-5.3-FlashX est un autre modèle et n’a pas été utilisé à sa place. La disponibilité varie selon le compte et l’édition ; la capture ne prouve pas une disponibilité en production.
Voir les bonnes pratiques Tabbit et le comparatif de navigateurs IA. Un assistant de navigateur ne remplace pas les tests du dépôt ; vérifiez aussi quotas, disponibilité et conditions relatives aux données.
Quel modèle selon votre besoin ?
| Besoin | Première option à examiner | Pourquoi |
|---|---|---|
| Interface à partir d’une capture | LongCat 2.5 | Entrée visuelle documentée ; vérifiez le point d’accès et le rendu. |
| Poids auto-hébergés aujourd’hui | GLM-5.3 | Poids et guides disponibles ; examinez licence et matériel. |
| Tarif API officiel le plus bas | LongCat 2.5 | Promotion actuellement inférieure ; calculez le coût par tâche acceptée. |
| Agent de code pour des tâches longues | Testez les deux | Les benchmarks ne contrôlent pas toutes les conditions. |
| Client exigeant la désactivation du raisonnement | Vérifiez LongCat | Z.ai impose le raisonnement actif pour GLM-5.3. |
Partez de votre contrainte non négociable et faites une petite évaluation. Si les résultats sont proches, gardez une solution de repli et recommencez après un changement de fournisseur, d’agent ou de version.

Questions fréquentes
Quel modèle choisir pour programmer, LongCat 2.5 ou GLM-5.3 ?
Les deux sont des candidats pour les agents de programmation, mais les benchmarks publiés utilisent des configurations différentes. Comparez-les sur les mêmes tâches, outils et tests d’acceptation avant un déploiement en production.
LongCat 2.5 est-il moins cher que GLM-5.3 ?
Le 3 novembre 2026, LongCat affichait un tarif temporaire de 0,30 dollar par million de tokens d’entrée hors cache et de 1,20 dollar en sortie. Z.ai affichait respectivement 1,40 et 4,40 dollars ; le coût réel dépend aussi des tokens, du cache, des outils et du fournisseur.
Les deux modèles peuvent-ils lire une capture d’écran ?
LongCat décrit 2.5 comme un modèle multimodal acceptant des images. Z.ai présente GLM-5.3 comme un modèle à entrée textuelle ; il faut donc un composant visuel séparé ou un autre modèle pour traiter une image.
Peut-on exécuter ces modèles sur son propre matériel ?
Z.ai publie les poids et les instructions de déploiement de GLM-5.3, sous réserve de sa licence et de ressources matérielles importantes. À la date de notre recherche, les liens GitHub et Hugging Face de LongCat 2.5 étaient annoncés comme à venir.
Quelle est la taille de leur fenêtre de contexte ?
Les deux fournisseurs annoncent environ un million de tokens, mais entrée et sortie partagent le budget de la requête et le client peut imposer une limite inférieure. Les documents LongCat divergent sur la sortie maximale ; vérifiez le point d’accès utilisé.
LongCat 2.5 Preview est-il identique à la version finale ?
Preview précède le lancement de LongCat 2.5 en novembre 2026. Les retours sur Preview servent à concevoir des tests, mais ne démontrent pas le comportement de la version finale.