
画像を読み取るエージェントや低い公開API料金を重視するなら、まずLongCat 2.5を試してください。モデルの重みが必要ならGLM-5.3が候補です。コードの品質は、同じタスクを実行し変更内容を検証して判断しましょう。発表時の表だけでは、手元のリポジトリでの結果は決まりません。
2026年11月3日時点のLongCatの期間限定料金は、キャッシュなしの入力100万トークン当たり0.30ドル、出力は1.20ドルでした。Z.aiはそれぞれ1.40ドル、4.40ドルです。これは各社のAPI料金であり、Tabbitのサブスクリプション料金ではありません。タスク完了までのトークン数も分かりません。
Redditの利用者は、OpenCodeでLongCat 2.5 PreviewにC#の5クラスの分析を依頼し、推論の繰り返しと未完了を報告しました。Previewでの一例であり正式版の評価ではありませんが、停止条件と受け入れテストを設ける理由になります。後半ではTabbit Browserでの料金計算例も紹介します。
要点
LongCat 2.5は画像入力に対応し、Z.aiはGLM-5.3をテキスト入力専用と説明しています。
調査時、LongCat 2.5の重みは公開予定でした。GLM-5.3は独自ライセンスの下で重みを公開しています。
Meituanの表ではタスクによって優位なモデルが異なります。GLMの一部は外部公表値で、同条件の対照実験ではありません。
LongCatの公式API料金は現在低いものの期間限定です。合格したタスク当たりの費用で比較してください。
Previewの体験談は失敗例を探す手掛かりであり、正式版の性能を示しません。
主な違い
| 項目 | LongCat 2.5 | GLM-5.3 | 確認すること |
|---|---|---|---|
| 入力 | テキストと画像 | テキスト | クライアントとエンドポイントの対応範囲。 |
| コンテキスト | 入出力合計1,048,576トークン | 100万トークン | 長い窓でも検索精度は保証されない。 |
| 推論 | パラメーターガイドではオン・オフ可能 | 常時オン、low・high・max | 設定で使用量と結果が変わる。 |
| 重み | 発表ページではGitHubとHugging Faceが公開予定 | 重みと実行手順を公開 | ライセンスとハードウェアを確認。 |
| 公式APIの100万入力 / 出力 | $0.30 / $1.20、期間限定 | $1.40 / $4.40 | 最新料金とキャッシュ条件を確認。 |
出典はLongCatの発表、パラメーター、GLM-5.3ガイド、モデルカードです。GLM-5.3の概要とLongCat 2.0の解説も参照できます。2.0は前世代です。
コーディングの評価条件
Meituanの発表表から抜粋します。アスタリスク付きのGLM値は公開資料などから引用したもので、LongCatと同時に同条件で測定したとは限りません。
| ベンチマーク | LongCat 2.5 | Meituan表のGLM-5.3 | 対応するタスク |
|---|---|---|---|
| Terminal-Bench 2.1 | 88.4 | 88.2* | 複数段階のターミナル操作 |
| Terminal-Bench 4.0 | 38.5 | 41.8* | より難しいターミナル操作 |
| DeepSWE v1.1 | 64.6 | 66.9* | ソフトウェア開発の課題 |
| NL2Repo | 60.5 | 58.0* | 説明からリポジトリを作成 |
出典は2026年11月3日確認のMeituan評価表です。LongCatのTerminal-Bench 2.1はClaude Code 2.1.280で3回の平均とされています。GLMモデルカードはClaude Code 2.1.207を記載しています。エージェント、ツール、時間制限、プロンプト、出力予算はいずれも結果に影響します。最初の行の小さな差だけで優劣は決められません。
既存リポジトリでは失敗するテストがあるバグを選び、テスト結果と無関係な変更を確認してください。新規プロジェクトなら期待する動作を先に定義します。GLMのプロンプト集と評価資料はテスト設計の参考になりますが、独自の受け入れ基準に代わるものではありません。
API料金とタスク当たりの費用
LongCatの料金は期間限定割引です。Z.aiの料金とともに2026年11月3日に確認しました。単位は100万トークン当たりの米ドルで、別途ツール料金などは含みません。
| 公式API | 入力・キャッシュなし | キャッシュ入力 | 出力 |
|---|---|---|---|
| LongCat 2.5、期間限定 | $0.30 | $0.006 | $1.20 |
| Z.ai GLM-5.3 | $1.40 | $0.26 | $4.40 |
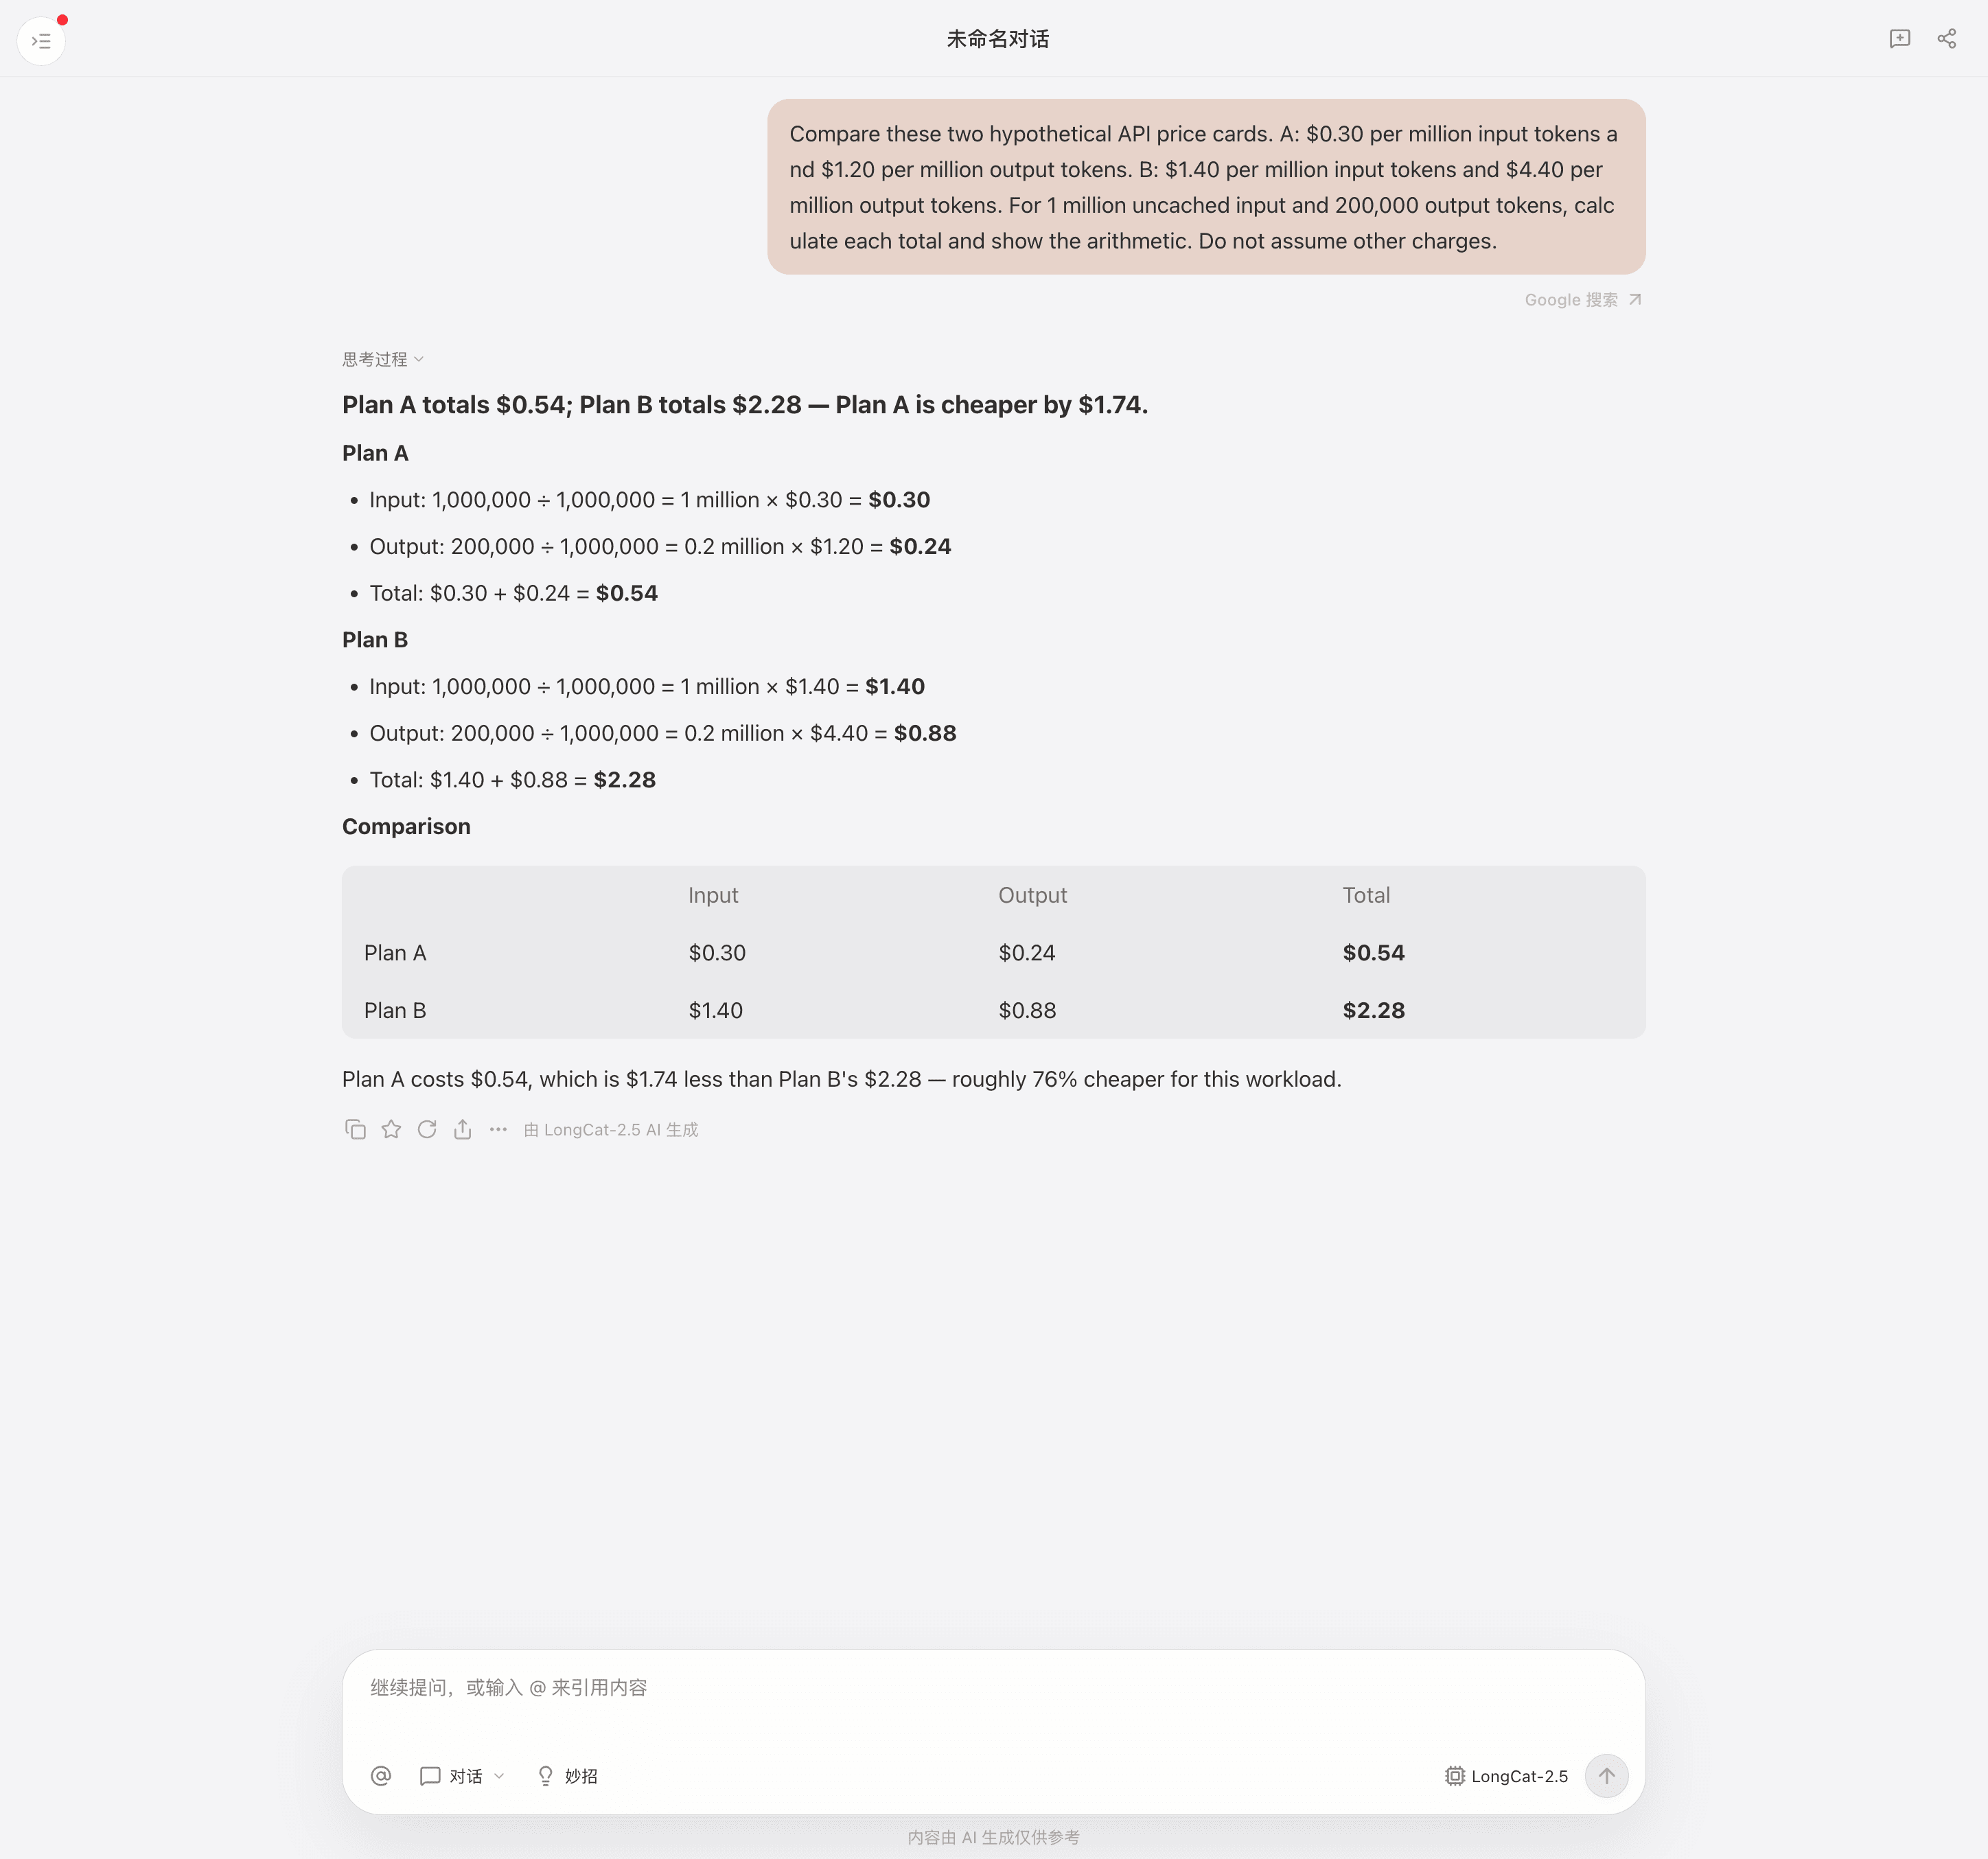
キャッシュなし入力100万、出力20万トークンで、他の料金がない場合、LongCatは $0.54、GLM-5.3は $2.28 です。同じトークン数を仮定した計算で、実際の使用量や成功率が同じだと主張するものではありません。
合格タスク当たりの費用 = モデルとツールの総費用 / テストに合格したタスク数失敗、再試行、コンテキストの再送、キャッシュミス、可能なら人手レビューも含めます。Z.aiの組み込み検索には別料金があります。Coding Plan、他社プロバイダー、Tabbitアカウントはそれぞれ別の契約です。
画像、コンテキスト、最大出力
LongCatの発表はネイティブな画像理解を説明しています。画面修正のテストでは、画像、関連ファイル、確認可能な表示条件を渡し、生成後の画面とアクセシビリティをブラウザで確認します。
Z.aiのガイドではGLM-5.3はテキスト入力のみです。画像を使う場合は別の視覚コンポーネントか、確認済みの文章説明が必要です。GLMを利用するすべてのアプリが画像機能を持たないという意味ではありません。
両社のコンテキストは約100万トークンです。LongCatは入力と出力の合計と明記しています。パラメーターリファレンスの max_tokens 上限は262,144ですが、クイックスタートは最大出力128Kと記載しています。使用するエンドポイントで確認してください。Z.aiはGLM-5.3の最大出力を128Kと説明し、クライアントがさらに制限する場合もあります。
重みとデプロイ
調査時、LongCat 2.5発表ページのGitHubとHugging Faceは公開予定でした。公開日や将来のライセンスは確定できません。自社運用が必須なら公式リポジトリと条件を再確認してください。LongCat 2.0のMITライセンスを2.5にそのまま適用することはできません。
GLM-5.3のモデルカードは重みを公開し、vLLMやSGLangを紹介しています。ライセンス表記は glm-5.3 なので用途に応じて条項を確認してください。重みの公開後もハードウェア、運用、セキュリティ、サポートの費用は残ります。カードの総パラメーターは753Bで、メモリーは量子化とコンテキストに合わせて見積もります。
Previewの利用者の声
C#の報告は繰り返しと未完了を述べています。ツール呼び出しを記録し、進展のないループを止めるテストには役立ちますが、正式版でも同じとは限りません。
別のReddit利用者はPreviewをTerminal-Bench 2.1の各タスクで3回実行し、比較対象より例外とタイムアウトが少なかったと報告しました。一方で自分の機器が1タスクで繰り返し失敗したと述べ、GLM-5.3は比較に含まれていません。これらは正式版の順位を示しません。
公平に試す手順
バグ修正、複数ファイルの変更、失敗からの復旧など、代表的で元に戻せるタスクを5件選ぶ。
リポジトリの版、権限、制限時間、受け入れテストを固定し、秘密情報や本番認証情報を除く。
モデルと提供元、エージェントの版、推論設定、プロンプト、コンテキスト、トークン、ツールエラー、時間、diffを記録する。
モデル自身の評価より先にテストと無関係な変更を確認する。視覚タスクは画面も確認する。
複数回実行してばらつきを調べ、失敗分も費用に含める。
1回の成功は例であり成功率ではありません。エージェント型ブラウザの解説では、ツールとアプリが複数段階の作業に与える影響を説明しています。
Tabbit Browserで比較資料を整理
資料調査なら、Tabbit Browserで各社の文書と料金ページを開き、出典URL、日付、モデルの版、未解決点を表にできます。期間限定料金と最大出力の食い違いは元ページで確認してください。
11月3日、Tabbitのテスト環境でLongCat-2.5を選び、2つの仮定料金と入力100万・出力20万トークンを渡して費用を計算しました。回答は$0.54と$2.28で、上記の計算と一致しました。料金はプロンプトで与えており、モデルが独自に確認したものではありません。1回の正答から一般的な信頼性やコード品質は判断できません。
このテストアカウントの選択画面にはLongCat-2.5はありましたが、完全版GLM-5.3はありませんでした。GLM-5.3-FlashXは別モデルなので代用していません。利用可能性はアカウントや地域版で異なり、この画像は本番環境での提供を証明しません。
Tabbitの使い方とAIブラウザ比較も参照してください。ブラウザ助手はリポジトリのテストを代替しません。利用可能性、使用枠、データの条件も確認しましょう。
用途別の選び方
| 要件 | まず調べる候補 | 理由 |
|---|---|---|
| 画像を使ったUI作業 | LongCat 2.5 | 画像入力を公表。エンドポイントと画面を検証する。 |
| 今すぐ重みを自社運用 | GLM-5.3 | 重みと手順を公開。ライセンスと機材を確認する。 |
| 低い公式API料金 | LongCat 2.5 | 現在の割引価格が低い。合格タスク当たりの費用を算出する。 |
| 長時間のコーディングエージェント | 両方試す | 公開ベンチマークはすべての条件を統一していない。 |
| 推論オフが必須のクライアント | LongCatのAPIを確認 | Z.aiはGLM-5.3で推論オンを必須としている。 |
譲れない要件から候補を絞り、小規模に評価してください。差が小さければ代替モデルを残し、提供元、エージェント、モデルの版が変わった際に再テストします。

よくある質問
プログラミングにはLongCat 2.5とGLM-5.3のどちらが適していますか?
どちらもコーディングエージェントの候補ですが、公開ベンチマークには異なる評価条件が混在しています。本番採用前に同じタスク、ツール、受け入れテストで比較してください。
LongCat 2.5の方が安いですか?
2026年11月3日時点のLongCatの期間限定料金は、キャッシュされていない入力100万トークン当たり0.30ドル、出力は1.20ドルでした。Z.aiのGLM-5.3はそれぞれ1.40ドルと4.40ドルで、実際の費用は使用量やキャッシュ、ツール、提供元にも左右されます。
両方のモデルでスクリーンショットを読み取れますか?
LongCat 2.5は画像入力に対応するマルチモーダルモデルと説明されています。Z.aiはGLM-5.3をテキスト入力専用と説明しており、画像には別の視覚コンポーネントかモデルが必要です。
自分のハードウェアで実行できますか?
Z.aiはGLM-5.3の重みと実行手順を公開していますが、ライセンスの確認と大規模なハードウェアが必要です。調査時点ではLongCat 2.5のGitHubとHugging Faceは公開予定と表示されていました。
コンテキスト長はどれくらいですか?
両社とも約100万トークンを公表していますが、入力と出力は同じリクエストの予算を共有し、クライアント側で制限される場合もあります。LongCatの最大出力は公式文書間で異なるため、使用するエンドポイントで確認してください。
LongCat 2.5 Previewと正式版は同じですか?
Previewは2026年11月のLongCat 2.5正式版に先行したバージョンです。Previewの利用者の声はテスト設計に役立ちますが、正式版の挙動を証明するものではありません。