
MiMo-V2.6-Pro 值得认真试一次:长程 Agent 批量任务、自动化工作流,以及出人意料的——写文章。它同时也是对你的耐心消耗最大的模型:发布当天,最强的开源智能分数背后,是开口前最长的等待之一。几个小时内,一位开发者说它修好了一个竞品旗舰模型修不动的脚本;另一位说它在终端里空转了三十分钟。这两条反馈都是真的。这篇测评负责把它们分拣清楚。
本文只计入你能点开核对的证据:官方口径、独立测量数据和有日期的社区反馈,各自标明它能证明什么。发布信息在 MiMo-V2.6-Pro 模型页,钱的事在定价分析。这里回答一个更窄的问题——它值不值得用、适合谁、代价是怎样的等待。
文末我会看这些结论对浏览器级工作流意味着什么。如果你的日常是多页面调研、信息抽取和自动化,而不是守着一个聊天框,这部分与你有关。
核心结论
MiMo-V2.6-Pro 在 Artificial Analysis 智能指数上得 46 分,同类 114 个模型中排名第一,是得分最高的开放权重模型;每项指数任务成本 0.13 美元,为对比组最低。(Artificial Analysis,2026-09-22 核对)
另一面是等待:Xiaomi 供应商 1 万输入 token 工作负载下,首答 token 需 18.17 秒,其中大部分是静默思考;之后的生成速度约每秒 125 token。(AA 供应商基准)
思考 token 按输出计费,每百万 0.87 美元(6.00 元)。指数任务集上思考 token 约 37,500 个,答案 token 约 26,800 个。
发布当天的真实反馈两极:一个坏掉的 Python 脚本在 GPT-6 Astra Light 失手后被它修好;一次 grep 死循环三十分钟,DeepSeek V4.1 Flash 完成了同样的任务。两个方向都只有单次样本。
写作是最大的意外惊喜——角色扮演与长文用户盛赞场景推进和对话质感。工具循环失控是最大的风险。按工作负载的裁决见文末决策表。
MiMo-V2.6-Pro 到底是什么
小米在 2026-09-22 发布 MiMo-V2.6-Pro 与 MiMo-V2.6-Flash,定位是围绕大规模强化学习打造的"原生全模态"开放权重模型。Pro 是稀疏 MoE:约 1.02T 总参数、每 token 激活 42B,100 万 token 上下文窗口,支持文本、图片、音频、视频输入、文本输出,MIT 许可。权重在 Hugging Face(XiaomiMiMo/MiMo-V2.6-Pro-RL);API 名称是 mimo-v2.6-pro,另有单独定价的高速档 mimo-v2.6-pro-ultraspeed。V2.5 系列端点将于 2026-10-21 下线(迁移背景)。
看任何数字之前先注意一件事:参数口径互相打架。技术报告写 1.02T 总参数 / 42B 激活;Hugging Face 摘要另有一行 524B;Artificial Analysis 结构化数据写 978B passive。把 1.02T/42B 当作官方技术报告的架构口径,但给硬件做预算前要核对具体 checkpoint。
本文回答的不是"它聪明吗"——排行榜已经回答了。而是:一个有着这样的速度画像、这样的计费结构、这样的工具循环特性的模型,是否适合进入你的工作流,尤其是对比 GPT-6 Astra、Claude Fable 5.1 或更便宜的 Gemini 3.8 Flash 时。
决定这篇测评的那一个数字:18 秒的沉默
下面这组数字统摄全文。MiMo-V2.6-Pro 拿下 Artificial Analysis 测得的最高开放权重智能分(46 分,114 个同类第一),同时是对比组里每任务成本最低的模型(0.13 美元)。它也是唯一名单供应商(Xiaomi,1 万输入 token 工作负载,2026-09-22 核对)上首答 token 需要 18.17 秒的模型。
这两个数字描述的是两个完全不同的模型,取决于等的是谁。对一个要跑三十轮工具调用的后台 Agent 来说,18 秒的前置思考摊薄在几分钟的无人值守工作里几乎无感,之后 125 token/秒的生成速度在同一快照里只落后一两个模型。对一个提了问题盯着光标的人来说,18 秒无比漫长,而 500 token 回答的端到端 22.2 秒更糟。
同日早些时候的 Artificial Analysis 快照把等待拆开:思考 15.41 秒 + 输入处理 2.17 秒——87.7% 的等待是模型开口前的推理。同一份结构化数据也解释了账单的怪相:每项指数任务约 37,520 个推理 token 对 26,756 个答案 token。每看到 1 个 token 的答案,你要为约 1.4 个 token 的隐藏思考付钱。
Reddit 用户在发布几小时内就撞上了同一堵墙:
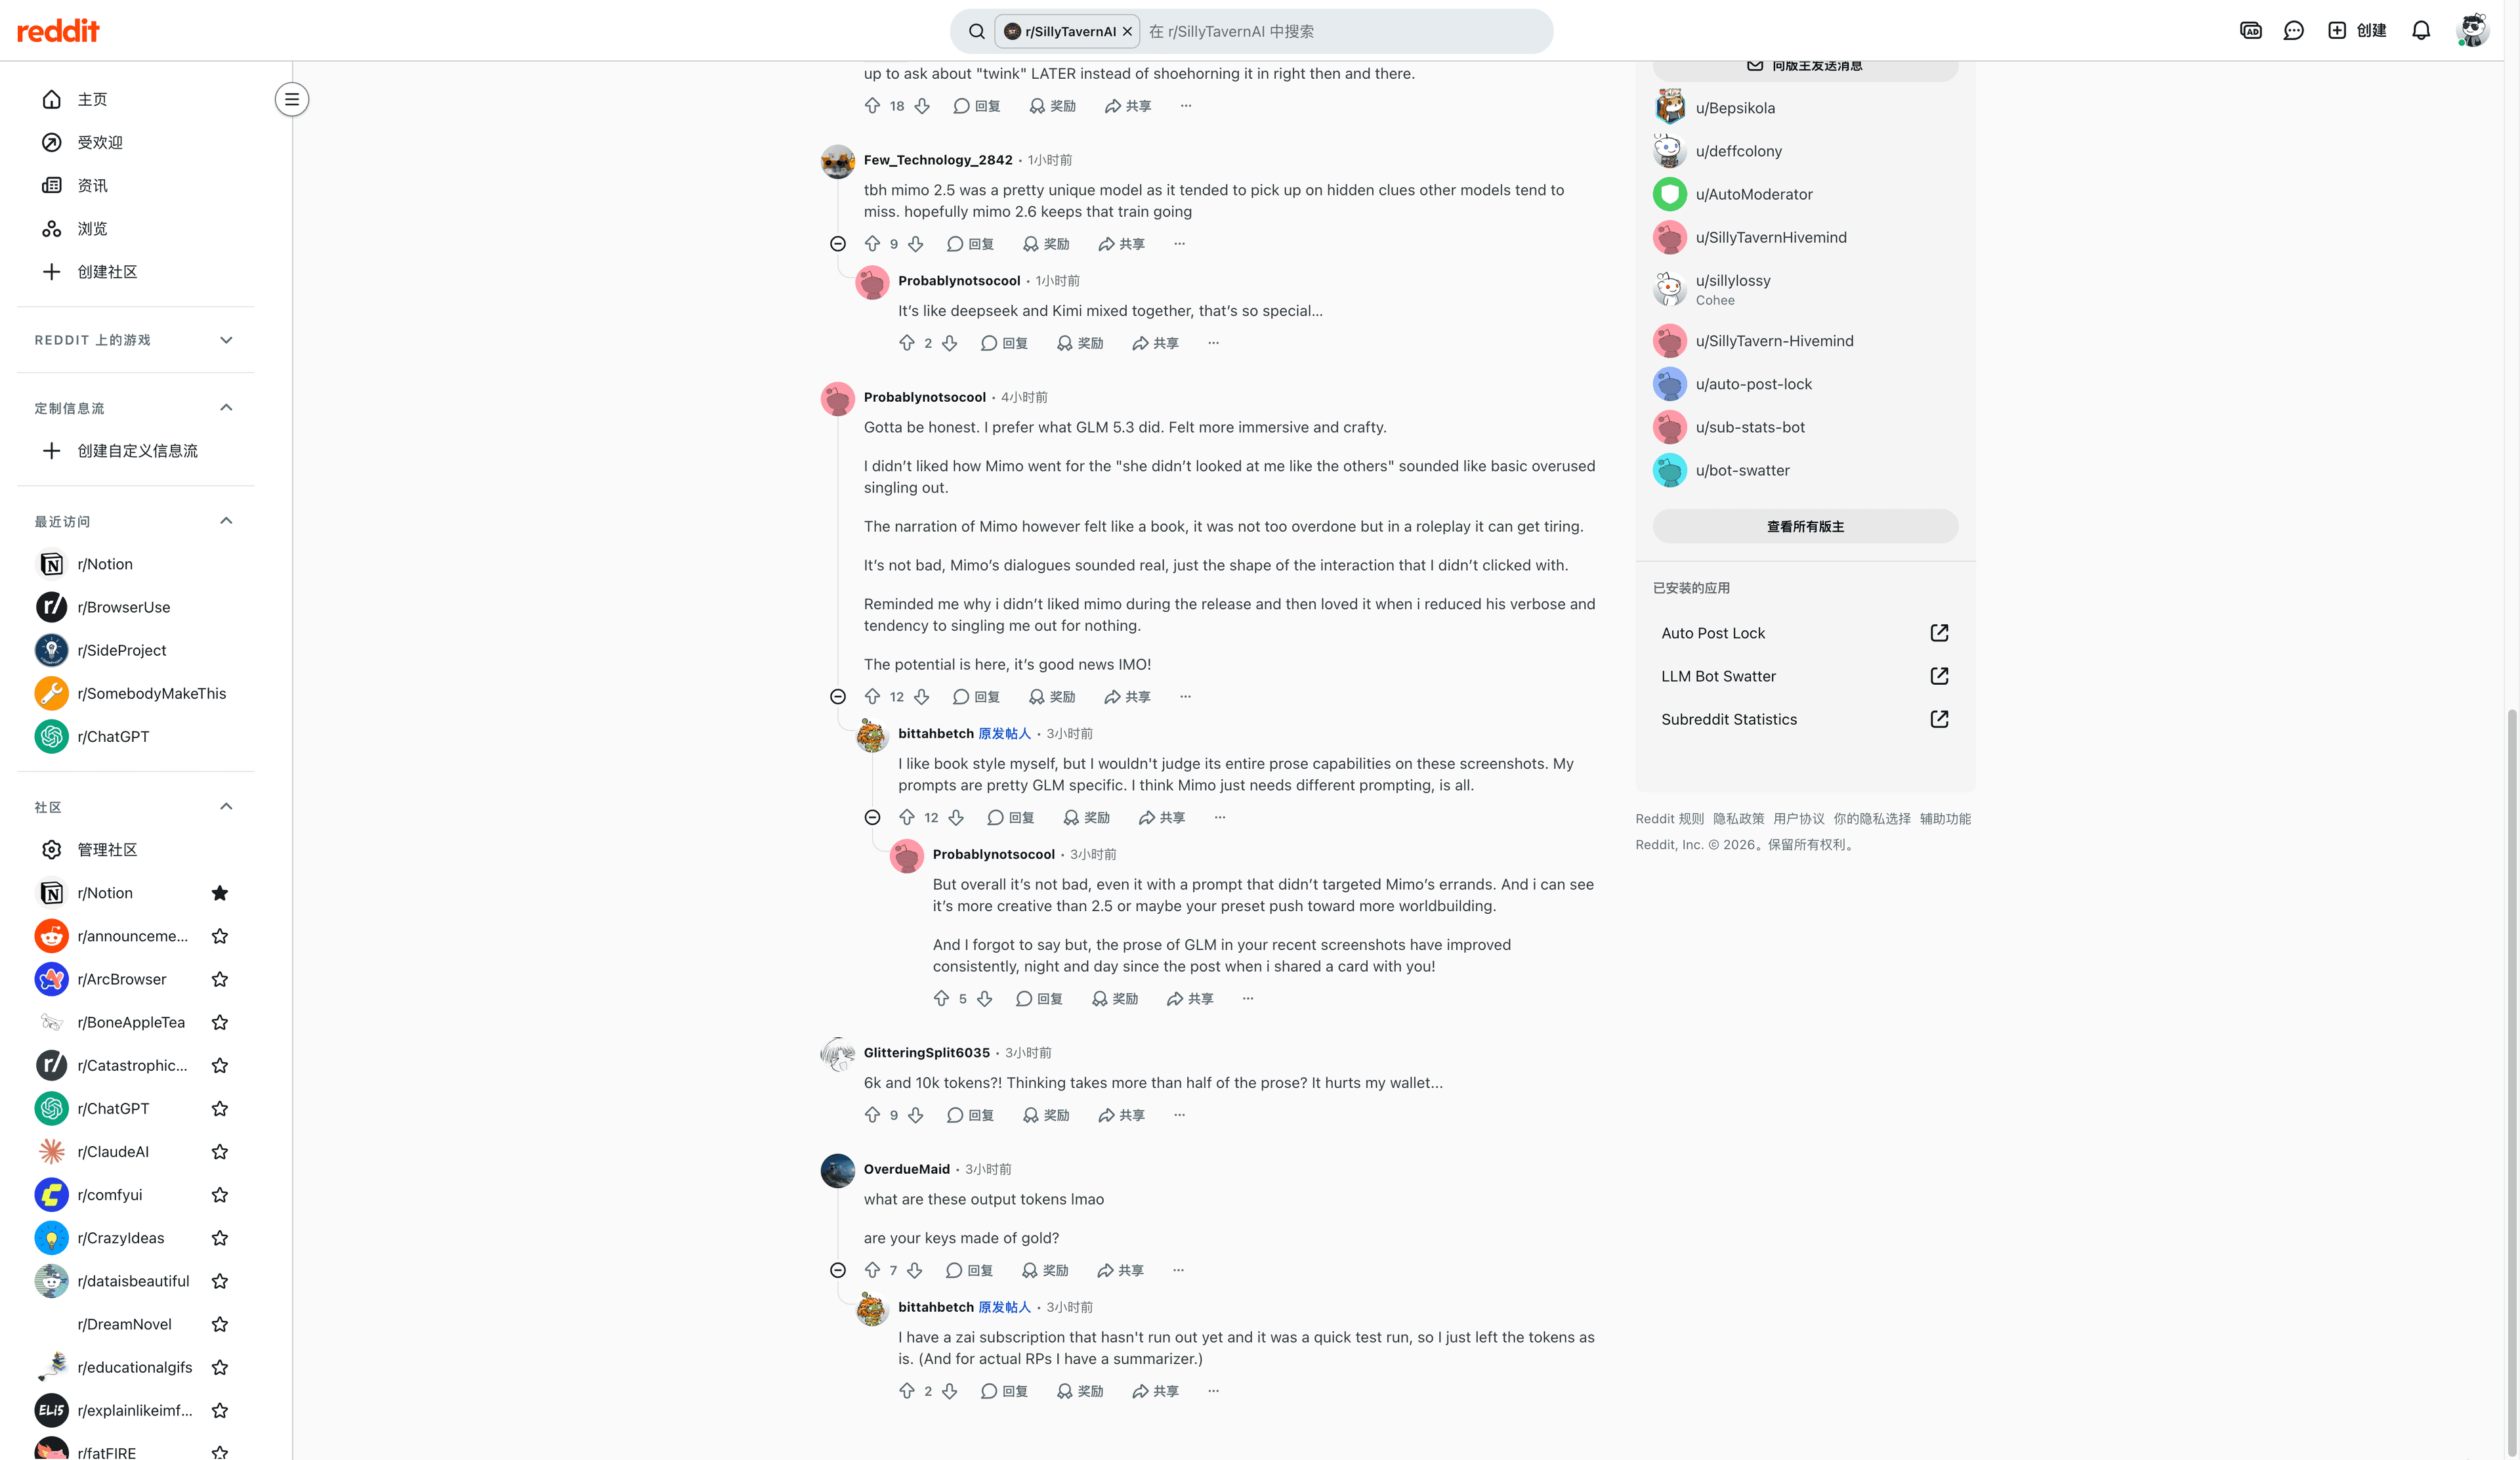
"6k and 10k tokens?! Thinking takes more than half of the prose? It hurts my wallet..." ——u/GlitteringSplit6035(r/SillyTavernAI,2026-09-22;译:六千一万个 token?思考占了正文的一半多?我的钱包在滴血……)
"what are these output tokens lmao are your keys made of gold?" ——u/OverdueMaid(同帖;译:这些输出 token 是什么鬼,你的 key 是金子做的吗?)
用这个锚点分拣你的工作负载:工作单位是长跑,就买它的脑子、忍它的等待;工作单位是人的一个回合,那等待本身就是产品。
先看真实工作上的成败,再看排行榜
发布当天最有用的证据不是基准行,而是两个有具体工具、具体结果的小故事。
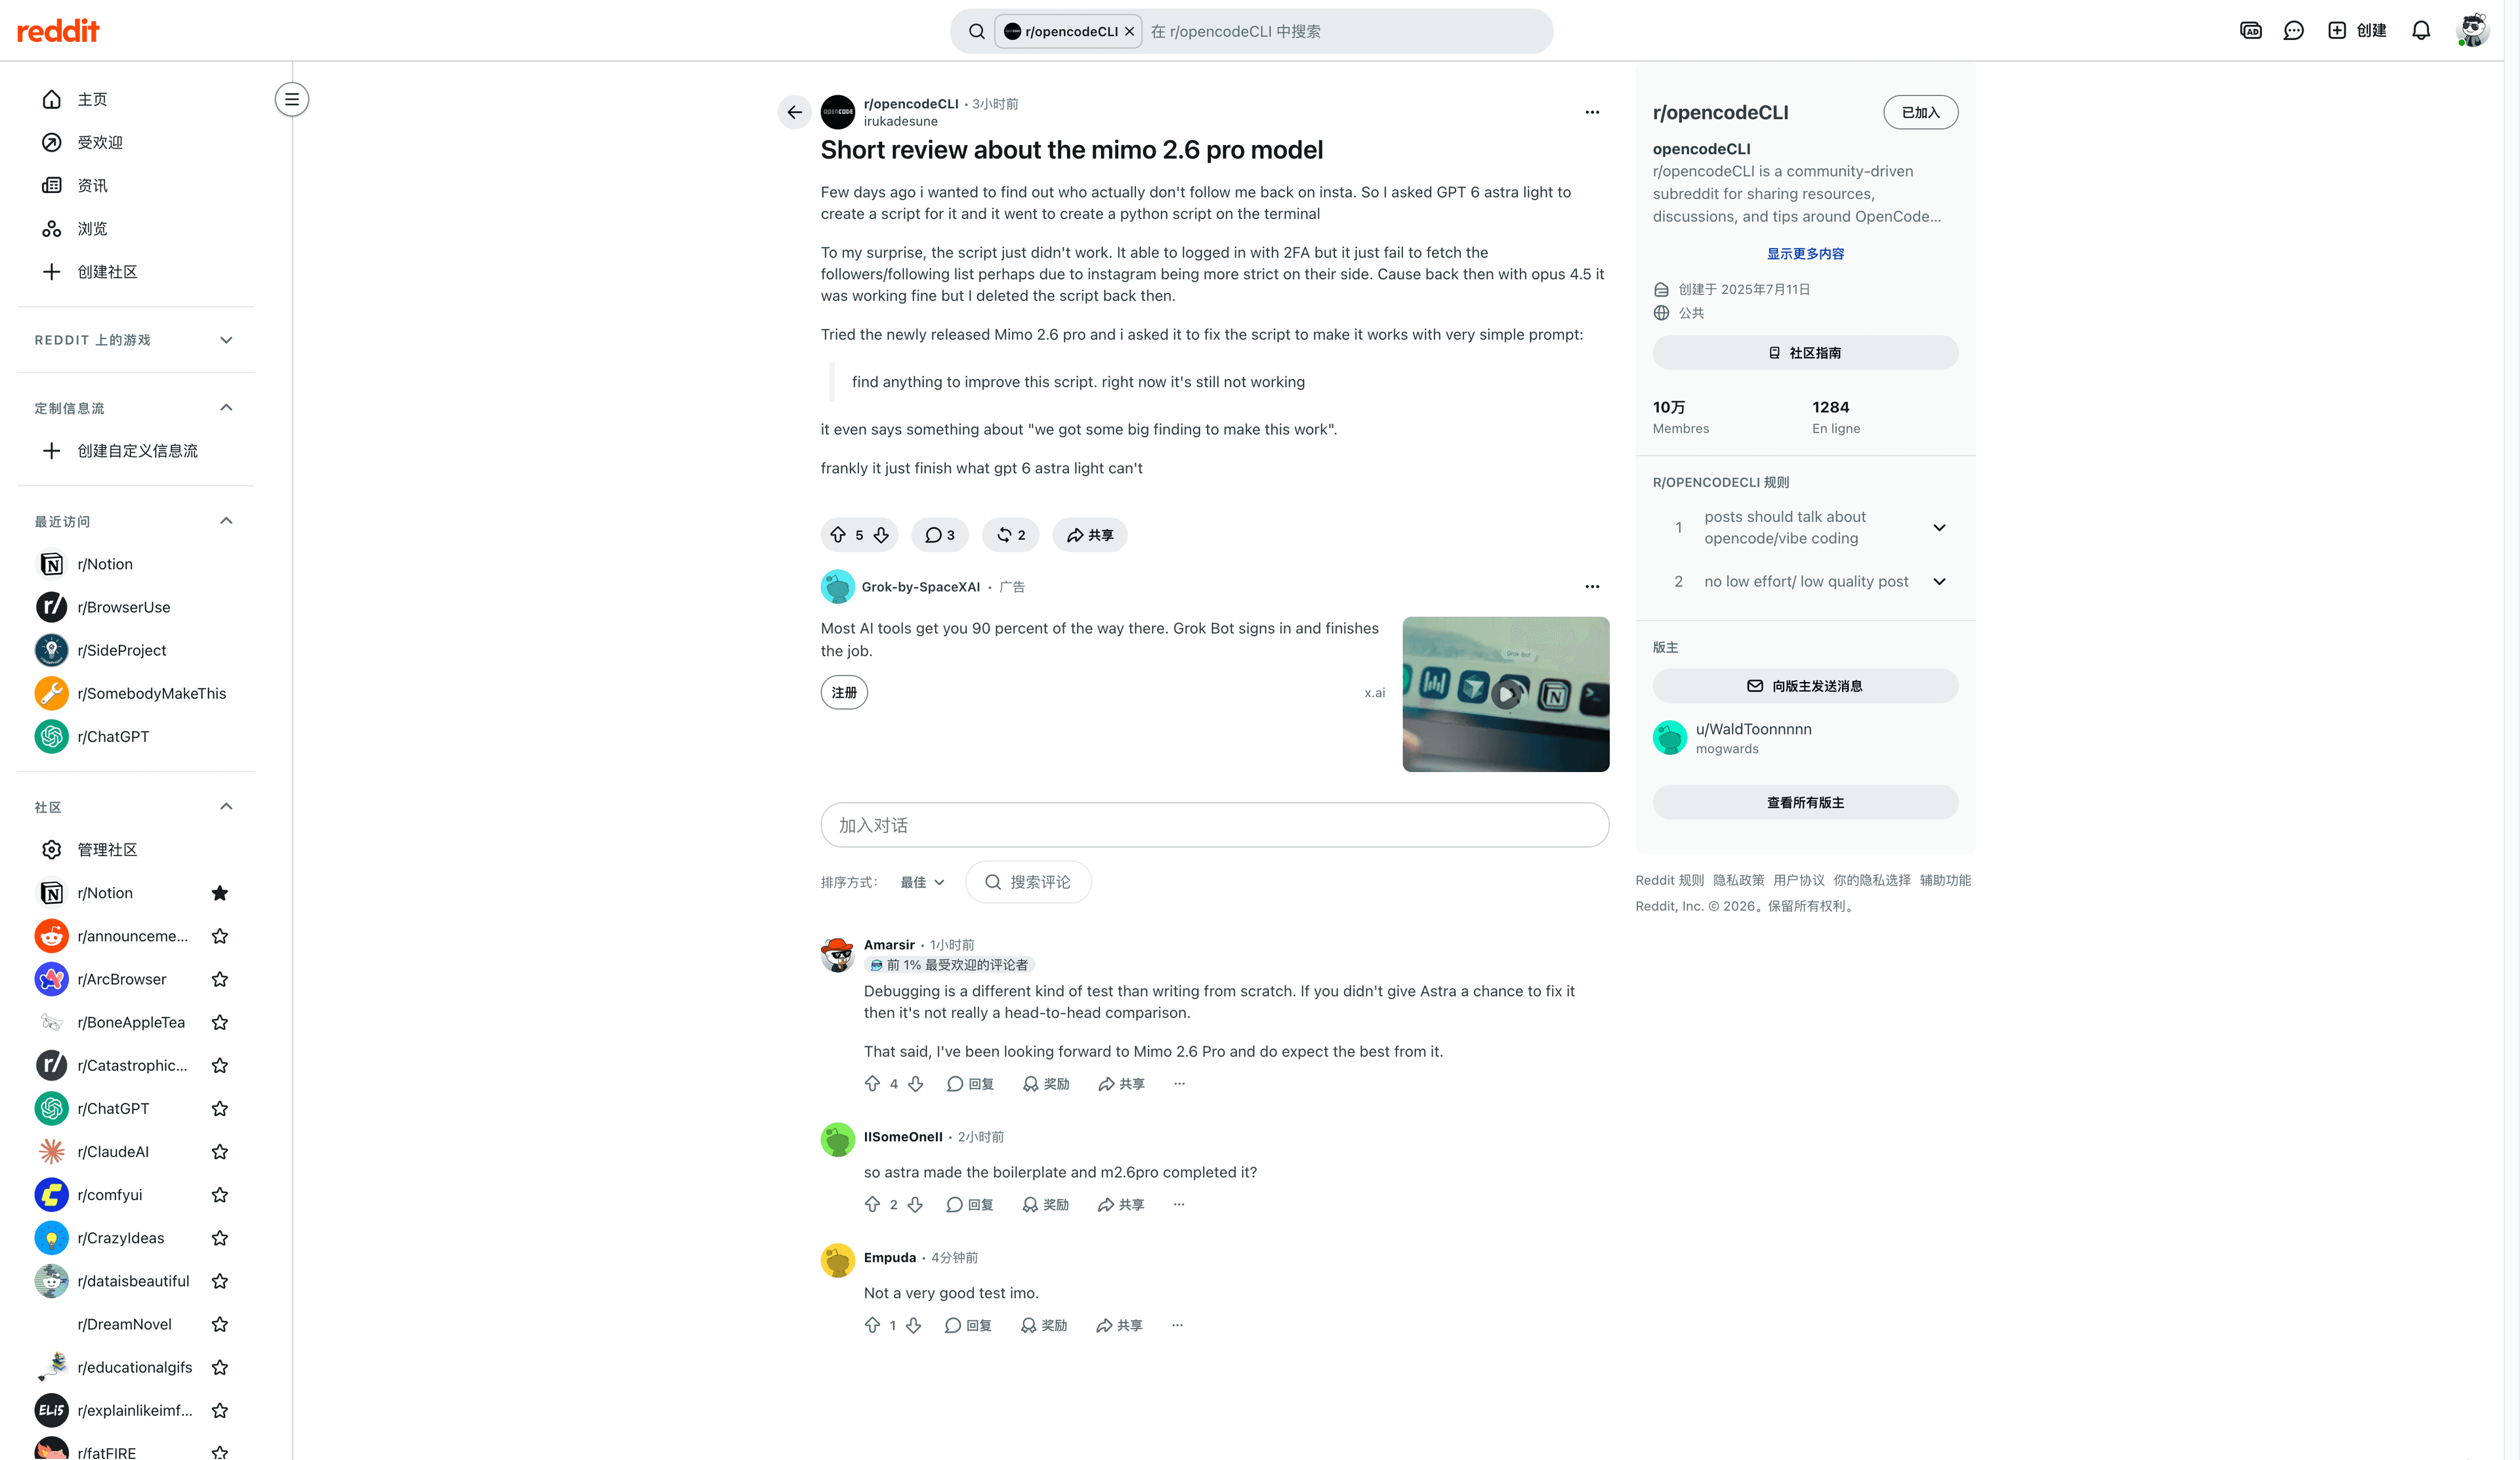
赢的那次。 u/irukadesune 有个查 Instagram 回关的 Python 脚本。GPT-6 Astra Light 重写后依然在拉取粉丝列表时失败。给 MiMo-V2.6-Pro 的提示只有一句:"find anything to improve this script. right now it's still not working." 它修好了。
"frankly it just finish what gpt 6 astra light can't" ——u/irukadesune(r/opencodeCLI,2026-09-22;译:说白了,它就是把 GPT-6 Astra Light 干不完的活干完了)
泼冷水的回复。 该帖最高赞回复指出了这个故事能与不能证明什么:
"Debugging is a different kind of test than writing from scratch. If you didn't give Astra a chance to fix it then it's not really a head-to-head comparison." ——u/Amarsir(同帖;译:调试和从零写是两种不同的考验;没给 Astra 修的机会,就谈不上正面对比)
输的那次。 u/choiyoh 把同一个网站 UI/UX 修改任务交给 MiMo-V2.6-Flash 和 MiMo-V2.6-Pro,在终端编码工具里执行。两个模型都陷入 grep 循环,毫无进展。
"for 30 minutes no code was fixed." ……"DS 4.1 Flash is still much better.." ——u/choiyoh(r/CommandCode,2026-09-22;译:三十分钟没有修好任何代码……DS 4.1 Flash 还是好用得多)
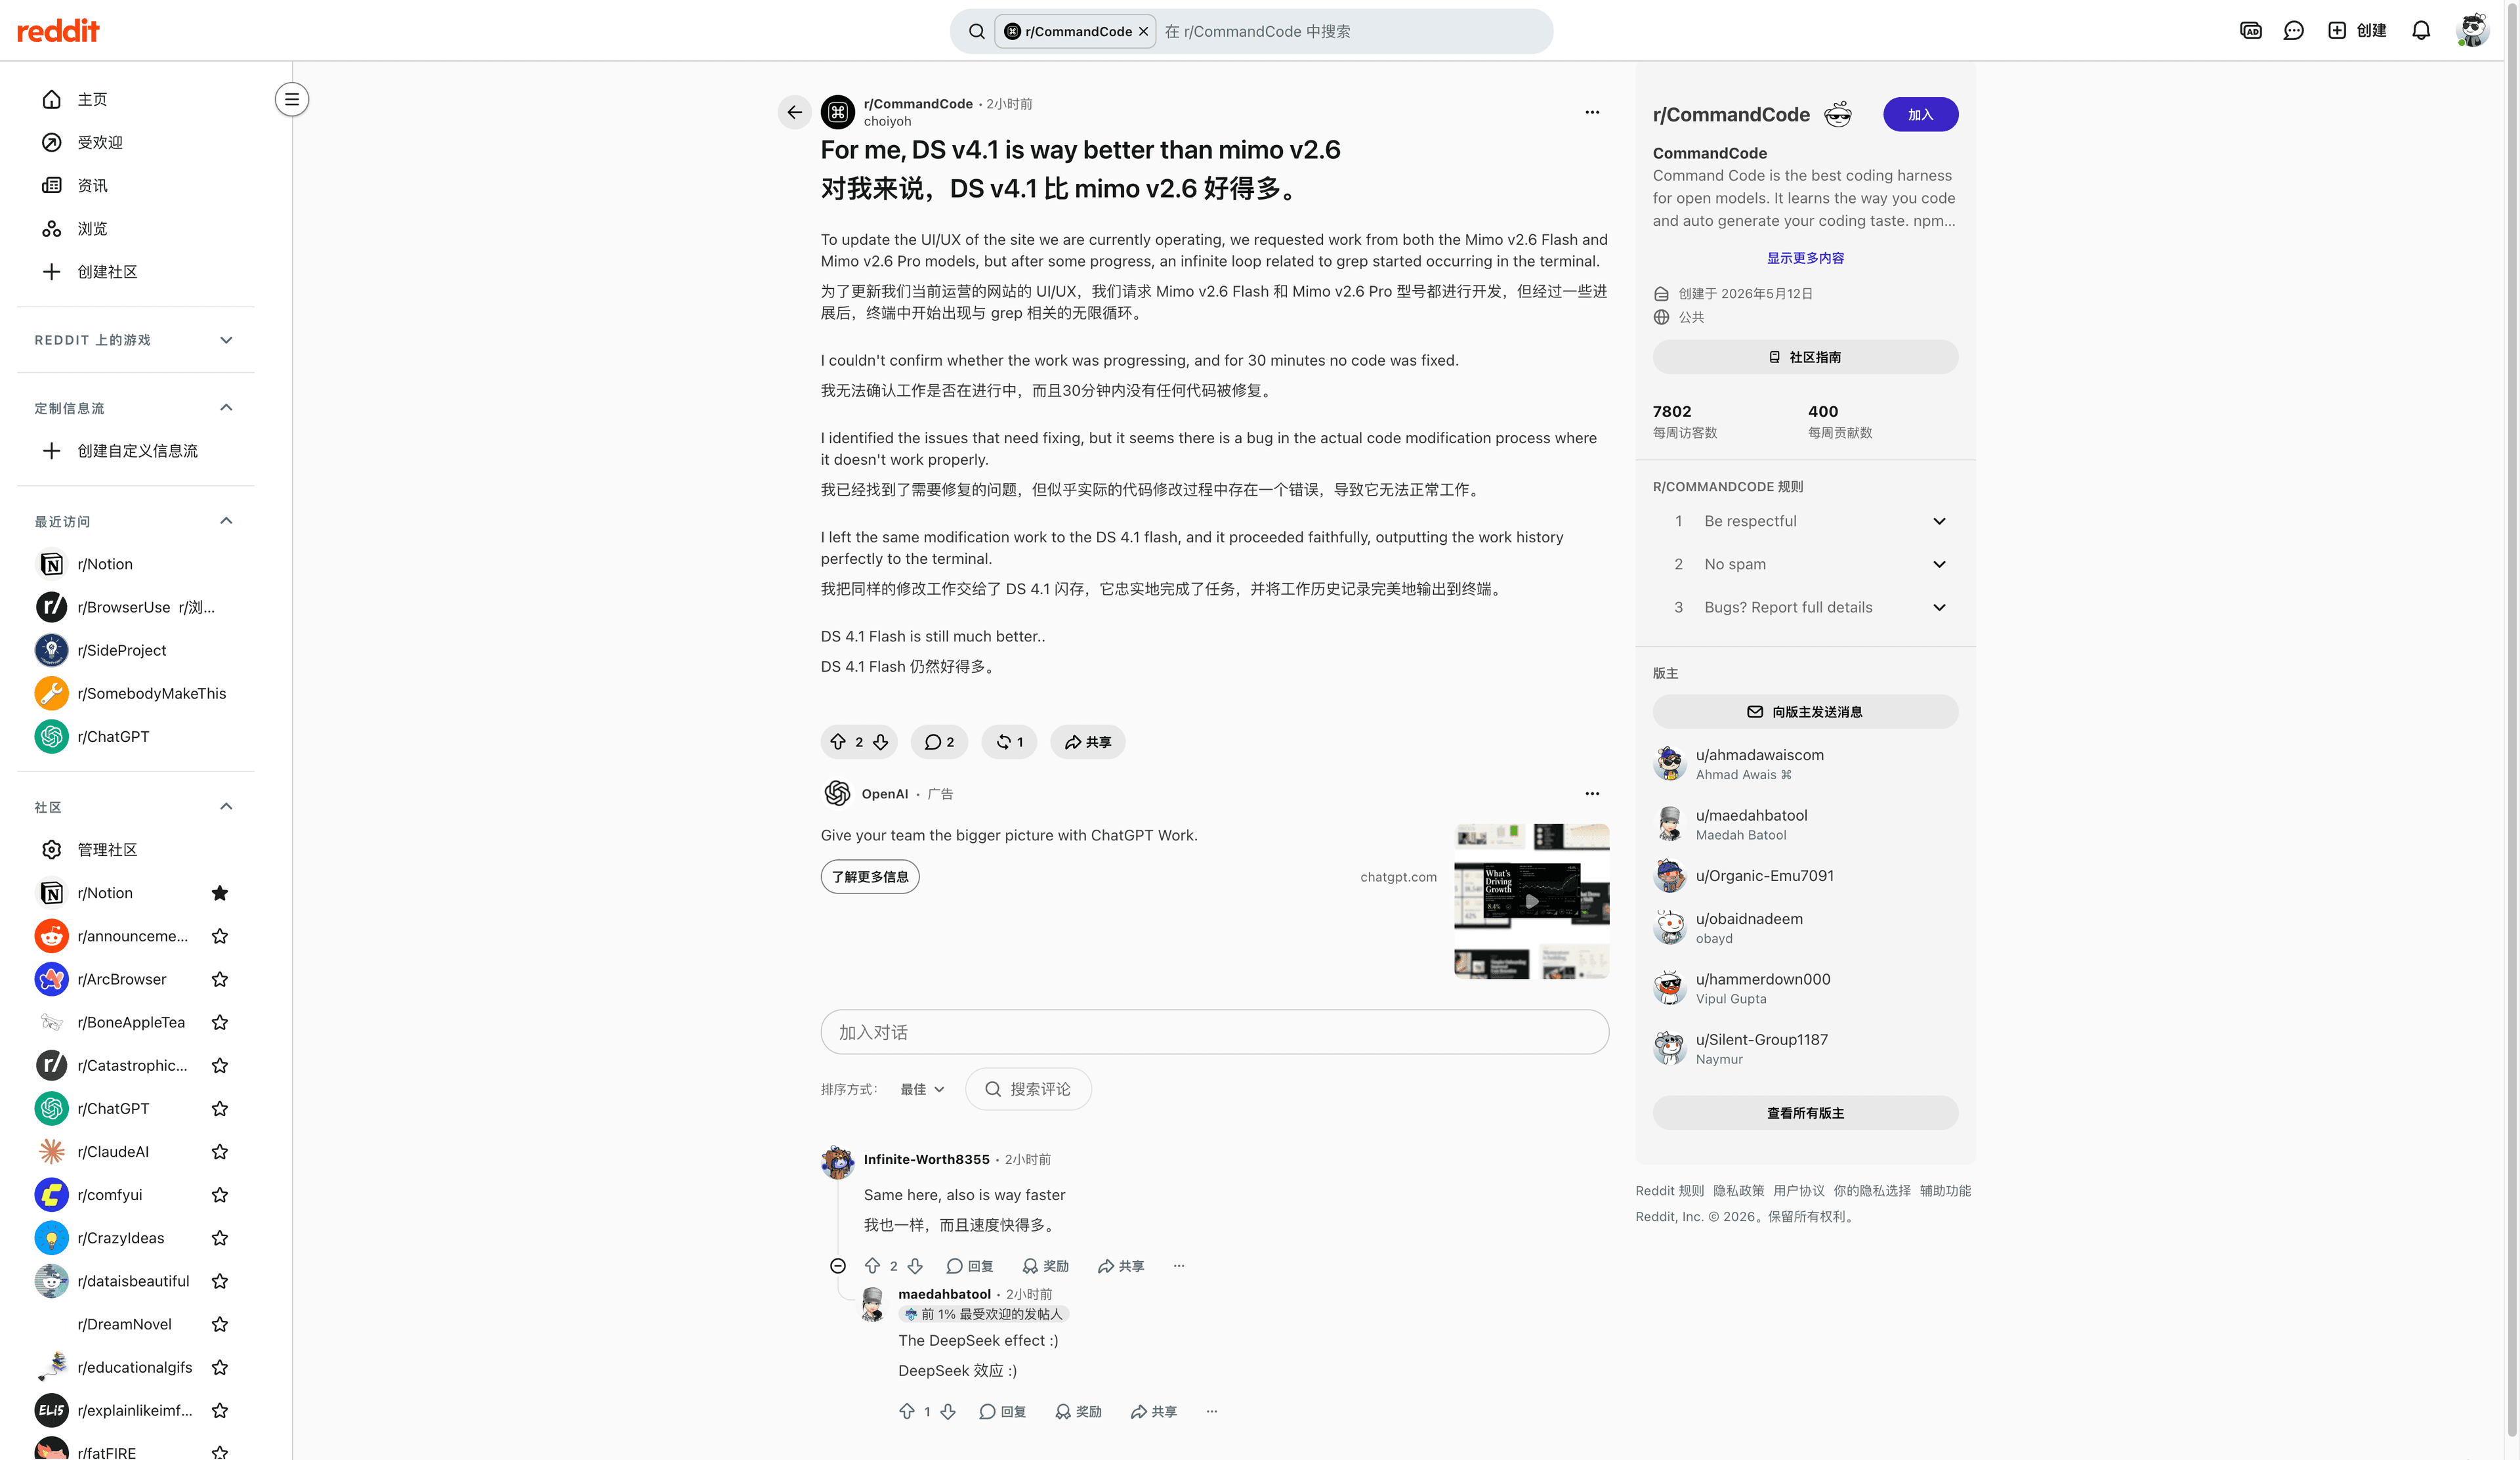
各一次运行,没有日志、没有仓库、没有 token 统计。它们只能证明两种结果都真实存在——赢过竞品的调试修复,和三十分钟的工具空转——证明不了各自的发生频率。这正是基准应该填补的空白。来看看它们到底填了多少。
基准数据,以及该信几分
小米技术报告(Table 3,厂商自报,2026-09-22 核对)把 Pro 与自家家族和三个闭源旗舰做了对比。数值按报告原样记录,- 表示未提供:
| 基准 | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.5-Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| MiMo Visual Coding(自研) | 72.3 | 71.5 | - | 70.0 | 73.4 | 69.1 |
现在按惯例泼三盆冷水。
测量条件很薄。 报告只给汇总分,没有逐题日志、提示词、随机种子、样本量和置信区间。三行(MiMo Code Bench、MiMo Cyber Bench、MiMo Visual Coding)是小米自己的基准。被反复转述的"DeepSWE 58.4 → 72.6"是同一次 RL 训练内的曲线变化——约 30 步、262 万美元算力——不是模型对模型的比较。官方发布页"在多数 Agent 基准上与 Claude Opus 5 和 GPT-5.6 Sol 相当"是定位话术,"价格是其 1/20 到 1/60"的说法没有给出对比集和 token 口径。
社区默认不信任训练期排行榜:
"We'll see how it works on real code. DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world … The benchmarks don't care if it's a code spaghetti." ——u/lilian_moraru(r/LocalLLaMA,2026-09-22;译:真实代码里见分晓……基准测试并不在意代码是否混乱不堪)
"i mostly care about roleplay so those benchmark wins dont mean much if it still forgets details after a few messages." ——u/Pure-Summer2818(同帖;译:我主要看角色扮演,聊了几句就忘细节的话,基准赢了也没意义)
独立来源印证的是形状,不是精度。 Artificial Analysis 在自有硬件上跑出 46 分智能指数(v4.3.2,10 项评测);Arena 的 Code Arena WebDev 行是 AutoEval 1628(+18/-18),Rank 与 Votes 均为 N/A——那是盲测投票榜上的脚本结果,不能写成"排名第 N"。上文 Amarsir 的方法论提醒适用于这里的每一行:调试不是创作,一个 harness 不是你的 harness,方向性信号不是标尺。
泼完冷水还站得住的:相对 V2.5-Pro 的代差(DeepSWE 19.0 → 71.9)大到不可能是统计花招;报告里跨 harness 迁移实验(四个训练 harness,再测没见过的 Codex、Claude Code、mini-swe-agent,通过率约 50% → 66%)是真正贴近部署的证据。只是别把任何一行读成你的成功率。
MiMo-V2.6-Pro 真正强的地方
写作是最大的意外
编码模型很少先被夸文笔。发布当天最响亮的赞美来自长文角色扮演写手——这是一群对重复套路极其苛刻的用户。
"honestly I'm really enjoying it for RP so far. The responses have been surprisingly good, especially when it comes to keeping the flow of a scene going and actually giving me something interesting to work with instead of falling into the usual repetitive RP patterns." ——u/Electrical_Mode_2489(r/SillyTavernAI,47 赞;译:RP 体验真的好,尤其擅长推着场景走,给我有意思的东西接戏,而不是掉进重复套路)
另一位与 GLM 5.3 正面对比的写手喜欢它的对话和克制:它"set[] up to ask about 'twink' LATER instead of shoehorning it in right then and there"(译:把关键信息留到后面再问,而不是硬塞进当下)。如果你以写作为生——小说、营销文案、长互动故事——这个升级对你可能比任何编码分都重要。
边界:文风是个人口味。在同一个对比帖里,u/Probablynotsocool 更喜欢 GLM 5.3("Felt more immersive and crafty"),觉得 MiMo 的叙事"like a book … in a roleplay it can get tiring"(译:像读小说,放在 RP 里容易累)。两位都是有经验的用户,同样的输出,相反的结论。
自动化与工具工作流,纸面上胜过旗舰
基准的形状在这里是真偏向 MiMo 的。AutomationBench v1.0.6:53.1,超过 Claude Opus 5(50.3)和 GPT-5.6 Sol(45.8)。Toolathlon-Verified:76.9,距 Opus 5 仅 3 分并领先 Sol。Terminal Bench 2.1:89.9,对比组第一。JobBench 62.0 是 GPT-5.6 Sol(45.4)的近一倍半。
这些行背后的工程细节对部署更重要:RL 阶段在四个极简 harness 上训练,再在三个没见过的 harness(Codex、Claude Code、mini-swe-agent)上验证迁移。只在自家 harness 里好用的模型是演示品,能迁移的模型才是基础设施。对搭建多步工具循环的人——浏览器 Agent、CI 修复器、内部自动化——这是试用它的最强理由。
商品级价格上的旗舰智能,还带 MIT 权重
2026-09-22 核对的 Artificial Analysis 快照里,MiMo-V2.6-Pro 智能指数 46 分——与 Grok 4.7(46)持平、低于 Claude Opus 5(51)——同时是对比组每指数任务成本最低的模型(0.13 美元)。牌价是每百万 token 输入 0.435 美元 / 输出 0.87 美元(3.00 / 6.00 元),缓存命中降到 0.0036 美元——120 倍折扣悄悄改写了多轮对话的经济性(定价精算见此;想横向比较开放旗舰预算,可看 Kimi K3 定价拆解)。
同日旗舰的社区对比把这笔账算得很具体:对 Grok 4.7,MiMo 上下文 100 万对 50 万 token、约 125 对 42 token/秒、MIT 权重对闭源、0.435/0.87 对 2/6 美元——而两者智能指数同为 46 分。如果你的约束是"每美元买到多少能力"——批量 Agent、研究流水线、Agentic 推理工作负载——这就是本次发布的价值主张。
它会咬人的地方
思考税:沉默你付两次钱
一次付在等待,一次付在账单。首答 token 18.17 秒;每项指数任务约 37,520 个推理 token 对 26,756 个答案 token,全部按每百万 0.87 美元的输出计费。推理密集的提示词上,社区用户反馈思考量超过总生成量的一半——正是上文"6k and 10k tokens?!"式反应的由来。
小米官方的逃生口是 mimo-v2.6-pro-ultraspeed:最高 20 倍生成速度,价格恰好 10 倍(输入 4.35 美元 / 输出 8.70 美元)。对有预算的交互式产品是真选项,但它把模型重新定价回了前沿区间,抵消了最大的性价比卖点。官方 API 材料里目前没有"少想点"的开关——定价分析里把这笔账算完了。
工具循环会跑飞
上文 grep 死循环是 Agent 工作里最疼的失败形态:不是答案错,而是没有答案,计费还在走。技术报告坦诚其训练基础设施遇到过 OOM、评分器不可达和部分 rollout 失败,但没有给出各基准的统一失败率。同帖另一位用户印证了同样的体验("Same here, also is way faster",说的是竞品)。如果拿它跑无人值守任务,就要配监督、工具调用超时和备选模型——与你对待任何 Agent 浏览器栈的纪律相同。
合规、端点与部署重量
三个不进分数的现实麻烦:
数据处理。 发布当天就有用户指出当前唯一在线端点是第一方的,且在他们的理解里不符合零数据保留(ZDR):"very interesting, but 2.6 Pro's only endpoint is non-ZDR compliant"(u/total_ty),紧接着是"How trustworthy is a random tag on a website, honestly? How do we verify none of our data has been retained by the endpoint?"(u/starliteburnsbrite)。开源权重意味着第三方托管会来——"the weights are already up on huggingface"——但今天合规路线是自建,或者找一个你读过条款的提供商。
自建很重。 1.02T 稀疏 MoE,官方 vLLM 示例默认
--tensor-parallel-size 8。这不是笔记本模型。预算按多卡节点算,先读参数口径的细则。版本与价格漂移。 V2.5 端点 2026-10-21 关闭;Artificial Analysis 的数字同一天内就随测量刷新漂移过(17.58 → 18.17 秒)。锁定版本,做预算前重新核价。
大家到底怎么说
发布当天的讨论沿两条轴分裂,而不是一条。
轴一:惊喜派对上烧手派。 修脚本的胜利和 grep 的翻车在 Reddit 上只隔四小时,两边阵营立刻满员。u/irukadesune 一句提示修好了竞品旗舰修不动的东西;u/choiyoh 在终端循环里丢了三十分钟,转投 DeepSeek V4.1 Flash。兴奋的人读同样的证据往外推——"I believe in mimo, mimo will replace GLM as THE rp model"(u/stopaskingforloginn)——怀疑的人则要日志。
轴二:价格惊喜派对思考账单派。 发布帖的第一波冲击是经济账——"They kept the prices!? It's over."(u/Pink_da_Web,译:价格没涨?!别的模型没戏了)——然后 token 数来了:
就连这个模型最满意的用户群——写手们——内部也吵不出一致:
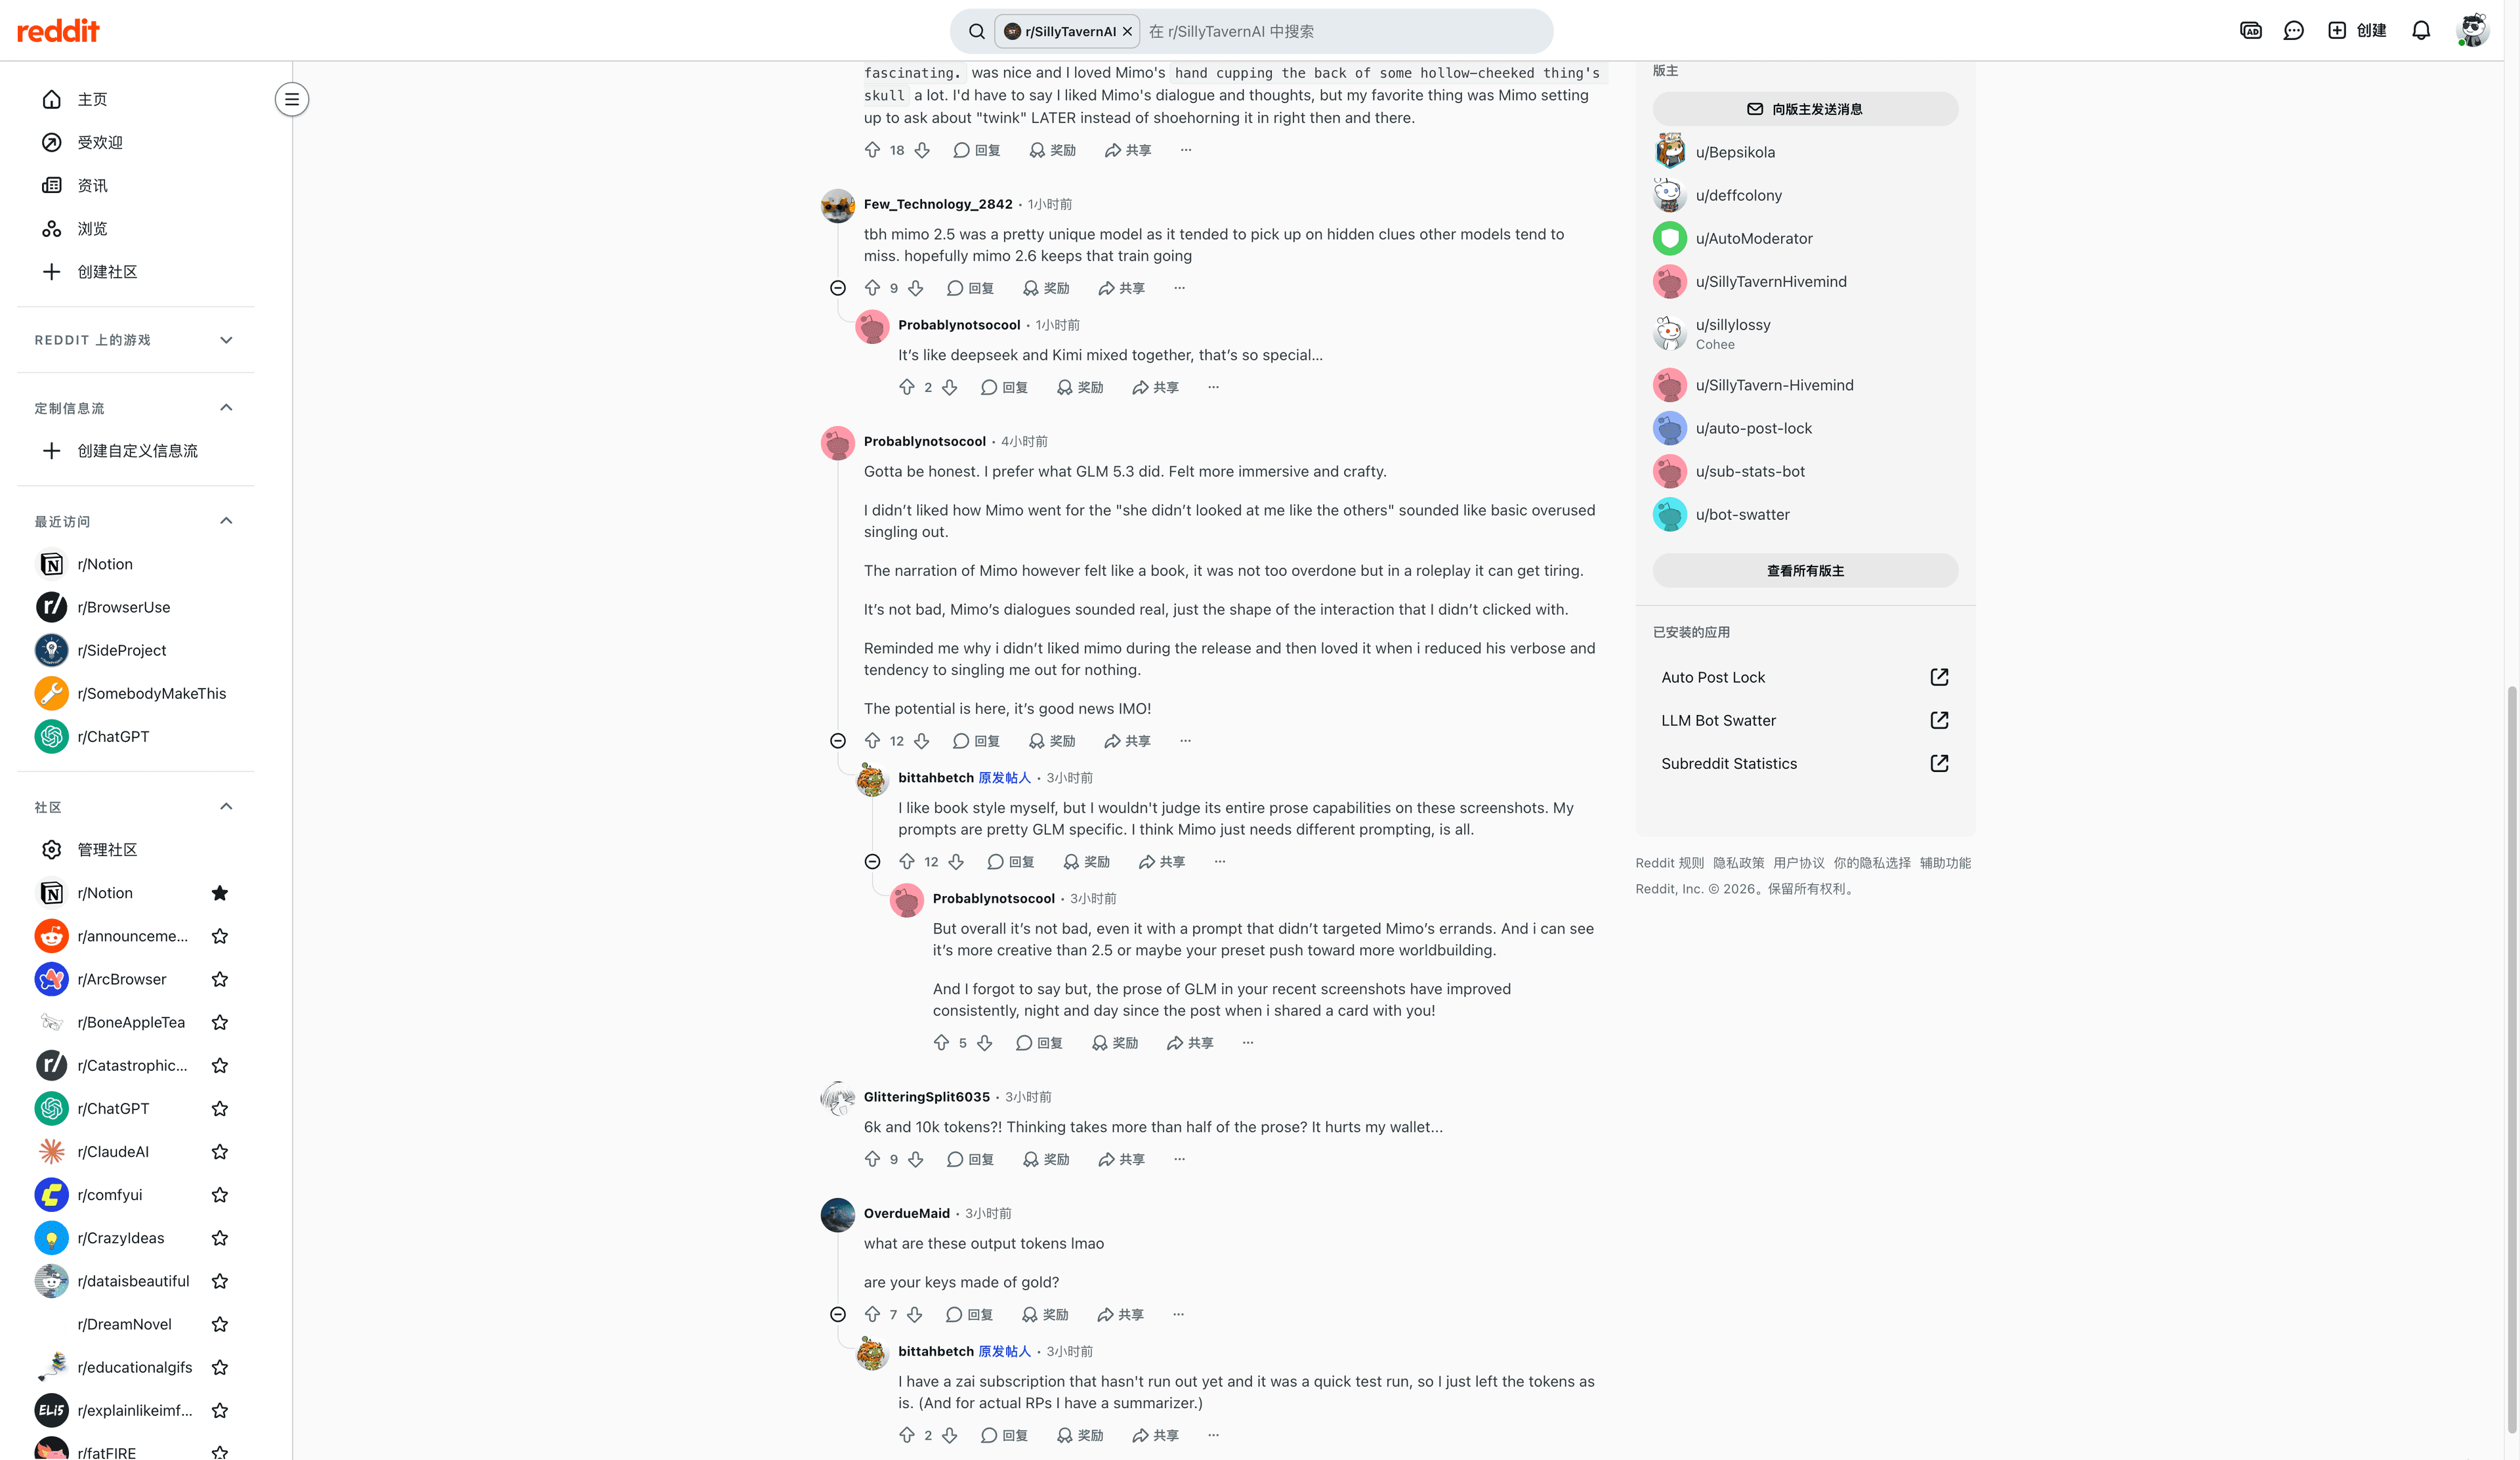
本文的立场:与 u/Amarsir 落点相同——欣赏这个模型,但对草率的对比不耐烦。九条可核对的声音呈现的模式与数字一致:能力是真的,等待和账单的摩擦是真的,工具循环的可靠性两个方向都还停留在 n=1。
裁决:按工作负载选,不按分数选
| 工作负载形状 | 裁决 | 为什么 | 主要保留 |
|---|---|---|---|
| 长程 Agent 编码、批量修复、无人值守工具循环 | 值得试 | AutomationBench 53.1 超过 Opus 5 与 Sol;有 harness 迁移证据;1M 上下文;0.13 美元/任务摊薄等待 | grep 式循环失败真实存在;跑批要监督并留备选模型 |
| 交互对话、角色扮演与长文写作 | 可以,带条件 | 写作赞美具体且重复出现;1M 上下文保住长场景连贯 | 18 秒首响 + 思考 token 同时抬高每场戏的延迟和成本;部分写手更喜欢 GLM 5.3 的文风 |
| 计算机操作与浏览器自动化 | 强候选 | OSWorld-Verified 82.0、JobBench 62.0、视觉编码 72.3(自研);全模态输入 | 证据以厂商数据为主;先在你自己的任务集上验证 |
| 受监管数据 / 零保留需求 | 暂不 | MIT 权重原则上允许自建或合规提供商 | 今天在线的只有第一方端点,其 ZDR 状态未经核实 |
| 单卡或笔记本本地推理 | 不行 | 1.02T 稀疏 MoE;官方推理示例按 8 路张量并行 | Flash 家族或更小的蒸馏版才是现实的本地选项 |
两个时效提醒。第一,Grok 4.7 同日发布,在 Artificial Analysis 指数上同为 46 分,社区对比的结论是"neither one decisively dominates the other"(译:谁也不能稳压谁)——你该做的是用你的工作负载跑对比,最好让两个模型并排作答。第二,V2.5 端点 2026-10-21 关闭,如果你建在它上面,迁移规划没有可选项。
一条务实路线:让它在干活的地方跑
这篇测评的所有结论都指向同一个画像:等待伤人不伤 Agent;思考 token 惩罚闲聊式单轮、奖励持续长跑;工具循环风险需要监督。这个画像塞进文档旁边的小聊天框是错配,放进浏览器级工作流则是顺理成章——读页面、装下 100 万 token 上下文、在你干别的时候把活干完。
这正是 Tabbit Browser 围绕的工作方式:把多页面调研、信息抽取和自动化当作 agentic browser 任务,而不是一次提示词。诚实的边界:本轮测评未能核实 MiMo-V2.6-Pro 当前是否出现在 Tabbit 的实时模型选择器中,本文不声称任何 Tabbit 实测。像对待任何模型在任何客户端的可用性一样,先检查你账户里的模型选择器再做规划。
如果上面的画像和你的工作吻合——长跑、重上下文、工具调用、成本纪律——正确的问题就不是"哪个模型分最高",而是"哪个模型把我的活干完"。用你自己的固定任务集让两个候选跑一轮,按每美元完成的工作量结算。这个测试胜过本文里的任何一行排行榜。
 Tabbit Browser

常见问题
MiMo-V2.6-Pro 值不值得用?
如果你跑的是长程 Agent 编码、自动化任务或创意写作这类更看重完成质量而非即时响应的工作负载,值得认真试一次。如果你需要快速首响、可验证的零数据保留端点或单卡本地部署,就要谨慎,并且在拍板前至少对比一个竞品。
MiMo-V2.6-Pro 多久能给出回答?
Artificial Analysis 在 Xiaomi 供应商、1 万输入 token 工作负载下测得首答 token 为 18.17 秒(2026 年 9 月 22 日核对)。等待之后生成速度约每秒 125 token,因此绝大部分延迟是开口之前的静默思考时间。
MiMo-V2.6-Pro 的思考 token 计费吗?
计费。小米把内部推理 token 按标准输出计费,每百万 6.00 元(0.87 美元)。Artificial Analysis 记录到每项指数任务约 37,500 个思考 token 对 26,800 个答案 token,也就是说你付的输出费用有很大一部分花在看不到的思考上。
MiMo-V2.6-Pro 和 Grok 4.7、Claude Opus 5 比怎么样?
在 2026 年 9 月 22 日核对的 Artificial Analysis 智能指数上,MiMo-V2.6-Pro 与 Grok 4.7 同为 46 分,Claude Opus 5 为 51 分。小米自己的报告里 DeepSWE v1.1 为 71.9,Grok 4.7 约 73、Opus 5 为 74;而输入价格是每百万 3.00 元对 2 美元和 15 美元。
MiMo-V2.6-Pro 是真开源吗,能自己部署吗?
权重采用 MIT 许可并可在 Hugging Face 下载,开放程度高于多数前沿模型。但自建门槛很高:这是约 1.02T 总参数、42B 激活参数的稀疏 MoE,官方 vLLM 与 SGLang 示例都按多卡配置。各处参数摘要口径不一致,选型前务必核对具体 checkpoint。
能在 Tabbit Browser 里用 MiMo-V2.6-Pro 吗?
Tabbit 通过账户实时模型选择器来运行浏览器级 AI 工作流。本轮测评未能核实 MiMo-V2.6-Pro 当前是否出现在该选择器中,请先检查你自己的选择器和账户条款再做规划。不要根据模型页想当然地认为可用。