
MiMo-V2.6-Pro mérite un essai sérieux pour les exécutions agéntiques longues, l'automatisation et, surprise, la prose. C'est aussi le modèle qui exige le plus de patience : le jour de son lancement, le meilleur score ouvert est arrivé avec l'une des plus longues attentes avant le premier mot. En quelques heures, un développeur racontait avoir réparé un script qu'un modèle rival n'avait pas pu, un autre racontait rester bloqué dans une boucle de terminal pendant trente minutes. Les deux rapports sont réels. Ce review les met en ordre.
Ce review ne compte que les preuves que vous pouvez ouvrir et vérifier : affirmations officielles, données mesurées indépendamment et retours communautaires datés, chacun étiqueté pour ce qu'il prouve. Les faits de lancement sont sur la page du modèle MiMo-V2.6-Pro (English) ; l'argent, dans l'analyse des prix. Ici, une question plus étroite : vaut-il la peine d'être utilisé, pour qui, et au prix de quelle attente ?
À la fin, je regarde ce que ces constats impliquent pour les flux de travail au niveau du navigateur, où ces modèles tournent de plus en plus. Ce morceau compte si votre travail, c'est de la recherche multi-pages, de l'extraction et de l'automatisation plutôt qu'une simple fenêtre de chat.
Points clés
MiMo-V2.6-Pro obtient 46 à l'Indice d'Intelligence d'Artificial Analysis — n° 1 sur 114 dans sa classe et meilleur score en poids ouverts — au coût par tâche le plus bas du groupe comparé (0,13 USD). (Artificial Analysis, vérifié 2026-09-22)
Le revers : 18,17 secondes jusqu'au premier token de réponse chez le fournisseur Xiaomi (charge de 10k tokens d'entrée), dont l'essentiel en réflexion silencieuse. La génération elle-même atteint environ 125 tokens/s. (benchmarks fournisseur AA)
Les tokens de réflexion sont facturés en sortie à 0,87 USD par million. Sur le jeu de l'indice, les tokens de raisonnement ont dépassé les tokens de réponse : environ 37 500 contre 26 800.
Les retours du jour du lancement se cassent net en deux : un script Python réparé là où GPT-6 Astra Light a échoué, et une boucle grep de trente minutes là où DeepSeek V4.1 Flash a réussi. Une exécution dans chaque sens.
L'écriture est la surprise : les utilisateurs de jeu de rôle et de prose longue louent le flux des scènes et les dialogues. La boucle d'outils est le risque. Verdict par charge de travail dans le tableau de décision.
Ce qu'est vraiment MiMo-V2.6-Pro
Xiaomi a publié MiMo-V2.6-Pro et MiMo-V2.6-Flash (English) le 2026-09-22 comme des modèles « nativement omnimodaux » à poids ouverts, construits autour de l'apprentissage par renforcement à grande échelle. Le point de contrôle Pro est un MoE dispersé d'environ 1,02 billion de paramètres totaux et 42 milliards actifs par token, une fenêtre de contexte de 1M de tokens, des entrées texte, image, audio et vidéo, une sortie texte, et une licence MIT. Les poids sont sur Hugging Face (XiaomiMiMo/MiMo-V2.6-Pro-RL) ; l'identifiant d'API est mimo-v2.6-pro, avec mimo-v2.6-pro-ultraspeed comme palier de vitesse facturé séparément. Les points de terminaison V2.5 disparaissent le 2026-10-21 (contexte de migration).
Une mise en garde avant tout chiffre : les résumés de paramètres divergent. Le rapport technique annonce 1,02 billion de totaux / 42 milliards actifs ; le résumé Hugging Face montre aussi une ligne 524 milliards ; les données structurées d'Artificial Analysis listent 978 milliards passifs. Prenez 1,02T/42B comme la ligne d'architecture du rapport technique officiel, et vérifiez le point de contrôle exact avant de dimensionner le matériel.
La question de ce review n'est pas « est-il intelligent » — le classement a déjà répondu. C'est : un modèle avec ce profil de vitesse, cette structure de facturation et ces caractéristiques de boucle d'outils a-t-il sa place dans votre flux de travail, face à des rivaux comme GPT-6 Astra, Claude Fable 5.1 ou le plus abordable Gemini 3.8 Flash ?
Le chiffre qui décide de ce review : 18 secondes de silence
Voici la paire qui organise tout le reste. MiMo-V2.6-Pro affiche le score d'intelligence ouvert le plus élevé mesuré par Artificial Analysis (46, n° 1 sur 114) au coût par tâche le plus bas du groupe (0,13 USD). Il met aussi 18,17 secondes à produire son premier token de réponse chez l'unique fournisseur listé (Xiaomi, charge de 10 000 tokens d'entrée, vérifié 2026-09-22).
Ces deux chiffres décrivent deux modèles différents selon qui attend. Pour un agent de fond qui enchaîne trente tours d'outils, 18 secondes de réflexion initiale se diluent dans des minutes de travail non supervisé, et les 125 tokens/s qui suivent ne sont devancés que par un ou deux modèles dans la même photographie. Pour un humain qui pose une question et regarde le curseur, 18 secondes sont une éternité, et les 22,2 secondes de bout en bout pour une réponse de 500 tokens sont pires qu'ils n'en ont l'air.
Une photographie antérieure du même jour décompose l'attente : 15,41 secondes de réflexion plus 2,17 secondes de traitement d'entrée — 87,7 % de l'attente est le modèle qui raisonne avant de parler. Les mêmes données expliquent la facture : environ 37 520 tokens de raisonnement contre 26 756 tokens de réponse par tâche d'indice. Vous payez environ 1,4 token de réflexion cachée pour chaque token de réponse visible.
Les utilisateurs de Reddit ont heurté le même mur en quelques heures :
"6k and 10k tokens?! Thinking takes more than half of the prose? It hurts my wallet..." — u/GlitteringSplit6035 (r/SillyTavernAI, 2026-09-22)
"what are these output tokens lmao are your keys made of gold?" — u/OverdueMaid (même discussion)
Servez-vous de l'ancre pour trier votre charge de travail : si l'unité de travail est une longue exécution, achetez le cerveau et avalez l'attente ; si l'unité est un tour humain, l'attente est le produit.
Ce qui s'est passé sur du travail réel, avant le classement
Les preuves les plus utiles du jour du lancement ne sont pas des lignes de benchmark. Ce sont deux petites histoires avec des outils et des résultats précis.
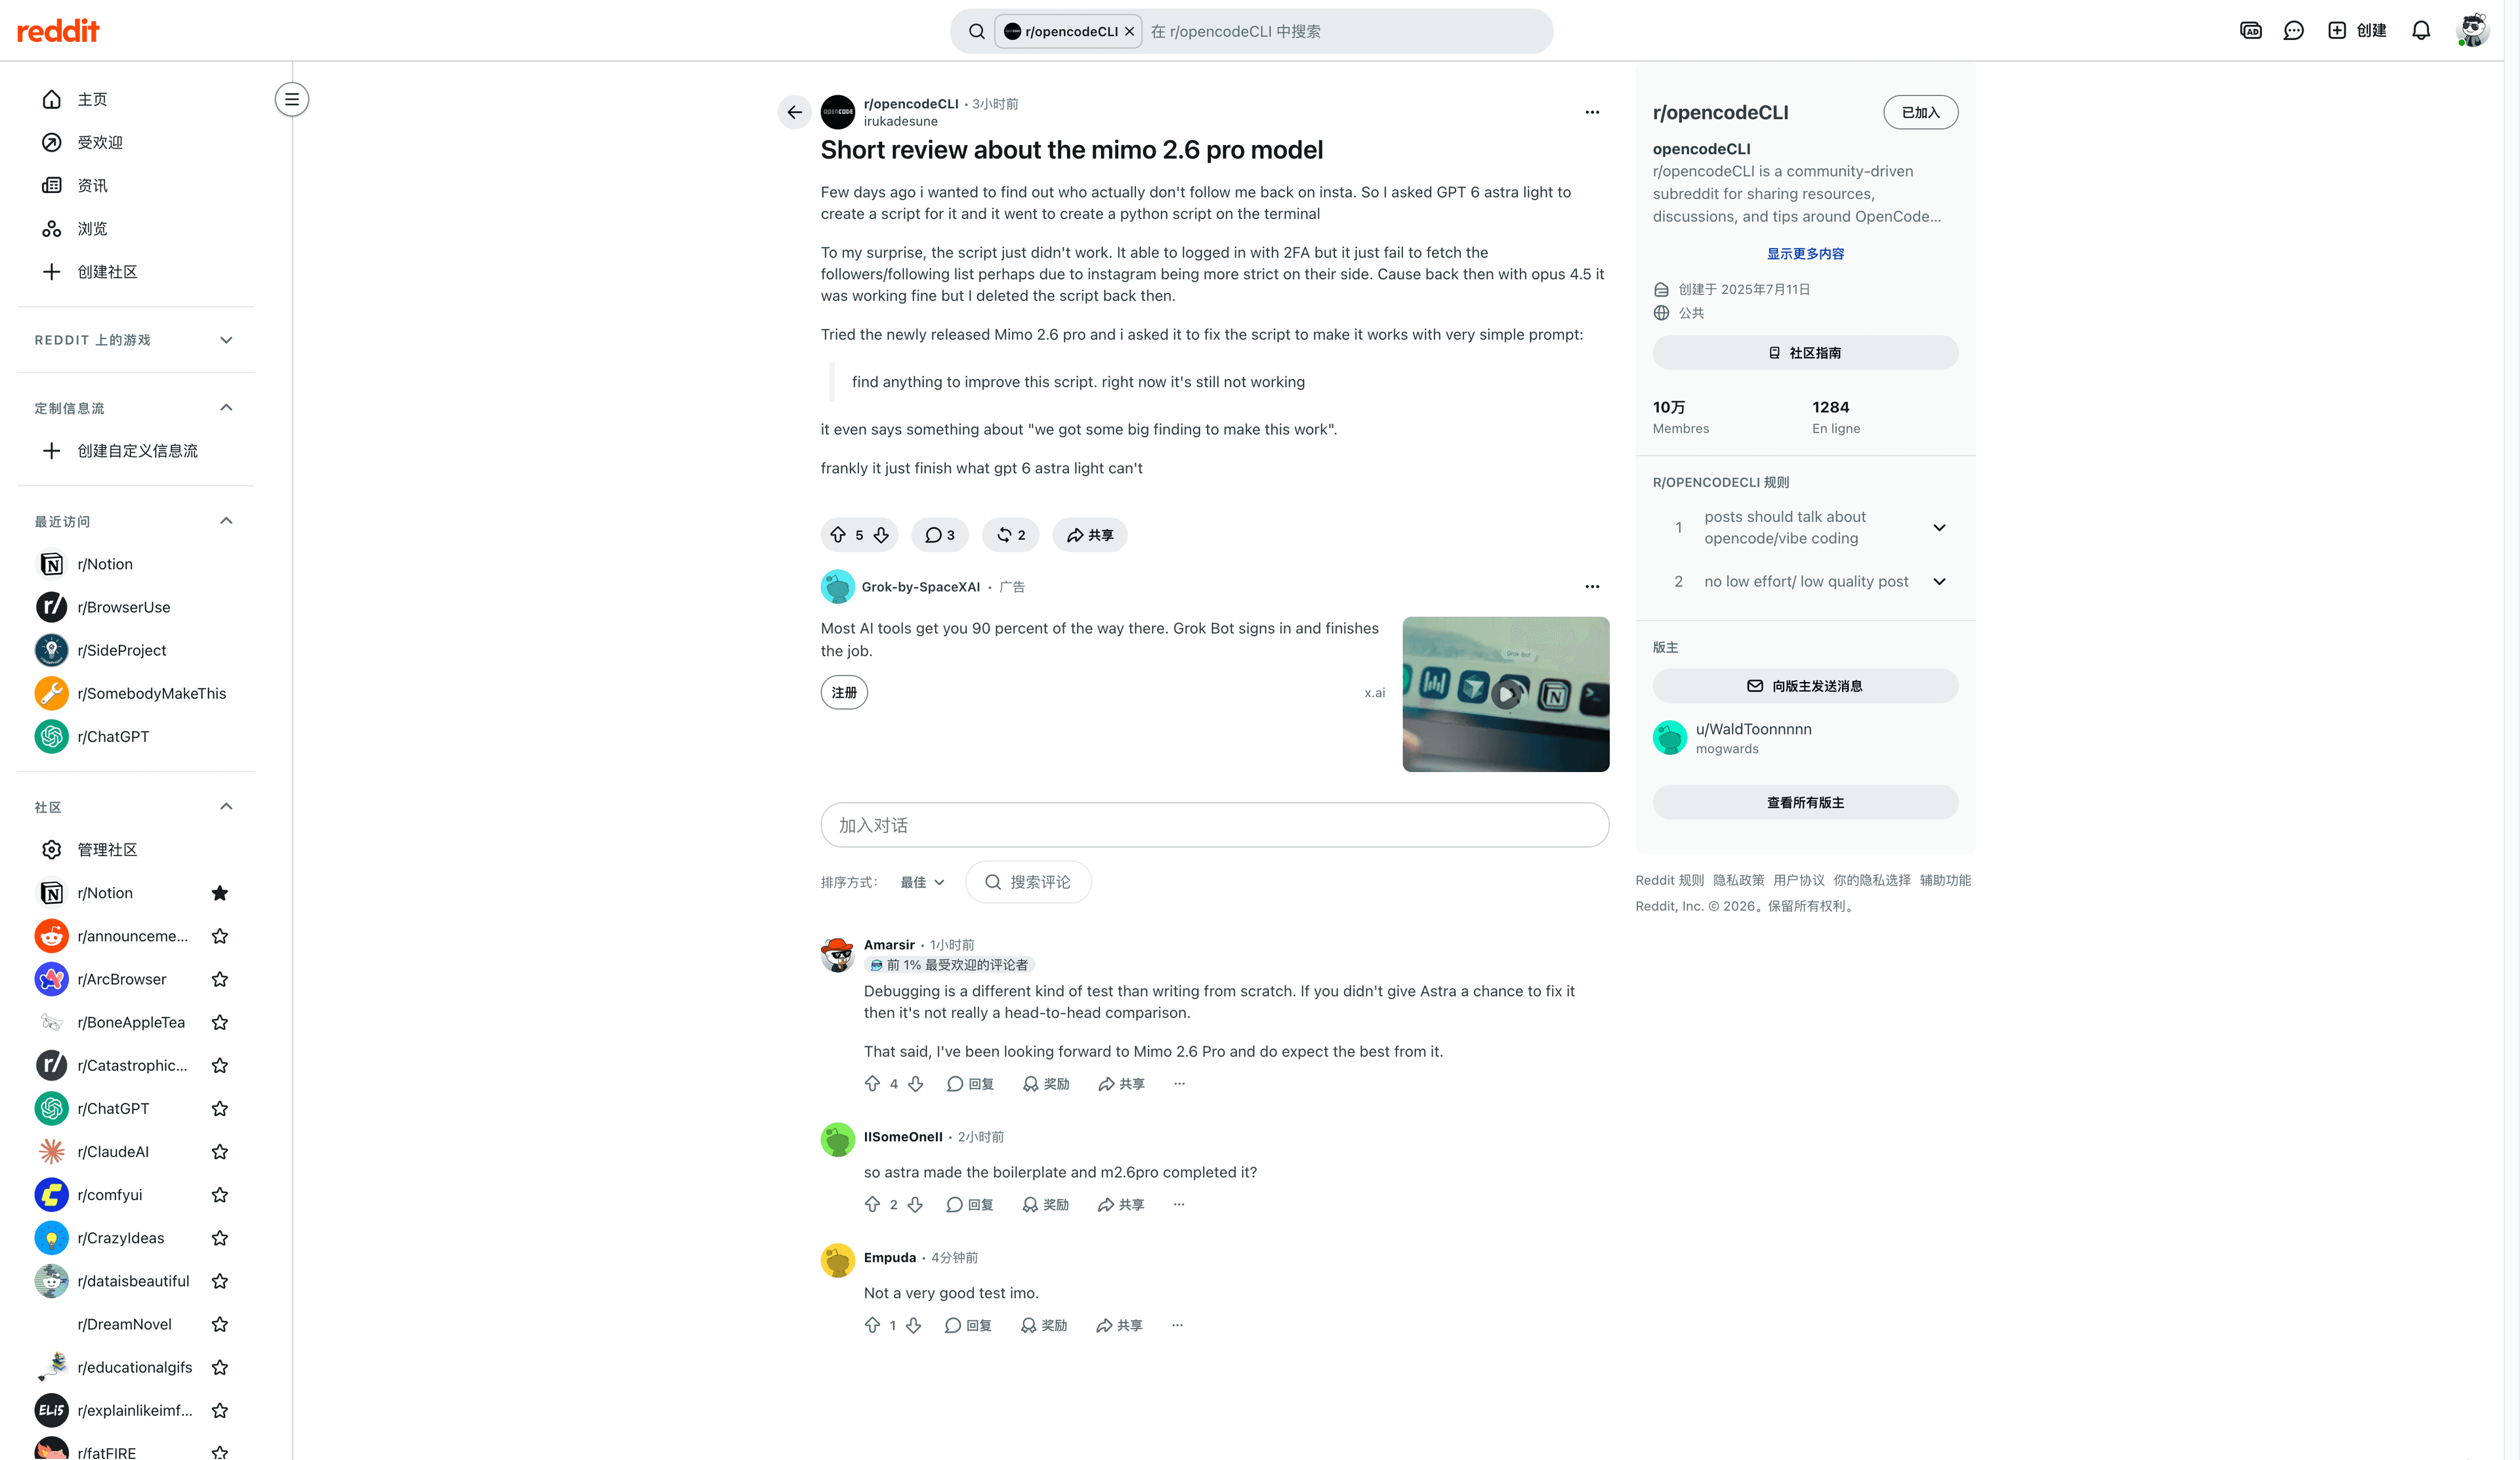
La victoire. u/irukadesune avait un script Python qui vérifie qui ne le suit pas en retour sur Instagram. GPT-6 Astra Light l'a réécrit et le script échouait toujours à récupérer la liste des abonnés. L'instruction donnée à MiMo-V2.6-Pro tenait en une ligne : « find anything to improve this script. right now it's still not working. » Il l'a réparé.
"frankly it just finish what gpt 6 astra light can't" — u/irukadesune (r/opencodeCLI, 2026-09-22)
La critique. La réponse la plus votée rappelle ce que cette histoire prouve et ne prouve pas :
"Debugging is a different kind of test than writing from scratch. If you didn't give Astra a chance to fix it then it's not really a head-to-head comparison." — u/Amarsir (même discussion)
La défaite. u/choiyoh a confié le même changement d'UI/UX de site à MiMo-V2.6-Flash et MiMo-V2.6-Pro dans un harnais de code en terminal. Les deux ont démarré une boucle grep sans avancer.
"for 30 minutes no code was fixed." … "DS 4.1 Flash is still much better.." — u/choiyoh (r/CommandCode, 2026-09-22)
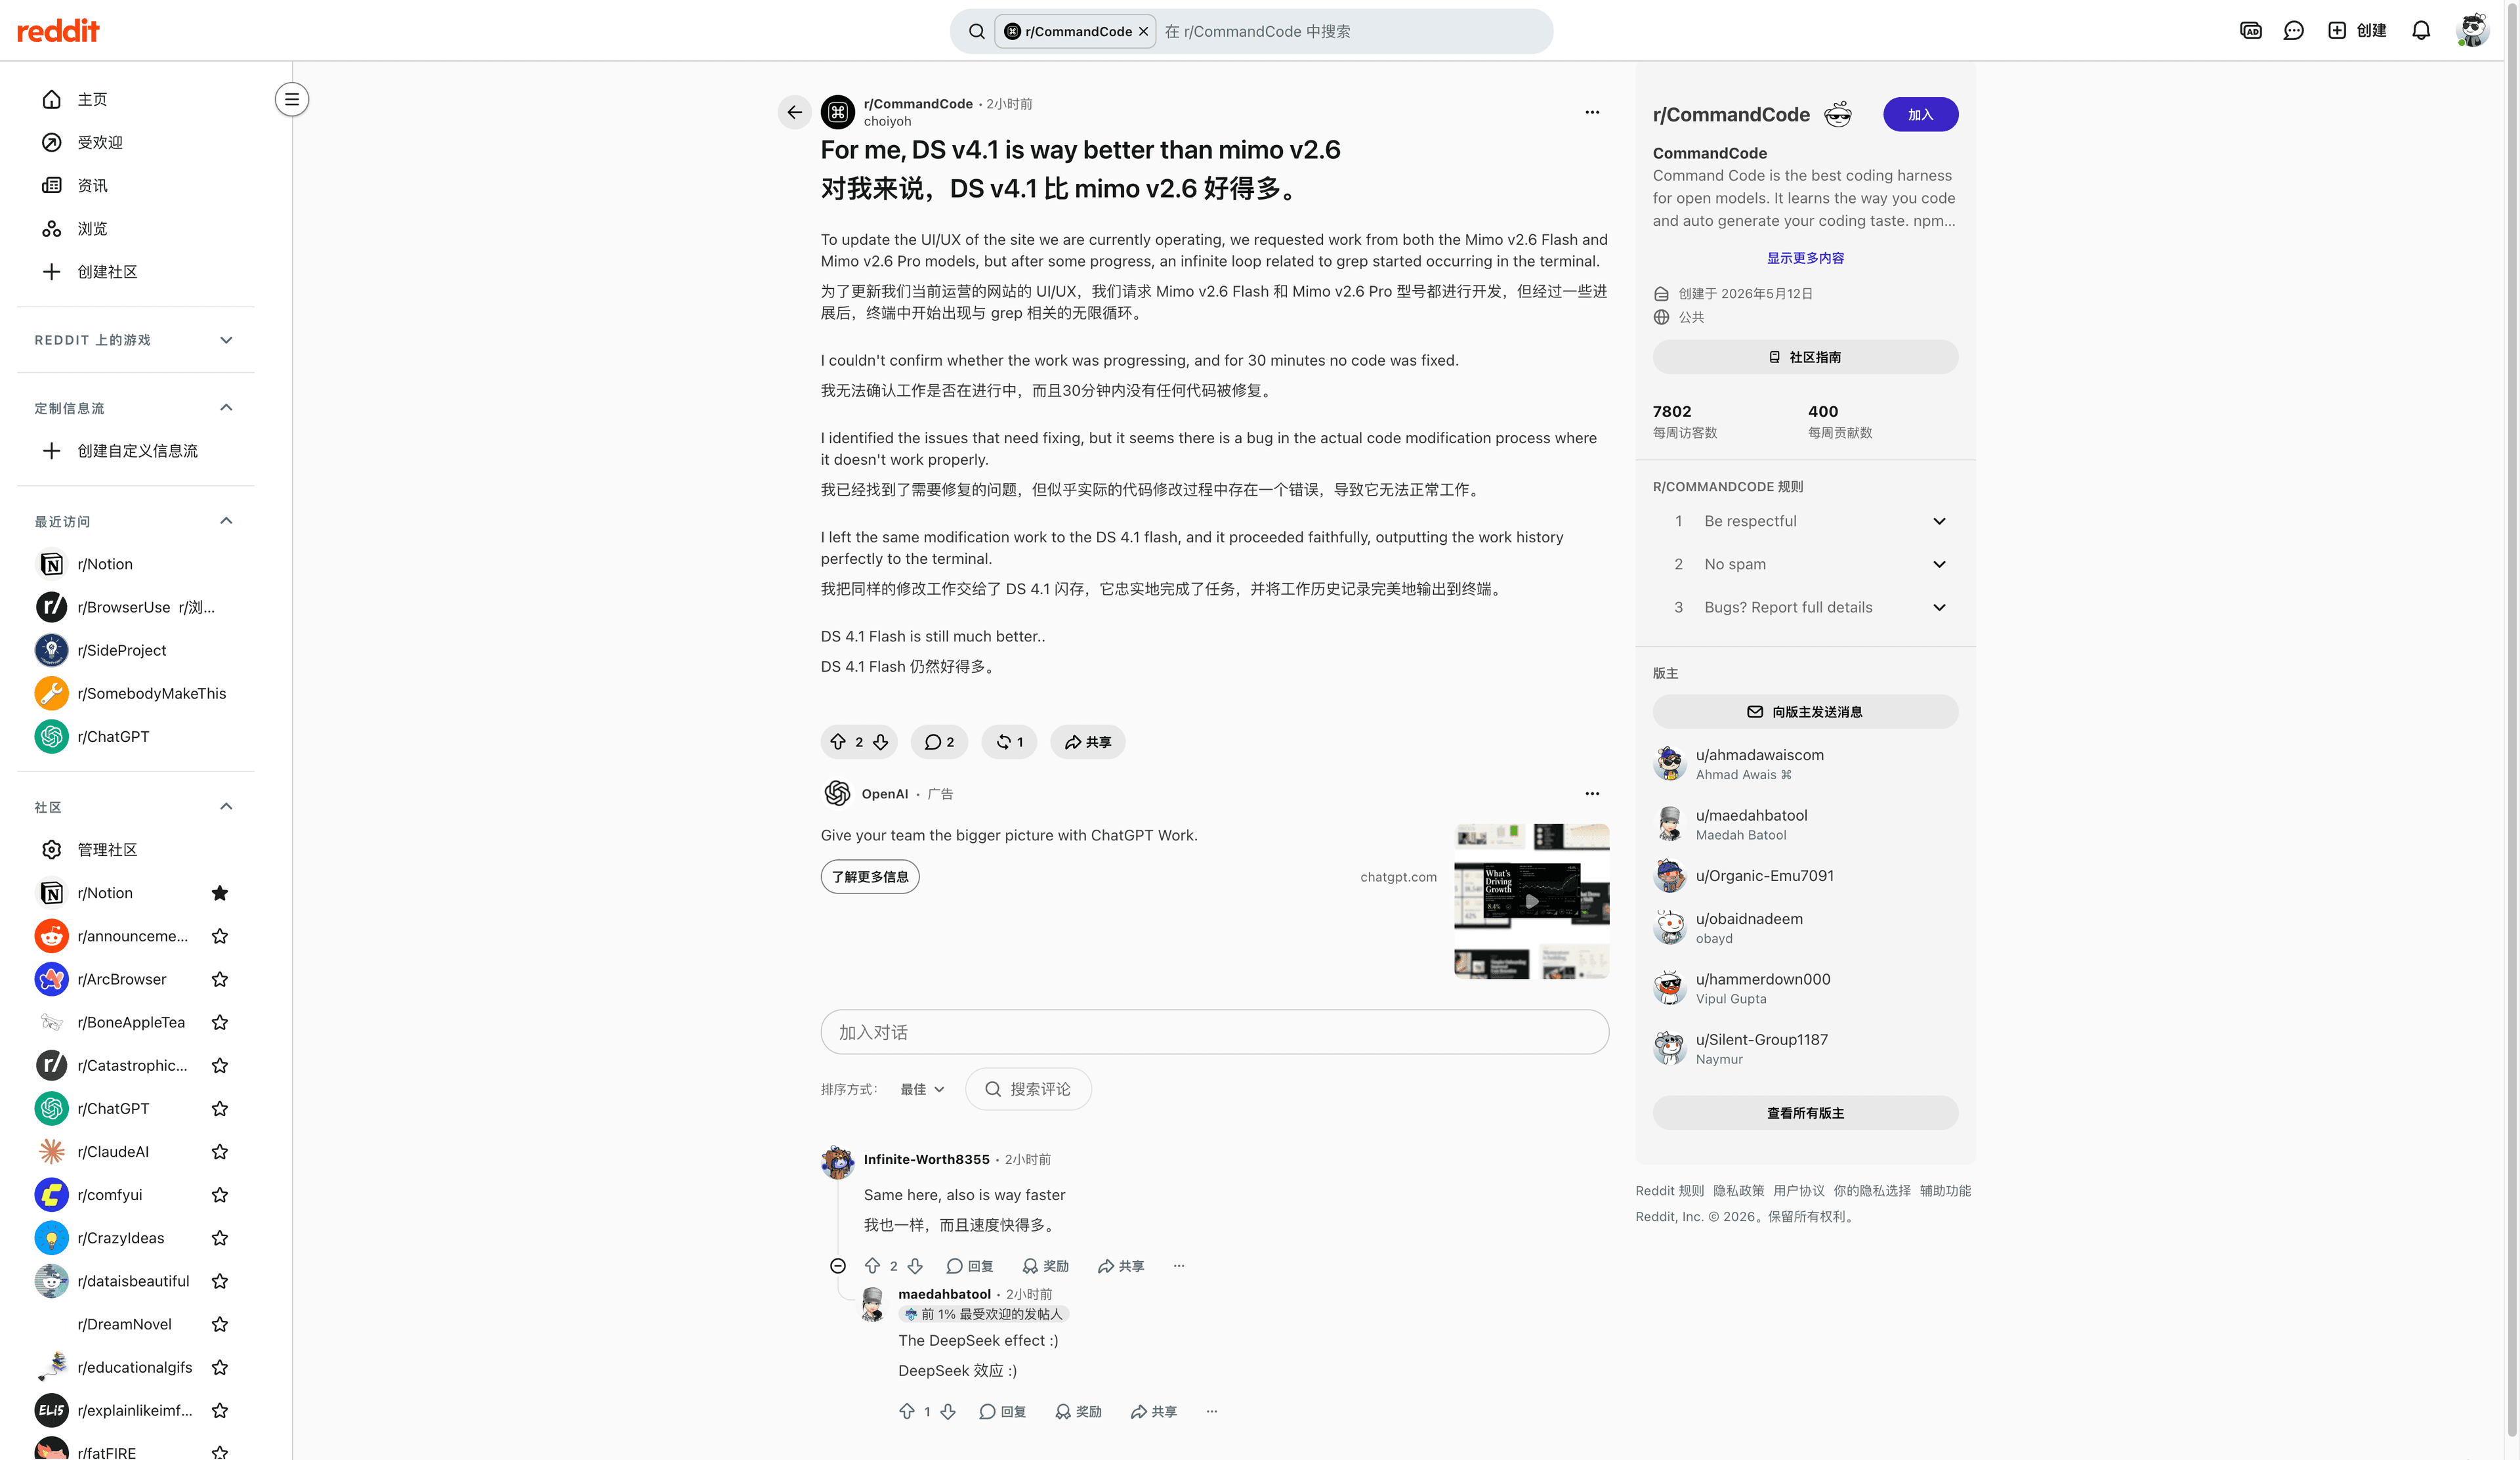
Une exécution chacun, sans journaux, sans dépôts, sans comptages de tokens. Ils établissent que les deux résultats existent dans la nature — une réparation qui bat un rival et une boucle d'outils de trente minutes — et rien sur leur fréquence. C'est exactement le vide que les benchmarks sont censés combler. Voyons combien ils le comblent vraiment.
Les benchmarks, et la confiance qu'ils méritent
Le rapport technique de Xiaomi (Tableau 3, rapporté par le constructeur, vérifié 2026-09-22) compare Pro à sa propre famille et à trois fleurons fermés. Valeurs telles que rapportées ; - signifie non fourni :
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.5-Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| MiMo Visual Coding (interne) | 72.3 | 71.5 | - | 70.0 | 73.4 | 69.1 |
Maintenant l'eau froide, en trois parties.
Les conditions de mesure sont minces. Le rapport publie des scores agrégés mais aucun journal par question, prompt, graine, taille d'échantillon ni intervalle de confiance. Trois lignes (MiMo Code Bench, MiMo Cyber Bench, MiMo Visual Coding) sont les benchmarks internes de Xiaomi. Le très répété « 58.4 → 72.6 sur DeepSWE » est une évolution de courbe dans une même exécution d'apprentissage par renforcement — environ 30 pas et 2,62 millions de dollars de calcul — pas une comparaison modèle contre modèle. Le « comparable à Claude Opus 5 et GPT-5.6 Sol sur la plupart des benchmarks d'agents » de la page officielle est du positionnement, et son « de 1/20 à 1/60 du prix » omet le groupe comparé et le comptage des tokens.
La communauté se méfie par défaut des classements produits pendant l'entraînement :
"We'll see how it works on real code. DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world … The benchmarks don't care if it's a code spaghetti." — u/lilian_moraru (r/LocalLLaMA, 2026-09-22)
"i mostly care about roleplay so those benchmark wins dont mean much if it still forgets details after a few messages." — u/Pure-Summer2818 (même discussion)
Les sources indépendantes s'accordent sur la forme, pas sur la précision. Artificial Analysis a tourné sur son propre matériel et donne 46 à MiMo-V2.6-Pro (v4.3.2, 10 évaluations), tandis que la ligne Arena Code Arena WebDev affiche un AutoEval de 1628 (+18/-18) avec Rank et Votes à N/A : c'est un résultat scripté sur un classement de votes à l'aveugle, et il ne peut pas s'écrire « classé N-ième ». La remarque méthodologique d'Amarsir vaut pour chaque ligne : déboguer n'est pas créer, un harnais n'est pas votre harnais, et un signal directionnel n'est pas une règle.
Ce qui survit au gâchis : l'écart avec V2.5-Pro (DeepSWE 19.0 → 71.9) est trop grand pour être un tour d'arrondi, et l'expérience de transfert de harnais du rapport (quatre harnais d'entraînement, puis Codex, Claude Code et mini-swe-agent jamais vus, environ 50 % → 66 % de réussite) est le type de preuve qui compte pour le déploiement réel. Ne lisez juste aucune ligne comme votre taux de réussite.
Là où MiMo-V2.6-Pro est vraiment bon
L'écriture est la surprise
On loue rarement la prose d'un modèle de code en premier. Le jour du lancement, les éloges les plus forts venaient des écrivains de jeu de rôle au long cours, un public qui punit durement les schémas répétitifs.
"honestly I'm really enjoying it for RP so far. The responses have been surprisingly good, especially when it comes to keeping the flow of a scene going and actually giving me something interesting to work with instead of falling into the usual repetitive RP patterns." — u/Electrical_Mode_2489 (r/SillyTavernAI, 47 votes)
Un autre écrivain le comparant face à face à GLM 5.3 a apprécié le dialogue et la retenue : le modèle « set[] up to ask about 'twink' LATER instead of shoehorning it in right then and there ». Si vous vivez de l'écriture — fiction, copy marketing, longues histoires interactives — cette amélioration peut compter plus que n'importe quel score de code.
La limite : le goût est personnel. Dans cette même discussion, u/Probablynotsocool a préféré GLM 5.3 (« Felt more immersive and crafty ») et trouvé la narration de MiMo « like a book … in a roleplay it can get tiring ». Deux utilisateurs expérimentés, des verdicts opposés, les mêmes sorties.
L'automatisation et les flux d'outils battent les fleurons sur le papier
Ici, la forme des benchmarks favorise vraiment MiMo. AutomationBench v1.0.6 : 53,1, devant Claude Opus 5 (50,3) et GPT-5.6 Sol (45,8). Toolathlon-Verified : 76,9, à trois points d'Opus 5 et devant Sol. Terminal Bench 2.1 : 89,9, meilleur score du groupe. JobBench 62,0 fait près d'un fois et demi les 45,4 de GPT-5.6 Sol.
Le détail d'ingénierie derrière ces lignes compte pour le déploiement : l'étape d'apprentissage par renforcement a entraîné sur quatre harnais minimaux, puis vérifié le transfert sur trois harnais inédits (Codex, Claude Code, mini-swe-agent). Un modèle qui ne marche que dans son propre harnais est une démo ; un modèle qui transfère est de l'infrastructure. Pour qui construit des boucles d'outils multi-étapes — agents de navigateur, correcteurs de CI, automatisations internes — c'est la raison la plus forte pour l'essayer.
Une intelligence de frontière au prix de la marchandise, poids MIT compris
La photographie d'Artificial Analysis du 2026-09-22 place MiMo-V2.6-Pro à 46 à l'Indice d'Intelligence — à égalité avec Grok 4.7 (46), sous Claude Opus 5 (51) — tout en étant le modèle le moins cher par tâche d'indice du groupe (0,13 USD). Le tarif est de 0,435 USD d'entrée / 0,87 USD de sortie par million de tokens, et les succès de cache descendent à 0,0036 USD : un rabais de 120× qui transforme discrètement l'économie des tours multiples (calcul des prix ici ; pour comparer les budgets avec un autre ouvert récent, voir le décryptage des prix de Kimi K3).
Une comparaison communautaire des fleurons du même jour rend le marché concret : face à Grok 4.7, MiMo offre 1M de contexte contre 500k, environ 125 contre 42 tokens/s, des poids MIT contre du fermé, et 0,435/0,87 contre 2/6 USD — les deux modèles à 46 de l'indice. Si votre contrainte est la capacité par dollar — agents par lots, pipelines de recherche, charges de raisonnement agéntique — c'est la proposition de valeur du lancement.
Là où ça mord
La taxe sur la réflexion : le silence se paie deux fois
Une fois dans l'attente, une fois sur la facture. 18,17 secondes jusqu'au premier token de réponse ; environ 37 520 tokens de raisonnement contre 26 756 de réponse par tâche d'indice, tous facturés en sortie à 0,87 USD par million. Sur les prompts gourmands en raisonnement, les utilisateurs rapportent une réflexion qui dépasse la moitié de la génération totale — la matière première de ces réactions « 6k and 10k tokens ?! ».
La soupape officielle est mimo-v2.6-pro-ultraspeed : jusqu'à 20× de vitesse de génération pour exactement 10× le prix (4,35 USD en entrée / 8,70 USD en sortie). C'est une option réelle pour les produits interactifs budgétés, mais elle reprice le modèle dans la gamme frontière, ce qui efface l'argument de valeur principal. Aucun interrupteur « penser moins » n'est documenté aujourd'hui dans l'API officielle ; l'analyse des prix fait les comptes.
Les boucles d'outils partent en vrille
La boucle grep ci-dessus est la forme d'échec qui fait le plus mal en travail agéntique : ce n'est pas une mauvaise réponse, c'est l'absence de réponse, compteur en marche. Le rapport technique admet que sa propre infrastructure d'entraînement a connu des OOM, des évaluateurs injoignables et des échecs de rollout partiel, sans publier de taux d'échec unifié par benchmark. Un autre utilisateur corrobore le motif (« Same here, also is way faster », à propos du rival). Si vous l'adoptez pour des exécutions non supervisées, budgétez de la supervision, des timeouts d'outils et un modèle de secours — la même discipline que pour n'importe quelle pile de navigateur agéntique.
Conformité, points de terminaison et poids de déploiement
Trois embûches pratiques qui n'apparaissent pas dans les scores :
Traitement des données. Dès le jour du lancement, des utilisateurs ont signalé que l'unique point de terminaison actif est de première partie et, selon leur lecture, non conforme à la rétention zéro (ZDR) : « very interesting, but 2.6 Pro's only endpoint is non-ZDR compliant » (u/total_ty), suivi de « How trustworthy is a random tag on a website, honestly? How do we verify none of our data has been retained by the endpoint? » (u/starliteburnsbrite). Les poids ouverts signifient que l'hébergement tiers arrive — « the weights are already up on huggingface » — mais aujourd'hui la voie conforme, c'est l'auto-hébergement ou un fournisseur dont vous avez lu les conditions.
L'auto-hébergement est lourd. 1,02T de MoE dispersé ; les exemples vLLM officiels supposent
--tensor-parallel-size 8. Ce n'est pas un modèle d'ordinateur portable. Budgétez des nœuds multi-GPU et lisez la petite print des paramètres.Dérive des versions et des prix. Les points de terminaison V2.5 meurent le 2026-10-21 ; les chiffres d'Artificial Analysis ont bougé dans la même journée au fil des rafraîchissements de mesure (17,58 → 18,17 s). Figez les versions et revérifiez les tarifs avant de budgéter.
Ce que les gens ont vraiment dit
La conversation du jour du lancement se scinde sur deux axes, pas un.
Axe un : ravis contre brûlés. La victoire de débogage et la boucle grep sont à quatre heures d'écart sur Reddit, et les deux camps se remplissent aussitôt. Le prompt d'une ligne d'u/irukadesune a réparé ce qu'un fleuron rival n'avait pas pu ; u/choiyoh a perdu trente minutes dans une boucle de terminal et est parti sur DeepSeek V4.1 Flash. Les enthousiastes lisent les mêmes preuves et extrapolent — « I believe in mimo, mimo will replace GLM as THE rp model » (u/stopaskingforloginn) — pendant que les sceptiques demandent des journaux.
Axe deux : ravis du prix, agacés par la réflexion. Le premier choc de la discussion de lancement fut économique — « They kept the prices!? It's over. » (u/Pink_da_Web) — puis les comptages de tokens sont arrivés :
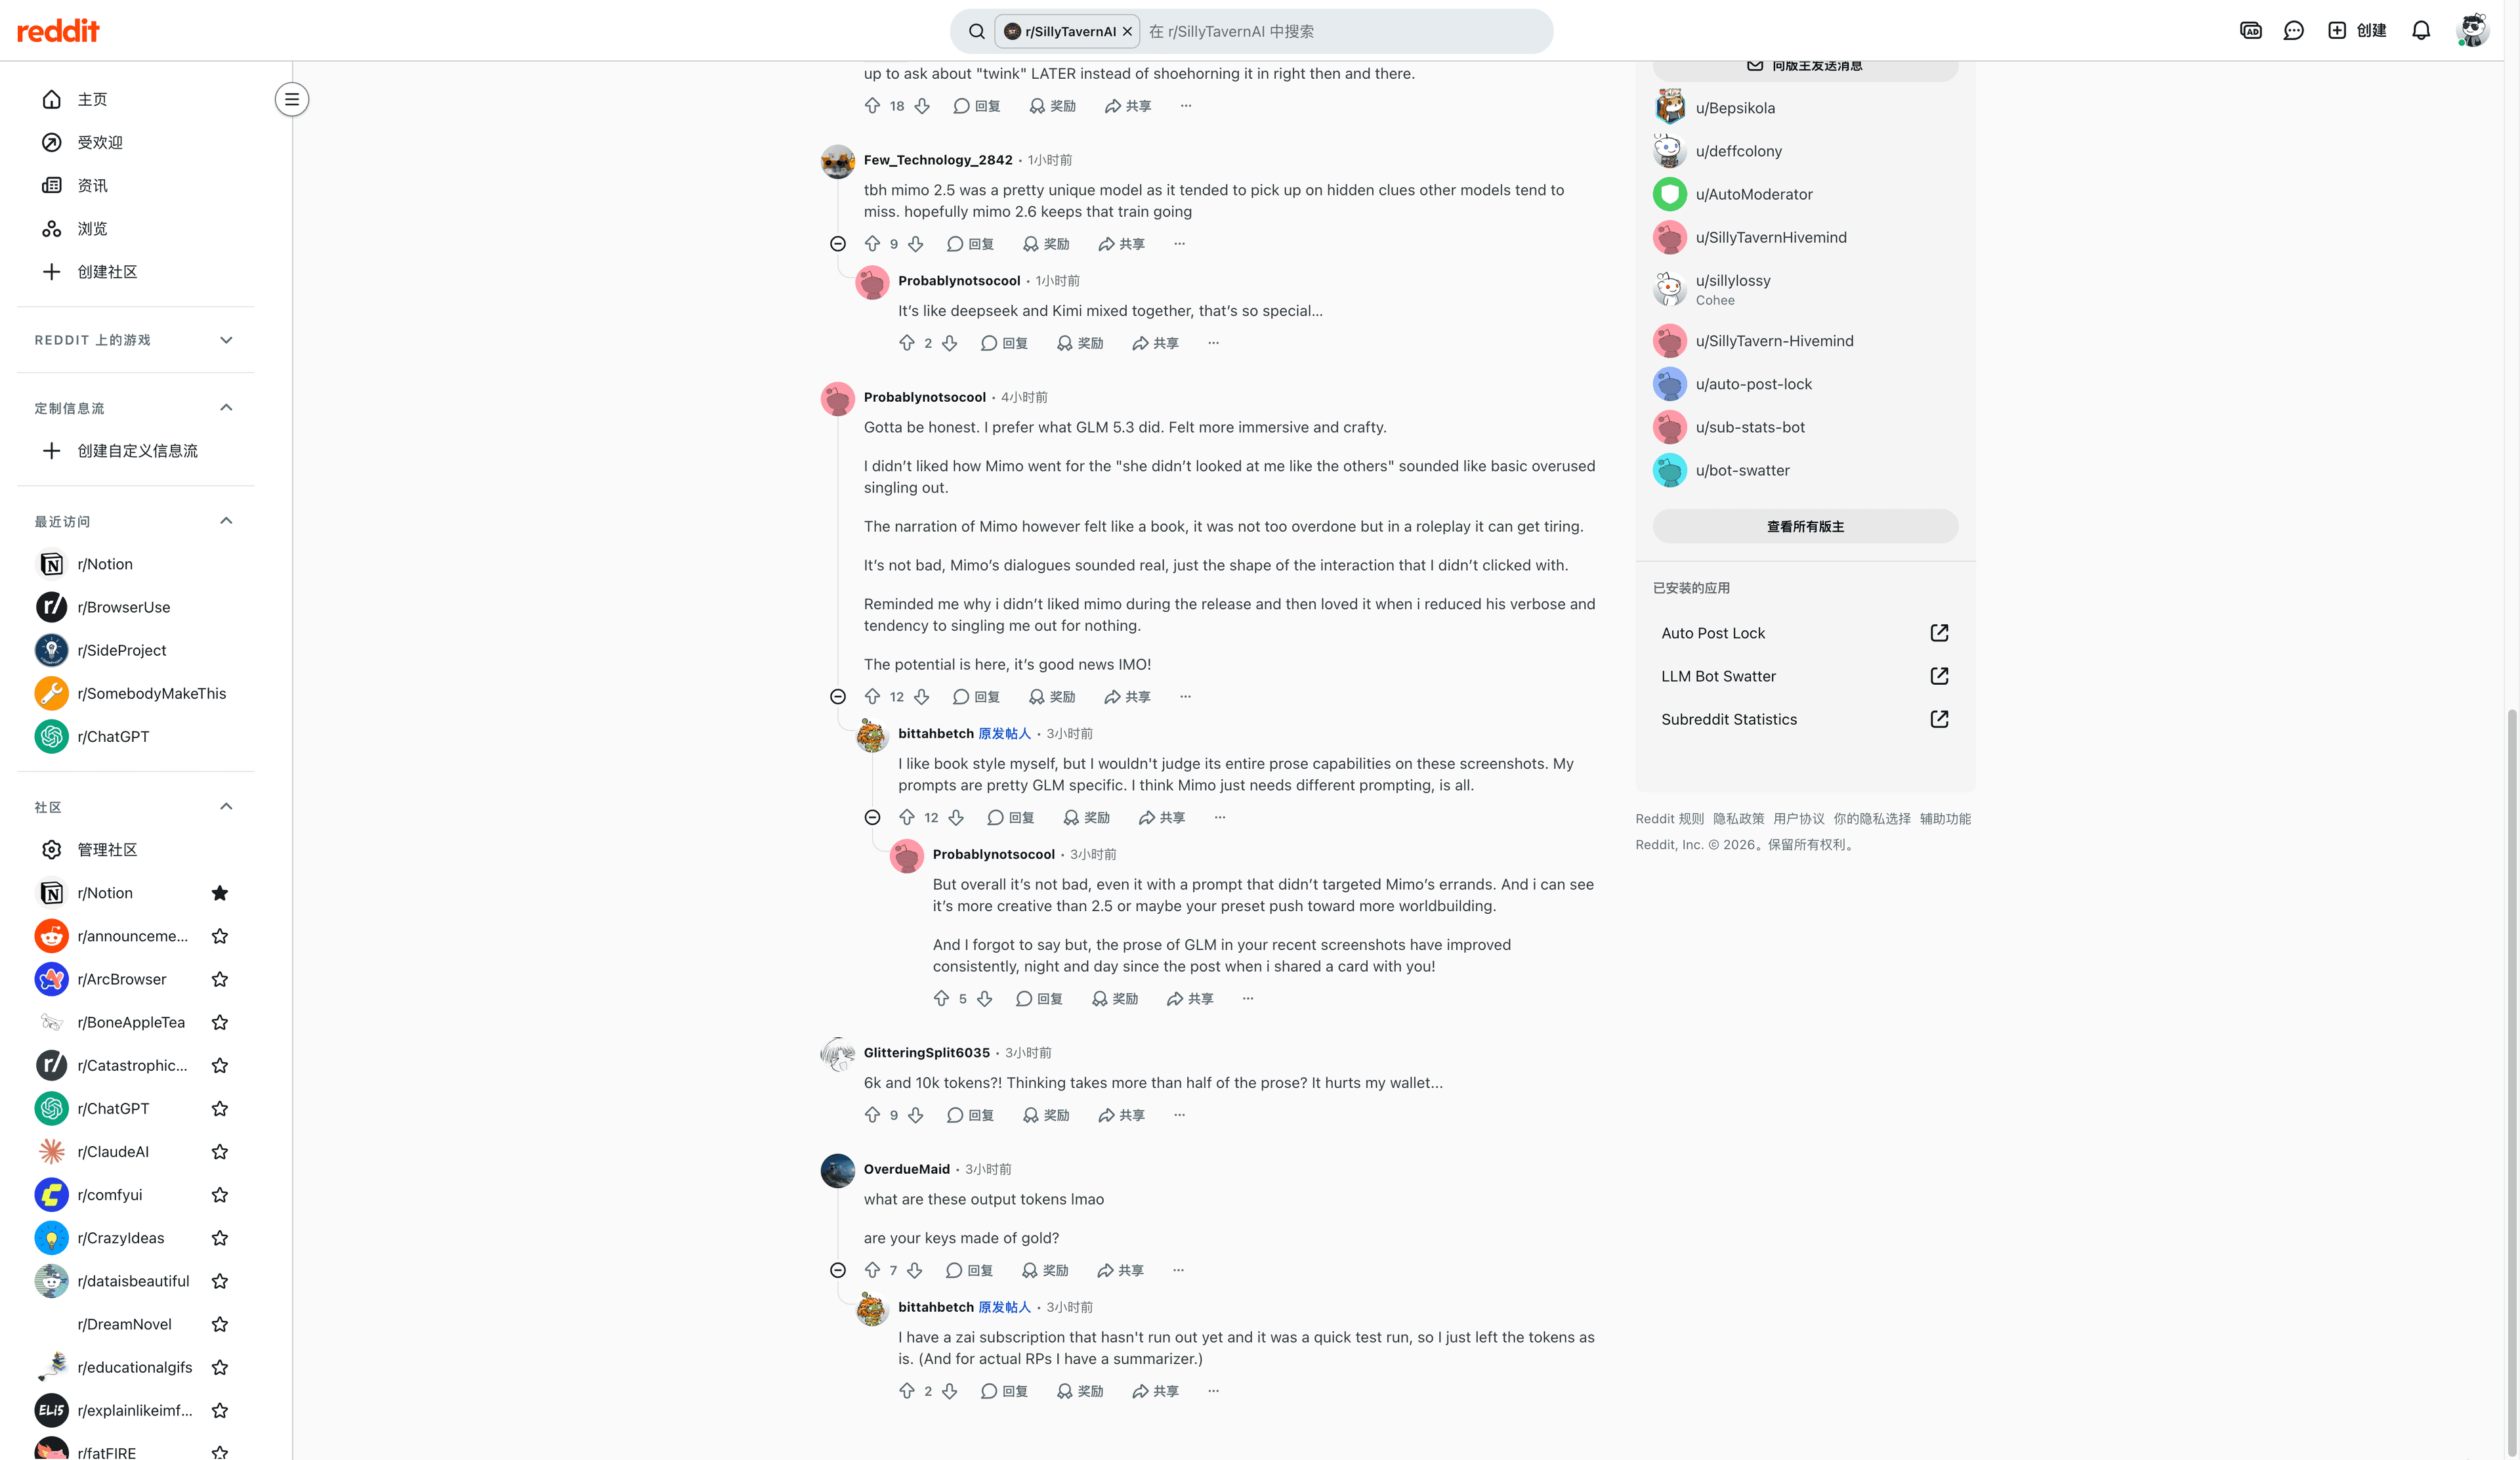
Même le public le plus satisfait du modèle, les écrivains, se déchire :
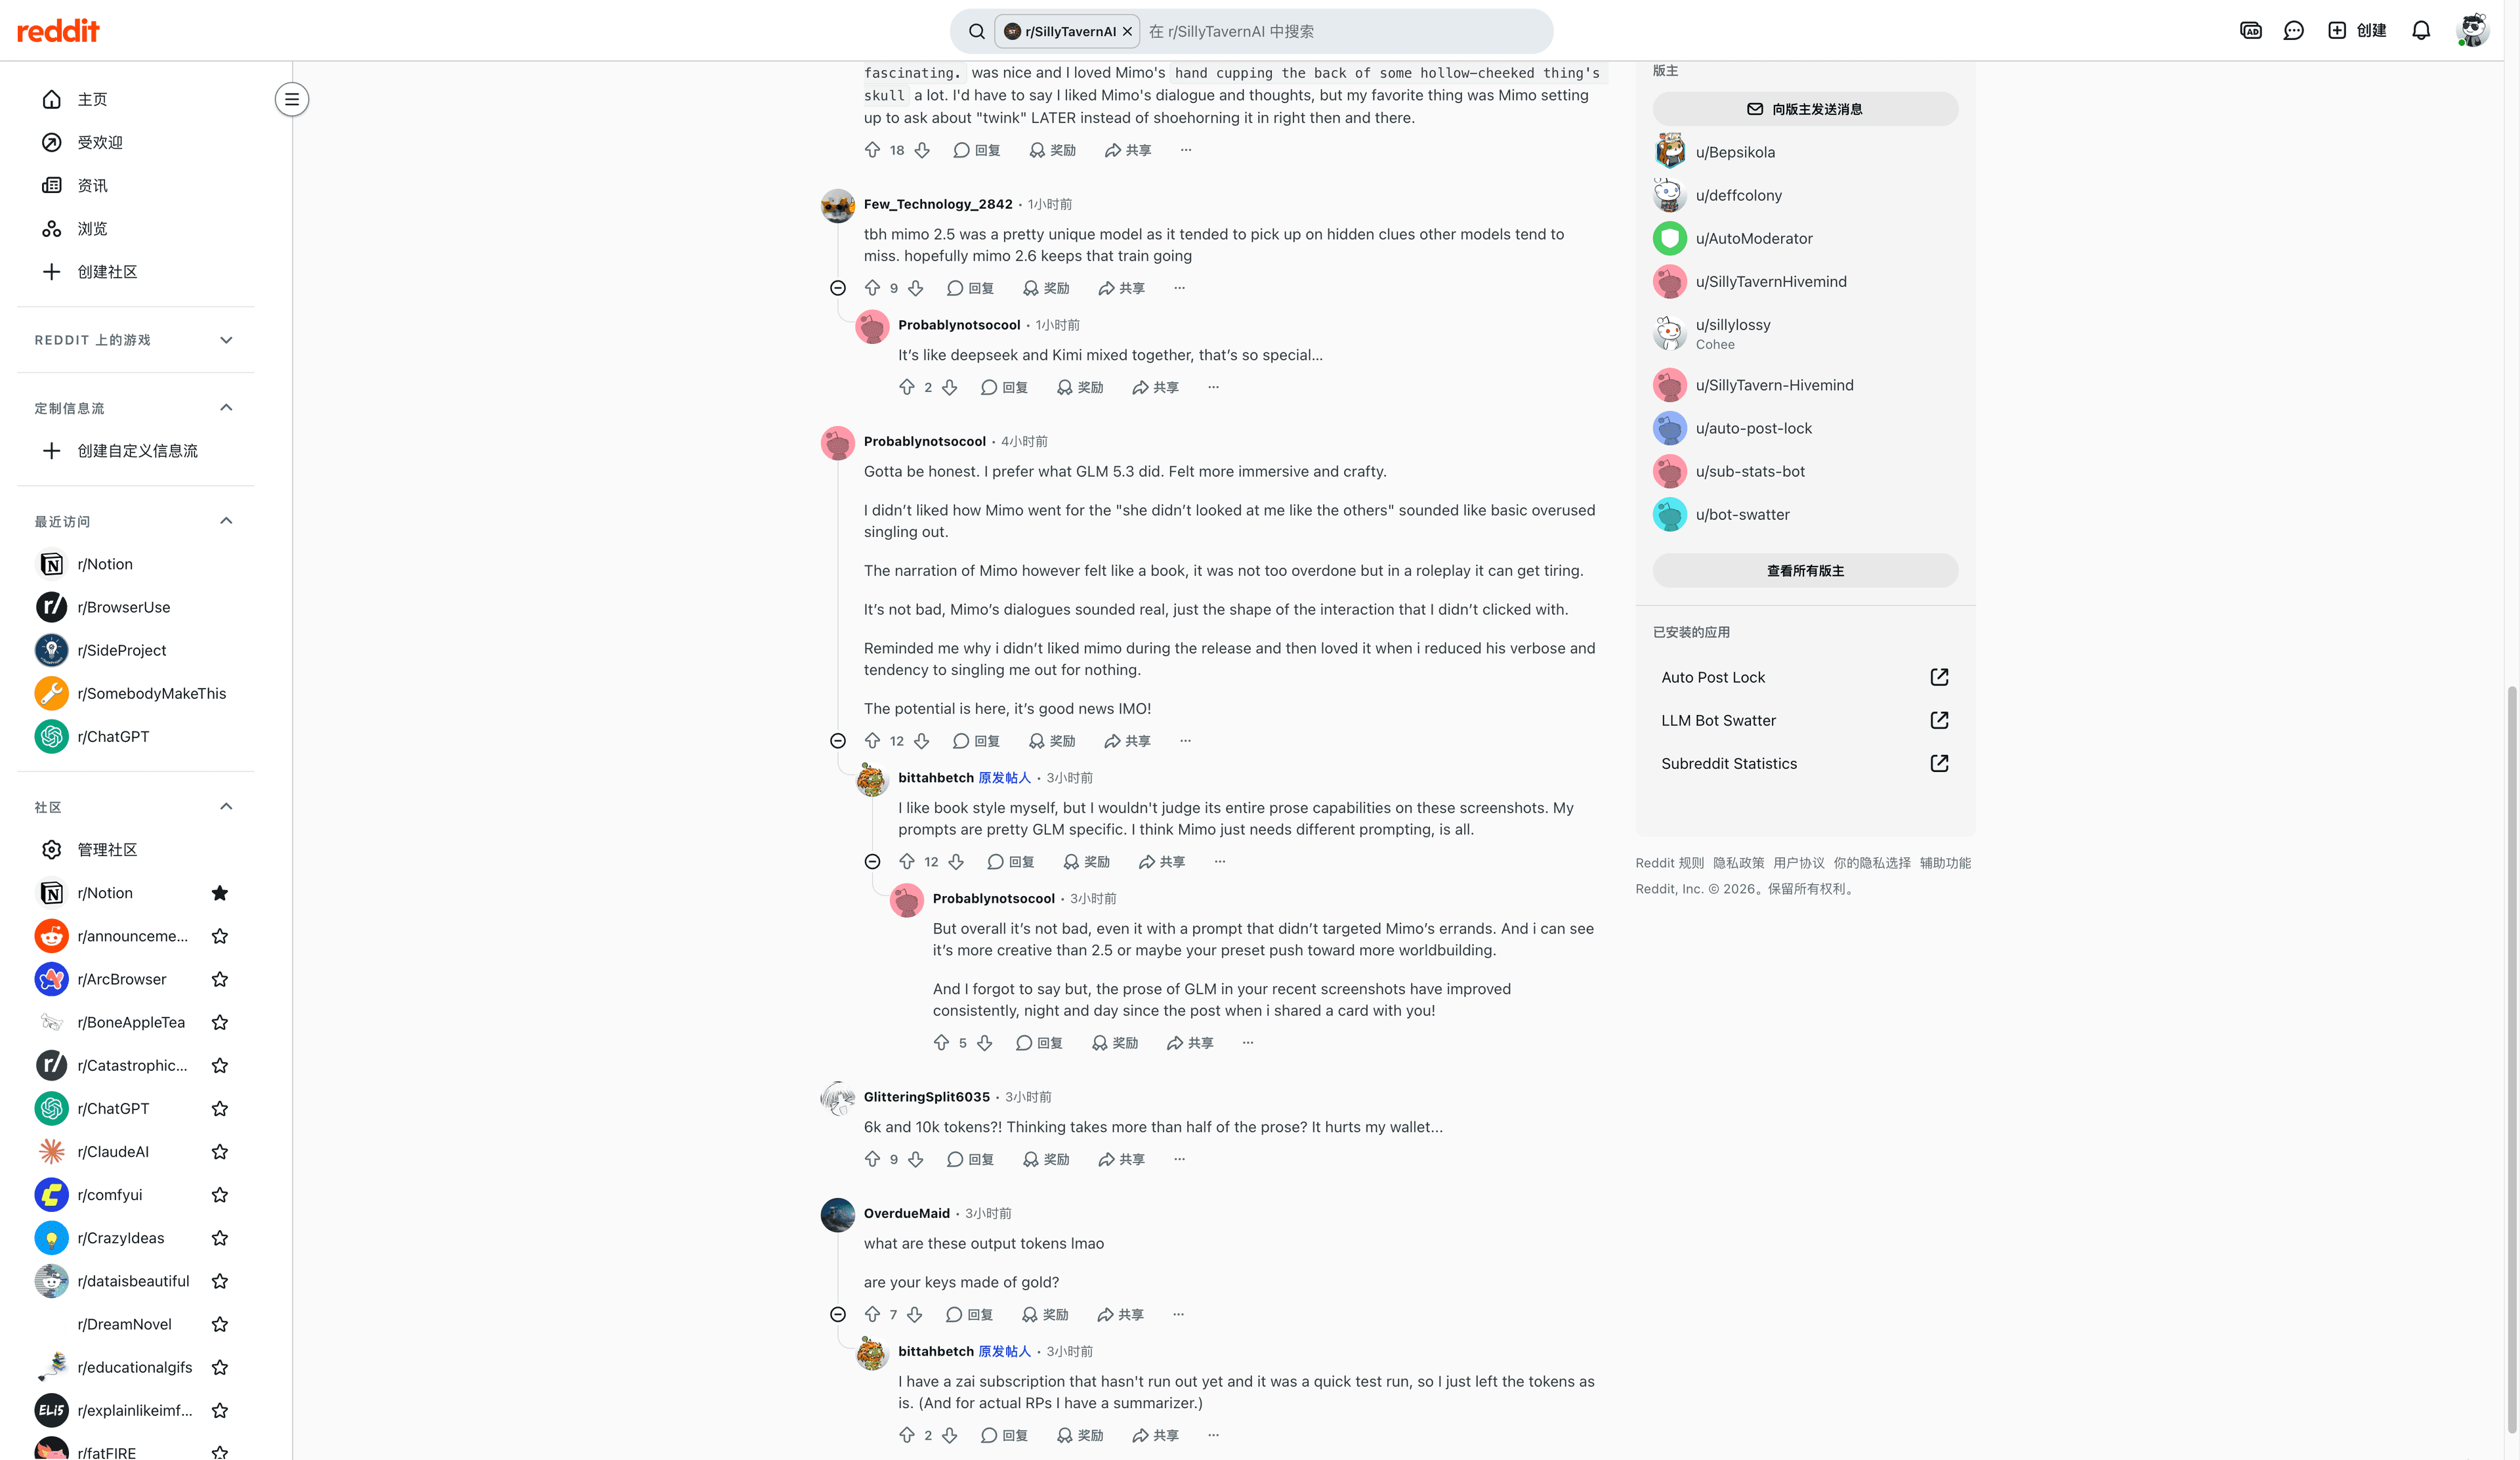
Où atterrit ce review : u/Amarsir a atterri au même endroit — enthousiasme pour le modèle, impatience face aux comparaisons bâclées. Le motif des neuf voix vérifiées coïncide avec les chiffres : une capacité sérieuse, une friction sérieuse dans l'attente et la facture, et une fiabilité de boucle d'outils non prouvée à n=1 dans les deux sens.
Le verdict : choisissez par charge de travail, pas par le score
| Forme de charge de travail | Verdict | Pourquoi | Réserve principale |
|---|---|---|---|
| Longues exécutions agéntiques de code, corrections par lots, boucles non supervisées | À essayer | AutomationBench 53,1 devance Opus 5 et Sol ; preuve de transfert de harnais ; contexte 1M ; 0,13 USD/tâche dilue l'attente | Les échecs en boucle type grep sont réels ; supervisez et gardez un modèle de secours |
| Chat interactif, jeu de rôle et prose longue | Oui, avec réserves | Les éloges sur la prose sont concrets et répétés ; le contexte 1M tient les longues scènes cohérentes | 18 s avant le premier token + tokens de réflexion alourdissent latence et coût par scène ; certains préfèrent GLM 5.3 |
| Automatisation d'ordinateur et de navigateur | Candidat solide | OSWorld-Verified 82,0, JobBench 62,0, code visuel 72,3 (interne) ; entrée omnimodale | Les preuves sont surtout du constructeur ; vérifiez d'abord sur votre propre jeu de tâches |
| Données réglementées / exigence de rétention zéro | Pas encore | Les poids MIT permettent en principe l'auto-hébergement ou des fournisseurs conformes | Le seul point de terminaison actif est de première partie et son statut ZDR est invérifié |
| Inférence locale sur une GPU ou un portable | Non | 1,02T de MoE dispersé ; le serving officiel suppose un parallélisme de tenseurs en 8 voies | La famille Flash ou des distillés plus petits sont l'option locale réaliste |
Deux notes datées. Premièrement, Grok 4.7 est sorti le même jour avec 46 sur l'indice d'Artificial Analysis, et une comparaison communautaire conclut que « neither one decisively dominates the other » : la comparaison à mener est celle de votre charge de travail, idéalement avec deux candidats côte à côte. Deuxièmement, les points de terminaison V2.5 ferment le 2026-10-21 : planifier la migration n'est pas optionnel si vous avez construit dessus.
Une voie pratique : faites-le tourner là où est le travail
Tout dans ce review pointe un même profil : l'attente pénalise les humains et pas les agents ; les tokens de réflexion punissent les tours isolés et récompensent les longues exécutions ; le risque de boucle exige de la supervision. Ce profil colle mal à une fenêtre de chat greffée sur un document, et bien à un flux de travail au niveau du navigateur qui lit des pages, tient 1M de tokens de contexte et travaille pendant que vous faites autre chose.
C'est le flux pour lequel Tabbit Browser est conçu : recherche multi-pages, extraction et automatisation comme tâche d'agentic browser, pas comme un prompt unique. La limite honnête : cette campagne de review n'a pas pu vérifier que MiMo-V2.6-Pro apparaît aujourd'hui dans le sélecteur de modèles en direct de Tabbit, et aucune manipulation en main n'est revendiquée ici. Vérifiez le sélecteur de votre compte avant de planifier autour, comme pour la disponibilité de n'importe quel modèle dans n'importe quel client.
Si le profil ci-dessus correspond à votre travail — longues exécutions, contexte lourd, appels d'outils, discipline de coût — la bonne question n'est pas « quel modèle a le meilleur score » mais « quel modèle finit mon travail ». Faites tourner un jeu de tâches fixe et personnel sur deux candidats et comptez le travail fini par dollar. Ce test bat n'importe quelle ligne de classement de cet article.
 Tabbit Browser

Questions fréquentes
Faut-il utiliser MiMo-V2.6-Pro ?
Oui pour les charges de travail longues de code agéntique, d'automatisation et d'écriture créative où la qualité du résultat compte plus que la réponse immédiate. Réfléchissez deux fois si vous avez besoin de premières réponses rapides, de points de terminaison à rétention zéro vérifiée ou d'un déploiement local sur une seule GPU, et comparez au moins un rival avant de vous décider.
Combien de temps MiMo-V2.6-Pro met-il à répondre ?
Artificial Analysis a mesuré 18,17 secondes jusqu'au premier token de réponse chez le fournisseur Xiaomi avec une charge de travail de 10 000 tokens d'entrée, vérifié le 22 septembre 2026. Après l'attente, la génération tourne à environ 125 tokens par seconde : l'essentiel du délai est donc du raisonnement silencieux.
Les tokens de réflexion coûtent-ils de l'argent ?
Oui. Xiaomi facture le raisonnement interne comme des tokens de sortie standard à 0,87 USD par million. Artificial Analysis a relevé environ 37 500 tokens de réflexion contre 26 800 tokens de réponse par tâche d'indice : une large part de la facture paie une réflexion que vous ne voyez jamais.
Comment MiMo-V2.6-Pro se compare-t-il à Grok 4.7 et Claude Opus 5 ?
Sur l'Indice d'Intelligence d'Artificial Analysis vérifié le 22 septembre 2026, MiMo-V2.6-Pro et Grok 4.7 obtiennent tous deux 46 et Claude Opus 5 obtient 51. Le rapport de Xiaomi place DeepSWE v1.1 à 71,9 contre environ 73 pour Grok 4.7 et 74 pour Opus 5, à 0,435 USD par million de tokens d'entrée contre 2 et 15 USD.
MiMo-V2.6-Pro est-il vraiment open source, et puis-je l'exécuter moi-même ?
Les poids sont sous licence MIT et téléchargeables sur Hugging Face, un accès plus ouvert que la plupart des modèles de frontière. L'auto-hébergement est lourd : le point de contrôle est un MoE dense en paramètres mais dispersé, d'environ 1,02 billion de paramètres dont 42 milliards actifs, et les exemples officiels vLLM et SGLang supposent des configurations multi-GPU. Les résumés de paramètres divergent selon les sources : vérifiez le point de contrôle exact avant de dimensionner le matériel.
Puis-je utiliser MiMo-V2.6-Pro dans Tabbit Browser ?
Tabbit exécute des flux de travail d'IA au niveau du navigateur avec les modèles de votre sélecteur en direct. Ce review n'a pas pu vérifier si MiMo-V2.6-Pro apparaît aujourd'hui dans ce sélecteur : vérifiez le vôtre et les conditions de votre compte avant de planifier autour.