
MiMo-V2.6-Pro merece um teste sério em execuções agênticas longas, automação e, surpreendentemente, prosa. É também o modelo que mais consome sua paciência: no dia do lançamento, a maior pontuação aberta veio acompanhada de uma das maiores esperas antes da primeira palavra. Em poucas horas, um desenvolvedor relatou ter consertado um script que um modelo rival não conseguiu, e outro relatou ficar preso num laço de terminal por trinta minutos. Os dois relatos são reais. Esta review os organiza.
Esta review só conta evidências que você pode abrir e conferir: afirmações oficiais, dados medidos de forma independente e relatos datados da comunidade, cada um rotulado pelo que prova. Os fatos de lançamento estão na página do modelo MiMo-V2.6-Pro (English); o lado do dinheiro, na análise de preços. Aqui respondemos uma pergunta mais estreita: se vale a pena, para quem e a que custo de espera.
No final, olho o que esses achados significam para fluxos de trabalho em nível de navegador, onde modelos como este cada vez mais rodam. Esse trecho importa se o seu trabalho é pesquisa multi-página, extração e automação, e não uma única caixa de chat.
Pontos principais
MiMo-V2.6-Pro pontua 46 no Índice de Inteligência da Artificial Analysis — nº 1 de 114 na classe e a maior pontuação de pesos abertos — ao custo mais baixo por tarefa do conjunto comparado (US$ 0,13). (Artificial Analysis, verificado 2026-09-22)
O outro lado é a espera: 18,17 segundos até o primeiro token de resposta no provedor Xiaomi (carga de 10k tokens de entrada), quase tudo raciocínio silencioso. A geração em si roda a cerca de 125 tokens/s. (benchmarks de provedor AA)
Tokens de pensamento são cobrados como saída a US$ 0,87 por milhão. No conjunto do índice, tokens de raciocínio superaram os de resposta: cerca de 37.500 contra 26.800.
Os relatos reais do dia do lançamento se dividem com força: um script Python consertado onde GPT-6 Astra Light falhou, e um laço de grep de trinta minutos onde DeepSeek V4.1 Flash teve sucesso. Uma execução em cada direção.
A escrita é a surpresa: usuários de roleplay e prosa longa elogiam o fluxo das cenas e os diálogos. O laço de ferramentas é o risco. Veredito por carga de trabalho na tabela de decisão.
O que MiMo-V2.6-Pro realmente é
A Xiaomi lançou MiMo-V2.6-Pro e MiMo-V2.6-Flash (English) em 2026-09-22 como modelos "nativamente omnimodais" de pesos abertos, construídos em torno de aprendizado por reforço em escala. O checkpoint Pro é um MoE esparso de cerca de 1,02 trilhão de parâmetros totais e 42 bilhões ativos por token, janela de contexto de 1M de tokens, entrada de texto, imagem, áudio e vídeo, saída de texto e licença MIT. Os pesos estão no Hugging Face (XiaomiMiMo/MiMo-V2.6-Pro-RL); o id da API é mimo-v2.6-pro, com mimo-v2.6-pro-ultraspeed como nível de velocidade cobrado à parte. Os endpoints V2.5 encerram em 2026-10-21 (contexto de migração).
Uma cautela antes de qualquer número: os resumos de parâmetros divergem. O relatório técnico diz 1,02T totais / 42B ativos; o resumo do Hugging Face mostra ainda uma linha de 524B; os dados estruturados da Artificial Analysis listam 978B passivos. Trate 1,02T/42B como a linha de arquitetura do relatório técnico oficial e verifique o checkpoint exato antes de dimensionar hardware.
A pergunta que esta review responde não é "é inteligente?" — o ranking já disse que sim. É se um modelo com este perfil de velocidade, esta estrutura de cobrança e estas características de laço de ferramentas pertence ao seu fluxo de trabalho, diante de rivais como GPT-6 Astra, Claude Fable 5.1 ou o mais barato Gemini 3.8 Flash.
O número que decide esta review: 18 segundos de silêncio
Aqui está o par que organiza tudo abaixo. MiMo-V2.6-Pro registra a maior pontuação de inteligência aberta medida pela Artificial Analysis (46, nº 1 de 114) ao custo mais baixo por tarefa do conjunto (US$ 0,13). Ele também leva 18,17 segundos para produzir seu primeiro token de resposta no único provedor listado (Xiaomi, carga de 10.000 tokens de entrada, verificado 2026-09-22).
Esses dois números descrevem dois modelos diferentes, dependendo de quem espera. Para um agente de fundo mastigando trinta turnos de ferramentas, 18 segundos de raciocínio inicial se diluem em minutos de trabalho não supervisionado, e os 125 tokens/s que seguem só ficam atrás de um ou dois modelos na mesma fotografia. Para um humano que faz uma pergunta e encara o cursor, 18 segundos são uma eternidade, e os 22,2 segundos de ponta a ponta para uma resposta de 500 tokens são piores do que parecem.
Uma fotografia anterior do mesmo dia da Artificial Analysis decompõe a espera: 15,41 segundos de pensamento mais 2,17 segundos de processamento de entrada — 87,7% da espera é o modelo raciocinando antes de falar. Os mesmos dados explicam a conta: cerca de 37.520 tokens de raciocínio contra 26.756 tokens de resposta por tarefa do índice. Você paga cerca de 1,4 token de pensamento oculto por cada token de resposta visível.
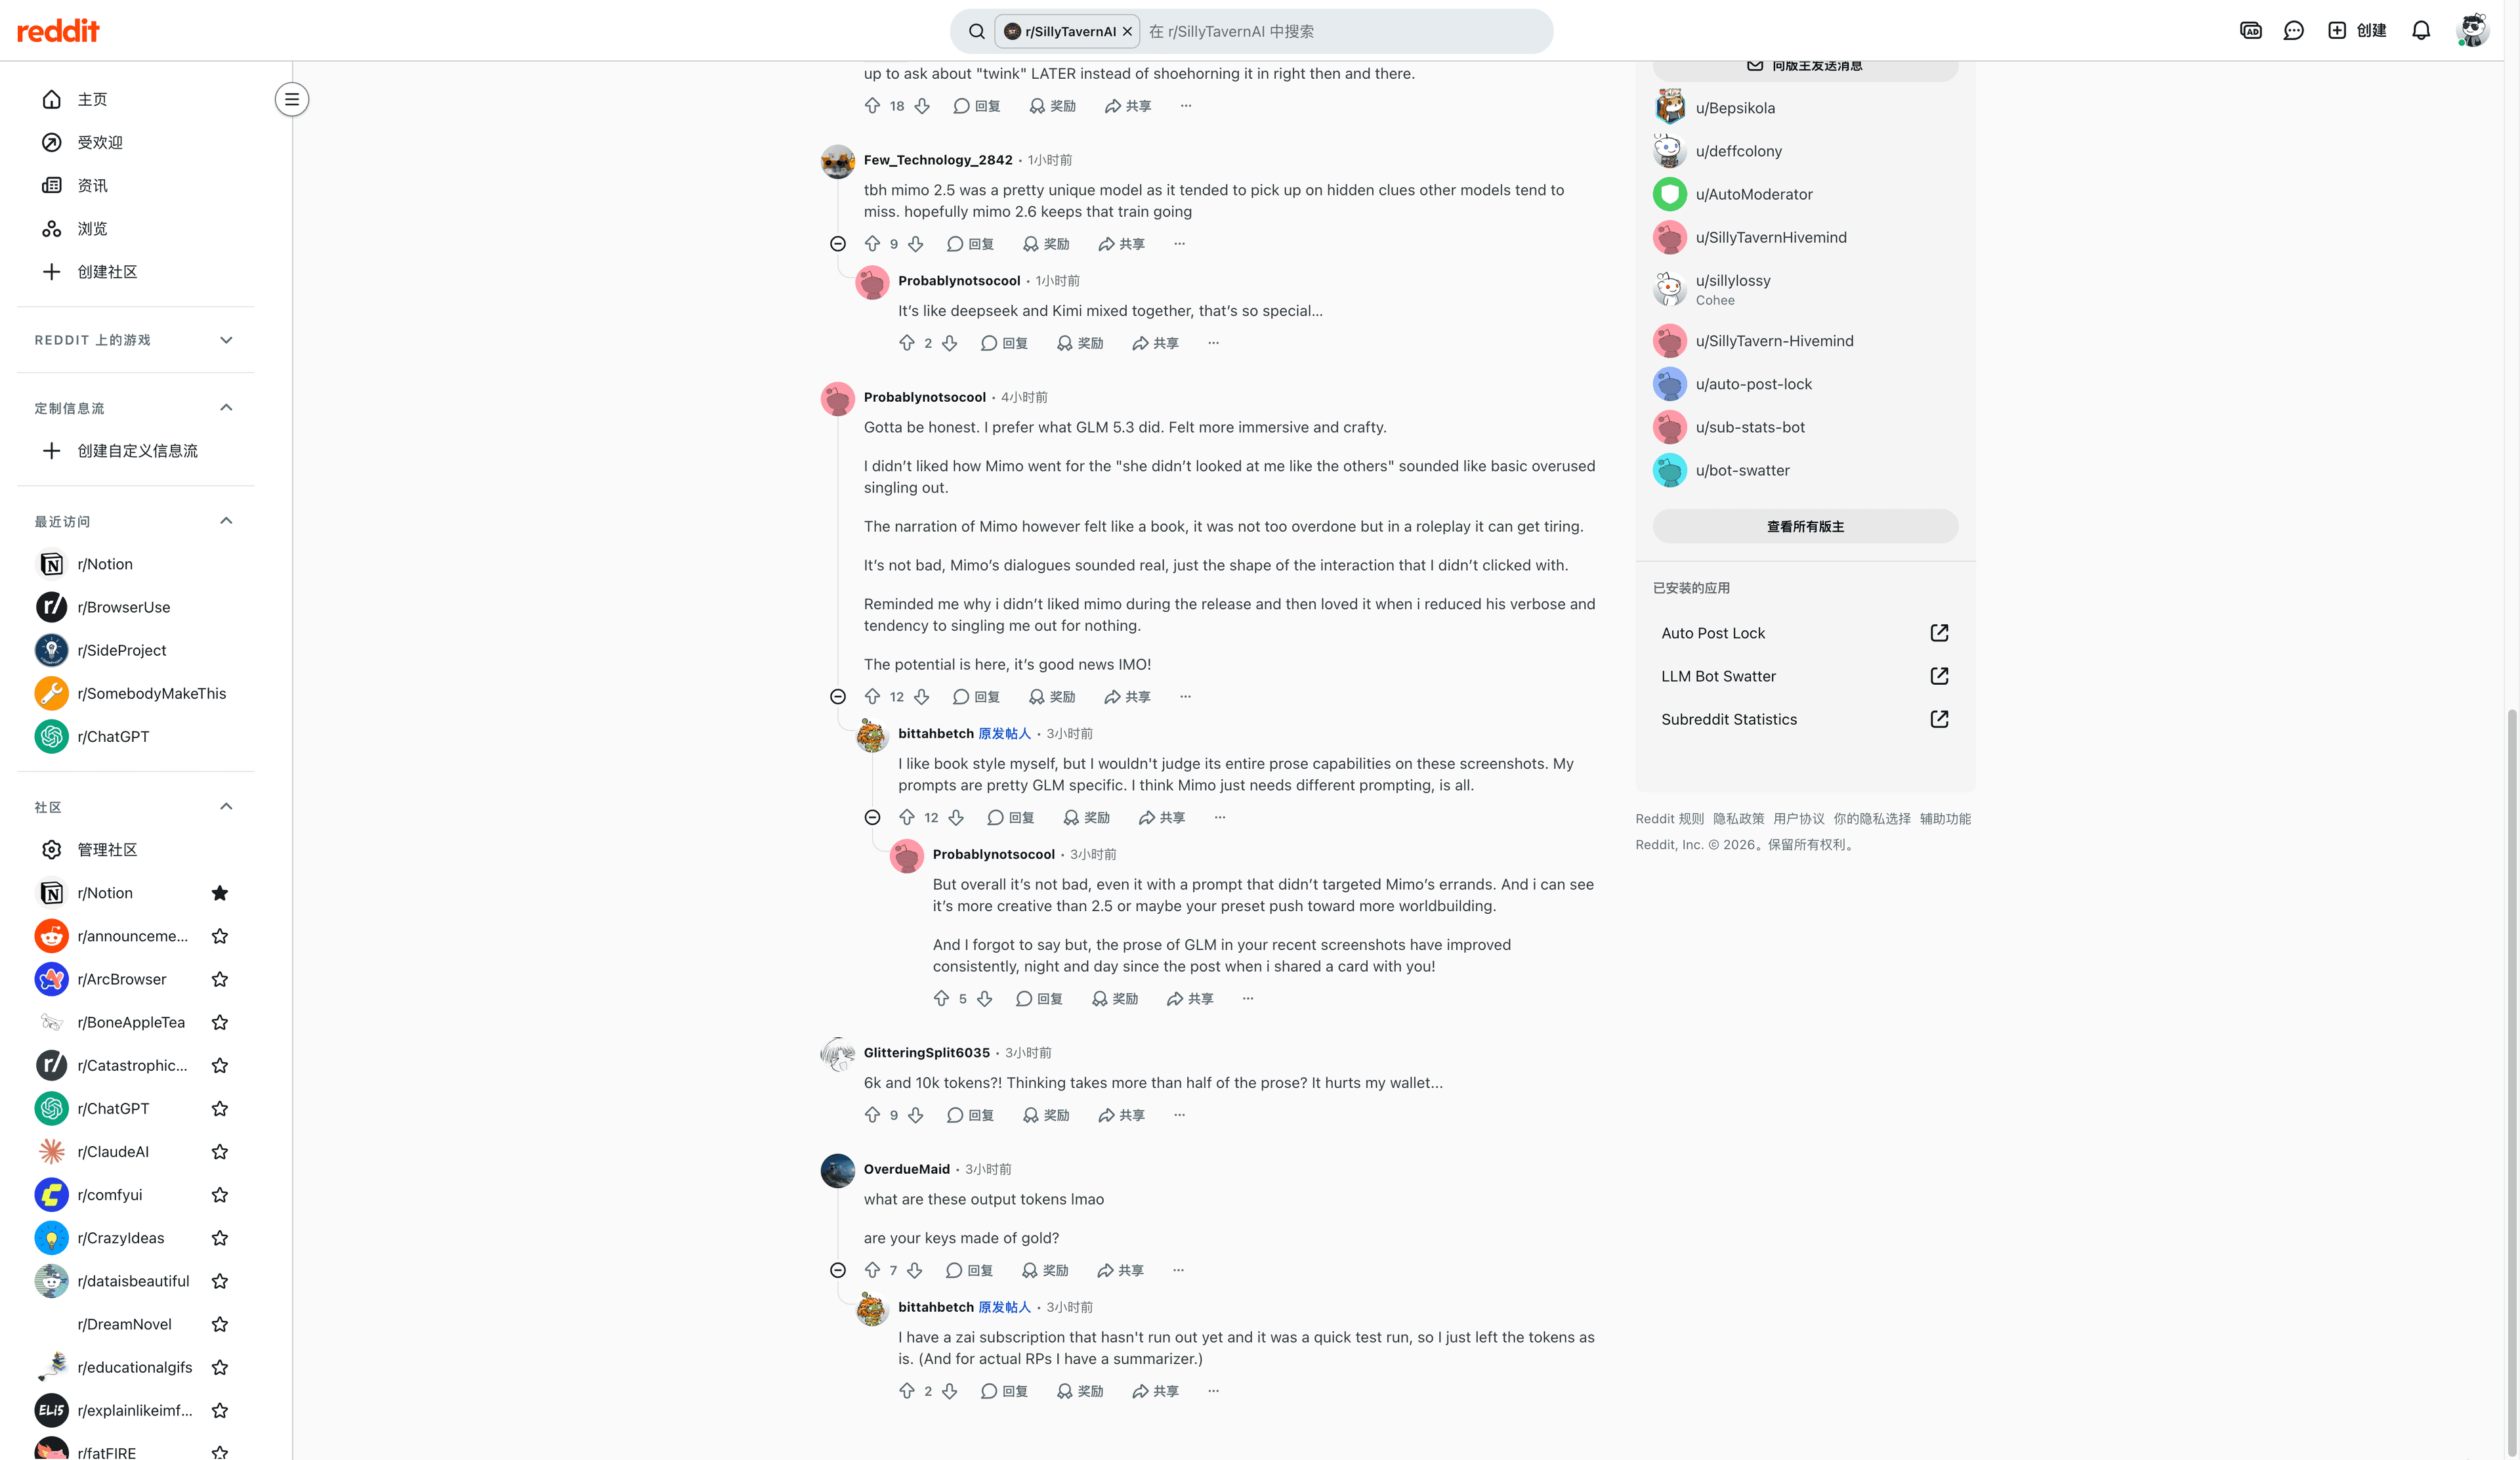
Usuários do Reddit bateram com o mesmo muro em poucas horas:
"6k and 10k tokens?! Thinking takes more than half of the prose? It hurts my wallet..." — u/GlitteringSplit6035 (r/SillyTavernAI, 2026-09-22)
"what are these output tokens lmao are your keys made of gold?" — u/OverdueMaid (mesmo tópico)
Use a âncora para ordenar sua carga de trabalho: se a unidade de trabalho é uma execução longa, compre o cérebro e engula a espera; se a unidade é um turno humano, a espera é o produto.
O que aconteceu em trabalho real, antes do ranking
A evidência mais útil do dia do lançamento não é uma linha de benchmark. São duas pequenas histórias com ferramentas e resultados concretos.
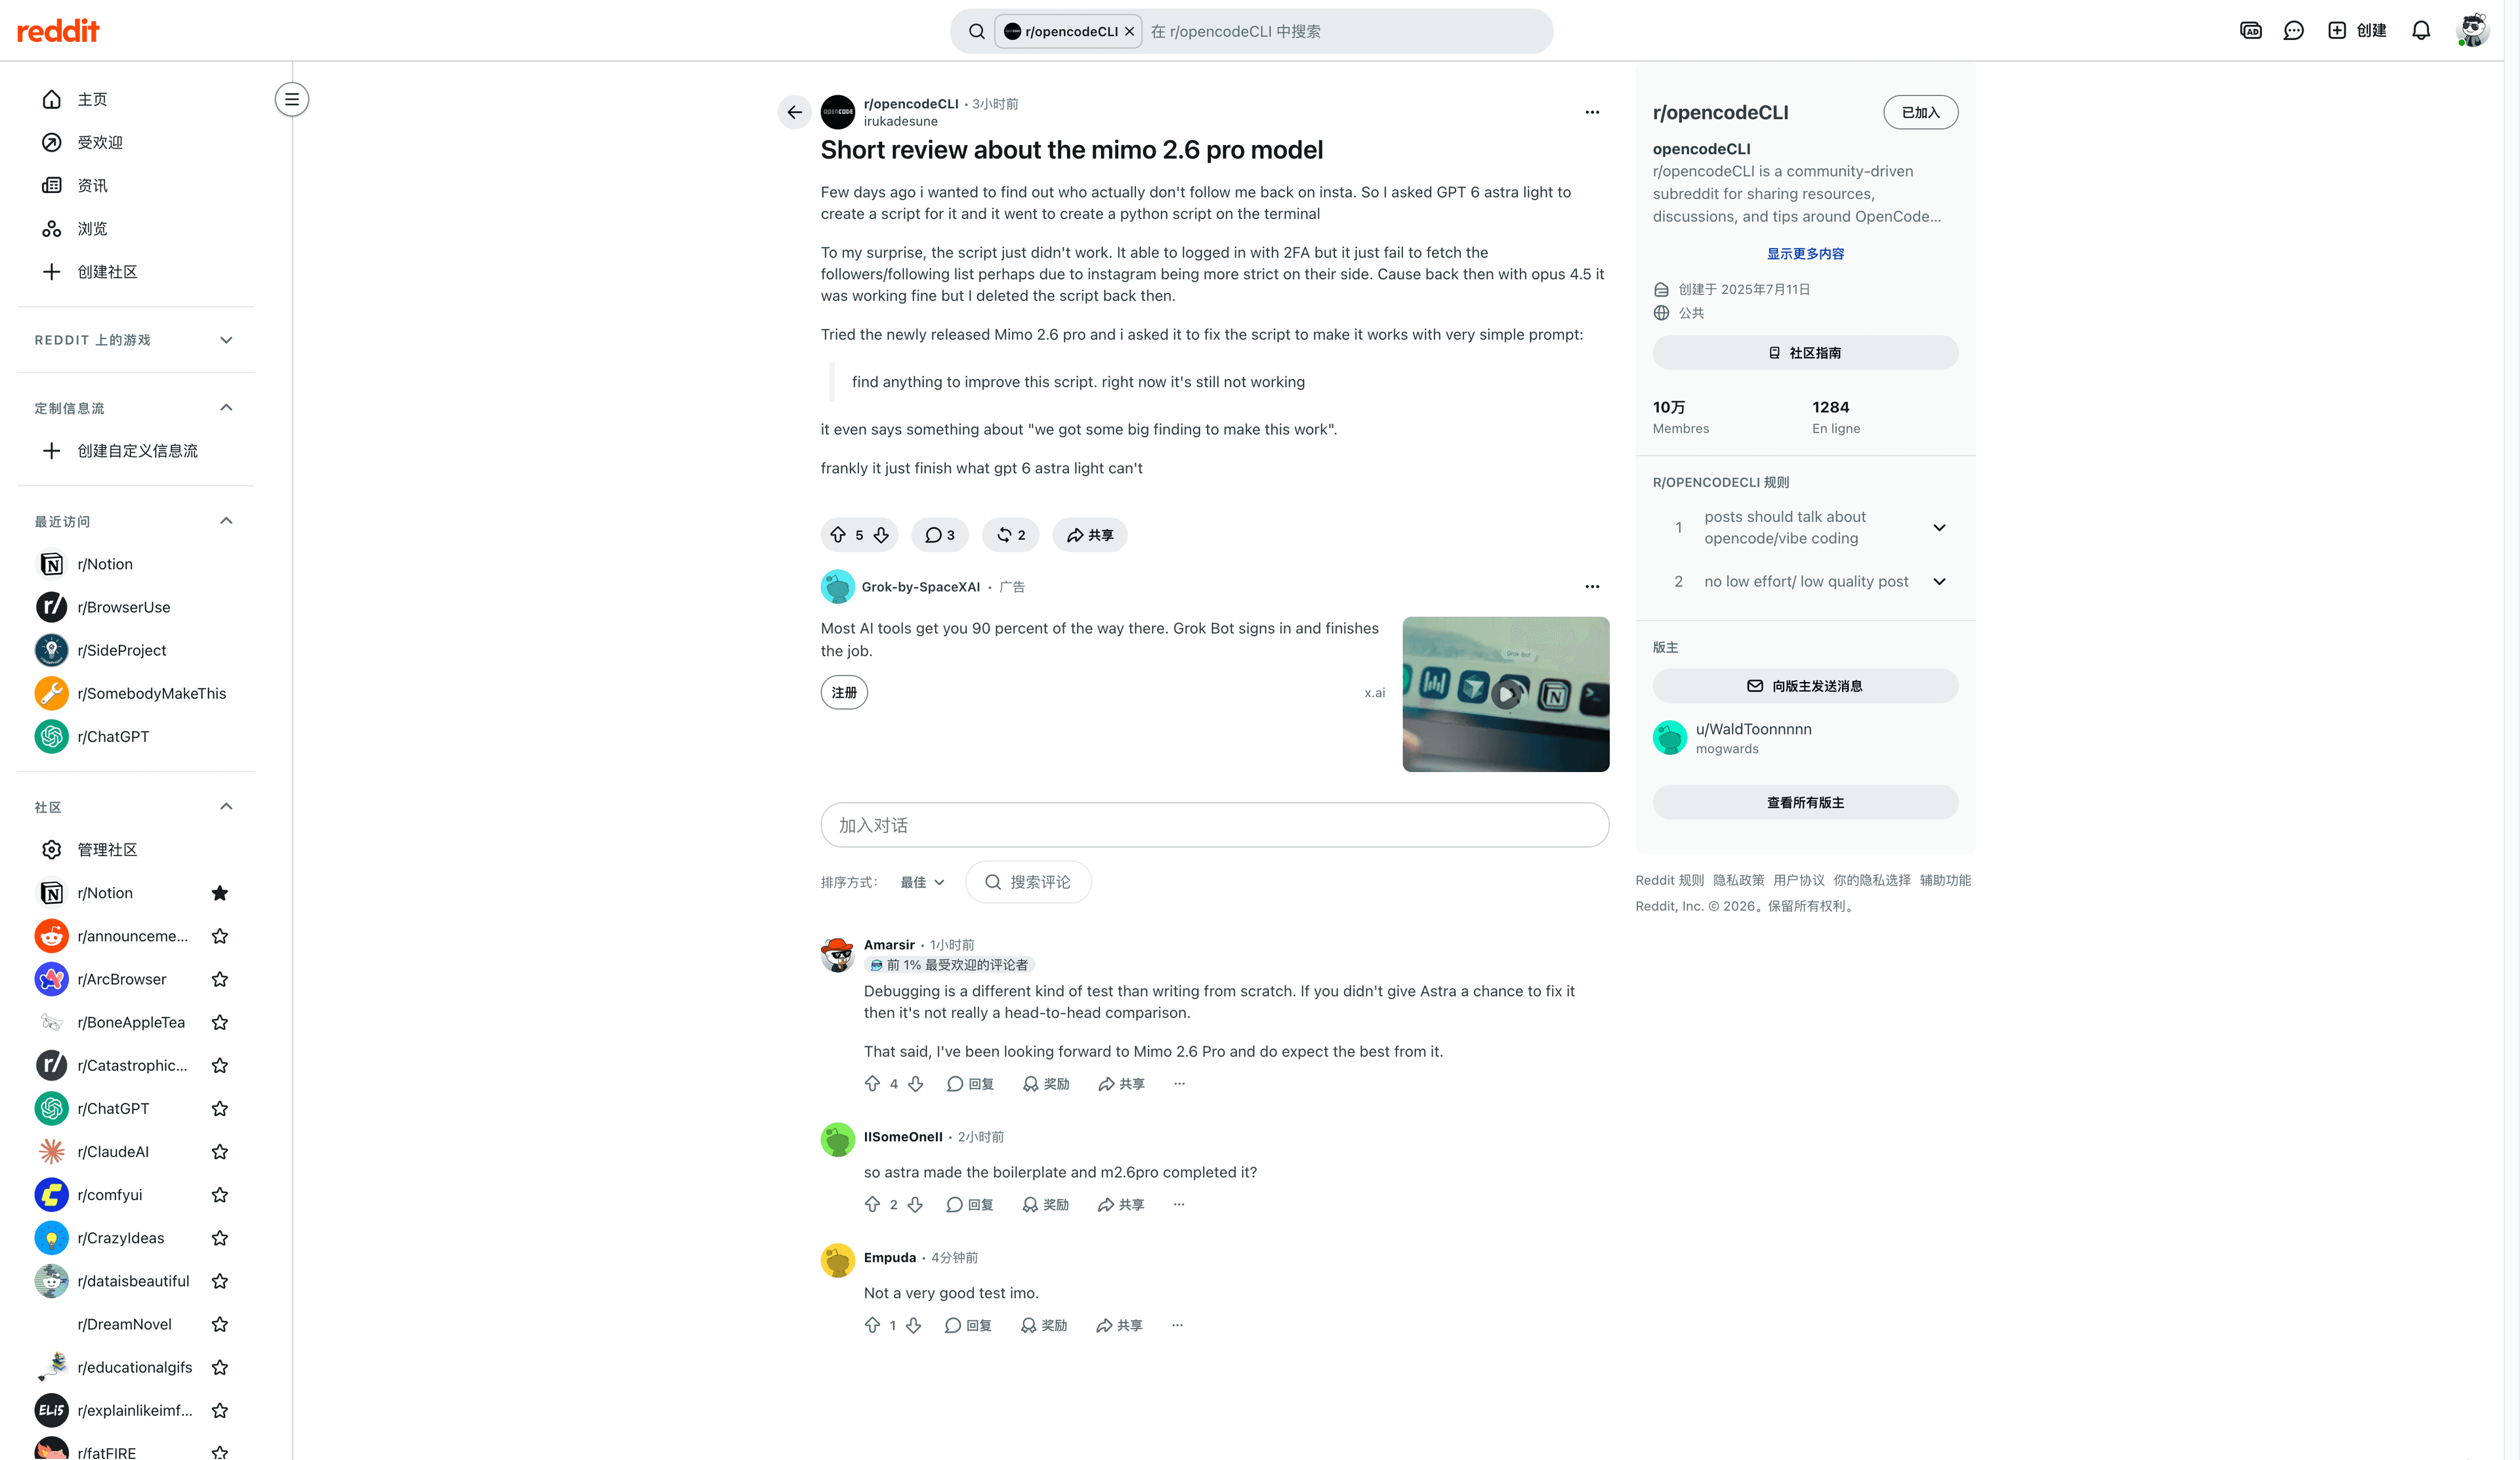
A vitória. u/irukadesune tinha um script Python que verifica quem não o segue de volta no Instagram. GPT-6 Astra Light o reescreveu e o script seguia falhando ao buscar a lista de seguidores. A instrução dada a MiMo-V2.6-Pro foi de uma linha: "find anything to improve this script. right now it's still not working." Ele consertou.
"frankly it just finish what gpt 6 astra light can't" — u/irukadesune (r/opencodeCLI, 2026-09-22)
A crítica. A resposta mais votada aponta o que essa história prova e não prova:
"Debugging is a different kind of test than writing from scratch. If you didn't give Astra a chance to fix it then it's not really a head-to-head comparison." — u/Amarsir (mesmo tópico)
A derrota. u/choiyoh passou a mesma mudança de UI/UX de site para MiMo-V2.6-Flash e MiMo-V2.6-Pro, numa ferramenta de código de terminal. Ambos entraram num laço grep sem avançar.
"for 30 minutes no code was fixed." … "DS 4.1 Flash is still much better.." — u/choiyoh (r/CommandCode, 2026-09-22)
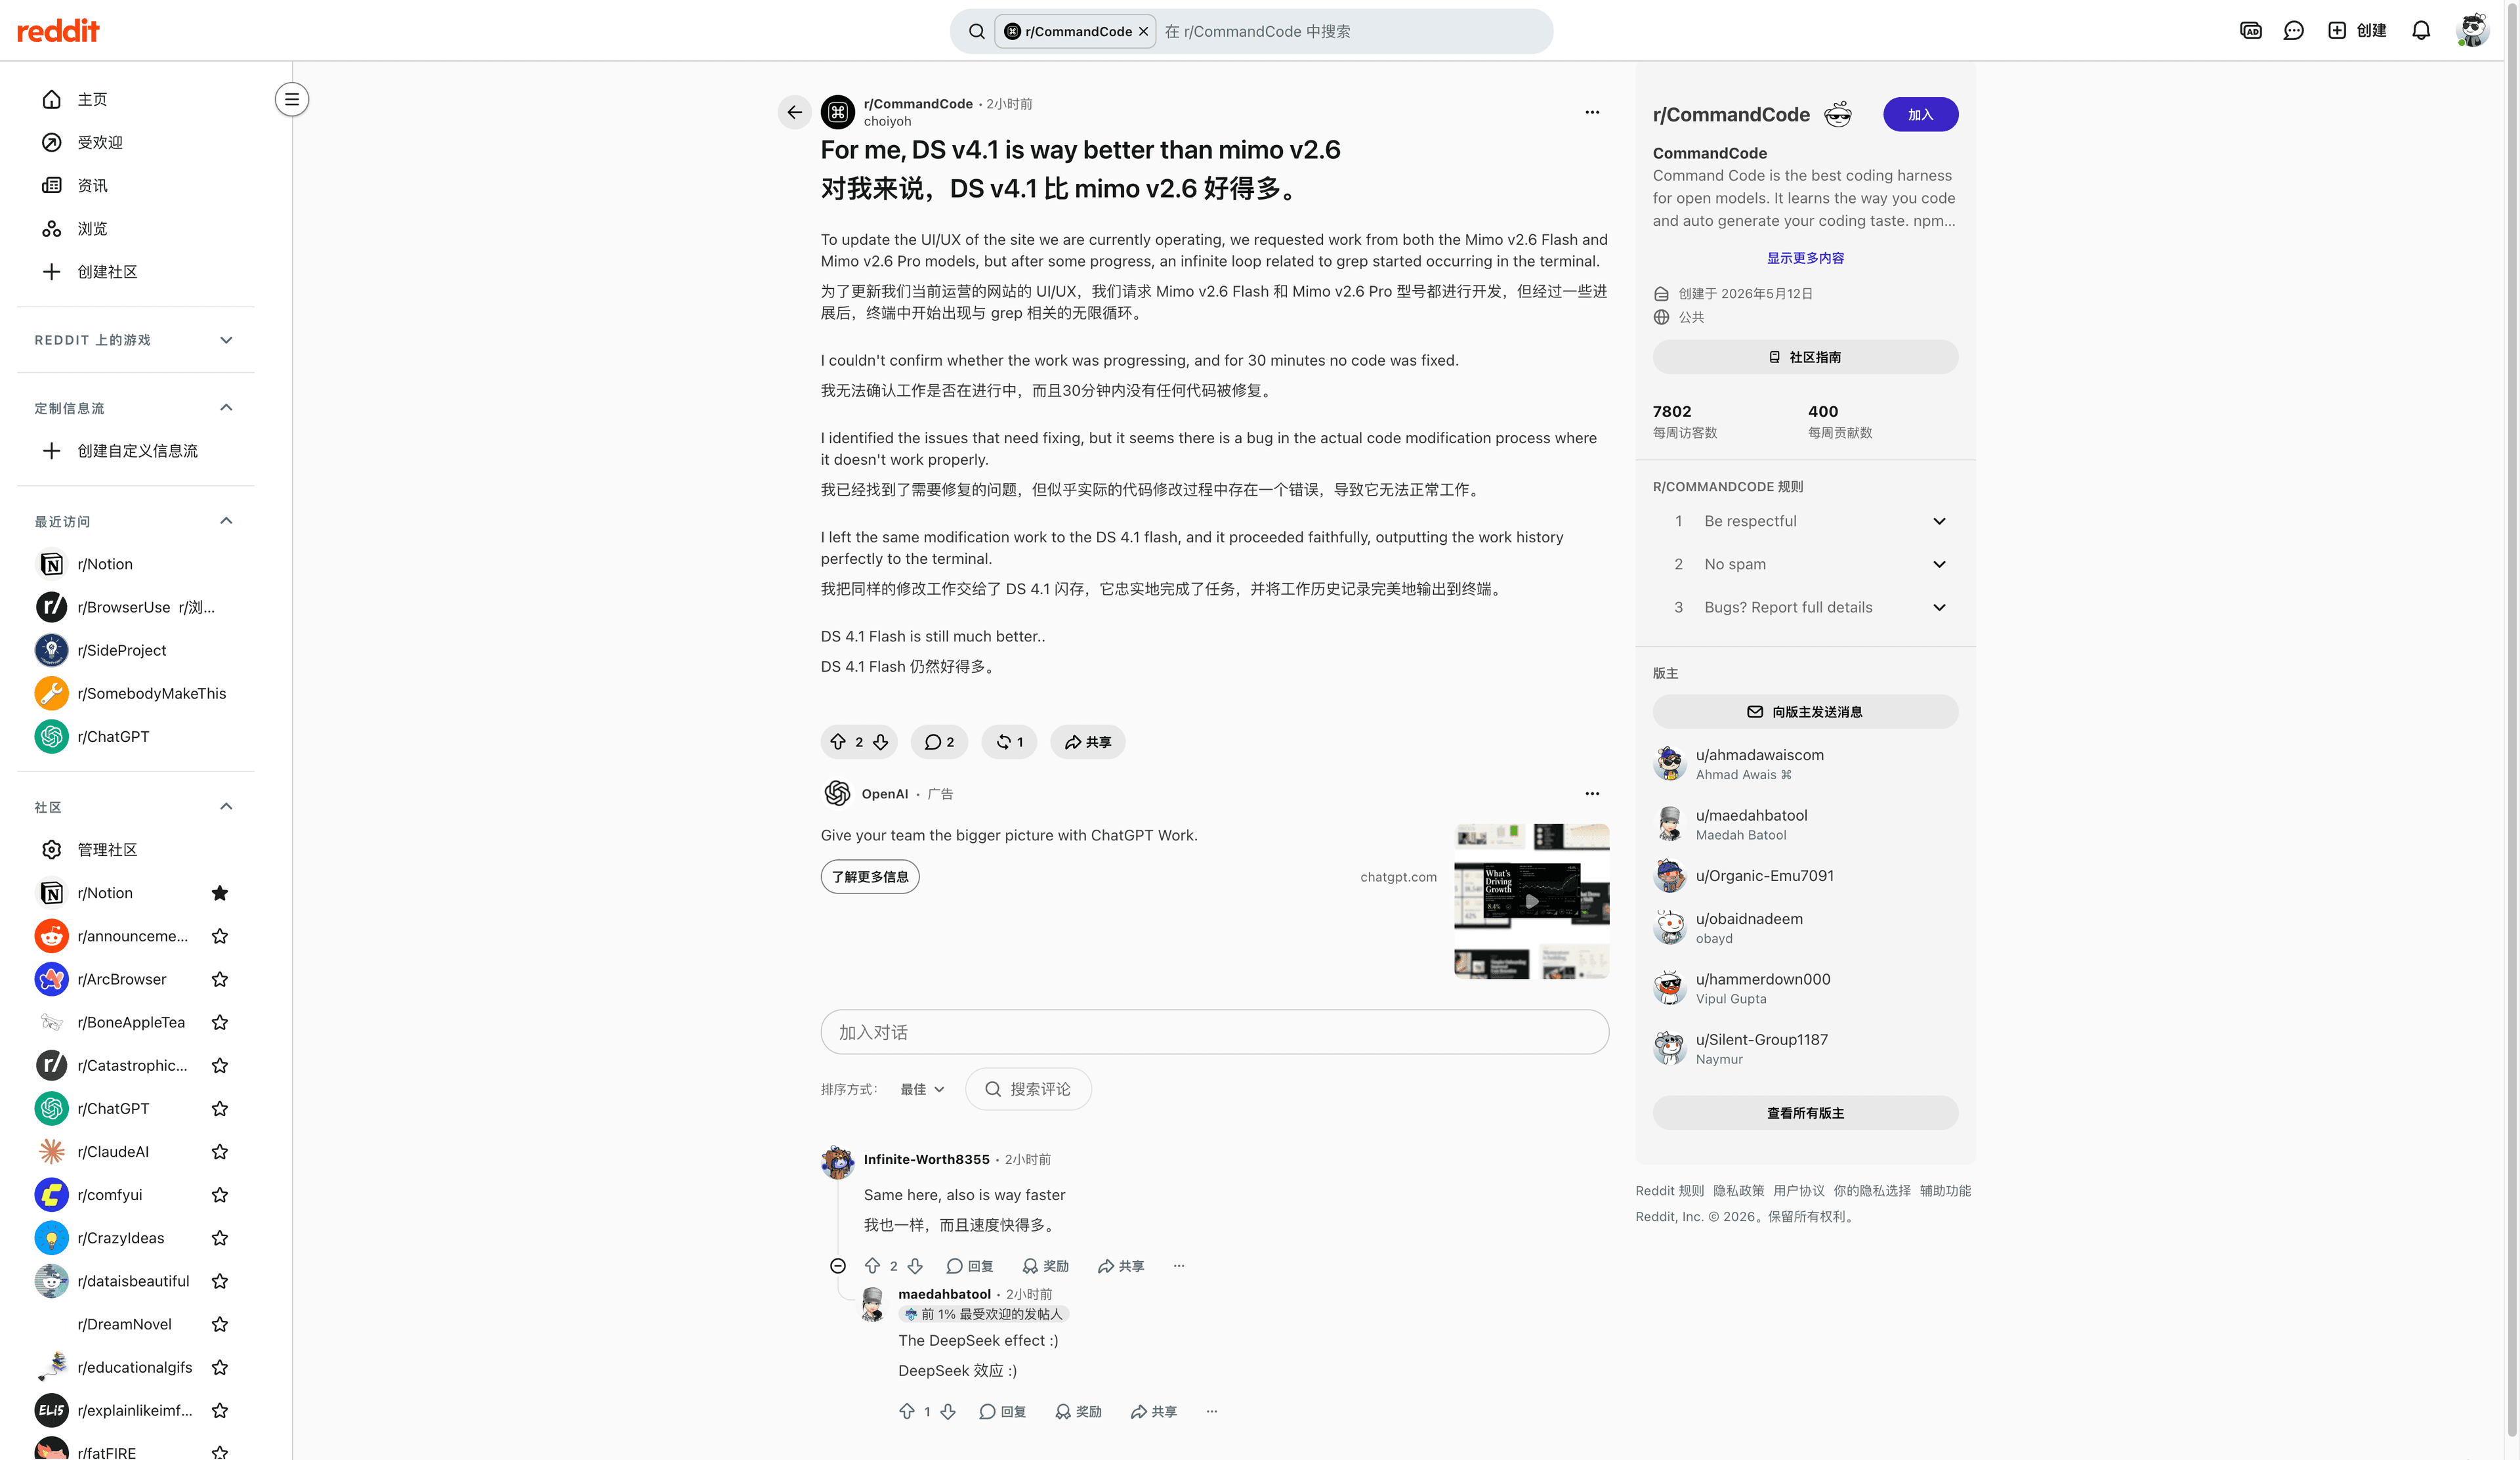
Uma execução cada, sem registros, sem repositórios, sem contagens de tokens. Eles estabelecem que os dois resultados existem por aí — uma depuração que vence um rival e um laço de ferramentas de trinta minutos — e nada sobre com que frequência cada um acontece. Esse é exatamente o vazio que os benchmarks deveriam preencher. Vejamos quanto preenchem.
Os benchmarks, e quanto confiar neles
O relatório técnico da Xiaomi (Tabela 3, informado pelo fabricante, verificado 2026-09-22) compara Pro à própria família e a três modelos fechados de fronteira. Valores como reportados; - significa não fornecido:
| Benchmark | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.5-Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| MiMo Visual Coding (interno) | 72.3 | 71.5 | - | 70.0 | 73.4 | 69.1 |
Agora a água fria, em três partes.
As condições de medição são finas. O relatório publica escores agregados, mas nenhum registro por pergunta, prompt, semente, tamanho de amostra ou intervalo de confiança. Três linhas (MiMo Code Bench, MiMo Cyber Bench, MiMo Visual Coding) são benchmarks internos da Xiaomi. O muito repetido "58.4 → 72.6 no DeepSWE" é uma mudança de curva dentro de uma mesma execução de RL — cerca de 30 passos e US$ 2,62 milhões de computação — não uma comparação modelo contra modelo. O "comparável a Claude Opus 5 e GPT-5.6 Sol na maioria dos benchmarks de agentes" da página oficial é posicionamento, e seu "de 1/20 a 1/60 do preço" omite o conjunto comparado e a contagem de tokens.
A comunidade desconfia por padrão de rankings de treinamento:
"We'll see how it works on real code. DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world … The benchmarks don't care if it's a code spaghetti." — u/lilian_moraru (r/LocalLLaMA, 2026-09-22)
"i mostly care about roleplay so those benchmark wins dont mean much if it still forgets details after a few messages." — u/Pure-Summer2818 (mesmo tópico)
As fontes independentes concordam na forma, não na precisão. A Artificial Analysis rodou em hardware próprio e deu 46 a MiMo-V2.6-Pro (v4.3.2, 10 avaliações), enquanto a linha Arena Code Arena WebDev mostra um AutoEval de 1628 (+18/-18) com Rank e Votes em N/A: é um resultado roteirizado num ranking de votos cegos, e não pode ser escrito como "classificado N-ésimo". A observação metodológica de Amarsir vale para cada linha: depurar não é criar, um harnês não é o seu harnês, e um sinal direcional não é uma régua.
O que sobrevive à água fria: o salto sobre V2.5-Pro (DeepSWE 19.0 → 71.9) é grande demais para ser um truque de arredondamento, e o experimento de transferência de harnês do relatório (quatro harnês de treinamento e depois Codex, Claude Code e mini-swe-agent nunca vistos, com cerca de 50% → 66% de taxa de sucesso) é o tipo de evidência que importa para a implantação real. Só não leia nenhuma linha como sua taxa de sucesso.
Onde MiMo-V2.6-Pro é genuinamente bom
A escrita é a surpresa
Raramente se elogia primeiro a prosa de um modelo de código. No dia do lançamento, os maiores elogios vieram de escritores de roleplay de formato longo, um público que pune com força os padrões repetitivos.
"honestly I'm really enjoying it for RP so far. The responses have been surprisingly good, especially when it comes to keeping the flow of a scene going and actually giving me something interesting to work with instead of falling into the usual repetitive RP patterns." — u/Electrical_Mode_2489 (r/SillyTavernAI, 47 votos)
Outro escritor comparando-o cara a cara com GLM 5.3 gostou do diálogo e da contenção: o modelo "set[] up to ask about 'twink' LATER instead of shoehorning it in right then and there". Se você vive de escrever — ficção, copy de marketing, histórias interativas longas — essa melhoria pode valer mais que qualquer escore de código.
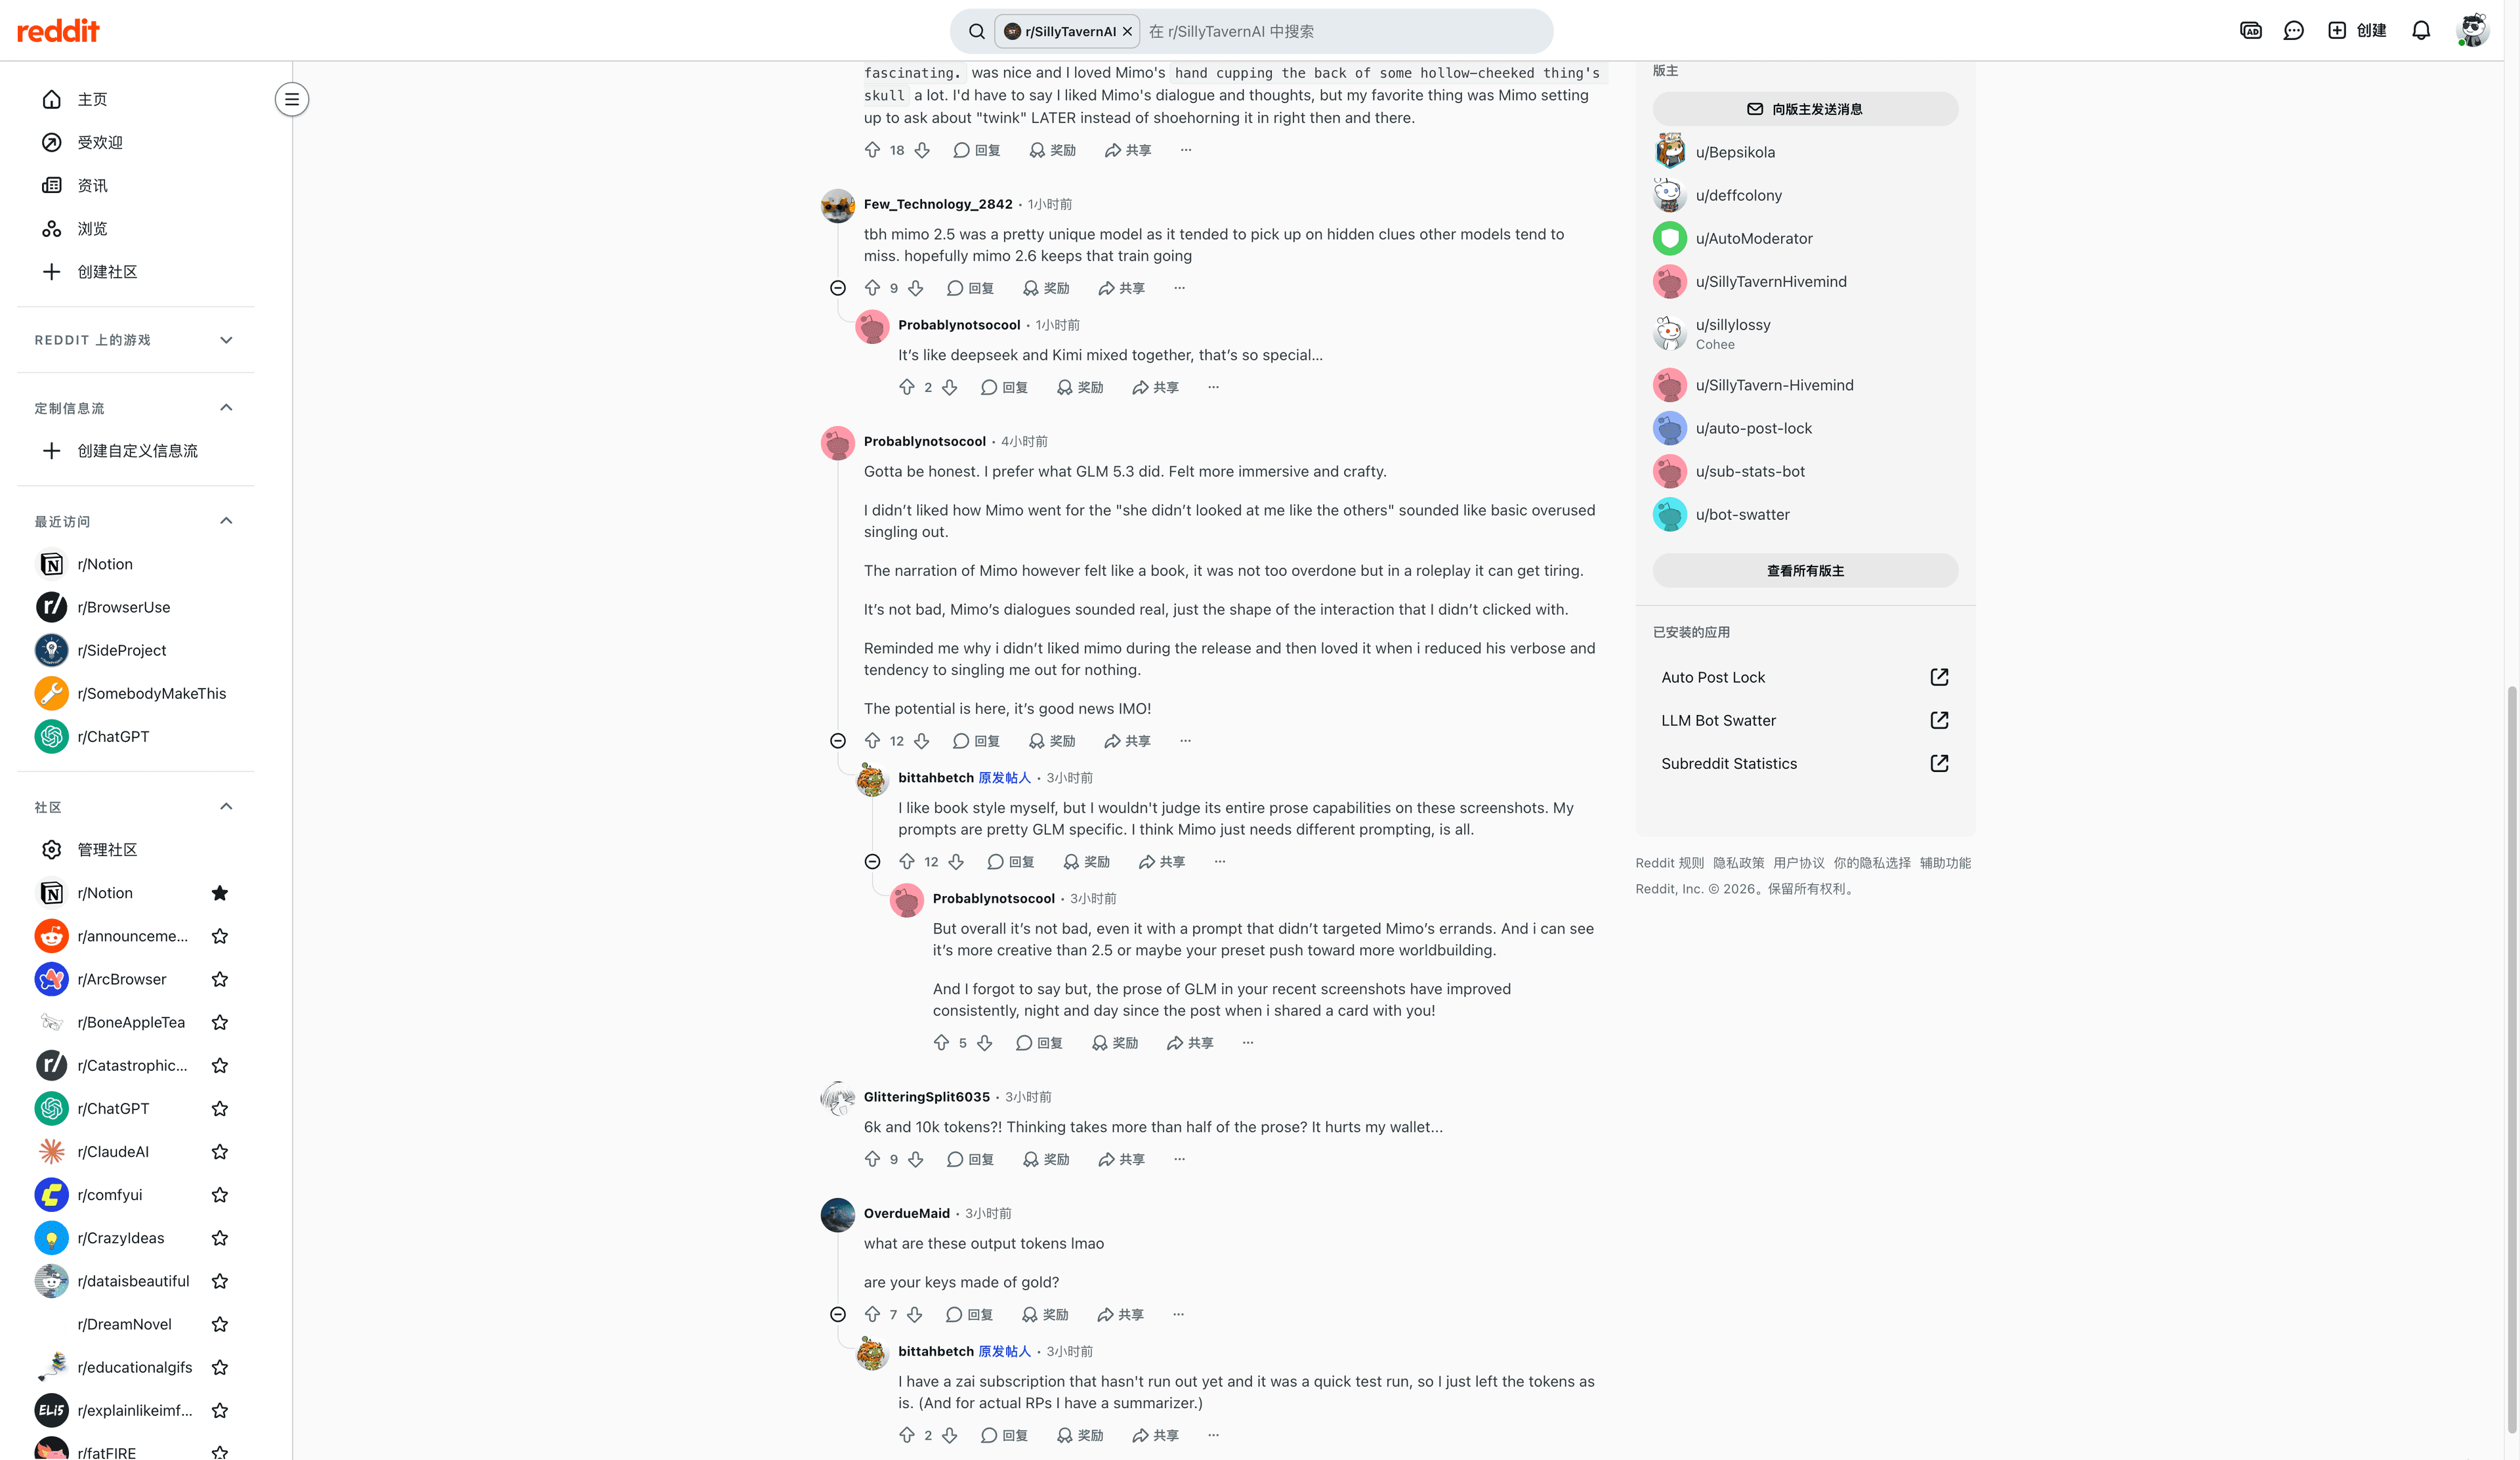
O limite: gosto é pessoal. Nesse mesmo tópico, u/Probablynotsocool preferiu GLM 5.3 ("Felt more immersive and crafty") e achou a narração de MiMo "like a book … in a roleplay it can get tiring". Dois usuários experientes, veredictos opostos, as mesmas saídas.
Automação e fluxos de ferramentas superam os modelos de fronteira no papel
Aqui a forma dos benchmarks realmente favorece MiMo. AutomationBench v1.0.6: 53,1, à frente de Claude Opus 5 (50,3) e GPT-5.6 Sol (45,8). Toolathlon-Verified: 76,9, a três pontos de Opus 5 e à frente de Sol. Terminal Bench 2.1: 89,9, o maior do conjunto. JobBench 62,0 quase dobra os 45,4 de GPT-5.6 Sol.
O detalhe de engenharia atrás dessas linhas importa para a implantação: a etapa de RL treinou com quatro harnês mínimos e depois verificou transferência em três nunca vistos (Codex, Claude Code, mini-swe-agent). Um modelo que só funciona no próprio harnês é uma demo; um modelo que transfere é infraestrutura. Para quem constrói laços de ferramentas multi-etapa — agentes de navegador, corrigidores de CI, automações internas — esta é a razão mais forte para testá-lo.
Inteligência de fronteira a preço de commodity, com pesos MIT
A fotografia da Artificial Analysis de 2026-09-22 coloca MiMo-V2.6-Pro em 46 no Índice de Inteligência — empatado com Grok 4.7 (46) e abaixo de Claude Opus 5 (51) — enquanto é o modelo mais barato por tarefa do índice do conjunto, com US$ 0,13. A tarifa é US$ 0,435 de entrada / US$ 0,87 de saída por milhão de tokens, e os acertos de cache caem para US$ 0,0036: um desconto de 120× que transforma em silêncio a economia de múltiplos turnos (conta de preços aqui; para cruzar orçamentos com outro aberto recente, veja a análise de preços do Kimi K3).
Uma comparação comunitária dos modelos de fronteira do mesmo dia torna o negócio concreto: contra Grok 4.7, MiMo oferece contexto de 1M contra 500k, cerca de 125 contra 42 tokens/s, pesos MIT contra fechado, e US$ 0,435/0,87 contra US$ 2/6 — com ambos em 46 no índice. Se a sua restrição é capacidade por dólar — agentes em lote, pipelines de pesquisa, cargas de raciocínio agêntico — essa é a proposta de valor do lançamento.
Onde morde
O imposto do pensamento: o silêncio se paga duas vezes
Uma vez na espera, outra na conta. 18,17 segundos até o primeiro token de resposta; cerca de 37.520 tokens de raciocínio contra 26.756 de resposta por tarefa do índice, todos cobrados como saída a US$ 0,87 por milhão. Em prompts intensivos em raciocínio, usuários relatam pensamento superior à metade da geração total — a matéria-prima daquelas reações de "6k and 10k tokens?!".
A válvula de escape oficial é mimo-v2.6-pro-ultraspeed: até 20× de velocidade de geração por exatamente 10× o preço (US$ 4,35 de entrada / US$ 8,70 de saída). É uma opção real para produtos interativos com orçamento, mas reprecifica o modelo na faixa de fronteira, o que apaga o principal argumento de valor. Não há hoje documentado na API oficial um interruptor de "pensar menos"; a análise de preços faz as contas.
Os laços de ferramentas fogem do controle
O laço de grep acima é a forma de falha que mais dói em trabalho agêntico: não é uma resposta errada, é resposta nenhuma, com o medidor correndo. O relatório técnico admite que sua própria infraestrutura de treinamento enfrentou OOMs, avaliadores inalcançáveis e falhas de rollout parcial, e não publica uma taxa de falha unificada por benchmark. Outro usuário corrobora o padrão ("Same here, also is way faster", sobre o rival). Se você o adotar para execuções não supervisionadas, orçamente supervisão, timeouts de ferramentas e um modelo de reserva — a mesma disciplina que aplicaria a qualquer stack de navegador agêntico.
Conformidade, endpoints e peso de implantação
Três tropeços práticos que não aparecem nos escores:
Tratamento de dados. Desde o dia do lançamento, usuários apontaram que o único endpoint ativo é de primeira parte e, na leitura deles, não cumpre retenção zero (ZDR): "very interesting, but 2.6 Pro's only endpoint is non-ZDR compliant" (u/total_ty), respondido com "How trustworthy is a random tag on a website, honestly? How do we verify none of our data has been retained by the endpoint?" (u/starliteburnsbrite). Pesos abertos significam que hospedagem de terceiros vem aí — "the weights are already up on huggingface" — mas hoje a rota conforme é auto-hospedagem ou um provedor cujos termos você leu.
Auto-hospedagem é pesada. 1,02T de MoE esparso; os exemplos oficiais de vLLM assumem
--tensor-parallel-size 8. Isto não é um modelo de laptop. Orçamente nós multi-GPU e leia a letra miúda dos parâmetros.Deriva de versões e preços. Os endpoints V2.5 morrem em 2026-10-21; os números da Artificial Analysis se moveram dentro do mesmo dia com o refresh das medições (17,58 → 18,17 s). Fixe versões e reverifique tarifas antes de orçar.
O que as pessoas realmente disseram
A conversa do dia do lançamento se partiu em dois eixos, não um.
Eixo um: encantados contra queimados. A vitória de depuração e o laço de grep estão a quatro horas de distância no Reddit, e as duas torcidas encheram na hora. O prompt de uma linha de u/irukadesune consertou o que um modelo de fronteira rival não conseguiu; u/choiyoh perdeu trinta minutos num laço de terminal e migrou para DeepSeek V4.1 Flash. Os entusiastas leem a mesma evidência e extrapolam — "I believe in mimo, mimo will replace GLM as THE rp model" (u/stopaskingforloginn) — enquanto os céticos pedem registros.
Eixo dois: animados com o preço, incomodados com o pensamento. O primeiro choque do tópico de lançamento foi econômico — "They kept the prices!? It's over." (u/Pink_da_Web) — e então chegaram as contagens de tokens:
Mesmo o público mais satisfeito do modelo, os escritores, discorda entre si:
Onde esta review pousa: u/Amarsir pousou no mesmo lugar — entusiasmo pelo modelo, impaciência com comparações capengas. O padrão das nove vozes verificadas é coerente com os números: capacidade séria, atrito sério na espera e na conta, e confiabilidade de laço de ferramentas não provada em n=1 nas duas direções.
O veredicto: escolha por carga de trabalho, não pelo escore
| Forma de carga de trabalho | Veredito | Por quê | Ressalva principal |
|---|---|---|---|
| Execuções agênticas longas de código, correções em lote, laços não supervisionados | Teste | AutomationBench 53,1 supera Opus 5 e Sol; evidência de transferência de harnês; contexto 1M; US$ 0,13/tarefa dilui a espera | Falhas em laço tipo grep são reais; supervise e mantenha um modelo reserva |
| Chat interativo, roleplay e prosa longa | Sim, com ressalvas | Os elogios à prosa são concretos e repetidos; contexto 1M mantém cenas longas coerentes | 18s de primeira resposta + tokens de pensamento encarecem latência e custo por cena; alguns preferem GLM 5.3 |
| Automação de computador e navegador | Candidato forte | OSWorld-Verified 82,0, JobBench 62,0, código visual 72,3 (interno); entrada omnimodal | A evidência é majoritariamente do fabricante; verifique primeiro no seu conjunto de tarefas |
| Dados regulados / exigência de retenção zero | Ainda não | Pesos MIT permitem em princípio auto-hospedagem ou provedores conformes | Hoje o único endpoint ativo é de primeira parte e seu status ZDR é não verificado |
| Inferência local em GPU única ou laptop | Não | 1,02T de MoE esparso; o serving oficial assume paralelismo de tensores em 8 vias | A família Flash ou destilados menores são a opção local realista |
Duas notas datadas. Primeira: Grok 4.7 lançou no mesmo dia com 46 no índice da Artificial Analysis, e uma comparação comunitária concluiu que "neither one decisively dominates the other": a comparação que você deve rodar é a da sua carga de trabalho, idealmente com dois candidatos lado a lado. Segunda: os endpoints V2.5 encerram em 2026-10-21, então planejar a migração não é opcional se você construiu sobre eles.
Uma rota prática: faça rodar onde o trabalho acontece
Tudo nesta review aponta para um mesmo perfil: a espera penaliza humanos e não agentes; tokens de pensamento punem turnos isolados e recompensam execuções sustentadas; o risco de laço exige supervisão. Esse perfil encaixa mal numa caixa de chat colada num documento, e bem num fluxo de trabalho em nível de navegador que lê páginas, segura 1M de tokens de contexto e trabalha enquanto você faz outra coisa.
Esse é o fluxo para o qual o Tabbit Browser foi construído: pesquisa multi-página, extração e automação como tarefa de agentic browser, e não como um prompt único. O limite honesto: esta rodada de review não conseguiu verificar se MiMo-V2.6-Pro aparece hoje no seletor de modelos ao vivo do Tabbit, e nenhuma execução prática no Tabbit é reivindicada aqui. Confira o seletor da sua conta antes de planejar em torno disso, como faria com a disponibilidade de qualquer modelo em qualquer cliente.
Se o perfil acima casa com o seu trabalho — execuções longas, contexto pesado, chamadas de ferramentas, disciplina de custo — a pergunta certa não é "qual modelo pontua mais" e sim "qual modelo termina meu trabalho". Rode um conjunto fixo de tarefas suas com dois candidatos e conte trabalho concluído por dólar. Esse teste vence qualquer linha de ranking deste artigo.
 Tabbit Browser

Perguntas frequentes
Vale a pena usar MiMo-V2.6-Pro?
Sim, para cargas de trabalho longas de código agêntico, automação e escrita criativa onde a qualidade da conclusão importa mais que a resposta imediata. Pense duas vezes se você precisa de primeiras respostas rápidas, endpoints com retenção zero verificada ou implantação local em GPU única, e compare pelo menos um rival antes de decidir.
Quanto tempo MiMo-V2.6-Pro leva para responder?
A Artificial Analysis mediu 18,17 segundos até o primeiro token de resposta no provedor Xiaomi com carga de trabalho de 10.000 tokens de entrada, verificado em 22 de setembro de 2026. Depois da espera, gera a cerca de 125 tokens por segundo, então quase toda a demora é raciocínio silencioso.
Tokens de pensamento custam dinheiro em MiMo-V2.6-Pro?
Custam. A Xiaomi cobra o raciocínio interno como tokens de saída padrão a US$ 0,87 por milhão. A Artificial Analysis registrou cerca de 37.500 tokens de pensamento contra 26.800 tokens de resposta por tarefa do índice: boa parte da conta paga pensamento que você nunca vê.
Como MiMo-V2.6-Pro se compara a Grok 4.7 e Claude Opus 5?
No Índice de Inteligência da Artificial Analysis verificado em 22 de setembro de 2026, MiMo-V2.6-Pro e Grok 4.7 pontuam 46 e Claude Opus 5 pontua 51. O relatório da Xiaomi coloca DeepSWE v1.1 em 71,9 contra cerca de 73 do Grok 4.7 e 74 do Opus 5, a US$ 0,435 por milhão de tokens de entrada contra US$ 2 e US$ 15.
MiMo-V2.6-Pro é realmente open source, e posso executá-lo por conta própria?
Os pesos são de licença MIT e baixáveis no Hugging Face, um acesso mais forte que o da maioria dos modelos de fronteira. A auto-hospedagem é pesada: o checkpoint é um MoE esparso de cerca de 1,02 trilhão de parâmetros com 42 bilhões ativos, e os exemplos oficiais de vLLM e SGLang assumem configurações multi-GPU. Os resumos de parâmetros divergem entre fontes, então verifique o checkpoint exato antes de dimensionar hardware.
Posso usar MiMo-V2.6-Pro no Tabbit Browser?
O Tabbit executa fluxos de trabalho de IA em nível de navegador com os modelos do seu seletor ao vivo. Esta review não conseguiu verificar se MiMo-V2.6-Pro aparece hoje nesse seletor, então confira o seu e os termos da sua conta antes de planejar em torno disso.