
MiMo-V2.6-Pro は、長いエージェント実行と自動化、そして意外なことに文章作成で、じっくり試す価値があります。同時に、あなたの時間を最も待たせるモデルでもあります。発売当日、オープン勢トップの賢さの裏で、最初の一言までの待ち時間は最長クラスでした。発表から数時間で、競合フロンティアモデルが直せなかったスクリプトを直したという報告と、ターミナルで 30 分もループして動かなかったという報告が同時に立っています。どちらも事実です。このレビューはそれらを仕分けします。
本稿が採用する証拠は、読者が自分で開いて確認できるものだけです。ベンダーの主張、独立測定値、日付付きのコミュニティ報告。それぞれに「何を証明できるか」を明記します。発表情報は MiMo-V2.6-Pro モデルページ (English)、お金の話は価格分析にあります。ここで答えるのはより狭い問い——使う価値があるか、誰に向くか、その代償としてどんな待ち時間を払うかです。
最後に、これらの結論がブラウザ級ワークフローにとって何を意味するかを見ます。日常がチャット窓の前に座ることではなく、複数ページの調査・情報抽出・自動化なら、この部分はあなたに関係します。
要点
MiMo-V2.6-Pro は Artificial Analysis のインテリジェンス指数で 46。同クラス 114 モデル中 1 位で、オープン重みとしては最高得点。比較セット内で 1 指数タスクあたりのコストは最安の $0.13。(Artificial Analysis、2026-09-22 確認)
裏面は待ち時間:Xiaomi プロバイダ・1 万入力トークンのワークロードで最初の回答トークンまで 18.17 秒、その大半は黙った思考。生成自体は約 125 トークン/秒。(AA プロバイダ基準)
思考トークンは出力課金(100 万トークン $0.87 / 6.00 元)。指数タスクでは思考約 37,500 トークンが回答約 26,800 トークンを上回りました。
発売当日の実体験報告は両極端:壊れた Python スクリプトが GPT-6 Astra Light の失敗後に直った話と、grep 無限ループ 30 分の末に DeepSeek V4.1 Flash が同じ作業を完了した話。どちらも n=1。
最大のサプライズは文章力——ロールプレイや長文ユーザーが場面の流れと会話を激賞。最大のリスクはツールループの暴走。ワークロード別の判定は文末の意思決定表へ。
MiMo-V2.6-Pro とは何か
Xiaomi は 2026-09-22 に MiMo-V2.6-Pro と MiMo-V2.6-Flash (English) を「ネイティブ・オムニモーダル」のオープン重みモデルとして発表しました。Pro はスパース MoE:総パラメータ約 1.02T、1 トークンあたり有効 42B、コンテキスト 100 万トークン、テキスト・画像・音声・動画の入力とテキスト出力、MIT ライセンス。重みは Hugging Face(XiaomiMiMo/MiMo-V2.6-Pro-RL)、API 名は mimo-v2.6-pro、速度重視の別料金ティア mimo-v2.6-pro-ultraspeed があります。V2.5 系のエンドポイントは 2026-10-21 に終了します(移行の背景)。
数字を見る前に注意が一つ:パラメータ表記が食い違います。技術レポートは総 1.02T / 有効 42B、Hugging Face の概要には 524B の行があり、Artificial Analysis の構造化データは 978B passive。公式技術レポートのアーキテクチャ値として 1.02T/42B を採用しつつ、ハードを見積もる前に実物の checkpoint を確認してください。
このレビューが答えるのは「賢いかどうか」ではありません——リーダーボードが答えています。この速度特性・課金構造・ツールループ特性を持つモデルがあなたのワークフローに適しているかどうか。比較相手は GPT-6 Astra、Claude Fable 5.1、あるいはより安い Gemini 3.8 Flash です。
このレビューを決めるひとつの数字:18 秒の沈黙
以下を貫くアンカーです。MiMo-V2.6-Pro は Artificial Analysis 測定のオープン重みとして最高の賢さ(46、114 モデル中 1 位)を、比較セットで最安のタスクコスト($0.13)で達成します。そしてリスト掲載プロバイダ(Xiaomi、1 万入力トークン、2026-09-22 確認)で最初の回答トークンに 18.17 秒かけます。
この 2 つの数字は、誰が待つかでまるで違う 2 つのモデルを描写します。30 回のツール呼び出しを回すバックグラウンドエージェントにとって、冒頭の 18 秒の思考は分数単位の放置作業に薄まるだけ。続く 125 トークン/秒は同じスナップショットで 1〜2 モデルを除いて最速です。一方、質問してカーソルを見つめる人間にとって 18 秒は永遠で、500 トークン回答のエンドツーエンド 22.2 秒はもっと深刻です。
同日早朝の Artificial Analysis スナップショストは待ち時間を分解しています:思考 15.41 秒 + 入力処理 2.17 秒——待ちの 87.7% は口を開く前の推論。同じ構造化データが請求書の謎も説明します。指数 1 タスクあたり推論約 37,520 トークン対回答 26,756 トークン。見える回答 1 トークンにつき、見えない思考に約 1.4 トークン払う計算です。
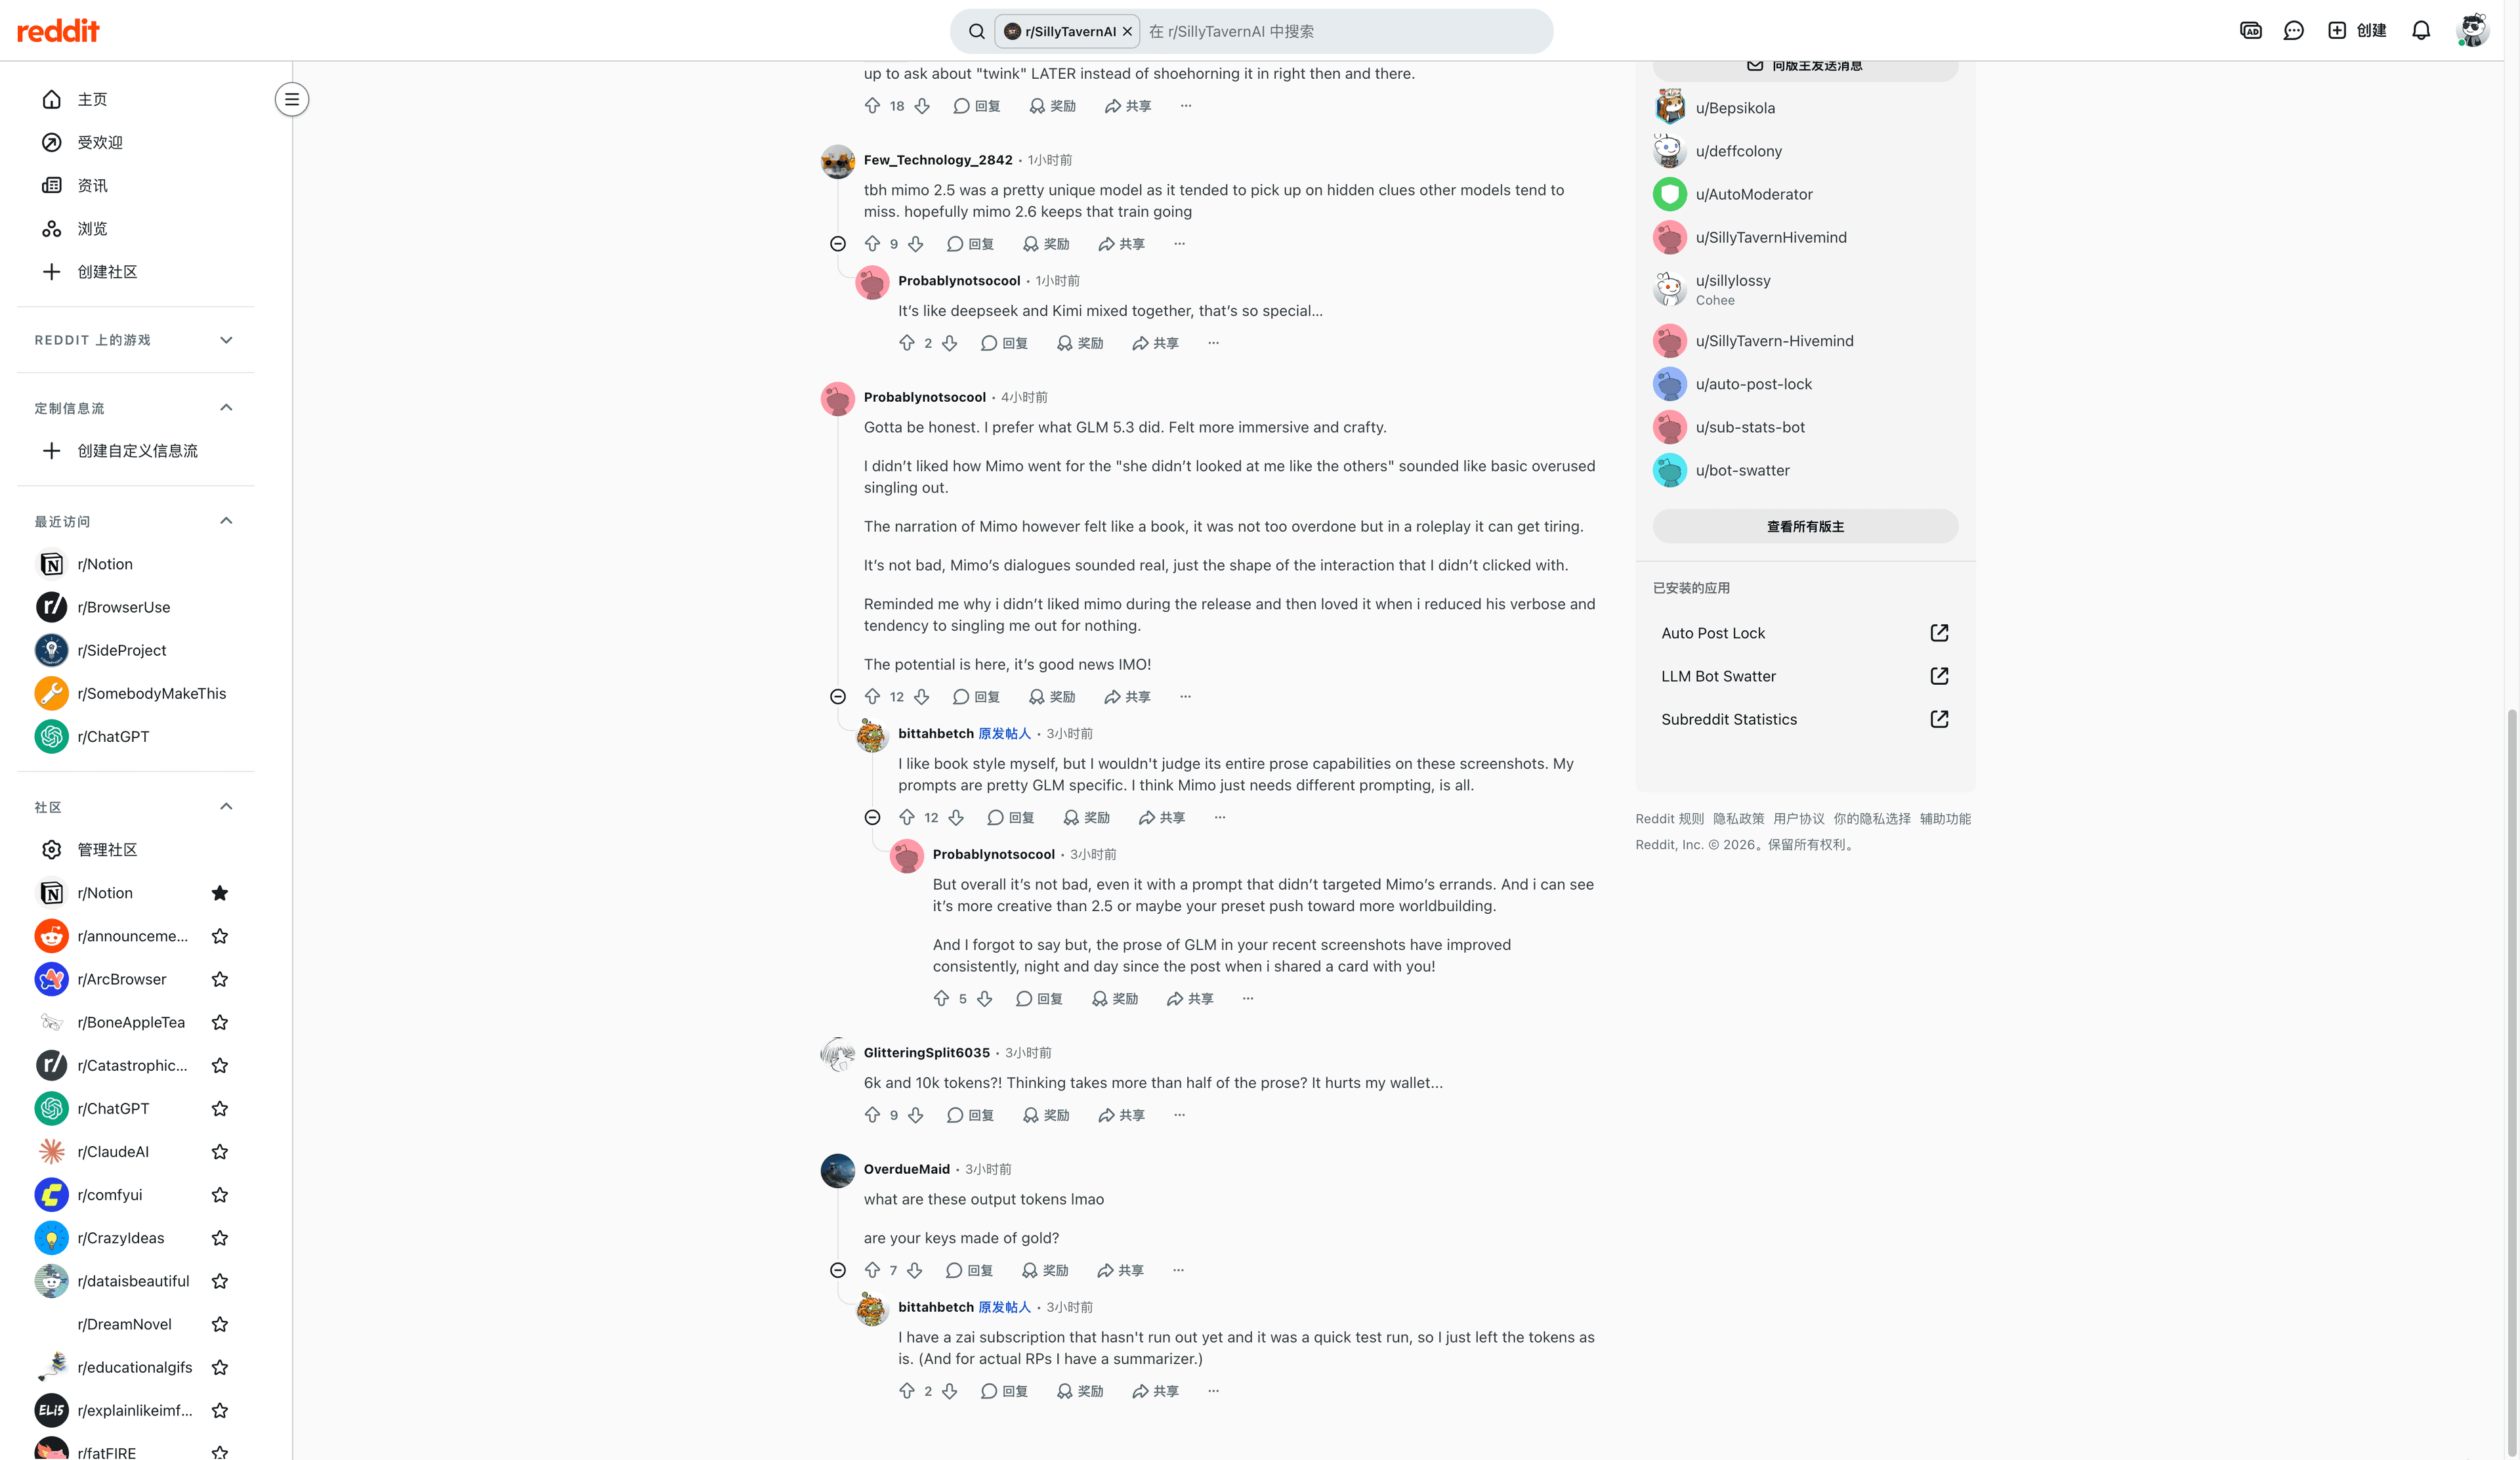
Reddit ユーザーは発売数時間で同じ壁にぶち当たりました:
"6k and 10k tokens?! Thinking takes more than half of the prose? It hurts my wallet..." — u/GlitteringSplit6035(r/SillyTavernAI、2026-09-22。訳:6 千や 1 万トークン!?思考が本文の半分超?財布が泣いてる……)
"what are these output tokens lmao are your keys made of gold?" — u/OverdueMaid(同スレッド。訳:この出力トークン何なんだよ、キーは金でできてるの?)
このアンカーでワークロードを仕分けてください。仕事の単位が長時間ランなら、頭脳を買って待ちを飲み込む。仕事の単位が人間の 1 ターンなら、待ちそのものが製品です。
リーダーボードの前に、実仕事の成否
発売当日で最も役立った証拠はベンチマークの行ではなく、具体的な道具と結果を持つ 2 つの小話です。
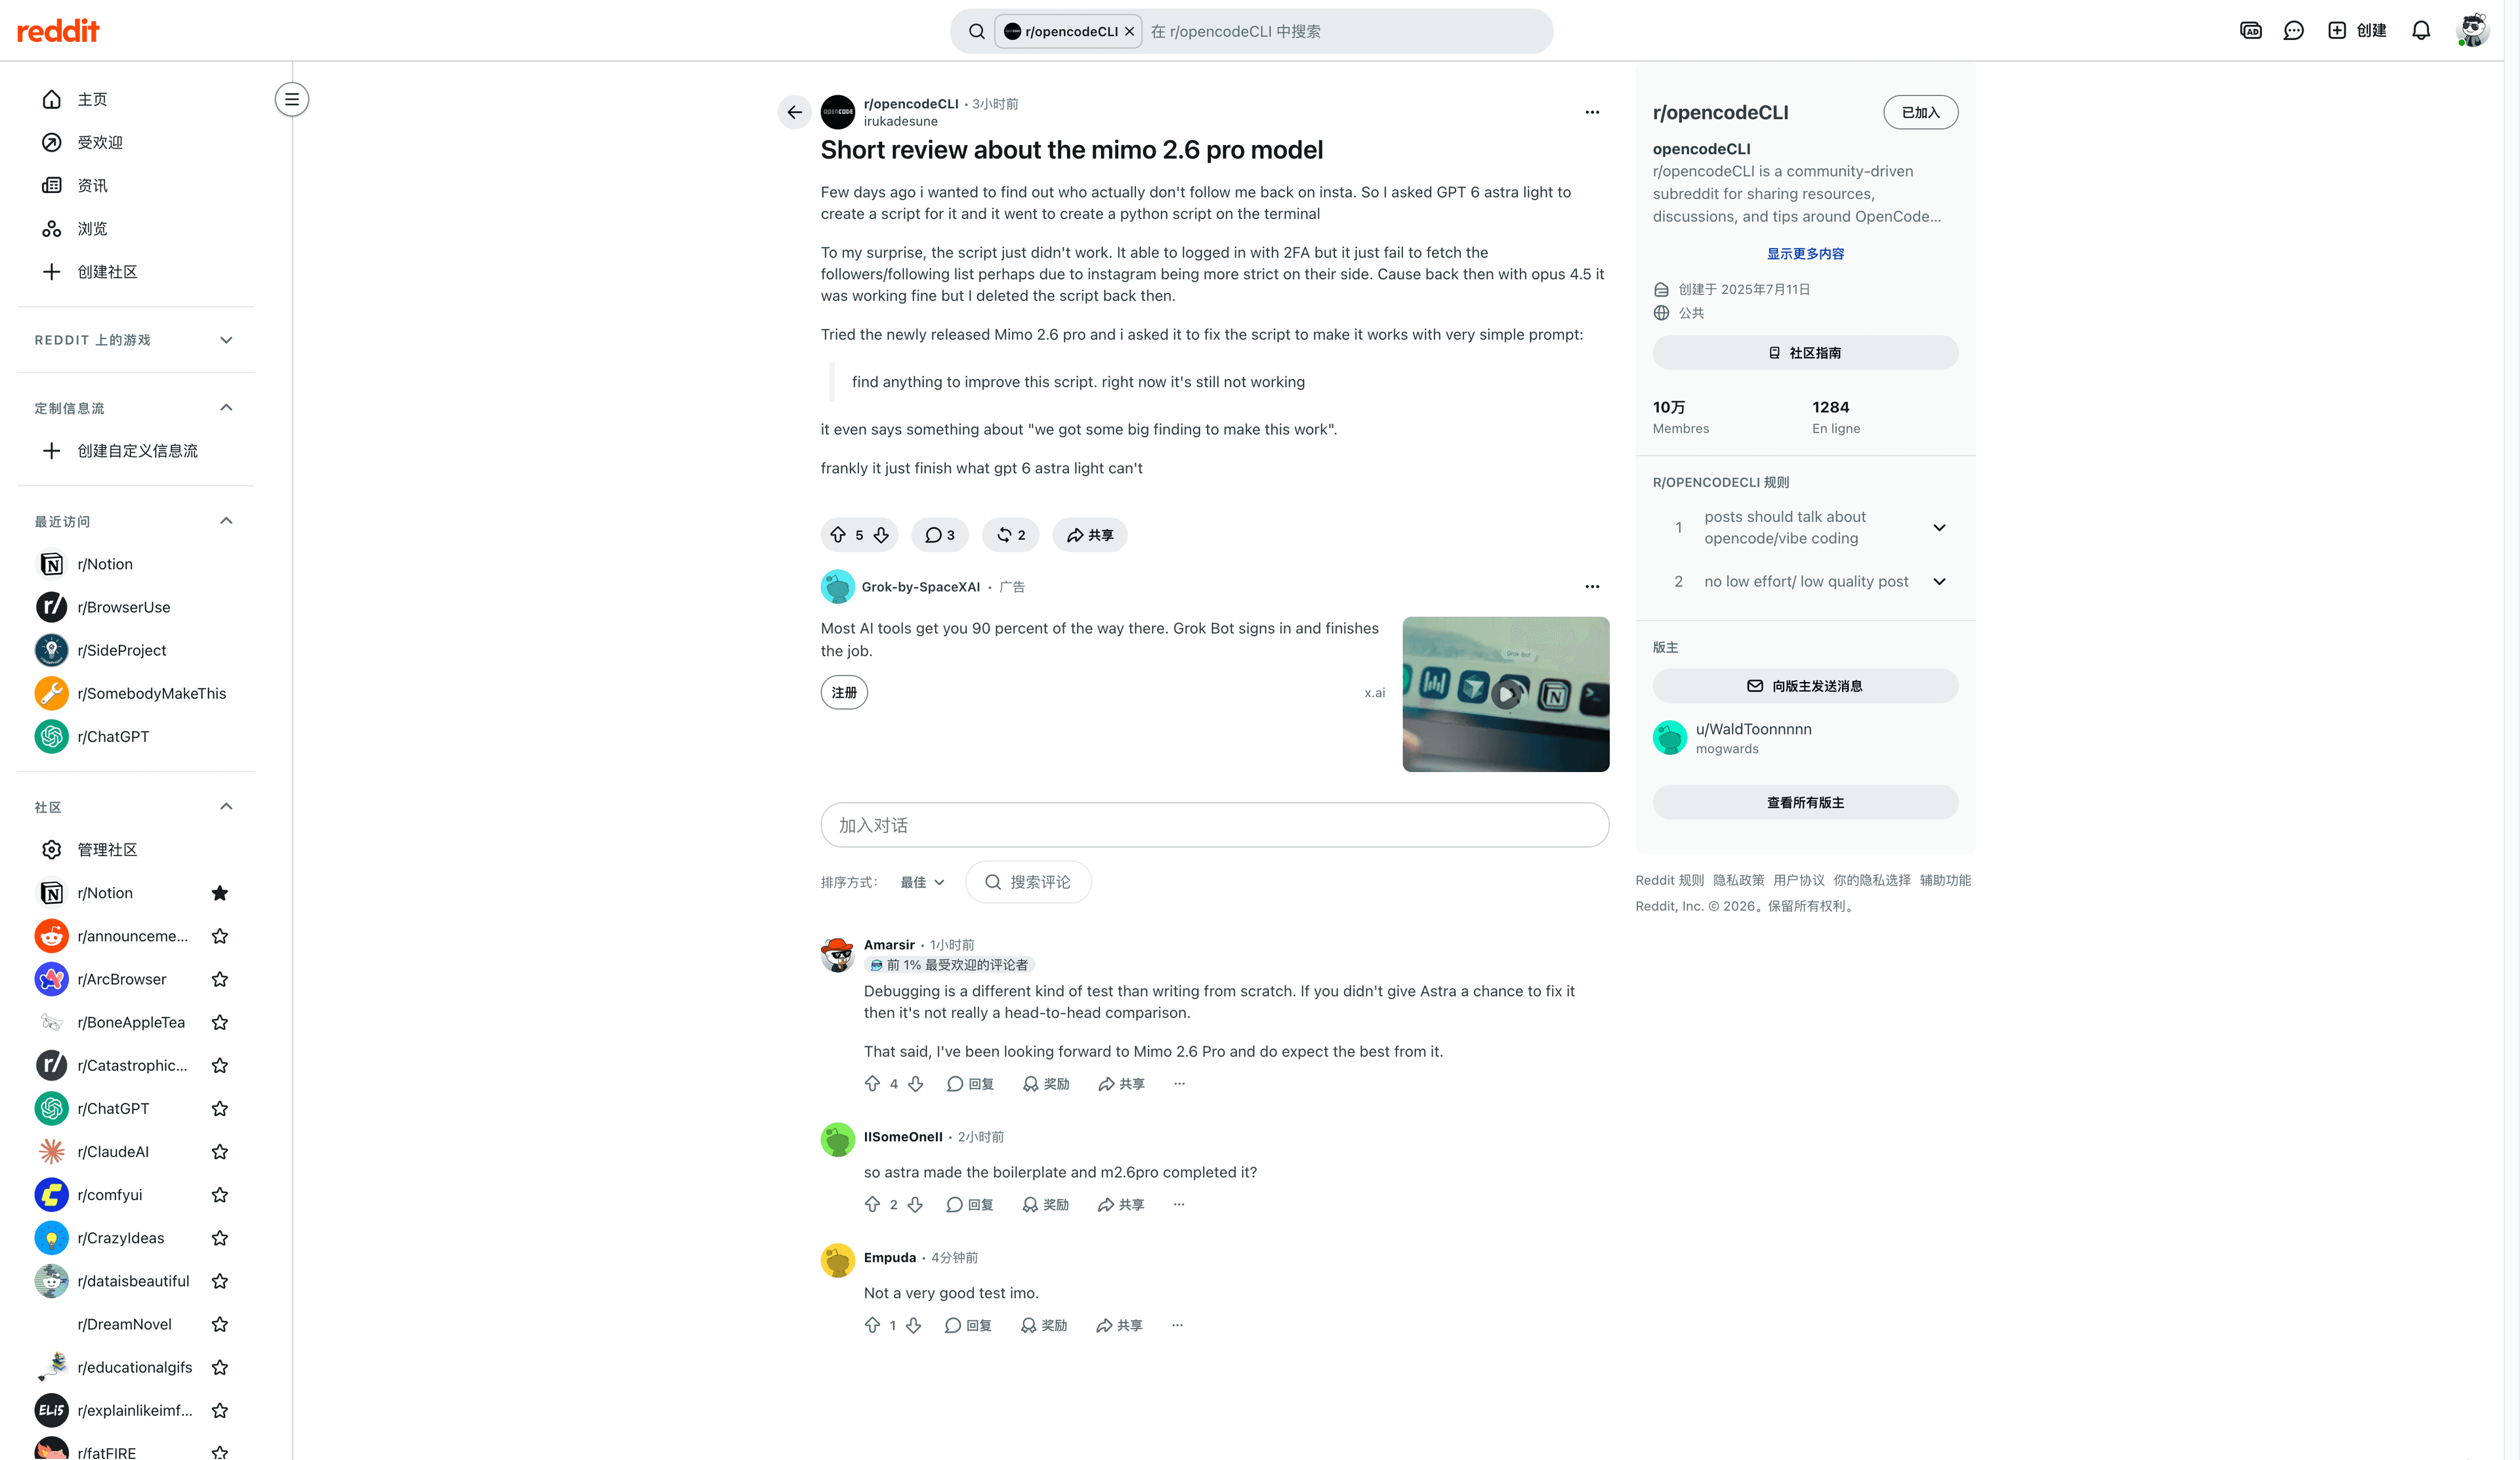
勝った話。 u/irukadesune は Instagram のフォロバチェッカー用 Python スクリプトを持っていました。GPT-6 Astra Light が書き直しても、フォロワー一覧の取得で失敗したまま。MiMo-V2.6-Pro に渡した指示は 1 行だけ:"find anything to improve this script. right now it's still not working." そして直しました。
"frankly it just finish what gpt 6 astra light can't" — u/irukadesune(r/opencodeCLI、2026-09-22。訳:白状するに、GPT-6 Astra Light が終わらせられなかったことをやり遂げた)
冷水を差した返信。 スレッドのトップ返信は、この話が何を証明できて何を証明できないかを指摘します:
"Debugging is a different kind of test than writing from scratch. If you didn't give Astra a chance to fix it then it's not really a head-to-head comparison." — u/Amarsir(同スレッド。訳:デバッグとゼロからの作成は別種の試験。Astra に直す機会を与えなかったなら真の比較ではない)
負けた話。 u/choiyoh は同じ Web サイトの UI/UX 変更を MiMo-V2.6-Flash と MiMo-V2.6-Pro に、ターミナルのコーディングハーネスで任せました。両方とも grep ループに入り、進展なし。
"for 30 minutes no code was fixed." … "DS 4.1 Flash is still much better.." — u/choiyoh(r/CommandCode、2026-09-22。訳:30 分間、コードは一行も直らなかった……DS 4.1 Flash の方がずっといい)
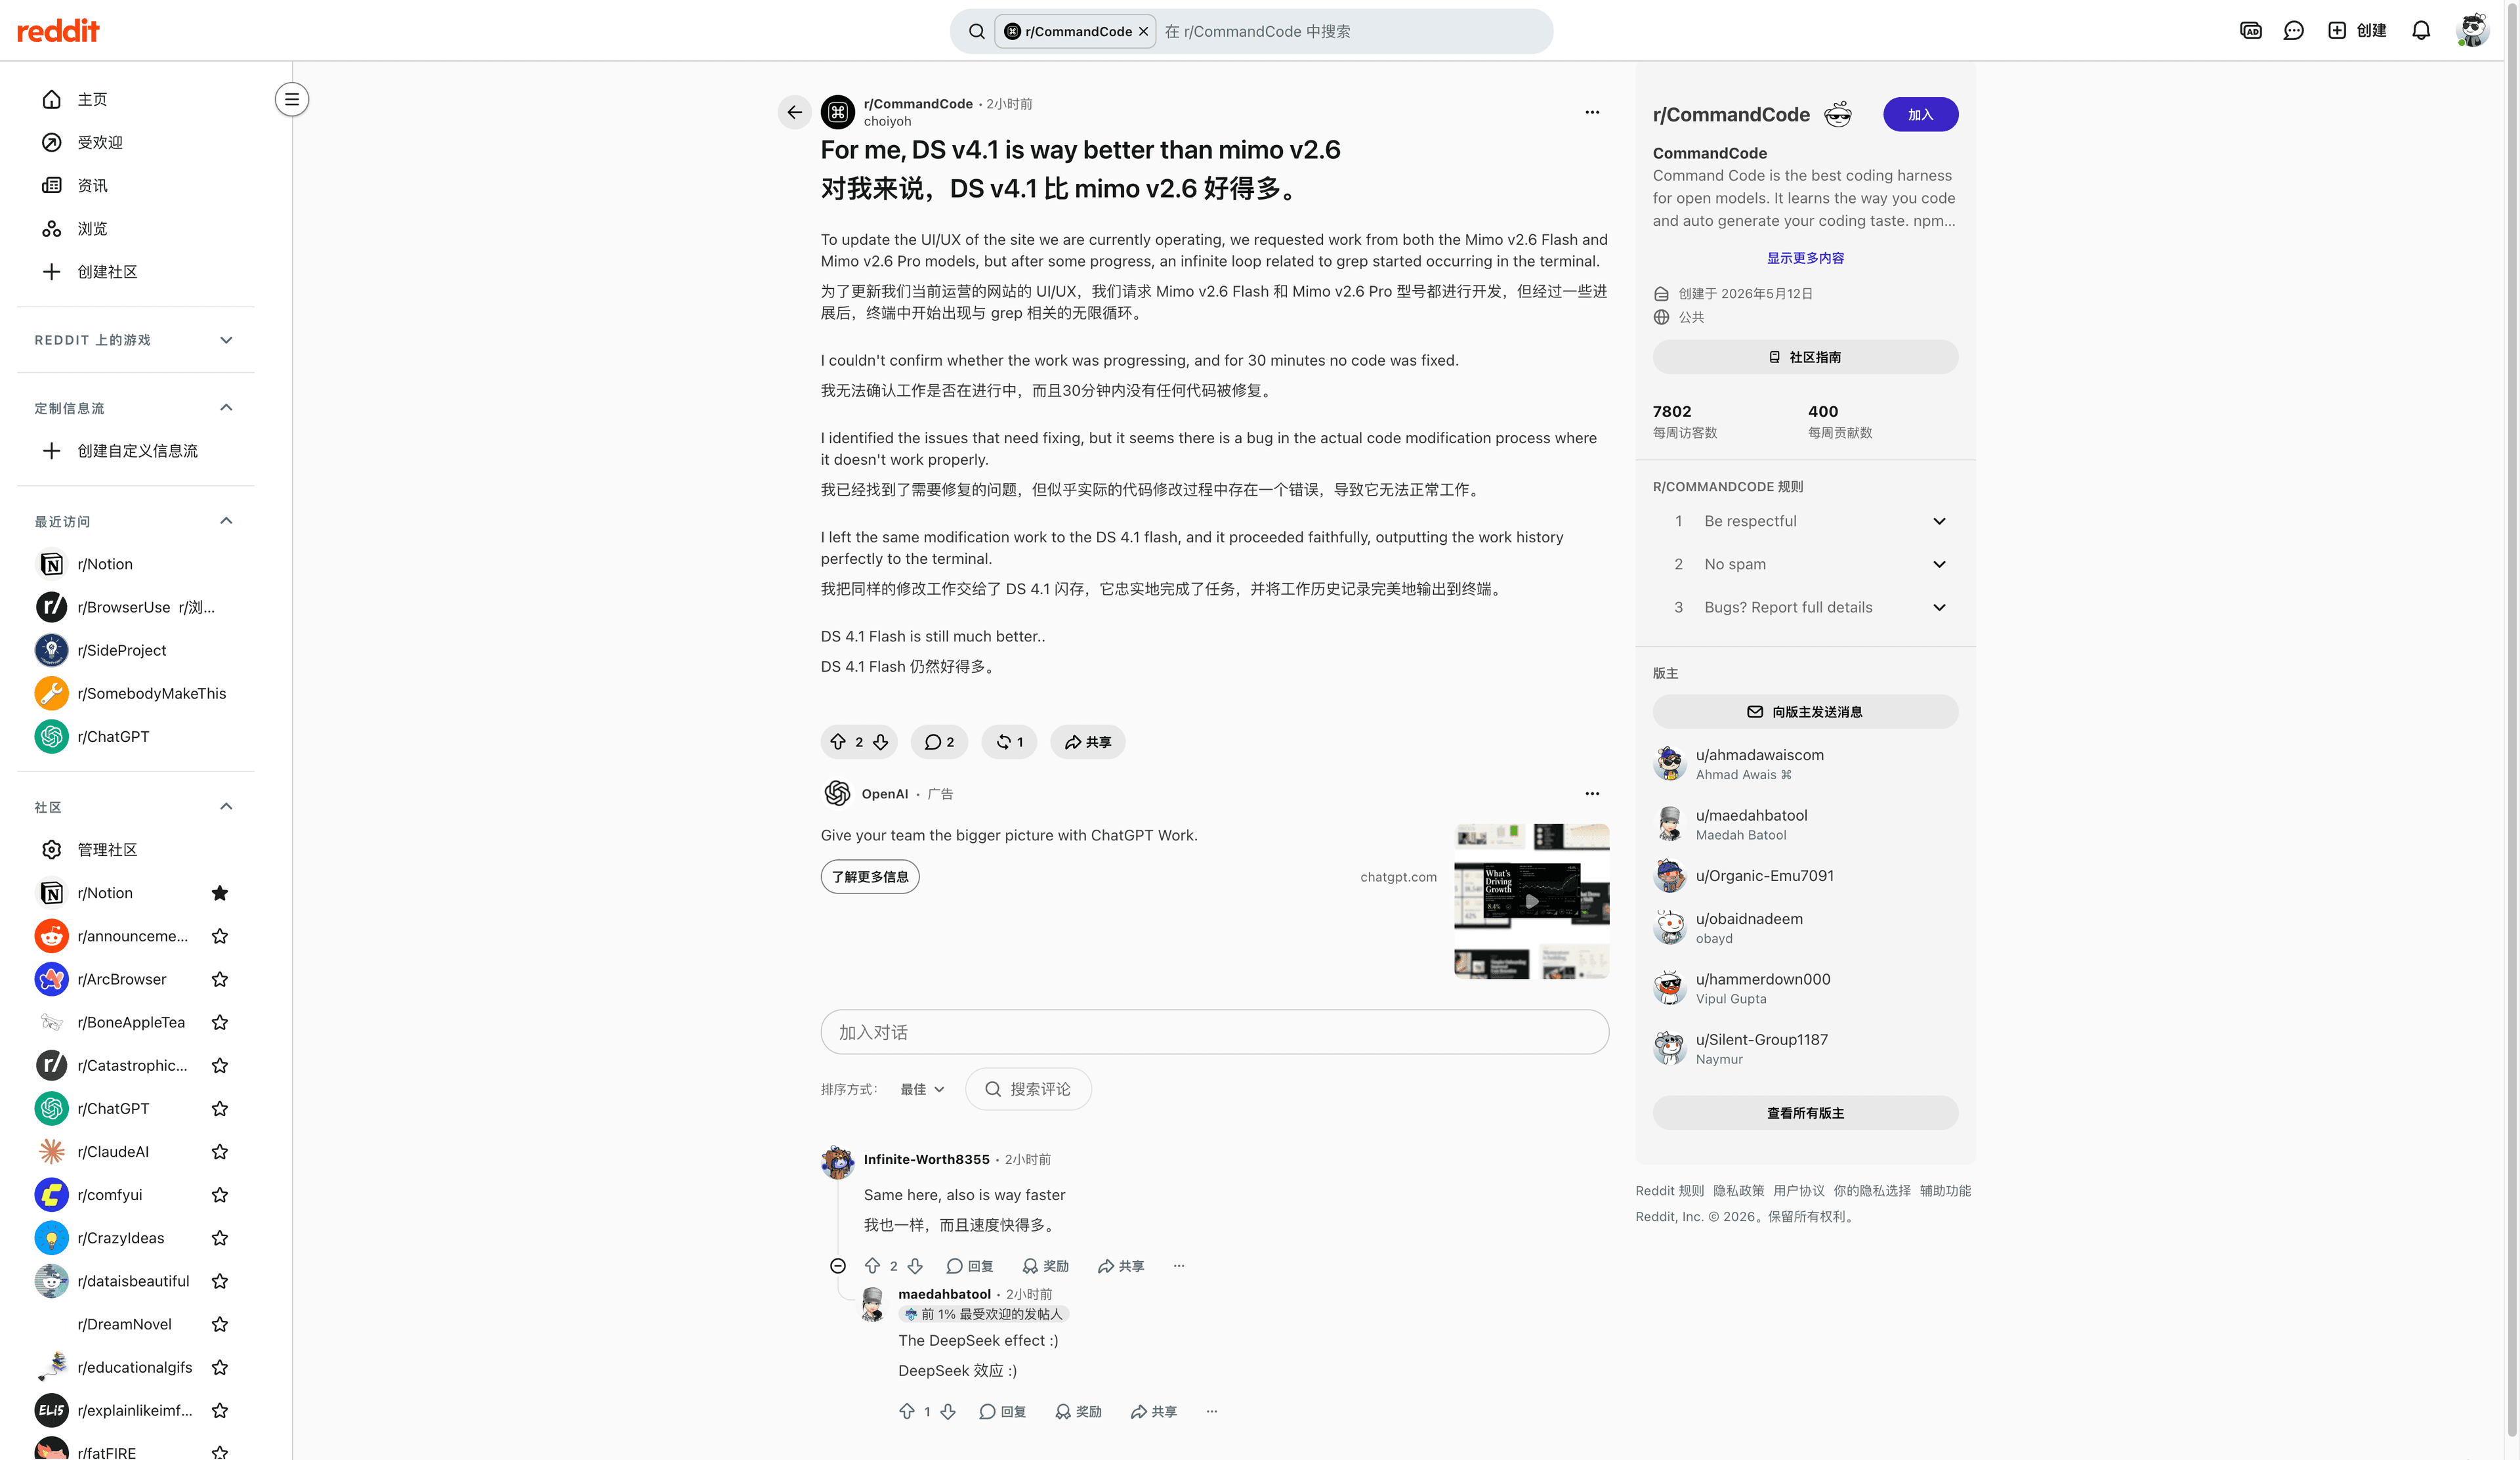
各 1 回の実行。ログなし、リポジトリなし、トークン数なし。両方の結果——競合に勝ったデバッグ修正と 30 分のツール空回り——が実在することと、それぞれの頻度がわからないことだけが言えます。ここを埋めるのがベンチマークの仕事なはずです。実際どれだけ埋めたのか見てみましょう。
ベンチマークと、その信頼度
Xiaomi の技術レポート(Table 3、ベンダー報告値、2026-09-22 確認)は Pro を自社ファミリーと 3 つのクローズドフロンティアと比較しています。数値は報告どおり、- は未提供:
| ベンチマーク | MiMo-V2.6-Pro | MiMo-V2.6-Flash | MiMo-V2.5-Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| Agents' Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| MiMo Visual Coding(自社) | 72.3 | 71.5 | - | 70.0 | 73.4 | 69.1 |
ここから冷水を 3 勺。
測定条件は薄い。 レポートが出すのは集計スコアのみ。設問ログ・プロンプト・乱数シード・サンプル数・信頼区間はありません。3 行(MiMo Code Bench、MiMo Cyber Bench、MiMo Visual Coding)は Xiaomi 自社ベンチ。広く引用される「DeepSWE 58.4 → 72.6」は同一 RL 実行内の学習曲線変化(約 30 ステップ、262 万ドルの計算資源)であってモデル対モデル比較ではありません。公式発表ページの「多くの Agent ベンチマークで Claude Opus 5 と GPT-5.6 Sol と同等」はポジショニング。「1/20〜1/60 の価格」は比較集合とトークン計上の条件を示していません。
コミュニティは訓練期リーダーボードを原則信用しません:
"We'll see how it works on real code. DeepSeek-V4.1-Flash was technically a lot more capable than GLM-5.3-Flash but it's worse in the real-world … The benchmarks don't care if it's a code spaghetti." — u/lilian_moraru(r/LocalLLaMA、2026-09-22。訳:実コードで見てみよう……ベンチマークはスパゲッティコードかどうか気にしない)
"i mostly care about roleplay so those benchmark wins dont mean much if it still forgets details after a few messages." — u/Pure-Summer2818(同スレッド。訳:数回のやり取りで細部を忘れるなら、ベンチの勝利に意味はない)
独立ソースが裏付けるのは形であって精度ではない。 Artificial Analysis は自前のハードで 46(v4.3.2、10 評価)。Arena の Code Arena WebDev 行は AutoEval 1628(+18/-18)で Rank と Votes は N/A——ブラインド投票のリーダーボード上のスクリプト結果であり「N 位」とは書けません。冒頭の Amarsir の方法論的指摘はすべての行に適用されます:デバッグは創作ではない、ある 1 つのハーネスはあなたのハーネスではない、方向性シグナルは物差しではない。
冷水をかけても残るもの:V2.5-Pro との差(DeepSWE 19.0 → 71.9)は端数の誤差では説明がつかない規模。そしてレポートのハーネス移行実験(4 つのミニハーネスで訓練し、 unseen の Codex・Claude Code・mini-swe-agent で合格率約 50% → 66%)は実運用に近い証拠です。ただし何行も「あなたの成功率」として読まないでください。
MiMo-V2.6-Pro が本当に強いところ
最大の意外性は文章力
コーディングモデルがまず文章を褒められることは稀です。発売当日の最大の称賛は長文ロールプレイ作家から——これは繰り返しパターンを最も厳しく罰するユーザー層です。
"honestly I'm really enjoying it for RP so far. The responses have been surprisingly good, especially when it comes to keeping the flow of a scene going and actually giving me something interesting to work with instead of falling into the usual repetitive RP patterns." — u/Electrical_Mode_2489(r/SillyTavernAI、47 アップ。訳:RP が本当に楽しい。場面の流れを保ち、定型の反復に陥らず面白い引き出しをくれる)
GLM 5.3 と並べて比較した別の作家は会話と抑制を評価しました。モデルが "set[] up to ask about 'twink' LATER instead of shoehorning it in right then and there"(訳:その場で押し込まず、後で聞く伏線を張った)。文章で飯を食っている人——フィクション、マーケティングコピー、長編インタラクティブ物語——にとって、この向上はどのコーディングスコアより重要かもしれません。
ただし限界:趣味の問題です。同じ比較スレッドで u/Probablynotsocool は GLM 5.3 を好み("Felt more immersive and crafty")、MiMo の語り口を "like a book … in a roleplay it can get tiring"(訳:本を読むようで、RP では疲れる)と評しました。熟練ユーザー 2 人が同じ出力に正反対の判定。
自動化とツールワークフローは紙面でフロンティア超え
ここではベンチの形が本当に MiMo に有利です。AutomationBench v1.0.6:53.1 で Claude Opus 5(50.3)と GPT-5.6 Sol(45.8)を上回る。Toolathlon-Verified:76.9 で Opus 5 に 3 点差、Sol より上。Terminal Bench 2.1:89.9 で比較セット最高。JobBench 62.0 は GPT-5.6 Sol(45.4)の約 1.4 倍。
これらの行の背後にある工学的詳細が導入には重要です:RL 段階は 4 つのミニマルハーネスで訓練し、unseen の 3 ハーネス(Codex、Claude Code、mini-swe-agent)で移行を確認しました。自社ハーネスでしか動かないモデルはデモであり、移行できるモデルがインフラです。多段ツールループ——ブラウザエージェント、CI 修正、社内自動化——を組む人にとって、これが試用の最有力理由です。
コモディティ価格のフロンティア級知能、MIT 重み付き
2026-09-22 確認の Artificial Analysis スナップショットで MiMo-V2.6-Pro の指数は 46——Grok 4.7(46)と同等、Claude Opus 5(51)には届かない——ながら比較セットで1 指数タスク最安($0.13)。定価は入力 $0.435 / 出力 $0.87(3.00 / 6.00 元)で、キャッシュヒットは $0.0036 に下がる 120 倍の割引がマルチターンの経済性を変えます(価格の計算はこちら。他のオープン系新型と予算を比べるなら Kimi K3 の価格分解)。
同日デビューの競合とのコミュニティ比較が具体化します:Grok 4.7 に対し MiMo はコンテキスト 100 万対 50 万トークン、約 125 対 42 トークン/秒、MIT 対クローズド、$0.435/$0.87 対 $2/$6——指数は両者 46。制約が「1 ドルでどれだけの能力」なら——バッチエージェント、研究パイプライン、エージェント推論ワークロード——これが今回の価値提案です。
噛まれるところ
思考税:沈黙に 2 回払う
一度は待ちに、一度は請求書に。最初の回答トークンまで 18.17 秒。指数 1 タスクあたり推論約 37,520 トークン対回答 26,756 トークン、すべて出力単価 100 万トークン $0.87 で課金。推論の重いプロンプトでは、思考が総生成量の半分を超えたという報告が並びます——上記「6k and 10k tokens?!」の正体です。
公式の逃げ道は mimo-v2.6-pro-ultraspeed:生成最大 20 倍速、価格はちょうど 10 倍(入力 $4.35 / 出力 $8.70)。予算のある対話型製品には現実的な選択肢ですが、モデルをフロンティア価格帯に引き戻し、最大の魅力を消します。「考えすぎを止める」スイッチは現時点の公式 API 資料にありません(価格分析で計算済み)。
ツールループは暴走する
上記の grep ループはエージェント作業で最も痛い失敗形態です:答えが違うのではなく、答えがなく、メーターは回り続ける。技術レポートは自社訓練インフラで OOM・評価系到達不能・部分ロールアウト失敗を経験したと認めつつ、ベンチ別の統一失敗率は出していません。同じスレッドの別のユーザーも体験を裏付けます("Same here, also is way faster"、比較対象について)。無人実行に使うなら、監督・ツール呼び出しタイムアウト・代替モデルを予算化してください——どんなエージェントブラウザスタックにも同じ規律です。
コンプライアンス・エンドポイント・展開の重さ
スコアに出てこない実務の罠が 3 つ:
データの扱い。 発売当日から、現時点の唯一の稼働エンドポイントは第一者で、コミュニティの理解ではゼロデータ保持(ZDR)準拠ではないという指摘があります:"very interesting, but 2.6 Pro's only endpoint is non-ZDR compliant"(u/total_ty)。返して "How trustworthy is a random tag on a website, honestly? How do we verify none of our data has been retained by the endpoint?"(u/starliteburnsbrite)。オープン重みは第三者ホスティングの到来を意味します("the weights are already up on huggingface")が、今日の現実的なコンプライアンス経路はセルフホストか、規約を読んだプロバイダです。
セルフホストは重い。 1.02T スパース MoE、公式 vLLM 例は
--tensor-parallel-size 8前提。ノートパソコンモデルではありません。マルチ GPU ノードを見積もり、パラメータ表記の細目を先に読むこと。バージョンと価格の漂移。 V2.5 は 2026-10-21 終了。Artificial Analysis の数値は同じ日のうちに測定更新で動きました(17.58 → 18.17 秒)。バージョンを固定し、予算前に再確認を。
実際の人たちは何と言ったか
発売当日の議論は 1 本ではなく 2 本の軸で割れました。
軸 1:驚き派とやけど派。 修正成功と grep 翻車は Reddit 上で 4 時間しか離れておらず、両陣営は即座に満員に。u/irukadesune の 1 行指示が競合旗艦の直せないものを直し、u/choiyoh は 30 分をツールループに失って DeepSeek V4.1 Flash へ移行。熱狂派は同じ証拠から外挿し——"I believe in mimo, mimo will replace GLM as THE rp model"(u/stopaskingforloginn)——懐疑派はログを求めます。
軸 2:価格の驚き派と思考請求派。 発表スレッドの第一衝撃は経済——"They kept the prices!? It's over."(u/Pink_da_Web。訳:価格据え置き!?他は終わりだ)——そしてトークン数が来ました:
このモデルに最も満足している書き手層ですら、内部で割れています:
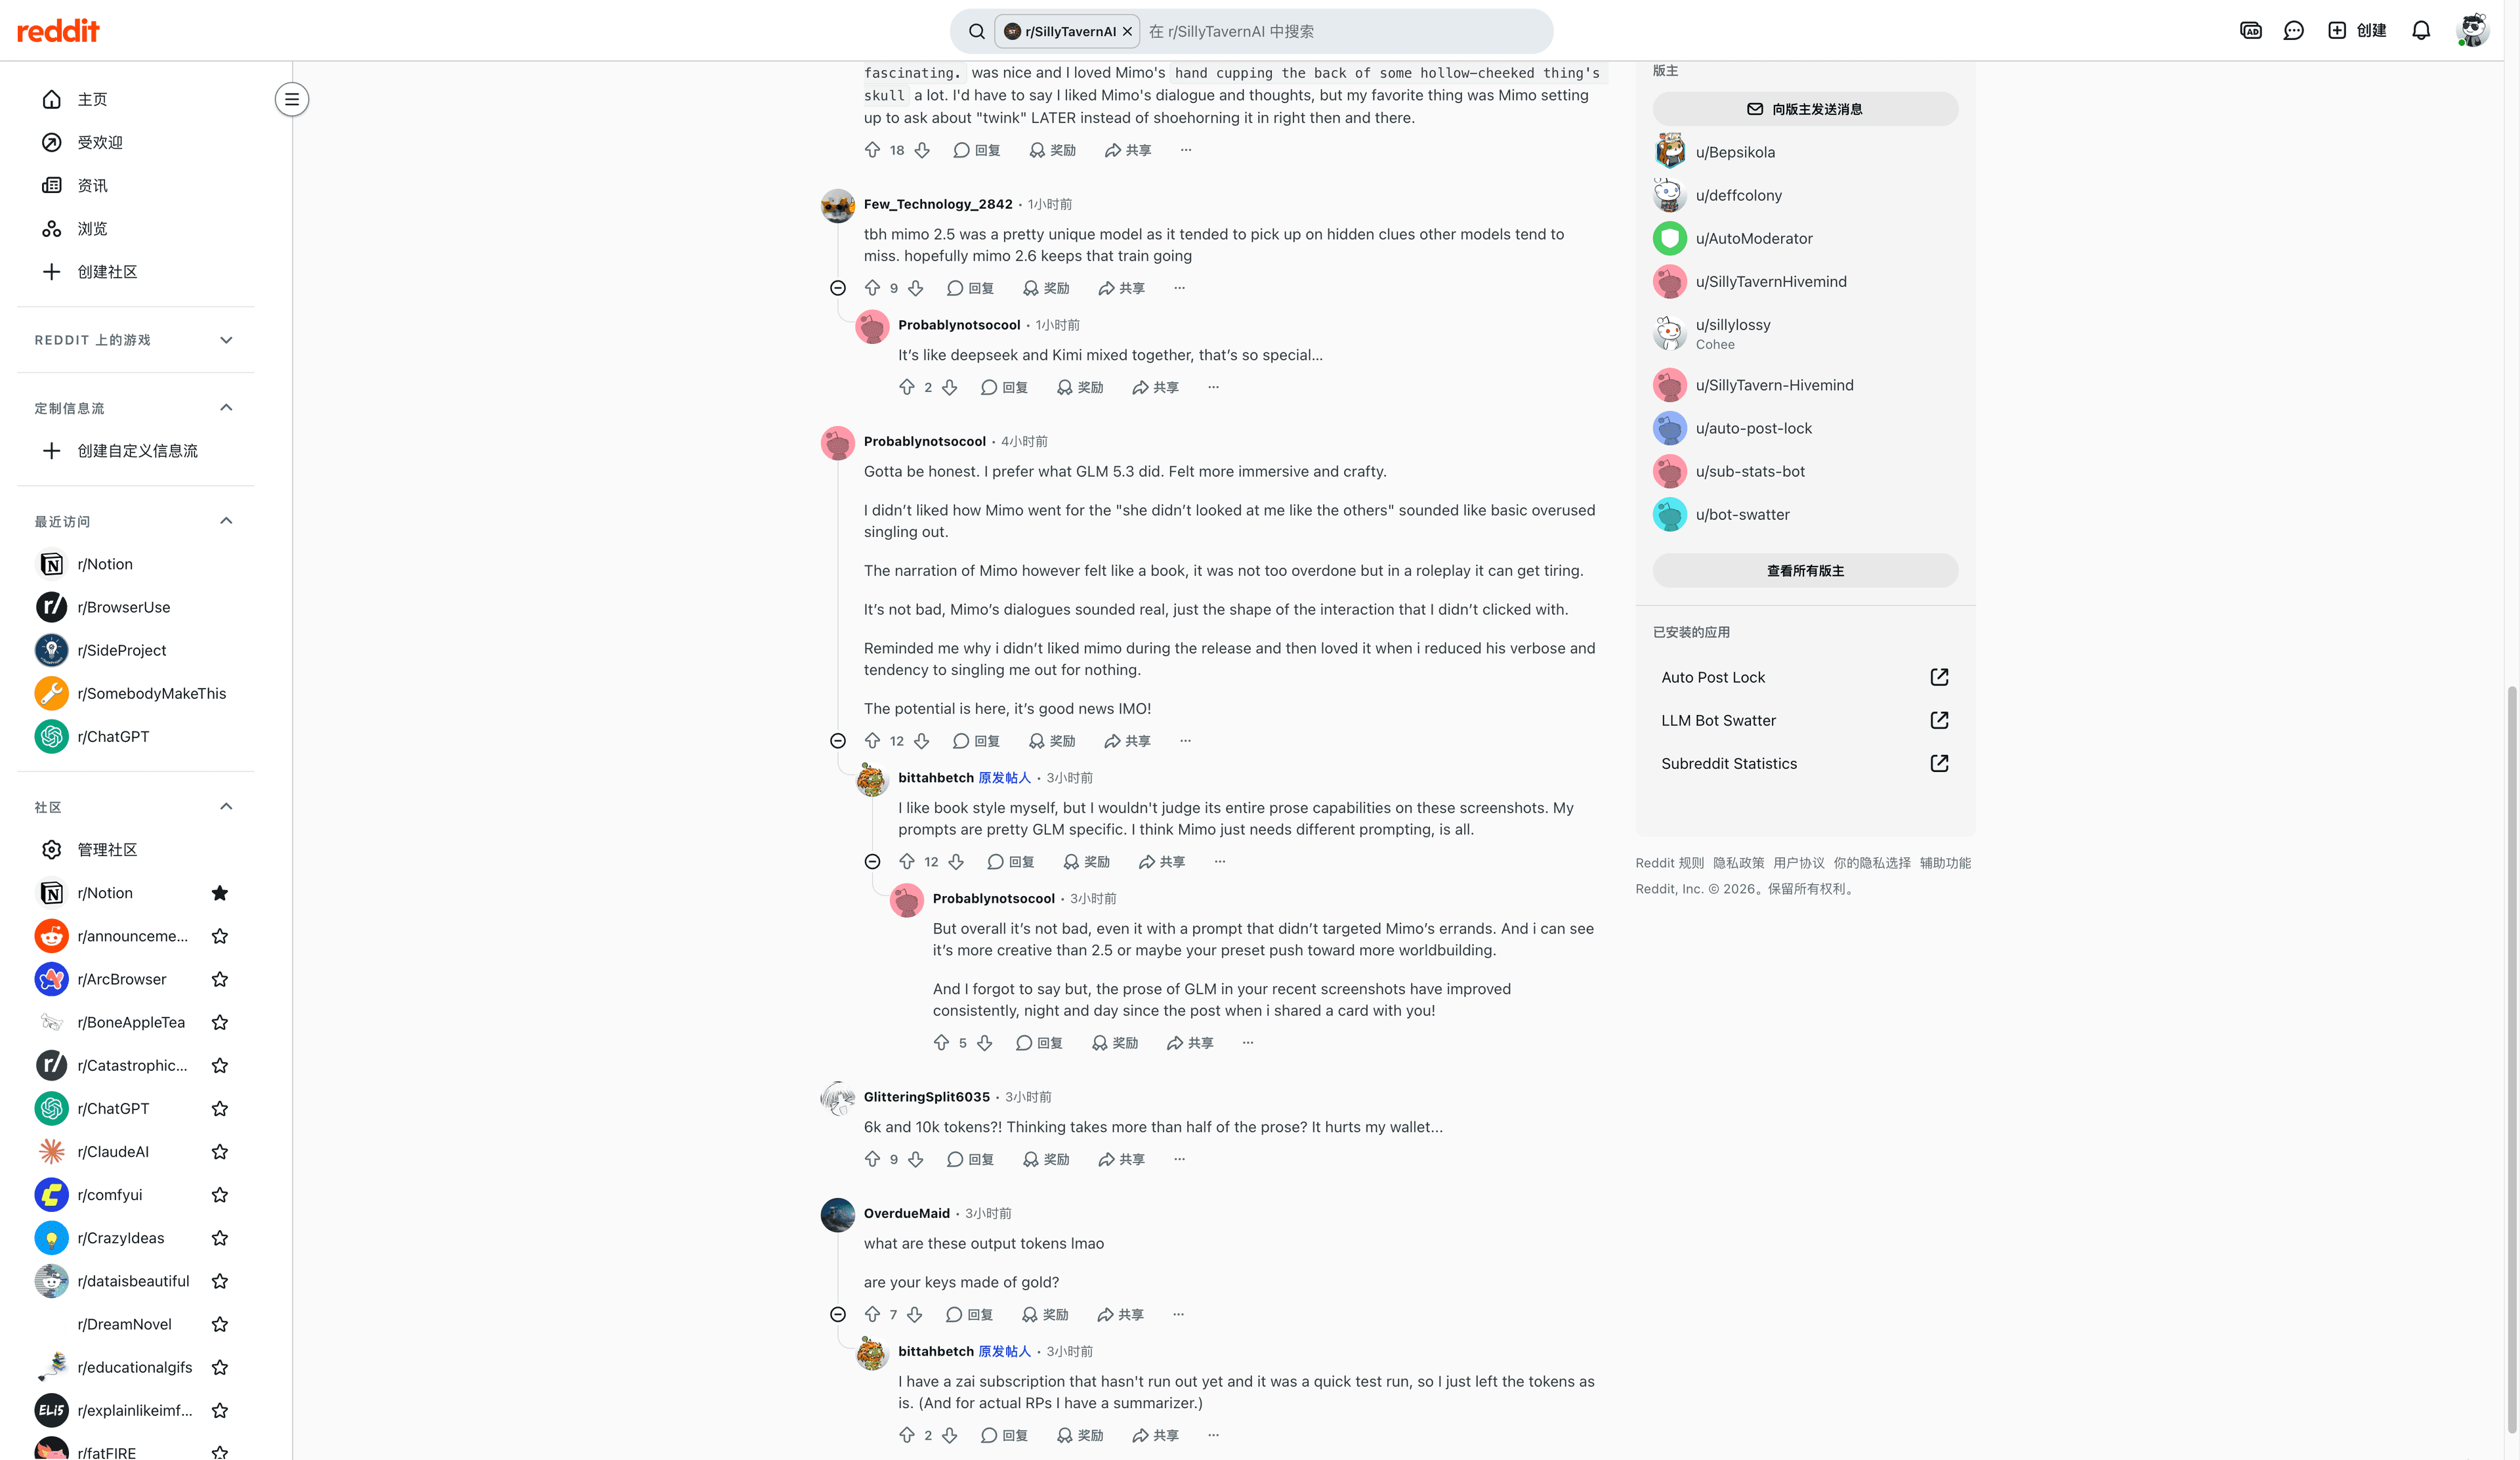
本レビューの着地点:u/Amarsir と同じです——モデルには熱狂、ずさんな比較には我慢ならなさ。9 つの検証済みの声が示すパターンは数字と一致します:能力は本物、待ちと請求の摩擦は本物、ツールループの信頼性は両方向ともまだ n=1。
結論:スコアでなくワークロードで選ぶ
| ワークロードの形 | 結論 | 理由 | 主な留保 |
|---|---|---|---|
| 長時間のエージェントコーディング、バッチ修正、無人ツールループ | 試す価値あり | AutomationBench 53.1 が Opus 5 と Sol を上回る。ハーネス移行の証拠。1M コンテキスト。$0.13/タスクが待ちを薄める | grep 型のループ失敗は実在。実行は監督し、代替モデルを確保 |
| 対話チャット、ロールプレイ、長文執筆 | 条件付きで可 | 文章力の称賛は具体的で繰り返し現れる。1M コンテキストが長場面の整合を守る | 18 秒の初動 + 思考トークンがシーンごとの遅延とコストを同時に押し上げ。GLM 5.3 が好みの作家も |
| PC 操作・ブラウザ自動化 | 有力候補 | OSWorld-Verified 82.0、JobBench 62.0、視覚コーディング 72.3(自社)。オムニモーダル入力 | 証拠はベンダー値が中心。まず自分のタスクセットで検証 |
| 規制データ / 保持ゼロ要件 | まだ不可 | MIT 重みでセルフホストや準拠プロバイダは原理的に可能 | 今日稼働しているのは第一者エンドポイントのみで、ZDR 状態は未検証 |
| 単一 GPU・ノートパソコンでのローカル推論 | 不可 | 1.02T スパース MoE。公式サービング例は 8 レンサー並列前提 | 現実的なローカル選択肢は Flash ファミリーや小型蒸留版 |
時期に関する注意が 2 つ。第一に、Grok 4.7 は同日リリースで Artificial Analysis 指数も 46。コミュニティ比較の結論は "neither one decisively dominates the other"(訳:どちらも決定的に上回れない)。やるべきは自分のワークロードでの比較で、理想は 2 候補の並列回答です。第二に、V2.5 は 2026-10-21 終了。そこに構築しているなら移行計画は選択肢ではなく必須です。
現実的な一本道:働く場所で走らせる
このレビューの全結論は同じプロファイルを指します:待ちは人を傷つけエージェントは傷つけない。思考トークンはおしゃべりな単発ターンを罰し、持続的な長ランに報いる。ツールループのリスクは監督を要求する。このプロファイルは文書の横の小窓チャットとは不釣り合いで、ブラウザ級ワークフロー——ページを読み、100 万トークンのコンテキストを抱え、あなたが別のことをしている間に働く——には合っています。
それが Tabbit Browser の前提とする働き方です。複数ページ調査・抽出・自動化を 1 回のプロンプトではなく agentic browser のタスクとして扱う。正直な境界:今回のレビューでは MiMo-V2.6-Pro が Tabbit のリアルタイムなモデル選択メニューに現在あるかどうかを確認できず、Tabbit でのハンズオン実行は主張しません。どのクライアントのどのモデルの可用性と同じように、計画前に自分のアカウントのセレクタを確認してください。
上記のプロファイルがあなたの仕事と合うなら——長時間ラン、重いコンテキスト、ツール呼び出し、コスト規律——正しい問いは「どのモデルが一番高いスコアか」ではなく「どのモデルが仕事を終わらせるか」。自分の固定タスクセットで 2 候補を 1 周させ、1 ドルあたりに完了した仕事を数えてください。そのテストはこの記事のどのリーダーボード行にも勝ります。
 Tabbit Browser

よくある質問
MiMo-V2.6-Pro は使う価値がある?
完了品質を重視する長時間のエージェントコーディング、自動化、創作系のワークロードなら、十分に試す価値があります。即レスが必要な用途、ゼロデータ保持が検証済みのエンドポイント、単一 GPU でのローカル運用が条件なら慎重に。決める前に少なくとも 1 つの比較対象を並べてください。
MiMo-V2.6-Pro の応答まで何秒かかる?
Artificial Analysis が Xiaomi プロバイダ・1 万入力トークンのワークロードで最初の回答トークンまで 18.17 秒を測定(2026 年 9 月 22 日確認)。待ち時間の後は約 125 トークン/秒で生成するため、遅延の大半は口を開く前の沈黙の思考時間です。
思考トークンも課金される?
されます。Xiaomi は内部推論トークンを標準出力トークンと同じ 100 万トークンあたり $0.87 で課金します。Artificial Analysis の記録では指数 1 タスクあたり思考約 37,500 トークンに対し回答約 26,800 トークン。見えない思考にお金を払う構造です。
Grok 4.7 や Claude Opus 5 と比べると?
2026 年 9 月 22 日確認の Artificial Analysis インテリジェンス指数では MiMo-V2.6-Pro と Grok 4.7 がともに 46、Claude Opus 5 は 51。Xiaomi 社のレポートでは DeepSWE v1.1 が 71.9 対 Grok 4.7 約 73、Opus 5 が 74 で、入力価格は 100 万トークン $0.435 対 $2 と $15 です。
本当にオープンソース?自分で動かせる?
重みは MIT ライセンスで Hugging Face から入手でき、フロンティアモデルとしては公開度が高い方です。ただしご自宅での運用は重い:総パラメータ約 1.02T・有効 42B のスパース MoE で、公式の vLLM / SGLang 例はマルチ GPU 前提。パラメータの集計値はソース間で食い違うため、ハードを見積もる前に checkpoint を確認してください。
Tabbit Browser で MiMo-V2.6-Pro を使える?
Tabbit はアカウントのリアルタイムなモデル選択メニューからブラウザ級の AI ワークフローを実行します。今回のレビューではその選択メニューに MiMo-V2.6-Pro が現在あるかどうかを確認できませんでした。計画を立てる前に自分のセレクタとアカウント規約を確認してください。