
Gemini 4 Carbon 可作為高難度、長流程任務的受控試用候選,但公開資料無法證明它適合所有工作,也未證明它最適合你的任務。Google 將 Carbon 定位為處理最難任務的模型,並表示 Argon 仍適合多數軟體工程與知識工作。模型卡包含不同任務及測試環境,應逐項解讀,不能換算成通用成功率。
使用者回報
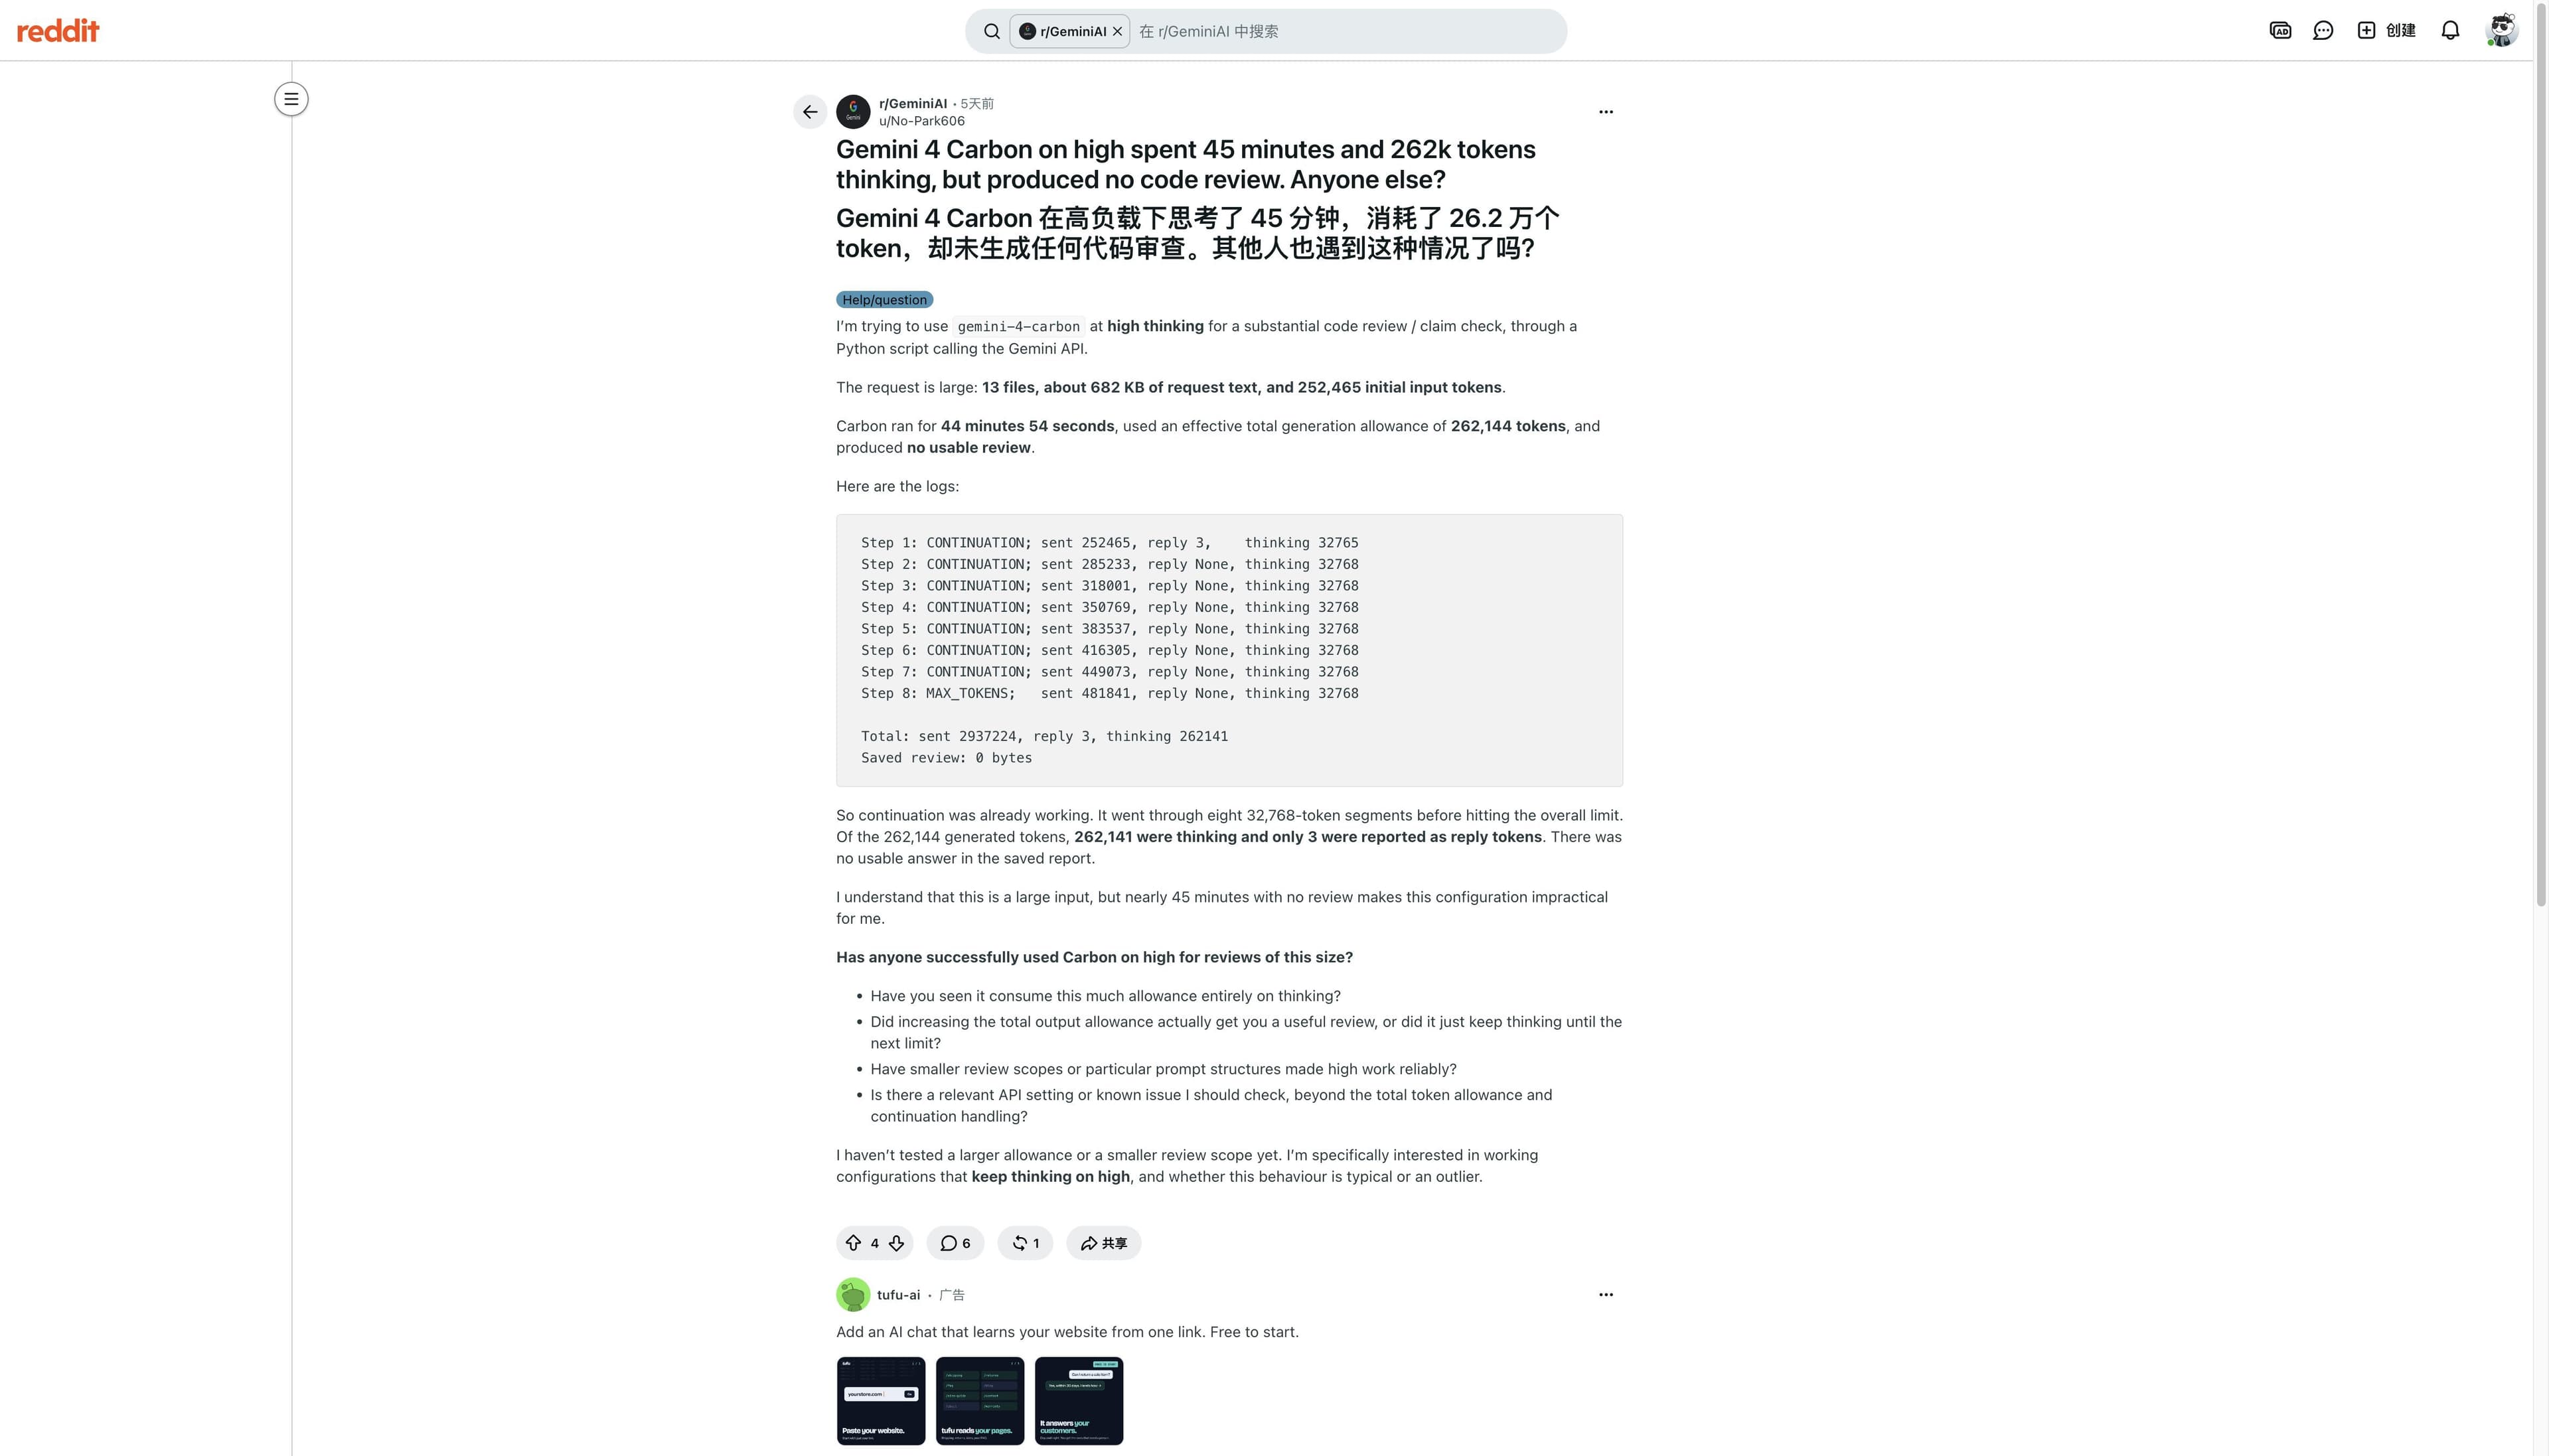
一位 Reddit 使用者表示,Carbon 在高思考設定下審閱 13 個檔案約 45 分鐘,耗用 262,141 個思考 token,卻沒有產生可用審閱。這是單一設定下的一次失敗,不代表通用可靠度。截圖保留作者的任務描述與頁面顯示數據。查看原文。
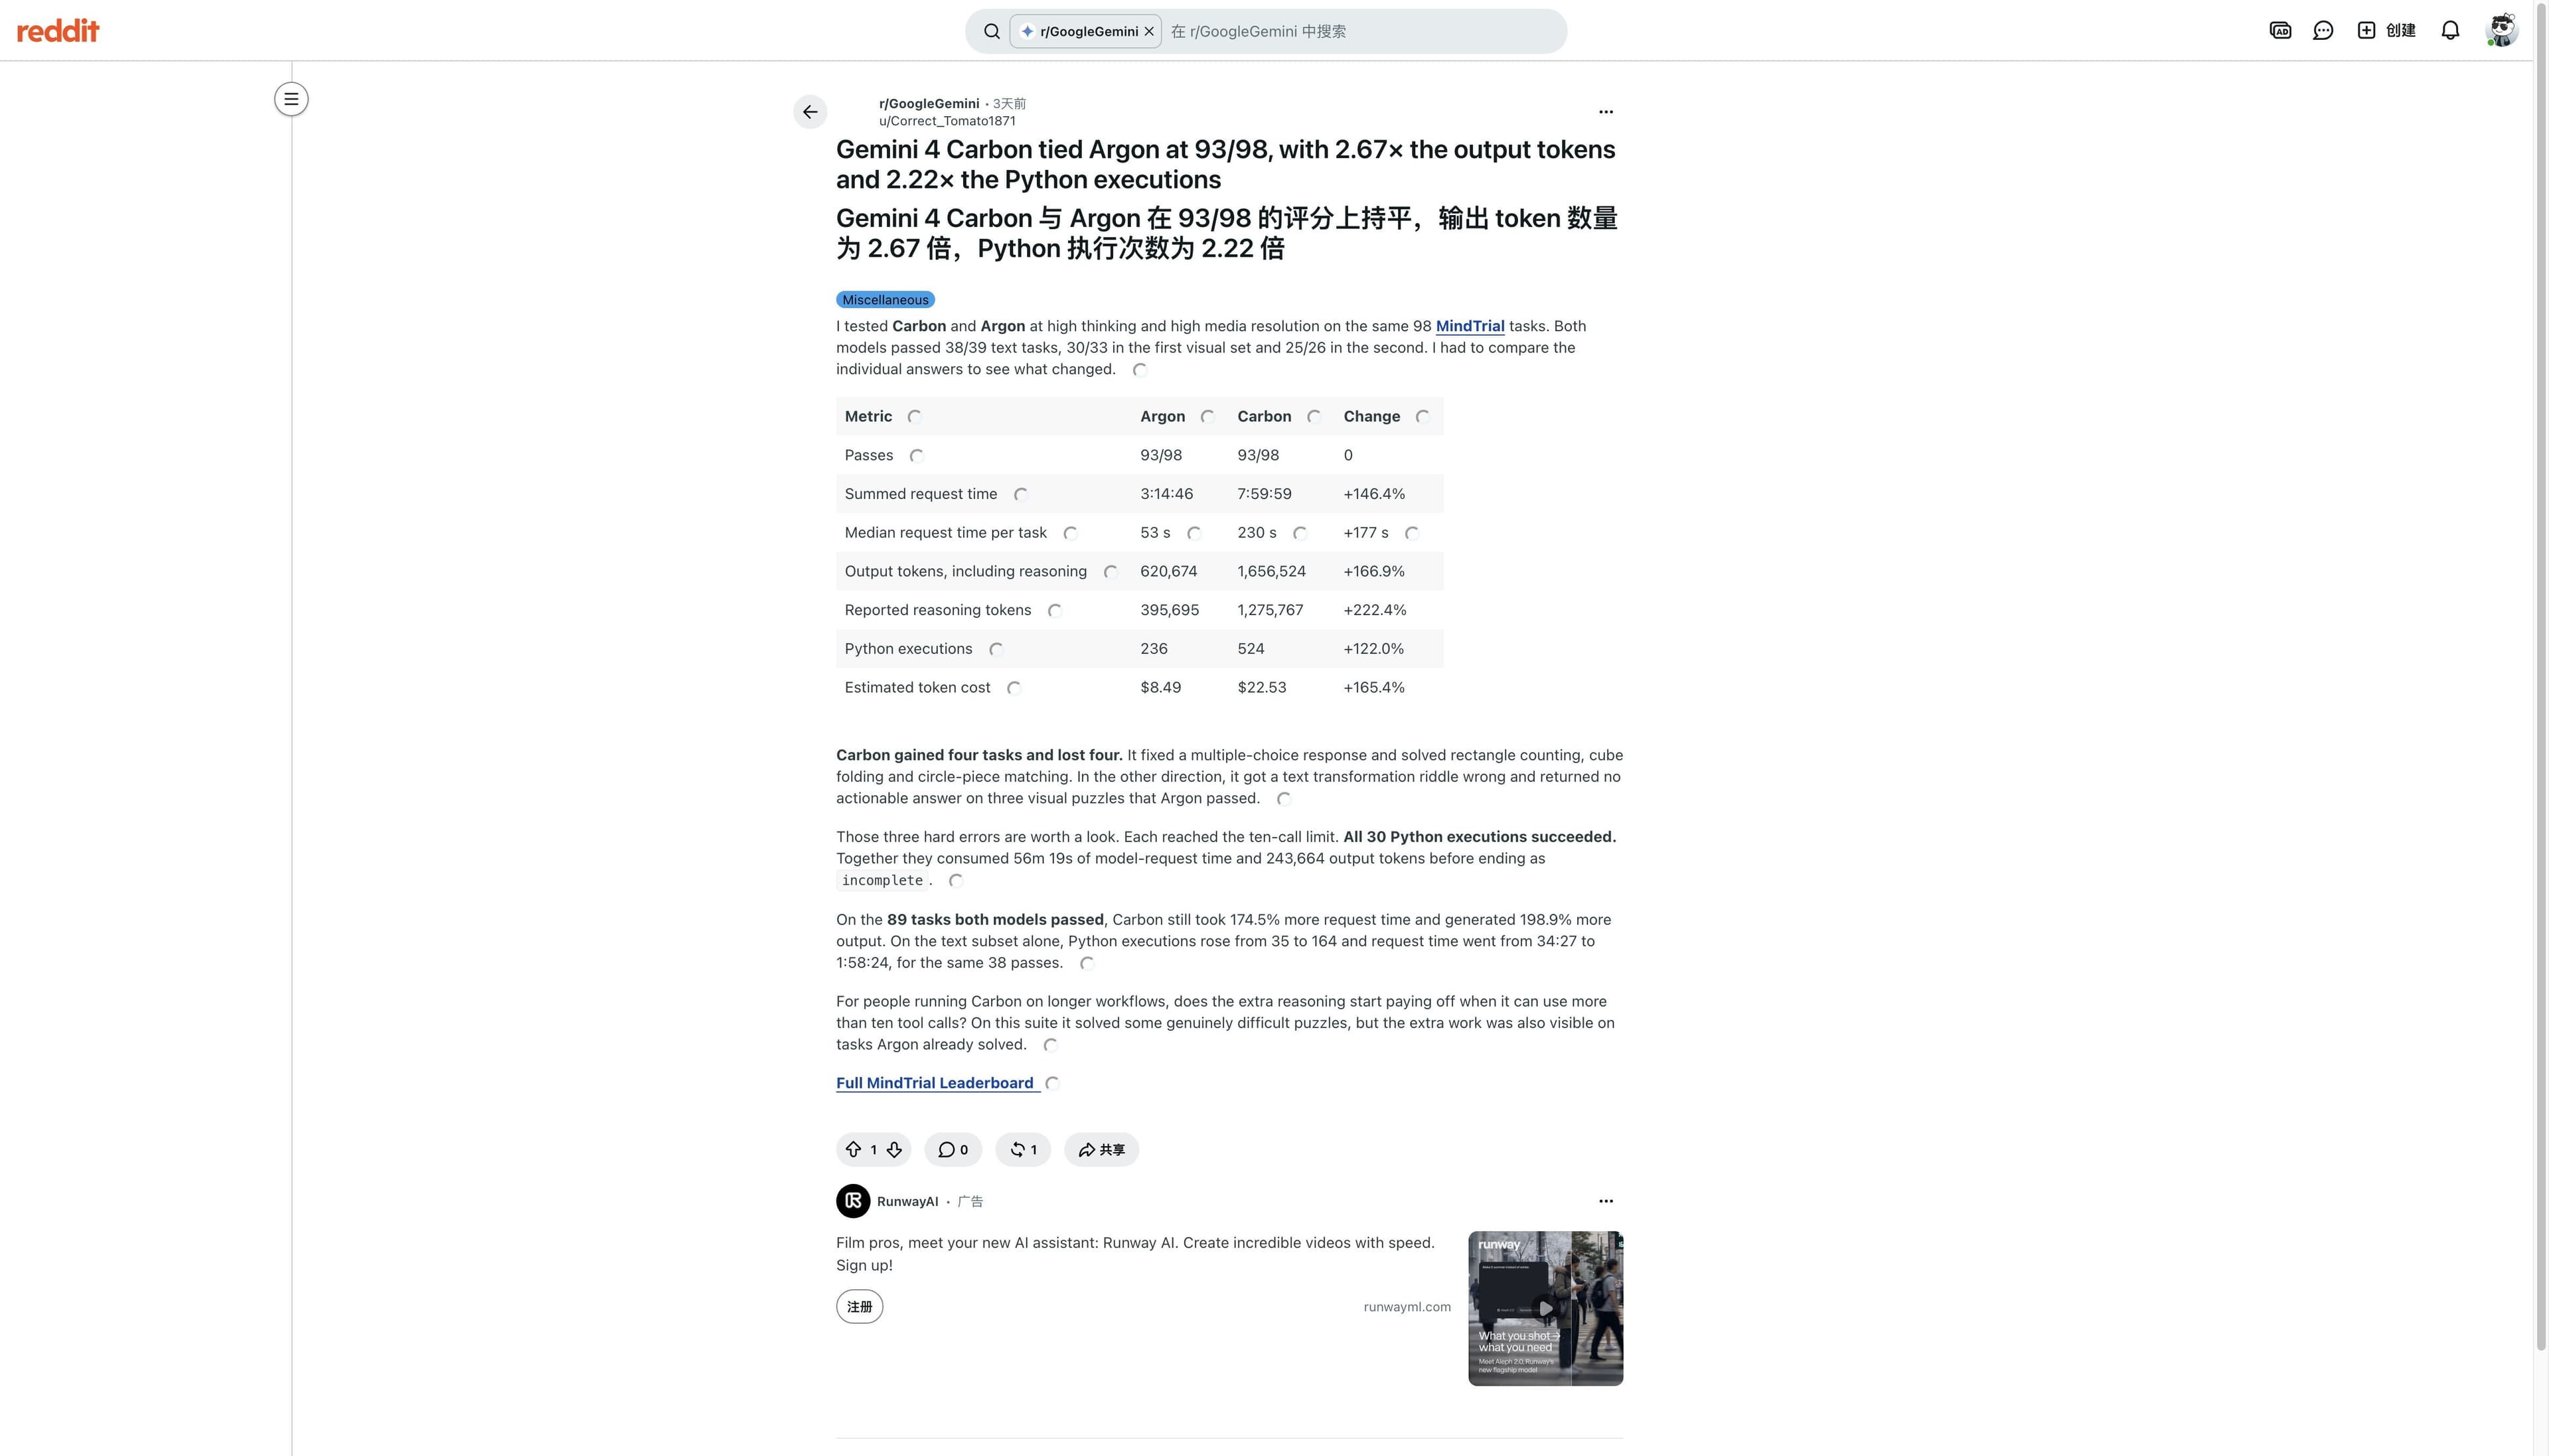
另一位 Reddit 使用者以 98 道 MindTrial 任務比較 Carbon 與 Argon,回報兩者皆為 93/98;Carbon 輸出 token 多 2.67 倍、耗時 2.46 倍,作者估計費用為 $22.53 與 $8.49。這是自述資料,可用來設計每個通過任務的成本測試,不能視為獨立重現。查看原文。
評測結論
Google 將 Carbon 定位為最困難、長流程任務的模型;這是考慮試用的理由,不是獨立推薦。
模型卡列出不同基準結果;版本、測試工具與任務範圍比單一總分更重要。
Google 提到高思考設定會增加 token 用量,也揭露延遲、逾時與幻覺風險;未提供通用成功率。
使用者回報顯示任務差異很大;本文沒有經查證的 Tabbit Carbon 實測或重複對照測試。
實用決策表
| 任務 | 資料支持什麼 | 尚未證明什麼 | 下一步檢查 |
|---|---|---|---|
| Vendor benchmarks | Model card names task, harness and score | General reliability on your workload | Reproduce a benign task |
| User reports | Individual Reddit/X experiences | Population-level result | Keep prompts and settings attached |
| High-thinking work | Vendor notes higher token use and possible latency/timeouts | Fixed quality-per-dollar advantage | Measure tokens and accepted output |
把結論轉成任務測試
試用前先寫下合格答案的標準。使用唯讀輸入與無害輸出,以相同上下文和評分規準重複任務。記錄正確性、遺漏、耗時、輸入/輸出 token 與費用。出現錯誤時,區分模型、提示與來源材料的問題,不要在不同模型間暗中改變任務。
Google 的 Carbon 模型卡列出多項結果,包括 Terminal-Bench 4.0 (AA) 65.2%、Agents’ Last Exam v1.1 為 77.4,以及特定 256k–1M BFS 設定的 GraphWalks F1 96.2%。這些屬於不同評測。Artificial Analysis 目前標示指數版本 v5.0.1,Google 卡片快照為 v5.0;不能把 59 與「最高 60」解讀成明確的前後提升。
| Evidence | What it can tell you | What it cannot tell you |
|---|---|---|
| Vendor benchmark | Performance on named task and harness | Your production success rate |
| Community task report | A person’s experience under their own setup | Independent replication or average cost |
| Your pilot | Fit for the chosen task and rubric | All future prompts or account configurations |
Carbon 已公開推出,但可用性取決於產品與帳戶。Google 公告列出開發者和企業可透過 Gemini API、AI Studio 使用,消費者則可在 Ultra 版 Gemini 應用程式使用。請檢查實際要用的產品選單和計費頁面。
Tabbit 適合放在哪一層
Tabbit 是瀏覽器與工作流程層,不能證明 Carbon 本身能操作已登入的瀏覽器。現有 Carbon 瀏覽器使用指南說明模型存取與本機瀏覽器執行的差異。本文沒有報告 Tabbit Carbon 基準或 Carbon 實測;上方測試僅是方法,不是結果。
若要進行可重複的證據工作,可看多模型研究紀錄、具來源的瀏覽器研究、深度研究方法及成功任務成本框架。
若要在瀏覽器工作流程中測試 Carbon,請透過Tabbit CLI 指南、連接現有瀏覽器步驟、首個任務清單、本機自動化指南與代理式瀏覽器說明區分模型存取與本機執行。
解讀基準分數時保留測試設定
模型卡必須將分數與任務名稱、版本、測試工具及輸入條件放在一起,才有參考價值。長上下文圖形任務的高分,不能證明 Carbon 能準確瀏覽企業帳戶;程式基準也不衡量引用品質。廠商測試可協助挑選試用場景,社群貼文則會提出 token 用量、逾時等實際問題,但兩者都不能取代針對驗收結果的重複測試。更有用的問題不是「Carbon 好不好」,而是「Carbon 能否依我們的標準完成這項明確任務,且成本與延遲可接受?」
把公開證據視為測試起點,而不是對你工作結果的保證。投入敏感資料或固定預算前,先確認目前模型、帳戶條款與實測結果。

常見問題
Gemini 4 Carbon 值得試用嗎?
若帳戶能選擇此模型,可針對一項困難任務進行有範圍的試用。公開證據無法證明它適合所有工作。
基準分數能預測我的結果嗎?
不能。分數取決於任務、測試工具、模型版本與設定。可用來提出測試問題,再測自己的任務。
模型卡有揭露限制嗎?
有。它提到高思考設定會用更多 token,也指出延遲、逾時與幻覺,但未提供通用失敗率。
Carbon 能瀏覽我已登入的頁面嗎?
模型本身不會控制瀏覽器。瀏覽能力取決於獨立的本機宿主、連接器、帳戶與獲授權的網站工作階段。
如何評估試用結果?
使用無害任務、固定輸入、評分規準並重複執行。擴大使用前檢查事實、遺漏、時間、token 與成本。