
Gemini 4 Carbon は難しく長いタスクの限定的な試用候補ですが、公開情報からあなたの業務に最適とは判断できません。Google は最難関の作業に Carbon を位置づけ、ソフトウェア開発や知識労働の多くには Argon が適すると説明しています。モデルカードには異なる課題・評価環境の結果が並ぶため、一般的な成功率としてまとめず個別に読みます。
ユーザーの報告
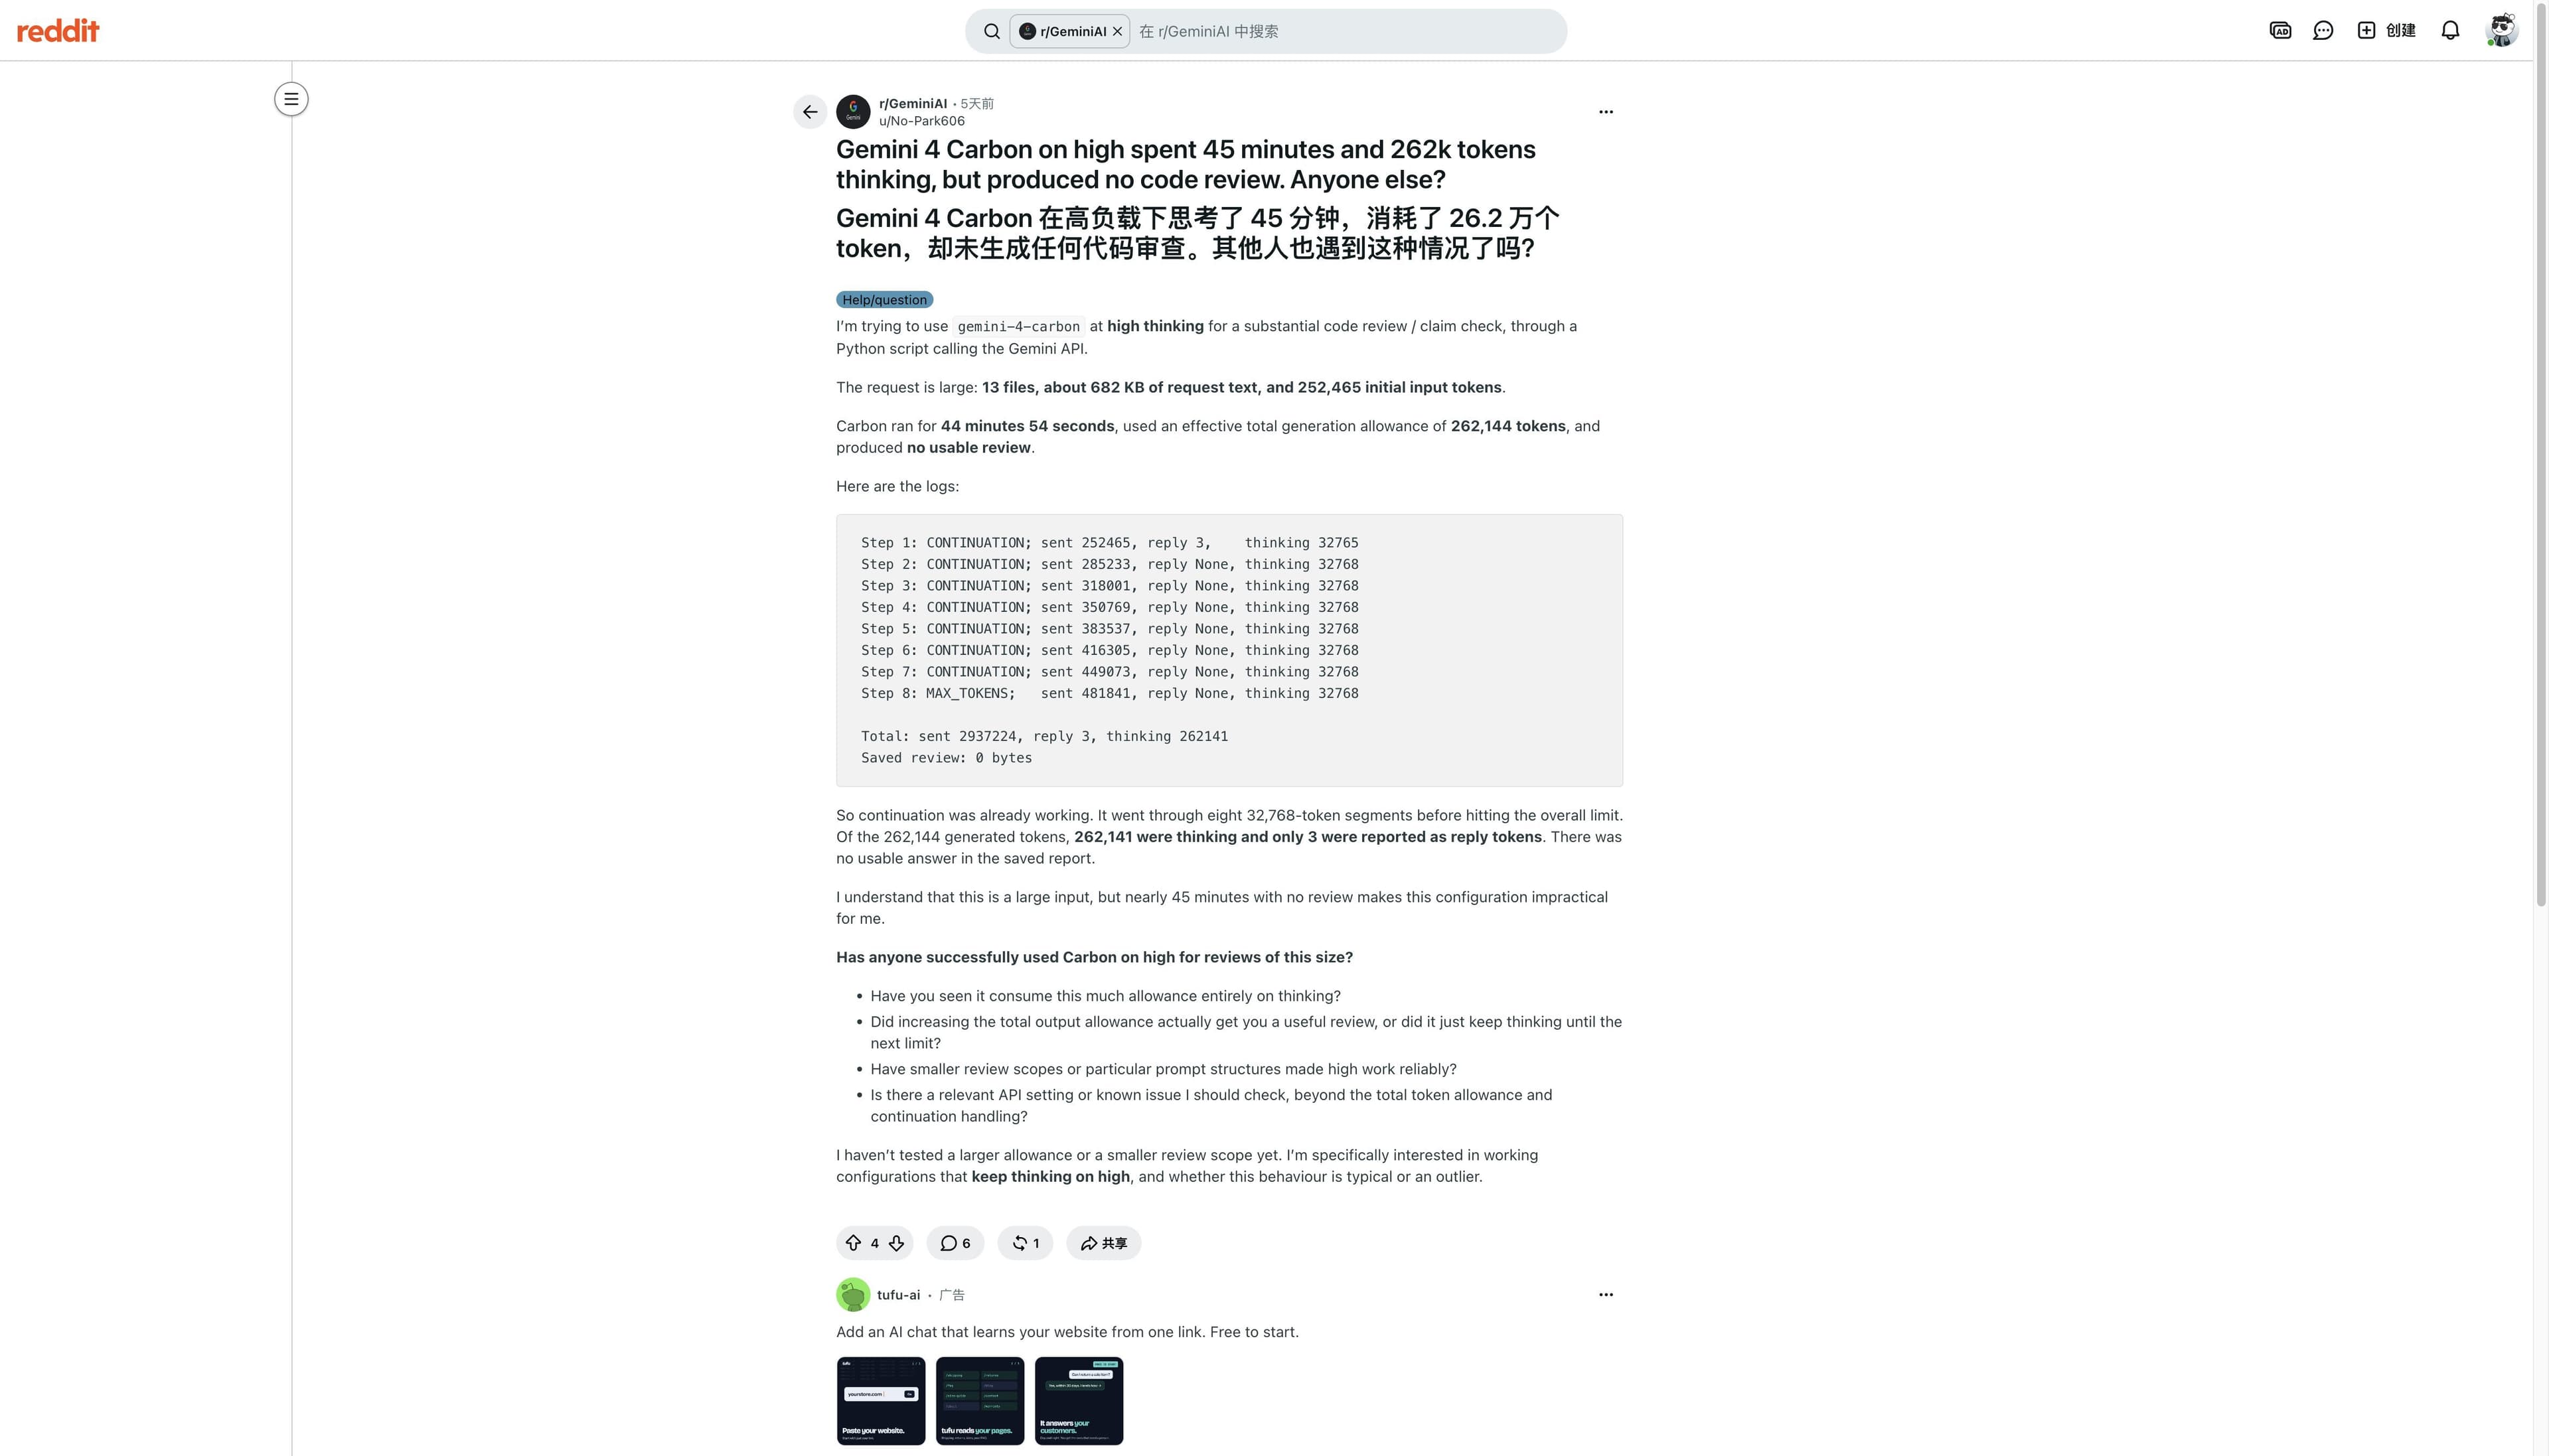
Reddit の投稿者は、高い思考設定で 13 ファイルをレビューした結果、約 45 分・思考トークン 262,141 を消費し、有用なレビューが得られなかったと報告しています。単一の設定・失敗例であり、一般的な信頼性の率ではありません。スクリーンショットに課題説明と表示された実行情報があります。投稿を読む。
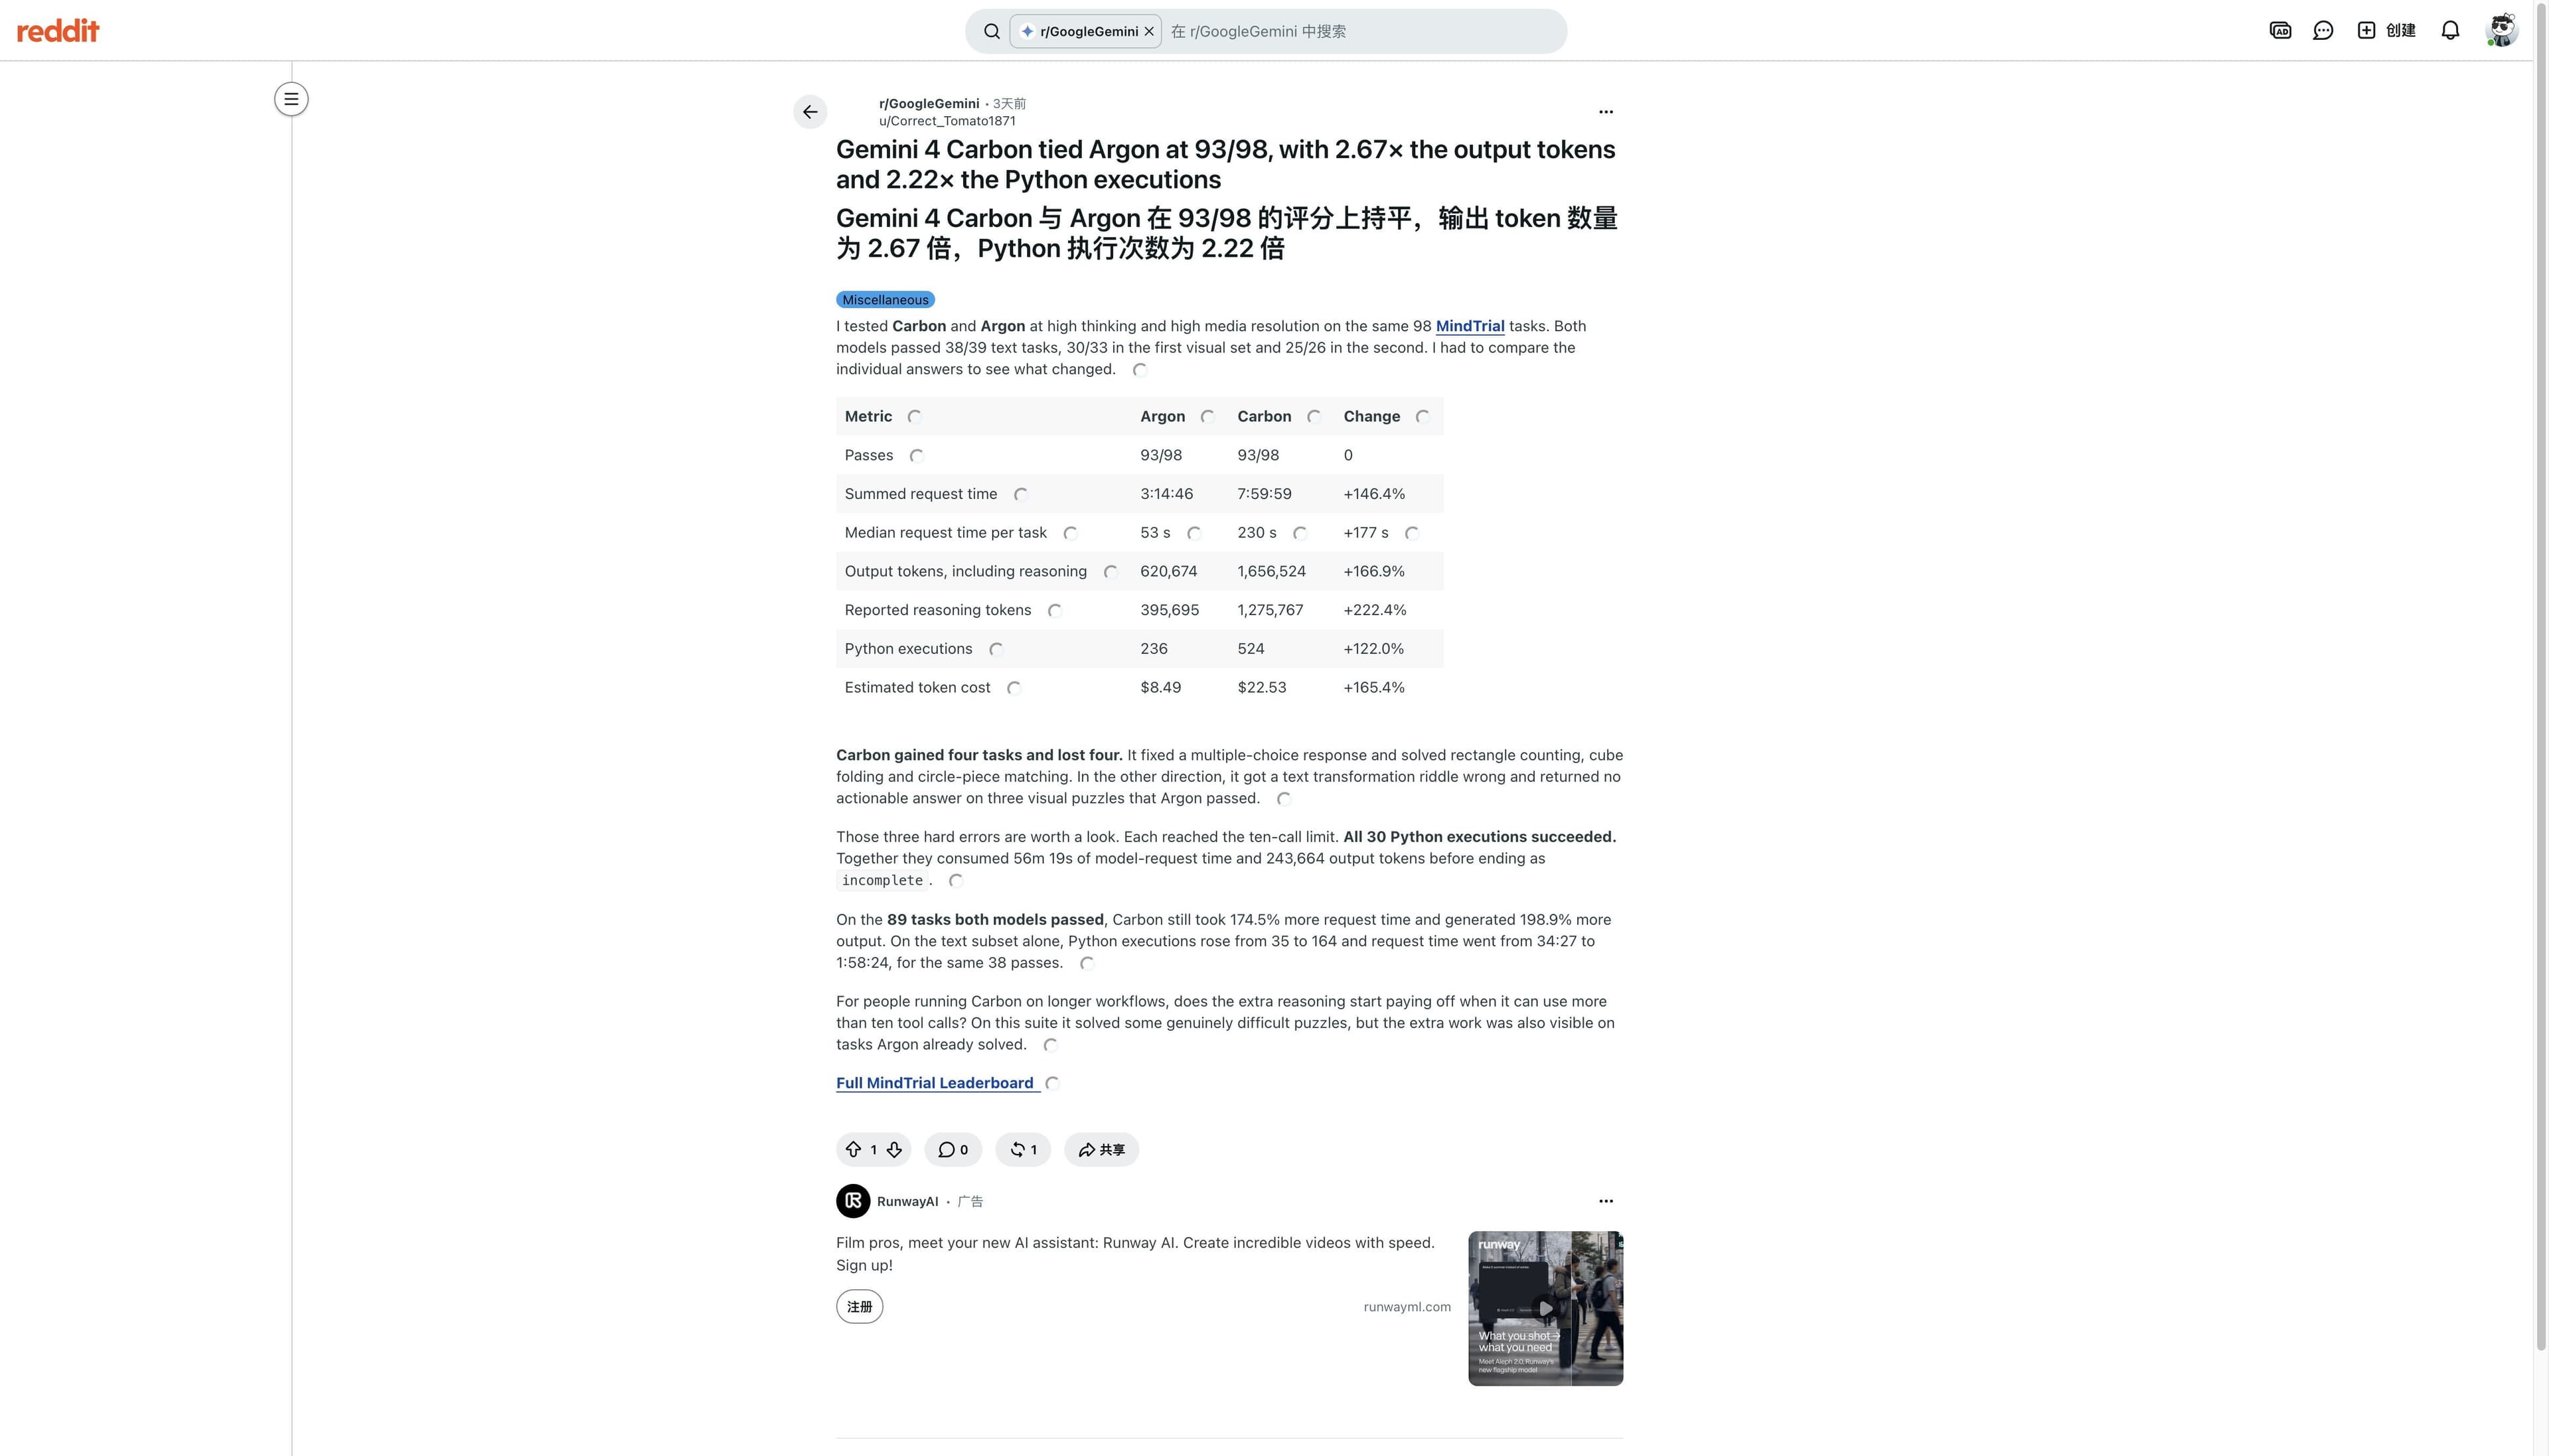
別の Reddit 投稿は 98 件の MindTrial で Carbon と Argon がともに 93/98、Carbon は出力トークン 2.67 倍、時間 2.46 倍、投稿者推定費用は $22.53 と $8.49 と報告します。自己申告であり、合格タスクあたりの費用を測る設計例にはなりますが、再現済みの点数ではありません。原文を読む。
レビューの要点
Google は Carbon を最難関の長期タスク向けと説明します。試用候補にはなりますが、第三者による推奨ではありません。
モデルカードの評価は別々のベンチマークです。見出しの単一スコアより、版・評価環境・タスクを確認します。
Google は高い思考設定でのトークン増加、遅延、タイムアウト、幻覚に触れています。一般的な成功率は示していません。
利用報告はタスクごとのばらつきを示しますが、Tabbit での Carbon 実測や反復対照試験は確認できていません。
実務で使う判断表
| タスク | 出典が示すこと | 未確認の点 | 次の確認 |
|---|---|---|---|
| Vendor benchmarks | Model card names task, harness and score | General reliability on your workload | Reproduce a benign task |
| User reports | Individual Reddit/X experiences | Population-level result | Keep prompts and settings attached |
| High-thinking work | Vendor notes higher token use and possible latency/timeouts | Fixed quality-per-dollar advantage | Measure tokens and accepted output |
主張をタスクテストに変える
試用前に合格条件を決めます。読み取り専用の入力と安全な出力を使い、同じ文脈・評価基準で繰り返します。正確さ、漏れ、時間、入出力トークン、費用を記録します。誤りがあればモデル、指示、情報源のどこに起因するかを分け、実行ごとに課題を変えないでください。
Google の Carbon モデルカードは Terminal-Bench 4.0 (AA) 65.2%、Agents’ Last Exam v1.1 77.4、指定された 256k–1M BFS 条件で GraphWalks F1 96.2% などを報告しています。各数値は別の評価です。Artificial Analysis は現在 v5.0.1、Google のカードのスナップショットは v5.0 と記載しており、59 と「最大 60」を単純な改善として比較できません。
| Evidence | What it can tell you | What it cannot tell you |
|---|---|---|
| Vendor benchmark | Performance on named task and harness | Your production success rate |
| Community task report | A person’s experience under their own setup | Independent replication or average cost |
| Your pilot | Fit for the chosen task and rubric | All future prompts or account configurations |
公開発表済みでも、利用可否は製品とアカウントによって異なります。Google は開発者・企業向けに Gemini API と AI Studio、消費者向けに Ultra の Gemini アプリを挙げています。実際に使う製品の選択画面と請求画面を確認してください。
再現可能な証拠収集には複数モデルの調査記録、出典付きブラウザー調査、ディープリサーチの方法、成功あたりの費用を参照してください。
Tabbit が担う役割
Tabbit はブラウザーとワークフローの層であり、Carbon 自体がログイン済みブラウザーを操作できる証拠ではありません。Carbon のブラウザー利用ガイドではモデルへの接続とローカル実行を分けて説明しています。本稿は Tabbit 上の Carbon ベンチマークや実行結果を報告していません。上記は試験手順であり結果ではありません。
ブラウザーワークフローで Carbon を試す場合は、Tabbit CLI ガイド、既存ブラウザーへの接続、最初のタスクの確認表、ローカル自動化、エージェント型ブラウザーの説明を使い、モデル接続とローカル実行を分けてください。
評価スコアは設定と一緒に読む
モデルカードは、スコアをタスク名、バージョン、評価環境、入力条件と併記すると参考になります。長文脈のグラフ課題で高得点でも、企業アカウントを正確に操作できるとは限りません。コード評価で引用の質も分かりません。ベンダー評価は試用先の選定に役立ち、利用者投稿はトークン消費やタイムアウトなどを示しますが、どちらも自分の基準で受け入れた結果を複数回測る代わりにはなりません。「Carbon は優秀か」ではなく、「このタスクを許容できる費用と遅延で完了するか」を確認します。
公開情報は自分の業務結果を保証するものではなく、検証の出発点です。機密データや継続的な費用を伴う前に、モデル、アカウント条件、実測結果を確認してください。

よくある質問
Gemini 4 Carbon は試す価値がありますか?
アカウントで選択できる場合、難しいタスクを限定して試す候補です。公開情報はすべての業務に適することを証明しません。
ベンチマークは自分の結果を予測しますか?
いいえ。タスク、評価環境、モデル版、設定に左右されます。評価設計の参考にし、自分の業務を測定してください。
モデルカードは限界を示していますか?
はい。高い思考設定でトークンが増えること、遅延、タイムアウト、幻覚に触れていますが、一般的な失敗率は示しません。
Carbon はログイン済みページを閲覧できますか?
モデル単体ではブラウザーを操作しません。別のローカル環境、接続ツール、アカウント、許可されたセッションが必要です。
試用をどう評価しますか?
安全なタスク、固定入力、評価表を使って複数回実行し、事実、漏れ、時間、トークン、費用を確認します。