
Gemini 4 Carbon peut justifier un pilote limité pour des tâches difficiles et longues, mais les informations publiques ne prouvent pas qu’il soit le meilleur pour votre travail. Google le destine aux tâches les plus complexes et indique qu’Argon convient à la majorité du développement logiciel et du travail de connaissance. La fiche regroupe des tests différents; leurs résultats dépendent de chaque tâche et protocole, et ne forment pas un taux de réussite général.
Retours d’utilisateurs
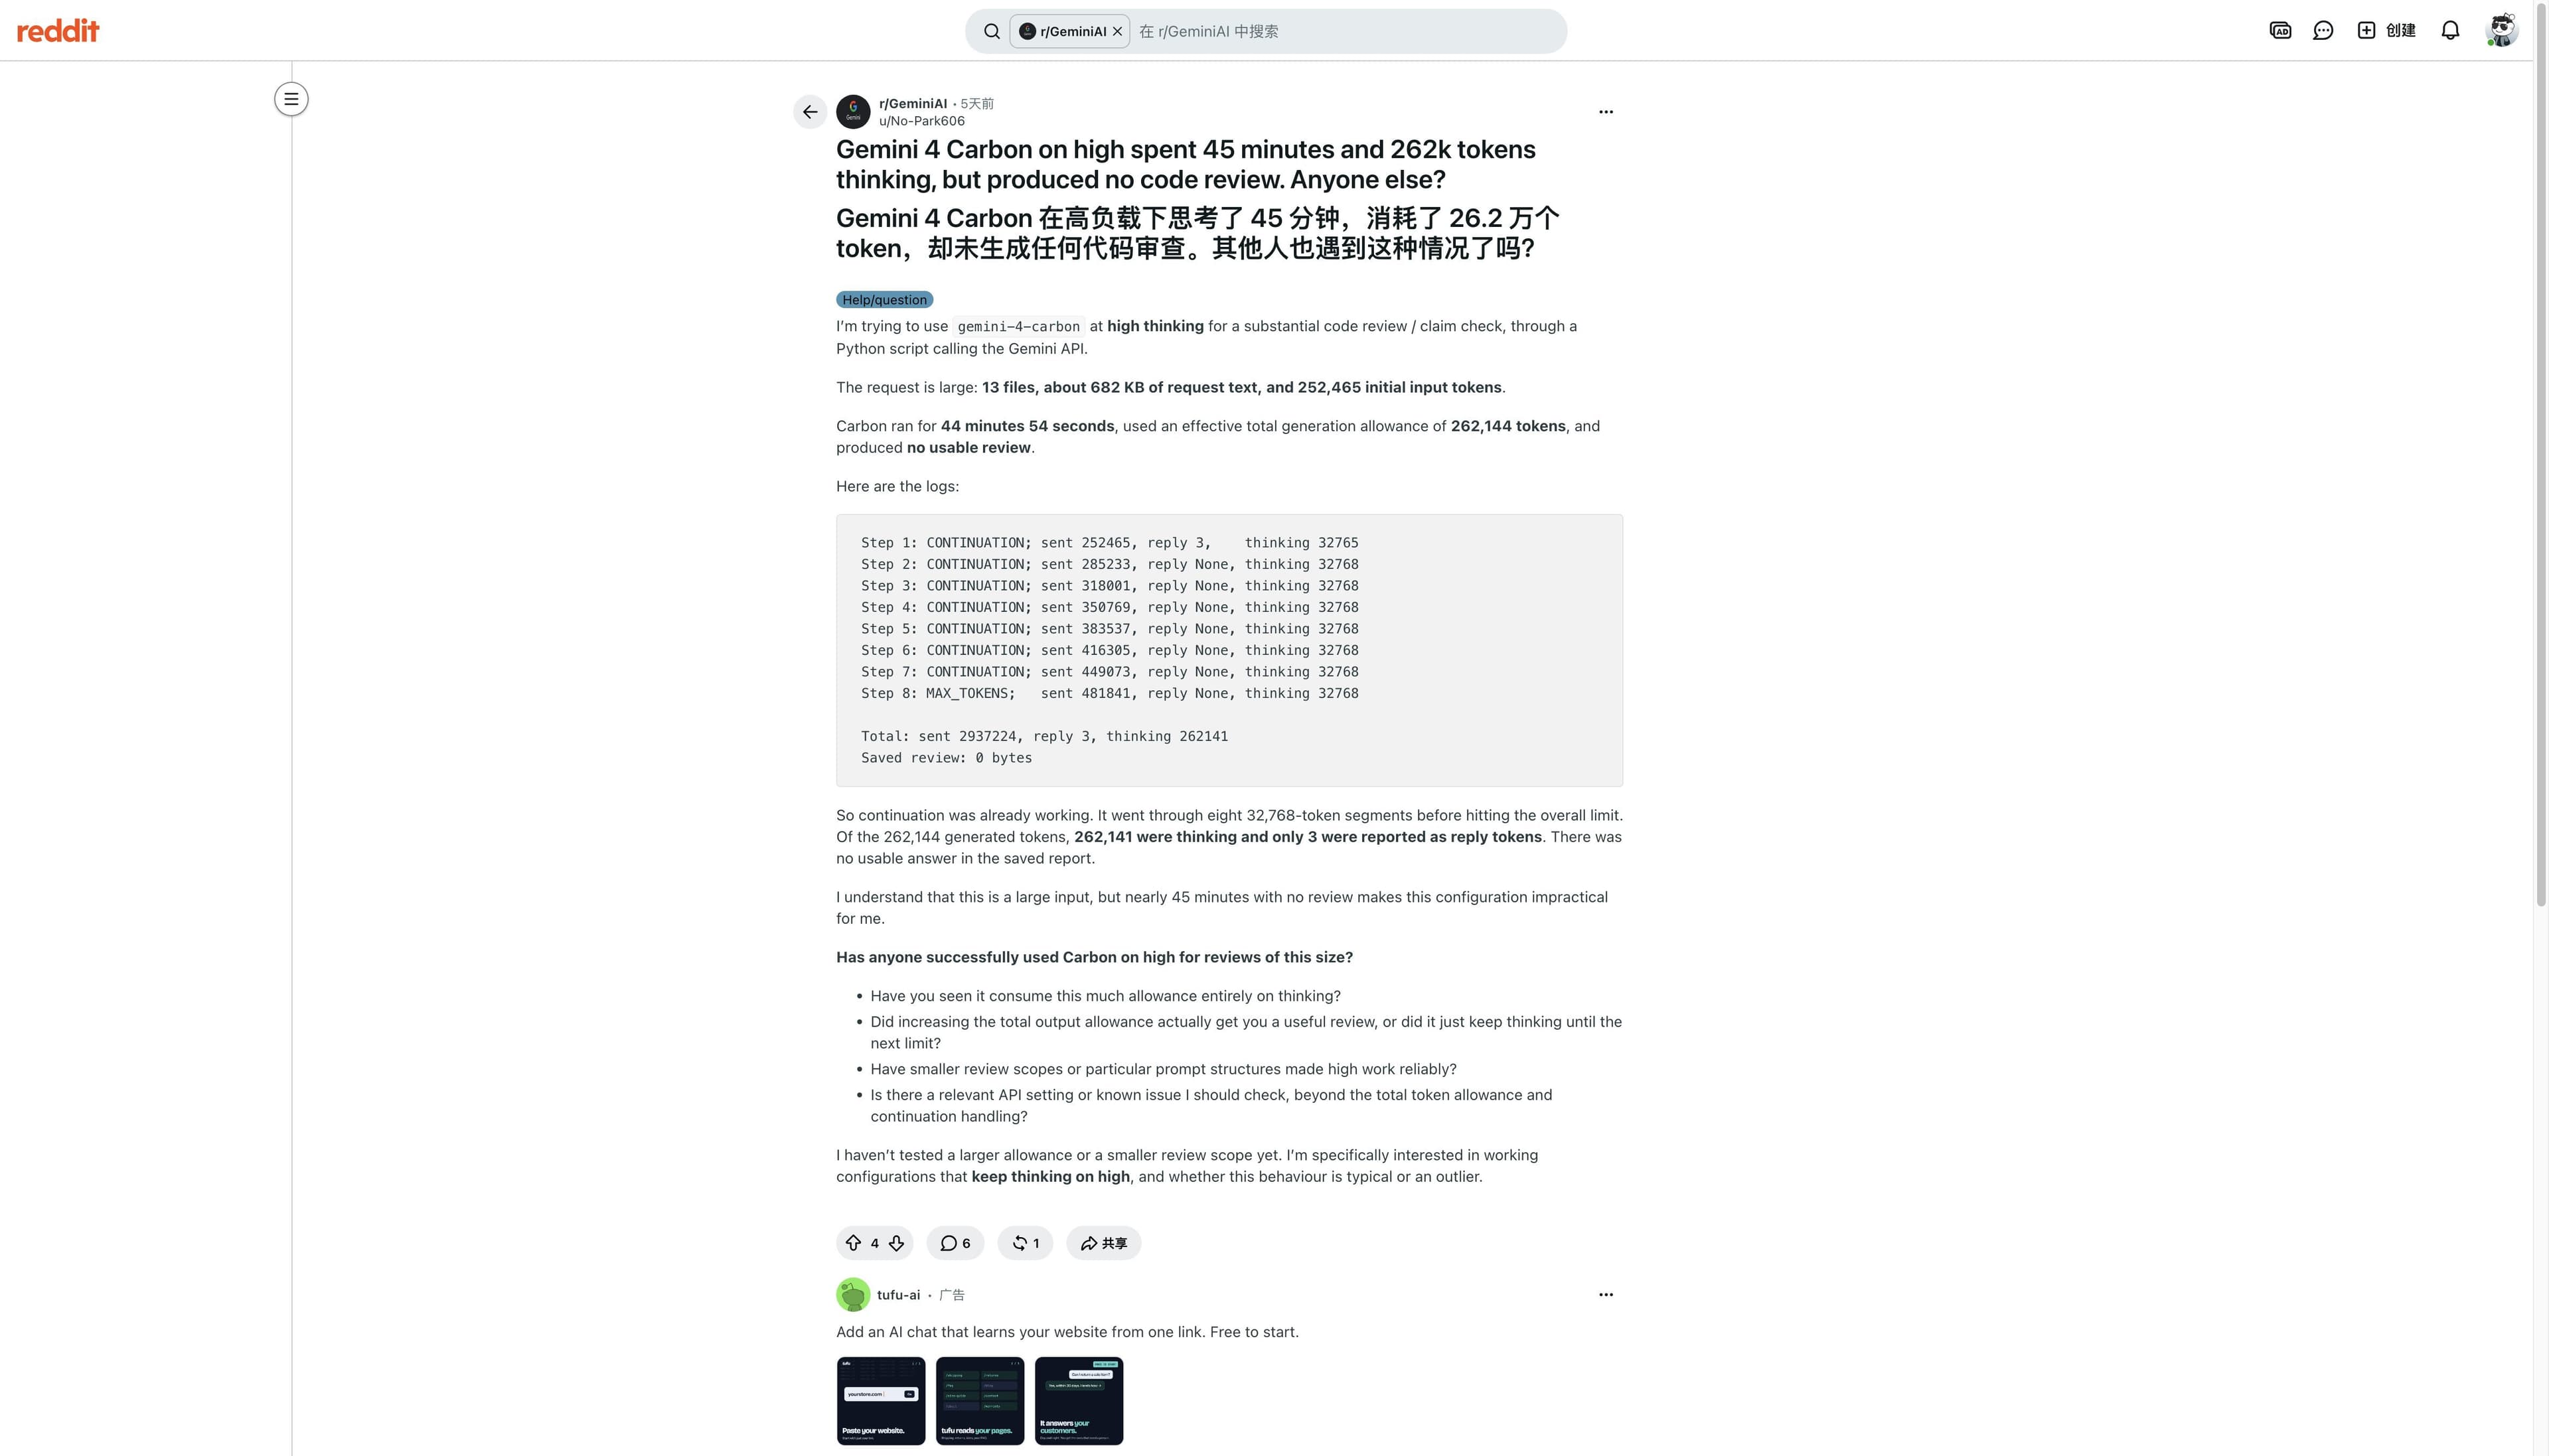
Un utilisateur Reddit rapporte qu’une revue de 13 fichiers en réflexion élevée a duré environ 45 minutes, consommé 262 141 tokens de réflexion et n’a produit aucun avis exploitable. Un seul échec dans une configuration donnée ne définit pas la fiabilité générale. La capture conserve la description et les chiffres affichés. Lire le post.
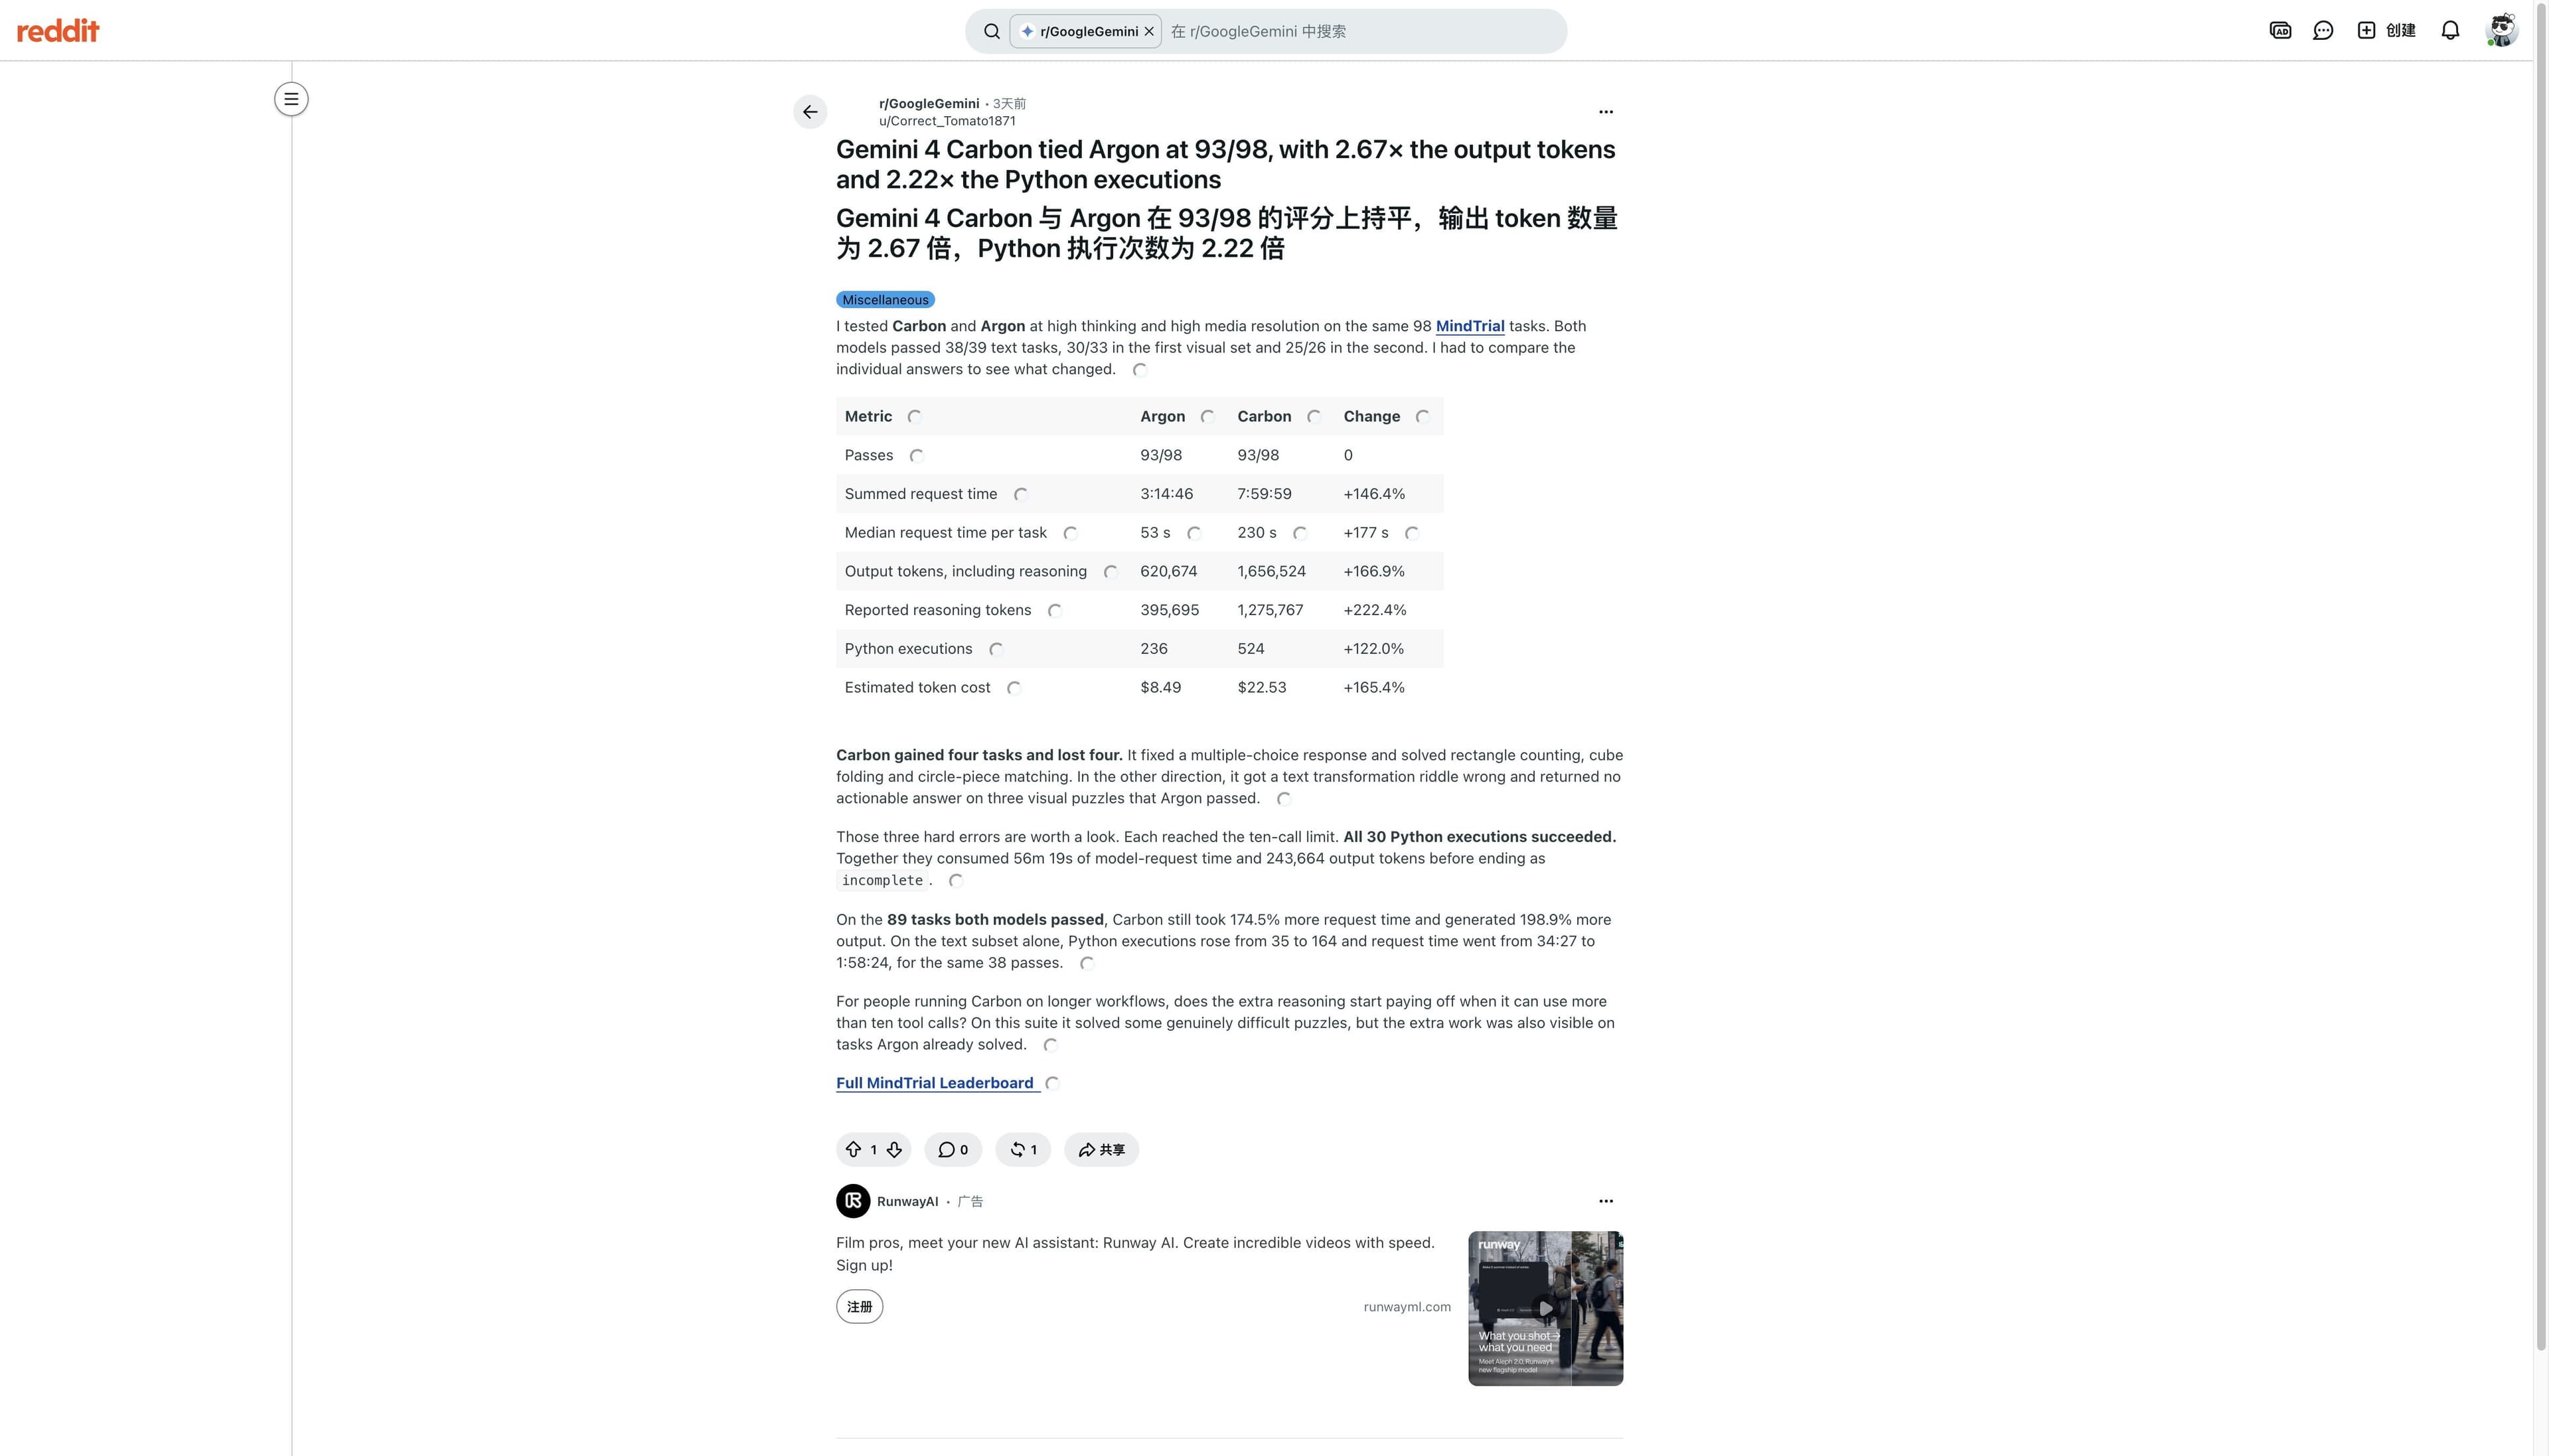
Un autre utilisateur compare Carbon et Argon sur 98 tâches MindTrial : 93/98 chacun, mais 2,67 fois plus de tokens sortants et 2,46 fois plus de temps pour Carbon; coûts estimés par l’auteur : 22,53 $ contre 8,49 $. Ce témoignage peut inspirer un test de coût par tâche réussie, mais il n’est pas reproduit indépendamment. Lire l’original.
Conclusion de l’évaluation
Google destine Carbon à ses tâches les plus difficiles et longues; cela motive un pilote, pas une recommandation indépendante.
La fiche réunit des benchmarks différents; version, protocole et tâche comptent davantage qu’un score unique.
Google signale plus de tokens en réflexion élevée, ainsi que latence, délais dépassés et hallucinations; aucun taux général de réussite n’est fourni.
Les témoignages montrent des écarts selon les tâches; aucun essai Carbon dans Tabbit ni test contrôlé répété n’est confirmé ici.
Tableau de décision pratique
| Tâche | Ce que les sources étayent | Ce qui reste à prouver | Prochaine vérification |
|---|---|---|---|
| Vendor benchmarks | Model card names task, harness and score | General reliability on your workload | Reproduce a benign task |
| User reports | Individual Reddit/X experiences | Population-level result | Keep prompts and settings attached |
| High-thinking work | Vendor notes higher token use and possible latency/timeouts | Fixed quality-per-dollar advantage | Measure tokens and accepted output |
Transformer l’affirmation en test
Avant le pilote, définissez le résultat acceptable. Utilisez des entrées en lecture seule et une sortie sans risque, puis répétez avec le même contexte et la même grille. Notez exactitude, omissions, durée, tokens entrants/sortants et coût. En cas d’erreur, distinguez modèle, consigne et sources; ne modifiez pas la tâche entre les essais.
La fiche Carbon de Google indique notamment 65,2 % sur Terminal-Bench 4.0 (AA), 77,4 sur Agents’ Last Exam v1.1 et un F1 de 96,2 % sur GraphWalks pour un protocole BFS de 256k–1M. Ces évaluations sont distinctes. Artificial Analysis affiche actuellement l’index v5.0.1, tandis que l’instantané de Google indique v5.0; 59 et « jusqu’à 60 » ne démontrent pas une progression directe.
| Evidence | What it can tell you | What it cannot tell you |
|---|---|---|
| Vendor benchmark | Performance on named task and harness | Your production success rate |
| Community task report | A person’s experience under their own setup | Independent replication or average cost |
| Your pilot | Fit for the chosen task and rubric | All future prompts or account configurations |
Le lancement est public, mais l’accès dépend du produit et du compte. Google cite Gemini API et AI Studio pour les développeurs et entreprises, ainsi que l’application Gemini Ultra pour les particuliers. Vérifiez le sélecteur et la facturation du produit réellement prévu.
Pour une collecte reproductible, consultez les notes multi-modèles, la recherche navigateur sourcée, les méthodes de recherche approfondie et le coût par réussite.
La place de Tabbit
Tabbit est une couche navigateur et workflow; cela ne prouve pas que Carbon pilote lui-même un navigateur connecté. Le guide navigateur Carbon distingue l’accès au modèle de l’exécution locale. Cet article ne présente aucun benchmark ni essai de Carbon dans Tabbit; la procédure ci-dessus est un protocole, pas un résultat.
Pour tester Carbon dans un workflow navigateur, distinguez accès au modèle et exécution locale avec le guide Tabbit CLI, la connexion navigateur existant, la checklist première tâche, l’automatisation locale et le guide agentique.
Lire les scores avec leur protocole
Une fiche est plus utile si chaque score reste associé au nom de la tâche, à la version, au protocole et aux entrées. Un bon résultat sur un graphe à long contexte ne prouve pas que Carbon naviguera correctement dans un compte professionnel; un benchmark de code ne mesure pas la qualité des citations. Les tests du fournisseur orientent le choix d’un pilote et les témoignages signalent des questions concrètes comme les tokens ou les délais, sans remplacer des essais répétés sur vos propres critères. La question utile est : Carbon termine-t-il cette tâche précise au coût et au délai acceptables ?
Les éléments publiés servent de point de départ, pas de garantie pour votre charge de travail. Vérifiez le modèle, les conditions du compte et les résultats mesurés avant d’engager des données sensibles ou des dépenses récurrentes.

Questions fréquentes
Gemini 4 Carbon mérite-t-il un essai ?
Un pilote limité sur une tâche difficile peut être utile si votre compte propose le modèle. Les sources publiques ne prouvent pas qu’il convienne à tous les usages.
Les scores de benchmark prédisent-ils mon résultat ?
Non. Ils dépendent de la tâche, du protocole, de la version et des réglages. Servez-vous-en pour définir votre propre test.
La fiche décrit-elle des limites ?
Oui. Elle mentionne une hausse des tokens avec le raisonnement élevé, ainsi que latence, délais dépassés et hallucinations, sans taux d’échec universel.
Carbon peut-il consulter mes pages connectées ?
Le modèle ne pilote pas le navigateur à lui seul. Il faut un hôte local, un connecteur, un compte et une session autorisée distincts.
Comment évaluer un pilote ?
Répétez une tâche sûre avec les mêmes entrées et critères. Vérifiez faits, omissions, durée, tokens et coût avant d’élargir l’usage.